10 przykładów polityk data governance
|
12
min. czyt.

Dokument polityki może istnieć, podczas gdy jego dane pozostają faktycznie bez nadzoru. Badania branżowe podają, że tylko 23 % organizacji stosuje formalne ramy governance lub jakości danych, 55 % nie prowadzi na bieżąco inwentarza danych wrażliwych, 70 % nie ma spójnej strategii łączącej widoczność danych i tożsamości, a jedynie 39 % potrafi sklasyfikować wszystkie swoje dane. Te ustalenia pokazują, dlaczego lista tytułów polityk nie wystarcza. Użyteczna polityka przekłada zasadę na obserwowalną kontrolę, wskazuje osobę, która ją prowadzi, zapisuje dowody i określa, co się dzieje, gdy kontrola zawiedzie. Wyniki badania na temat wdrażania data governance
Poniższych dziesięć przykładów polityk data governance napisano jako szablony operacyjne, a nie statyczne definicje. Każdy łączy cel kontrolny z właścicielem, wyzwalaczem, dowodami, ścieżką eskalacji i mierzalnym rezultatem. Przykłady dotyczą usług finansowych, ochrony zdrowia, telekomunikacji i administracji publicznej, ale ta sama logika działa dla krytycznych zbiorów danych, sprawozdawczości regulowanej, pipeline'ów analitycznych i systemów AI.
Polityka powinna też odzwierciedlać kontekst prawny organizacji. Unijny akt o zarządzaniu danymi został przyjęty przez Parlament Europejski 6 kwietnia 2022 r., wszedł w życie 23 czerwca 2022 r. i zaczął obowiązywać 24 września 2023 r. po 15-miesięcznym okresie przejściowym, tworząc ramy prawne dla ponownego wykorzystania danych, pośredników i altruizmu danych na rynkach UE. Harmonogram i skutki unijnego aktu o zarządzaniu danymi Ten przebieg ilustruje praktyczną presję na przedsiębiorstwa, by przejść od projektowania polityk do egzekwowalnych kontroli, zwłaszcza gdy dane przekraczają granice jurysdykcji.
Spis treści
4. Polityka wykrywania zmian schematu i governance strukturalnego
6. Polityka monitorowania metryk biznesowych i wiarygodności KPI
1. Polityka standardów jakości danych i walidacji
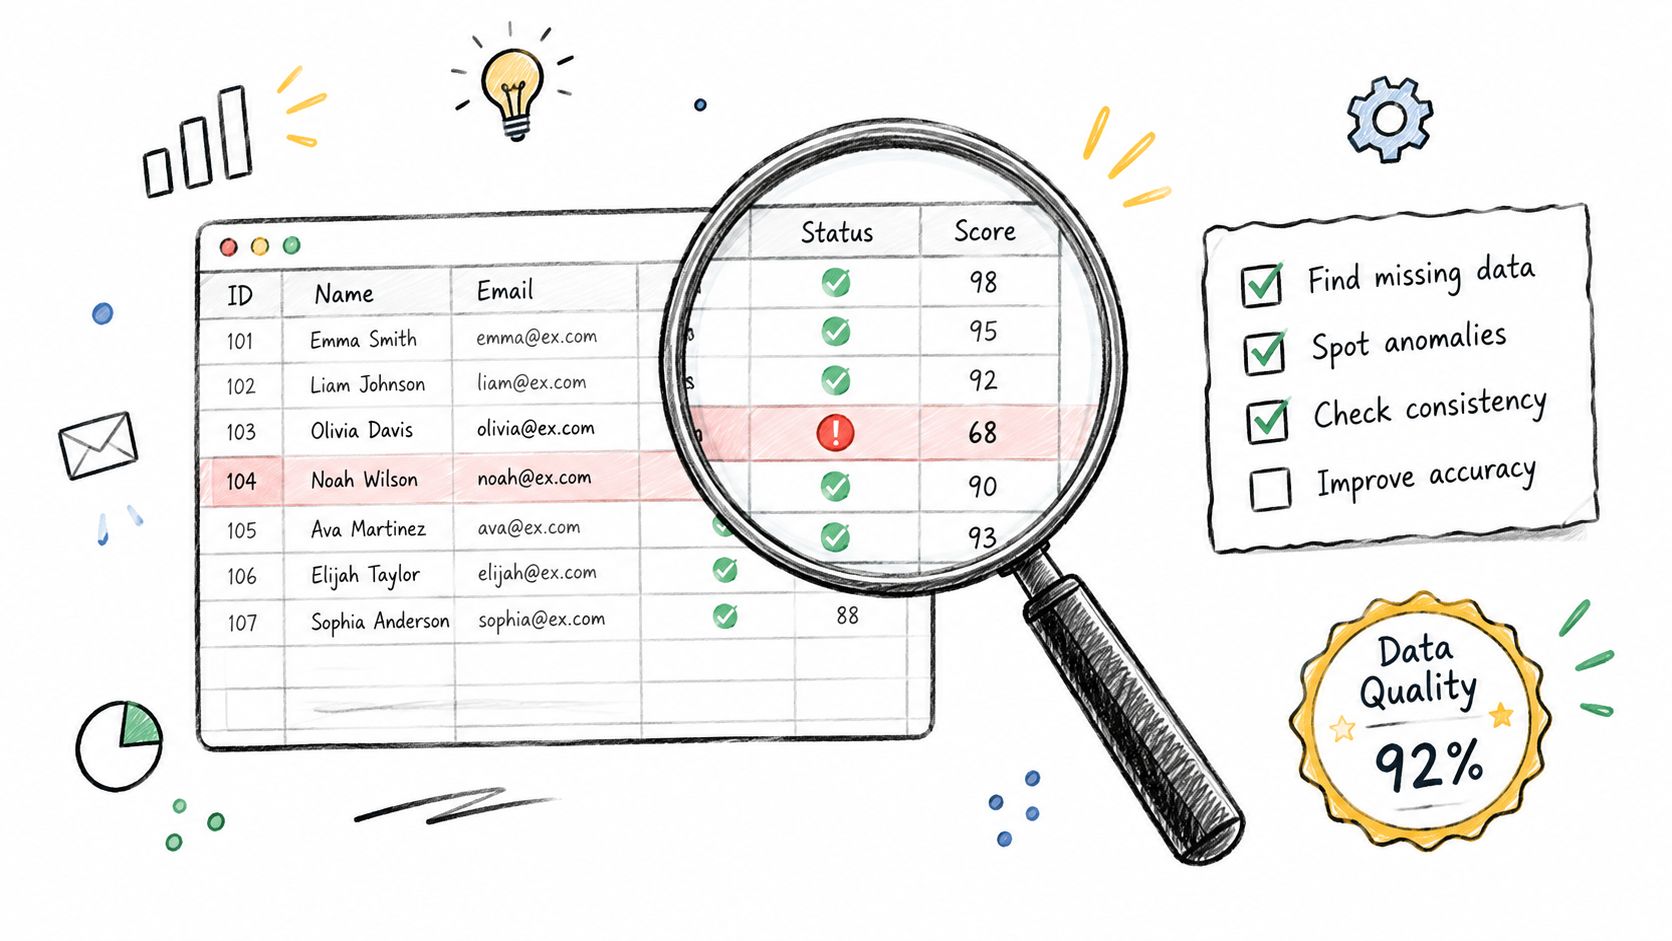
Polityka jakości danych określa minimalny warunek, jaki rekord musi spełnić, zanim systemy poniżej uznają go za użyteczny. Jej celem kontrolnym jest przydatność do celu, a nie abstrakcyjna doskonałość. Rekord transakcji może wymagać prawidłowej kwoty, możliwej do zidentyfikowania strony i wymaganych pól regulacyjnych. Rekord kliniczny może wymagać wewnętrznie spójnych pomiarów i identyfikatorów. Konto telekomunikacyjne może potrzebować spójnych atrybutów rozliczeniowych i klienckich, zanim ruszy raportowanie przychodów.
Właściciel danych zatwierdza biznesowe znaczenie każdej reguły. Data steward utrzymuje rejestr reguł, a inżynierowie danych wdrażają kontrole we właściwym pipeline lub bazie. Wyzwalaczem jest zaplanowane ładowanie, zdarzenie ingestu albo przekazanie w procesie biznesowym. Dowody powinny obejmować definicję reguły, uzasadnienie biznesowe, znacznik czasu wykonania, dotknięte rekordy, wyniki zaliczeń i niepowodzeń, stan naprawy oraz historię zatwierdzeń.
Zasada praktyczna: Reguła walidacyjna daje się nadzorować dopiero wtedy, gdy ktoś potrafi wyjaśnić, po co istnieje, co sprawdza i kto działa, gdy zawiedzie.
Walidacja deterministyczna różni się od monitorowania zachowania. Reguła w rodzaju „kwota transakcji musi być obecna i liczbowa” daje powtarzalny wynik. Monitor anomalii ocenia natomiast, czy zachowanie odbiegło od oczekiwanego wzorca. Oba należą do programu jakości, ale odpowiadają na inne pytania.
Jak ją wdrożyć
Zacznij od zbiorów danych niosących największe ryzyko biznesowe, regulacyjne lub operacyjne. Poproś inżynierów danych, analityków i interesariuszy biznesowych, by zdefiniowali reguły wspólnie, a następnie udokumentuj uzasadnienie, żeby przyszli opiekunowie rozumieli zamierzoną kontrolę.
Właściciel: Biznesowy właściciel danych zatwierdza progi i wyjątki.
Wyzwalacz: Każde istotne ładowanie lub zdarzenie przetwarzania na poziomie rekordu.
Dowody: Wersje reguł, logi wykonania, rekordy odrzucone, notatki naprawcze i akceptacja.
Eskalacja: Steward bada sprawę pierwszy, a nierozwiązane kieruje do właściciela i dotkniętych odbiorców.
Rezultat: Krytyczne zbiory mają widoczne pokrycie walidacją i udokumentowaną reakcję na niepowodzenia.
Zespoły mogą użyć standardów jakości danych digna i modułu walidacji na poziomie rekordu, by egzekwować deterministyczne kontrole biznesowe bez polegania na przeglądzie ręcznym. Reguły należy przeglądać kwartalnie lub półrocznie, zwłaszcza po zmianach produktów, obowiązków sprawozdawczych lub systemów źródłowych. Dodatkowy kontekst daje przewodnik AutoProv po standardach jakości danych.
2. Polityka wykrywania anomalii i uczenia linii bazowej
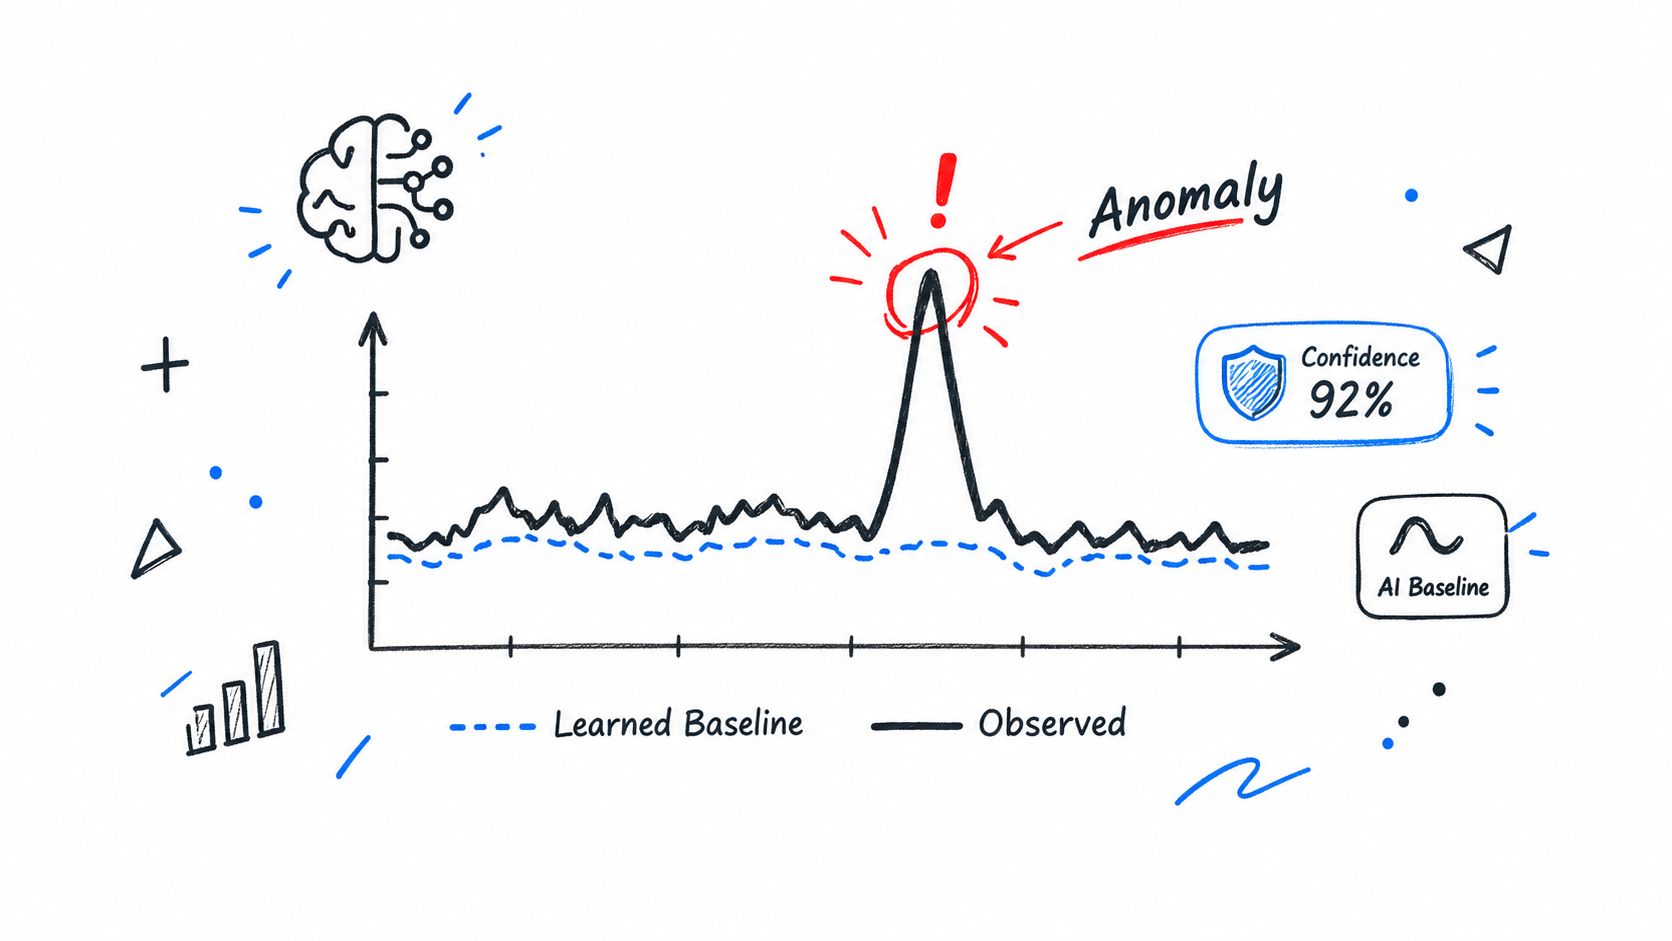
Zbiór danych może spełniać każdą statyczną regułę walidacyjną i mimo to stać się niewiarygodny, gdy jego zachowanie się przesunie. Polityka wykrywania anomalii kontroluje tę lukę, określając, które wzorce monitorować, jak uczy się normalne zachowanie, kto bada odchylenia i jakie dowody wspierają ostateczną decyzję.
Właściciel monitorowania wybiera zbiór danych, kontekst biznesowy i monitorowane wymiary. Data scientist lub inżynier platformy konfiguruje uczenie linii bazowej. Data steward zapisuje potwierdzone anomalie, przyczyny i rozstrzygnięcia. Wyzwalaczem mogą być zmiany wolumenu, rozkładu, częstotliwości albo innego zdefiniowanego zachowania.
Kontrola musi oddzielić sygnał statystyczny od potwierdzonego incydentu. Zespoły w usługach finansowych mogą badać nietypowe wolumeny obrotu lub wzorce związane z oszustwami. Zespoły w ochronie zdrowia mogą analizować nieoczekiwane zmiany przyjęć albo rozkładów pomiarów klinicznych. Instytucje publiczne mogą przeglądać nietypowe rozkłady świadczeń lub aktywność składania wniosków. Te przypadki wymagają kontekstu, zanim alert stanie się incydentem operacyjnym.
Monitorowanie zachowania wskazuje odchylenie. Przegląd wykonany przez człowieka rozstrzyga, czy odchylenie jest defektem, uprawnionym zdarzeniem biznesowym czy narastającym ryzykiem.
Kontrole dla monitorowania zachowania
Pozwól modelowi nauczyć się zachowania historycznego, zanim alerty staną się operacyjne. Projekt wdrożenia przewiduje okres uczenia od 2 do 4 tygodni, aby zwykłe cykle i powtarzalne wzorce ukształtowały linię bazową. Ten czas należy do projektu wdrożenia tej polityki, a nie do ogólnego benchmarku branżowego.
Właściciel: Właściciel monitorowania przydziela odpowiedzialność za triage i SLA reakcji.
Wyzwalacz: Zdefiniowane odchylenie wolumenu, rozkładu, częstotliwości lub innego monitorowanego wymiaru.
Dowody: Zachowaj okres linii bazowej, okno porównania, szczegóły alertu, dotkliwość, notatki z badania, przyczynę źródłową, rozstrzygnięcie i naprawę.
Pętla uczenia: Zapisuj potwierdzone anomalie i fałszywe alarmy, by można było stroić model i progi.
Eskalacja: Kieruj anomalie o dużym wpływie lub nierozwiązane do właściciela danych i procesu reagowania na incydenty.
Rezultat: Analitycy odróżniają oczekiwaną zmienność od defektów danych, co zwiększa zaufanie do raportowania i wejść dla AI.
Zespoły mogą użyć wykrywania anomalii digna dla workflow w Pythonie, by wesprzeć uczenie linii bazowej i ciągłe monitorowanie. Funkcja analityczna pomaga też badać historyczne wzorce anomalii, zamiast traktować każdy alert jako zdarzenie odosobnione.
Wdrożenie powinno przebiegać po kolei: wybrać zbiory wysokiego ryzyka, zdefiniować monitorowane zachowanie, ustalić okres uczenia, przetestować dotkliwość alertów, przydzielić odpowiedzialność za triage, a potem przeglądać potwierdzone przypadki. Politykę należy zmienić, gdy zmieniają się procesy biznesowe lub zachowanie danych.
3. Polityka Timeliness i monitorowania dostaw
Terminowy zbiór danych to zależność operacyjna, a nie tylko atrybut jakości. Kanał może zawierać poprawne wartości i mimo to przegapić okno decyzyjne rozliczenia na koniec dnia, wystawienia faktur, operacji klinicznych tego samego dnia albo sprawozdawczości regulacyjnej. Polityka powinna zamienić „wystarczająco świeże” w uzgodnione oczekiwanie dostawy, obserwowalny wyzwalacz i zdefiniowaną reakcję.
Zacznij od potrzeby odbiorcy. Finanse, operacje, raportowanie i interesariusze kliniczni mogą korzystać z tej samej tabeli w różnych porach dnia, więc producent danych odpowiada za wykonanie dostawy, a odbiorca definiuje wymagane okno. Zespół platformowy bada awarie orkiestracji, infrastruktury i zależności.
Zapisz odbiorcę, przypadek użycia, akceptowane okno dostawy i konsekwencję opóźnienia. Prawidłowym wyzwalaczem może być nieprzybycie danych, wczesne ładowanie łamiące założenia poniżej albo dostawa poza uzgodnionym oknem serwisowym. Pakiet dowodów powinien zachować oczekiwane i faktyczne czasy przybycia, historię dostaw, status pipeline'u, informacje o zależnościach, zapisy incydentów i rozstrzygnięcie, czy naruszono SLA.
Uczyń oczekiwania dostawy obserwowalnymi
Harmonogramy wyuczone przez AI potrafią rozpoznać normalne zachowanie dostaw bez zmuszania inżynierów do utrzymywania kruchych, ręcznych okien czasowych. Przewodnik digna po definicjach i metrykach Timeliness wyjaśnia, jak monitorować brakujące, opóźnione i wczesne przybycia oraz obliczać oczekiwany czas dostawy.
Wdróż kontrolę po kolei:
Zdefiniuj termin odbiorcy i konsekwencję opóźnienia.
Ustal oczekiwane zachowanie dostaw na podstawie obserwowanej historii.
Ustaw alert, gdy minie przewidywane przybycie bez oczekiwanych danych albo gdy zmieni się zachowanie dostaw.
Wskaż producenta jako pierwszy punkt eskalacji.
Kieruj zagrożenia dla terminu do właściciela platformy i odbiorcy biznesowego.
Zachowaj czas oczekiwany, czas faktyczny, długość opóźnienia, stan zależności i reakcję właściciela.
Rezultatem jest jasność diagnostyczna. Zespoły potrafią oddzielić spóźnione źródło od nieudanego pipeline'u czy problemu infrastruktury poniżej, zamiast traktować każdą przegapioną dostawę jako ten sam incydent.
Przeglądaj trendy Timeliness co miesiąc. Powtarzające się opóźnienie może wskazywać na problem procesowy, a wiarygodny kanał może już nie spełniać potrzeb nowo dołączonego odbiorcy. Te ustalenia powinny aktualizować okno dostawy, własność lub regułę eskalacji.
4. Polityka wykrywania zmian schematu i governance strukturalnego
Zmiana schematu potrafi unieważnić zaufane wyniki, zanim kontrola na poziomie wartości cokolwiek wykryje. Usunięcie kolumny, zmiana typu danych albo modyfikacja ograniczenia mogą złamać raport, model lub transformację już przy ingeście. Dlatego ta polityka nadzoruje widoczność i wpływ zmiany strukturalnej, z deterministycznym porównaniem do zatwierdzonej linii bazowej schematu.
Kontrola zaczyna się od zarejestrowanego schematu i wskazanego właściciela schematu. Automatyczne wykrywanie porównuje każdą wdrożoną wersję z tą linią bazową i zapisuje dodania, usunięcia, zmiany typów i zmiany ograniczeń. Wyzwalaczem jest każde niezatwierdzone odchylenie strukturalne. Recenzent zmian ocenia dotkniętych odbiorców, a inżynierowie platformy prowadzą wdrożenie, powiadomienie i rollback.
Dowody muszą uczynić decyzję audytowalną:
Schemat przed i po oraz znacznik czasu wykrycia.
Wniosek o zmianę, uzasadnienie i poziom ryzyka.
Ocena wpływu i dotknięty lineage.
Zatwierdzenie, wynik wdrożenia i decyzja o rollbacku.
Instytucja finansowa mogłaby wykryć usunięte pole używane w obliczeniach regulacyjnych. Organizacja ochrony zdrowia mogłaby przechwycić zmianę typu w pomiarze klinicznym, zanim trafi do wsparcia decyzji. Instytucja publiczna może potrzebować dostosować systemy audytowe, gdy zmienia się struktura publicznego zbioru danych. W każdym przypadku mierzalnym rezultatem jest wcześniejsze wykrycie i mniej cichych awarii w raportowaniu, analityce i pipeline'ach AI.
Zamień wykrycie w proporcjonalny przegląd
Znani odbiorcy poniżej powinni otrzymać powiadomienie przed skutkiem na produkcji. Ten wymóg zależy od aktualnego lineage, więc polityka powinna sprawdzić przed zatwierdzeniem, czy mapa wpływu jest kompletna. Komitet przeglądowy może zmianę zatwierdzić, odrzucić albo odłożyć, a poziomy ryzyka zapobiegają temu, by ewolucja o niskim wpływie tworzyła ręczne wąskie gardło.
Właściciel: Właściciel zbioru danych lub domeny.
Wyzwalacz: Odchylenie strukturalne od zarejestrowanego schematu.
Dowody: Diff schematu, uzasadnienie, zatwierdzenia, mapa wpływu i zapis wdrożenia.
Eskalacja: Kieruj zmiany niezatwierdzone lub o dużym wpływie do komitetu przeglądowego i procesu incydentów.
Rezultat: Odbiorcy dostają użyteczne powiadomienie, zanim dryf strukturalny stanie się cichą awarią.
Wyjaśnienie digna na temat dryfu schematu i zmiany strukturalnej opisuje ciągłe monitorowanie strukturalne potrzebne dla tej kontroli. Schema Tracker ustala linię bazową dla dodań, usunięć i zmian typów danych, pomagając zespołom blokować lub przeglądać zmiany, zanim dotrą do odbiorców.

5. Polityka własności danych i odpowiedzialności stewardów
Własność jest kontrolą operacyjną, a nie etykietą w katalogu. Polityka przypisuje odpowiedzialność za jakość, terminowość, oczekiwania dostępowe, definicje i rozwiązywanie problemów w krytycznych zbiorach danych. Musi też pokazywać, kto może decydować, kto wykonuje pracę i jakie dowody świadczą, że odpowiedzialność jest aktywna.
Właściciel danych przyjmuje ryzyko biznesowe i zatwierdza definicje, oczekiwania jakościowe i wyjątki. Data steward przekłada te decyzje na metadane, reguły, monitorowanie i obsługę zgłoszeń. Producenci pozostają odpowiedzialni za tworzenie i dostarczanie danych. Inżynierowie platformy utrzymują kontrole techniczne, a odbiorcy zgłaszają defekty wpływające na analitykę, raportowanie i użycie AI.
Nowy krytyczny zbiór, istotna zmiana własności albo nierozwiązany problem governance uruchamiają przegląd. Właściciel potwierdza zakres i ryzyko, steward zapisuje reguły operacyjne, a dotknięte zespoły dostają ścieżkę eskalacji. Spory międzydomenowe trafiają do wyznaczonego decydenta, zamiast zostawać w nieprzypisanej kolejce.
Uczyń odpowiedzialność audytowalną
Rejestr własności powinien łączyć każdy krytyczny zbiór z właścicielem, stewardem, producentem, odbiorcami, wrażliwością, prawami decyzyjnymi i ścieżką eskalacji. Trzymaj go tam, gdzie prowadzący dochodzenia, inżynieria, analityka i biznes sięgną po ten sam zapis.
Dowody kontrolne: Zatwierdzone definicje, oczekiwania jakościowe, reguły dostępu, decyzje o wyjątkach i zmiany własności.
Dowody operacyjne: Działania stewarda, przypisane zgłoszenia, notatki naprawcze, protokoły przeglądów i aktualne wpisy rejestru.
Dowody eskalacji: Niedotrzymane zobowiązania reakcji, nierozwiązane konflikty, akceptacja ryzyka i decyzje kierownictwa.
Miara rezultatu: Każdy ważny zbiór ma odpowiedzialną osobę, która potrafi wyjaśnić jego znaczenie, dopuszczalne użycie i reakcję, gdy kontrole zawiodą.
Ta definicja data stewarda odróżnia odpowiedzialność biznesową od koordynacji operacyjnej. Spotkania stewardów, gdzie zasadne cotygodniowe lub co dwa tygodnie, mogą przeglądać incydenty, zaległe działania i powtarzalne wzorce jakościowe. Spotkanie jest użyteczne tylko wtedy, gdy uczestnicy pracują na wspólnych dowodach i zapisują decyzje, właścicieli i terminy. Ten zapis wiąże pracę governance z bardziej wiarygodnym raportowaniem, analityką i wynikami AI.
6. Polityka monitorowania metryk biznesowych i wiarygodności KPI
Wiarygodność KPI jest kontrolą operacyjną, a nie funkcją pulpitu. Chroni planowanie, raportowanie i komunikację z akcjonariuszami, wykrywając, kiedy metryka biznesowa porusza się nieoczekiwanie, i sprawdzając, czy przyczyną jest działalność biznesowa czy awaria danych.
Właściciel metryki, zwykle lider biznesowy, zatwierdza definicję, interpretację i dopuszczalne użycie każdego KPI. Analytics engineering utrzymuje obliczenia i zależności. Data steward koordynuje badanie, gdy zmieniają się dane źródłowe lub reguły biznesowe. Wyzwalaczem może być nietypowy ruch przychodów, aktywności klientów, wolumenów, ryzyka portfela, odejść, wyników leczenia albo wydajności operacyjnej.
Każdy wpis KPI powinien zawierać zatwierdzoną definicję, dane źródłowe, logikę obliczeń, właściciela, kontekst przeglądu oraz znane czynniki sezonowe lub operacyjne. Zespoły w usługach finansowych mogą monitorować przychód netto, koszt pozyskania i ryzyko portfela. Zespoły w ochronie zdrowia mogą śledzić przyjęcia, wyniki i wydajność operacyjną. Zespoły telekomunikacyjne mogą obserwować odejścia, średni przychód na użytkownika i dostępność sieci.
Alert KPI wymaga dowodów przed eskalacją. Duża zmiana może wynikać ze spóźnionego ładowania, modyfikacji schematu, zmienionego filtra, aktualizacji definicji albo prawdziwego zdarzenia biznesowego. Połącz monitorowanie z kontrolami jakości, Timeliness, anomalii i schematu opisanymi w innych miejscach programu governance.
Zacznij od 3 do 5 najbardziej krytycznych metryk biznesowych, jak przewiduje podejście wdrożeniowe. Rozszerzaj pokrycie dopiero wtedy, gdy właściciele potrafią spójnie badać i reagować. Kolejność operacyjna jest następująca:
Kontrola definicji: Potwierdź, że zatwierdzona definicja i obliczenia pozostają niezmienione.
Kontrola danych: Przejrzyj świeżość, wolumen, kompletność i dowody strukturalne.
Kontrola biznesowa: Zapisz zdarzenie lub warunek operacyjny, który wyjaśnia ruch.
Kontrola eskalacji: Ustal, czy KPI wpływa na formalny raport, decyzję biznesową lub komunikację zewnętrzną.
Właściciel zapisuje alert, przejrzane dowody, wniosek, działanie i termin. Sprawy nierozwiązane trafiają do stewarda, decydenta biznesowego lub instancji raportującej stosownie do wpływu. Mierzalnym rezultatem jest KPI, który analitycy, kierownictwo i systemy AI potrafią odtworzyć, wyjaśnić i któremu ufają.
Rozwiązanie Business Monitoring digna potrafi badać nietypowe zmiany przychodów, wolumenów, aktywności klientów i metryk operacyjnych. Comiesięczne przeglądy z kierownictwem biznesowym sprawdzają, czy alerty wciąż odzwierciedlają istotne ryzyko i czy progi wymagają korekty.
7. Polityka lineage i analizy wpływu
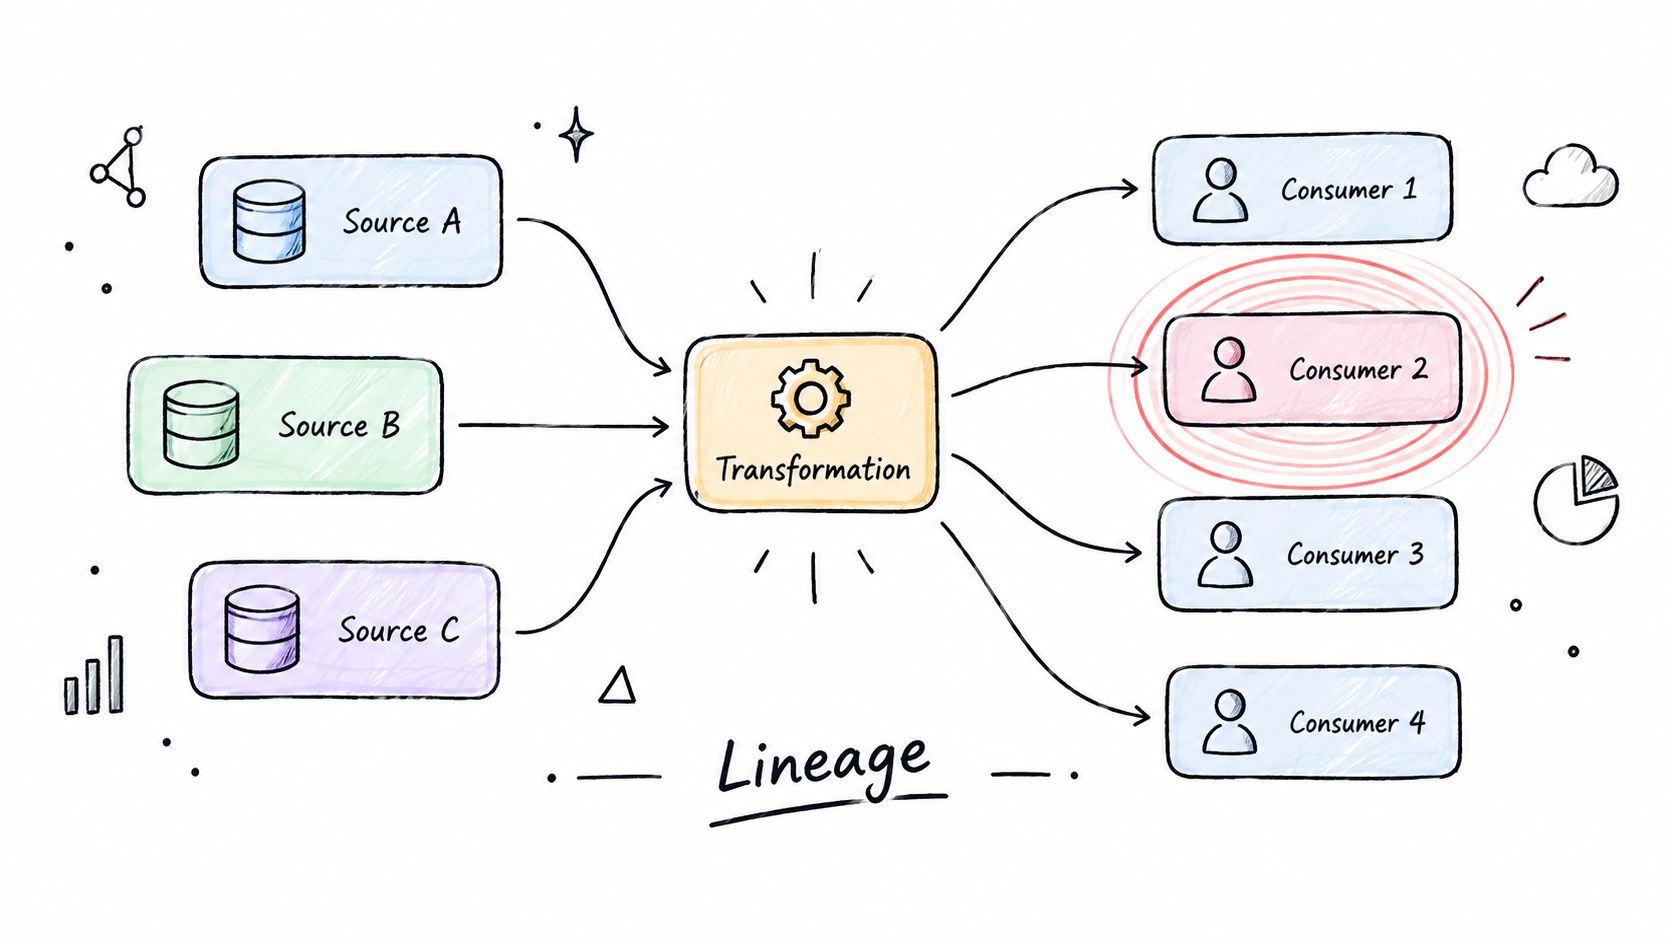
Lineage zamienia zależność danych w kontrolę operacyjną. Łączy raportowaną liczbę lub wejście modelu z jej źródłem, transformacjami, miejscami docelowymi i odbiorcami. Celem polityki jest ustalenie dotkniętego zakresu, zanim defekt, zmiana strukturalna lub ustalenie audytu wymuszą naprawę.
Właściciel danych klasyfikuje krytyczne zasoby i zatwierdza ich użycie biznesowe. Inżynierowie danych wychwytują zależności pipeline'ów i transformacji, a stewardzi weryfikują, czy relacje techniczne odzwierciedlają znaczenie biznesowe. Nowy krytyczny przepływ, istotna zmiana pipeline'u, incydent jakościowy, wdrożenie modelu albo wniosek audytowy uruchamiają kontrolę.
Dowody powinny obejmować zasoby źródłowe i docelowe, logikę transformacji, relacje zależności, wersjonowaną mapę lineage, datę przeglądu i dotkniętych odbiorców. Kolejność operacyjna jest następująca:
Zarejestruj przepływ i jego właściciela.
Wychwyć zależności techniczne i wersje transformacji.
Potwierdź definicje biznesowe i krytycznych odbiorców.
Oceń wpływ, gdy zmienia się źródło, reguła lub miejsce docelowe.
Eskaluj brakujące lub niejasne relacje do właściciela danych i architekta platformy.
Bank może wykorzystać ten zapis, by wskazać modele ryzyka dotknięte zerwanym kanałem. Organizacja ochrony zdrowia może zmapować kliniczne przepływy danych na potrzeby audytu i zgodności, a instytucja publiczna może pokazać, jak dane źródłowe docierają do systemów raportowych. Dla systemów AI lineage dostarcza dowodu, jakie wejścia model skonsumował i jak te wejścia się zmieniały.
Lineage jest kontrolą strukturalną, a nie statycznym diagramem.
Ręczne diagramy niszczeją wraz z rozwojem systemów. Automatyczne wychwytywanie z narzędzi pipeline'owych daje mocniejszą bazę operacyjną, ale steward wciąż musi sprawdzić, czy zależności są kompletne i czy odbiorcy o dużym wpływie są odwzorowani. Mierzalnym rezultatem jest szybsza, oparta na dowodach analiza wpływu, gdzie naprawę priorytetyzują dotknięte raporty, modele i decyzje, a nie ręczne poszukiwania.
digna zawiera katalog danych, który może wspierać dokumentowanie lineage i wspólne rozumienie. Wizualna ścieżka audytu może też pokazać, co i kiedy się wydarzyło, co jest wymogiem dowodowym istotnym również dla oprogramowania ścieżki audytu dla zgodności flot w Wielkiej Brytanii.
8. Polityka dostępu do danych i governance bezpieczeństwa
Governance dostępu jest kontrolą operacyjną, a nie listą uprawnień. Określa, kto może oglądać lub zmieniać każdą domenę danych, jaki cel biznesowy uzasadnia ten dostęp, jak uprawnienia są nadawane i odbierane oraz jakie dowody wspierają decyzję. Celem kontrolnym jest autoryzowane użycie danych wrażliwych i krytycznych. Restrykcyjne reguły mogą opóźnić uprawnioną analizę, a słaby przegląd zwiększa ekspozycję i utrudnia ustalenie odpowiedzialności.
Właściciel danych definiuje reguły dostępu domeny i zatwierdza wyjątki. Zespoły zarządzania tożsamością i dostępem nadają uprawnienia, zespoły bezpieczeństwa utrzymują uwierzytelnianie i logowanie, a stewardzi sprawdzają, czy dostęp wciąż odpowiada bieżącym obowiązkom. Wniosek, zmiana roli, przeniesienie, odejście, podniesienie uprawnień albo zaplanowana recertyfikacja uruchamiają przepływ.
Obronny zapis łączy wniosek z zatwierdzającym, mapowaniem ról, stanem uprawnień, znacznikami czasu nadania i odebrania, zdarzeniami dostępu, uzasadnieniem wyjątku i wynikiem przeglądu. Nierozwiązane konflikty trafiają do bezpieczeństwa i odpowiedzialnego właściciela, a dostęp zostaje zawieszony lub ograniczony tam, gdzie wymaga tego polityka.
Kontrolę kształtuje też ograniczenie celu. Wytyczne unijnego RODO stanowią, że dane osobowe należy zbierać w konkretnych, wyraźnych i prawnie uzasadnionych celach i nie wykorzystywać ponownie w sposób z nimi niezgodny. Wytyczne Komisji Europejskiej do zasad RODO Użytkownik może zatem otrzymać dostęp do określonego zadania operacyjnego bez prawa do wykorzystania tych samych danych w niezwiązanej analizie, raportowaniu czy rozwoju AI.
Wbuduj ścieżkę przeglądu we wdrożenie
Stosuj dostęp oparty na rolach powiązany z obowiązkami stanowiska, a nie z nieformalną przynależnością do zespołu. Połącz politykę z systemami tożsamości tam, gdzie to możliwe, a potem prowadź kwartalne przeglądy dostępu, by właściciele odbierali uprawnienia pozbawione udokumentowanego celu.
Właściciel: Biznesowy właściciel danych.
Wyzwalacz: Wniosek, zmiana roli, odejście, zmiana uprawnień albo przegląd kwartalny.
Dowody: Przepływ zatwierdzania, stan uprawnień, zdarzenie dostępu, odebranie i wyjątek.
Eskalacja: Zespół bezpieczeństwa i odpowiedzialny właściciel przy nierozwiązanych konfliktach.
Rezultat: Dostęp pozostaje autoryzowany, wytłumaczalny, możliwy do przeglądu i odwracalny.
Wykonanie w bazie danych przez dignę oraz opcje wdrożenia w chmurze prywatnej lub on-premises mogą wspierać kontrole, podczas gdy dane pozostają w środowisku klienta. Technologia zapisuje i egzekwuje decyzje, ale to organizacja musi ustalić, kto potrzebuje dostępu, dlaczego jest on potrzebny i kiedy powinien się skończyć.
9. Polityka reagowania na incydenty danych i eskalacji
Incydenty danych wymagają kontroli operacyjnej, a nie tylko zgłoszenia. Polityka powinna obejmować awarie jakościowe, spóźnione lub brakujące dostawy, zmiany schematu, niewiarygodne KPI i obawy dostępowe. Jej celem jest wykryć problem, ograniczyć jego wpływ na analitykę, raportowanie i przepływy AI, udokumentować decyzje i zapobiec powtórce.
Właściciel incydentu kieruje reakcją. Właściciel zbioru ocenia wpływ biznesowy i zatwierdza dopuszczalną naprawę. Inżynierowie platformy badają przyczyny techniczne, stewardzi prowadzą zapis, a dotknięci odbiorcy dostają aktualizacje. Wyzwalacze obejmują nieudaną walidację, alerty anomalii, przegapioną dostawę, nieautoryzowaną zmianę strukturalną albo niewyjaśnioną metrykę biznesową.
Dotkliwość wyznacza ścieżkę reakcji. Incydent dotykający sprawozdawczości regulacyjnej, operacji handlowych lub bezpieczeństwa pacjentów uzasadnia szybszą eskalację i wyraźniejszą komunikację niż wewnętrzny problem o niskim wpływie.
Uczyń rozwiązanie audytowalnym
Zapis powinien zachować alert, powiadomienie, badanie, przyczynę źródłową, działanie korygujące, zgodę na przywrócenie i przegląd poincydentalny. Te dowody odróżniają naprawioną awarię źródła od tymczasowej obejścia.
Wykrycie: Zarejestruj sygnał, znacznik czasu, dotknięty zbiór i początkowy zakres.
Powiadomienie: Skontaktuj się z właścicielem, stewardem, odbiorcami i dyżurnymi.
Badanie: Ustal wpływ, przyczynę, zależności i sposób ograniczenia.
Rozwiązanie: Popraw, wycofaj, odizoluj albo zakomunikuj ograniczenie danych.
Zapobieganie: Przydziel pracę następczą i sprawdź, czy kontrola faktycznie się zmieniła.
Eskalację powinien wyzwalać wpływ biznesowy, a nie sam wolumen alertów.
Właściciel zamyka incydent dopiero wtedy, gdy dowody potwierdzają przywrócone użycie albo wyraźne ograniczenie. Przeszukiwalna baza wiedzy powinna zachować przyczyny źródłowe, decyzje i wyjątki. Comiesięczne przeglądy poincydentalne mogą ujawnić powtarzalne słabości procesu lub platformy, które ukrywają pojedyncze zgłoszenia.
Alertowanie i zorientowany na użytkownika pulpit digna mogą dać inżynierom, analitykom i interesariuszom wspólny obraz incydentów i trendów. Kolejność wdrożenia to: zdefiniować kryteria dotkliwości, podłączyć sygnały wykrywania, przydzielić role reakcji, wymagać dowodów przy zamknięciu, a potem przeglądać powtarzające się przyczyny. Mierzalnym rezultatem jest historia reakcji wspierająca wiarygodne raportowanie i bezpieczniejsze użycie AI poniżej.

10. Polityka ciągłego doskonalenia i metryk data governance
Governance potrzebuje własnych metryk operacyjnych. Polityka ciągłego doskonalenia określa, jak organizacja mierzy pokrycie kontrolami, przegląda wyniki, priorytetyzuje luki i zmienia politykę, gdy przesuwają się warunki biznesowe lub regulacyjne. Zapobiega temu, by governance stało się przeglądem dokumentów oderwanym od faktycznego zachowania danych.
Rada governance ustala ramy pomiaru. Właściciele domen interpretują wyniki, stewardzi koordynują naprawę, a zespoły platformowe dostarczają dowodów wykonania. Wyzwalaczem jest zaplanowany przegląd governance, istotny incydent, nowy regulowany przepływ albo znacząca zmiana krajobrazu danych.
Użyteczne miary obejmują:
Pokrycie klasyfikacją: Udział zasobów danych z przypisaną klasyfikacją.
Pokrycie własnością: Udział krytycznych zbiorów z wskazanymi właścicielami.
Pokrycie lineage: Udział krytycznych elementów danych z udokumentowanym lineage.
Responsywność dostępu: Udział wniosków o dostęp zatwierdzonych w uzgodnionym SLA.
Ukończenie recertyfikacji: Udział kwartalnych przeglądów dostępu ukończonych na czas.
Miary te pochodzą z przewodnika wdrożeniowego, który zaleca śledzenie pokrycia operacyjnego zamiast polegania wyłącznie na dokumentach polityki. Ten sam przewodnik podaje, że średni czas zatwierdzenia dostępu spadł do 1,3 dnia z 5,2 dnia przed polityką, zaplanowane kontrole jakości osiągnęły 97 % wykonania, a zgodność retencji 88 %. Metryki wdrożeniowe dla kontroli z polityk data governance
Korzystaj z benchmarków, nie oddając osądu
Prace UNSC i Global Data Governance Mapping stworzyły ramy 26 wskaźników w sześciu atrybutach governance do porównywania wdrożeń między organizacjami i jurysdykcjami. Ramy Global Data Governance Mapping Benchmark potrafi ujawnić brakujące kontrole własności, metadanych, dostępu, lineage lub obsługi zgłoszeń, ale nie rozstrzygnie, które ryzyko liczy się najbardziej dla konkretnego biznesu.
Wybierz 5 do 7 kluczowych metryk powiązanych z wartością biznesową, przeglądaj je kwartalnie i publikuj prace usprawniające w sposób przejrzysty. Moduł Data Analytics digna może wspierać analizę historyczną metryk observability, a materiały o narzędziach do bezpiecznego, audytowalnego wdrażania AI dają trafną perspektywę na wymagania dowodowe w środowiskach mocno opartych na AI.
Porównanie 10 polityk data governance
Polityka | 🔄 Złożoność wdrożenia | ⚡ Wymagane zasoby | 📊 Oczekiwane rezultaty | Idealne zastosowania | ⭐ Kluczowe zalety |
|---|---|---|---|---|---|
Polityka standardów jakości danych i walidacji | Wysoka, rozbudowana definicja reguł i governance | Średnie–Wysokie, inżynierowie danych, eksperci dziedzinowi, narzędzia walidacyjne | Spójna przydatność danych, ścieżki audytu, mniej błędów poniżej | Branże regulowane, pipeline'y ML, raportowanie korporacyjne | Zapobiega złym danym, wymusza spójność, wspiera zgodność |
Polityka wykrywania anomalii i uczenia linii bazowej | Średnia, konfiguracja modeli i pipeline'ów monitorujących | Średnie, dane historyczne, zasoby ML i observability | Wczesne wykrycie przesunięć danych, adaptacyjne alerty, skalowalne monitorowanie | Wykrywanie oszustw, szeregi czasowe o dużym wolumenie, metryki operacyjne | Wykrywa nowe problemy automatycznie, ogranicza ręczne strojenie, łatwo się skaluje |
Polityka Timeliness i monitorowania dostaw | Średnia, definicja SLA i uczenie harmonogramów | Średnie, instrumentacja pipeline'ów, observability | Lepsza terminowość, dotrzymanie SLA, mniej opóźnień poniżej | Rozliczenia, terminy regulacyjne, pipeline'y wrażliwe na czas | Proaktywne alerty opóźnień, dowody SLA, wgląd w niezawodność pipeline'ów |
Polityka wykrywania zmian schematu i governance strukturalnego | Średnia–Wysoka, ciągłe śledzenie struktury i analiza wpływu | Średnie, mapowanie lineage, mapowanie odbiorców poniżej | Szybkie wykrycie zmian łamiących, mniej awarii poniżej | Ewoluujące schematy, platformy wielozespołowe, walidacja kontraktów | Zapobiega cichym awariom, umożliwia skoordynowane rollbacki, ścieżki audytu |
Polityka własności danych i odpowiedzialności stewardów | Średnia, definicje ról i procesy organizacyjne | Średnie, wyznaczeni stewardzi, rytm governance, pulpity | Jasna odpowiedzialność, szybsze dochodzenia, trwała własność | Duże organizacje, środowiska regulowane, rozproszone zespoły danych | Przyspiesza rozwiązywanie, porządkuje obowiązki, zachowuje wiedzę |
Polityka monitorowania metryk biznesowych i wiarygodności KPI | Średnia, definicje metryk i integracja z BI | Średnie, interesariusze biznesowi, analitycy, narzędzia BI | Wiarygodne KPI, wczesne alerty o wpływie biznesowym, pewność decyzji | Raportowanie zarządcze, metryki produktu i finansów, KPI dla inwestorów | Zapobiega złym decyzjom, wiąże metryki z przyczynami, wspiera strategię |
Polityka lineage i analizy wpływu | Wysoka, wychwytywanie i utrzymanie lineage end-to-end | Wysokie, narzędzia katalogowe, automatyzacja, nakład integracyjny | Szybka ocena promienia rażenia, krótsze dochodzenia, dowody governance | Złożone pipeline'y, audyty, zależności międzysystemowe | Umożliwia szybką analizę wpływu, skraca triage, wspiera zgodność |
Polityka dostępu do danych i governance bezpieczeństwa | Średnia, integracja RBAC i IAM | Średnie, IAM, logowanie, procesy przeglądu dostępu | Kontrolowany dostęp, logi gotowe na audyt, mniejsze ryzyko wewnętrzne | Dane wrażliwe lub regulowane (PII, PHI, finansowe) | Chroni dane wrażliwe, zapewnia audytowalność, wymusza minimum uprawnień |
Polityka reagowania na incydenty danych i eskalacji | Średnia, playbooki incydentów, SLA i dyżury | Średnie–Wysokie, zespoły dyżurne, narzędzia incydentowe, procesy postmortem | Niższe MTTD/MTTR, udokumentowana naprawa, ciągła nauka | Krytyczne usługi danych, pipeline'y sprawozdawczości regulacyjnej | Ustrukturyzowana reakcja, szybsze rozwiązanie, nauka organizacyjna |
Polityka ciągłego doskonalenia i metryk data governance | Średnia, dobór metryk i procesy dojrzałości | Średnie, analityka, przeglądy z interesariuszami, metryki historyczne | Zmierzony postęp governance, spriorytetyzowana mapa usprawnień | Organizacje dojrzewające w governance, potrzeba uzasadnienia ROI | Dostarcza dowodów wpływu, napędza ciągłą optymalizację, jednoczy interesariuszy |
Zamień tekst polityki w kontrole operacyjne
Najmocniejsze programy governance nie zaczynają od napisania każdej możliwej polityki. Zaczynają od małego zestawu zbiorów wysokiego ryzyka i uwidaczniają odpowiedzialność. To podejście adresuje też centralny problem wdrożeniowy: formalne governance pozostaje niekompletne w wielu organizacjach, więc szeroka dokumentacja potrafi stworzyć pozór dojrzałości bez dostarczenia pokrycia kontrolami.
Zacznij od wyboru zbiorów, które wspierają sprawozdawczość regulowaną, istotne decyzje finansowe, operacje kliniczne, rozliczenia klientów albo przepływy AI i analityki. Przydziel właściciela biznesowego i stewarda operacyjnego, zanim zdefiniujesz szczegółowe kontrole. Właściciel powinien rozstrzygnąć, co znaczy „przydatne do użycia”, którzy odbiorcy się liczą i jaki poziom ryzyka organizacja akceptuje. Steward powinien utrzymywać reguły, dowody, zapisy zgłoszeń i aktywność eskalacyjną.
Następnie zdefiniuj dowody jakości i dostawy. Polityka jakości powinna wytwarzać wyniki walidacji, szczegóły odrzuconych rekordów i historię napraw. Polityka Timeliness powinna pokazywać oczekiwane i faktyczne zachowanie dostaw, a nie tylko to, czy pipeline się zakończył. Te kontrole współpracują, bo udany pipeline wciąż może dostarczyć dane niekompletne lub spóźnione, a terminowe ładowanie może zawierać nieprawidłowe rekordy.
Dalej dodaj kontrole dostępu i strukturalne. Governance dostępu powinno łączyć cel, rolę, zatwierdzenie, nadanie uprawnień, ich odebranie i dowody przeglądu. Zasada minimalizacji danych z RODO wymaga, by dane osobowe były adekwatne, stosowne i ograniczone do tego, co niezbędne dla celu przetwarzania. Wytyczne brytyjskiego ICO o minimalizacji danych Ta zasada daje decyzjom o dostępie i zbieraniu praktyczną granicę. Polityki retencji również potrzebują obronnej podstawy. NIST SP 800-63B wskazuje, że dostawcy usług chmurowych muszą przestrzegać obowiązujących wymogów przechowywania zapisów, a gdy przechowywanie nie jest obowiązkowe, stosować proces zarządzania ryzykiem uwzględniający ryzyka prywatności i bezpieczeństwa oraz informować abonenta o polityce retencji. Wytyczne NIST SP 800-63B o przechowywaniu zapisów
Governance staje się wiarygodne, gdy każdy ważny wymóg wytwarza dowód, który wskazana osoba potrafi zinterpretować i na którym potrafi się oprzeć.
Powiąż incydenty ze ścieżkami eskalacji, zamiast kierować alerty do kolejki bez właściciela. Zdefiniuj dotkliwość, obowiązki dyżurne, odbiorców komunikacji, opcje ograniczania skutków, oczekiwania wobec przyczyny źródłowej i przegląd poincydentalny. Właściciel powinien móc zatwierdzić reakcję biznesową, a inżynierowie i stewardzi dostarczają potrzebnych dowodów technicznych i operacyjnych.
Na koniec regularnie przeglądaj trendy. Mierz pokrycie klasyfikacją i własnością, lineage krytycznych elementów, wyniki SLA dostępu, ukończenie recertyfikacji, wykonanie kontroli jakości, terminowość, wzorce anomalii i powtarzalność incydentów. Podejście benchmarkowe wypracowane w ramach Global Data Governance Mapping pokazuje, dlaczego ustrukturyzowane wskaźniki są do porównań użyteczniejsze niż narracyjne deklaracje dojrzałości. Zespoły governance mogą przejąć tę logikę, nie traktując zewnętrznych ram jako zamiennika własnych decyzji o ryzyku.
ISO/IEC 38505-1 ujmuje data governance jako obowiązek organu zarządzającego, by oceniać, ukierunkowywać i monitorować obchodzenie się z danymi oraz ich użycie. Uznaje też odpowiedzialność za naruszenia prywatności, ustawodawstwo o przechowywaniu zapisów i niezgodność z obowiązkowymi standardami. Odpowiedzialności data governance według ISO/IEC 38505-1 Ta perspektywa zmienia rolę technologii governance. Narzędzia potrafią wykonywać kontrole, zachowywać dowody i uwidaczniać incydenty, ale to kierownictwo pozostaje odpowiedzialne za decyzje, interpretację, wyjątki i rozliczalność.
digna może wspierać ten model operacyjny przez walidację w bazie danych, wykrywanie anomalii sterowane AI, monitorowanie Timeliness, śledzenie schematu, wspólną widoczność incydentów, katalog danych i analizę historyczną. Opcje wdrożenia w chmurze prywatnej i on-premises pozwalają platformie działać wewnątrz środowiska klienta, podczas gdy organizacja zachowuje odpowiedzialność za projekt polityk i własność kontroli.
Wdrażaj polityki po kolei, mierz, czy faktycznie działają, i zmieniaj je, gdy zmienia się biznes. Szablon to punkt wyjścia. Działający program governance to połączenie praw decyzyjnych, wykonywalnych kontroli, dowodów, ludzkiej reakcji i cyklicznego przeglądu.
digna łączy walidację na poziomie rekordu, wykrywanie anomalii, monitorowanie Timeliness, śledzenie schematu, monitorowanie biznesowe i analitykę historyczną w platformie działającej wewnątrz środowiska klienta. Odwiedź dignę, by zobaczyć, jak jej moduły pomagają zamienić polityki data governance w obserwowalne kontrole dla analityki i AI.
Polityka 4 opisuje kontrolę; wykrywanie, które za nią stoi, jest możliwością produktu. Schema Tracker porównuje każdy wdrożony schemat z zatwierdzoną linią bazową i zapisuje dodania, usunięcia, zmiany nazw i zmiany typów na bieżąco.
Najczęściej zadawane pytania
Co czyni politykę data governance operacyjną, a nie dekoracyjną?
Każda polityka nazywa cel kontrolny, właściciela, wyzwalacz, pakiet dowodów, ścieżkę eskalacji i mierzalny rezultat. Dane z badania przytoczone w artykule pokazują, że tylko 23 % organizacji stosuje formalne ramy governance, więc sama dokumentacja regularnie tworzy pozór dojrzałości bez pokrycia kontrolami.
Które polityki zespół powinien napisać najpierw?
Zacznij od małego zestawu zbiorów wysokiego ryzyka: sprawozdawczość regulowana, istotne decyzje finansowe, operacje kliniczne, rozliczenia klientów oraz przepływy AI lub analityki. Przydziel właściciela biznesowego i stewarda operacyjnego przed zdefiniowaniem szczegółowych kontroli, bo szeroka dokumentacja napisana najpierw wyprzedza kontrole, które miała egzekwować.
Czym polityka Timeliness różni się od polityki jakości?
Polityka jakości rozstrzyga, czy rekord jest przydatny do celu. Polityka dostawy zamienia „wystarczająco świeże” w uzgodnione okno, obserwowalny wyzwalacz i zdefiniowaną reakcję, gdzie producent odpowiada za wykonanie, a odbiorca definiuje okno. Pipeline może zakończyć się powodzeniem i mimo to przegapić rozliczenie na koniec dnia.
Jakie dowody powinna zachować polityka zmian schematu?
Schemat przed i po wraz ze znacznikiem czasu wykrycia, wniosek o zmianę z uzasadnieniem, poziom ryzyka, ocenę wpływu obejmującą dotknięty lineage oraz zatwierdzenie, wynik wdrożenia i decyzję o rollbacku. Wykrywanie porównuje każdą wdrożoną wersję z zarejestrowaną linią bazową prowadzoną przez wskazanego właściciela schematu.
Kto odpowiada za politykę governance na co dzień?
Dzielą to trzy role. Właściciel danych zatwierdza biznesowe znaczenie każdej reguły i przyjmuje ryzyko rezydualne, steward utrzymuje rejestr reguł, dowody i aktywność eskalacyjną, a inżynierowie wdrażają kontrole w pipeline lub bazie danych. Zapisanie tego podziału na początku jest tym, co utrzymuje politykę audytowalną.



