Przeglądarka plików Parquet: jak wybrać właściwe narzędzie
|
7
min. czyt.

Pewnie nieraz dostałeś plik .parquet na Slacku, mailem albo w buckecie w chmurze i potrzebowałeś szybkiej odpowiedzi. Jakie kolumny zawiera. Czy schemat zgadza się z wczorajszym eksportem. Czy w pliku są faktyczne wiersze, czy to tylko kolejny artefakt zepsutego Data Pipeline.
Wtedy właśnie okazuje się, że Parquet to nie format arkusza kalkulacyjnego z ładniejszym rozszerzeniem. Jest wydajny, kompaktowy i projektowany przede wszystkim z myślą o maszynach. Jeśli wybierzesz niewłaściwy sposób jego inspekcji, albo stracisz czas na walkę z narzędziami, albo stworzysz niepotrzebny problem bezpieczeństwa, przenosząc wrażliwe dane do niewłaściwego środowiska.
Spis treści
Dlaczego pliki Parquet wymagają specjalistycznych przeglądarek
Porównanie najpopularniejszych metod przeglądania plików Parquet
Dlaczego pliki Parquet wymagają specjalistycznych przeglądarek
Zwykły edytor tekstu niewiele pomoże przy pliku Parquet. Nie zobaczysz czytelnych wierszy i kolumn. Zobaczysz binarny blob z akurat taką liczbą rozpoznawalnych fragmentów, żeby zmarnować twój czas.
Tak to zaprojektowano. Apache Parquet powstał w 2013 roku jako wspólny projekt Twittera i Cloudery, pierwsze wydanie ukazało się 1 lipca 2013 roku, a później stał się projektem Apache najwyższego poziomu. Format zbudowano wokół kolumnowego przechowywania danych, row groups i metadanych opartych na Thrift, i właśnie dlatego zwykła przeglądarka tekstu nie potrafi go odczytać (tło formatu Parquet).
Co idzie nie tak w praktyce
Typowy scenariusz produkcyjny wygląda tak:
Analityk dostaje eksport pliku od dostawcy.
Data engineer musi sprawdzić, czy schemat się nie zmienił.
Zespół platformowy musi zweryfikować, czy pola zagnieżdżone zostały zakodowane tak, jak oczekują tego dalsze joby.
Ktoś próbuje otworzyć plik w edytorze tekstu albo ogólnej przeglądarce plików i nic z tego nie wychodzi.
W tym momencie przeglądarka plików Parquet przestaje być wygodnym dodatkiem i staje się podstawowym narzędziem. Jej zadaniem nie jest wyłącznie wyświetlanie wierszy. Musi przełożyć format przechowywania zoptymalizowany pod wydajną analitykę na coś, co ludzie mogą sprawdzić szybko i bezpiecznie.
Jeśli potrzebujesz szybkiego przypomnienia, czym jest sam format, to wyjaśnienie, czym jest Parquet, warto przeczytać przed wyborem przeglądarki.
Dlaczego ogólne przeglądarki plików zawodzą
Schemat porażki jest przewidywalny. Ogólne przeglądarki zakładają, że plik jest tekstem zorganizowanym w linie, prostym kontenerem binarnym albo dokumentem z rendererem. Parquet nie jest żadnym z nich.
Dobra przeglądarka rozumie między innymi:
Ekstrakcję schematu z metadanych pliku
Projekcję kolumn, dzięki której pokazuje tylko interesujące cię pola
Struktury zagnieżdżone, w tym tablice i wartości nullable
Podglądy uwzględniające sposób przechowywania zamiast udawanego „otwierania pliku”, które próbuje załadować wszystko
Praktyczna zasada: jeśli narzędzie traktuje plik Parquet jak CSV z innym rozszerzeniem, to jest złe narzędzie.
Ukryte wymaganie
Powszechnie uważa się, że przeglądarka jest potrzebna, bo Parquet nie jest czytelny dla człowieka. To prawda, ale niepełna. Głębsze wymaganie polega na tym, że inspekcja Parquet wymaga logiki rozumiejącej format.
Nie otwierasz po prostu pliku. Przepytujesz strukturę przechowywania danych. Najlepsze narzędzie zależy więc od tego, co chcesz sprawdzić: wiersze, schemat, row groups, statystyki, sposób kodowania czy metadane na poziomie pliku. Właściwa przeglądarka da ci te odpowiedzi bez wymuszania pełnego skanu i zbędnego przenoszenia danych.
Wewnętrzna struktura Parquet
Różnica między szybką a nieporadną przeglądarką plików Parquet zaczyna się od układu pliku. Bez jego zrozumienia trudno ocenić, czy narzędzie jest wydajne, czy tylko ukrywa kosztowne odczyty za interfejsem.
Parquet organizuje dane jako plik → row groups → column chunks → strony. W obrębie row group column chunks są zapisywane jeden za drugim, a strona to najmniejsza jednostka, która jest kodowana i kompresowana (układ data pages w Parquet).

Co tak naprawdę pokazuje przeglądarka
Gdy przeglądarka pokazuje row groups i column chunks, nie dodaje zaawansowanej funkcji dla power userów. Odsłania model przechowywania danych.
Ma to znaczenie na produkcji, bo podgląd tabeli może wprowadzać w błąd. Ogólny podgląd może pokazać dziesięć wierszy i sprawić, że plik wygląda banalnie, podczas gdy w rzeczywistości zawiera wiele row groups, chunki o nierównych rozmiarach, zagnieżdżone kolumny i decyzje dotyczące metadanych, które wpływają na to, jak odczytują go dalsze silniki.
Dla zespołów pracujących ze zmieniającymi się data contracts zrozumienie układu pliku pomaga też w śledzeniu ewolucji schematu. Przydatnym uzupełnieniem jest temat projektowania typów schematów i obsługi zmian, bo inspekcja plików staje się dużo prostsza, gdy zespół wie już, jakiego dryfu strukturalnego szukać.
Dlaczego footer ma znaczenie
Parquet przechowuje kluczowe metadane w footerze na końcu pliku. Czytniki zwykle przechodzą do ostatnich 8 bajtów, aby znaleźć długość footera i końcowe magic bytes PAR1, a dopiero potem parsują schemat, row groups i statystyki kolumn (przegląd formatu Apache Parquet).
Ten jeden szczegół wiele wyjaśnia, jeśli chodzi o to, dlaczego jedne przeglądarki działają natychmiast, a inne nie. Dobra przeglądarka nie zaczyna od czytania pliku od początku i ładowania wszystkiego do pamięci. Przeskakuje na koniec, parsuje metadane i dopiero wtedy decyduje, co odczytać dalej.
Przeglądarka Parquet, która zaczyna od footera, odpowie na wiele pytań o strukturę, zanim dotknie większości zbioru danych.
Pola zagnieżdżone i nullable to nie kosmetyczne detale
Wewnętrzna budowa Parquet wyjaśnia też, dlaczego zagnieżdżone kolumny bywają dziwnie wyświetlane w słabych narzędziach. Column chunk może zawierać najwyżej jedną dictionary page, a jeśli istnieje, musi być pierwszą stroną w chunku. Data pages zawierają następnie repetition levels, definition levels i zakodowane wartości, właśnie w tej kolejności (budowa column chunks w Parquet).
To nie ciekawostka. Od tego zależy, co przeglądarka musi zdekodować, aby poprawnie pokazać tablice, struktury i wartości null. Jeśli narzędzie niezgrabnie wszystko spłaszcza, często oznacza to, że ukrywa złożoność, zamiast prawidłowo obsługiwać format.
Czego szukać w przeglądarce rozumiejącej strukturę
Z przeglądarki zwykle warto korzystać, jeśli czytelnie pokazuje te elementy:
Funkcja przeglądarki | Dlaczego to ważne |
|---|---|
Przeglądarka schematu | Pomaga zweryfikować nazwy kolumn, typy i strukturę zagnieżdżoną |
Widok row groups | Pokazuje, jak dane są partycjonowane poziomo |
Szczegóły column chunks | Ujawnia granice przechowywania dla poszczególnych kolumn |
Metadane stron lub kodowania | Przydatne przy debugowaniu pól zagnieżdżonych, nullability lub problemów z kompresją |
Jeśli narzędzie oferuje tylko „podgląd wierszy”, może to wystarczyć do szybkiego sprawdzenia. Nie wystarczy jednak, gdy diagnozujesz zachowanie pipeline'u, weryfikujesz eksporty od dostawców albo próbujesz zrozumieć, dlaczego jeden silnik zapytań działa zupełnie inaczej niż drugi.
Porównanie najpopularniejszych metod przeglądania plików Parquet
Nie ma jednej najlepszej przeglądarki plików Parquet. Jest pięć popularnych podejść i każde rozwiązuje inny problem. Na produkcji błędem nie jest wybór słabego produktu. Błędem jest użycie niewłaściwej klasy narzędzia do danego zadania.
Narzędzia wiersza poleceń
Jeśli potrzebujesz szybkiej lokalnej inspekcji, narzędzia wiersza poleceń są często najprostszą opcją. Klasycznym przykładem jest parquet-tools.
Sprawdzają się, gdy chcesz wyświetlić schemat, sprawdzić metadane albo pobrać próbkę rekordów bez otwierania IDE. Dobrze pasują też do workflow w shellu i debugowania w CI.
Ceną jest wygoda użycia. Narzędzia CLI są wydajne dla inżynierów i nieprzyjazne dla wszystkich pozostałych. Utrudniają też wspólną inspekcję, chyba że wynik zostanie celowo zapisany i udostępniony.
Biblioteki Pythona
Dla data engineerów PyArrow i pandas to często najbardziej elastyczna droga. Możesz sprawdzić schemat, załadować wybrane kolumny, szybko filtrować dane i połączyć inspekcję z doraźną logiką walidacji.
Właśnie ta elastyczność sprawia, że stają się wyborem domyślnym. I właśnie dlatego łatwo ich nadużyć.
Notebook czy skrypt ma tendencję do przechodzenia od „szybkiej inspekcji” do „przypadkowego załadowania zbyt wielu danych do pamięci”. A gdy zespół uzna lokalne skrypty na wyciągach produkcyjnych za normę, granice bezpieczeństwa zaczynają się zacierać. Jeśli twój zespół już ocenia szersze praktyki inspekcji i monitoringu, warto porównać kategorie oprogramowania do data profiling równolegle z przeglądarkami plików.
Spark i silniki rozproszone
Spark nie jest przeglądarką w zwykłym sensie, ale zespoły stale używają go w tej roli. Jeśli plik znajduje się w środowisku lakehouse, a ty masz już dostęp do klastra, odczyt przez Sparka może być operacyjnie najbardziej spójną opcją.
Najlepiej sprawdza się, gdy celem jest inspekcja w ramach istniejącej platformy, a nie jednorazowe otwarcie pliku. Spark naturalnie radzi sobie z dużymi zbiorami danych i zdalnym storage'em. Kosztem jest ciężka konfiguracja, wolniejsza informacja zwrotna przy prostych zadaniach i zdecydowanie za dużo infrastruktury do podstawowych pytań typu „co jest w tym pliku”.
Jeśli potrzebujesz klastra, by odpowiedzieć na pytanie, na które narzędzie czytające footer odpowiedziałoby lokalnie, twoja ścieżka inspekcji jest zbyt ciężka.
Rozszerzenia VS Code i przeglądarki desktopowe
Przydają się inżynierom, którzy chcą wizualnego interfejsu bez wychodzenia z lokalnego workflow. Zwykle są prostsze niż narzędzia CLI i lżejsze niż uruchamianie notebooków czy sesji Sparka.
Problemem jest nierówna jakość. Niektóre rozszerzenia oferują tylko powierzchowne podglądy. Inne w ogóle nie pokazują row groups, statystyk ani szczegółów kodowania. Do prostej inspekcji to może wystarczyć. Do debugowania na produkcji często nie wystarcza.
Narzędzia desktopowe są też tylko tak bezpieczne jak stacja robocza, na której działają. Ma to znaczenie, gdy plik zawiera dane regulowane lub poufne.
Przeglądarki Parquet online
Przeglądarki online kuszą, bo eliminują problemy z konfiguracją. Otwierasz stronę, wgrywasz plik, sprawdzasz zawartość.
Tę wygodę trzeba starannie rozważyć. Niektóre zespoły mogą bezpiecznie używać ich do niewrażliwych próbek. Wiele zespołów w ogóle nie może z nich korzystać ze względów governance.
Jedna z obecnych przeglądarek opisuje lepszy model. Według opisu potrafi otwierać lokalne lub zdalne pliki Parquet, odczytywać je in place za pomocą zapytań HTTP range i pobierać tylko bajty potrzebne do bieżącego widoku, dzięki czemu wielogigabajtowe pliki otwierają się w kilka chwil, a dane pozostają na komputerze użytkownika (opis produktu Parquet Viewer). To istotna poprawa w porównaniu z naiwnymi rozwiązaniami typu „wgraj i przetwórz”.
Praktyczna tabela decyzyjna
Metoda | Najlepsza do | Co działa | Co zawodzi |
|---|---|---|---|
Narzędzia CLI | Szybkie lokalne sprawdzenia przez inżynierów | Szybka inspekcja schematu i metadanych | Słaby UX dla osób nietechnicznych |
PyArrow lub pandas | Doraźna analiza inżynierska | Elastyczne, skryptowalne, łatwe do rozbudowy | Łatwo wczytać za dużo danych lub stworzyć chaotyczne lokalne workflow |
Spark | Inspekcja natywna dla platformy na dużą skalę | Pasuje do dużych środowisk data lake | Zbyt duży narzut przy prostych sprawdzeniach |
VS Code lub przeglądarki desktopowe | Lekka inspekcja wizualna | Wygodny lokalny interfejs | Zakres funkcji bardzo się różni |
Przeglądarki online | Szybki dostęp bez konfiguracji | Wygodne do szybkiej eksploracji | Kwestie prywatności, governance i przenoszenia danych |
Najlepsze zespoły nie standaryzują jednej metody na każdą okazję. Standaryzują to, kiedy dana metoda jest dozwolona, kto z niej korzysta i jakie dane można nią sprawdzać.
Jak bezpiecznie sprawdzać pliki Parquet
Bezpieczna inspekcja zaczyna się, zanim klikniesz „otwórz”. Pierwsze pytanie nie brzmi, którą przeglądarkę lubisz. Brzmi ono: czy plik można sprawdzić bez kopiowania większej ilości danych niż to konieczne i bez przenoszenia go do niewłaściwego środowiska.
Parquet daje tu przewagę. Przeglądarka może znacząco ograniczyć I/O, korzystając z metadanych w footerze. Ponieważ Parquet przechowuje metadane na końcu pliku, w tym lokalizacje row groups i column chunks, przeglądarka może najpierw sparsować footer, a potem odczytać tylko potrzebne row groups lub kolumny zamiast skanować cały zbiór danych. Ten sam układ umożliwia selektywną inspekcję i predicate pushdown, ponieważ row groups są główną jednostką partycjonowania poziomego, a każda row group zawiera dokładnie jeden column chunk na kolumnę (zachowanie metadanych w formacie Parquet).
Zacznij od struktury, nie od wierszy
Najbezpieczniejsza kolejność wygląda tak:
Najpierw otwórz metadane. Sprawdź schemat, row groups i informacje na poziomie pliku, zanim podejrzysz rekordy.
Projektuj tylko potrzebne kolumny. Jeśli walidujesz jedno pole, nie ładuj dwudziestu.
Stosuj selektywne filtry, gdy są dostępne. Pozwól przeglądarce pominąć nieistotne grupy lub chunki.
Podglądaj małe wycinki. Próbka zwykle wystarcza, aby potwierdzić formatowanie lub obsługę wartości null.
Przechodź do pełnego odczytu tylko wtedy, gdy zadanie tego wymaga.
Brzmi oczywiście, ale wiele zespołów wciąż sprawdza pliki, ładując je w całości do notebooków. Jest to akceptowalne przy małych, niewrażliwych próbkach deweloperskich. W środowiskach współdzielonych lub regulowanych to zły nawyk.
Dopasuj metodę do środowiska
Ten sam plik wymaga innego podejścia w zależności od tego, gdzie się znajduje.
Lokalny plik deweloperski: narzędzie CLI lub lokalna przeglądarka zwykle wystarczą, jeśli zbiór danych nie jest wrażliwy, a dostęp jest kontrolowany.
Eksport w object storage: wybierz narzędzie, które potrafi sprawdzać plik zdalnie i czytać go selektywnie, zamiast wymuszać pełne pobranie.
Dane produkcyjne lub regulowane: prowadź inspekcję w zatwierdzonej infrastrukturze i ogranicz krąg osób, które mogą podglądać rzeczywiste rekordy.
Wspólny workflow debugowania: najpierw zapisz ustalenia dotyczące schematu i metadanych. Wiele incydentów da się rozwiązać bez ujawniania surowych wartości.
Duża część ochrony danych klientów polega na ograniczaniu zbędnego przenoszenia danych. To ta sama zasada, którą zespoły stosują w szerszych praktykach ochrony danych klientów.
Kontrola bezpieczeństwa: jeśli twój workflow inspekcji domyślnie wymaga pobierania surowych wyciągów produkcyjnych na prywatne komputery, problemem nie jest format pliku. Problemem jest proces.
Gdy pytanie dotyczy struktury, czytaj tylko footer
Nie każde zadanie inspekcji wymaga rekordów. Czasem wystarczy potwierdzić schemat, układ row groups, metadane klucz-wartość lub podstawowe statystyki.
Dlatego inspekcja oparta na footerze jest tak praktyczną linią podziału. Apache Doris udostępnia ten wzorzec bezpośrednio przez funkcję tabelaryczną PARQUET_META, która potrafi odczytać metadane z footera Parquet bez skanowania data pages i zwrócić schemat, statystyki row groups, metadane na poziomie pliku, metadane klucz-wartość, wyniki sprawdzania bloom filterów, a nawet metadane dotyczące wersji lub szyfrowania (dokumentacja Apache Doris PARQUET_META).
To przydatny test przy ocenie każdej przeglądarki. Jeśli funkcja bazodanowa potrafi odpowiedzieć na twoje pytanie na podstawie samych metadanych, przeglądarka plików też nie powinna potrzebować pełnego odczytu danych.
Workflow, który sprawdza się na produkcji
Gdy zespoły obchodzą się z Parquet bezpiecznie, ich proces zwykle wygląda tak:
Wstępna analiza najpierw na podstawie metadanych
Sprawdzanie wartości tylko w minimalnym niezbędnym zestawie kolumn
Unikanie eksportowania kopii pośrednich
Dokumentowanie niezgodności schematu oddzielnie od anomalii na poziomie wartości
Preferowanie inspekcji w obrębie platformy dla wrażliwych zbiorów danych
To nie jest przesadna inżynieria. To właśnie chroni przed tym, by debugowanie nie zamieniło się w przypadkowy wyciek danych.
Optymalizacja wydajności przeglądarki
Szybkość przeglądarki nie zależy wyłącznie od samej aplikacji. Często wynika z tego, jak plik Parquet został w ogóle zapisany.
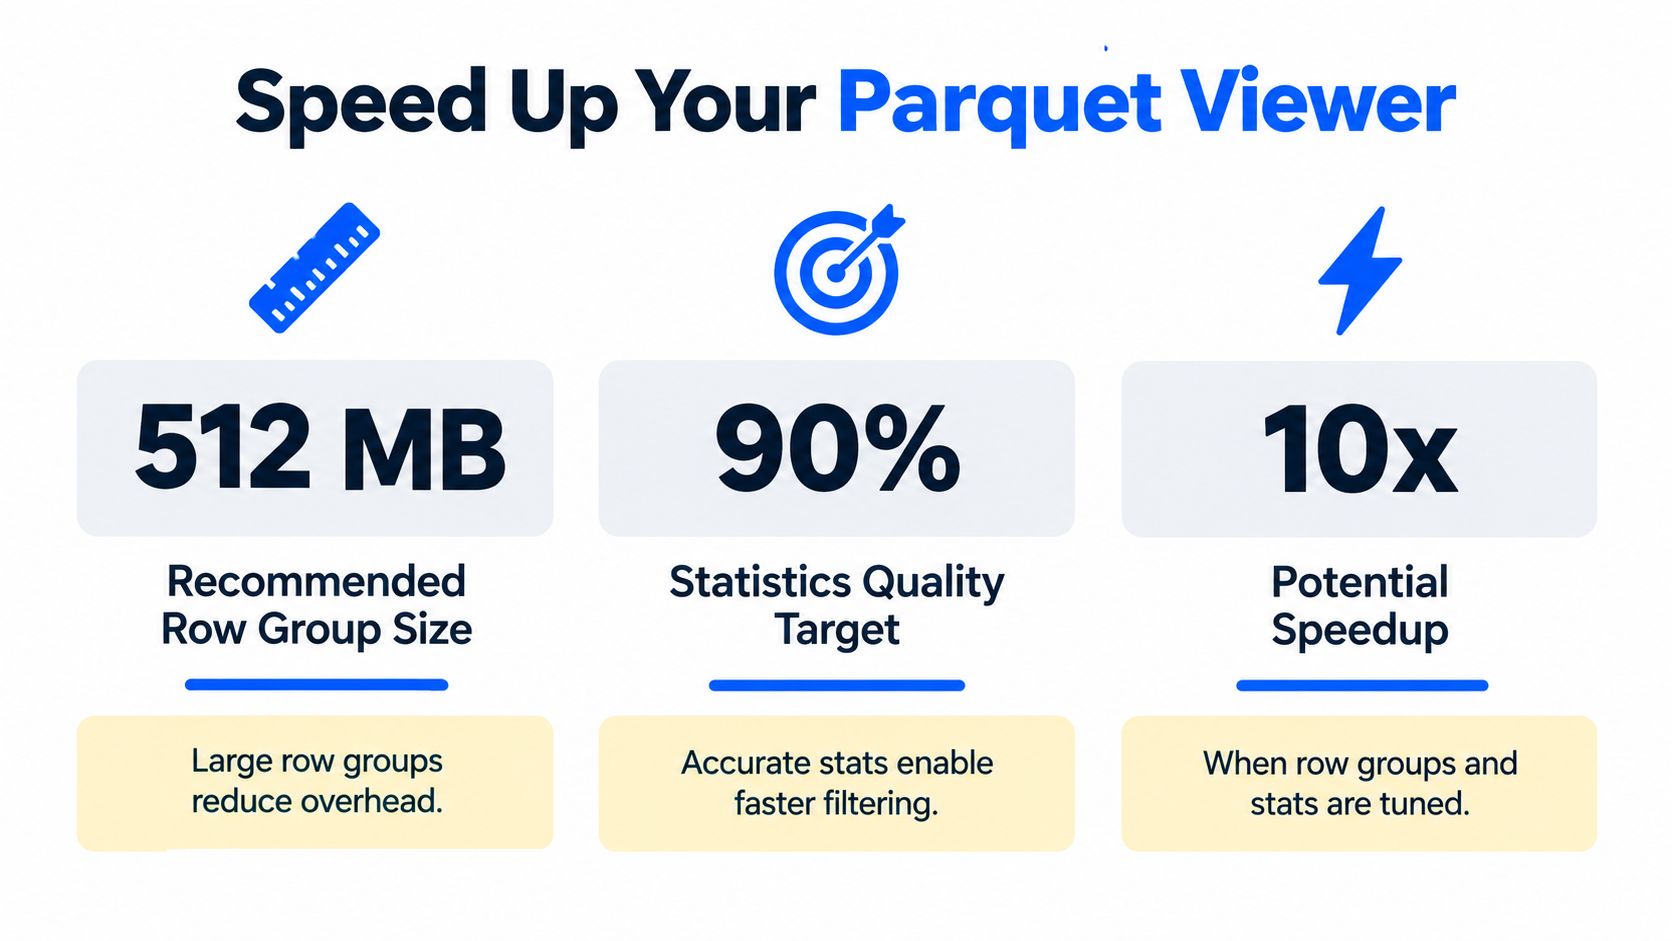
Apache Parquet zaleca duże row groups o rozmiarze około 512 MB do 1 GB dla zoptymalizowanych odczytów, ponieważ cała row group jest często minimalną jednostką, którą trzeba odczytać. Gdy row groups są za małe, rośnie narzut metadanych i spada wydajność skanowania. Większe grupy poprawiają dostęp sekwencyjny i przetwarzanie równoległe. Jednocześnie statystyki row groups, takie jak wartości min i max dla każdej kolumny, pozwalają przeglądarce lub silnikowi zapytań pomijać nieistotne chunki, co ma największe znaczenie przy szerokich tabelach i selektywnych filtrach (zalecenia konfiguracyjne Parquet).
Co naprawdę poprawia wydajność
Jeśli chcesz, aby przeglądarka plików Parquet działała responsywnie, skup się na ścieżce zapisu tak samo jak na ścieżce odczytu.
Rozmiar row groups powinien być przemyślany. Pliki z rozdrobnionymi row groups trudniej sprawdzać wydajnie.
Statystyki muszą być wiarygodne. Słabe lub brakujące statystyki obniżają wartość selektywnej inspekcji.
Szerokie schematy wymagają dyscypliny. Im więcej kolumn, tym ważniejsza staje się projekcja.
Dane zagnieżdżone wymagają starannego testowania. Przeglądarka może szybko otworzyć plik, a mimo to tracić czas na dekodowanie złożonych struktur.
Dlaczego to ważne nie tylko przy inspekcji plików
Szybka inspekcja to jeden z objawów zdrowego projektu przechowywania danych. Powolna, uciążliwa inspekcja często wskazuje na szersze problemy platformy danych: niespójne ustawienia zapisu, słabe zarządzanie schematami lub brak obserwowalności procesu generowania plików.
Dlatego traktuję przeglądanie plików Parquet jako coś więcej niż wygodną funkcję. To często pierwsze miejsce, w którym inżynierowie zauważają, że pliki są tworzone w sposób szkodzący także wydajności zapytań w dalszych etapach. Te same nawyki, które pomagają człowiekowi sprawnie sprawdzać dane, pomagają też silnikom wydajnie je skanować. Należą do nich rozsądne rozmiary plików, dobre statystyki i przejrzyste schematy.
Jeśli twoje obciążenia SQL również mają problemy, zasady optymalizacji zapytań często pokrywają się z tym, co odkryjesz podczas inspekcji plików Parquet.
Bezpieczeństwo w przedsiębiorstwie i alternatywy in-place
W środowiskach regulowanych głównym problemem zwykle nie jest to, czy przeglądarka plików Parquet jest wygodna. Chodzi o to, czy jej użycie wymaga przenoszenia danych poza zatwierdzone granice.
Tu zespoły muszą być rygorystyczne. W finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym często nie można pozwolić analitykom ani inżynierom na wgrywanie wrażliwych wyciągów do zewnętrznych usług ani na rozpraszanie lokalnych kopii po laptopach. Nawet jeśli sama przeglądarka jest dobra, workflow może naruszać wymagania governance.
Model in-place jest bezpieczniejszy, bo utrzymuje inspekcję i monitoring we własnym środowisku klienta. W praktyce oznacza to, że zespoły sprawdzają strukturę, walidują rekordy i monitorują zmiany schematu bez eksportowania danych do systemów zewnętrznych. Oznacza to również, że obliczenia powinny odbywać się blisko danych, najlepiej w samej bazie danych, aby uniknąć zbędnego przenoszenia danych tylko po to, by odpowiedzieć na pytania operacyjne.
W codziennej pracy inżynierskiej zmienia to cel. Zamiast pytać „Która przeglądarka powinna otworzyć ten plik?”, zespoły zaczynają pytać „Czy możemy odpowiedzieć na to pytanie w ogóle bez przenoszenia pliku?”. To lepsze domyślne podejście w operacjach korporacyjnych.
Jeśli twój zespół potrzebuje takiego podejścia in-place, digna oferuje korporacyjną platformę do jakości danych i Data Observability, która działa w twoim własnym środowisku. Pomaga zespołom śledzić zmiany schematu, walidować rekordy, monitorować zachowanie danych i prowadzić analizę blisko danych, co jest właśnie bezpieczniejszym wzorcem, gdy inspekcja plików Parquet dotyczy wrażliwych danych produkcyjnych.
Ręczne otwarcie footera odpowiada na pytanie, czy schemat zmienił się w jednym pliku; aby automatycznie wychwytywać dodane, usunięte lub zmienione typem kolumny we wszystkich tabelach, Schema Tracker od digna monitoruje zmiany strukturalne w twoim własnym środowisku, więc dane nigdy nie muszą go opuszczać.
Najczęściej zadawane pytania
Jak otworzyć plik Parquet?
Użyj narzędzia rozumiejącego format, a nie edytora tekstu, ponieważ Parquet to binarny format kolumnowy z metadanymi opartymi na Thrift. Do wyboru są parquet-tools w wierszu poleceń, PyArrow lub pandas w Pythonie, Spark, rozszerzenia VS Code i przeglądarki online, z których każda pasuje do innego zadania inspekcji i poziomu wrażliwości danych.
Dlaczego nie mogę otworzyć pliku Parquet w edytorze tekstu?
Edytor tekstu pokazuje tylko binarny blob, ponieważ Parquet przechowuje dane jako row groups, column chunks i skompresowane strony, a schemat znajduje się w footerze na końcu pliku. Aby go odczytać, trzeba sparsować ten footer, zlokalizowany na podstawie ostatnich 8 bajtów i końcowych magic bytes PAR1.
Czy korzystanie z przeglądarki Parquet online jest bezpieczne?
To zależy od danych. Przeglądarki typu „wgraj i przetwórz” mogą być akceptowalne dla niewrażliwych próbek, ale wiele zespołów z finansów, ochrony zdrowia, telekomunikacji i sektora publicznego nie może z nich korzystać ze względów governance. Bezpieczniejsze są przeglądarki, które czytają pliki in place za pomocą zapytań HTTP range i trzymają dane lokalnie.
Czy mogę sprawdzić schemat Parquet bez odczytywania danych?
Tak, ponieważ schemat, lokalizacje row groups i statystyki kolumn znajdują się w footerze pliku. Narzędzia czytające footer najpierw parsują te metadane, a Apache Doris oferuje funkcję tabelaryczną PARQUET_META, która zwraca schemat, statystyki row groups i metadane klucz-wartość bez skanowania jakichkolwiek data pages.
Dlaczego moja przeglądarka Parquet działa wolno przy dużych plikach?
Powolność często wynika ze sposobu zapisu pliku, a nie z samej przeglądarki. Apache Parquet zaleca row groups o rozmiarze około 512 MB do 1 GB, ponieważ cała row group jest często minimalną jednostką odczytu. Rozdrobnione row groups, brakujące statystyki i bardzo szerokie schematy spowalniają inspekcję.



