Optymalizacja zapytań T-SQL: Praktyczny przewodnik po wydajności
|
7
min. czyt.

Powolne zapytanie SQL Server zazwyczaj nie pojawia się z jasnym wyjaśnieniem. Trafia na produkcję jako panel, w którym upływa limit czasu, procedura składowana, która wcześniej działała poprawnie, lub raport, który kończy się niepowodzeniem tylko wtedy, gdy trafi na odpowiedniego klienta lub zakres dat. Dlatego tsql query optimization działa najlepiej, gdy zaczyna się od dowodów, a nie od przepisywania kodu.
Spis treści
Odczytywanie planów wykonania i zrozumienie zachowania optymalizatora
Przepisywanie zapytań z użyciem wzorców zbiorowych i wczesnego filtrowania
Rozwiązywanie problemów z parameter sniffing i wymuszaniem planów
Radzenie sobie z presją pamięci i ograniczeniami zasobów platformy
Wdrażanie ciągłego monitorowania z Observability wewnątrz bazy danych
Rozpoczęcie od diagnostyki przed przepisaniem czegokolwiek
Najszybszym sposobem na stratę czasu jest zmiana SQL przed dowiedzeniem się, co działa wolno. Na produkcji zapytanie może wyglądać na problematyczne, podczas gdy rzeczywistą przyczyną jest rywalizacja o współdzielone zasoby, nieaktualne statystyki lub zły plan zapisany w pamięci podręcznej dla innej wartości parametru. Dyscyplinowane podejście do dostrajania zaczyna się od zarejestrowania dokładnego obciążenia, w tym rzeczywistych parametrów, oraz zmierzenia zapytania przed wprowadzeniem jakichkolwiek zmian.
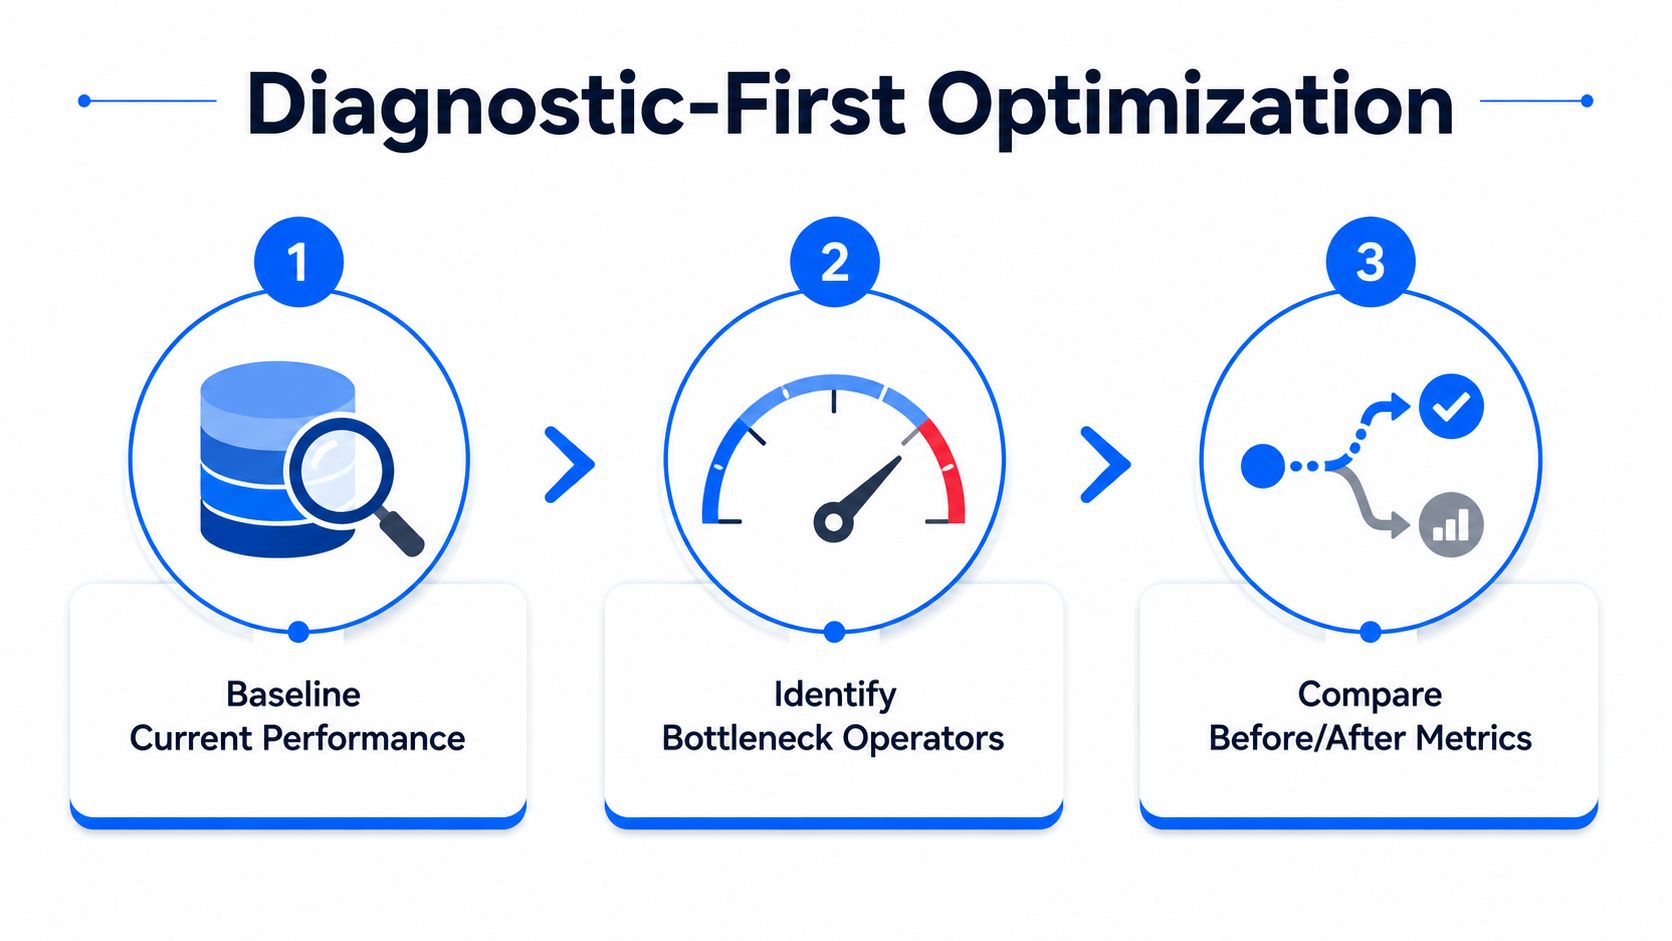
Najpierw linia bazowa, potem modyfikacja SQL
Linia bazowa nie jest opcjonalna. Praktyczna pętla strojenia zaczyna się od czasu wykonania, odczytów logicznych i procesora, a następnie rejestruje plan oraz otaczające obciążenie, dzięki czemu można stwierdzić, czy zmiana pomogła, czy tylko przeniosła koszt w inne miejsce. Jest to przepływ pracy zalecany w przewodnikach po dostrajaniu SQL Server, ponieważ pozwala zachować widoczność przyczyn i skutków (tuning workflow guidance).
Zasada praktyczna: jeśli nie potrafisz wyjaśnić wąskiego gardła operatora przed przepisaniem kodu, prawdopodobnie nie rozumiesz jeszcze problemu.
Jest to szczególnie prawdziwe, gdy objawem jest wolny czas reakcji, ale przyczyna leży poza tekstem instrukcji. Analiza oczekiwań na poziomie serwera, korelacja kolejek, a następnie inspekcja na poziomie bazy danych lub zapytania to sekwencja, która pozwala uniknąć pogoni za niewłaściwą rzeczą, ponieważ obciążenie może być blokowane przez operacje we/wy, pamięć lub współbieżność, zanim w ogóle dotrze do kandydata do przepisania (instance-to-query tuning sequence).
Wprowadzaj jedną zmianę na raz
Strojenie oparte na jednej zmiennej na raz brzmi powoli, ale to jedyny sposób, aby zaufać wynikom. Jeśli w tym samym podejściu zmienisz tekst zapytania, indeks i zaktualizujesz statystyki, nie będziesz wiedzieć, który element miał znaczenie. Co gorsza, przepisanie kodu może poprawić odczyty logiczne, jednocześnie zwiększając zużycie procesora lub sprawiając, że plan będzie bardziej niestabilny przy innym zestawie parametrów.
Dobry przepływ pracy wygląda następująco:
Przechwyć dokładny tekst zapytania i parametry. Ta sama procedura składowana może zachowywać się bardzo różnie przy różnych danych wejściowych.
Znajdź operator będący wąskim gardłem. Sortowanie, skanowanie i wyszukiwanie kluczy (key lookups) to miejsca, w których najczęściej kumulują się koszty.
Zastosuj jedną ukierunkowaną zmianę. Następnie uruchom ponownie to samo obciążenie w tych samych warunkach.
Porównaj z linią bazową. Ponownie sprawdź odczyty, procesor i upływający czas przed przejściem dalej.
Ta metoda brzmi prosto, ponieważ taka jest. Trudnością jest powstrzymanie pokusy „naprawiania” wszystkiego na raz. Jeśli zapytanie naprawdę cierpi z powodu rywalizacji o współdzielone zasoby, pierwsza skuteczna poprawka może znajdować się poza samym zapytaniem, dlatego doświadczeni administratorzy baz danych nie traktują tekstu SQL jako jedynego miejsca, w którym należy szukać przyczyny.
Odczytywanie planów wykonania i zrozumienie zachowania optymalizatora
Złe zapytanie często wygląda dobrze w edytorze tekstu, a mimo to przestaje działać w czasie rzeczywistym. SQL Server nie wykonuje instrukcji w kolejności, w jakiej zostały napisane. Optymalizator opiera się na kosztach i jest napędzany statystykami, więc ocenia możliwe plany, szacuje liczbę wierszy i wybiera ścieżkę, która jego zdaniem będzie kosztować najmniej (cost-based optimizer overview). W tsql query optimization sprawia to, że odczytywanie planu staje się pierwszą kluczową umiejętnością diagnostyczną, a nie tylko dodatkiem na koniec.
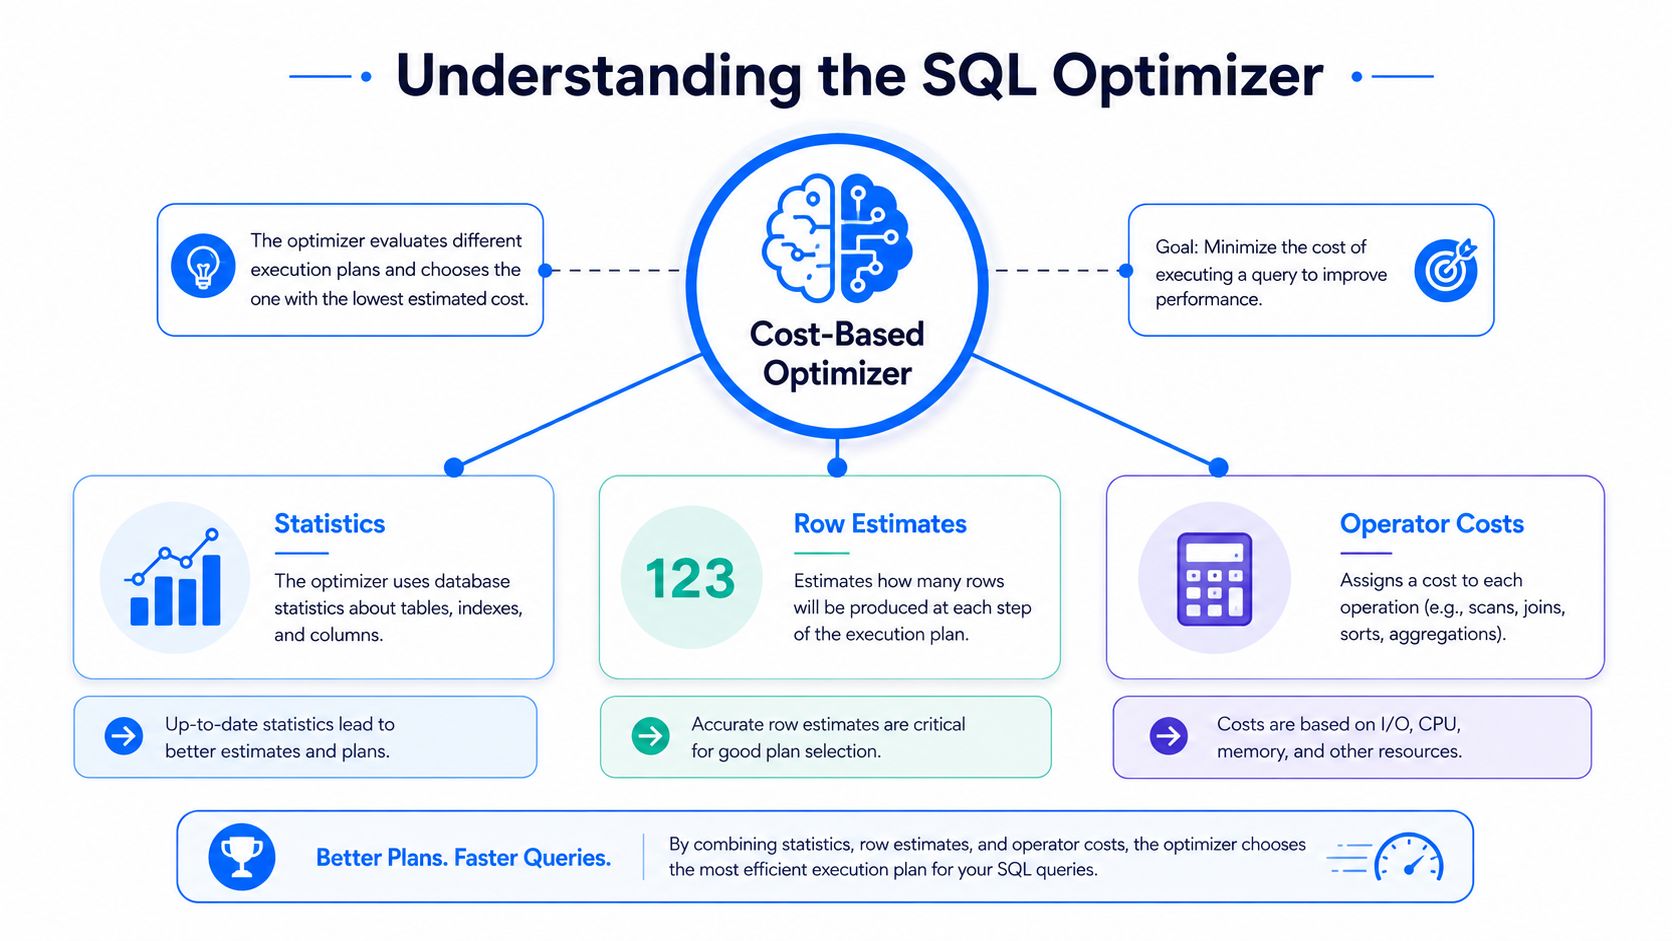
Odczytuj plan od dołu do góry
Zacznij od dołu, a nie od góry. Operatory najniższego poziomu pokazują, gdzie wiersze wchodzą do planu, a najkosztowniejszy operator liścia, często ten o najwyższym koszcie iloczynu pętli i czasu, zazwyczaj wskazuje pierwsze miejsce, w którym plan idzie nie tak. Jeśli skanowanie zasila złączenie, a następnie sortowanie, skanowanie jest często głównym problemem, nawet gdy sortowanie dominuje w łącznym czasie.
Ten nawyk odczytywania staje się bardziej przydatny, gdy połączysz go z danymi wejściowymi optymalizatora. DBCC SHOW_STATISTICS ujawnia statystyki, których SQL Server używa dla tabeli lub widoku indeksowanego, w tym STAT_HEADER, DENSITY_VECTOR oraz HISTOGRAM (Microsoft documentation). Te obiekty mają znaczenie, ponieważ optymalizator dokonuje oszacowania kardynalności przed ustaleniem planu. Informacje o gęstości są szczególnie przydatne przy filtrach wielokolumnowych na tej samej tabeli, gdzie prosta intuicja dotycząca liczby wierszy często zawodzi.
Jeśli plan wygląda podejrzanie, porównuję go z praktyczną listą kontrolną dostrajania, taką jak how to optimize SQL queries with execution plan analysis. Taki krok pozwala utrzymać analizę w oparciu o rzeczywiste operatory, a nie tylko domysły dotyczące tekstu zapytania.
Szacowana liczba wierszy a rzeczywista liczba wierszy
Pierwszą rzeczą, którą sprawdzam w złym planie, jest rozbieżność między szacowaną a rzeczywistą liczbą wierszy. Gdy te liczby drastycznie się różnią, optymalizator działa na zniekształconym obrazie, a reszta planu jest zazwyczaj budowana na tym błędzie. Artykuł z VLDB 2025 wykazał, że błędy szacowania kardynalności są powszechne i często stanowią dominujący czynnik stojący za słabymi planami (VLDB 2025 paper), co pokrywa się z sytuacją na produkcji, gdy skośne rozkłady lub skorelowane predykaty kierują silnik w stronę niewłaściwego złączenia lub metody dostępu.
Jeśli optymalizator sądzi, że nadejdzie 10 wierszy, a faktycznie dociera 10 000, plan nie jest nieco niedokładny – rozwiązuje zupełnie niewłaściwy problem.
Z tego powodu nieaktualne statystyki zasługują na wczesną uwagę. Świeże statystyki nie gwarantują idealnego planu, ale nieaktualne znacznie zwiększają prawdopodobieństwo błędnego oszacowania. W przypadku tabel zoptymalizowanych pod kątem pamięci firma Microsoft zauważa, że optymalizator nadal utrzymuje statystyki kolumn klucza indeksu i może w razie potrzeby tworzyć dodatkowe statystyki dla kolumn niebędących kluczami, więc te obciążenia nadal zależą od tego samego obrazu kardynalności.
Przepisywanie zapytań z użyciem wzorców zbiorowych i wczesnego filtrowania
Gdy wąskie gardło jest rzeczywiste i widoczne, przepisz SQL w konkretnym, wąskim celu. Zmiany o najwyższej wartości to zazwyczaj te, które zmniejszają ilość danych przetwarzanych przez silnik, a nie te, które sprawiają, że zapytanie wygląda na sprytne. Wczesne filtrowanie, wybieranie mniejszej liczby kolumn i utrzymywanie predykatów w postaci sargable – wszystko to pomaga optymalizatorowi efektywniej korzystać z indeksów oraz obniża presję na we/wy i pamięć (optimization techniques guide).
Spraw, aby silnik przetwarzał mniej danych
Najprostsze sukcesy to często te, które zespoły pomijają, ponieważ wydają się zbyt banalne. Unikaj SELECT *, gdy zapytanie nie potrzebuje każdej kolumny, ponieważ dodatkowe pobierane kolumny poszerzają wiersze i zwiększają operacje we/wy. Umieszczaj selektywne filtry w klauzuli WHERE przed złączeniami, jeśli to możliwe, ponieważ zmniejsza to wolumen danych przenoszonych przez silnik w dalszej części planu.
Kilka wzorców ma stałe znaczenie:
Używaj predykatów typu sargable. Jeśli predykat nie może być efektywnie dopasowany do indeksu, optymalizator ma mniejsze pole manewru.
Preferuj
UNION ALL, gdy nie trzeba usuwać duplikatów.UNIONdodaje pracę związaną z sortowaniem lub deduplikacją.Uprość podzapytania, które tylko reformułują dane. Zagnieżdżona logika, która nie zmniejsza liczby wierszy, często dodaje narzut bez pomocy w optymalizacji planu.
Dopasuj indeksy do rzeczywistych filtrów. Ukierunkowany indeks pomaga, gdy pokrywa się ze ścieżką dostępu używaną przez zapytanie.
Dobre przepisanie kodu zmniejsza nakład pracy, który optymalizator musi rozważyć, a nie tylko liczbę linii SQL, które trzeba przeczytać.
Używaj celów wierszy (row goals) i wskazówek z umiarem
Microsoft dokumentuje wskazówki zapytania (query hints), które mogą zmieniać zachowanie wykonania, w tym zachowanie celów wierszy (row goal), gdzie po zwróceniu pierwszej określonej liczby wierszy zapytanie działa dalej, aby wygenerować pełny zestaw wyników (query hints documentation). Może to być przydatne, gdy szybkie uzyskanie początkowych wyników jest ważniejsze niż całkowita przepustowość, ale zmienia to kompromisy optymalizatora. Plan, który jest świetny dla małego zestawu wyników, może być złym wyborem dla dużego.
Dlatego traktuję wskazówki jako korektę ostatniej szansy, a nie pierwszą reakcję. Jeśli po wczesnym filtrowaniu i uporządkowaniu operacji zbiorowych zapytanie nadal działa wolno, kolejnym pytaniem jest zazwyczaj to, czy ścieżka dostępu nie kłóci się ze strukturą danych lub stojącymi za nią statystykami.
Index Design i i strategie utrzymania statystyk
Indeksy to nie magiczne przełączniki wydajności. Są to dane wejściowe do modelu kosztowego optymalizatora i pomagają tylko wtedy, gdy pasują do wzorca zapytania i rozkładu danych. Jeśli ścieżka dostępu nie odpowiada sposobowi, w jaki zapytanie filtruje, łączy lub wybiera kolumny, silnik wciąż może wybrać skanowanie, plan obciążony wyszukiwaniami lub sortowanie z zapisem na dysku (spill).
Design pod kątem zapytań, które faktycznie uruchamiasz
Najlepszy indeks w teorii i najlepszy indeks na produkcji rzadko są tym samym. W praktyce potrzebujesz indeksów pasujących do najkosztowniejszych i powtarzalnych wzorców dostępu, zwłaszcza filtrów pojawiających się w najwolniejszych zapytaniach. Indeks pokrywający (covering index) może wyeliminować wyszukiwanie klucza (key lookups), gdy zapytanie potrzebuje małego, stabilnego zestawu kolumn, ale może również zwiększyć narzut przy zapisie i koszty przechowywania, więc projekt wymaga analizy rzeczywistego obciążenia, a nie domysłów.
Model statystyk firmy Microsoft ma tutaj kluczowe znaczenie, ponieważ optymalizator szacuje kardynalność na podstawie tych obiektów przed wyborem planu (DBCC SHOW_STATISTICS). Jeśli statystyki są nieaktualne, nawet dobrze zbudowany indeks może zostać zignorowany lub błędnie użyty. Dlatego dobre projektowanie indeksów i właściwa konserwacja statystyk idą w parze.
Utrzymuj statystyki na tyle świeże, aby móc im zaufać
Konserwacja statystyk to nie zwykłe porządki, to element dbania o jakość planów. Gdy rozkłady wierszy się zmieniają, optymalizator może nadal widzieć tabelę taką, jaka była wczoraj lub w zeszłym miesiącu, a ten nieaktualny obraz może prowadzić do złych decyzji o złączeniach, słabych metod dostępu i nieoczekiwanego zużycia pamięci. W przypadku tabel zoptymalizowanych pod kątem pamięci Microsoft wciąż utrzymuje statystyki kolumn klucza indeksu i może dodawać kolejne dla innych kolumn w razie potrzeby, co pokazuje, jak kluczowe pozostają statystyki niezależnie od modelu przechowywania.
Praktyczne podejście do konserwacji jest proste:
Aktualizuj statystyki przy regresji planów. Nie czekaj, aż problem stanie się systemowy.
Zwracaj uwagę na powtarzające się wzorce wyszukiwania kluczy (key lookup). Często wskazują one miejsca, w których pomógłby indeks pokrywający.
Przebudowuj i reorganizuj indeksy z konkretnego powodu. Konserwacja powinna wspierać rzeczywiste obciążenie, a nie odbywać się na autopilocie.
Regularnie analizuj użycie indeksów. Indeks, który wydawał się sprytny sześć miesięcy temu, dziś może być tylko zbędnym obciążeniem.
Sugestie dotyczące brakujących indeksów mogą pomóc zauważyć oczywiste luki, ale same w sobie nie stanowią strategii projektowej. Traktuję je jako wskazówki, a następnie porównuję z obciążeniem pracą i kosztem utrzymania. Optymalizator może wybierać tylko z form, które mu udostępnisz, a nieaktualne statystyki mogą sprawić, że nawet dobra forma będzie wyglądać źle.
Rozwiązywanie problemów z parameter sniffing i wymuszaniem planów
Niektóre z najgorszych niespodzianek na produkcji wcale nie dotyczą tekstu zapytania. Zdarzają się, ponieważ ta sama procedura składowana otrzymuje bardzo różne plany w zależności od pierwszej wartości parametru, którą zobaczy optymalizator, a następnie ten plan jest używany przy kolejnych wywołaniach, które nie pasują do pierwotnego kształtu. Dlatego zachowanie planów wrażliwych na parametry powinno znajdować się na samej górze każdego poważnego przewodnika po tsql query optimization.
Gdy problemem jest plan w pamięci podręcznej
Wskazówki Microsoft dotyczące Azure SQL jednoznacznie wskazują RECOMPILE, OPTIMIZE FOR, OPTIMIZE FOR UNKNOWN, wymuszanie planów oraz dzielenie procedur jako ukierunkowane środki zaradcze, gdy jedno zapytanie działa dobrze dla niektórych wartości parametrów, a fatalnie dla innych (Microsoft training guidance). Ma to znaczenie, ponieważ sam tekst zapytania może być poprawny, ale plan z pamięci podręcznej może być niewłaściwy dla aktualnego obciążenia.
Praktyczny objaw jest dobrze znany. Procedura działa błyskawicznie dla jednego klienta, dramatycznie wolno dla innego, i waha się tam i z powrotem po czyszczeniu pamięci podręcznej lub restartach. W takim przypadku problem optymalizacyjny dotyczy kontrolowania zmienności planu, a nie przepisywania czytelnego zapytania na coś trudnego w utrzymaniu.
Wybierz rozwiązanie pasujące do trybu awarii
RECOMPILE jest przydatne, gdy zapytanie wymaga planu dostosowanego do bieżących parametrów, a narzut z tym związany jest akceptowalny. OPTIMIZE FOR sprawdza się lepiej, gdy znasz reprezentatywną wartość i chcesz ukierunkować plan pod jej kątem. OPTIMIZE FOR UNKNOWN może być bezpieczniejszą drogą środka, gdy żadna pojedyncza wartość parametru nie odzwierciedla dobrze całego obciążenia. Wymuszanie planu pomaga, gdy zidentyfikowano już kształt planu, który zachowuje się stabilnie.
Właściwym rozwiązaniem dla parameter sniffing nie zawsze jest lepszy indeks. Czasami jest to bardziej racjonalny wybór planu.
Nowsze mechanizmy kontroli operacyjnej również mają znaczenie. Nowoczesne wskazówki firmy Microsoft obejmują DISABLE_RESULT_SET_CACHE, co pokazuje, że dostrajanie zapytań musi teraz uwzględniać zachowanie pamięci podręcznej, a nie tylko indeksowanie i przepisywanie kodu. To przydatne przypomnienie, że niestabilna wydajność często wynika z interakcji między danymi, pamięcią podręczną a wartościami parametrów, a nie tylko z samego kodu SQL.
Radzenie sobie z presją pamięci i ograniczeniami zasobów platformy
Zapytanie może być świetnie napisane, poprawnie zaindeksowane, a mimo to działać wolno. Gdy tak się dzieje, wąskim gardłem często okazuje się presja na pamięć, zapisywanie danych tymczasowych na dysk (spill) lub szersze limity platformy, a nie sam tekst zapytania. Wiele poradników pomija tę rzeczywistość, mimo że często to właśnie z tego powodu „naprawione” zapytanie nadal rozczarowuje.
Oddziel koszt lokalnego zapytania od presji na współdzielone zasoby
Zacznij od analizy oczekiwań (wait analysis) i monitorowania zasobów, zanim obwinisz pojedyncze polecenie. Zapytanie, które zapisuje na dysk, rywalizuje o przydziały pamięci lub powoduje spowolnienia w tempdb, może wyglądać jak zły kandydat do przepisywania, podczas gdy głębszym problemem jest przeciążenie systemu. Wskazówki firmy Microsoft dotyczące przetwarzania zapytań i observability w Azure SQL odsyłają do narzędzi takich jak monitorowanie zasobów, Database Watcher, Query Performance Insights oraz metryki pojemności Fabric, aby sprawdzić, czy obciążenie nie jest ograniczane przez samą platformę (platform observability guidance).
Jeśli cała instancja jest przeciążona, lokalne przepisanie SQL może wydawać się nieskuteczne, nawet jeśli robi dokładnie to, co powinno.
Właśnie dlatego typy oczekiwań (wait types) mają znaczenie. Pokazują, czy wąskim gardłem jest nasycenie procesora, opóźnienia we/wy, blokady współbieżności, czy coś zupełnie innego. Zapytanie, które zmniejsza liczbę odczytów logicznych, ale wciąż zapisuje dane na dysk, może poprawić jeden wskaźnik, pozostawiając wrażenia użytkownika niemal bez zmian.
Przejdź do planowania pojemności, gdy wymaga tego obciążenie pracą
W pewnym momencie dostrajanie zapytań przestaje być odpowiednim narzędziem. Jeśli obciążenie stale zderza się z limitami pamięci, pamięci masowej lub współbieżności, rozwiązaniem może być planowanie pojemności, izolacja obciążeń lub przeprojektowanie platformy, a nie kolejne przepisanie kodu. Na tym polega praktyczna różnica między rozwiązywaniem problemu na poziomie pojedynczej instrukcji a rozwiązywaniem go na poziomie całego systemu.
Dla zespołów pracujących w środowiskach zarządzanych to rozróżnienie ma jeszcze większe znaczenie, ponieważ platforma może ukrywać część obciążeń, dopóki system nie zacznie działać niestabilnie. Jeśli Twoje poprawki stale obniżają koszt zapytania, ale użytkownicy nadal odczuwają spowolnienie, kolejnym pytaniem nie jest to, który fragment SQL zmodyfikować, ale jaki współdzielony zasób jest wciąż przeciążony. W tym miejscu pomaga również podejście oparte na inżynierii niezawodności baz danych, ponieważ łączy zachowanie zapytań z powtarzalnymi kontrolami operacyjnymi i zapobiega traktowaniu regresji związanych z pamięcią jako jednorazowych niespodzianek. Zobacz database reliability engineering practices, aby poznać szerszy model operacyjny stojący za tego typu pracą.
Wdrażanie ciągłego monitorowania z Observability wewnątrz bazy danych
Jednorazowe dostrajanie jest przydatne, ale nie powstrzyma kolejnej regresji. Dane rosną, ich rozkłady się zmieniają, obciążenia ulegają przesunięciom, a plan, który działał w zeszłym kwartale, może zestarzeć się bez ostrzeżenia. Dlatego ciągłe monitorowanie to jedyny rozsądny sposób na to, aby wydajność zapytań nie stała się stale powtarzającą się akcją ratunkową.
Obserwuj odchylenia, zanim zrobią to użytkownicy
Kluczową zmianą jest przejście od reakcji do wykrywania. Platformy observability działające wewnątrz bazy danych mogą monitorować metryki wydajności zapytań, zmiany we wzorcach wykonania i sygnały o opóźnieniach bez przenoszenia danych poza środowisko, co ma znaczenie, gdy zasady bezpieczeństwa lub governance sprawiają, że przenoszenie danych jest kosztowne lub niepożądane. Przykładem takiego modelu jest Data Platform Observability od firmy digna, z monitorowaniem, które pozostaje wewnątrz środowiska klienta i śledzi kondycję obciążeń, wzorce zużycia oraz metryki wydajności w całym środowisku danych (digna data observability).
Tego rodzaju monitorowanie oparte na linii bazowej jest niezwykle cenne, ponieważ wykrywa nietypowe zachowanie, zanim panel przestanie działać lub zostanie naruszone umowne SLA. Celem nie jest zastąpienie dostrajania, ale sprawienie, by było ono proaktywne, a nie reaktywne.
Użyj observability, aby zamknąć pętlę
Ciągłe monitorowanie sprawia, że wcześniejszy przepływ diagnostyczny staje się stałym elementem pracy. Zamiast jednorazowego zdiagnozowania spowolnienia i zapomnienia o nim, zespoły mogą porównywać nowe zachowanie ze starym planem, wcześnie wyłapywać regresje i utrzymywać obciążenie blisko linii bazowej sprawdzonej na produkcji. digna publikuje również przewodnik po SQL query optimisation, który wpisuje się w ten wzorzec, skupiając się na rzeczywistych parametrach, planach wykonania, węzłach będących wąskimi gardłami, odświeżaniu statystyk i porównywaniu planów.
To jest element, który bardzo cenię pod kątem operacyjnym. Poprawki na poziomie zapytań są realne, ale tracą na sile, jeśli nikt nie śledzi obciążenia po wdrożeniu zmiany. Observability zamienia to w rutynę, a nie w misję ratunkową.
Jeśli zmagasz się z powolną procedurą składowaną, planem, który stale się zmienia, lub zapytaniem, które wydawało się naprawione, dopóki dane ponownie się nie przesunęły, odwiedź stronę digna i sprawdź, czy observability wewnątrz bazy danych może zapewnić linię bazową, wykrywanie anomalii i monitorowanie obciążeń, których potrzebujesz do utrzymania stabilnej wydajności. Właściwy proces dostrajania nie kończy się na przepisaniu kodu – stale monitoruje system, aby kolejna regresja nie zaskoczyła Twojego zespołu.
Najczęściej zadawane pytania
Co zrobić przed przepisaniem wolnego zapytania?
Zmierzyć. Najszybszy sposób na zmarnowanie czasu to zmiana SQL, zanim wiadomo, co jest wolne, a linia bazowa nie jest opcjonalna, bo bez niej nie da się powiedzieć, czy przepisanie pomogło, czy tylko przesunęło problem.
Kiedy naprawdę rozumie się problem?
Gdy potrafisz wyjaśnić operator stanowiący wąskie gardło jeszcze przed przepisaniem. Jeśli nie umiesz nazwać, który operator dominuje w planie i dlaczego, każda zmiana jest domysłem przebranym za optymalizację.
Dlaczego wolne zapytanie może nie mieć związku ze swoją treścią?
Bo objawem jest czas odpowiedzi, a przyczyna może leżeć poza instrukcją. Blokady, parameter sniffing, nieaktualne statystyki albo rywalizacja o zasoby objawiają się jednym wolnym zapytaniem, choć sam SQL jest w porządku.
Co plan wykonania mówi, czego nie powie pomiar czasu?
Gdzie wykonuje się praca. Łączny czas mówi, że zapytanie było wolne; plan pokazuje, który operator pochłonął wysiłek, a to różnica między wiedzą, że coś jest nie tak, a wiedzą, co zmienić.
Czy dodanie indeksu naprawia wolne zapytanie?
Tylko wtedy, gdy plan wskazuje ścieżkę dostępu jako wąskie gardło. Indeksy dodane bez tego dowodu niosą koszt zapisu i utrzymania na zawsze, pozostawiając pierwotne wąskie gardło nietkniętym.



