Monitoruj oczekiwany czas realizacji dla potoków danych
|
6
min. czyt.

Pulpit menedżerski informuje, że wczorajszy przepływ danych jest prawidłowy, ale dane są nieaktualne. Nocne ładowanie się opóźniło, tabela pojawiła się o kilka godzin za późno i nikt tego nie zauważył przed rozpoczęciem spotkania. To właśnie tego rodzaju niedopatrzenie sprawia, że oczekiwany czas dostawy przestaje być pojęciem logistycznym, a staje się codziennym sygnałem operacyjnym dla zespołów ds. danych.
W praktyce problem rzadko sprowadza się do jednego zepsutego zadania. Chodzi o rozbieżność między momentem, w którym zestaw danych powinien dotrzeć, a czasem, w którym faktycznie się pojawia, oraz o to, czy użytkownicy końcowi mogą zaufać wynikom przed podjęciem decyzji. Najsilniejsze zespoły traktują tę lukę jako mierzalną właściwość systemu, a nie jako niejasną niedogodność.
Spis treści
Dlaczego oczekiwany czas dostawy ma znaczenie dla zespołów ds. danych
Statystyczne metody i uczenie maszynowe do określania okien czasowych przybycia danych
Obsługa sezonowości i harmonogramów biznesowych w prognozach dostaw
Projektowanie umów SLA i strategii alertów dla Data Timeliness
Procedury ustalania przyczyn opóźnionego lub brakującego napływu danych
Wskazówki dotyczące wdrażania w bazie danych za pomocą digna Timeliness i Analytics
Dlaczego oczekiwany czas dostawy ma znaczenie dla zespołów ds. danych
Poniedziałkowy poranny raport pokazujący piątkowe liczby zazwyczaj nie jest błędem raportowania, lecz porażką w zakresie terminowości. Dane dotarły późno, hurtownia je zaakceptowała, a biznes dowiedział się o tym dopiero, gdy ktoś zapytał, dlaczego wskaźniki KPI wyglądają na zamrożone. Właśnie dlatego oczekiwany czas dostawy powinien być rozpatrywany w tym samym kontekście, co świeżość, kompletność i poprawność danych.
W kontekście danych oczekiwany czas dostawy to wyuczone lub uzgodnione okno czasowe, w którym zestaw danych, tabela bądź partycja powinny zostać zapełnione i przygotowane do dalszego użytku. W przeciwieństwie do terminów wysyłki, które często określa się jako pojedynczy moment docelowy, na czas przybycia danych wpływ mają harmonogramy orkiestracji, zachowanie systemów źródłowych, godziny graniczne oraz kalendarze biznesowe. Sztywne sprawdzenie harmonogramu cron może wykazać, że „zadanie zostało wykonane”, podczas gdy właściwe pytanie brzmi, czy dane dotarły wtedy, gdy odbiorcy ich potrzebowali.
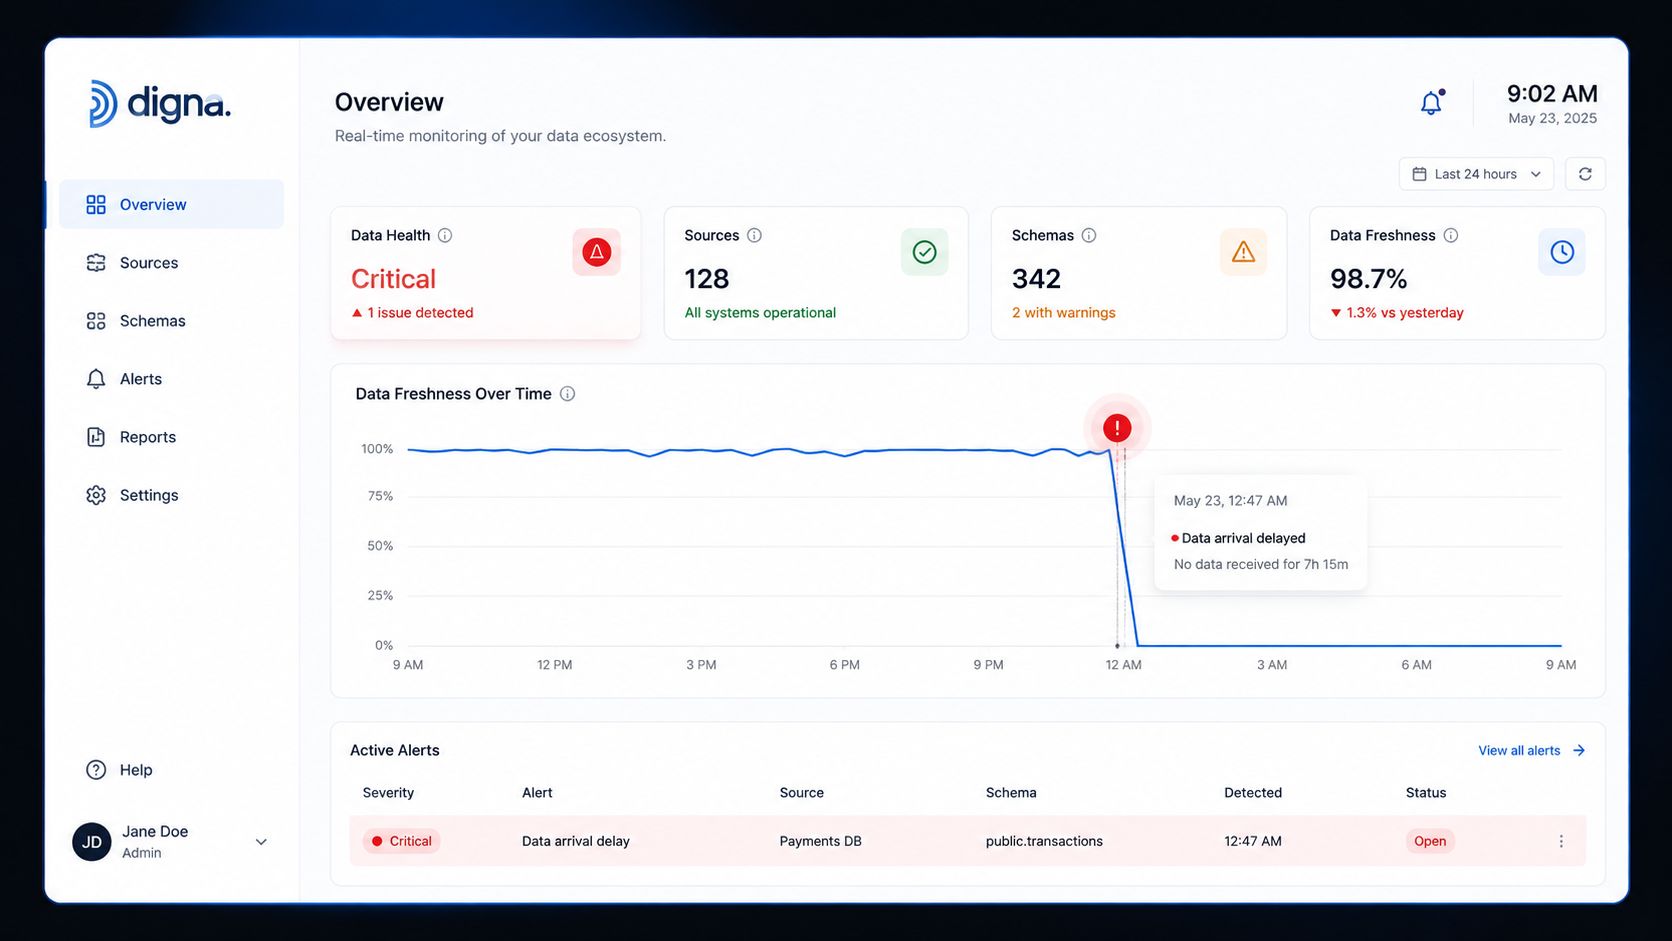
Zasada praktyczna: jeśli tabela zasila spotkanie, model lub wyciąg regulacyjny, terminowość jest wymaganiem produktowym, a nie szczegółem zaplecza technicznego.
Statyczne założenia oparte na harmonogramach cron zawodzą, ponieważ opierają się na życzeniach, a nie na rzeczywistym zachowaniu. Systemy nadrzędne ulegają rozproszeniu, okna wsadowe się przesuwają, a jedna opóźniona partycja może popsuć kilka kolejnych zadań, zanim ktokolwiek otworzy dziennik zdarzeń. Gdy zespół zaczyna jawnie mierzyć oczekiwany czas dostawy, nieaktualne raporty przestają być zaskoczeniem i stają się monitorowanym problemem z niezawodnością.
Statystyczne metody i uczenie maszynowe do określania okien czasowych przybycia danych
Zespoły, które przechowują tylko zaplanowany czas uruchomienia, kończą z zawodnymi alertami. Lepszym modelem jest wyuczone okno przybycia danych, w którym historyczne zachowanie definiuje, co zazwyczaj oznacza „na czas” dla każdej tabeli, partycji czy grupy plików. Taka zmiana przekształca pojedynczy znacznik czasu w rozkład, co znacznie lepiej odzwierciedla rzeczywiste funkcjonowanie potoków danych.
Zacznij od statystycznych punktów odniesienia
Najprostszy punkt odniesienia wciąż jest użyteczny. Średnie kroczące zapewniają ruchomy środek ciężkości dla czasów przybycia danych, podczas gdy okna percentylowe, takie jak P50, P80 i P95, pokazują, jak szeroki jest normalny rozrzut. Śledzenie współczynnika zmienności pomaga odróżnić stabilne źródło od takiego, które wykazuje ogromne wahania między kolejnymi uruchomieniami, co w wielu potokach danych ma większe znaczenie niż sama średnia arytmetyczna.
Użytecznym wzorcem wewnętrznym jest obliczanie metryk na poziomie wierszy dla rzeczywistego czasu realizacji, obiecanego czasu realizacji oraz odchylenia między nimi. Odpowiada to wytycznym dotyczącym Observability zawartym w artykule digna opisującym statystyczne rozpoznawanie wzorców, gdzie celem nie jest dążenie do jednego oczekiwanego znacznika czasu, ale wykrywanie powtarzalnych struktur w zachowaniu czasowym.
Wprowadź uczenie maszynowe, gdy zachowanie przestaje być jednolite
Uczenie maszynowe (ML) staje się wartościowe, gdy sam punkt odniesienia zmienia się wraz z obciążeniem systemu źródłowego, regionalnymi zmianami lub złożonymi ścieżkami orkiestracji. Pozwala ono wykrywać wzorce sezonowe i stopniowo zmieniające się zachowania dotyczące przybycia danych, których proste limity nie są w stanie wychwycić. Istnieje tu jednak oczywisty kompromis. Metody statystyczne są przejrzyste i łatwe do debugowania, podczas gdy ML wymaga odpowiednio długiej historii i uważnego monitorowania, aby nie zinterpretować zakłóceń jako normy.
Najlepsze wdrożenia łączą oba podejścia. Statystyczne punkty odniesienia zapewniają wyjaśnialność, natomiast ML radzi sobie z niuansami. To połączenie ma jeszcze większe znaczenie w środowiskach opartych w dużej mierze na strumieniowaniu, gdzie wzorce obciążenia zmieniają się na tyle szybko, by zepsuć stałe założenia, jak omówiono w tym przydatnym artykule na temat wpływu obciążeń strumieniowych.
Porównanie metod modelowania okien przybycia danych | Najlepsze do | Przejrzystość | Zdolność adaptacji |
|---|---|---|---|
Średnia krocząca | Stabilne potoki danych z niewielkim przesunięciem czasowym | Wysoka | Niska do umiarkowanej |
Okna percentylowe | Potoki danych o nieregularnych lub skokowych czasach przybycia | Wysoka | Umiarkowana |
Współczynnik zmienności | Porównanie stabilności różnych źródeł danych | Wysoka | Umiarkowana |
Punkty odniesienia wyuczone przez ML | Złożone potoki danych ze zmiennym zachowaniem | Umiarkowana | Wysoka |
Złota zasada: zacznij od najprostszego modelu, który potrafi wyjaśnić Twoje błędy, a następnie dodawaj wyuczone zachowania tylko tam, gdzie uzasadniają to zakłócenia operacyjne.
Obsługa sezonowości i harmonogramów biznesowych w prognozach dostaw
Uproszczona prognoza dostaw załamuje się w momencie zderzenia z rzeczywistością biznesową. Dane weekendowe często podlegają innym wzorcom, zamknięcia miesiąca jeszcze innym, a okna konserwacyjne tworzą przerwy czasowe, które bez uwzględnienia kontekstu wyglądają na awarie. Zadaniem logiki oczekiwanego czasu dostawy jest przyswojenie tych wzorców, a nie ich piętnowanie.
Koduj limity czasowe uwzględniające kalendarz
Godziny graniczne mają znaczenie, ponieważ zmieniają obiecaną datę, a nie tylko próg alertu. Jeśli plik z danymi dotrze po terminie przetwarzania, oczekiwane okno czasowe powinno przesunąć się na kolejny ważny dzień roboczy, zamiast być traktowane jako „opóźnienie” w stosunku do poprzedniego dnia. Ta sama idea stoi za brytyjskimi przepisami dotyczącymi dostaw, które pozwalają na określenie obiecanego okna jako przedziału, np. „od 3 do 5 dni” lub „w ciągu 10 dni”, o ile zobowiązanie to nadal respektuje ustawowy 30-dniowy termin domyślny, gdy ma on zastosowanie, co odnotowano w wytycznych dotyczących dostaw Business Companion oraz brytyjskiej regule domyślnej dostawy konsumenckiej.
Ta sama logika dotyczy globalnych zasobów danych. Przesył danych do hurtowni, który zachowuje się w określony sposób w Londynie, a w inny w Sydney, nie powinien mieć jednego sztywnego okna obietnicy. Kalendarze świąt, granice okresów fiskalnych oraz regionalne harmonogramy konserwacji wpływają na przesunięcie oczekiwanego wzorca przybycia danych.
Traktuj sezonowość jako cechę, a nie wyjątek
Sezonowość powinna być uwzględniona w samym modelu. Jeśli przesył danych zawsze spowalnia podczas zamknięcia miesiąca, to opóźnienie jest częścią oczekiwanego okna. W przeciwnym razie szybko dojdzie do zmęczenia alertami, a inżynierowie przestaną ufać systemowi. W ten sposób zespoły przegapiają rzeczywiste anomalie, ponieważ są zasypywane przewidywalnymi alertami o „opóźnieniach”, które nigdy nie wymagały eskalacji.
Praktyczna wskazówka: logika uwzględniająca kalendarz powinna zmienić punkt odniesienia, zanim zmieni alert. Jeśli firma była zamknięta, dane nie spóźniły się w taki sam sposób, jak w zwykły dzień roboczy.
Projektowanie umów SLA i strategii alertów dla Data Timeliness
Umowa SLA dotycząca terminowości działa tylko wtedy, gdy odpowiada biznesowym konsekwencjom niedotrzymania terminu. Tabela zasilająca pulpit menedżerski może wymagać sztywnego limitu czasu, podczas gdy wewnętrzne dane przejściowe mogą potrzebować jedynie łagodniejszego okna na dochodzenie. Mylenie tych pojęć prowadzi do nadreaktywności lub samozadowolenia.
Oddziel sztywne terminy od elastycznych okien czasowych
W transporcie towarowym termin must arrive by date (MABD) stanowi ostateczną granicę, a jego niedotrzymanie może skutkować obciążeniami zwrotnymi, odmową przyjęcia przesyłki lub utratą relacji biznesowych, przy czym planowanie odbywa się wstecz od wymaganej daty dostawy. Zespoły ds. danych powinny przejąć to rozróżnienie. Niektóre zestawy danych wymagają bezwzględnego dotrzymania terminu, ponieważ procesy następcze nie mogą zostać wznowione. Inne potrzebują elastycznego oczekiwanego przedziału, w którym powtarzające się opóźnienia mają większe znaczenie niż jedno sporadyczne potknięcie.
Strona konsumencka pokazuje, dlaczego to rozróżnienie jest tak ważne. Do 2025 roku niemal dwie trzecie globalnych klientów oczekiwało zakupów online w ciągu 24 godzin, około połowa chciała otrzymać zakupy spożywcze w czasie poniżej dwóch godzin, a inne szacunki z 2025 r. oparte na wielu badaniach określiły globalny średni udział paczek dostarczanych w ciągu dwóch dni kalendarzowych na poziomie 64%, zgodnie z danymi Statista dotyczącymi oczekiwań w zakresie dostaw. Oczekiwania zmieniają się szybko, więc obietnica musi być jasna, a nie domyślna.
Buduj alerty, którym ludzie ufają
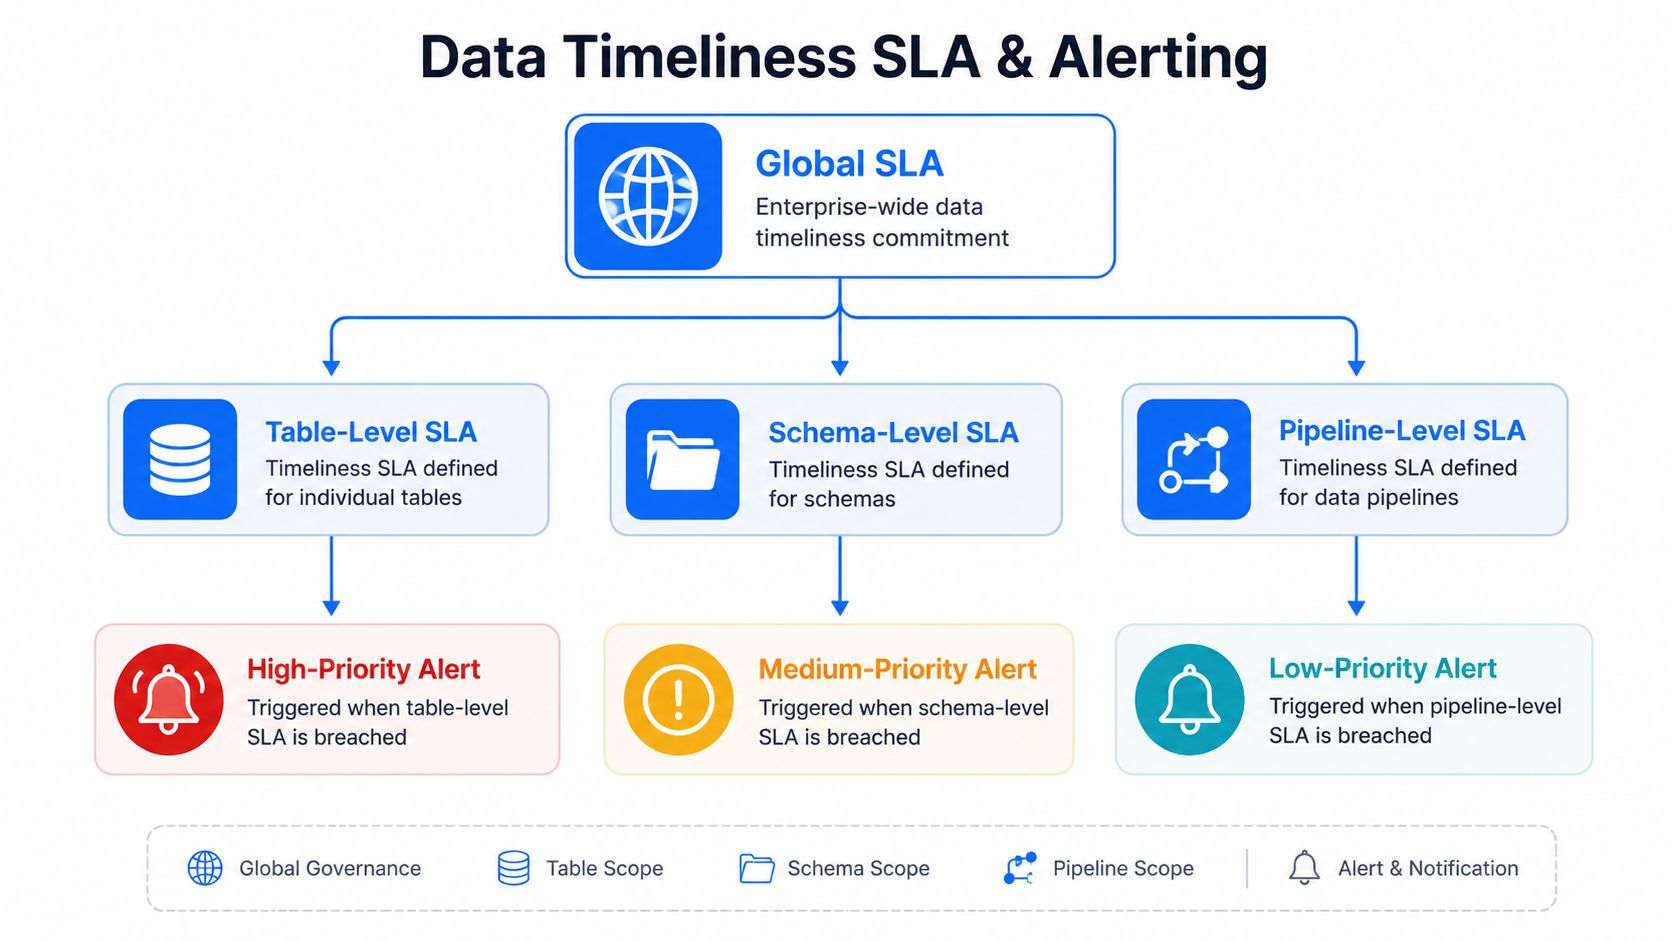
Projekt alertów powinien ograniczać szum informacyjny, zanim zacznie zmniejszać opóźnienia. Grupuj powiązane opóźnienia, wyciszaj alerty podczas planowanych okien konserwacyjnych i tam, gdzie to możliwe, używaj przedziałów ufności zamiast binarnych testów zaliczone/niezaliczone. Umowa SLA na poziomie tabeli może generować alert o wysokim priorytecie, podczas gdy zmiana na poziomie schematu może uzasadniać inną ścieżkę eskalacji, jeśli okno przybycia danych wciąż nie zostało naruszone.
Zasada operacyjna: jeśli inżynierowie dwukrotnie zignorują alert, oznacza to, że błędnie zaprojektowano alert, a nie że zawiódł zespół.
Praktyczna struktura SLA zaczyna się na poziomie globalnej polityki, a następnie zawęża się do reguł dotyczących tabel, schematów i potoków danych. Taka konstrukcja pozwala zachować widoczność wpływu na biznes bez konieczności stawiania na nogi całego zespołu o 2 nad ranem przy każdym opóźnionym uruchomieniu.
Procedury ustalania przyczyn opóźnionego lub brakującego napływu danych
Niedotrzymanie okna dostawy danych to symptom, a nie diagnoza. Najszybsze zespoły opierają się pokusie obwiniania w pierwszej kolejności hurtowni danych. Śledzą opóźnienie wstecz – od spóźnionej tabeli do systemu, który to opóźnienie wywołał.
Praca od symptomu do źródła
Zacznij od opóźnionego zbioru danych i sprawdź, czy system źródłowy nie miał opóźnienia, był niedostępny lub niekompletny. Następnie zbadaj dzienniki orkiestracji pod kątem pominiętych harmonogramów, nieudanych prób powtórzenia lub wąskich gardeł w zależnościach. Jeśli źródło i harmonogram wyglądają poprawnie, przejdź do błędów transformacji i konfliktów w hurtowni danych, ponieważ obie te kwestie mogą zablokować dostawę bez ujawniania problemu na samym początku grafu DAG.
Najbardziej pożytecznym nawykiem jest porównanie obecnego opóźnienia z historycznymi wzorcami Observability. Jeśli przesunięcie czasu ma charakter izolowany, prawdopodobnie mamy do czynienia z anomalią. Jeśli jednak pogłębia się ono przy kolejnych uruchomieniach, przyczyną może być pogarszająca się wydajność potoku lub system źródłowy, który powoli wykracza poza swój normalny wzorzec. W tym miejscu monitorowanie czasu idealnie współgra z wykrywaniem anomalii i śledzeniem zmian schematu, ponieważ zmiana schematu może zepsuć proces ładowania bez wpływu na nazwę zadania.
Use a repeatable investigation checklist
Spójny schemat działania pozwala zachować porządek podczas obsługi incydentu.
Sprawdź status systemu źródłowego. Potwierdź, czy dostawca danych opublikował oczekiwaną partię.
Zweryfikuj dzienniki potoków danych. Poszukaj ponownych prób, pominiętych zadań lub błędów orkiestracji.
Zbadaj błędy transformacji. Wykryj ciche błędy analizowania danych, nagłe pojawienie się wartości null lub uszkodzone połączenia tabel (join).
Przejrzyj próg SLA. Upewnij się, że alert nie został błędnie przypisany z powodu nieaktualnego okna czasowego.
Udokumentuj wnioski. Zapisz przyczynę, sposób naprawy i nowe zabezpieczenie, aby zapobiec powtórzeniu się tego samego opóźnienia.
Nie chodzi wyłącznie o szybkość. Chodzi o wypracowanie wspólnej ścieżki badania problemu, która skraca średni czas naprawy (MTTR) i ułatwia lokalizację kolejnego incydentu.
Wskazówki dotyczące wdrażania w bazie danych za pomocą digna Timeliness i Analytics
Przenoszenie kontroli czasu poza hurtownię danych generuje niepotrzebne problemy bez dobrego powodu. Czystszym wzorcem jest obliczanie metryk dostarczania bezpośrednio tam, gdzie dane już się znajdują, a następnie prezentowanie wyników w tym samym środowisku, które przechowuje stan potoku. Pozwala to na pozostawienie danych w systemie kontrolowanym przez klienta i pozwala uniknąć przesyłania wrażliwych tabel tylko w celu zmierzenia świeżości.
Zintegruj testy z hurtownią danych
Pierwszym krokiem jest obliczenie rzeczywistego czasu przybycia danych wewnątrz bazy danych, a następnie porównanie go z wyuczonym oczekiwanym oknem czasowym. Narzędzie digna Timeliness realizuje to poprzez monitorowanie przybycia danych w odniesieniu do wyuczonych wzorców i harmonogramów użytkownika, w tym oczekiwanego czasu dostawy i wykrywania opóźnień. W połączeniu z digna Data Analytics pozwala ono badać historyczne metryki Observability pod kątem trendów, szybkich zmian sygnałów i wzorców statystycznych, co pomaga z czasem rekalibrować okno czasowe.
Z mojego doświadczenia wynika, że ma to kluczowe znaczenie w hurtowniach danych przedsiębiorstw, gdzie duże tabele sprawiają, że zewnętrzne odpytywanie jest nieefektywne i kosztowne. Wykonywanie obliczeń wewnątrz bazy utrzymuje metryki blisko danych, co upraszcza ścieżkę alertów i ułatwia zaufanie do procesów operacyjnych.
Skonfiguruj narzędzie pod kątem faktycznie uruchamianego przepływu danych
Zastosuj tę samą logikę do powszechnych wzorców, ale dostosuj punkt odniesienia do zachowania tabeli. Dla codzienne tabeli faktów oczekiwane okno powinno odzwierciedlać normalne przesunięcie po godzinie granicznej. Dla zmiennego źródła danych okno powinno być szersze i mieć charakter bardziej probabilistyczny. W przypadku kluczowych danych zasilających model następny połącz kontrolę czasu ze śledzeniem schematu oraz walidacją na poziomie rekordów, aby „opóźnione, ale obecne” ładowanie nie maskowało wadliwej zawartości.
Jeśli szukasz punktu wyjścia, moduł digna Timeliness został stworzony do monitorowania przybycia danych na podstawie wyuczonych wzorców, a nie sztywnych założeń cron. Ma to duże znaczenie, ponieważ systemy produkcyjne nie są niezmienne – i model czasu również taki być nie powinien.
Uwaga dotycząca wdrożenia: gdy tylko to możliwe, przechowuj metrykę czasu i odbiorcę alertu w tym samym środowisku. Każdy dodatkowy krok zwiększa opóźnienia, ryzyko awarii i wprowadza chaos.
Najbardziej efektywny wzorzec to krótka pętla: obliczenie metryki czasu, porównanie z wyuczonymi oczekiwaniami, wyświetlenie sygnału na pulpicie nawigacyjnym i ponowne wprowadzenie historycznych pomiarów do punktu odniesienia. Pozwala to uzyskać system, który sam się doskonali bez konieczności ręcznego utrzymywania zestawów reguł.
Budowanie zrównoważonych praktyk w zakresie Data Timeliness
Monitorowanie terminowości sprawdza się najlepiej, gdy stanowi część szerszego programu Data Observability, a nie jedynie osobny alert. Nieaktualne raporty, zepsute pulpity nawigacyjne i niewiarygodne dane wejściowe dla sztucznej inteligencji często mają wspólne źródło w postaci opóźnienia danych. Gdy oczekiwany czas dostawy staje się pierwszorzędną metryką, chroni on jednocześnie analityków, inżynierów i użytkowników biznesowych.
Wdrażanie zrównoważonych praktyk zazwyczaj zaczyna się od małych kroków. Najpierw zidentyfikuj kluczowe tabele, ustal początkowy punkt odniesienia, zdefiniuj umowy SLA powiązane z wpływem na biznes, skonfiguruj alerty z rzeczywistymi poziomami ważności, a następnie doprecyzowuj okno czasowe w miarę uszczegóławiania wzorców. Dodaj wykrywanie anomalii, śledzenie schematu oraz walidację na poziomie rekordów do tego samego modelu operacyjnego, tak aby jedna cicha awaria nie maskowała innej.
Uzasadnienie biznesowe jest oczywiste. Dane docierające na czas wspierają podejmowanie lepszych decyzji, sprawniejsze audyty i mniejszą liczbę nagłych awarii. Co ważniejsze, daje to zespołom wspólny język dla określenia, co rzeczywiście oznacza „opóźnienie”, co stanowi kluczową różnicę między chaotycznym reagowaniem a rzeczywistym standardem operacyjnym.
Jeśli chcesz zastąpić niestabilne testy cron wyuczonymi oknami przybycia danych, odwiedź witrynę digna i zobacz, jak funkcje terminowości, analityki, wykrywania anomalii oraz walidacji współpracują ze sobą bezpośrednio w Twojej hurtowni danych. Zacznij od najważniejszych tabel, a następnie użyj tego samego modelu działającego w bazie danych do monitorowania ryzyka opóźnień, zanim nieaktualne dane trafią do struktur biznesowych.