Metoda symulacji Monte Carlo: Praktyczny przewodnik
|
7
min. czyt.
Zazwyczaj zadanie ETL odświeża tabelę klientów w około dwie godziny. Dziś rano, przed zbliżającym się posiedzeniem zarządu, to samo odświeżanie wciąż działa po sześciu godzinach. Pulpity nawigacyjne zaświeciły się na czerwono, raporty podrzędne są nieaktualne, a inżynier dyżurny sprawdza jednocześnie obciążenie klastra, logi API i kolejki hurtowni danych.
Problem nie polega na tym, że zespół zapomniał, jak szacować. Problem polega na tym, że pojedyncze oszacowanie ukryło warunki, które mogły spowolnić zadanie. Metoda symulacji Monte Carlo czyni te warunki jawnymi, próbkuje z ich niepewności i zamienia jedną pewną odpowiedź w rozkład możliwych wyników.
Spis treści
Dlaczego deterministyczne szacunki często zawodzą
Deterministyczne oszacowanie przyjmuje stałe dane wejściowe i daje stały wynik. W przypadku odświeżania ETL może to oznaczać założenie znanej wielkości ładunku danych, przewidywalnego opóźnienia u dostawców oraz stabilnej wydajności obliczeniowej. Wynikająca z tego obietnica brzmi jasno: tabela klientów będzie gotowa w ciągu dwóch godzin.
Ta obietnica jest użyteczna tylko wtedy, gdy dane wejściowe są wystarczająco stabilne, aby ją uzasadnić. W produkcji rywalizacja o zasoby klastra może ulec zmianie podczas działania, zewnętrzne API może odpowiadać wolno, a przychodzący ładunek danych może być znacznie większy niż zwykle. Rurociąg, który zwykle kończy pracę szybko, może napotkać nietypową kombinację warunków i znacznie minąć się z oczekiwaniami dotyczącymi świeżości danych (Timeliness).
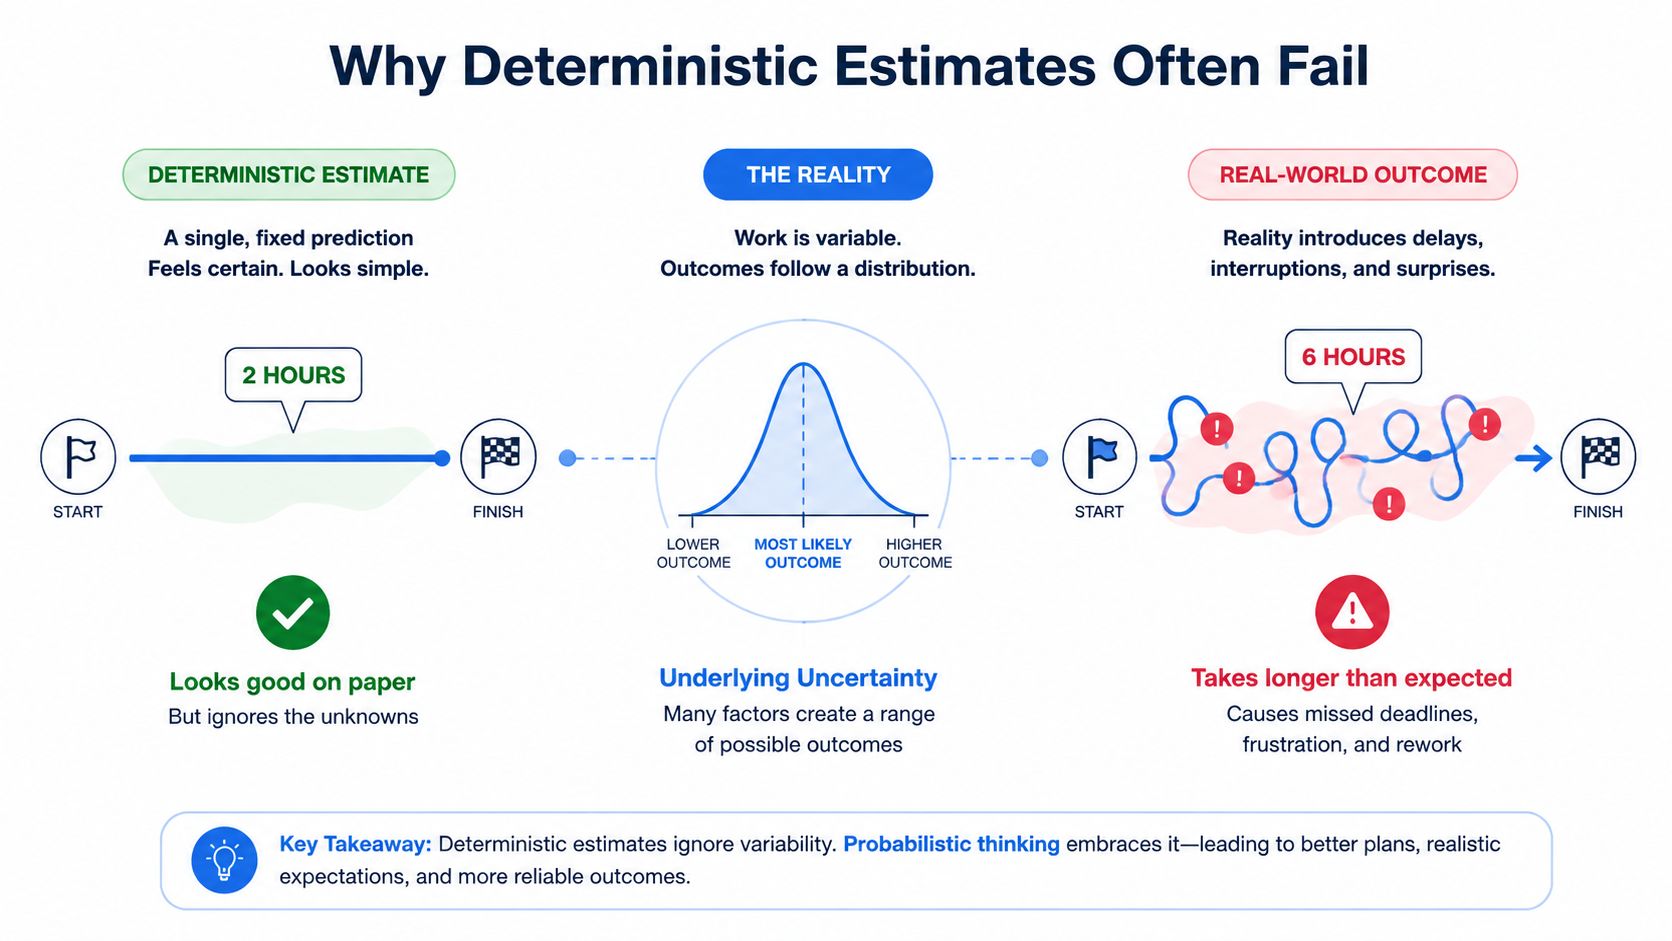
Oszacowanie punktowe ukrywa rozrzut
Załóżmy, że inżynier rejestruje czas trwania każdego udanego odświeżenia. Istotne pytanie brzmi nie tylko: „Jaki czas trwania powinniśmy zaplanować?”, ale także:
Typowe zachowanie: Ile czasu zwykle zajmuje odświeżenie?
Zmienność operacyjna: Jak szeroko rozchodzą się czasy trwania?
Zachowanie w ogonie rozkładu (tail behavior): Jak często zadanie kończy się nienaturalnie późno?
Próg decyzyjny: Przy jakim prawdopodobieństwie zespół powinien wezwać kogoś na pomoc (alert)?
Rozkład prawdopodobieństwa opisuje to zachowanie dokładniej niż pojedynczy czas trwania. Daje zespołowi sposób na odróżnienie zwykęj zmienności od zdarzenia, które zasługuje na zbadanie. Aby uzyskać praktyczne podstawy do zrozumienia tej idei, zobacz, co reprezentuje rozkład danych.
Losowość nie oznacza automatycznie złych danych. Pewna losowość odzwierciedla rzeczywiste warunki operacyjne. Harmonogram hurtowni danych, sieć, system źródłowy i obciążenie pracą — wszystko to przyczynia się do zmienności, którą rurociąg musi tolerować. Ignorowanie tej zmienności jej nie eliminuje. Przenosi jedynie niepewności w obszar incydentów.
Zasada praktyczna: Jeśli decyzja zależy od zakresu prawdopodobnych wyników, modeluj ten zakres bezpośrednio, zamiast ukrywać go za średnią.
Deterministyczna umowa SLA wciąż może być użyteczna jako kontrakt, ale nie należy jej mylić z pełną prognozą. Kontrakt określa, czego oczekuje biznes. Model probabilistyczny szacuje, jak często platforma prawdopodobnie go spełni w obserwowanych warunkach.
Metoda symulacji Monte Carlo traktuje rozrzut jako dane wejściowe, a nie wroga.
Główna idea stojąca za metodą symulacji Monte Carlo
Metoda staje się znacznie prostsza, gdy zrozumie się trzy pojęcia. Po pierwsze, każda niepewna dana wejściowa ma swój rozkład prawdopodobieństwa. Po drugie, symulacja pobiera losową próbkę z każdego rozkładu. Po trzecie, model łączy te próbki i generuje jeden wynik.
W przypadku rurociągu danych, wejścia mogą obejmować czas ekstrakcji źródłowej, czas transformacji, opóźnienie w kolejce hurtowni oraz ostateczny czas publikacji. Model może sumować te czasy trwania lub może zawierać logikę warunkową, powtórzenia, zadania równoległe i reguły zależności. Struktura modelu pozostaje taka sama, podczas gdy próbkowane dane wejściowe zmieniają się z jednej iteracji na drugą.

Dlaczego powtarzanie pomaga
Jedno losowanie nie mówi nam prawie nic. Może trafić w pobliże środka rozkładu lub w ogon. Powtarzanie tego procesu dostarcza rozkładowi wyjściowemu wystarczająco dużo obserwacji, aby ujawnić jego kształt.
Taka jest intuicja stojąca za prawem wielkich liczb. Pojedyncze próbki pozostają zmienne (szum), ale zachowanie zagregowane staje się bardziej stabilne wraz ze wzrostem liczby niezależnych próbek. Wyobraź sobie na początku nieregularny histogram, którego słupki skaczą w różne strony. W miarę kolejnych iteracji słupki wygładzają się, a centralny wzorzec staje się łatwiejszy do zauważenia.
Wynikiem nie jest pewność. To bardziej wiarygodne przybliżenie modelu sugerowanego przez dane wejściowe.
Pętla symulacji
Każda iteracja przebiega według tego samego cyklu:
Próbkowanie wejść: Wylosuj wartość z każdego rozkładu wejściowego.
Uruchomienie modelu: Przekaż te wartości do agregacji lub logiki biznesowej.
Zapisanie wyniku: Zachowaj uzyskany czas trwania, stratę, liczbę wierszy lub inną metrykę.
Powtórzenie procesu: Kontynuuj, aż wynik będzie wystarczająco stabilny do podjęcia decyzji.
Podsumowanie wyników: Przeanalizuj średnią, percentyle i prawdopodobieństwo przekroczenia progu.
Rozkład wyjściowy odpowiada na pytania, na które oszacowanie punktowe nie potrafi odpowiedzieć. Możesz zapytać, ile czasu zwykle zajmuje odświeżenie, jak późne mogą stać się najwolniejsze prawdopodobne ścieżki lub jak prawdopodobne jest, że pulpit nawigacyjny nie dotrzyma kontraktu dotyczącego świeżości.
Z punktu widzenia inżynierii danych ten przepływ pracy opisały metody Monte Carlo dla lepszej Observability danych, łącząc powtarzalne próbkowanie z monitorowaniem operacyjnym.
Technika ta oferuje trzy praktyczne obietnice: odpowiedzi oparte na rozkładzie, wgląd w ryzyko ogona oraz reprodukowalną zmienność przy kontrolowanym generatorze liczb losowych. Poniższy algorytm zamienia te obietnice w kroki implementacji gotowe do ponownego użycia.
Algorytmy i pseudokod, które możesz wykorzystać ponownie
Zacznij od algorytmu, nie od języka programowania. Język to tylko mechanizm służący do wykonania pętli.
Ogólny pseudokod
Ważnym elementem jest oddzielenie próbkowania od modelowania. Próbkowanie odpowiada na pytanie: „Jakich prawdopodobnych wartości wejściowych należy użyć w tej iteracji?”. Model odpowiada: „Jaki wynik nastąpi po użyciu tych wartości?”. Mieszanie tych zadań utrudnia testowanie i debugowanie.
Praktyczny przykład w języku Python może oszacować prawdopodobieństwo, że suma trzech logarytmiczno-normalnych czasów trwania zadań przekroczy czterogodzinne SLA. Rozkład ten jest odpowiedni dla dodatniego, prawostronnie skośnego modelu czasu trwania, ale poniższe parametry są jedynie ilustracyjnymi przykładami na potrzeby demonstracji, a nie szacunkami produkcyjnymi.
Wzorce warte ponownego wykorzystania
Zwektoryzowane próbkowanie:
numpy.random.default_rngwydajnie generuje tablice, zamiast zmuszać język Python do obsługi każdego losowania w powolnej pętli.Kontrolowana losowość: Parametr
seed(ziarno) sprawia, że przebieg jest powtarzalny, co ma kluczowe znaczenie, gdy inżynier musi wyjaśnić przyczyny alertu lub porównać wersje modeli.Widoczność postępu: W przypadku modelu celowo iteracyjnego lub zależnego od ścieżki, opakuj pętlę za pomocą
tqdm, aby długo działające zadanie pokazywało swój postęp.
Czytelnicy przechodzący od szkiców algorytmów do działającego kodu Python mogą użyć tych przykładów konwersji pseudokodu na język Python jako czytelnego punktu odniesienia.
W dalszej kolejnosci możesz zapoznać się z metodami zmiennych antytetycznych oraz zmiennych kontrolnych jako technikami redukcji wariancji. Nie są one wymagane w pierwszym modelu, ale mogą zmniejszyć szum symulacyjny, gdy każdy przebieg jest kosztowny obliczeniowo. W przypadku procesów wykrywania anomalii te same podsumowania wyników mogą wspierać wykrywanie anomalii danych w języku Python.
Implementacja Monte Carlo w językach Python, R i SQL
Ta sama symulacja nie różni się pod względem matematycznym tylko dlatego, że zostaje przeniesiona między językami Python, R i SQL. Kompromis ma charakter operacyjny: gdzie powinno odbywać się próbkowanie, gdzie powinien być wykonywany model i gdzie będą konsumowane wyniki?
Python z NumPy
Python jest zwykle najszybszym miejscem do tworzenia prototypów. NumPy radzi sobie ze zwektoryzowanym próbkowaniem, wyodrębnianie percentyli jest proste, a otaczający go ekosystem wspiera dopasowywanie rozkładów, tworzenie wykresów diagnostycznych i testowanie zachowania modeli.
R z replicate
Język R to doskonały wybór, gdy praca koncentruje się na analizie statystycznej i wizualizacji. Funkcja replicate() zwiększa czytelność wielokrotnego uruchamiania kodu, podczas gdy pakiety takie jak dplyr pozwalają na wygodne agregowanie podsumowań po zakończeniu symulacji.
SQL wewnątrz hurtowni danych
SQL wygrywa, gdy symulacja zależy od danych już przechowywanych w hurtowni. Pobieranie dużych próbek historycznych do Pythona wiąże się z obciążeniem sieci, pamięci oraz tworzeniem kolejnej bariery wykonawczej. Implementacja w hurtowni danych pozwala łączyć historyczne rekordy czasów trwania z losową tabelĕ referencyjną, obliczać symulowane wyniki bezpośrednio przy danych źródłowych i zapisywać podsumowania bez eksportowania surowych wierszy.
Dokładna funkcja losująca różni się w zależności od bazy danych, dlatego warto ją odizolować za pomocą prostego adaptera. Rekurencyjne zapytanie CTE może generować identyfikatory iteracji, podczas gdy powiązanie ze spróbkowanymi wierszami referencyjnymi dostarcza wartości wejściowe. W przypadku codziennych, wysokonakładowych kontroli liczby wierszy, takie rozwiązanie pozwala utrzymać obliczenia blisko testowanych partycji.
Wymiar | Python (NumPy) | R | SQL (w bazie danych) |
|---|---|---|---|
Najlepsze dopasowanie | Prototypowanie i usługi wielokrotnego użytku | Analiza statystyczna i wizualizacja | Symulacje obok danych w hurtowni |
Główna zaleta | Wektoryzacja i bogate biblioteki | Przejrzysty przepływ pracy statystycznej | Ograniczenie przesyłu danych |
Zagrożenie pamięciowe | Duże tablice mogą obciążać pamięć roboczą | Replikacja może generować ogromne obiekty | Obciążenie hurtowni i ryzyko zrzucania danych na dysk |
Powtarzalność | Należy jawnie określić ziarno generatora (seed) | Należy jawnie ustawić ziarno losowości | Zależy od funkcji bazy danych i planu wykonania zapytania |
Wybór operacyjny | Stosuj w złożonych modelach lub modelach zależnych od ścieżki | Stosuj do prac zorientowanych na analizę | Stosuj do prostych testów o dużej objętości danych |
Usługa napisana w języku Python może również wykorzystywać pakiet Python SDK platformy digna, gdy otaczający proces wymaga powiązania wyników symulacji z monitorowaniem platformy. Decyzja ta powinna wynikać z lokalizacji danych i złożoności modelu, a nie tylko z preferencji zespołu.
Zastosowania w jakości danych, Observability i ryzyku
Metoda Monte Carlo staje się cenna w platformie danych wtedy, gdy statyczny próg jest zbyt nieprecyzyjny. Liczba wierszy może być odpowiednia w jednym okresie operacyjnym, a podejrzana w innym. Rurociąg może się opóźnić z powodu nietypowego, lecz w pełni legalnego obciążenia pracą. Rozkład strat z tytułu oszustw może wydawać się niegrożny w swoim centrum, niosąc jednocześnie poważne ryzyko w ogonie rozkładu.
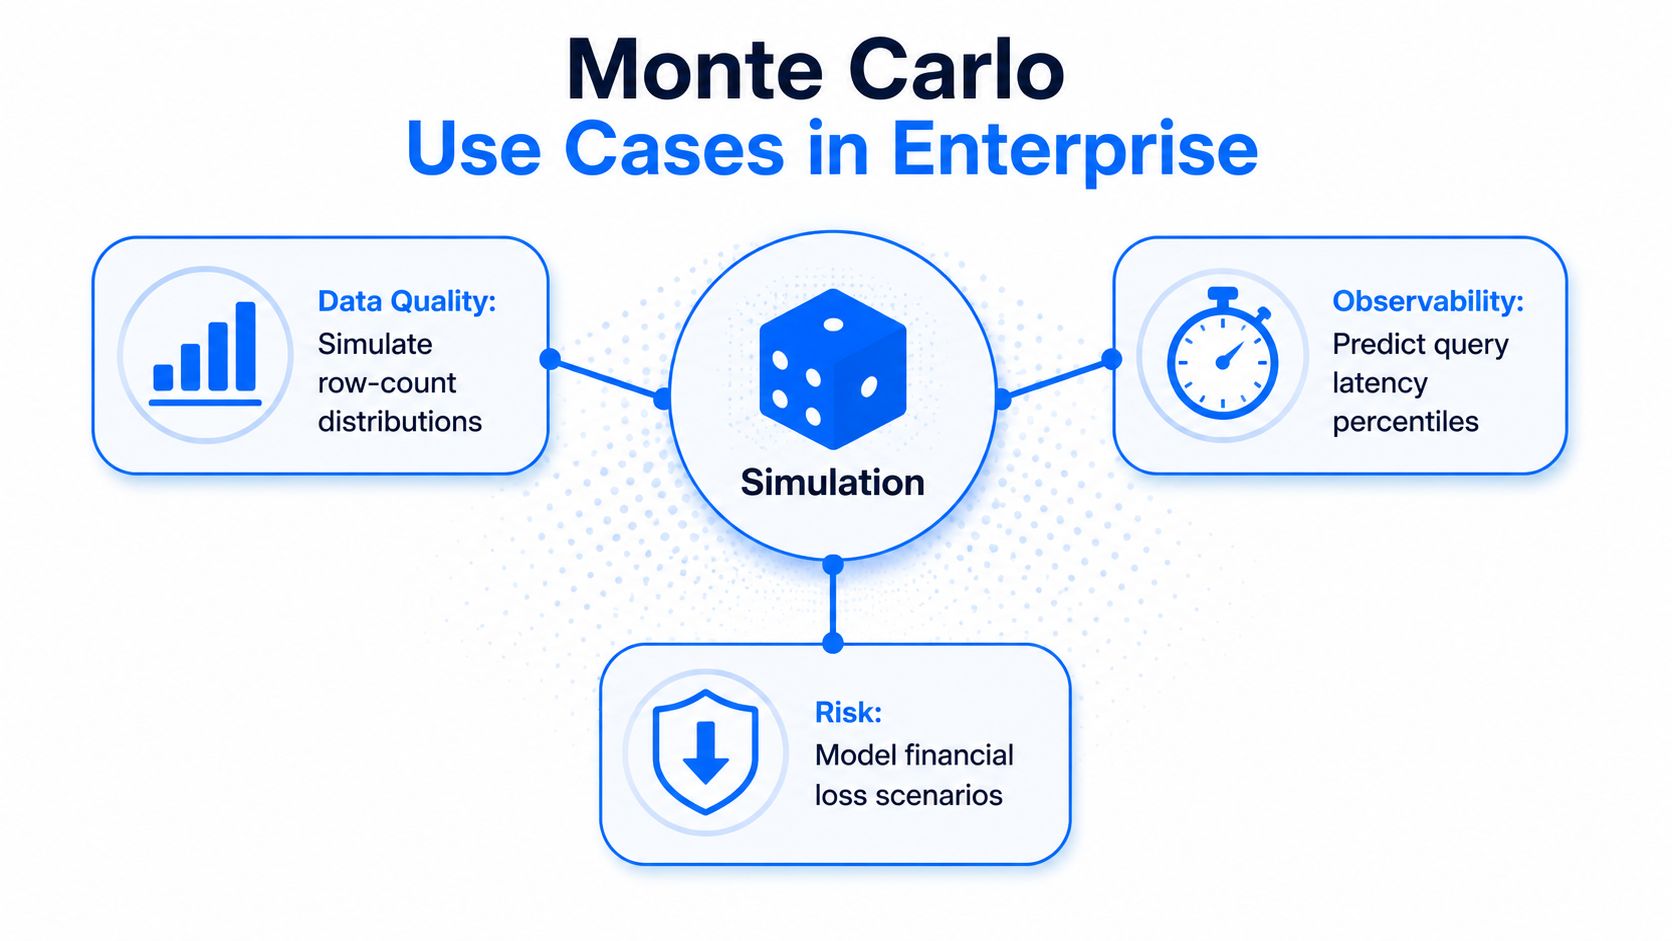
Detekcja anomalii w liczbie wierszy
Zacznij od historycznych godzinnych lub dziennych liczb wierszy w partycjach. Zamiast ustalać jedną sztywną wartość minimalną i maksymalną, dopasuj rozkład, który odzwierciedla normalny wolumen dla danego okresu, typu dnia lub zachowania źródła. Symuluj oczekiwane liczby wierszy i porównuj obserwowaną partycję z wynikowym zakresem.
Działanie powinno zależeć od granicy decyzyjnej. Wartość poza oczekiwanym zakresem może wywołać dochodzenie, natomiast wynik znajdujący się głęboko w symulowanym ogonie może wygenerować incydent o wyższym priorytecie. Takie podejście pozwala wychwycić nietypowe skoki i spadki, które szeroki zakres statyczny po prostu by zignorował.
Ryzyko terminowości rurociągu (pipeline freshness)
W przypadku analizy czasu (Timeliness), rozkładem wejściowym jest historyczny czas trwania etapu lub opóźnienie wejściowe. Model łączy te spróbkowane opóźnienia z harmonogramem powiązań i szacuje, czy docelowy pulpit nawigacyjny będzie gotowy przed upływem czasu określonego w kontrakcie świeżości.
Daje to operacyjne prawdopodobieństwo, a nie ogólne ostrzeżenie. Jeśli symulowane ryzyko opóźnienia przekroczy skonfigurowany przez zespół próg, platforma może powiadomić właściciela, zanim interesariusz zauważy nieświeże dane. Inżynierowie mogą wówczas zbadać najwolniejszy etap, zamiast czekać na awarię końcowego pulpitu.
Straty finansowe i operacyjne
Ten sam mechanizm ma zastosowanie do niedoborów przychodów, strat z tytułu oszustw czy ekspozycji portfela. Rozkład wejściowy może pochodzić z historycznych obserwacji strat, dopasowanych stóp zwrotu lub celowo przygotowanego scenariusza stresowego. Wynikiem jest rozkład strat, na podstawie którego zespół ds. ryzyka może przeanalizować percentyl lub oszacować szansę na przekroczenie zdefiniowanej tolerancji.
Percentyl nie jest gwarancją. To wnioskowanie na temat założeń i procesu próbkowania użytego do jego wygenerowania.
Dryf schematu (schema drift) wpisuje się w ten sam wzorzec. Próbkuj wskaźniki wartości pustych (null rates) lub zachowania polegające na zmianie typów w porównywalnych zbiorach danych, a następnie oznacz nowo zaobserwowany wskaźnik, który znajduje się nietypowo daleko w symulowanym rozkładzie. Może to ujawnić ukryte uszkodzenie, nawet gdy rurociąg formalnie zakończy się sukcesem.
Pułapki i dobre praktyki, których należy unikać
Kod Monte Carlo może działać bez błędów, dając jednocześnie mylące odpowiedzi. Problemy w środowisku produkcyjnym wynikają zazwyczaj z błędnych założeń, zależności lub diagnostyki, a nie z samej pętli.
Losowość nie jest automatycznie niezależna
Generator liczb pseudolosowych to deterministyczny mechanizm zaprojektowany tak, by zachowywać się jak próbkowanie losowe. Złe ustawienia domyślne, krótkie okresy działania lub specyficzne dla bazy danych działanie funkcji rand() mogą tworzyć wzorce zaburzające wyniki. Celowo ustawiaj ziarno (seed) generatora, korzystaj ze sprawdzonych implementacji i testuj spróbkowany rozkład, zamiast zakładać, że funkcja będzie odpowiednia.
Skorelowane dane wejściowe to poważniejszy błąd modelowania. Jeśli opóźnienie u dostawców i czas w kolejce hurtowni rosną jednocześnie pod obciążeniem, próbkowanie ich jako niezależnych sprawi, że ogon rozkładu będzie wydawać się znacznie łagodniejszy niż w rzeczywistości. Używaj wspólnych próbek historycznych, modelu zależności lub funkcji kopuły (copula), gdy ta relacja ma znaczenie.
Zbieżność wymaga dowodów
Średnia krocząca, która wydaje się stabilna, nie dowodzi, że ogony rozkładu również się ustabilizowały. Śledź statystyki, które są kluczowe dla podjęcia decyzji, analizuj wykresy przebiegu (trace plots) i porównuj wyniki w niezależnych partiach danych. W przypadku modeli używających formalnego próbkowania iteracyjnego pomocna w ocenie odpowiedniego wymieszania łańcuchów może być diagnostyka Gelmana-Rubina, choć nie naprawi ona błędnie sformułowanego modelu.
Kwantyle ogonowe wymagają szczególnej ostrożnoci. Jeśli Twój alert zależy od rzadkiego zdarzenia granicznego, pozornie gładkie centrum może współistnieć z niestabilnym ogonem. Zwiększ liczbę powtórzeń symulacji, zastosuj metody redukcji wariancji tam, gdzie to uzasadnione, i raportuj niepewność wokół szacowanego percentyla.
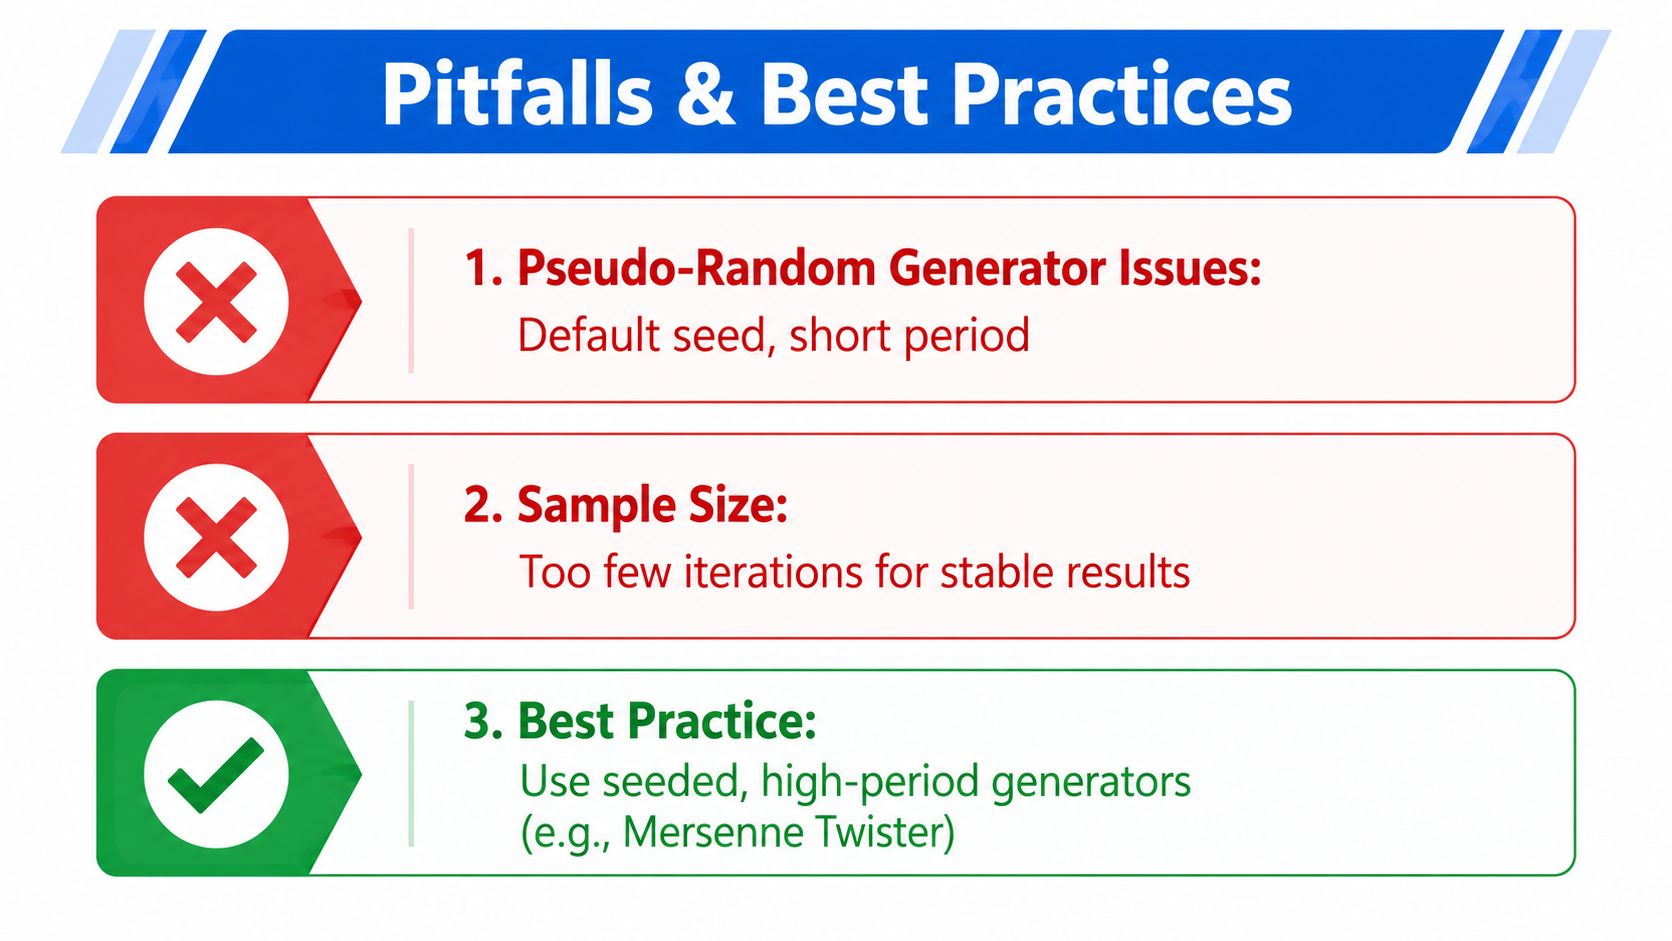
Starannie dopasowuj rozkłady: Korzystaj z odpowiednich danych historycznych, segmentuj odmienne warunki operacyjne i dokumentuj założenia eksperckie.
Kontroluj powtarzalność: Przechowuj ziarno (seed), szczegóły generatora, wersję modelu oraz parametry wejściowe dla każdego uruchomienia.
Waliduj niezależnie: Porównuj proste modele z wynikami analitycznymi lub znanymi przypadkami testowymi, zanim zaufasz wynikom produkcyjnym.
Testuj zależności: Mierz relacje między danymi wejściowymi i zachowuj je podczas próbkowania.
Zapisuj metadane audytowe: Przechowuj razem ustawienia iteracji, wybór rozkładów, wersje kodu i zagregowane wyniki.
Nigdy nie traktuj średniej jako jedynej prawdy. Wynik Monte Carlo jest warunkowany przez model, dane i proces próbkowania. Większa liczba iteracji sprawi jedynie, że błędny model będzie wydawać się bardziej precyzyjny, a nie bardziej poprawny.
Wdrożenie Monte Carlo w korporacyjnej platformie danych
Operacyjne wykorzystanie metody Monte Carlo powinno stać się częścią standardowej ścieżki uruchamiania platformy, a nie lądować w zapomnianym notatniku. Harmonogramuj symulacje wraz z procesami ETL, wersjonuj ich parametry i zapisuj wynikowe podsumowania jako monitorowane metryki. Model, którego nie można uruchomić ponownie ani wyjaśnić, nie jest gotowy na obsługę alertów w klasie enterprise.
Praktyczny projekt operacyjny
Utrzymuj prostą granicę usługi. Proces zasilania (ingestion) powinien dostarczać obserwacje historyczne, komponent symulacji powinien realizować próbkowanie i obliczenia, a warstwa alertów powinna oceniać progi i powiadamiać właścicieli. Taka separacja pozwala inżynierom modyfikować model bez konieczności przebudowy każdego systemu odbiorczego.
Wybieraj wykonywanie w bazie danych dla testów o dużej objętości, takich jak liczba wierszy w partycjach, rozkłady wartości pustych i zakresy świeżości. Używaj Pythona lub R do modeli zależnych od ścieżki, procesów typu bootstrap lub symulacji wymagających specjalistycznych bibliotek statystycznych. Właściwy wybór zależy zazwyczaj od wolumenu przesyłu danych i stopnia złożoności modelu.
Zapisuj wystarczająco dużo metadanych, aby móc odtworzyć każdą decyzję:
Rozkład wejściowy: Zapisuj metodę dopasowania, parametry, okno danych źródłowych i logikę segmentacji.
Konfiguracja symulacji: Zachowuj liczbę próbek, typ generatora liczb losowych, ziarno (seed) oraz wersję modelu.
Podsumowania wyników: Zapisuj percentyle, prawdopodobieństwa w ogonach rozkładu, średnie i diagnostykę zbieżności.
Kontekst alertu: Dołączaj próg, zaobserwowaną wartość, powiązany zbiór danych i reakcję właściciela.
Dowody wykonania: Przechowuj statusy uruchomień, znaczniki czasu oraz szczegóły środowiska na potrzeby audytu.
Rozwiązanie takie jak korporacyjna platforma danych digna może dostarczyć całościowy kontekst monitorowania zachowania danych, ich terminowości, walidacji i zmian schematów. Wynik symulacji powinien być widoczny obok standardowych sygnałów świeżości i jakości, dzięki czemu zespoły mogą porównywać prognozowane ryzyko z rzeczywistymi incydentami.
Przed wdrożeniem (Release) upewnij się, że model radzi sobie z brakującą historią, późno docierającymi rekordami, zmieniającymi się schematami, ponownymi próbami oraz częściowymi awariami hurtowni. Następnie uruchom go w trybie cienia (shadow mode), porównaj alerty z oceną inżynierów i dostosowuj progi dopiero po analizie błędnych powiadomień (false positives) oraz pominiętych zdarzeń.
Platforma digna łączy detekcję anomalii danych, monitorowanie terminowości, walidację oraz śledzenie zmian schematów, dzięki czemu zespoły mogą zamieniać sygnały probabilistyczne w konkretne działania operacyjne. Odwiedź stronę digna, aby przekonać się, jak Observability wspierana metodami Monte Carlo może funkcjonować w Twoim korporacyjnym środowisku danych.
Najczęściej zadawane pytania
Dlaczego szacunki deterministyczne zawodzą?
Bo szacunek deterministyczny bierze stałe wejścia i daje stałe wyjście, a ta obietnica trzyma się tylko wtedy, gdy wejścia są dostatecznie stabilne. Wartość punktowa ukrywa rozrzut, a to właśnie od niego zwykle zależy decyzja.
Na jakie cztery pytania odpowiada rozkład, a nie średnia?
Typowe zachowanie, ile zwykle trwa odświeżenie; zmienność operacyjną, jak szeroko rozkładają się czasy; zachowanie ogona, jak często zadanie kończy się nietypowo późno; oraz próg decyzyjny, przy jakim prawdopodobieństwie wezwać dyżurnego. Średnia odpowiada tylko na pierwsze.
Jakie trzy obiekty trzeba mieć w głowie?
Niepewne wejścia, model, który je łączy, oraz wyjście, które agregujesz. Dla potoku danych wejściami mogą być czas ekstrakcji ze źródła, czas transformacji, opóźnienie kolejki w hurtowni i moment publikacji, każde opisane jako rozkład, a nie liczba.
Czy losowość wejść oznacza złe dane?
Nie. Losowość nie jest automatycznie złą jakością danych, a technika Monte Carlo traktuje rozrzut jako wejście, a nie wroga. Deterministyczne SLA pozostaje użyteczne jako kontrakt, ale nie należy go mylić z pełną prognozą.
Kiedy modelować zakres zamiast średniej?
Zawsze wtedy, gdy decyzja zależy od zakresu prawdopodobnych wyników. Pojedyncze losowanie mówi niemal nic, dlatego liczy się powtarzanie, a prawo wielkich liczb zamienia wiele losowań w użyteczny szacunek zamiast w szum.


