Opanowanie jakości danych AI na potrzeby monitorowania przedsiębiorstw 2026
|
7
min. czyt.

Poniedziałkowy poranek zaczyna się od doskonale znanego rodzaju bólu. Pulpit nawigacyjny, na którym powinien panować spokój, miga na czerwono, liczby wyglądają podejrzanie, a nikt nie jest w stanie uzgodnić, czy problem jest rzeczywisty, czy to tylko kolejny nieaktualny strumień danych. Zanim ktoś dotrze do źródła problemu — opóźnionego pliku, powielonej partii lub niezauważonej zmiany schematu — szkody są już widoczne w notatkach ze spotkania, wynikach modelu lub pakiecie materiałów dla zarządu.
Tak wygląda obecny stan jakości danych AI w 2026 roku. Nie jest to już proste zadanie polegające na poprawianiu wartości null i usuwaniu duplikatów z wierszy, ponieważ nowoczesne potoki danych poruszają się zbyt szybko, by statyczne kontrole mogły wychwycić każdą istotną zmianę. Szczególnie w Europie dyskusja przesunęła się z pytania „czy dane są czyste?” na „czy możemy tym danym zaufać, udowodnić to i zarządzać nimi w pełnym cyklu życia?”. Dlatego Observability, audytowalność i pochodzenie danych (lineage) stoją teraz na równi z dokładnością jako kwestie priorytetowe, szczególnie w przypadku systemów AI wysokiego ryzyka i środowisk regulowanych. Dobrym punktem wyjścia jest praktyczne ujęcie obszaru observability na stronie digna's data observability overview.
Więcej niż czyste dane — nowy imperatyw
Zespół finansowy poradzi sobie z niedziałającym wykresem przez godzinę. Silnik ustalania cen — nie. Gdy strumień danych jest delikatnie opóźniony lub gdy przychodzący rozkład zmienia się na tyle nieznacznie, by zmieścić się w granicach mało elastycznej reguły, firma i tak odczuwa tego skutki. Ręczne kontrole wychwytują oczywiste błędy, ale omijają te ciche awarie, które napływają partia po partii, rekord po rekordzie.
Właśnie dlatego jakość danych AI wyrosła już ze starego podejścia typu „wyczyścimy to później”. Badania koncentrujące się na rynku unijnym traktują obecnie kontrolę jakości danych jako część szerszego procesu Data Governance, zwłaszcza tam, gdzie w grę wchodzi sztuczna inteligencja wysokiego ryzyka, a zestawy danych muszą być odpowiednie, reprezentatywne, wolne od błędów i kompletne (European Journal of Information Law analysis of Article 10). Aspekt związany z governance ma kluczowe znaczenie, ponieważ wadliwy zestaw danych to nie tylko uciążliwość przy modelowaniu, ale dowód na to, że potokowi danych nie można jeszcze zaufać.
Przejście od sprzątania do kontroli
Stary model był prosty. Inżynier danych pisał regułę, pulpit nawigacyjny zgłaszał alert, a ktoś badał sprawę już po tym, jak szkody się rozprzestrzeniły. To działa, gdy problem jest namacalny i powtarzalny. Przestaje jednak działać, gdy błąd ma charakter behawioralny — na przykład, gdy strumień danych dociera na czas, ale ze zmienionym rozkładem, lub gdy segment klientów znika bez uruchomienia kontroli wartości null.
Na tym właśnie polega współczesne observability. Nie pyta ono jedynie o to, czy kolumna istnieje. Pyta o to, czy dane nadal zachowują się tak, jak tego oczekiwano. Dla zespołów w Hiszpanii czy w całej UE to coś więcej niż wygoda — to wpisuje się w zorientowane na prawa podejście, według którego niezawodna sztuczna inteligencja zaczyna się od wiarygodnych mechanizmów kontrolnych. Przydatną, praktyczną perspektywą jest ta stosowana przez platformy stworzone z myślą o tym problemie, np. data quality dimensions and how to measure them, ponieważ wymiary mają tak samo duże znaczenie jak same narzędzia.
Praktyczna zasada: Jeśli problem z danymi może zostać wykryty tylko przez osobę otwierającą arkusz kalkulacyjny na koniec tygodnia, to dla operacyjnej sztucznej inteligencji jest już za późno.
Lepsze pytanie brzmi: czy system potrafi wykryć dryf danych, opóźnienia, duplikację i problemy z poprawnością, zanim ich objawy dostrzegą użytkownicy biznesowi. To jest teraz kluczowy standard i poprzeczka zawieszona tak samo wysoko w obszarze governance, jak i technologii.
Co naprawdę oznacza jakość danych AI
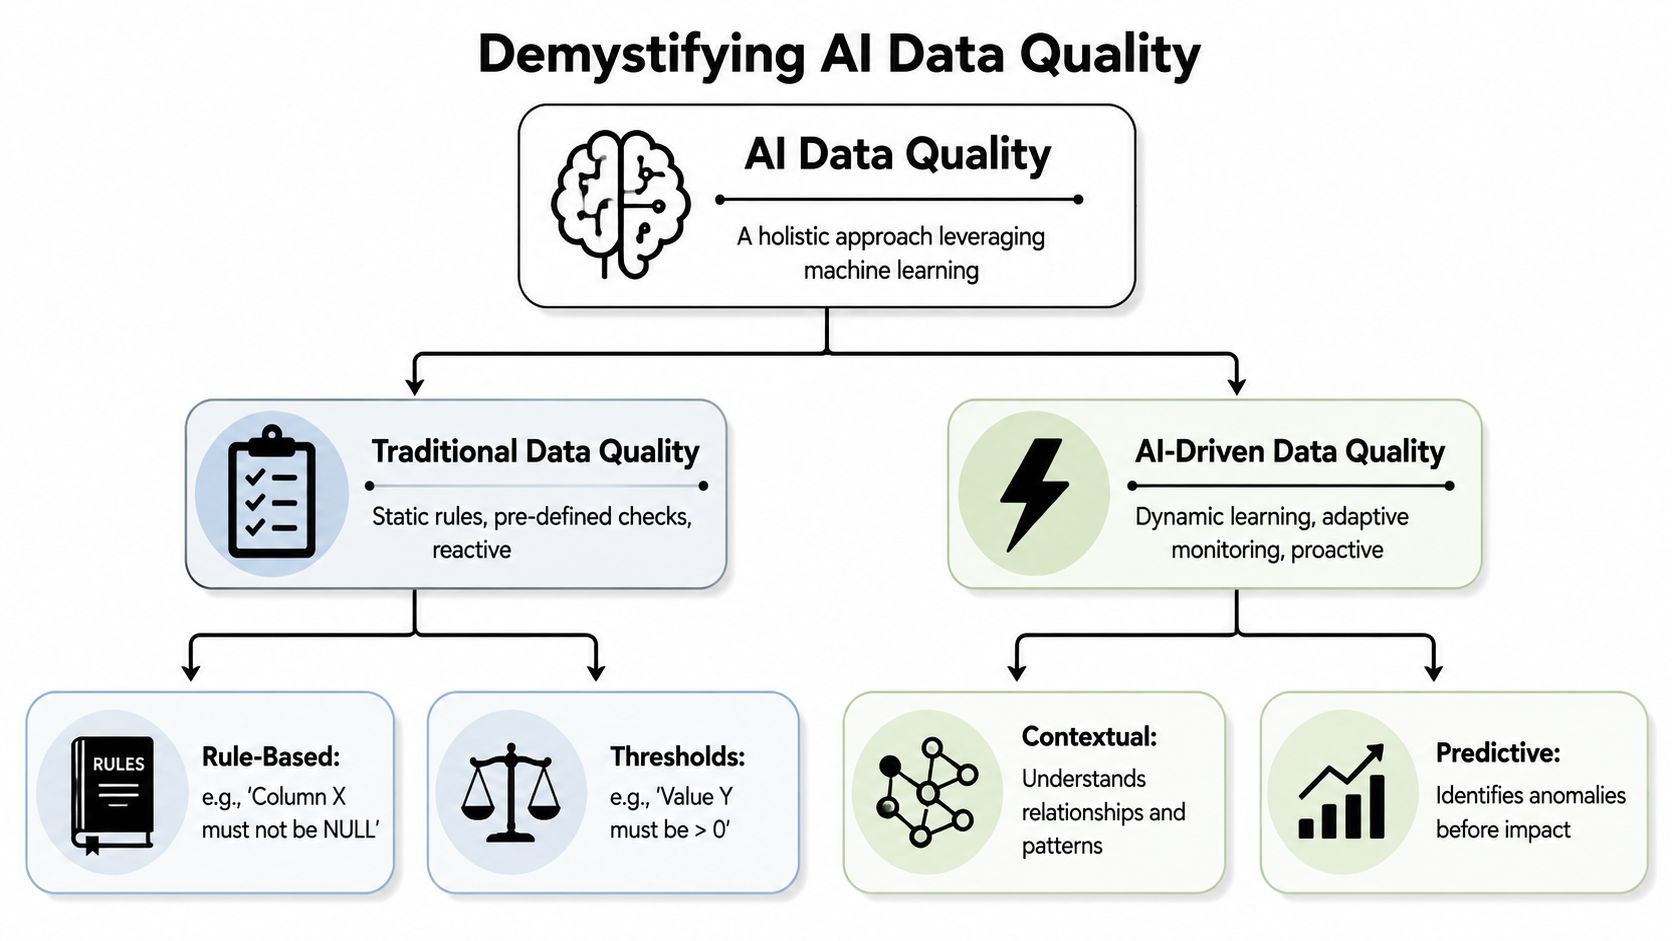
Tradycyjne kontrole danych są jak alarm samochodowy, który ma jedno zadanie — wyje, gdy otworzy się okno. Przydatne, ale mało precyzyjne. Inteligentny system bezpieczeństwa domowego obserwuje wzorce ruchu, czas otwarcia drzwi, nietypowy dostęp i kontekst tego, co jest normalne dla danego domu. Jakość danych AI działa bardziej jak ten drugi model, ponieważ uczy się rytmu pracy potoku danych, zamiast czekać na złamanie pojedynczej reguły.
Definicja FRA stanowi tutaj dobry punkt odniesienia. Mówi ona, że jakość danych dla AI obejmuje kompletność, dokładność, spójność, terminowość, duplikację, ważność, dostępność i pochodzenie (FRA report). Ma to znaczenie, ponieważ poszerza perspektywę. Zestaw danych może być dokładny w wąskim tego słowa znaczeniu, a jednocześnie bezużyteczny, jeśli dotrze z opóźnieniem, brakuje mu informacji o pochodzeniu lub zmienił się na tyle, że decyzje podejmowane na jego podstawie stają się niewiarygodne.
Statyczne reguły kontra nauczone zachowania
Monitorowanie oparte na regułach stawia pytania typu „Czy kolumna X ma wartość null?” lub „Czy wartość Y jest większa od zera?”. Te kontrole nadal są przydatne i nikt rozsądny nie powinien z nich rezygnować. Ale pozwalają one wykryć tylko te warunki, które sami wcześniej przewidzieliśmy i zakodowaliśmy.
Monitorowanie oparte na AI uczy się normalnych wzorców w czasie, biorąc pod uwagę wolumen, rozkład, sezonowość oraz relacje między polami. Może zasygnalizować zmianę, nawet jeśli surowe wartości nadal mieszczą się w sztywnym przedziale progowym. To jest kluczowa różnica i dlatego nowoczesne zespoły wykorzystują sztuczną inteligencję do uzupełniania, a nie zastępowania twardych reguł.
Wymiary, które naprawdę mają znaczenie
Ujęcie zaproponowane przez FRA pomaga również zespołom uniknąć częstego błędu, jakim jest traktowanie „jakości danych” jako jednego ogólnego wskaźnika. Tak nie jest. Wymiary te dzielą się na różne pytania operacyjne.
Kompletność określa, czy dane w ogóle istnieją.
Terminowość określa, czy dotarły wtedy, kiedy ich oczekiwano.
Spójność określa, czy rekordy nadal są ze sobą zgodne.
Pochodzenie określa, skąd pochodzą i jak się zmieniały.
Ważność określa, czy rekordy nadal mają sens w kontekście oczekiwanego kształtu biznesu.
Ta szersza definicja dobrze współgra z operacyjnym observability. System, który monitoruje trendy, zmiany schematów, opóźnienia i poprawność na poziomie rekordów, wykonuje realną pracę nad jakością danych, a nie tylko kosmetyczne porządki.
Jak AI aktywnie usprawnia monitorowanie danych
Praktyka europejskiej statystyki publicznej pokazuje już, jak to wygląda w rzeczywistości. Sztuczna inteligencja jest wykorzystywana do wspierania pozyskiwania danych, klasyfikacji, edycji, wykrywania anomalii i sugerowania imputacji, podczas gdy nadzór człowieka pozostaje w pętli decyzyjnej w celu ochrony jakości (EU official statistics webinar). To przydatny model również dla zespołów w przedsiębiorstwach, ponieważ pozwala maszynie skupić się na wykrywaniu wzorców, a ekspertowi na ocenie sytuacji.
Największą zaletą AI nie jest to, że działa jak magia. Chodzi o to, że skaluje ona czujność, której ludzie nie są w stanie utrzymać przy ręcznej pracy. Platforma może nauczyć się, że dany strumień danych zazwyczaj spływa o tej samej porze w dni powszednie lub że dany wskaźnik naturalnie rośnie po określonym zdarzeniu biznesowym, a następnie wskazać wyjątek bez konieczności pisania przez kogoś niestandardowej reguły dla każdego przypadku. Aby przyjrzeć się temu bliżej od strony produktu, warto zapoznać się z procesem opisanym w artykule how AI detects data anomalies in pipelines, który idealnie pokazuje, jak zespoły klasyfikują incydenty.
Punkty odniesienia, które zmieniają się wraz z danymi
Statyczne wartości progowe są zawodne, ponieważ to, co normalne, zmienia się w czasie. Sezonowy biznes nie ma jednego stałego wzorca, podobnie jak nowoczesny magazyn danych. Nauczanie punktu odniesienia przez AI dostosowuje się do powtarzających się zachowań, dzięki czemu alert uruchamia się przy nieoczekiwanej zmianie, a nie przy spodziewanym cyklu.
To robi ogromną różnicę podczas reagowania na incydenty. Zamiast spierać się, czy nagły skok jest „zły”, zespoły widzą, czy odbiega on od wyuczonego wzorca. Jakość sygnału rośnie, a szum informacyjny maleje.
Terminowość to kwestia jakości, a nie uciążliwość harmonogramu
Europejskie zarządzanie danymi traktuje terminowość jako formalny element jakości, a nie mało istotną kwestię operacyjną. Ramy DQI EUROCAT obejmują terminowość transmisji danych obok kompletności i dokładności (EUROCAT DQI list). To dobitne przypomnienie, że opóźniona dostawa może być tak samo szkodliwa jak błędna wartość.
Strumień danych, który dociera z dwugodzinnym opóźnieniem, może być groźniejszy niż ten z widocznym błędem, ponieważ pulpit nawigacyjny nadal wygląda poprawnie, podczas gdy firma podejmuje decyzje na podstawie nieaktualnych danych.
Tradycyjne reguły kontra monitorowanie oparte na AI
Aspekt | Tradycyjne podejście oparte na regułach | Podejście oparte na AI |
|---|---|---|
Sposób wykrywania | Sztywne progi i ręcznie przygotowywane kontrole | Uczy się zachowań i wypatruje odchyleń |
Czas reakcji | Często reaktywny | Proaktywny i ciągły |
Zakres | Ograniczony do znanych typów błędów | Lepszy w wykrywaniu nieznanych anomalii |
Utrzymanie | Reguły wymagają ciągłej aktualizacji | Modele dostosowują się w miarę rozwoju potoków danych |
Terminowość | Zazwyczaj oddzielona od innych kontroli | Monitorowana jako część normalnego zachowania |
W przypadku zespołów zarządzających złożonymi potokami danych ta zmiana przekształca monitorowanie z alarmu przeciwpożarowego w system wczesnego ostrzegania.
Prawdziwe korzyści i ukryte zagrożenia
Najlepszy argument za jakością danych AI jest prosty. Skraca ona czas, jaki zespoły spędzają na pisaniu i utrzymywaniu mało elastycznych testów, oraz wychwytuje problemy, których nikt nie pomyślał wcześniej zakodować. Ma to kluczowe znaczenie, gdy potoki danych często się zmieniają, a rodzaje błędów stale ewoluują. Zwiększa to również zaufanie, ponieważ analitycy i użytkownicy biznesowi przestają postrzegać kontrole jakości jako zapleczowy rytuał, a zaczynają dostrzegać w nich część samego produktu.
Głębsze korzyści płyną z tego również w branżach regulowanych. Badania praktyków zgodne z regulacjami UE wykazały, że brakujące dane były głównym problemem jakościowym, podczas gdy kwestie prywatności (37%) stanowiły poważny powód do niepokoju (EU-aligned practitioner research). To przypomnienie, że dbałość o jakość w finansach, opiece zdrowotnej i telekomunikacji musi odbywać się w kontrolowanych środowiskach, a nie po tym, jak wrażliwe dane zostaną przesłane gdzie indziej w celu weryfikacji.
Co poprawia się najszybciej
Zespoły zazwyczaj najpierw zauważają trzy praktyczne korzyści. Pierwszą z nich jest ograniczenie ręcznej klasyfikacji błędów, ponieważ system odfiltrowuje oczywisty szum, zanim zaangażuje się człowiek. Drugą jest wcześniejsze ostrzeganie o nieznanych problemach, co ma większe znaczenie niż idealne sklasyfikowanie każdego incydentu. Trzecią jest większa pewność co do raportów końcowych, dzięki czemu ludzie rzadziej tworzą własne, nieoficjalne kontrole.
To zaufanie jest jednak kruche. Jeśli sama warstwa monitorowania stanie się nieprzejrzysta lub jeśli każdy nietypowy przypadek będzie wywoływał uciążliwy alert, wdrażanie rozwiązania utknie w martwym punkcie. Zmęczenie alertami może zabić dobry system szybciej niż wadliwe modelowanie.
Kompromis w kwestii prywatności, który większość artykułów pomija
Dostawca, który kopiuje wrażliwe dane poza kontrolowane środowisko, tworzy nowy problem, próbując rozwiązać stary. Dla zespołów podlegających regulacjom bezpieczniejszym modelem jest zazwyczaj monitorowanie wewnątrz bazy danych (in-database) lub lokalne (on-prem), gdzie analiza odbywa się tuż obok danych, a nie poprzez przenoszenie danych do narzędzia analitycznego. Taka architektura odpowiada sektorom wymagającym domyślnej ochrony prywatności (privacy by default) i jest to jeden z powodów, dla których wybór platformy ma większe znaczenie niż lista funkcji.
To samo napięcie między prywatnością a governance pojawia się w badaniach medycznych. Przydatną analogią jest mastering clinical test accuracy, ponieważ pomaga ona zrozumieć, dlaczego czułość, specyficzność i kontekst mają kluczowe znaczenie, gdy koszt błędnego sygnału jest wysoki.
Dlaczego architektura jest częścią historii o jakości
digna działa w środowisku klienta, lokalnie lub w chmurze prywatnej, a z jej dokumentacji wynika, że nigdy nie jest dostarczana w modelu SaaS, co uniemożliwia dostawcy dostęp do danych klienta (digna docs in Spanish). Ten wybór projektowy to nie chwyt marketingowy. Bezpośrednio odpowiada on na praktyczną barierę, przed którą stoi wiele europejskich zespołów — jak poprawić jakość bez osłabiania kontroli.
Ma to również znaczenie jako dowód na potrzeby governance. Jeśli system sprawdzający jakość działa w zabezpieczonym środowisku, historia audytu jest przejrzysta, a weryfikacja bezpieczeństwa zazwyczaj o wiele mniej uciążliwa.
Wdrażanie jakości danych AI w przedsiębiorstwie
Wdrożenie w przedsiębiorstwie zazwyczaj kończy się niepowodzeniem z jednego z dwóch powodów. Albo zespół kupuje błyszczące nowe narzędzie przed zdefiniowaniem problemu operacyjnego, albo podpina je pod proces, za który nikt nie ponosi odpowiedzialności. Lepsza ścieżka jest węższa i mniej spektakularna. Wybierz jeden krytyczny potok danych, jednego odbiorcę biznesowego i jeden zestaw problemów z jakością, które już teraz dają się we znaki.
Dzięki temu kryteria oceny stają się wyraźniejsze. Prawdziwa platforma powinna integrować się z obecnym stosem technologicznym, uczyć się wzorców bez nieskończonego ręcznego pisania reguł, dostarczać inżynierom i analitykom wystarczających wyjaśnień, by mogli zaufać wynikom, oraz działać w modelu bezpieczeństwa, z którego Twoja organizacja już korzysta. Jeśli nie potrafi tego zrobić, stanie się bezużytecznym oprogramowaniem z ładnym pulpitem nawigacyjnym.
Na co zwrócić uwagę przed jakimkolwiek wdrożeniem
Głębokość integracji: Narzędzie powinno współpracować z Twoim magazynem danych, jeziorem danych (lake) i potokami bez wymuszania tworzenia równoległego stosu.
Przejrzystość modelu: Zespoły muszą rozumieć, dlaczego coś zostało oflagowane, a nie tylko wiedzieć, że tak się stało.
Dopasowanie do governance: Narzędzie powinno dostarczać dowodów wspierających walidację, testowanie i przeglądy.
Kontrola nad wdrożeniem: W przypadku wrażliwych obciążeń szukaj rozwiązań działających w chmurze prywatnej lub lokalnie (on-prem).
Użyteczność dla różnych użytkowników: Inżynierowie, analitycy i liderzy governance potrzebują różnych widoków tego samego problemu.
Ten ostatni punkt bywa niedoceniany. Jeśli z narzędzia może korzystać tylko jeden specjalista, proces się nie skaluje.
Naciski regulacyjne zmieniają decyzje zakupowe
Zgodnie z unijnym aktem o sztucznej inteligencji (EU AI Act) zestawy danych dla systemów AI wysokiego ryzyka muszą podlegać procesom governance przez cały cykl życia, aby pozostały odpowiednie, reprezentatywne, wolne od błędów i kompletne (EU AI Act analysis). Oznacza to, że wykrywanie anomalii, kontrole stronniczości i obsługa brakujących danych nie są opcjonalnymi dodatkami. Stanowią one część płaszczyzny kontrolnej (control plane).
Platforma z możliwością wykonywania operacji bezpośrednio w bazie danych (in-database) może pomóc, ponieważ utrzymuje analizę blisko danych i zachowuje ścieżkę dowodową. Jest to szczególnie przydatne, gdy zespoły ds. governance muszą wykazać, w jaki sposób zestaw danych był monitorowany, a nie tylko twierdzić, że został „wyczyszczony”.
Jednym z praktycznych podejść jest rozpoczęcie od strumienia danych, który ma już bezpośredni wpływ na przychody, zgodność z przepisami (Compliance) lub doświadczenia klientów. Udowodnij, że system potrafi wychwycić opóźnienia, zmiany schematów lub skoki zmienności, zanim staną się one widoczne dla biznesu, a dopiero potem go rozwijaj. To podejście za każdym razem wygrywa z wdrażaniem narzędzia od razu na szeroką skalę.
Twoje kolejne kroki w kierunku inteligentnego monitorowania danych
Główna zmiana jest już widoczna. Jakość danych AI nie jest ozdobną warstwą nałożoną na stare reguły — to model operacyjny dla danych, które zmieniają się zbyt szybko, by pilnować ich ręcznie. Organizacje, które podchodzą do tego właściwie, przestają spierać się o to, czy każdy wiersz jest idealny, a zaczynają skupiać się na tym, czy potok danych jest godny zaufania, wyjaśnialny i gotowy do audytu.
Jeśli chcesz pchnąć ten temat do przodu w przyszłym tygodniu, postaw na prostotę.
Wybierz jeden potok o wysokiej wartości i wypisz błędy jakościowe, które negatywnie wpływają na decyzje.
Przetestuj, jak Twoje obecne narzędzia radzą sobie z nieznanymi anomaliami, a nie tylko ze znanymi naruszeniami reguł.
Włącz observability do dyskusji o governance, tak aby działy compliance, inżynierii i analiz patrzyły na te same dowody.
Jako praktyczny punkt wyjścia, przyjrzyj się digna's data quality monitoring tools i zestaw je z obecnymi wzorcami incydentów, ograniczeniami wdrożeniowymi oraz potrzebami audytowymi. Następnie przedstaw tę krótką listę przy najbliższym przeglądzie platformy danych, zadając jedno jasne pytanie: czy ta konfiguracja może chronić zaufanie do danych bez spowalniania działalności biznesowej?
Wezwanie do działania (CTA) dla digna.
Jak wyuczone linie bazowe, Timeliness i monitorowanie schematów współdziałają w środowisku klienta, a nie w chmurze dostawcy, pokazuje digna dla obserwowalności platform danych.
Najczęściej zadawane pytania
Czym jest jakość danych wspierana przez AI?
Jakość danych wspierana przez AI to monitorowanie, które uczy się normalnych wzorców pipeline'u w czasie, wolumenie, rozkładzie, sezonowości i relacjach między polami, a następnie sygnalizuje odchylenia nawet wtedy, gdy wartości mieszczą się w stałych progach. Artykuł porównuje je do inteligentnego systemu ochrony domu, a tradycyjne kontrole do alarmu samochodowego z jedną funkcją.
Jakie wymiary definiują jakość danych dla AI?
Zgodnie z przytoczoną w artykule definicją FRA jakość danych dla AI obejmuje kompletność, dokładność, spójność, terminowość, duplikację, poprawność, dostępność i pochodzenie. To poszerza perspektywę: zbiór danych może być dokładny w wąskim sensie, a mimo to bezużyteczny, jeśli dociera z opóźnieniem, nie ma udokumentowanego pochodzenia lub uległ przesunięciu.
Czy AI zastępuje kontrole jakości danych oparte na regułach?
Nie, AI uzupełnia sztywne reguły, a nie je zastępuje. Kontrole typu „Czy kolumna X jest null?” lub „Czy wartość Y jest większa od zera?” pozostają przydatne, ale wychwytują tylko warunki już zakodowane. Monitorowanie oparte na uczeniu obejmuje także nieznane anomalie, np. feed dostarczony na czas, lecz ze zmienionym rozkładem.
Czego EU AI Act wymaga w zakresie jakości danych treningowych?
Zgodnie z EU AI Act zbiory danych dla systemów AI wysokiego ryzyka muszą być zarządzane przez cały cykl życia tak, aby pozostały adekwatne, reprezentatywne, wolne od błędów i kompletne. Artykuł wnioskuje, że wykrywanie anomalii, kontrole stronniczości i obsługa brakujących danych stają się częścią warstwy kontrolnej, a nie opcjonalnym dodatkiem.
Jak przedsiębiorstwo powinno zacząć wdrażanie jakości danych wspieranej przez AI?
Zacznij wąsko: wybierz jeden krytyczny pipeline, jednego odbiorcę biznesowego i zestaw pytań o jakość, które już sprawiają problemy. Udowodnij, że system wychwytuje opóźnione dostawy, zmiany schematu lub zmiany zmienności, zanim zauważy je biznes, a potem rozszerzaj, oceniając integrację, przejrzystość modelu, zgodność z governance, kontrolę wdrożenia i użyteczność dla różnych ról.



