Jak mierzyć kompletność danych: 8 praktycznych metod
|
8
min. czyt.
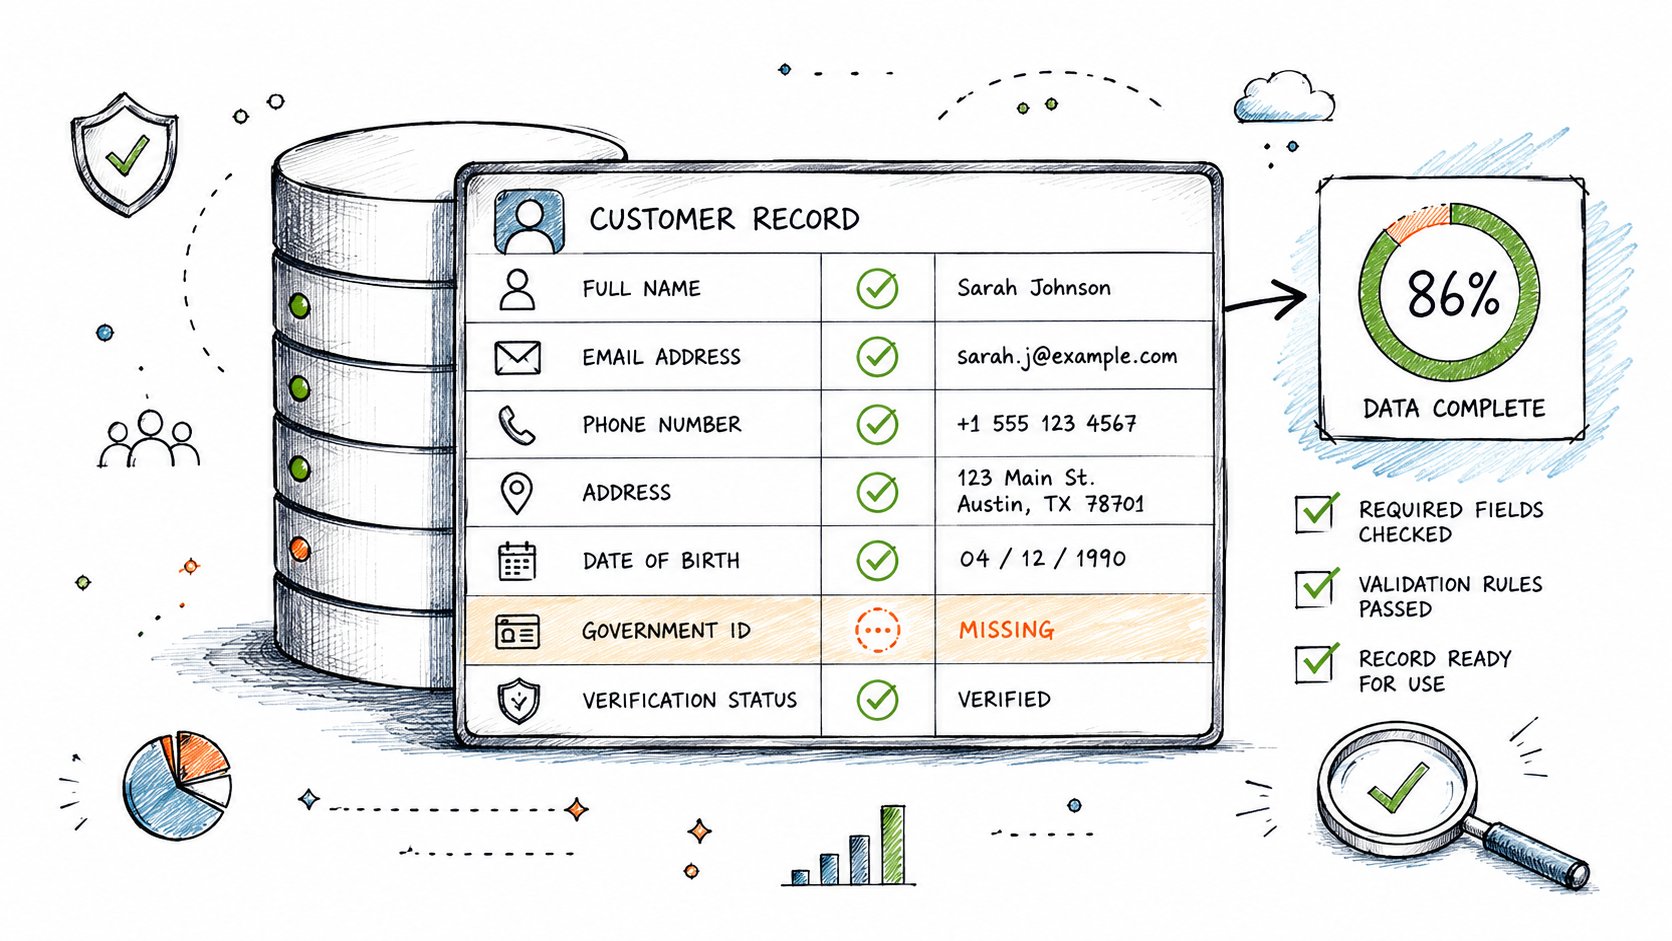
Kompletność danych (Data Completeness) mierzy się poprzez porównanie wymaganych danych obecnych w zbiorze z danymi oczekiwanymi. Podstawowy wzór to Wskaźnik kompletności = (Rekordy z danymi / Wszystkie rekordy) × 100, co oznacza, że 9800 uzupełnionych numerów telefonów na 10 000 oczekiwanych wartości daje wskaźnik kompletności na poziomie 98% (Data Quality Sense wyjaśnia standardowe obliczenia).
Potok transakcyjny może zgłosić pomyślne załadowanie, pozostawiając firmę z niekompletnymi danymi. Liczba rekordów może gwałtownie spaść, wymagane pola klientów mogą zawierać więcej wartości NULL niż zwykle, a cały plik raportu może nigdy nie dotrzeć. Potok został uruchomiony, ale zestaw danych może nie być wystarczająco kompletny dla decyzji podejmowanej w dalszej części procesu.
Kompletność danych to stopień, w jakim obecne są wszystkie dane wymagane do zamierzonego zastosowania. Obejmuje to brakujące wartości pól, brakujące rekordy, brakujące transakcje, brakujące zestawy danych, brakujące okresy historyczne oraz brakujące wymagane atrybuty. Rekord klienta z prawidłowym imieniem i nazwiskiem oraz adresem, ale bez identyfikatora klienta, jest niekompletny dla każdego procesu, który zależy od tego identyfikatora.
Niezawodny monitoring musi zatem wykraczać poza pojedynczą wartość procentową. Powinien badać uzupełnione pola, kompletne rekordy, wolumeny rekordów, oczekiwane zestawy danych, czas dostarczenia i nietypowe zmiany historyczne. Osiem praktycznych metod przedstawionych poniżej buduje ten obraz krok po kroku, łącząc każdy pomiar z walidacją, detekcją anomalii, terminowością i analizą historyczną w digna.
Spis treści
1. Wskaźnik kompletności pól
Profil klienta może zawierać imię, nazwisko i adres, ale pozostawać bezużyteczny, jeśli wymagany identyfikator klienta jest pusty. Wskaźnik kompletności pól mierzy tę pierwszą warstwę kompletności: jak wiele wartości oczekiwanych w jednej kolumnie jest uzupełnionych. Weryfikacja obejmuje wartości NULL, puste ciągi znaków i inne zdefiniowane znaczniki brakujących danych.
Użyj następującego wzoru:
Wskaźnik kompletności = uzupełnione wartości / oczekiwane wartości × 100
Na przykład, jeśli tabela kont zawiera 4500 oczekiwanych adresów e-mail, z czego 4365 jest uzupełnionych, wskaźnik kompletności pola wynosi 97%. Ta metoda oparta na wartościach procentowych jest zgodna z wskazówkami dotyczącymi kompletności Data Quality Sense.
Mianownik musi być dopasowany do reguły biznesowej. Identyfikator klienta może być wymagany dla każdej transakcji, więc wszystkie wiersze transakcji powinny znaleźć się w mianowniku. Pole, które dotyczy wyłącznie kwalifikujących się klientów, powinno być mierzone w odniesieniu do tej właśnie grupy. Liczenie nieadekwatnych wierszy jako brakujących danych sztucznie zaniżyłoby wynik w stosunku do rzeczywistego stanu procesu.
Ustalanie progów na podstawie potrzeb biznesowych
Wartość 100% to idealny punkt odniesienia dla wielu pól podlegających nadzorowi. Wymagane poziomy świadczenia usług (SLA) dla pól mogą być ustalone powyżej 95%, w zależności od ryzyka biznesowego i konsekwencji brakujących wartości, zgodnie z opisem praktyk ustalania celów przez SailPoint. Identyfikator transakcji może wymagać pełnego pokrycia, podczas gdy cecha opisowa o niższym ryzyku może dopuszczać pewne braki, jeśli użytkownicy końcowi są świadomi tego ograniczenia.
Ustal próg dla każdego ważnego pola, zamiast polegać na średniej dla całego zestawu danych. Średnia może ukryć poważne braki w kolumnie identyfikatora. Data Quality Sense zaleca traktowanie wskaźnika wartości null jako kluczowego sygnału kompletności, dlatego należy połączyć ten wskaźnik z jawnymi kontrolami wartości NULL i pustych pól.
W digna narzędzie digna Data Validation pozwala na uruchamianie takich kontroli dla identyfikatorów klientów, kwot transakcji, znaczników czasu, numerów kont i innych obowiązkowych atrybutów. Wyniki można zapisywać według pól i systemów źródłowych. Taka historia wspiera walidację przy wprowadzaniu danych, detekcję anomalii po wprowadzeniu zmian oraz późniejsze porównania kompletności w różnych okresach.
Zasada praktyczna: Przed ustaleniem progów należy udokumentować, których pól wymaga dany proces biznesowy. Wartość procentowa ma znaczenie tylko wtedy, gdy jasne są oczekiwana grupa odbiorców i zamierzone zastosowanie.
2. Monitorowanie liczby rekordów
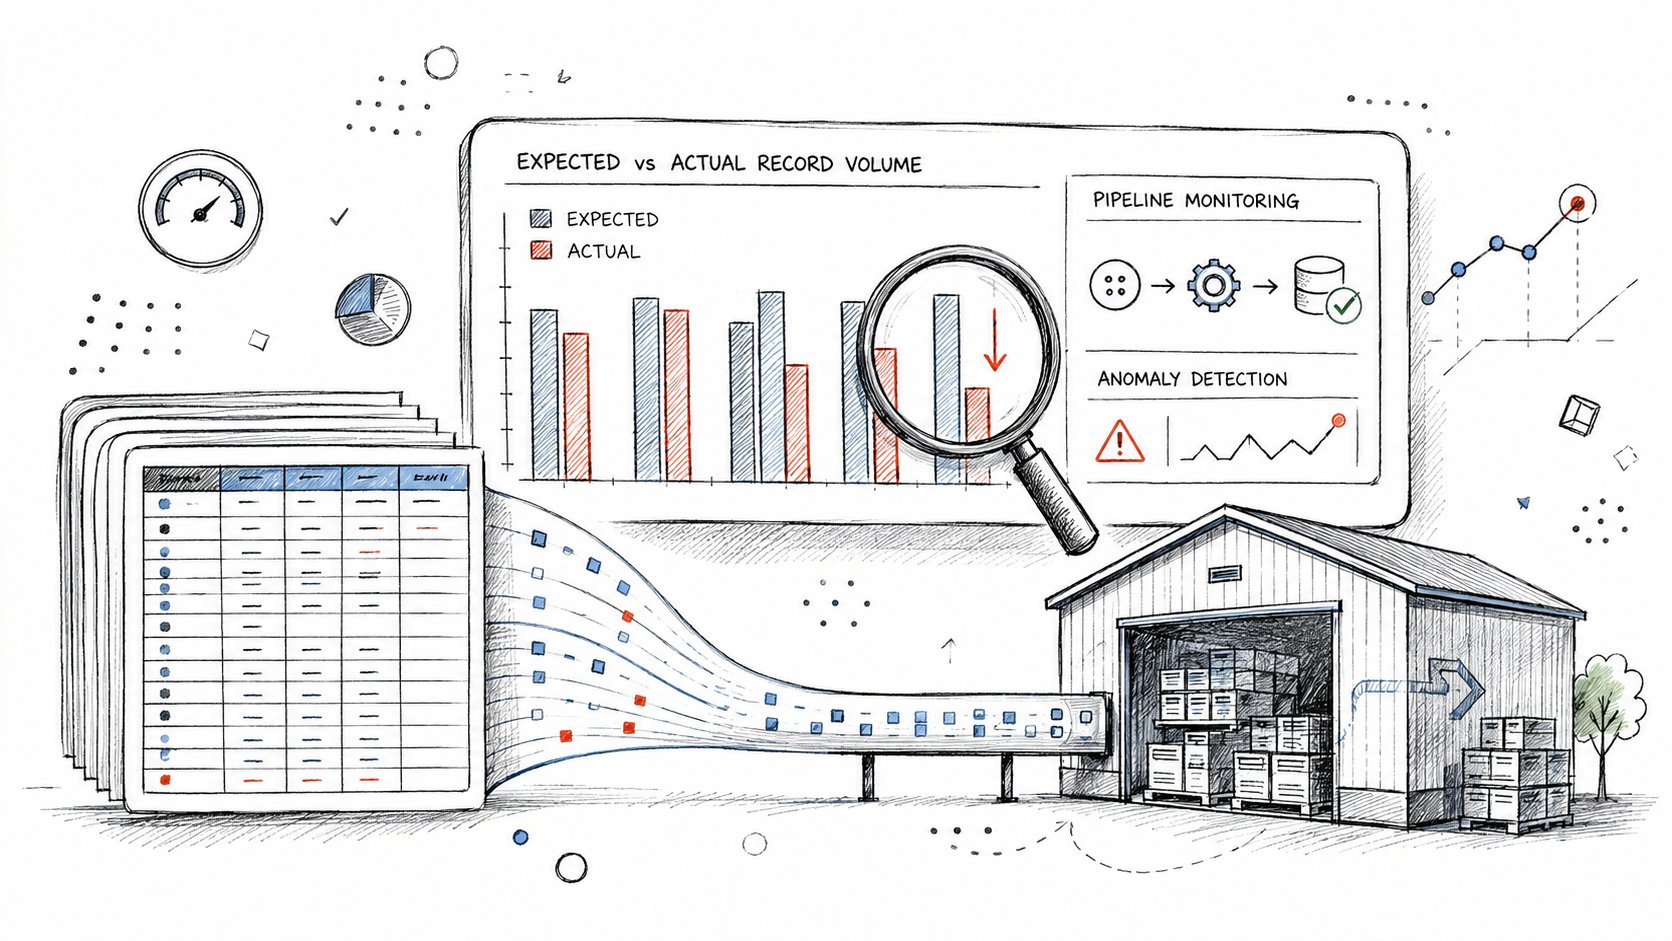
Zbiór danych może zawierać prawidłowo uzupełnione pola, a mimo to być niekompletny, ponieważ całe rekordy nigdy do niego nie trafiły. Monitorowanie liczby rekordów porównuje liczbę załadowanych wierszy z oczekiwanym wolumenem, określonym minimum lub historycznym zachowaniem tego samego zestawu danych.
Weźmy pod uwagę dzienną tabelę transakcji, która zazwyczaj otrzymuje 10 milionów rekordów, ale nagle zawiera ich tylko 7 milionów. Taka zmiana może wskazywać na niekompletne ładowanie danych lub brakujące rekordy źródłowe. Ten przykład jest częścią dostarczonego scenariusza operacyjnego i ilustruje, dlaczego pomyślny status potoku nie dowodzi, że dostarczono wszystkie oczekiwane zdarzenia biznesowe.
Kontrola liczby rekordów działa na dwóch poziomach. Reguła bezwzględna może sygnalizować liczbę poniżej zdefiniowanego przez biznes minimum. Kontrola porównawcza może wskazać nietypową zmianę w stosunku do historii samego zestawu danych. Drugie podejście jest szczególnie cenne, gdy rzeczywisty wolumen różni się w zależności od dnia tygodnia, sezonu, regionu lub cyklu księgowego.
Badanie spadków i wzrostów
Naglący spadek jest oczywistym ostrzeżeniem, ale nieoczekiwany wzrost również może wskazywać na duplikację, powtórne przetworzenie plików, niekontrolowane powielenie wierszy przy łączeniu tabel (join explosion) lub zmianę w systemie źródłowym. Zespoły powinny rejestrować liczbę rekordów wraz z czasem ładowania, partycją, źródłem i datą biznesową, aby osoby badające problem mogły szybko zawęzić obszar usterki.
Unikaj kopiowania ogólnych zakresów z innych zestawów danych. Określ oczekiwane zachowanie na podstawie historii danej tabeli, a następnie uwzględnij znane cykle biznesowe, takie jak przetwarzanie na koniec miesiąca lub popyt sezonowy. Dane źródłowe mogą również docierać partiami, dlatego kontrola powinna odbywać się w momencie, gdy ładowanie powinno być już zakończone.
Narzędzie digna Data Anomalies potrafi zidentyfikować nietypowe zachowanie wolumenu rekordów bez zmuszania inżynierów do utrzymywania osobnego progu dla każdej tabeli. Skoreluj sygnał wolumenu z kompletnością pól. Niższa liczba wierszy połączona ze wzrostem liczby brakujących identyfikatorów klientów wskazuje na szerszy problem z wprowadzaniem danych, podczas gdy mniejsza liczba wierszy przy stabilnym pokryciu pól sugeruje brak partycji lub segmentu biznesowego.
Monitorowanie liczby rekordów dotyczy również brakujących wierszy w danym okresie. Jeśli system źródłowy powinien dostarczać transakcje dla każdego regionu lub jednostki biznesowej, porównaj liczby według tych wymiarów, a nie tylko na poziomie całej tabeli. Kompletna na pierwszy rzut oka suma może ukrywać brak danych z jednego regionu, który został zrekompensowany wyższą aktywnością w innym miejscu.
3. Monitorowanie wskaźnika wartości NULL
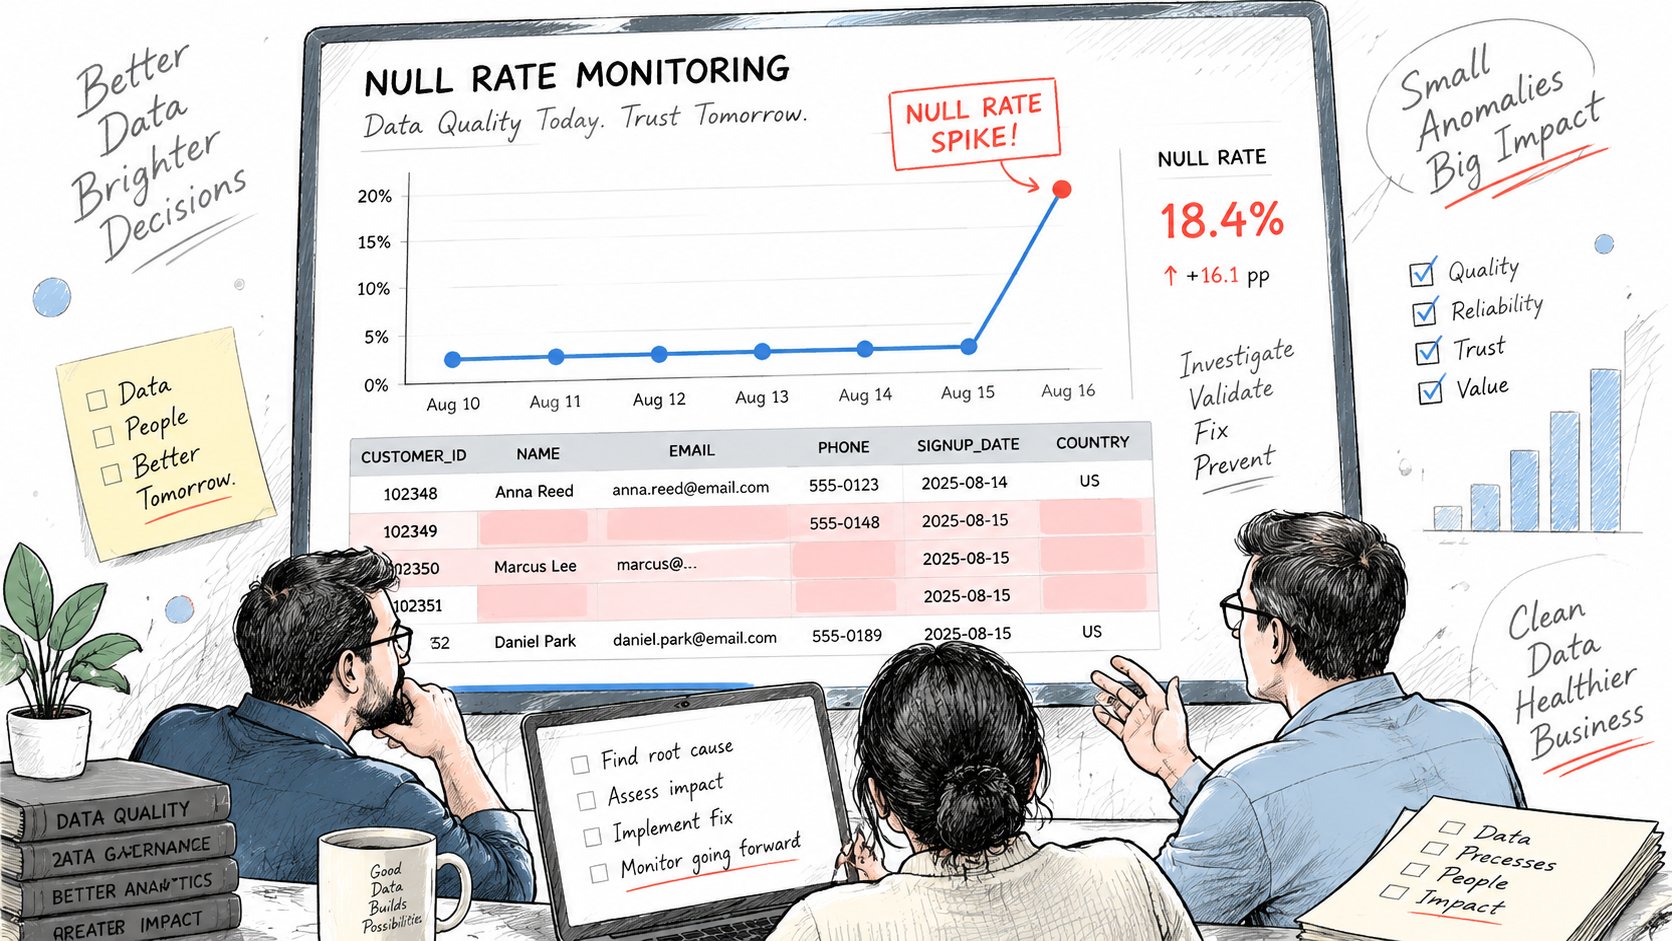
Monitorowanie wskaźnika wartości NULL mierzy udział brakujących wartości w stosunku do wartości oczekiwanych i śledzi ten udział w czasie. Na poziomie pola oblicza się go następująco:
Wskaźnik wartości NULL = wartości null lub puste / wszystkie oczekiwane wartości × 100
Kompletność i wskaźnik wartości NULL opisują dwie strony tego samego stanu. Kompletność pokazuje to, co jest uzupełnione; wskaźnik wartości NULL pokazuje to, czego brakuje. Data Quality Sense wskazuje wskaźnik wartości NULL jako kluczową miarę kompletności.
Bieżący wskaźnik to tylko część oceny. Pole ze stabilnym, akceptowalnym poziomem braków danych może wspierać przeznaczony dla niego proces, podczas gdy nagły wzrost może wskazywać na uszkodzony interfejs, zmienione mapowanie, nieudaną transformację lub zmodyfikowane zachowanie źródła. Porównaj bieżący wynik z linią bazową dla danego pola i powiąż go z wynikami walidacji, czasem ładowania oraz zmianami w źródłach.
Traktowanie braków danych jako kontekstu, a nie tylko liczby
Wartość NULL nie zawsze oznacza to samo. Może reprezentować wartość, która nie została przechwycona, pole, które nie ma zastosowania, celowe pominięcie lub specjalny stan kodowany inaczej w różnych systemach. Przed obliczeniem skorygowanej miary kompletności należy sklasyfikować wartości NULL, puste ciągi znaków, teksty zastępcze (placeholdery) oraz specjalne kody. Niezależna dokumentacja jakości danych ostrzega, że uproszczone podejście do braków danych może wprowadzać w błąd, gdy brakujące wartości są błędnie zakodowane.
Reguły kwalifikacji zapobiegają sytuacji, w której dozwolony brak zastosowania jest traktowany jako błąd. Na przykład pole kontaktu do faktury należy sprawdzać tylko w rekordach, dla których taki kontakt jest wymagany. Warto też oddzielić źródła i ścieżki wprowadzania danych, ponieważ baza klientów i ręcznie obsługiwany system serwisowy mogą mieć różne standardowe wzorce.
Praktyczny model monitorowania łączy cztery kontrole:
Wymóg statyczny: Alert, gdy wymagane pole przekracza dopuszczalny wskaźnik wartości NULL.
Zmiana historyczna: Alert, gdy bieżący wskaźnik odbiega od linii bazowej pola.
Porównanie źródeł: Badanie zachowania według systemu źródłowego, regionu lub ścieżki wprowadzania danych.
Korelacja zmian: Przegląd wdrożeń, zmian interfejsów i aktualizacji mapowania obok przesunięć wskaźnika wartości NULL.
Materiały referencyjne dotyczące kompletności Data Quality Sense opisują liczby pól uzupełnionych, pustych i niekompletnych jako przydatne widoki monitorowania. Statystyki te łączą alert z procesem badania problemu. Analitycy mogą zidentyfikować dotknięte rekordy, źródła, okresy i warunki biznesowe, a następnie porównać wzorzec braków z błędami walidacji lub opóźnieniami w ładowaniu.
4. Ocena kompletności rekordów
Kompletność pól odpowiada na pytanie, czy poszczególne kolumny są uzupełnione. Ocena kompletności rekordów sprawdza, czy każdy rekord zawiera pełen zestaw atrybutów wymaganych dla konkretnego procesu. To rozróżnienie ma znaczenie, ponieważ poszczególne pola mogą wyglądać poprawnie, podczas gdy te same rekordy klientów pozostają tylko częściowo uzupełnione.
Załóżmy, że rekord klienta wymaga identyfikatora klienta, imienia i nazwiska, adresu e-mail oraz adresu zamieszkania. Kompletność rekordów mierzy, ile rekordów klientów zawiera wszystkie cztery wymagane atrybuty. Wynik typu 97% rekordów klientów zawiera wszystkie wymagane atrybuty daje właścicielom procesów inną wiedzę niż cztery osobne wskaźniki procentowe dla poszczególnych pól. Definicję i sposób obliczania na poziomie rekordu opisują wskazówki dotyczące kompletności The Pedowitz Group.
Właściwe wymagania zależą od dalszego zastosowania danych. Proces oceny ryzyka kredytowego może wymagać w pełni kompletnego wniosku kredytowego przed jego rozpatrzeniem. Proces fakturowania może wymagać numeru konta, adresu do wysyłki faktury i kontaktu rozliczeniowego. Raportowy zestaw danych może wymagać znacznika czasu i klucza biznesowego, nawet jeśli pole opisowe jest opcjonalne.
Znajdowanie wzorców stojących za niekompletnymi rekordami
Zacznij od reguły na poziomie rekordu, która ocenia wszystkie obowiązkowe pola razem. Następnie zachowaj informacje o konkretnych przyczynach błędów. Wynik zbiorczy informuje, ile rekordów jest użytecznych, podczas gdy przyczyny na poziomie pól wskazują, co uniemożliwia wykorzystanie pozostałych rekordów.
Na przykład rekord zakupu w sklepie internetowym może wymagać identyfikatora zamówienia, identyfikatora klienta, identyfikatora produktu, ilości, ceny i znacznika czasu. Rekord, w którym brakuje jednej z tych wartości, powinien zostać odrzucony przez regułę kompletności rekordu, jeśli analityka przychodów zależy od pełnej kombinacji tych danych.
Użyj digna Data Validation do przeprowadzania kontroli na poziomie rekordu pod kątem sprecyzowanych wymagań biznesowych. Rozdzielaj typy rekordów, jeśli różnią się wymaganiami. Klient, transakcja, roszczenie i zamówienie usługi nie powinny automatycznie dzielić tej samej definicji kompletności.
Kompletny rekord to nie to samo co kompletny zestaw danych. Potrzebujesz obu tych perspektyw, aby zrozumieć, czy poszczególne wiersze nadają się do użytku i czy w ogóle dotarła oczekiwana grupa danych.
Śledź dwa parametry wyjściowe:
Pokrycie kompletnych rekordów: Udział rekordów spełniających wszystkie wymagania dla zamierzonego procesu.
Struktura błędów: Pola, których najczęściej brakuje w niekompletnych rekordach.
Ta kombinacja ułatwia naprawę danych. Jeśli w wielu rekordach brakuje tylko kilku tych samych pól, napraw źródło lub mapowanie. Jeśli w małej grupie rekordów brakuje wielu różnych pól, zbadaj konkretne źródło, typ rekordu lub partycję wprowadzania danych.
5. Weryfikacja kompletności zestawu danych i okresu
Niektóre problemy z kompletnością pojawiają się powyżej poziomu wierszy i kolumn. Może brakować całego oczekiwanego zestawu danych, jednego okresu sprawozdawczego lub źródło może przestać dostarczać dane dla określonego regionu. Weryfikacja kompletności zestawu danych i okresu odpowiada na pytanie, czy oczekiwane pliki, tabele, partycje i daty biznesowe w ogóle istnieją.
Typowe kontrole obejmują:
Przybycie oczekiwanego pliku: Potwierdzenie, czy dotarł dzienny plik sprzedaży lub rozliczeń.
Pokrycie okresu: Weryfikacja, czy reprezentowane są wszystkie oczekiwane dni, miesiące lub kwartały.
Pokrycie źródła: Sprawdzenie, czy każdy region biznesowy lub system nadrzędny dostarczył dane.
Obecność partycji: Potwierdzenie, czy hurtownia danych zawiera oczekiwane partycje dat i podmiotów.
Zestaw danych może pomyślnie przejść walidację na poziomie pól, ponieważ wiersze, które dotarły, są idealnie uzupełnione. Taki wynik wciąż jednak nie uzasadnia publikacji raportu, jeśli brakuje całego okresu sprawozdawczego. Kompletność musi być oceniana w odniesieniu do kalendarza raportowania i zakresu biznesowego.
Dodanie czasu dostarczenia do definicji kompletności
Czas dostarczenia dostarcza sygnału operacyjnego. Jeśli dzienny plik jest oczekiwany w określonym przedziale czasowym i nie dotarł, zestaw danych jest niedostępny dla procesu, nawet jeśli ostatecznie się pojawi. Moduł digna Timeliness pozwala monitorować wzorce przybycia danych, flagować brakujące lub opóźnione ładowania oraz obliczać oczekiwane czasy dostarczenia na podstawie zaobserwowanego zachowania.
Dla praktycznych ram kontroli kompletności danych zdefiniuj oczekiwania dla każdego zestawu danych:
Wskaż źródło i miejsce docelowe.
Określ oczekiwaną datę biznesową lub partycję.
Zdefiniuj okno dostarczenia i strefę czasową.
Zarejestruj zależności od plików lub zadań nadrzędnych.
Ustaw działanie naprawcze na wypadek braku lub opóźnienia dostawy.
Takie podejście pomaga zespołom wychwycić brakujący dzienny plik sprzedaży, zanim panel nawigacyjny (dashboard) uruchomi się z niewidoczną luką. Wspiera to również gromadzenie danych dla zespołów IEP, gdzie oczekiwane okresy i wymagane rekordy muszą być śledzone w sposób jawny, a nie tylko wnioskowane z jakichkolwiek dostępnych danych.
Udokumentuj źródła zapasowe i procedury ponownego uruchamiania. Brak zestawu danych może wynikać z awarii źródła, błędu harmonogramu zadań, odrzuconego pliku lub opóźnionego zadania nadrzędnego. Alert powinien kierować osoby badające problem ku tym właśnie możliwościom, zamiast traktować każdy brak w ten sam sposób.
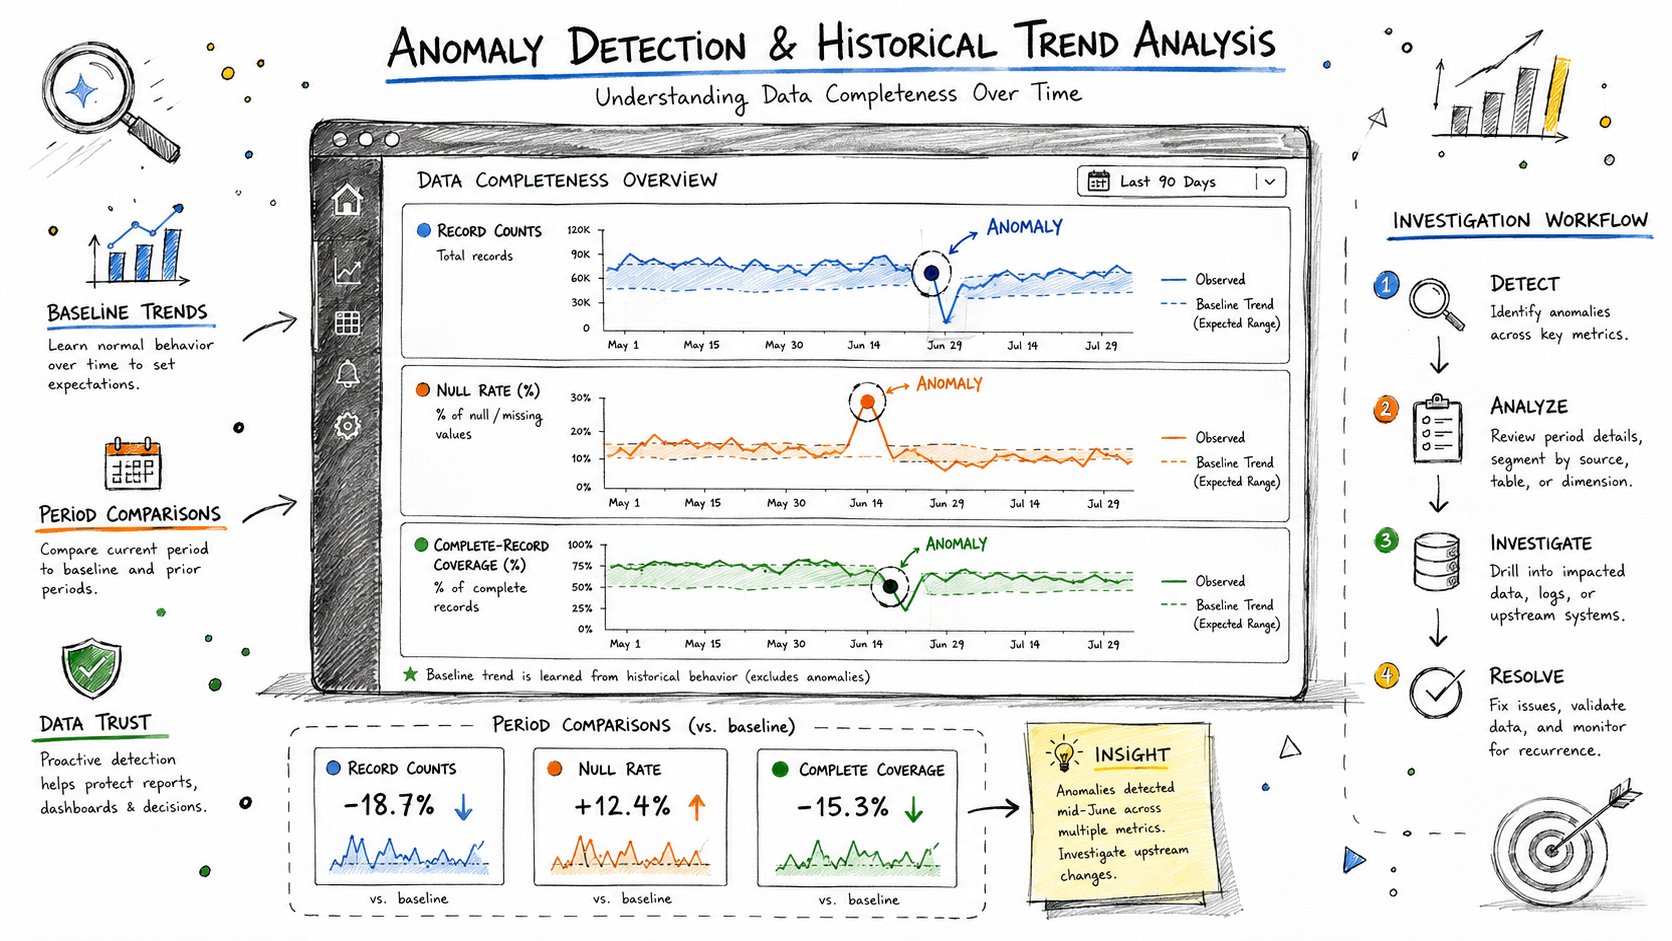
6. Detekcja anomalii i analiza trendów historycznych dla kompletności
Sztywne reguły identyfikują znane wymagania. Detekcja anomalii i analiza trendów historycznych identyfikują wzorce kompletności, które ulegają zmianie bez uprzednio zdefiniowanego warunku błędu. Przydatne sygnały obejmują wskaźniki wartości NULL, uzupełnione wartości, liczbę rekordów, pokrycie kompletnych rekordów, czasy dostarczenia oraz obecność oczekiwanych okresów.
Jakość zestawu danych może pogarszać się stopniowo. Liczba rekordów może spadać w kolejnych krokach ładowania, a wymagane pole może być rzadziej uzupełniane po zmianie systemu. Każda metryka może pozostawać powyżej progu ostrzegawczego, podczas gdy ogólne ryzyko rośnie. Porównanie historyczne uwidacznia ten kierunek zmian – podobnie jak porównanie dzisiejszego wyniku z ustalonym profilem pacjenta, a nie tylko ocena pojedynczego odczytu.
Użyj podejścia digna do detekcji anomalii w szeregach czasowych, aby porównać bieżące zachowanie kompletności z wyuczonymi wzorcami. Celem jest wskazanie istotnych zmian do przeglądu, a nie klasyfikowanie każdego odchylenia jako błędu.
Łączenie linii bazowych z oceną merytoryczną
Anomalia staje się użyteczna dopiero po sprawdzeniu jej kontekstu. Proces uzgadniania na koniec miesiąca może generować powtarzający się wzorzec. Nowy proces rejestracji może celowo zmieniać zakres uzupełnianych pól. Migracja źródła może wywołać tymczasowy stan przejściowy, który wymaga osobnego traktowania.
Przeglądaj sygnały w regularnych odstępach czasu i zapisuj obserwacje. Narzędzie digna Data Analytics dostarcza historycznego kontekstu dla trendów, zmienności, powtarzających się błędów oraz różnic między okresami. Analitycy mogą pytać, kiedy rozpoczęła się zmiana, czy dotyczy każdego źródła i czy wynika z określonego harmonogramu.
Zastosuj następującą sekwencję działań:
Wykrywanie: Znajdź nietypową zmianę w wolumenie, wskaźniku wartości NULL lub pokryciu kompletnych rekordów.
Lokalizacja: Rozbij sygnał według źródła, regionu, partycji, typu rekordu lub procesu.
Korelacja: Porównaj go z wdrożeniami, zmianami schematów, zdarzeniami operacyjnymi i opóźnieniami dostaw.
Walidacja: Zapytaj właściciela biznesowego, czy ta zmiana jest oczekiwana.
Naprawa: Napraw źródło lub potok danych, a następnie potwierdź, że metryka powróciła do akceptowalnego stanu.
Przechowuj obserwacje kompletności w sposób spójny. Codzienne gromadzenie danych sprawdza się w przypadku wielu operacyjnych zbiorów, podczas gdy potoki o dużym wolumenie mogą wymagać częstszych kontroli. Analiza trendów jest wiarygodna tylko wtedy, gdy definicja metryki, zakres i oczekiwane zachowanie pozostają stabilne. Zachowaj te szczegóły przy każdej obserwacji, aby późniejsze porównania nie myliły zmiany sposobu pomiaru ze zmianą jakości danych.
7. Kompletność danych a ocena dokładności i poprawności
Kompletność jest niezbędna, ale nie odpowiada na wszystkie pytania dotyczące jakości danych. Kompletność pyta, czy wymagane dane są obecne. Dokładność pyta, czy poprawnie odzwierciedlają one rzeczywistość. Poprawność (Validitiy) sprawdza, czy dane są zgodne ze zdefiniowanymi regułami.
Numer telefonu dobrze obrazuje tę różnicę:
Brakująca wartość: Problem z kompletnością.
Wartość obecna, ale nieprawidłowo sformatowana: Problem z poprawnością.
Prawidłowo sformatowana, ale należąca do innej osoby: Problem z dokładnością.
To samo rozróżnienie dotyczy identyfikatora klienta. Uzupełniony identyfikator może spełniać wymóg kompletności pola, ale jednocześnie nie przejść weryfikacji poprawności, jeśli narusza oczekiwany format lub relację. Może również okazać się niedokładny, jeśli wskazuje niewłaściwego klienta.
Monitorowanie wymiarów razem
Użyj digna Data Validation do stosowania jednoznacznych kontroli wymaganych wartości, formatów, zakresów, relacji i logiki biznesowej. Ten przewodnik po narzędziach do sprawdzania poprawności dostarcza przydatnego kontekstu, pokazując, że walidacja to znacznie więcej niż tylko wykrywanie wartości NULL.
Wspólny widok jakości powinien prezentować poszczególne wymiary osobno oraz łącznie. Ścieżka naprawcza jest różna:
Błąd kompletności: Dowiedz się, dlaczego brakuje wartości, rekordu lub okresu.
Błąd poprawności: Popraw format, domenę, typ lub regułę relacji.
Błąd dokładności: Porównaj wartość z zaufanym źródłem lub rzeczywistym zdarzeniem.
Znaczenie mają również wymagania warunkowe. Atrybut może być obowiązkowy tylko wtedy, gdy inne pole wskazuje, że rekord kwalifikuje się do danej reguły. Prosty, ogólny wskaźnik kompletności może niesłusznie karać za prawidłowe pominięcia wynikające z architektury systemu, chyba że reguła uwzględnia ten warunek.
Unikanie fałszywego poczucia bezpieczeństwa przy wysokim wyniku
Zestaw danych, w którym uzupełniono każde wymagane pole, może nadal zawierać niepoprawne adresy, nieprawidłowe numery kont lub błędne kwoty transakcji. I odwrotnie – zestaw danych może zawierać dokładne wartości dla wierszy, które otrzymał, mimo braku całego okresu ze źródła.
Kompletność jest dowodem na to, że wymagane informacje są obecne. Nie jest jednak dowodem na to, że informacje te są poprawne, dokładne, dostarczone na czas lub wystarczające do każdej analizy.
Priorytetyzuj problemy według ich wpływu na biznes. Stale uzupełniane pole z nieprawidłowymi wartościami może stwarzać większe ryzyko niż opcjonalna cecha z okazjonalnymi brakami. Użytkownicy biznesowi powinni pomagać w określaniu tych priorytetów, ponieważ rozumieją, jak dany błąd wpływa na raportowanie, operacje, zgodność (Compliance) i decyzje.
8. Strategia ciągłego monitorowania
Niezawodny program dbania o kompletność łączy deterministyczną walidację, detekcję anomalii, monitorowanie terminowości i analizę historyczną. Każda z tych warstw odpowiada na inne pytanie. Walidacja sprawdza, czy spełnione są znane wymagania. Detekcja anomalii bada, czy bieżące zachowanie różni się od normalnego poziomu odniesienia. Monitorowanie terminowości kontroluje, czy oczekiwane dane docierają wtedy, gdy są potrzebne, podczas gdy analiza historyczna pokazuje, czy luka ma charakter odosobniony, powtarzalny, sezonowy czy też ulega pogorszeniu.
Zacznij od zdefiniowania, co decyduje o użyteczności rekordu oraz zestawu danych. Następnie powiąż każdą definicję z odpowiednim pomiarem:
Walidacja wymaganych pól: Wykrywanie brakujących obowiązkowych wartości, takich jak identyfikator klienta czy kwota transakcji.
Walidacja na poziomie rekordu: Potwierdzenie, czy kwalifikujący się rekord zawiera wszystkie atrybuty potrzebne do jego wykorzystania.
Monitorowanie liczby rekordów: Identyfikowanie brakujących lub nieoczekiwanie zduplikowanych grup danych.
Monitorowanie terminowości: Wykrywanie spóźnionych, przedwczesnych lub brakujących dostaw.
Detekcja anomalii: Sygnalizowanie nietypowych zmian w wolumenie, wskaźnikach wartości NULL, zachowaniu dostaw lub pokryciu kompletnych rekordów.
Analiza historyczna: Porównywanie kompletności w różnych okresach w celu identyfikacji powtarzalności i długoterminowych zmian.
Monitorowanie schematu: Wychwytywanie zmian strukturalnych, które mogą wprowadzić nowe braki w danych.
Warstwy te działają jak zestaw różnych wskaźników na tym samym panelu sterowania. Kontrola pola może wykazać obecność wartości, podczas gdy kontrola liczby rekordów ujawni, że cała populacja ze źródła nigdy nie dotarła. Alert terminowości może z kolei wyjaśnić, dlaczego oba te sygnały uległy zmianie.
Platforma digna wspiera ten model operacyjny poprzez moduły Data Validation, Data Anomalies, Data Analytics, Timeliness oraz Schema Tracker. Obliczanie metryk i analizy odbywają się bezpośrednio w bazach danych klienta. Opcje wdrożenia w chmurze prywatnej (private cloud) oraz lokalnie (on-premises) wspierają korporacyjne wymogi kontroli danych.
Korelowanie sygnałów przed przypisaniem odpowiedzialności
Załóżmy, że liczba błędów walidacji rośnie, podczas gdy liczba rekordów spada, a źródło dociera z opóźnieniem. Łącznie sygnały te mogą wskazywać na jeden niekompletny proces ekstrakcji danych u dostawcy. Potraktuj to zdarzenie jako pojedyncze dochodzenie, zamiast otwierać osobne zgłoszenia, które maskują wzajemne powiązania.
Praktyczna rutyna wygląda następująco:
Zdefiniuj wymagane pola i kwalifikujące się rekordy wspólnie z właścicielami biznesowymi.
Określ oczekiwania dotyczące wolumenu, pokrycia okresów i czasu dostarczenia.
Zastosuj deterministyczne kontrole do znanych wymagań.
Ustal linie bazowe dla ważnych metryk kompletności.
Koreluj alerty dotyczące walidacji, anomalii, terminowości i zmian schematu.
Przeglądaj powtarzające się problemy i trendy z właścicielami danych.
Weryfikuj reguły przy zmianach procesów biznesowych lub systemów źródłowych.
Interpretuj braki danych zgodnie z kryteriami kwalifikacji, sposobem kodowania, kontekstem źródła i dalszym wykorzystaniem. Brak wartości może być czymś oczekiwanym dla rekordu niekwalifikującego się, podczas gdy brak okresu lub całego zestawu danych wskazuje na błąd dostawy. Badania nad mechanizmami brakujących danych wskazują, że same wskaźniki obecności mogą nie wystarczyć do określenia, czy brak danych jest strukturalnie informacyjny, czy też obciążony błędem systematycznym.
Porównanie w 8 punktach: Jak mierzyć kompletność danych
Metoda | 🔄 Złożoność wdrożenia | ⚡ Wymagania zasobowe | 📊 Oczekiwane rezultaty | 💡 Idealne przypadki użycia | ⭐ Główne zalety |
|---|---|---|---|---|---|
Wskaźnik kompletności pól | Niska, proste zapytania SQL/kontrole NULL | Niska, minimalna moc obliczeniowa i pamięć | % kompletności na poziomie pola; precyzyjne wskazanie brakujących pól | Zgodność wymaganych pól, audyty, podstawowe walidacje | Przejrzysta, łatwa do wdrożenia, ukierunkowana na działanie |
Monitorowanie liczby rekordów | Niska, okresowe zliczanie i linie bazowe | Niska, lekkie agregacje, historyczne liczby rekordów | Wykrywa brakujące ładowania i anomalie wolumenu | Monitorowanie ładowania wsadowego/strumieniowego, wykrywanie awarii potoków | Szybkie wykrywanie brakujących zestawów danych; niski koszt |
Monitorowanie wskaźnika wartości NULL | Średnia, śledzenie trendów i tworzenie linii bazowych | Średnie, historyczne metryki i monitorowanie | Trendy/skoki w proporcjach wartości NULL w czasie | Pola, w których brak danych sygnalizuje zmiany w źródłach | Wrażliwość na pojawiające się problemy; wczesne ostrzeganie |
Ocena kompletności rekordów | Średnia–Wysoka, reguły wielopolowe dla rekordu | Średnie, moc obliczeniowa do walidacji każdego rekordu | % rekordów spełniających wszystkie wymagane atrybuty | Procesy końcowe wymagające kompletnych rekordów (ocena ryzyka, fakturowanie) | Metryka istotna biznesowo; ułatwia priorytetyzację napraw |
Weryfikacja kompletności zestawu danych i okresu | Niska, kontrole obecności i harmonogramu | Niska, minimalne kontrole + metadane harmonogramu | Potwierdza dotarcie zestawu/pliku i pokrycie okresu | Planowane zadania wsadowe, raportowanie regulacyjne/okresowe | Zapobiega raportom z brakującymi okresami; prosta w egzekwowaniu |
Detekcja anomalii i analiza trendów historycznych | Wysoka, linie bazowe ML i analiza szeregów czasowych | Wysokie, przechowywanie historii, obliczenia ML | Wykrywa nietypowe odchylenia i powolny spadek jakości | Złożone potoki, wzorce sezonowe, monitorowanie w skali przedsiębiorstwa | Wychwytuje subtelne/stopniowe problemy; mniej fałszywych alarmów |
Kompletność a ocena dokładności i poprawności | Wysoka, integruje wiele wymiarów jakości | Wysokie, kontrole międzywymiarowe i narzędzia | Całościowy profil jakości (kompletność+dokładność+poprawność) | Data Governance, priorytetyzacja napraw, audyty | Zapobiega powierzchownym poprawkom; skupia się na wpływie biznesowym |
Strategia ciągłego monitorowania (Zintegrowana) | Wysoka, łączy reguły, anomalie i analitykę | Wysokie, wiele modułów, korelacja alertów | Kompleksowe pokrycie ze skorelowanymi alertami i kontekstem | Przedsiębiorstwa z krytycznymi potokami i zróżnicowanymi źródłami | Łączy zalety wszystkich metod; ogranicza przeoczone problemy |
Od procentu kompletności do zaufania do danych
Żadna pojedyncza metryka nie udowadnia, że zestaw danych jest kompletny dla każdego celu. Wskaźnik kompletności pól może pokazać, że wymagane wartości są uzupełnione, ale nie ujawni braku pliku, nieobecności regionu biznesowego, opóźnionej dostawy ani powolnego spadku liczby rekordów. Procent kompletnych rekordów może wskazać, że wiersze są użyteczne, ale nie dowiedzie, że dotarła cała oczekiwana grupa danych.
Najsilniejszy model pomiaru rozwija się na kilku poziomach:
Poziom pola: Czy wymagane wartości są uzupełnione?
Poziom rekordu: Czy każdy użyteczny rekord zawiera wszystkie wymagane atrybuty?
Poziom wolumenu: Czy dotarła oczekiwana liczba rekordów?
Poziom zestawu danych: Czy obecne są oczekiwane pliki, tabele i partycje?
Poziom okresu: Czy dane pokrywają każdą wymaganą datę biznesową lub okres sprawozdawczy?
Poziom terminowości: Czy dane dotarły w oczekiwanym oknie czasowym?
Poziom behawioralny: Czy wskaźniki wartości NULL, liczby rekordów i uzupełnione wartości zachowują się normalnie?
Poziom wymiarów jakości: Czy obecne dane są również dokładne i poprawne?
Ten wielowarstwowy widok zapobiega sytuacji, w której pomyślny status uruchomienia potoku staje się fałszywym sygnałem zapewnienia jakości. Pomaga również zespołom przypisać odpowiedniego właściciela do problemu. Brak wymaganej wartości może dotyczyć zespołu aplikacji źródłowej. Brak partycji może leżeć po stronie procesu wprowadzania danych. Opóźniony plik może wymagać zbadania potoku danych lub harmonogramu zadań. Zmiana schematu może wymagać koordynacji z odbiorcami danych końcowych.
Zdefiniowanie „kompletności” dla celów decyzyjnych
Akceptowalny poziom kompletności zależy od zamierzonego zastosowania. Wskazówki dotyczące jakości danych Uniwersytetu w Greifswaldzie wskazują, że nie ma uniwersalnej granicy dla akceptowalnych braków danych. Istotne jest pytanie, czy pozostałe, kompletne rekordy pozwalają na podjęcie decyzji, sporządzenie raportu, stworzenie modelu lub realizację procesu operacyjnego.
To oznacza, że zespół Data Governance powinien udokumentować:
Które atrybuty są obowiązkowe.
Które rekordy kwalifikują się do każdego wymagania.
Które źródła i okresy są oczekiwane.
Jakie okno czasowe dostarczenia ma zastosowanie.
Które luki w kompletności blokują publikację lub przetwarzanie.
Które wzorce braków wymagają zbadania, nawet gdy próg został zachowany.
Następnie należy mierzyć zarówno sam wynik, jak i stojącą za nim przyczynę. Pojedyncza średnia może maskować kluczową kolumnę, źródło, region lub okres. Rozbijaj metryki według wymiarów, które mają znaczenie dla procesu, i zachowaj odpowiednio długą historię, aby identyfikować powtarzające się błędy.
Przekształcenie monitorowania w praktykę operacyjną
Praktyczne wdrożenie rozpoczyna się od deterministycznych reguł dla znanych wymagań. Dodaj kontrole oczekiwanego wolumenu i dostarczenia danych. Ustal historyczne linie bazowe dla wskaźników wartości NULL i uzupełnienia rekordów. Gdy uruchomi się alert, badaj skorelowane sygnały, zamiast traktować każdą metrykę niezależnie. Przeglądaj trendy z właścicielami biznesowymi, aby uzasadnione zmiany procesów nie były mylone z błędami.
Platforma digna oferuje modułową ścieżkę do realizacji tych zadań. Data Validation pozwala wymuszać wymagane wartości i reguły biznesowe na poziomie rekordów. Data Anomalies pomaga identyfikować nietypowe zmiany w zachowaniach związanych z kompletnością. Moduł Data Analytics dostarcza historycznego kontekstu. Narzędzie Timeliness monitoruje wzorce przybycia i brakujące ładowania danych, a Schema Tracker wykrywa zmiany strukturalne, które mogą prowadzić do nowych problemów z kompletnością.
Platforma wykonuje kontrole i obliczenia metryk bezpośrednio w bazach danych klienta, oferując opcje wdrożenia w chmurze prywatnej i lokalnie dla organizacji, które wymagają, aby dane pozostały w ich własnym środowisku. Taka architektura wspiera kontrolowane podejście w hurtowniach danych, jeziorach danych (data lakes) i potokach danych, podczas gdy wspólny panel nawigacyjny daje inżynierom, analitykom i interesariuszom jednolity widok na incydenty i trendy.
Kompletność danych to nie tylko suchy procent. To informacja o tym, czy dane wymagane do rzeczywistego celu biznesowego są obecne, dostępne we właściwym czasie i wystarczająco stabilne, by można było im zaufać. Mierz poszczególne wartości, kompletne rekordy, wolumeny rekordów, oczekiwane okresy, zachowanie dostaw i zmiany historyczne. Następnie powiąż te sygnały z dokładnością i poprawnością, aby zespoły wiedziały nie tylko, czego brakuje, ale także czy dane, które dotarły, mogą stanowić podstawę do podjęcia decyzji.
digna łączy moduły Data Validation, Data Anomalies, Data Analytics, Timeliness oraz Schema Tracker, ułatwiając zespołom monitorowanie kompletności w danych przedsiębiorstwa. Odwiedź digna, aby poznać modułową platformę observability, która działa w Twoim środowisku i pomaga badać brakujące wartości, brakujące ładowania, nietypowe zmiany oraz powiązane problemy z jakością danych.


