Formaty plików Parquet: struktura, strojenie i dobre praktyki
|
12
min. czyt.

Twój pulpit BI znów działa wolno. Nocne zadanie zrzuciło kolejną stertę plików CSV do magazynu obiektowego, ktoś bez uprzedzenia dodał kilka kolumn, a jedno zapytanie, na którym zależy biznesowi, przeżuwa teraz znacznie więcej danych, niż uzasadnia wynik.
To zwykle moment, w którym formaty plików Parquet przestają przypominać wybór rozszerzenia, a zaczynają wyglądać na decyzję architektoniczną. Jeśli Twój zespół korzysta ze Sparka, DuckDB, Trino, BigQuery, modeli dbt albo potoków lakehouse, Parquet siedzi w samym środku Twojej opowieści o niezawodności i kosztach. Kłopot w tym, że większość wyjaśnień kończy się na „Parquet jest kolumnowy”, co jest prawdą, ale niepełną.
W praktyce liczy się to, jak Parquet układa dane na dysku, które kodowania pomagają, które zmiany schematu są bezpieczne i co wciąż zmienia się w samym formacie. W 2026 roku Parquet nie jest zamrożony. Wciąż pojawiają się nowe typy logiczne i kodowania, a wsparcie ląduje nierównomiernie w poszczególnych silnikach. Właśnie tam zespoły produkcyjne wpadają w pułapkę.
Spis treści
Dlaczego formaty plików Parquet istnieją dla nowoczesnej analityki
CSV łatwo wytworzyć i boleśnie analizuje się go w skali. Jeśli zapytanie pulpitu potrzebuje tylko price, region i event_date, czytnik CSV i tak musi sparsować każde pole każdego wiersza, żeby w ogóle dotrzeć do tych kolumn. Format nie wie, gdzie wartości jednej kolumny leżą jako ciągły blok, i nie niesie dość metadanych, by czysto pominąć nieistotne fragmenty.
Parquet to naprawia, przechowując dane kolumnami zamiast wierszami. Zapisuje też metadane, które pozwalają czytającym uniknąć zbędnej pracy. Nowoczesne opisy formatu zauważają, że te decyzje projektowe zwykle czynią pliki Parquet 5–10 razy mniejszymi niż CSV i 10–100 razy szybszymi w odpytywaniu w obciążeniach analitycznych; przykładowy benchmark pokazuje plik Parquet-Zstd o rozmiarze 164 MB wobec 1,09 GB dla CSV na zbiorze 11,2 miliona wierszy, a część zapytań zliczających działa około 160 razy szybciej, gdy same metadane potrafią na nie odpowiedzieć (objaśnienie formatu Parquet od MotherDuck).
Dlaczego układ kolumnowy zmienia wszystko
Gdy wartości tej samej kolumny leżą razem, silniki mogą zrobić trzy użyteczne rzeczy:
Czytać mniej bajtów: zapytanie potrzebujące trzech kolumn nie musi przeciągać pozostałych przez sieć i parser.
Lepiej kompresować: podobne wartości skupiają się w obrębie kolumny, więc kodowania takie jak słownikowe, run-length i delta stają się skuteczne.
Pomijać całe fragmenty: Parquet trzyma w stopce metadane minimum, maksimum i liczby wartości pustych, więc czytający mogą odrzucić row groups przed ich dekodowaniem.
Dlatego Parquet stał się domyślnym formatem składowania analitycznego, a nie przetwarzania transakcyjnego. Jest zoptymalizowany pod skany, agregacje, filtrowanie i projekcję.
Reguła praktyczna: jeśli ludzie odpytują głównie podzbiory kolumn i skanują duże zbiory danych, wierszowe formaty tekstowe walczą z obciążeniem.
Co inżynierowie nadal muszą rozstrzygnąć
Parquet nie usuwa decyzji projektowych. Przesuwa je.
Zespół produkcyjny wciąż musi odpowiedzieć na pytania o rozmiar row groups, domyślne kodeki, układ stron, wsparcie wersji i ewolucję schematu. To nie są przypadki brzegowe. Wpływają wprost na koszt skanowania, interoperacyjność i na to, czy czytający niżej przetrwają zmianę w potoku.
Jeśli projektujesz składowanie w lakehouse albo rewidujesz formaty eksportu z hurtowni, to moment, w którym decyzje o architekturze systemów danych przestają być abstrakcyjne. Zachowanie formatu pliku kształtuje opóźnienie zapytań, efektywność składowania i operacyjne tryby awarii.
Historia powstania i dlaczego wciąż ma znaczenie
Sporo produkcyjnego bólu wokół Parquet zaczyna się od fałszywego założenia: że to tylko neutralne rozszerzenie pliku, które każdy silnik obsługuje tak samo. Tak nie jest. Parquet wyrósł z konkretnego problemu analitycznego, a te pierwotne decyzje projektowe do dziś tłumaczą zarówno jego siły, jak i tryby awarii.
Parquet powstał w 2013 roku jako wspólne przedsięwzięcie Twittera i Cloudery. Wydanie 1.0 ogłoszono 30 lipca 2013 roku, gdy projekt miał już za sobą ponad 90 scalonych pull requestów, co pokazuje, jak szybko format nabierał kształtu w pierwszych miesiącach (ogłoszenie Parquet 1.0 przez inżynierię Twittera).

Zespoły ery Hadoopa zmagały się wtedy z szerokimi zbiorami danych, długimi czasami skanowania i rachunkami za składowanie rosnącymi szybciej niż budżety. Parquet zbudowano właśnie dla tego środowiska. Przechowuj wartości kolumnami, kompresuj podobne wartości razem i dawaj silnikom zapytań dość metadanych, by oszczędzić pracę. Dziś brzmi to zwyczajnie, bo każdy zespół lakehouse tego oczekuje. W 2013 roku rozwiązywało to bardzo kosztowne wąskie gardło.
Projekt stał się później projektem najwyższego poziomu Apache Software Foundation 27 kwietnia 2015 roku. To ważne, bo formaty plików żyją lub giną wraz ze wsparciem czytających. Gdy kolejne silniki, hurtownie i formaty tabel postawiły na Parquet, zgodność stała się równie istotna jak sam współczynnik kompresji.
Wczesne zakłady widać jeszcze w 2026 roku
Dwie decyzje projektowe z samego początku wciąż kształtują realne potoki.
Po pierwsze, Parquet zoptymalizowano pod skany analityczne, a nie pod wyszukiwanie punktowe. Plik Parquet działa jak magazyn ułożony według rodzaju produktu, a nie według zamówienia klienta. Jeśli potrzebujesz każdej wartości jednej kolumny w 500 milionach wierszy, ten układ jest wydajny. Jeśli potrzebujesz jednego konkretnego wiersza ze środka, jest niezgrabny. Zespoły wciąż wpadają w kłopoty, używając Parquet do odtwarzania zdarzeń, operacyjnych API czy obciążeń wymagających szybkiego dostępu do pojedynczego rekordu.
Po drugie, Parquet uczynił pliki samoopisującymi się. Schemat i metadane row group leżą w stopce, więc czytający mogą odkryć strukturę bez zależności od osobnej usługi schematów. Ta przenośność to ważny powód, dla którego Parquet rozlał się na Spark, Hive, Trino, DuckDB, tabele zewnętrzne Snowflake i stosy lakehouse.
Tworzy to też ostrą krawędź. Gdy stopka zostanie uszkodzona, plik może być nieczytelny, nawet jeśli strony danych wciąż leżą nienaruszone w magazynie obiektowym. Format mówi to wprost. Pliki kończą się liczbą magiczną PAR1, a długość metadanych zapisano jako 4-bajtową liczbę całkowitą little-endian w stopce, co wskazuje czytającym, gdzie zaczynają się schemat i metadane row group (dokumentacja formatu pliku Apache Parquet).
Ten szczegół brzmi niskopoziomowo, ale liczy się w eksploatacji. Urwany upload, nieudany zapis wieloczęściowy albo wadliwe zadanie przepisujące potrafią zamienić jedną zepsutą stopkę w jeden nieczytelny plik. W partycjonowanym zbiorze ujawnia się to zwykle jako brakujący dzień, zepsuty backfill albo zapytanie, które zawodzi tylko dla jednego wycinka klientów. Dla zespołów pracujących nad jakością i niezawodnością danych w lakehouse to jeden z powodów, dla których walidacja plików należy do potoku, a nie do analizy powypadkowej.
Historia powstania tłumaczy też, czego Parquet domyślnie wciąż nie rozwiązuje. Pierwotna wygrana była oczywista przy powtarzających się wartościach, wymiarach o niskiej kardynalności i analityce mocno opartej na skanach. W 2026 roku więcej uwagi dostają trudniejsze przypadki: kolumny tekstowe o wysokiej kardynalności, jak adresy URL czy identyfikatory użytkowników, miary zmiennoprzecinkowe, które nie kompresują się czysto, oraz zmiany schematu, które technicznie przechodzą walidację, a mimo to psują czytających niżej. To nie są oznaki porażki Parquet. To przypomnienia, że format zaprojektowano jako fundament, a nie jako gwarancję, że każdy zbiór danych osiągnie dobry rozmiar, szybkość i zgodność wyłącznie na ustawieniach domyślnych.
Wewnątrz pliku Parquet: od row groups do pages
Zapytanie produkcyjne jest wolne dla jednej partycji i szybkie dla pozostałych 364 dni tabeli. Zwykłym powodem nie jest „Parquet jest wolny”. Chodzi o to, że plik ułożono tak, że silnik musiał przeczytać znacznie więcej bajtów, niż zapytanie potrzebowało.
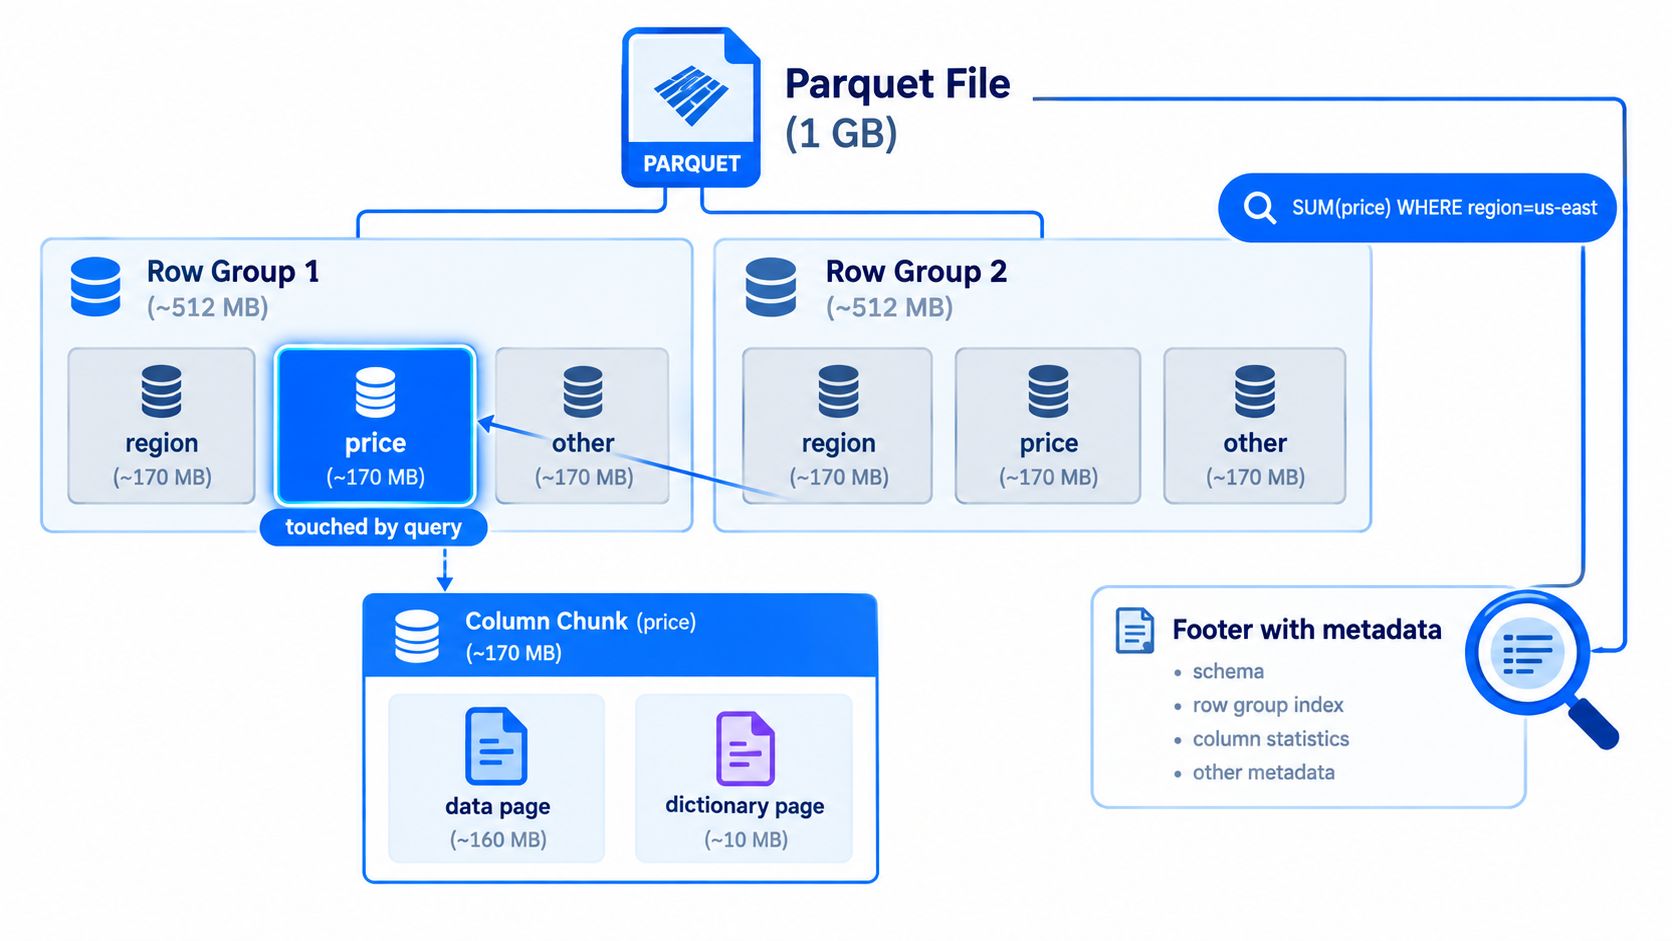
Parquet staje się zrozumiały, gdy wyobrazisz sobie jego układ jako zagnieżdżone pojemniki. Plik zawiera row groups. Każda row group zawiera po jednym column chunk na kolumnę. Każdy column chunk dzieli się na pages. Ta hierarchia pozwala silnikom czytać price bez dotykania comment_text albo pomijać bloki danych, które nie mogą spełnić filtru. Dokumentacja page index w Parquet opisuje strukturę i opcjonalne, drobniejsze metadane używane do pomijania stron (dokumentacja page index w Parquet).
Zacznij od poziomu row group
Jeśli przychodzisz z myślenia wierszowego, row group pomaga przestawić model. To poziomy wycinek tabeli, ale wewnątrz tego wycinka przechowywany kolumnami.
Załóżmy, że jeden plik zawiera kolumny region, price i event_date. Jedna row group będzie zawierać trzy column chunks: jeden dla region, jeden dla price i jeden dla event_date. Wartości nie leżą wiersz po wierszu. Leżą jako trzy osobne ciągi danych wewnątrz tej row group. Dlatego zapytanie potrzebujące tylko price może uniknąć czytania bajtów pozostałych dwóch kolumn.
Dla analityki opartej na skanach row groups są pierwszą użyteczną jednostką zrównoleglenia i pomijania. Tu też zaczyna się wiele kompromisów operacyjnych. Zbyt mała row group tworzy nadmiar metadanych i zbyt wiele drobnych odczytów. Zbyt duża może sprawić, że selektywne zapytania przeczytają więcej danych niż trzeba, i podnosi koszt ponowień oraz przepisań w magazynie obiektowym.
Potem przybliż pages
Pages to mniejsze bloki wewnątrz każdego column chunk. Kodowanie i kompresja dzieją się na tym poziomie.
Szczegół brzmi mechanicznie, ale wpływa na realne obciążenia. Kolumna z długimi łańcuchami o wysokiej kardynalności, jak adresy URL, identyfikatory urządzeń czy tokeny sesji, często wygląda dobrze na poziomie pliku i mimo to kompresuje się słabo strona po stronie. Ten sam wzorzec widać przy miarach zmiennoprzecinkowych, które rzadko się powtarzają i źle reagują na domyślne kodowania. W 2026 roku te dwa przypadki wciąż są miejscem, w którym zespoły odkrywają, że „zapisane w Parquet” nie znaczy automatycznie „małe i szybkie”.
Użytecznym modelem myślowym jest magazyn. Plik to budynek. Row groups to alejki. Column chunks to regały dla jednego rodzaju produktu w alejce. Pages to kartony na każdym regale. Zapytanie powinno otworzyć jak najmniej kartonów.
Co naprawdę robi czytający
Czytający zaczyna od metadanych stopki, a potem decyduje, które row groups i kolumny warto otworzyć. Gdy zapytanie prosi o SUM(price) przy region = 'us-east', silnik często może sprawdzić statystyki row group dla region i pominąć te, których wartości nie mogą pasować. Jeśli potrzebuje wyłącznie price, może też uniknąć czytania pozostałych column chunks w tych row groups.
To ścieżka idealna.
Haczyk polega na tym, że pomijanie zależy od rozkładu danych i zachowania zapisującego. Jeśli wiersze są losowo wymieszane, a każda row group zawiera każdy region, statystyki minimum i maksimum pomagają mniej. Jeśli kolumna tekstowa jest nieposortowana i mocno unikalna, granice stron mogą zawierać dość zmienności, by pomijanie na poziomie strony dawało niewiele. Format dostarcza mechanizm, ale to układ Twoich danych decyduje, czy ten mechanizm oszczędza pracę.
Dlaczego metadane stron znaczą dziś więcej
Metadane stron to jedno z ciekawszych osiągnięć dla systemów produkcyjnych, bo potrafią ograniczyć zmarnowane odczyty wewnątrz row group, a nie tylko pomiędzy row groups. Liczy się to tym bardziej, im większe stają się pliki i im częstsze są filtry selektywne.
W praktyce bywa też nierówno. Część silników zapisuje te metadane, część je czyta, a część ignoruje. Błąd operacyjny polega na zakładaniu wsparcia dlatego, że specyfikacja zawiera daną funkcję. Zespoły aktualizujące stos w 2026 roku powinny zweryfikować zachowanie na swoich rzeczywistych silnikach i ścieżkach magazynu chmurowego, zwłaszcza w mieszanych środowiskach, gdzie zapisuje Spark, a odpytują DuckDB, Trino lub czytniki hurtowni.
Zalecenia konfiguracyjne wobec realiów
Zalecenia konfiguracyjne Parquet radzą duże row groups i małe strony, z przykładami takimi jak row groups od 512 MB do 1 GB i strony 8 KB, wraz z założeniami układu dopasowanymi do HDFS (zalecenia konfiguracyjne Parquet).
Te liczby są użyteczne jako wskazówka formatu, a nie jako uniwersalne ustawienia.
W magazynie obiektowym praktyczny wybór zależy często od współbieżności czytających, rozmiarów partycji, kosztu ponowień i kształtu Twoich predykatów. Wsadowa tabela faktów skanowana od początku do końca może zyskać na większych row groups. Zbiór trafiany selektywnymi filtrami klienta lub czasu poradzi sobie może lepiej przy innej równowadze. Częsty błąd to przenoszenie ustawień domyślnych z jednego silnika czy systemu składowania na inny i oczekiwanie tego samego zachowania.
Miej tę hierarchię w głowie:
Plik: obiekt zapisany w S3, GCS, ADLS lub HDFS
Row group: poziomy wycinek wierszy i główna jednostka zgrubnego pomijania
Column chunk: dane jednej kolumny wewnątrz jednej row group
Page: blok, który jest kodowany, kompresowany i czasem pomijany dzięki drobniejszym metadanym
Jeśli rozumiesz te cztery warstwy, Parquet przestaje być nieprzejrzysty. Staje się zestawem decyzji o składowaniu, które możesz obejrzeć, zmierzyć i dostroić.
Parquet w wersji 1 wobec wersji 2 w praktyce
Specyfikacja Parquet przeszła przez wiele wydań, a użyteczne pytanie brzmi: które możliwości wspierają Twoi czytający i zapisujący.
Parquet v2 wprowadził coś więcej niż nową etykietę. Rozszerzył obsługę danych zagnieżdżonych, reprezentację wartości pustych i metadane pozwalające na drobniejsze pomijanie. Struktura pliku wciąż wydaje się znajoma, ale wsparcie nowszych możliwości ląduje nierównomiernie w silnikach — dlatego „zapisuj w v2” bywa albo dobrym ustawieniem domyślnym, albo pułapką interoperacyjności, zależnie od Twojego środowiska.
Macierz możliwości, która ma znaczenie
Możliwość | Parquet v1 | Parquet v2 | Wiarygodne w 2026? |
|---|---|---|---|
Podstawowy układ kolumnowy | Tak | Tak | Tak |
Statystyki min/maks/null w stopce na poziomie row group | Tak | Tak | Tak |
Obsługa danych zagnieżdżonych z poziomami powtórzeń i definicji | Wspierane w rodzinie formatu | Kontynuowane i szeroko używane | Zwykle tak, ale sprawdź zachowanie czytnika na złożonych schematach |
Statystyki stron przez page index | Nie | Tak | Tylko jeśli Twój silnik wyraźnie je wspiera i wykorzystuje |
Lepsza obsługa wartości pustych w nowszych formatach stron | Ograniczona | Lepsze wsparcie | Często tak, ale zależnie od silnika |
Nowsze funkcje opcjonalne, jak filtry Blooma | Nie | Dostępne w ekosystemie | Nie, najpierw zaudytuj wsparcie czytników |
Na czym można bezpiecznie polegać
Jeśli zapisujesz pliki dla środowisk mieszanych obejmujących Spark, DuckDB, Trino i BigQuery, najbezpieczniejsze pozostają podstawy: projekcja kolumn, statystyki row group, standardowe kodowania i popularne kodeki kompresji.
Uniwersalnie bezpieczne nie jest natomiast nic, co zależy od nowszych metadanych opcjonalnych lub świeżych funkcji specyfikacji. Ta ostrożność liczy się tym bardziej, że Parquet wciąż ewoluuje. W 2026 roku projekt wydał Parquet 2.14.0 i wyróżnił prace nad typem logicznym FILE, adaptacyjnym bezstratnym kodowaniem zmiennoprzecinkowym (ALP) oraz lepszym porządkowaniem znaczników czasu. Projekt zaznacza też, że wdrożenie jest etapowe, a ALP oznaczono jako „in preview”, dopóki implementacje nie nadążą (blog formatu Apache Parquet).
Reguła zgodności: zapisuj pod najstarszy czytnik, którego nie kontrolujesz.
To praktyczna perspektywa. Dla nowych potoków v2 jest zwykle lepszym celem zapisu. Zanim jednak oprzesz się na nowszych metadanych stron, zaawansowanej semantyce znaczników czasu czy kodowaniach w wersji zapoznawczej, zaudytuj każdy silnik, który będzie czytał te pliki. Jeśli Twój zespół używa Databricks albo mieszanych czytników lakehouse, kontrole jakości danych w Databricks stają się częścią rozmowy o formacie, bo problemy zgodności ujawniają się często jako incydenty jakościowe niżej, a nie jako oczywiste błędy odczytu.
Kodowania i kodeki kompresji, które naprawdę robią różnicę
Plik Parquet staje się mały w dwóch osobnych krokach, a strojenie produkcyjne robi się łatwiejsze, gdy trzymasz te kroki osobno.
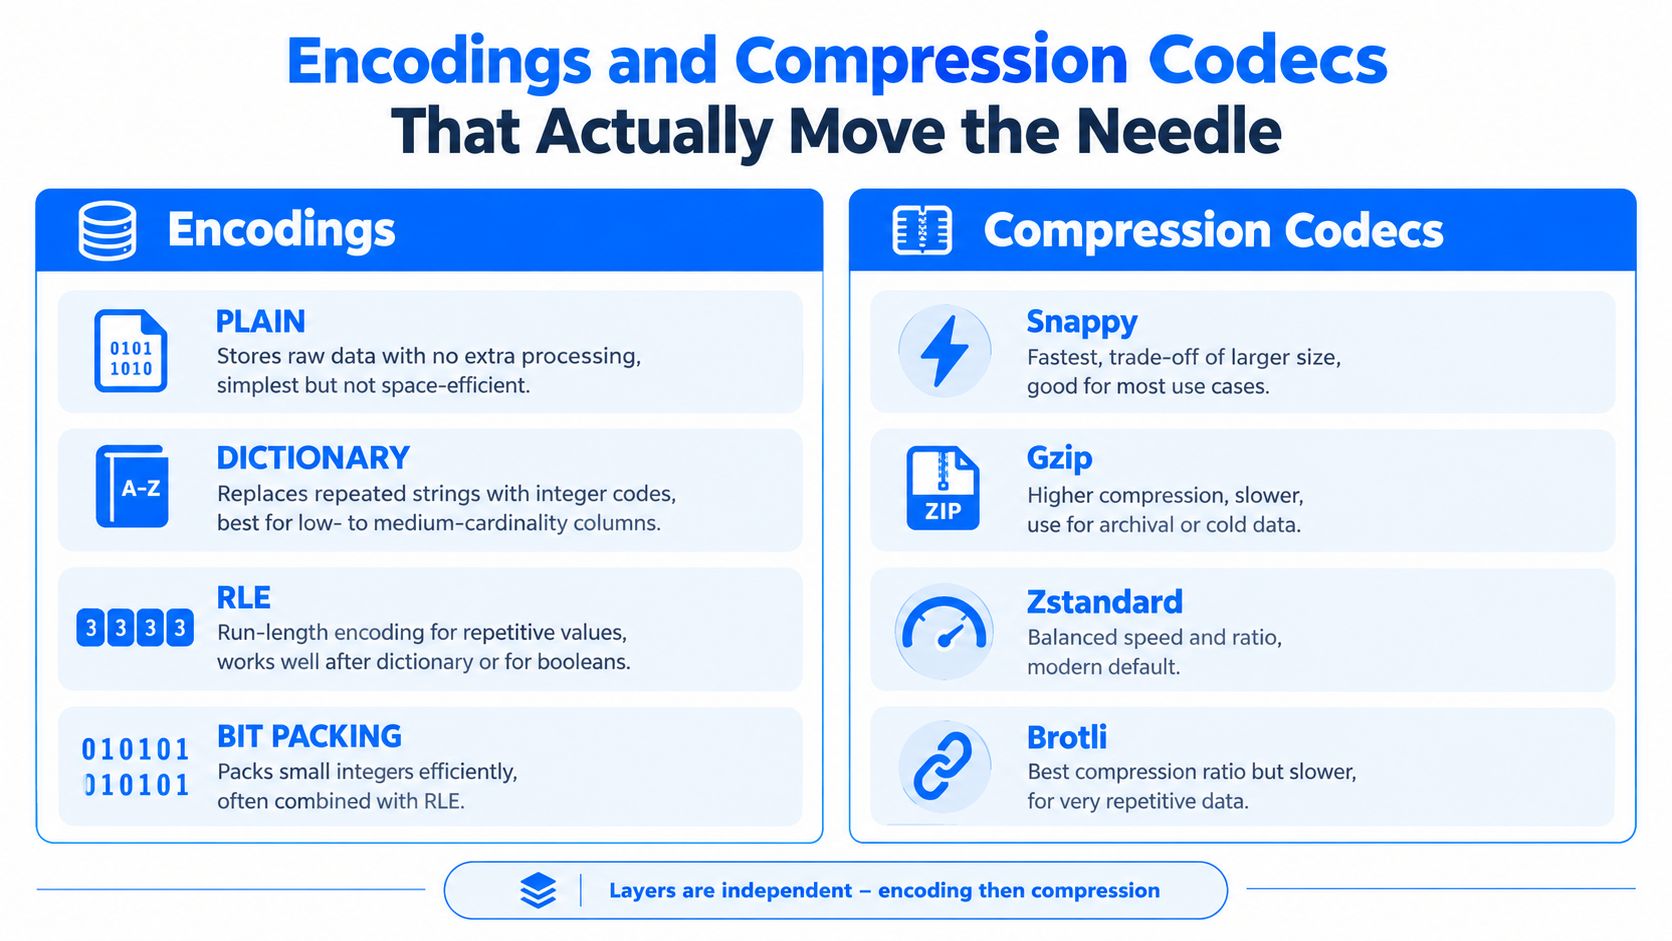
Najpierw Parquet koduje kolumnę do postaci pasującej do kształtu danych. Potem uruchamia kodek kompresji na powstałych bajtach. Pomijając to rozróżnienie, łatwo obwinić Snappy albo ZSTD za problem z rozmiarem, który naprawdę zaczął się od kiepskiego wyboru kodowania. Badania porównujące zachowanie kodowań i kompresji w Parquet w obciążeniach analitycznych wykazały, że połączenie liczy się bardziej niż sam kodek (podsumowanie badań o kompresji i kodowaniach w Parquet).
Kodowanie działa jak sortowanie narzędzi do opisanych skrzyń przed załadunkiem ciężarówki. Kompresja to pasy i folia zakładane po załadowaniu. Dobre pakowanie zaczyna się od skrzyń.
Najpierw kodowania, potem kodeki
Typowe kodowania rozwiązują różne problemy:
PLAIN: zapisuje wartości wprost. Dobra opcja awaryjna, słaba pod względem rozmiaru.
DICTIONARY: zastępuje powtarzające się wartości małymi kodami całkowitymi. Mocne przy łańcuchach o niskiej i średniej kardynalności, typach wyliczeniowych i wielu kolumnach identyfikatorowych.
RLE i bit-packing: zwięźle zapisują powtarzalne lub wąskie liczby całkowite. Przydatne dla wartości logicznych, indeksów słownika i danych bogatych w powtórzenia.
Kodowania DELTA: zapisują zmiany między sąsiednimi wartościami zamiast każdej pełnej wartości. Najlepiej pasują do posortowanych liczb całkowitych, liczników i części kolumn czasowych.
Pomaga konkretny przykład. Załóżmy, że kolumna status zawiera w 100 milionach wierszy tylko pending, paid i failed. Kodowanie słownikowe zamienia te łańcuchy w maleńkie kody, jak 0, 1 i 2. RLE i bit-packing mogą potem wydajnie zapisać długie serie albo wartości o małej szerokości bitowej. Później ZSTD lub Snappy ma do skompresowania znacznie prostszy strumień bajtów. Jeśli ten sam plik trzyma surowe łańcuchy z kodowaniem PLAIN, kodek musi wykonać dużo więcej pracy i zwykle osiąga gorsze wyniki.
To samo podsumowanie badań podaje, że Parquet często drastycznie zmniejsza mieszane dane analityczne oraz że ZSTD zwykle bije Snappy współczynnikiem kompresji, podczas gdy Snappy wciąż wypada lepiej niż brak kompresji. Zaznacza też, że kodowanie słownikowe w parze z bit-packingiem i RLE jest szczególnie skuteczne w kolumnach całkowitoliczbowych o niższej kardynalności. Ten wzorzec pokrywa się z tym, co inżynierowie danych widzą w tabelach faktów i logach zdarzeń.
Sensowne połączenia według kształtu danych
Niech kształt kolumny wyznacza wybór.
Pola kategoryczne, kody krajów, wartości statusu, rodzaje produktów: słownik plus ZSTD to mocne ustawienie domyślne.
Flagi logiczne, kolumny wskaźnikowe pełne wartości pustych, znaczniki partycyjne wewnątrz pliku: ścieżki przyjazne RLE zwykle działają dobrze, bo dominuje powtarzalność.
Posortowane znaczniki czasu, numery sekwencji, monotonicznie rosnące liczniki: kodowania delta potrafią zmniejszyć ładunek, zanim zadziała jakikolwiek kodek.
Interaktywne ścieżki zapytań, gdzie liczy się czas CPU: Snappy pozostaje popularne, bo koszt dekodowania jest przewidywalny.
Zbiory archiwalne, gdzie koszt składowania waży więcej niż szybkość zapisu: ZSTD, GZIP, a czasem Brotli mogą być warte dodatkowego CPU.
Częsty błąd to zastosowanie jednej globalnej polityki kodeka i uznanie sprawy za zamkniętą. Tabela z UUID-ami, agentami użytkownika, cenami, wartościami logicznymi i czasami zdarzeń zawiera pięć różnych problemów kompresji.
Gdzie ustawienia domyślne wciąż zawodzą w 2026 roku
To część, którą wiele objaśnień Parquet pomija.
Standardowe ustawienia Parquet wciąż są nierówne przy dwóch typach kolumn, które stale pojawiają się w realnych systemach: łańcuchach o wysokiej kardynalności i wartościach zmiennoprzecinkowych. Kodowanie słownikowe traci przewagę, gdy niemal każdy łańcuch jest inny, jak przy adresach URL, identyfikatorach żądań, agentach użytkownika i długich atrybutach tekstowych. Liczby zmiennoprzecinkowe mają inny problem. Kodeki ogólnego przeznaczenia potrafią je zmniejszyć, ale wzorce bajtów bywają na tyle zaszumione, że zyski są słabsze, niż zespoły oczekują.
Ta luka jest ważnym powodem, dla którego rozmowa o Parquet w 2026 roku przesunęła się ku nowszym pracom, takim jak FSST dla łańcuchów i ALP dla danych zmiennoprzecinkowych. Nie chodzi o to, że dzisiejszy Parquet jest zepsuty. Chodzi o to, że domyślne kodowania wciąż zostawiają pieniądze na stole przy telemetrii, logach, metrykach, wyjściach modeli, cenach i wartościach procentowych. Użyteczne podsumowanie tego kierunku znajdziesz w omówieniu FSST i ALP dla kodowań Parquet.
To wsparcie czytników wciąż decyduje, czego możesz bezpiecznie używać. Kodowania w wersji zapoznawczej albo świeżo dodane potrafią poprawić rozmiar pliku w benchmarkach, ale potok produkcyjny stawia ostrzejsze pytanie: czy Spark, Trino, DuckDB, Twoje zadanie wczytujące i Twoje narzędzia odtwarzania przeczytają te pliki tak samo w przyszłym miesiącu?
Co naprawdę robi różnicę na produkcji
Trzy decyzje zwykle ważą więcej niż spory o kodeki w mediach społecznościowych.
Dopasuj kodowanie do kardynalności. Kodowanie słownikowe jest znakomite, dopóki słownik nie urośnie na tyle, że przestaje się opłacać.
Sortuj lub klastruj dane przed zapisem, gdy możesz. Lepsze lokalne wzorce wartości dają delcie, RLE, statystykom i kompresji więcej materiału.
Mierz całe ścieżki odczytu, nie tylko rozmiar pliku. Plik mniejszy o 20 procent nie jest wygraną, jeśli koszt CPU podbija opóźnienie pulpitów albo rozciąga wsadowe SLA.
Jeszcze jeden kompromis zasługuje na szczerość. Najmniejszy plik nie zawsze jest najtańszy w eksploatacji. Zespoły często oszczędzają więcej na nieco większym pliku, który każdy silnik dekoduje szybko i niezawodnie, niż na agresywnym wyborze kodowania wprowadzającym ryzyko zgodności albo trudne do zdiagnozowania awarie odczytu.
Ewolucja schematu bez psucia czytających niżej
Ewolucja schematu to miejsce, w którym dobre praktyki wokół formatów plików Parquet albo ratują zespół, albo go zdradzają. Format jest dość elastyczny, by unieść zmianę, ale to nie znaczy, że każda zmiana jest bezpieczna.
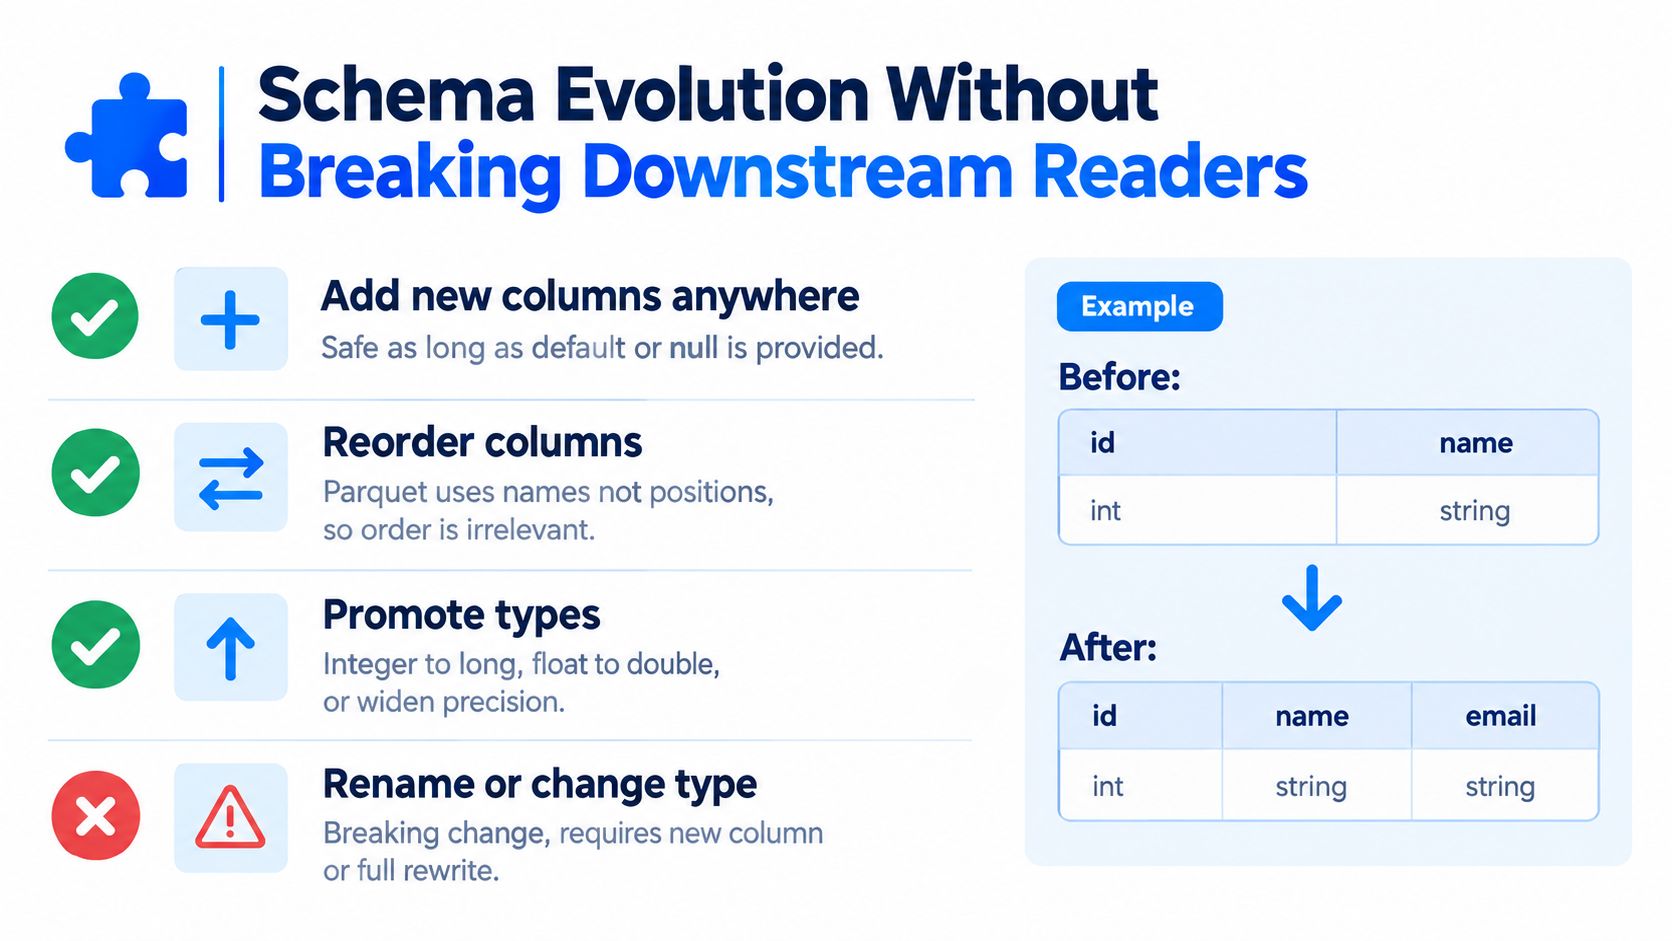
Najbezpieczniejsze podejście jest proste: dodawanie jest zwykle łatwiejsze niż zmienianie.
Zmiany, które zwykle są bezpieczne
Te zmiany są w zasadzie do opanowania, gdy Twoi czytający zachowują się przyzwoicie:
Dodanie nowej kolumny: stare pliki jej nie mają, więc czytający zwykle pokazują wartości puste lub domyślne.
Zmiana kolejności kolumn: czytający korzystają na ogół z metadanych schematu, a nie z wizualnej pozycji w pliku.
Poszerzenie typu: przejście z węższego na szerszy, zgodny typ bywa akceptowalne, jeśli silnik to wspiera.
Te wzorce pasują do tego, jak Parquet trzyma schemat w metadanych, zamiast wymuszać interpretację po pozycji. Wciąż zasługują na testy, ale nie są to zmiany, które zwykle wyrządzają cichą szkodę.
Zmiany powodujące ciche awarie
Zmiany nazw to klasyczna pułapka. Dla czytających niżej zmiana nazwy wygląda często jak „usunięcie jednej kolumny i dodanie innej”. Żaden wyjątek nie zostaje zgłoszony. Po prostu dostajesz wartości puste tam, gdzie wcześniej były dane.
Zmiany typu bywają gorsze. Zmiana znaczenia logicznego pod tą samą nazwą pola może dawać wartości, które się parsują, ale nie znaczą już tego samego. Tak zespoły kończą, debugując „poprawne” wiersze, które przestały się zgadzać.
W potokach Parquet zmiany nazw nie są kosmetyką metadanych. To zdarzenia migracyjne.
Nawyki zapobiegające gniciu potoków
Kilka nawyków operacyjnych daje wiele:
Zamroź kontrakty schematu poza kodem zapisującego. Rejestr, kontrakt w repozytorium albo proces oparty na katalogu jest lepszy niż „cokolwiek zadanie wypluje dziś w nocy”.
Traktuj zmiany nazw jak dwuetapową migrację. Dodaj nowe pole, uzupełnij historię, przestaw czytających, a dopiero potem wycofaj stare.
Waliduj poszerzanie i zgodność typów logicznych przed wydaniem. Używaj tych samych bibliotek czytających, na których opierają się Twoje silniki niżej.
Monitoruj dryf strukturalny w sposób ciągły. Narzędzia takie jak Schema Tracker są przydatne, bo wykrywają dodane lub usunięte kolumny oraz zmiany typów danych, zanim te zmiany przerodzą się w incydenty produkcyjne.
Jeśli Twój zespół obsługuje dane regulowane albo dużo współdzielonej konsumpcji niżej, dyscyplina schematu liczy się bardziej niż strojenie kodeków. Błędy kompresji kosztują pieniądze. Błędy schematu kosztują zaufanie.
Jak Parquet wypada przy ORC i Avro
Parquet, ORC i Avro rozwiązują różne części cyklu życia danych. Zespoły wpadają w kłopoty, gdy żądają od jednego formatu wszystkiego.
Avro jest wierszowe i dobrze pasuje do granic wczytywania. Parquet i ORC są kolumnowe i znacznie lepiej pasują do odczytów analitycznych. Gdy oprzesz wybór na obciążeniu zamiast na lojalności wobec marki, kompromisy stają się jaśniejsze.
Parquet, ORC i Avro w skrócie
Kryterium | Parquet | ORC | Avro |
|---|---|---|---|
Model składowania | Kolumnowy | Kolumnowy | Wierszowy |
Najlepsze dopasowanie | Analityka międzysilnikowa i wymiana w lakehouse | Środowiska mocno oparte na hurtowni, często wokół Hive | Streaming, bufory komunikatów, wymiana wierszowa |
Przycinanie kolumn | Mocne | Mocne | Słabe w porównaniu z formatami kolumnowymi |
Predicate pushdown | Mocny, gdy statystyki są obecne i dobrze zapisane | Mocny | Ograniczony, bo brakuje statystyk kolumnowych w stylu Parquet |
Obsługa schematu | Samoopisujące się metadane pliku | Samoopisujące się metadane pliku | Mocne przepływy skoncentrowane na schemacie |
Dane zagnieżdżone | Wspierane | Wspierane | Wspierane |
Szeroka interoperacyjność narzędzi | Bardzo mocna w nowoczesnych silnikach analitycznych | Mocna, ale często najmocniejsza w stosach sprzyjających ORC | Mocna dla przepływów wczytywania i serializacji |
Praktyczna reguła decyzyjna
Wybierz Avro, gdy zależy Ci na zapisach wierszowych, wymianie zdarzeń i wczytywaniu zarządzanym schematem. To dobry format graniczny.
Wybierz ORC, gdy Twój stos jest ściśle dopasowany do silników i przepływów, które go preferują, zwłaszcza w środowiskach z utrwalonymi konwencjami hurtowni.
Wybierz Parquet, gdy najbardziej liczy się szeroka interoperacyjność. Obejmuje to mieszane silniki, otwarte formaty tabel, analitykę ad hoc i zbiory lakehouse, które wiele narzędzi musi czytać bez negocjacji.
To, że Parquet wciąż wygrywa ten środek pola, wynika mniej z jednej przełomowej funkcji, a bardziej z grawitacji ekosystemu. Dobrze podróżuje między czytnikami, a dla większości zespołów analitycznych liczy się to tyle samo, co sama efektywność pliku.
Dobre praktyki dla niezawodnych potoków Parquet
Potok Parquet zawodzi zwykle w zwyczajny sposób. Aktualizacja zapisującego zmienia domyślne kodowanie jednej kolumny. Zadanie strumieniowe wypuszcza przez noc tysiące plików po 5 MB. Pole dopuszczające wartości puste pojawia się jako INT32 u jednego producenta i INT64 u innego. W chwili zapisu nic nie wygląda dramatycznie, ale następnego ranka Trino skanuje więcej danych niż oczekiwano, Spark traci predicate pushdown na jednej partycji, a model niżej zaczyna czytać wartości puste tam, gdzie spodziewał się wartości.
To jest ta produkcyjna rzeczywistość, pod którą należy optymalizować. Niezawodność bierze się mniej z jednego idealnego ustawienia pliku, a bardziej z uczynienia jawnymi układu plików, reguł schematu i zgodności czytników.
Lista kontrolna eksploatacji
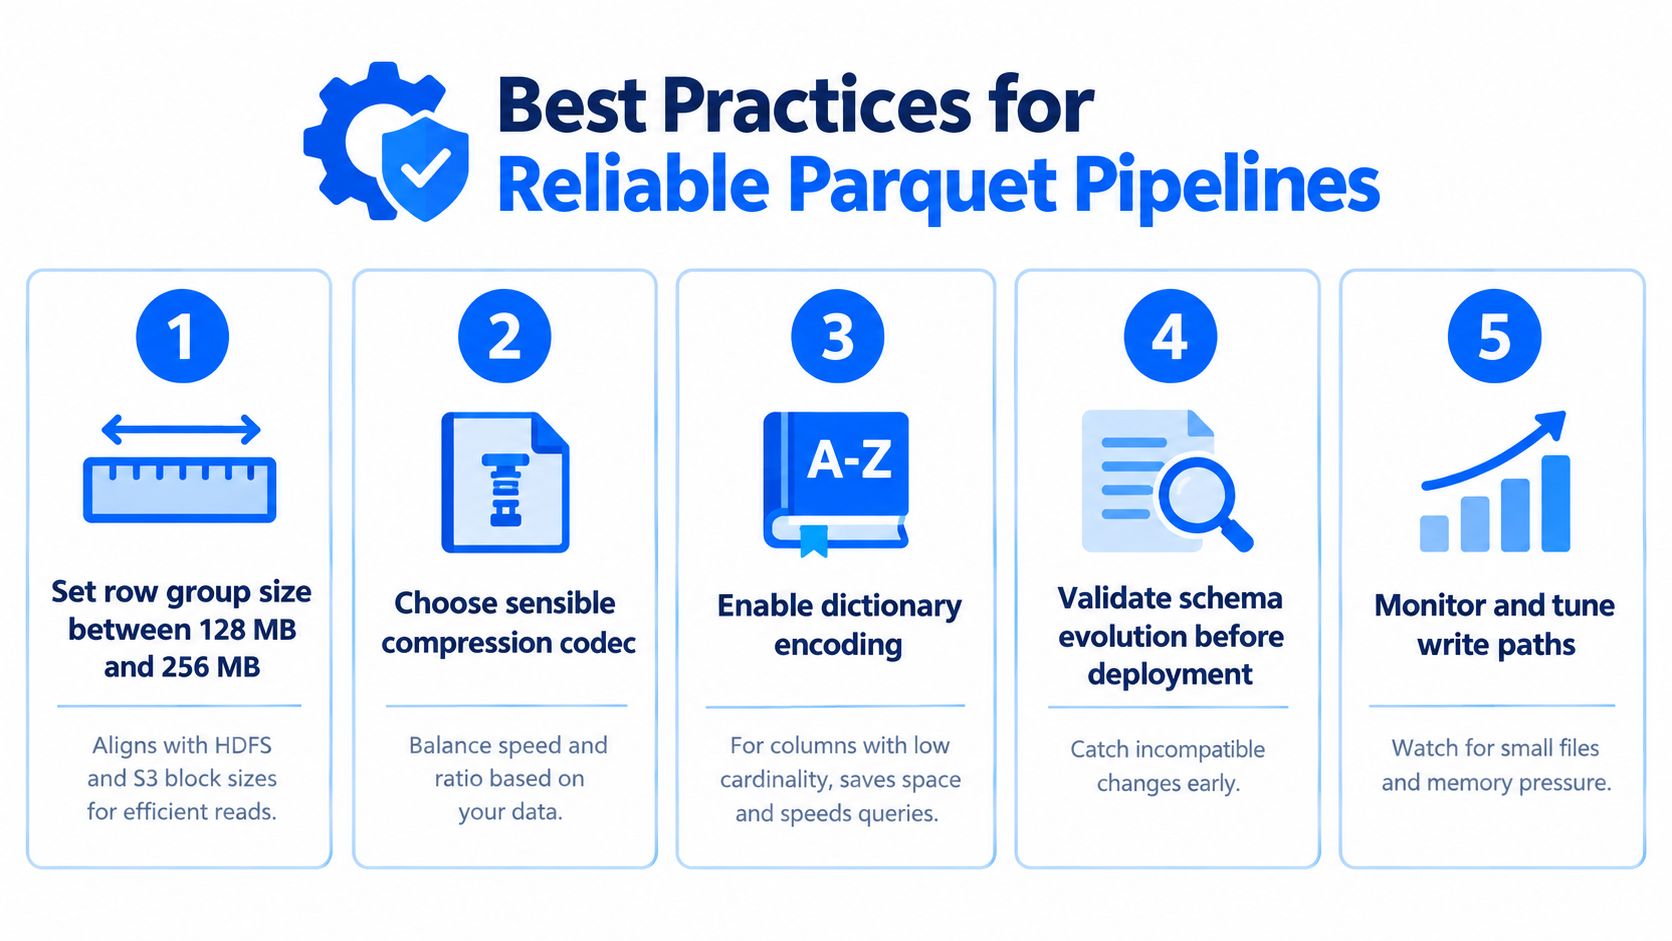
Wybieraj rozmiary row group świadomie. Wiele zespołów zaczyna w okolicach 128 MB i dostraja według wzorców skanowania, presji pamięci i zachowania magazynu obiektowego. Większe row groups mogą poprawić efektywność skanów, ale poszerzają też zasięg szkód, gdy statystyki są słabe. Mniejsze dają czytającym więcej okazji do pomijania danych, lecz zbyt duża ich liczba dokłada narzutu metadanych. Traktuj rozmiar row group jak regały magazynowe. Gdy każdy karton jest maleńki, tracisz czas na przekładanie kartonów. Gdy każdy jest ogromny, wciąż otwierasz pojemniki pełne danych, których nie potrzebowałeś.
Zatrzymuj wcześnie przyrost maleńkich plików. To jeden z najczęstszych błędów w potokach Parquet. Małe pliki marnują czas planowania, zwiększają pracę z metadanymi i obniżają efektywność odczytu w Sparku, Trino, DuckDB i hurtowniach chmurowych na równi. Jeśli sink Kafki opróżnia się co kilka sekund, uczyń kompaktowanie pełnoprawnym zadaniem, a nie refleksją po fakcie.
Dopasuj kodowania do rzeczywistego kształtu kolumny. Ustawienia domyślne są często akceptowalne dla liczb całkowitych i typowych wymiarów. Znacznie mniej satysfakcjonują przy łańcuchach o wysokiej kardynalności, długich identyfikatorach i wielu kolumnach zmiennoprzecinkowych. Ta luka liczy się bardziej w 2026 roku, bo zespoły trzymają w Parquet coraz więcej embeddingów, wyjść cech i identyfikatorów generowanych maszynowo, a domyślna ścieżka zapisu wciąż zostawia dla tych kształtów pieniądze na stole. Kodowanie słownikowe pomaga, gdy powtarzalność jest realna. Pomaga znacznie mniej, gdy niemal każda wartość jest unikalna.
Zapisuj dane tak, by statystyki miały szansę zadziałać. Predicate pushdown zależy od czegoś więcej niż od „włączonych statystyk”. Jeśli partycja dzienna zawiera w każdej row group wymieszanych klientów, regiony i typy zdarzeń, wartości minimum i maksimum stają się słabymi filtrami. Sortowanie lub klastrowanie przed zapisem daje efektywności pomijania często więcej niż zmiana kodeka kompresji.
Traktuj ewolucję schematu jak zmianę API. Dodanie kolumny dopuszczającej wartości puste jest zwykle mało ryzykowne. Zmiana nazwy pola, zmiana szerokości liczbowej, przesunięcie semantyki znacznika czasu albo przełączenie wymaganego na opcjonalne potrafi zepsuć czytniki w subtelny sposób. Waliduj zmiany schematu przed wdrożeniem i testuj je wobec silników, które liczą się na produkcji, a nie tylko wobec biblioteki zapisującej. Praktyczny sposób sformalizowania tych kontroli to wpisanie ich w Twoje dobre praktyki potoków danych dotyczące walidacji, monitorowania i kontroli zmian.
Testuj Parquet między silnikami, nie tylko wewnątrz jednego stosu. Plik, który wygląda poprawnie w Sparku, wciąż może ujawnić przypadki brzegowe w Trino, pandas, Arrow albo czytniku hurtowni. Typy logiczne, page indexes, obsługa wartości pustych i interpretacja znaczników czasu wciąż różnią się na tyle, że testy międzyczytnikowe wychwytują prawdziwe błędy produkcyjne.
Pytania produkcyjne, które w 2026 roku liczą się bardziej
Strojenie plików wciąż ma znaczenie, ale dwie kwestie zasługują teraz na większą uwagę.
Po pierwsze, domyślne kodowania są wciąż nierówne wobec nowoczesnych obciążeń. Parquet pozostaje znakomity dla wielu tabel analitycznych, jednak łańcuchy o wysokiej kardynalności i zbiory bogate w liczby zmiennoprzecinkowe często kompresują się i skanują mniej wydajnie, niż inżynierowie oczekują. Jeśli Twoje jezioro trzyma cechy modeli, identyfikatory telemetryczne albo półstrukturalne wymiary rozbite na kolumny, zmierz ustawienia zapisu na własnych danych zamiast ufać wartościom domyślnym.
Po drugie, opóźnienie zgodności jest realne. Wejście funkcji do specyfikacji to dopiero linia startu. Operacyjnie bezpieczna staje się wtedy, gdy Twoje czytniki, walidatory i narzędzia katalogowe interpretują ją tak samo. Dlatego na niezawodną pracę z Parquet składają się testy wersji, kontrole różnic schematu i obserwowalność. digna jest jedną z opcji używanych przez zespoły do tej warstwy operacyjnej: monitoruje zmiany schematu, Timeliness, anomalie i sygnały walidacyjne wewnątrz środowiska klienta.
Problemy z niezawodnością Parquet rzadko zostają w warstwie składowania. Ujawniają się później jako wolniejsze skany, cichy dryf typów, zepsute pulpity i modele trenowane na niewłaściwym kształcie danych.
Rozmiary row group i wybory kodeków dryfują wraz ze zmianami zapisujących, więc połącz te praktyki z obserwowalnością platformy danych, która zgłosi, gdy układ plików przestanie odpowiadać zaleceniom.
Najczęściej zadawane pytania
Jakie rozmiary row group i stron zaleca Parquet?
Zalecenia konfiguracyjne Parquet radzą duże row groups i małe strony, z przykładami takimi jak row groups od 512 MB do 1 GB i strony 8 KB, przy założeniu układu dopasowanego do HDFS. Wiele zespołów w magazynie obiektowym zaczyna raczej bliżej 128 MB i dostraja według wzorców skanowania, presji pamięci i zachowania magazynu.
Jaka jest różnica między Parquet w wersji 1 i 2?
Specyfikacja przeszła przez kilka wydań, ale praktyczne pytanie brzmi, które możliwości Twoje czytniki i zapisujące faktycznie wdrażają, a nie który numer wersji sobie obierasz. Dla mieszanych środowisk obejmujących Spark, DuckDB, Trino i BigQuery bezpiecznym gruntem pozostają projekcja kolumn, statystyki row group, standardowe kodowania i popularne kodeki.
Które zmiany schematu psują czytniki Parquet niżej?
Zmiany nazw to klasyczna pułapka. Dla czytających niżej zmiana nazwy wygląda jak usunięta kolumna plus nowa, więc nie zostaje zgłoszony żaden wyjątek — po prostu dostajesz wartości puste tam, gdzie wcześniej były dane. Dodawanie kolumn dopuszczających wartości puste jest zasadniczo bezpieczne; ciche awarie zaczynają się przy zmianach typów i przebudowanym zagnieżdżeniu.
Jak metadane stron poprawiają wydajność zapytań?
Ograniczają zmarnowane odczyty wewnątrz row group, nie tylko pomiędzy row groups. Czytający startuje od stopki, decyduje, które row groups i kolumny warto otworzyć, a potem używa statystyk stron, by nie dekodować tych, które nie mogą spełnić filtru. Liczy się to tym bardziej, im większe są pliki i im bardziej selektywne filtry.
Czy powinienem używać Parquet, ORC czy Avro?
Wybieraj według etapu cyklu życia, a nie według benchmarku. Avro pasuje do zapisów wierszowych, wymiany zdarzeń i wczytywania zarządzanego schematem, co czyni go dobrym formatem granicznym. Parquet i ORC celują w skany analityczne, przy czym Parquet zwykle prowadzi szerokością ekosystemu. Kłopoty zaczynają się, gdy jeden format ma pokryć każdy etap.



