Czyszczenie danych w SQL: Praktyczne wzorce
|
9
min. czyt.
Nagle, w ciągu nocy, na pulpicie nawigacyjnym pojawia się gwałtowny wzrost wartości, a pierwszym wyjaśnieniem jest zazwyczaj aktywność biznesowa. Następnie ktoś sprawdza hurtownię i znajduje zduplikowane zamówienia, brakujące klucze obce lub daty przeanalizowane w dwóch różnych formatach. Raport nie był „prawie poprawny”. Dane wejściowe były niespójne, a każda kalkulacja w dalszej części procesu odziedziczyła ten problem.
Taka jest rzeczywistość operacyjna oczyszczania danych w SQL. Praca ta polega w mniejszym stopniu na sprytnej składni, a bardziej na mierzeniu błędów, izolowaniu ryzykownych rekordów, stosowaniu deterministycznych napraw i zapobieganiu powrotom tych samych defektów. W skali hurtowni nieostrożne polecenie UPDATE może uszkodzić więcej danych niż naprawić, podczas gdy dobrze przygotowany przepływ pracy SQL może sprawić, że logika jakości stanie się powtarzalna, możliwa do przejrzenia i wydajna.
Spis treści
Dlaczego SQL pozostaje kręgosłupem oczyszczania danych
Profilowanie danych przed napisaniem pojedynczej poprawki
Ustalenie bazowego poziomu błędów
Znajdowanie duplikatów bez dotykania środowiska produkcyjnego
Obsługa wartości Null i usuwanie duplikatów na dużą skalę
Deduplikacja z jawną regułą przetrwania
Wiedza o tym, jak unikalność traktuje wartości null
Standaryzacja formatów tekstowych i naprawianie typów danych
Stosowanie jawnych konwersji
Standaryzacja przed deduplikacją
Zapewnianie jakości za pomocą ograniczeń i reguł walidacji
Wybór twardego odrzucenia lub miękkiej kwarantanny
Wyjście poza jednorazowe skrypty w stronę ciągłego monitorowania
Dlaczego SQL pozostaje kręgosłupem oczyszczania danych
Duże obciążenie analityczne może wymagać więcej czasu na przygotowanie danych niż na ich analizę. Powszechnie cytowane badanie porównawcze wskazuje, że analitycy i badacze danych mogą spędzać nawet do 80% swojego czasu na oczyszczaniu i przygotowywaniu danych, co zostało omówione w tym przeglądzie oczyszczania danych SQL od Domo. Ta alokacja wyjaśnia, dlaczego operacje takie jak filtrowanie wartości null, usuwanie duplikatów, standaryzacja formatów i walidacja zakresów stały się podstawowymi umiejętnościami inżynierów danych i inżynierów analitycznych.
SQL znajduje się blisko danych, co ma kluczowe znaczenie w nowoczesnych architekturach ELT. Surowe rekordy mogą być ładowane do hurtowni i przekształcane tam, gdzie już się znajdują, zamiast być wielokrotnie pobierane, przenoszone i przetwarzane w innym systemie. Baza danych staje się warstwą wykonawczą dla logiki jakości, podczas gdy instrukcje SQL zapewniają deterministyczny zapis tego, co się zmieniło i dlaczego.
Typowy incydent zaczyna się od małego defektu, który przeradza się w duży problem z raportowaniem:
Zduplikowane zdarzenia biznesowe: Ponowna próba w zadaniu pobierania danych tworzy dwa wiersze dla jednej transakcji, sztucznie zawyżając przychody lub wolumen.
Brakujące klucze powiązań: Brakujący klucz klienta lub produktu (null) uniemożliwia dopasowanie złączenia (join), przez co pulpit nawigacyjny zaniża aktywność.
Rozbieżność formatów: Jedno źródło wysyła datę jako tekst w innym formacie, co przenosi rekordy do niewłaściwego okresu sprawozdawczego.
Wartości wartownicze (sentinel): Puste ciągi znaków, zastępcze daty lub zera zastępują brakujące informacje i przechodzą powierzchowne kontrole wartości null.
Zasada produkcyjna: Traktuj oczyszczanie jako kontrolowaną operację na danych, a nie jako improwizowaną serię poprawek w zapytaniu pulpitu nawigacyjnego.
To rozróżnienie ma znaczenie, ponieważ SQL może zarówno naprawiać, jak i ukrywać błędy. Instrukcja COALESCE może sprawić, że raport zostanie wygenerowany, jednocześnie maskując brakującą wartość, która powinna wywołać incydent na wcześniejszym etapie. Szerokie polecenie DELETE może usunąć duplikaty, ale jednocześnie usunąć prawidłowy rekord, który powinien zostać zachowany. Dobra logika oczyszczania najpierw klasyfikuje błędy, izoluje dotknięte wiersze i zachowuje wystarczająco dużo dowodów, aby móc zweryfikować decyzję.
Dla czytelników, którzy chcą poznać szersze przykłady SQL i praktyczne perspektywy, zasoby SQL firmy Wonderment Apps oferują przydatny kontekst dotyczący języka i jego zastosowań. Dla zespołów oceniających natywne dla hurtowni wykonywanie kontroli jakości, wskazówki digna dotyczące jakości danych w bazie danych są istotne, ponieważ utrzymywanie kontroli blisko danych zmniejsza niepotrzebny ruch i oddziela logikę walidacji od niestabilnych zewnętrznych skryptów.
Profilowanie danych przed napisaniem pojedynczej poprawki
Najbardziej kosztownym błędem podczas oczyszczania jest często ten pierwszy: napisanie instrukcji UPDATE przed zmierzeniem problemu. Profil daje punkt odniesienia, ujawnia, czy problem jest odosobniony czy systemowy, oraz pozwala porównać zestaw danych przed i po naprawie.
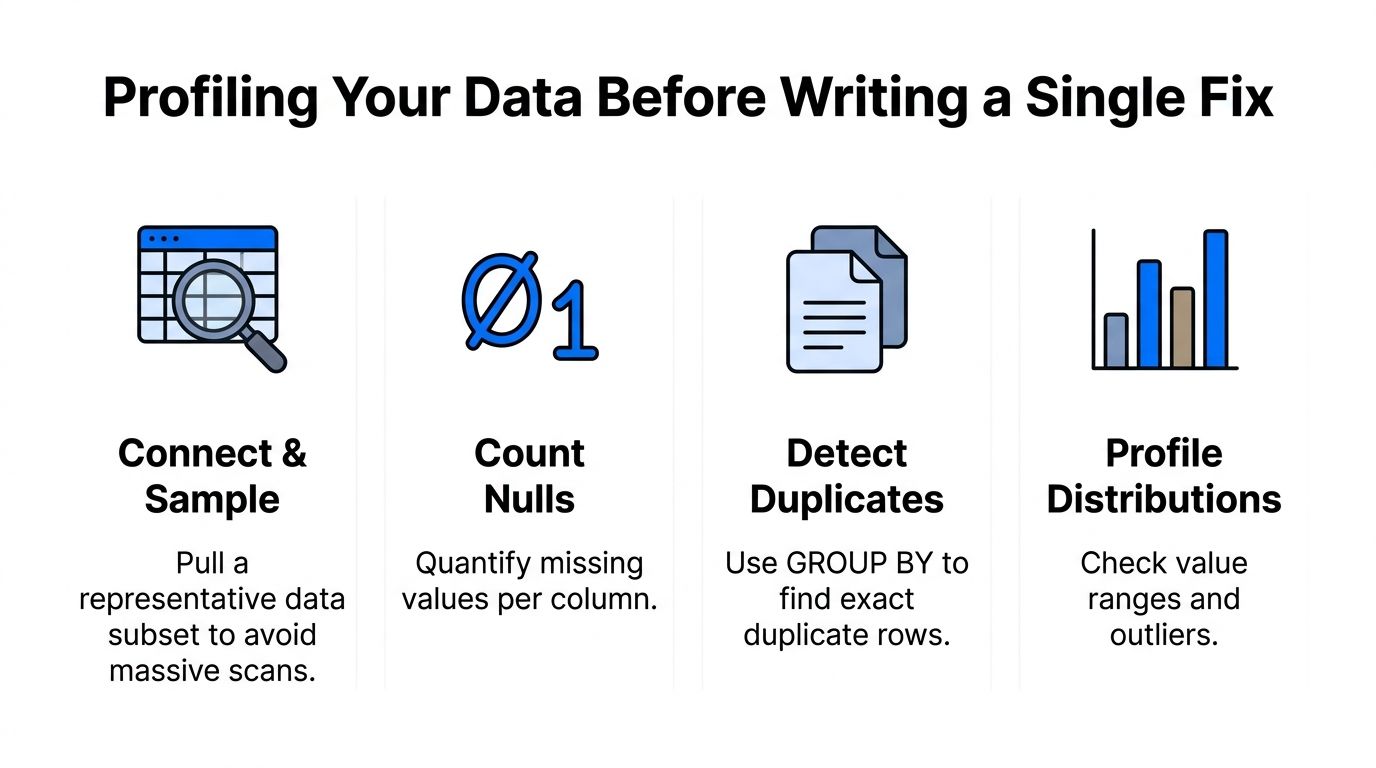
Gdy tabela jest duża, zacznij od reprezentatywnej próbki. Próbka nie zastąpi pełnego przebiegu walidacji, ale pomaga sprawdzić formaty i wartości biznesowe bez natychmiastowego wymuszania masowego skanowania. Uruchamiaj ukierunkowane agregacje na pełnej tabeli, gdy silnik hurtowni i partycjonowanie czynią takie kontrole praktycznymi.
Ustalenie bazowego poziomu błędów
W przypadku kolumn mogących przyjmować wartości null, zliczaj brakujące wartości bezpośrednio, zamiast polegać na wizualnej próbce:
Wskaźnik wartości null jest użyteczny, ponieważ sprawia, że błąd staje się mierzalny i porównywalny pomiędzy przebiegami potoku danych. Możesz także pogrupować braki według systemu źródłowego, partycji lub daty pobrania, aby odróżnić długotrwałą charakterystykę danych od niedawnej awarii.
Kontrole unikalnych wartości ujawniają nieoczekiwane kategorie:
Szukaj wariantów pisowni, niespójnej wielkości liter, pustych ciągów znaków oraz wartości naruszających słownik biznesowy. Kolumna, która wydaje się zawierać mały zestaw statusów, może zawierać kilka reprezentacji tego samego stanu.
Znajdowanie duplikatów bez dotykania środowiska produkcyjnego
Wykrywanie dokładnych duplikatów zaczyna się od pogrupowania kolumn definiujących rekord:
To zapytanie informuje o istnieniu duplikatów, ale nie wskazuje, który wiersz powinien zostać zachowany. Przechwyć podejrzane rekordy w oddzielnej tabeli przejściowej (staging) i dołącz metadane pobierania, priorytet źródła, znacznik czasu aktualizacji oraz stabilny klucz zastępczy, jeśli jest dostępny.
Dokładna składnia różni się w zależności od hurtowni, ale zasada działania jest spójna: nigdy nie eksperymentuj bezpośrednio na relacji produkcyjnej, jeśli możesz najpierw wyizolować kandydatów. Praktyczne wskazówki dotyczące oczyszczania SQL zalecają również walidację transformacji na małych podzbiorach przed ich szerokim zastosowaniem, co zmniejsza promień rażenia nieprawidłowego predykatu. Techniki profilowania danych stosowane przy oczyszczaniu hurtowni uzupełniają to podejście, czyniąc fazę inspekcji jawną, a nie traktując ją jako opcjonalne przygotowanie.
Najpierw zmierz, potem naprawiaj. Jeśli nie potrafisz określić, ile wierszy dotyczy problem, nie możesz bezpiecznie zweryfikować zmiany.
Obsługa wartości Null i usuwanie duplikatów na dużą skalę
Obsługa wartości null to decyzja biznesowa przebrana za wyrażenie SQL. Zastąpienie każdej brakującej wartości wartością domyślną może uprościć kolejne zapytania, ale może również zamienić stan „nieznany” w fałszywe twierdzenie. Zachowaj oryginalną wartość, gdy to rozróżnienie ma znaczenie.
Funkcja COALESCE jest odpowiednia, gdy wartość rezerwowa ma jasne znaczenie:
Ten wzorzec jest bezpieczniejszy do celów prezentacji niż do nieodwracalnego przechowywania. Jeśli brak waluty oznacza, że źródło nie dostarczyło wymaganych informacji, bardziej uczciwa jest flaga walidacji:
Funkcja NULLIF pomaga przekształcić znane symbole zastępcze w rzeczywiste wartości null przed profilowaniem:
Możesz również użyć logiki warunkowej, gdy właściwe zastąpienie zależy od udokumentowanej reguły. Nie wnioskuj o atrybucie klienta na podstawie niepowiązanego pola tylko dlatego, że zapytanie wymaga wartości innej niż null.
Deduplikacja z jawną regułą przetrwania
Funkcja ROW_NUMBER() jest trwałym wzorcem identyfikacji jednego ocalałego rekordu w każdej grupie duplikatów:
Klauzula ORDER BY jest kluczową częścią. Zasada „zachowaj najnowsze” działa tylko wtedy, gdy znacznik czasu jest wiarygodny, a w przypadku remisów istnieje deterministyczna reguła rezerwowa. Jeśli rekordy różnią się stopniem kompletności, nadaj im priorytet na podstawie udokumentowanej reguły kompletności, zamiast zakładać, że ostatnio przybyły wiersz jest najlepszy.
W przypadku tabel o skali hurtowni, w miarę możliwości zmaterializuj sklasyfikowany wynik w nowej relacji lub partycji zastępczej. Odbudowanie czystej partycji może być bezpieczniejsze niż wykonywanie masowego usuwania wiersz po wierszu, zwłaszcza gdy tabela jest klastrowana lub partycjonowana. Zachowaj odrzucone wiersze w tabeli audytowej, jeśli duplikaty mogą wymagać poprawki w systemie źródłowym.
Wiedza o tym, jak unikalność traktuje wartości null
SQL Server charakteryzuje się szczególnie ważnym zachowaniem: ograniczenie UNIQUE dopuszcza wartość NULL, ale dozwolona jest tylko jedna wartość NULL na kolumnę z ograniczeniem, co zostało udokumentowane w dokumentacji firmy Microsoft dotyczącej ograniczeń unikalności i check. To zachowanie może zaskoczyć zespoły oczyszczające opcjonalne pola, ponieważ obsługa wartości null wpływa na to, czy kolejne rekordy zostaną zaakceptowane, czy odrzucone.
Użyj kontroli kompletności danych, aby oddzielić statusy „brakujący, ale dozwolony” od „brakujący i nieprawidłowy”. Usuwaj duplikaty tylko wtedy, gdy reguła tożsamości jest jednoznaczna. W przeciwnym razie oznacz grupę do weryfikacji i zachowaj dowody potrzebne do wyjaśnienia, dlaczego wybrano konkretny rekord.
Standaryzacja formatów tekstowych i naprawianie typów danych
Niespójności w tekście często przechodzą podstawowe testy, ponieważ dla człowieka wyglądają poprawnie. Końcowa spacja w kluczu złączenia, różna wielkość liter w statusie lub znak Unicode przypominający znak ASCII mogą powodować niedopasowane złączenia i pofragmentowane agregacje.
Najpierw znormalizuj wartości w kontrolowanej projekcji:
Funkcja TRIM usuwa otaczające białe znaki, podczas gdy UPPER i LOWER ustanawiają spójną formę porównania. Funkcja REPLACE może usunąć znane znaki formatowania, ale szerokie zamiany są ryzykowne, gdy interpunkcja ma znaczenie. Wyrażenia regularne są przydatne do walidacji wzorców i ukierunkowanych poprawek tam, gdzie hurtownia je obsługuje, ale powinny być testowane na rzeczywistych wariantach źródłowych, a nie stosowane jako uniwersalne narzędzie czyszczące.
Stosowanie jawnych konwersji
Niejawne rzutowania (casts) są wygodne podczas eksploracji i niebezpieczne na produkcji. Wartość tekstowa może zostać przekonwertowana inaczej w zależności od silnika, ustawień sesji, ustawień regionalnych lub typu docelowego. Jawne instrukcje CAST lub CONVERT sprawiają, że zamierzona reprezentacja staje się widoczna:
Przed konwersją sprofiluj wartości, które nie są zgodne z oczekiwanym formatem. Nieudane rzutowanie powinno zostać zarejestrowane jako wyjątek jakości, a nie odrzucone. Sprawdź również precyzję i skalę, ponieważ docelowy typ numeryczny może utracić istotne szczegóły, jeśli jest węższy niż źródłowy.
Dane czasowe wymagają jeszcze większej ostrożności. Znacznik czasu bez kontekstu strefy czasowej może ulec przesunięciu, gdy systemy interpretują go przy różnych ustawieniach sesji. Standaryzuj konwencję źródłową, konwertuj z jawną polityką strefy czasowej i zachowaj oryginalną, surową wartość, dopóki wynik nie przejdzie pomyślnie walidacji.
Standaryzacja przed deduplikacją
Kolejność ma znaczenie. Praktyczna sekwencja oczyszczania to inspekcja wartości null, duplikatów i nietypowych formatów, a następnie standaryzacja tekstu, naprawa typów i deduplikacja po sprowadzeniu równoważnych wartości do wspólnej formy. Kolejność ta została opisana w wskazówkach dotyczących oczyszczania danych SQL w zakresie inspekcji i standaryzacji.
Jeśli deduplikujesz dane przed usunięciem spacji (trim) i normalizacją, rekordy takie jak ACME i ACME pozostaną rozdzielone, mimo że biznes traktuje je jako jeden klucz. Jeśli dodasz ograniczenia przed konwersją typów, baza danych może odrzucić prawidłowe rekordy przychodzące lub zachować nieodpowiednią reprezentację. Podczas programowania utrzymuj kolumny surowe, znormalizowane i zweryfikowane oddzielnie, aby recenzenci mogli porównać każdą transformację.
Zapewnianie jakości za pomocą ograniczeń i reguł walidacji
Skrypt czyszczący naprawia bieżącą partię. Ograniczenie (constraint) chroni następną partię. Używaj zabezpieczeń bazy danych tam, gdzie reguła jest stabilna, lokalna dla rekordu i wystarczająco ważna, aby odrzucić nieprawidłowe dane podczas pobierania.
Ograniczenie | Zakres | Najlepszy przypadek użycia |
|---|---|---|
| Obecność w kolumnie | Wymagane identyfikatory, daty i klucze |
| Pojedyncza kolumna lub kombinacja | Kontrola tożsamości i zapobieganie duplikatom |
| Reguła logiczna na poziomie wiersza | Dozwolone zakresy, statusy i kolejność dat |
Reguła NOT NULL jest prosta, ale powinna odzwierciedlać rzeczywiste wymagania. Zastosowanie jej do opcjonalnego atrybutu tworzy opór operacyjny bez poprawy poprawności. Reguła UNIQUE sprawdza się dobrze w przypadku naturalnych identyfikatorów lub złożonych kluczy biznesowych, pod warunkiem, że zdefiniowano, jak powinny zachowywać się wartości null i opóźnione aktualizacje.
Ograniczenia CHECK wyrażają reguły takie jak:
Wyrażenia CHECK w ANSI SQL mogą przyjmować wartości TRUE, FALSE lub UNKNOWN i są ograniczone do spójności dziedziny. Mogą walidować wartości wiersza, ale nie mogą sprawdzać innych wierszy pod kątem spójności międzywierszowej, jak wyjaśniono w tym odniesieniu do migracji ograniczeń SQL. Ograniczenie CHECK może odrzucić ujemną kwotę lub nieprawidłową kolejność dat. Nie może jednak potwierdzić, czy suma konta zgadza się z osobną tabelą.
Wybór twardego odrzucenia lub miękkiej kwarantanny
Twarde ograniczenia są odpowiednie, gdy zaakceptowanie błędnego wiersza uszkodziłoby krytyczną tabelę, a źródło może szybko naprawić błędy. Są one mniej odpowiednie, gdy systemy nadrzędne regularnie wysyłają niepełne rekordy, które wymagają zbadania przed finalizacją.
Miękki wzorzec polega na zapisaniu rekordu przy jednoczesnym dodaniu kolumn walidacyjnych, takich jak is_valid, failure_reason lub rule_name. Modele downstream mogą wykluczać błędne wiersze, podczas gdy zespoły operacyjne zachowują wgląd w błędy źródłowe. To podejście wymaga większego nakładu pracy projektowej, ale pozwala uniknąć sytuacji, w której przejściowy problem źródłowy zmienia się w nieudane ładowanie pozbawione kontekstu diagnostycznego.
Wytyczne dotyczące reguł walidacji danych SQL i ciągłego zapewniania jakości zapewniają użyteczne ramy do oddzielania wymaganych wartości, formatów, kompletności, unikalności i spójności referencyjnej. W praktyce należy połączyć ograniczenia z walidacją na etapie przejściowym (staging). Ograniczenia są ostateczną bramą, a nie substytutem profilowania, klasyfikacji błędów czy ścieżki audytu.
Wyjście poza jednorazowe skrypty w stronę ciągłego monitorowania
Oczyszczanie w SQL ma charakter reaktywny. Naprawia ono rekordy po tym, jak błąd trafił do potoku, podczas gdy ciągłe monitorowanie poszukuje warunków wskazujących na regresję.
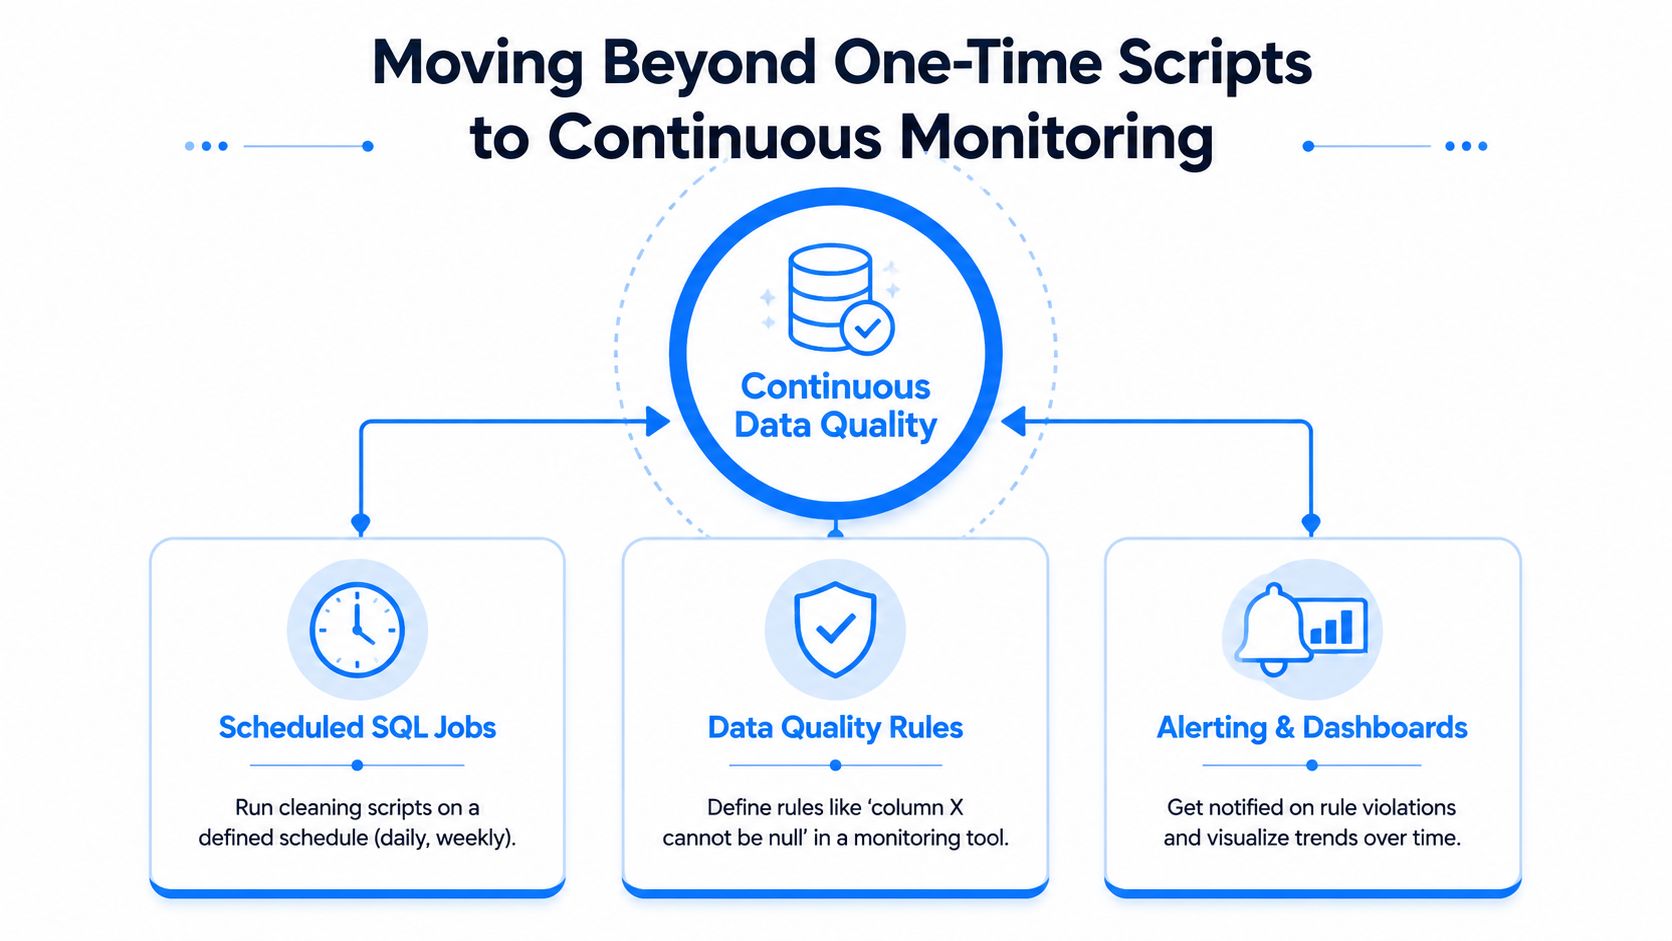
Dojrzały przepływ pracy nakłada kilka sygnałów na oczyszczony zestaw danych:
Zaplanowane zadania SQL: Uruchamianie deterministycznych transformacji zgodnie ze zdefiniowanym harmonogramem i rejestrowanie liczby dotkniętych wierszy.
Reguły jakości: Sprawdzanie wymaganych wartości, prawidłowych formatów, unikalności, integralności referencyjnej i warunków biznesowych.
Wykrywanie anomalii: Porównywanie bieżących rozkładów i wolumenów z ustalonym zachowaniem w celu ujawnienia nietypowych zmian.
Kontrola terminowości (Timeliness): Wykrywanie brakujących, opóźnionych lub nieoczekiwanie wczesnych dostaw.
Śledzenie schematu: Identyfikowanie dodanych lub usuniętych kolumn oraz zmian typów danych, zanim zapytania w dalszej części procesu zakończą się niepowodzeniem.
Właściwa inwestycja zależy od rodzaju awarii. Napisz skrypt SQL, gdy reguła jest deterministyczna, transformacja powtarzalna, a dotknięty zestaw danych jest wyraźnie ograniczony. Dodaj zautomatyzowaną obserwowalność (observability), gdy błędy się powtarzają, zachowanie źródła się zmienia, czas dostawy ma znaczenie lub gdy błąd pulpitu nawigacyjnego zostałby wykryty zbyt późno podczas ręcznej weryfikacji.
Platformy takie jak digna wykonują kontrole jakości i anomalii wewnątrz środowiska bazy danych klienta, umożliwiając zespołom monitorowanie zachowania danych bez przenoszenia rekordów produkcyjnych do zewnętrznej warstwy przetwarzania. Funkcje monitorowania jakości danych tej platformy wypełniają lukę między zaplanowanym oczyszczaniem a ciągłym wykrywaniem, łącząc walidację, anomalie, terminowość (timeliness) i monitorowanie strukturalne.
Użyj platformy digna do uruchamiania walidacji w bazie danych, wykrywania anomalii, kontroli terminowości (timeliness) oraz śledzenia schematów w zestawach danych, od których zależą Twoje potoki SQL. Odwiedź digna, aby zobaczyć, jak ciągłe monitorowanie może przekształcić jednorazową logikę oczyszczania w operacyjny system jakości danych.
Najczęściej zadawane pytania
Dlaczego SQL pozostaje kręgosłupem czyszczenia danych?
Bo znajduje się blisko danych, co ma znaczenie w nowoczesnych architekturach ELT, gdzie transformacja następuje po załadowaniu. Szeroko cytowany punkt odniesienia mówi, że analitycy i naukowcy danych potrafią poświęcać do 80 % czasu na czyszczenie i przygotowanie danych, więc miejsce wykonywania tej pracy to nie drobiazg.
Które usterki wyrządzają najwięcej szkód w raportowaniu?
Powtarzają się cztery: zduplikowane zdarzenia biznesowe, gdy ponowienie ingestii tworzy dwa wiersze i zawyża przychód; brakujące klucze relacji, gdy wartość pusta uniemożliwia złączenie i pulpit zaniża liczby; dryf formatu, gdy data przychodzi w innej konwencji i przesuwa rekordy do złego okresu; oraz wartości zastępcze przechodzące powierzchowne kontrole wartości pustych.
Dlaczego wartości zastępcze są szczególnie groźne?
Bo wyglądają jak dane. Puste łańcuchy, daty wypełniające i zera zastępują brakującą informację i czysto przechodzą kontrolę wartości pustych, więc rekord liczy się jako kompletny, choć w kluczowym polu nie niesie nic użytecznego.
Czy SQL potrafi ukrywać usterki tak samo jak je naprawiać?
Tak, i dlatego czyszczenie należy traktować jako kontrolowaną operację na danych, a nie improwizowany ciąg poprawek wewnątrz zapytania pulpitu. COALESCE w warstwie raportowej usuwa jednocześnie objaw i dowód.
Co zrobić przed napisaniem pierwszej poprawki?
Sprofilować dane. Znajomość bieżącego wolumenu, rozkładu, udziału wartości pustych i wzorców wartości pokazuje, które usterki faktycznie występują, a nie te, o których każe myśleć ostatni incydent.



