Czym jest otwarty format tabeli i dlaczego ma znaczenie
|
9
min. czyt.

Jeśli Twoje jezioro przechowuje już pliki Parquet, dlaczego nie daje Ci to automatycznie tabeli?
Na tej luce potyka się wiele zespołów. Mają pliki, foldery, partycje i silniki SQL zdolne je czytać. Ale wciąż nie mają wiarygodnej odpowiedzi na podstawowe pytania produkcyjne: które pliki tworzą bieżącą wersję tej tabeli? Co się stanie, jeśli dwa zadania zapiszą naraz? Czy mogę wycofać wadliwe ładowanie bez ręcznego odbudowywania danych?
Spis treści
Czym jest otwarty format tabeli
Jeśli Twoje jezioro przechowuje już pliki Parquet, dlaczego potoki produkcyjne wciąż psują się na czymś tak prostym jak „która tabela jest bieżąca”?

Zespoły prowadzące współbieżne zapisy Sparka na spartycjonowany prefiks Parquet często poznają odpowiedź boleśnie. Pliki istnieją, ale stan tabeli jest niejasny. Jeden silnik może przeczytać częściowo zaktualizowaną partycję, inny przeoczyć nowo dodane pliki, a inżynier na dyżurze kończy, ręcznie przeglądając ścieżki magazynu obiektowego, by ustalić, co w ogóle znaczy „bieżący”.
Otwarty format tabeli rozwiązuje ten problem na warstwie metadanych. Definiuje, jak tabela śledzi swoje pliki, wersje, zmiany schematu i operacje zapisu, tak aby wiele silników mogło traktować dane w magazynie obiektowym jak prawdziwą tabelę, a nie luźną konwencję katalogów.
To rozróżnienie ma znaczenie, bo kluczowa decyzja jest architektoniczna, a nie dotyczy wyboru nowego typu pliku. Pliki danych nadal są często Parquet albo ORC. Jeśli chcesz odświeżyć wiedzę o warstwie składowania pod spodem, to wyjaśnienie formatu Parquet obejmuje ten fundament. Otwarty format tabeli leży nad tymi plikami i zapisuje reguły stanu tabeli.
Użyteczną analogią jest magazyn z opisanymi pojemnikami inwentarzowymi. Pliki Parquet to kartony na podłodze. Otwarty format tabeli to system inwentarzowy, który mówi, które kartony należą do bieżącej dostawy, które wymieniono, kto zaktualizował wpisy i jak magazyn wyglądał przed ostatnią nieudaną zmianą. Bez tego systemu każdy czytający musi zgadywać z tego, co widzi w magazynie.
W praktyce ta architektura metadanych daje Ci zachowanie tabeli, którego same pliki czysto nie zapewniają. Dostajesz transakcje ACID, ewolucję schematu i podróż w czasie, bo format prowadzi spójny zapis stanu tabeli i zmian w czasie. Dlatego Apache Hudi, Apache Iceberg i Delta Lake omawia się zwykle razem. To różne sposoby radzenia sobie z tym samym problemem u podstaw.
Efekty operacyjne to część, którą czują inżynierowie. Dryf schematu łatwiej kontrolować, bo tabela ma miarodajną historię schematu. Koszt zapytań spada, bo silniki mogą korzystać z metadanych zamiast skanować każdy plik tylko po to, by odkryć, co istnieje. Obserwowalność rośnie, bo można badać migawki, zatwierdzenia i zmiany na poziomie plików zamiast traktować prefiks magazynu jak czarną skrzynkę.
Najkrótsza trafna definicja brzmi więc tak: otwarty format tabeli to otwarta specyfikacja zarządzania metadanymi i zachowaniem tabeli nad plikami w magazynie obiektowym. Pliki trzymają dane. Format definiuje, jak systemy uzgadniają, czym jest tabela.
Warstwa metadanych, która zmienia wszystko
Dlaczego dwa silniki czasem czytają to samo jezioro i zwracają różne odpowiedzi?
Przyczyną często nie są same pliki. To brak wspólnego, miarodajnego zapisu stanu tabeli. Dlatego otwarte formaty tabel najlepiej rozumieć jako wybór architektury metadanych. Pliki wciąż mają znaczenie, ale zachowanie produkcyjne zależy głównie od tego, jak warstwa metadanych definiuje prawdę.
Katalog biblioteczny jest tu użytecznym modelem. Książki na półkach to Twoje pliki Parquet. Katalog decyduje, które książki należą do zbioru, które wydanie jest aktualne, które usunięto i jak zbiór wyglądał wczoraj. Bez katalogu każdy czytelnik chodzi wzdłuż półek i zgaduje na własną rękę.
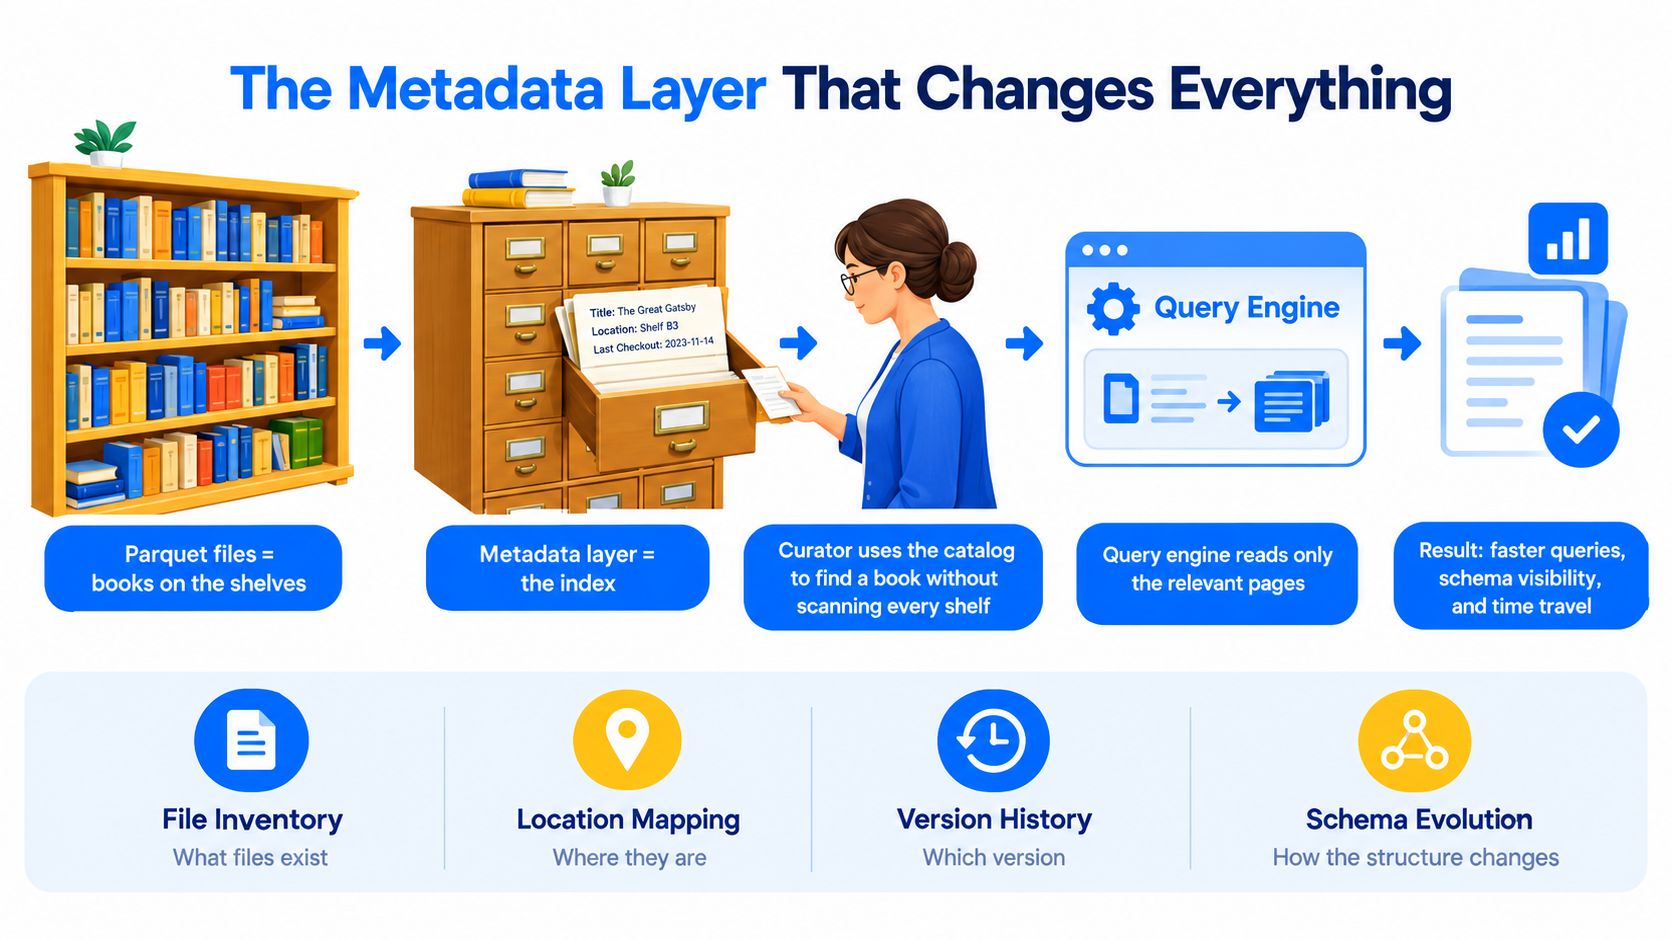
Ta różnica szybko wychodzi w eksploatacji. Koszt zapytań rośnie, gdy silniki muszą listować katalogi i oglądać pliki tylko po to, by odkryć tabelę. Dryf schematu trudniej powstrzymać, gdy żaden system nie posiada historii schematu. Obserwowalność zostaje słaba, gdy prefiks magazynu to jedyne, co możesz obejrzeć.
Szerszy kontekst tego, jak zespoły porządkują i nadzorują metadane, opisuje przewodnik digny po zarządzaniu metadanymi.
Sześć rzeczy, które zmienia warstwa metadanych
Migawki tworzą spójny widok tabeli
Czytający nie interpretują „jakichkolwiek plików, które akurat istnieją” jako tabeli. Czytają z określonej migawki, co daje każdemu silnikowi tę samą odpowiedź o bieżącym stanie w danym momencie.Śledzenie plików obniża koszt planowania
Zamiast skanować całe drzewo katalogów, silnik może sięgnąć po metadane, które już wymieniają istotne pliki danych i ich statystyki. W praktyce oznacza to niższy koszt zapytań i bardziej przewidywalne planowanie, zwłaszcza gdy tabele rosną.Transakcje zapobiegają częściowej widoczności
Zapis staje się widoczny, gdy zatwierdzenie się powiedzie. Jeśli zadanie polegnie w połowie, czytający zostają na poprzedniej poprawnej migawce zamiast widzieć mieszankę starych i nowych plików.Ewolucja schematu staje się jawna
Dodania, zmiany nazw i zmiany typów kolumn zapisywane są jako zmiany metadanych tabeli. Daje Ci to źródło prawdy dla historii schematu zamiast polegania na tym, że każdy silnik wywnioskuje strukturę z plików.Partycjonowanie staje się regułą tabeli
Układ katalogów przestaje nieść tak wiele znaczenia. Metadane tabeli mogą wprost opisywać logikę partycji, co ułatwia zarządzanie zmianami układu w czasie.Historia staje się dostępna do wglądu
Starsze migawki pozostają częścią zapisu tabeli. Pomaga to przy wycofywaniu, diagnostyce, pytaniach audytowych i prostych kwestiach w rodzaju „co zmieniło się między tymi dwoma przebiegami?”.
Konkretny tryb awarii ułatwia to zobaczyć.
Potok wsadowy zapisuje nowy dzień danych do magazynu obiektowego. Jeden silnik zapytań zaczyna czytać, gdy zapis wciąż trwa. Inny czyta kilka minut później, gdy dotarły kolejne pliki. Oba zespoły mówią, że odpytały „tę samą tabelę”. Nieprawda. Odpytały różne listy plików w różnych momentach.
Z otwartym formatem tabeli zatwierdzenie publikuje nowy stan tabeli dopiero wtedy, gdy jest kompletny. Do tego czasu czytający korzystają z poprzedniej migawki. To właśnie ta zmiana operacyjna. Przestajesz traktować listę folderu jako kontrakt, a zaczynasz traktować jako kontrakt metadane.
Reguła praktyczna: jeśli zawartość folderów definiuje Twoją tabelę w chwili odczytu, zachowanie tabeli wciąż opiera się na konwencjach magazynu.
Apache Iceberg czyni ten kontrakt szczególnie wyraźnym. Jego specyfikacja tabel definiuje metadane jako obiekt JSON, który śledzi schemat, specyfikacje partycji, właściwości i migawki, przy czym migawki zapisane są w samych metadanych tabeli, jak opisuje specyfikacja tabel Iceberg.
Dlatego ta warstwa tak wiele zmienia na produkcji. Decyduje, jak systemy uzgadniają prawdę o tabeli, a ta decyzja wpływa na poprawność, koszt i to, jak szybko Twój zespół potrafi wyjaśnić zły wynik.
Apache Iceberg, Delta Lake i Apache Hudi w porównaniu
Jeśli otwarte formaty tabel to naprawdę wybór architektury metadanych, a nie tylko formatu pliku, porównanie się zmienia. Nie wybierasz między trzema sposobami przechowywania Parquet. Wybierasz trzy sposoby definiowania prawdy tabeli, publikowania zmian i koordynowania czytających oraz zapisujących na produkcji.
To ujęcie ma znaczenie, bo ból operacyjny pojawia się w różnych miejscach. Jeden format może zmniejszyć tarcie między silnikami. Inny naturalniej pasuje do platformy skupionej na Sparku. Trzeci może ułatwić eksploatację częstych aktualizacji i potoków CDC. Praktyczne pytanie brzmi prosto: gdzie chcesz, by system metadanych dźwigał największy ciężar?
Iceberg, Delta Lake i Hudi w skrócie
Wymiar | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Pochodzenie | Opracowany w Netflix w 2018, przekazany Apache w 2019 | Udostępniony jako open source w 2019 | Stworzony w Uberze w 2016 |
Główny nacisk | Przenośna specyfikacja metadanych między silnikami | Mocny protokół tabel skupiony na Sparku i integracja platformy | Upserty, przetwarzanie przyrostowe i konserwacja tabel mocno strumieniowa |
Model metadanych | Drzewo metadanych oparte na migawkach i manifestach | Log transakcji skupiony wokół | Oś czasu zatwierdzeń z usługami tabel i konserwacją zorientowaną na rekordy |
Najlepsze dopasowanie | Środowiska lakehouse z wieloma silnikami | Krajobrazy mocno oparte na Databricks albo Sparku | Potoki CDC i strumieniowe z częstymi aktualizacjami |
Odczucie operacyjne | Czysty rozdział między plikami a metadanymi tabeli | Zwarty przepływ dla zespołów już wystandaryzowanych na narzędziach Delta | Więcej usług tabelowych, większy nacisk na ścieżkę zapisu |
Historia powstania liczy się mniej niż środek ciężkości projektu. Każdy format odpowiada inaczej na to samo pytanie: jak tabela powinna zapisywać zmiany, ujawniać bieżący stan i pozwalać silnikom uzgodnić, co czytają?
Czym różnią się projekty
Apache Iceberg stawia tabelę wokół drzewa metadanych. Zwykle przemawia to do zespołów z wieloma silnikami, bo kontrakt tabeli jest zdefiniowany jako przenośna specyfikacja, a nie przez zachowanie jednego stosu przetwarzania. W praktyce oznacza to często mniej niespodzianek, gdy Spark, Trino, Flink i inne silniki muszą czytać te same dane bez wymyślania osobnych konwencji.
Delta Lake stawia tabelę wokół logu transakcji. Dla zespołów już wystandaryzowanych na Sparku i Databricks wydaje się to często naturalne, bo ścieżka zapisu, kontrole nadzoru i narzędzia operacyjne ściśle się zgrywają. Wybór metadanych widać w codziennej pracy. Zmiany schematu, wycofywanie i konserwacja tabel bywają bardziej zintegrowane, gdy szersza platforma i tak zakłada semantykę Delta.
Apache Hudi kieruje znacznie więcej projektu na eksploatację mocno zapisującą. Jeśli Twoim bólem nie jest „wiele silników musi się zgadzać”, lecz „rekordy zmieniają się bez przerwy, a odbiorcy niżej potrzebują ruchu przyrostowego”, Hudi wchodzi do rozmowy wcześnie. Jego architektura odzwierciedla to nachylenie. Specyfikacja techniczna Hudi wyjaśnia, że metadane trzymane są w wewnętrznie zarządzanej tabeli pod ścieżką specyfikacji technicznej Hudi .hoodie/metadata, a ta tabela metadanych sama jest tabelą Hudi w trybie merge-on-read.
Użyteczną analogią jest magazynowy system inwentarzowy. Iceberg zaprojektowano tak, by wiele działów mogło ufać temu samemu wpisowi katalogowemu. Delta zaprojektowano tak, by magazyn i jego system operacyjny działały ściśle razem. Hudi zaprojektowano dla magazynu, w którym towary są stale poprawiane, wymieniane albo uzupełniane, a inwentarz musi nadążać za tym ruchem.
Co te wybory znaczą na produkcji
Zespoły najpierw czują różnicę.
Jeśli dryf schematu wraca regularnie, model metadanych ma znaczenie, bo ewolucja schematu to nie tylko haczyk na liście funkcji. Decyduje, czy zadania niżej zawodzą głośno, czytają pomieszane założenia, czy wymagają obsługi zależnej od silnika.
Jeśli koszt zapytań wciąż rośnie, liczy się układ metadanych, bo tabela musi pomóc silnikowi unikać zbędnych plików. Czystsza ścieżka planowania zwykle oznacza mniej skanowanych plików i mniej kosztownych niespodzianek w czasie wykonania.
Jeśli problemem są luki w obserwowalności, liczy się wybór formatu, bo historia metadanych decyduje, jak łatwo Twój zespół odpowie na podstawowe pytania operacyjne. Która migawka wprowadziła złe rekordy? Które zatwierdzenie zmieniło zachowanie partycji? Który zapisujący opublikował niezgodne pliki?
Dlatego też decyzje o formacie tabeli i kontrole jakości okazują się powiązane. W środowiskach mocno opartych na Databricks praktyki jakości danych w Databricks trzeba często projektować razem z zachowaniem tabel Delta, a nie traktować jako warstwę doklejoną później.
Praktyczny sposób wyboru
Użyj Iceberg, jeśli interoperacyjność między silnikami jest wymaganiem pierwszej kategorii i chcesz, by sama specyfikacja tabeli pozostała możliwie niezależna od środowiska jednego dostawcy.
Użyj Delta Lake, jeśli Twoja platforma i tak mocno stoi na Sparku albo Databricks i cenisz ścisłą integrację ścieżki zapisu, nadzoru i codziennej eksploatacji.
Użyj Hudi, jeśli częste aktualizacje, wczytywanie CDC i konsumpcja przyrostowa definiują obciążenie bardziej niż szeroka przenośność między silnikami.
Żaden format nie wygrywa w każdej kategorii. Każdy umieszcza kontrakt metadanych w nieco innej roli. Ten wybór projektowy kształtuje sposób, w jaki radzisz sobie z poprawnością, kosztem i diagnozowaniem incydentów, gdy tabela jest już na produkcji.
Jak zapytanie naprawdę dociera do danych
Dlaczego to samo zapytanie SQL bywa tanie na jednej tabeli i boleśnie kosztowne na innej, choć obie wskazują ten sam magazyn obiektowy?
Odpowiedź leży zwykle w metadanych, nie w samym Parquet.
SELECT * FROM sales WHERE order_date = current_date
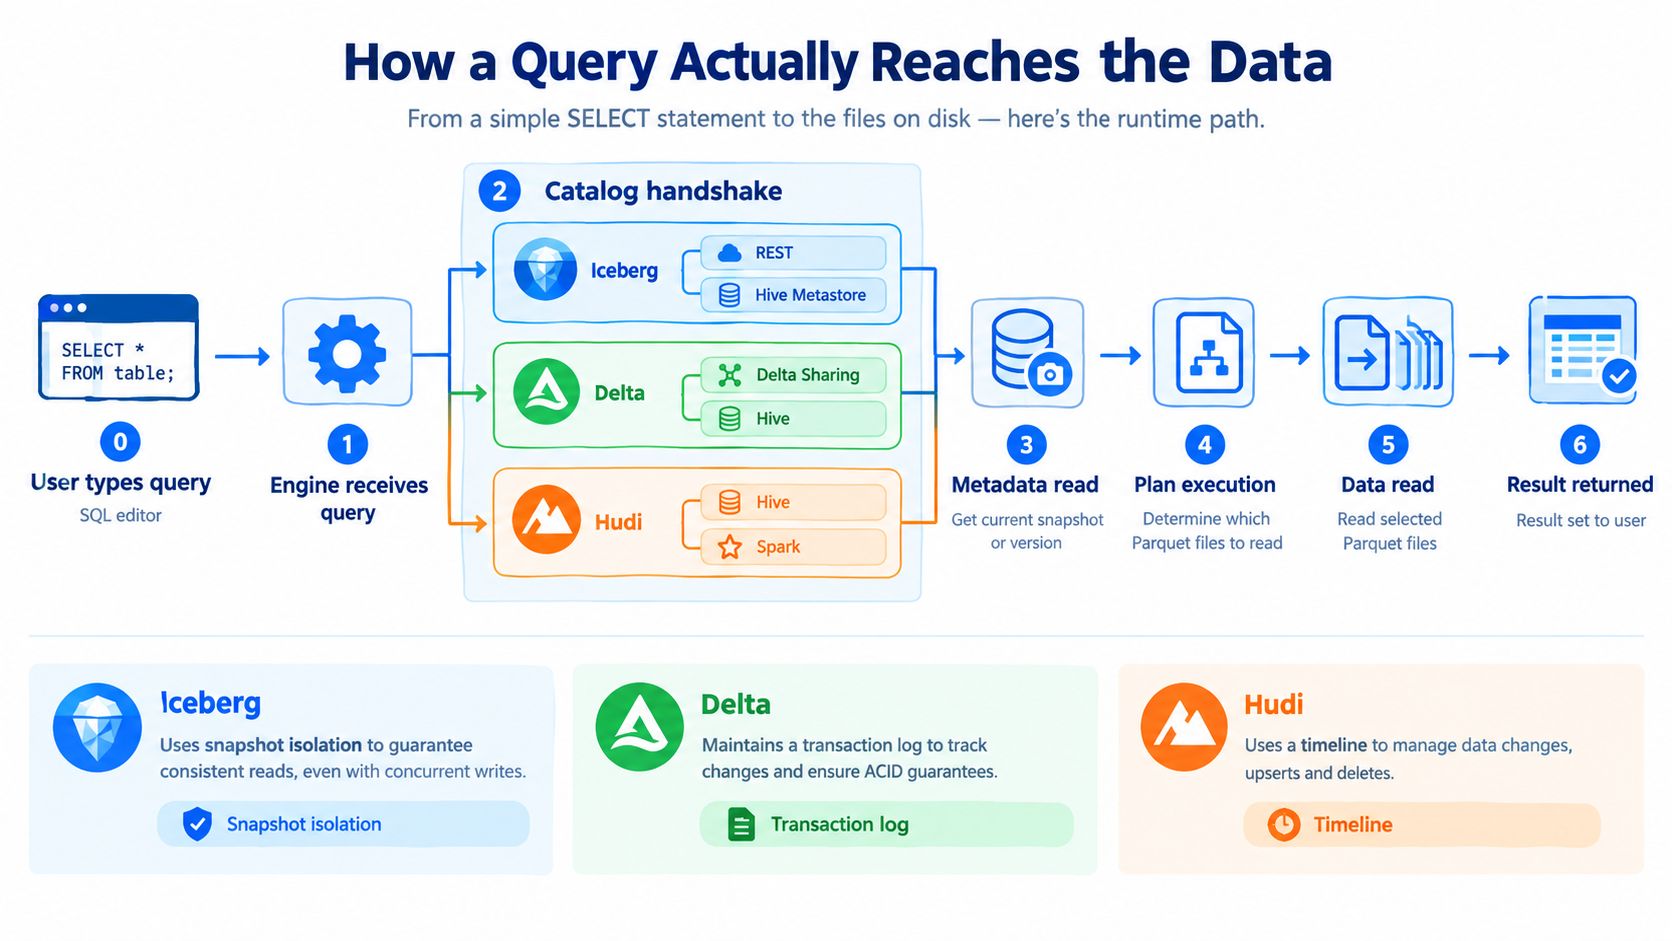
Takie zapytanie nie zaczyna od skanowania folderów. Zaczyna od pytania: „co ta tabela oznacza w tej chwili?”. To kluczowy model myślowy. Otwarty format tabeli to architektura metadanych służąca wiarygodnej odpowiedzi na to pytanie.
Najpierw silnik pyta o bieżący stan tabeli
Silnik zapytań rozwiązuje sales przez katalog taki jak Hive Metastore, AWS Glue, Unity Catalog albo Nessie. Katalog działa jak recepcja z aktualnym adresem, a nie jak magazyn trzymający każdy karton. Jego zadaniem jest wskazać silnikowi bieżący wpis metadanych tabeli.
Ten szczegół ma realne skutki operacyjne. Jeśli katalog wskazuje nieaktualne metadane, silnik planuje wobec nieaktualnego stanu tabeli. Jeśli zadanie wczytujące zrzuca pliki wprost do magazynu bez poprawnego zatwierdzenia, pliki te mogą istnieć fizycznie, a logicznie pozostać niewidoczne.
Dla szerszego widoku architektury ten przegląd architektury systemów danych pomaga umiejscowić katalog względem magazynu i mocy obliczeniowej.
Potem format tabeli dostarcza mapę plików
Gdy silnik ma już wpis metadanych, przejmuje otwarty format tabeli:
Iceberg czyta metadane tabeli, manifesty i aktywną migawkę.
Delta Lake czyta log transakcji oraz ewentualny stan z punktu kontrolnego.
Hudi czyta swoją oś czasu i metadane tabeli, by ustalić bieżący widok.
Różna mechanika, ten sam cel. Silnik potrzebuje miarodajnej mapy plików, zanim przeczyta jakikolwiek plik danych.
To praktyczna zmiana między zwykłym jeziorem danych a otwartym formatem tabeli. Bez tej warstwy metadanych silnik często musi wnioskować stan tabeli z folderów i nazw plików. Z nią stan tabeli jest zadeklarowany wprost.
Planowanie dzieje się przed skanowaniem
Koszt zapytań zaczyna się rozchodzić.
Gdy silnik wie już, które pliki należą do bieżącej migawki, może zawęzić pracę przy pomocy danych partycji, statystyk plików i metadanych zatwierdzeń. Zamiast otwierać każdy plik pod ścieżką i wyjaśniać sprawę późno, może odrzucić nieistotne pliki już w fazie planowania.
To zmienia zachowanie produkcyjne w sposób, który inżynierowie danych szybko zauważają:
Niższy koszt zapytań, bo trzeba otworzyć mniej plików
Mniej zamieszania z dryfem schematu, bo ścieżka odczytu podąża za zatwierdzonymi metadanymi tabeli, a nie za plikami, które akurat wylądowały w magazynie
Lepsza diagnostyka incydentów, bo możesz wprost oglądać migawki, zatwierdzenia i przynależność plików
Mniej martwych pól obserwowalności, bo stan tabeli jest zapisany jako metadane, a nie ukryty w konwencjach folderów
Gdy pulpit nagle wygląda źle, pytanie diagnostyczne staje się precyzyjniejsze. Którą migawkę przeczytał silnik? Które zatwierdzenie dodało te pliki? Która zmiana metadanych zmieniła zachowanie partycji albo schematu?
Dlatego otwarte formaty tabel lepiej rozumieć jako warstwę sterowania dla tabel. Zapytanie sięga danych dopiero wtedy, gdy metadane określą, czym jest tabela, które pliki do niej należą i które można pominąć.
Realne korzyści i kompromisy, na które trafisz
Pierwszy sprint po wdrożeniu otwartego formatu tabeli zwykle daje dobre samopoczucie. Zapisy stają się pewniejsze. Zmiany tabel przestają przypominać chirurgię na folderach. Zespoły odzyskują przekonanie, że tabela w danym momencie znaczy jedną spójną rzecz.
Potem zjawia się rzeczywistość produkcyjna.
Korzyści i kompromisy otwartych formatów tabel w skrócie
Korzyść | Co dostajesz | Kompromis, który dziedziczysz |
|---|---|---|
Zapisy ACID | Czytający nie widzą wsadów w połowie | Zaczynasz zależeć od koordynacji zatwierdzeń i kondycji metadanych |
Ewolucja schematu | Kontrolowane zmiany kolumn bez ciągłych przepisań | Wciąż potrzebujesz dyscypliny wokół zgodności i kontraktów niżej |
Podróż w czasie | Łatwiejsze wycofywanie i diagnostyka | Retencją historii trzeba świadomie zarządzać |
Przenośność między silnikami | Większa elastyczność wobec Spark, Trino, Flink i innych | Przenośność na poziomie formatu nie gwarantuje otwartego nadzoru |
Lepsze planowanie zapytań | Skuteczniejsze przycinanie plików i czystszy stan tabeli | Konserwacja metadanych staje się częścią eksploatacji platformy |
Każda korzyść tworzy nową odpowiedzialność
Wiarygodne zapisy usuwają pewną klasę awarii jeziora, ale tworzą też nową granicę awarii wokół ścieżki metadanych i katalogu.
Podróż w czasie pomaga, gdy ktoś opublikuje złe dane, ale historyczne migawki nie zarządzają sobą same. Jeśli nigdy nie wygaszasz starych migawek ani nie czyścisz metadanych, rośnie magazyn i narzut planowania.
Ewolucja schematu ogranicza siłowe przepisania, ale nie znosi potrzeby kontraktów danych. Przemianowana kolumna wciąż może zepsuć odbiorcę niżej, który spodziewał się starej nazwy.
Zespołom porównującym wzorce lakehouse szerzej przyda się to porównanie jeziora danych i hurtowni tematycznej, bo pokazuje, jak elastyczność składowania i kuratorowana konsumpcja służą różnym celom operacyjnym.
Ukrytym kosztem jest praca konserwacyjna
To ta część, którą wiele diagramów architektury pomija. Samodzielnie zarządzane tabele otwarte wciąż potrzebują kompaktowania, wygaszania migawek, czyszczenia metadanych i bieżącej konserwacji. Bez tej pracy wydajność spada, a koszty składowania rosną, jak omawia analiza CDO Magazine o tabelach otwartych i interoperacyjności.
Ten sam tekst stawia jeszcze jedną ważną tezę. Otwarte formaty tabel poprawiają przenośność, ale nie rozwiązują automatycznie niezawodności ani obserwowalności, zwłaszcza w szybko zmieniających się środowiskach z wieloma silnikami.
Realia operacyjne: otwarte formaty tabel ograniczają chaos plików. Nie znoszą potrzeby dyscypliny platformowej.
Jest też haczyk nadzorczy. Zespoły często świętują, że format tabeli jest otwarty, zostawiając katalog, polityki dostępu, reguły maskowania i zachowanie audytu pod kontrolą jednego dostawcy. Niedawne komentarze przekonują, że jeśli te warstwy pozostają w rękach dostawcy, architektura w praktyce nie jest w pełni otwarta, nawet jeśli pliki i format tabeli są, co rozwija perspektywa Onehouse na otwarte formaty tabel i otwartą architekturę lakehouse.
Praktyczne wdrożenie i kwestie migracji
Decyzje migracyjne idą gładziej, gdy podejmujesz je w kolejności, w jakiej napotykają je zespoły operacyjne.
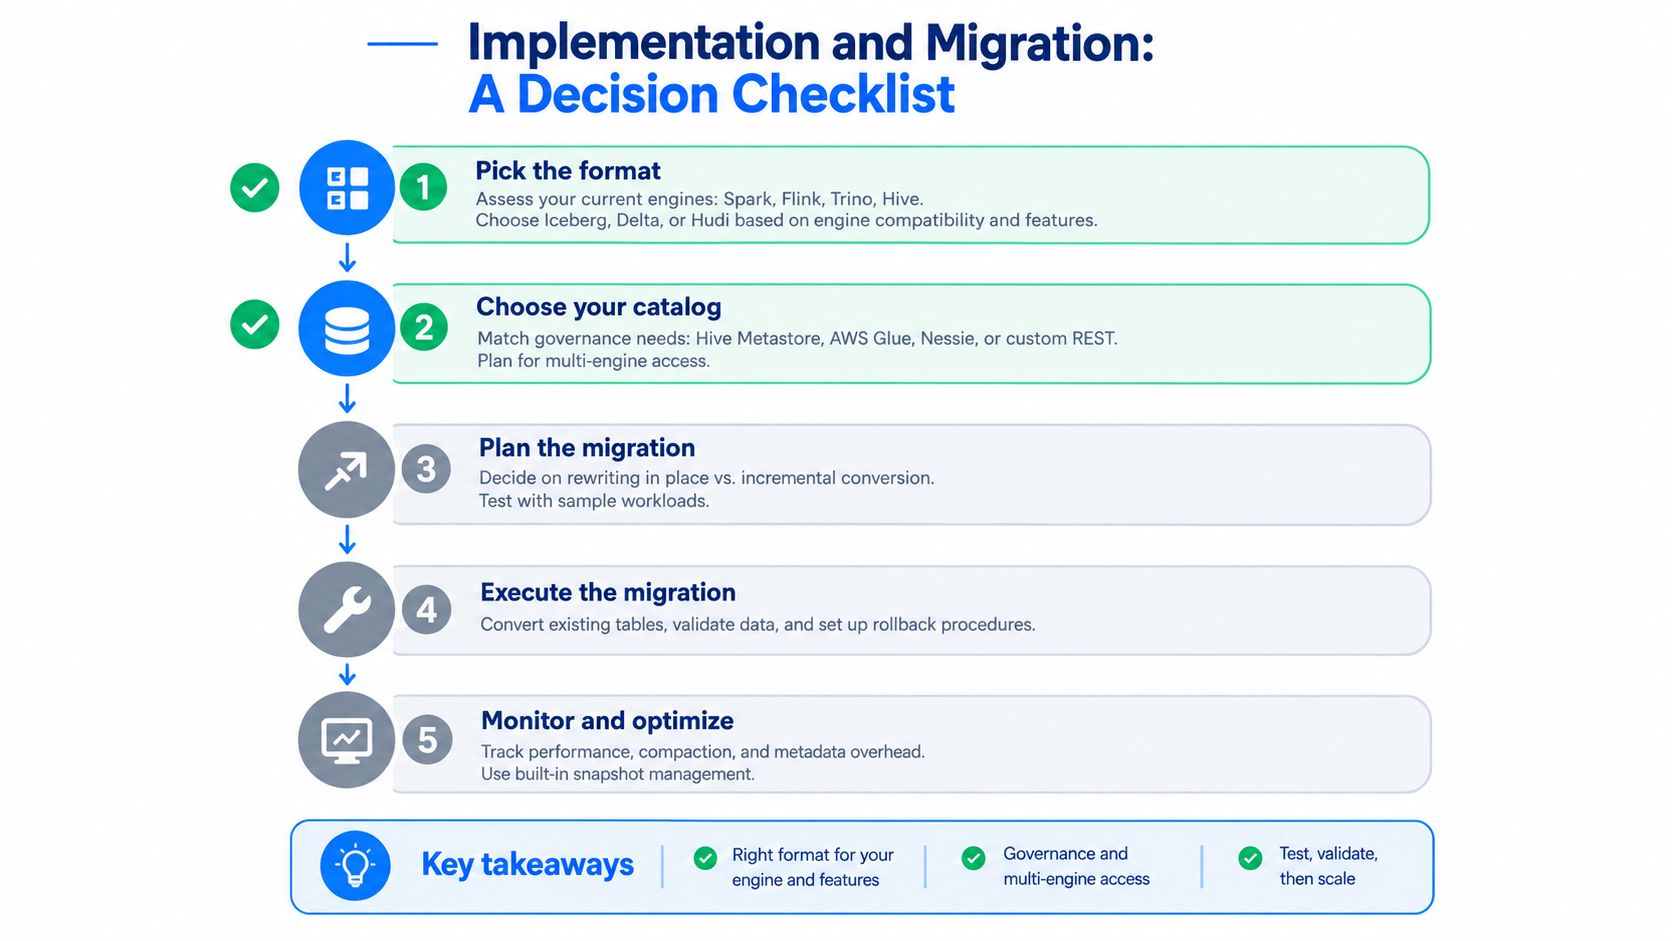
Zacznij od silników, które już masz
Jeśli dominuje Spark, a zespół już polega na natywnych przepływach Delta, Delta bywa najmniej zaburzającą drogą.
Jeśli Twoje środowisko ma wiele silników, Iceberg zwykle czyściej pasuje do modelu eksploatacji.
Jeśli najtwardszym wymaganiem są częste upserty ze źródeł CDC i strumieniowych, Hudi zasługuje na poważną ocenę.
Wybieraj katalog jak infrastrukturę
Wiele zespołów traktuje katalog jak szczegół implementacyjny. Nie jest. Staje się częścią Twojej warstwy sterowania.
Weź prosty katalog, jeśli priorytetem jest prostota. Weź katalog zintegrowany z chmurą albo nadzorowany przez platformę, jeśli ważniejsze są bezpieczeństwo, lineage i centralna polityka. Jeśli spodziewasz się wielu silników w różnych chmurach, wybierz strategię katalogu, która nie zamknie nadzoru w jednym środowisku.
Migracja bywa mniej efektowna niż ogłoszenie
Typowe wzorce migracji obejmują:
Przepisanie do nowych tabel: najczystsza semantyka, największy ruch na starcie
Podwójny zapis przez pewien czas: bezpieczniejsze przełączenie, więcej tymczasowej złożoności
Klonowanie lub konwersja, gdy to możliwe: szybciej, ale starannie sprawdź założenia
Etapowe wdrożenie po domenach: lepsze dla dużych krajobrazów z różnymi obciążeniami
Cichym ryzykiem zwykle nie jest sama konwersja plików. To zapomnienie o uruchomieniu konserwacji od pierwszego dnia.
Potrzebujesz zadań albo usług zarządzanych do kompaktowania, retencji i sprzątania, zanim pierwsza ważna tabela pójdzie na produkcję. Jeśli to pominiesz, platforma zaczyna dryfować natychmiast.
Praktyczny wybór domyślny
Rozsądny wybór domyślny jest prosty:
Wybierz Iceberg do SQL między silnikami i projektu lakehouse zorientowanego na nadzór.
Wybierz Delta Lake, jeśli Twoja platforma mocno opiera się na Databricks i Sparku.
Wybierz Hudi, gdy ścieżkę zapisu zdominowały CDC, upserty i strumieniowe wzorce korekt.
A jeśli instrumentujesz kondycję tabel od pierwszego dnia, jedną z opcji jest digna, która działa w środowisku klienta i monitoruje zmiany schematu, Timeliness, anomalie i walidację rekordów w jeziorach, hurtowniach i potokach.
Co otwarte formaty tabel znaczą dla obserwowalności danych
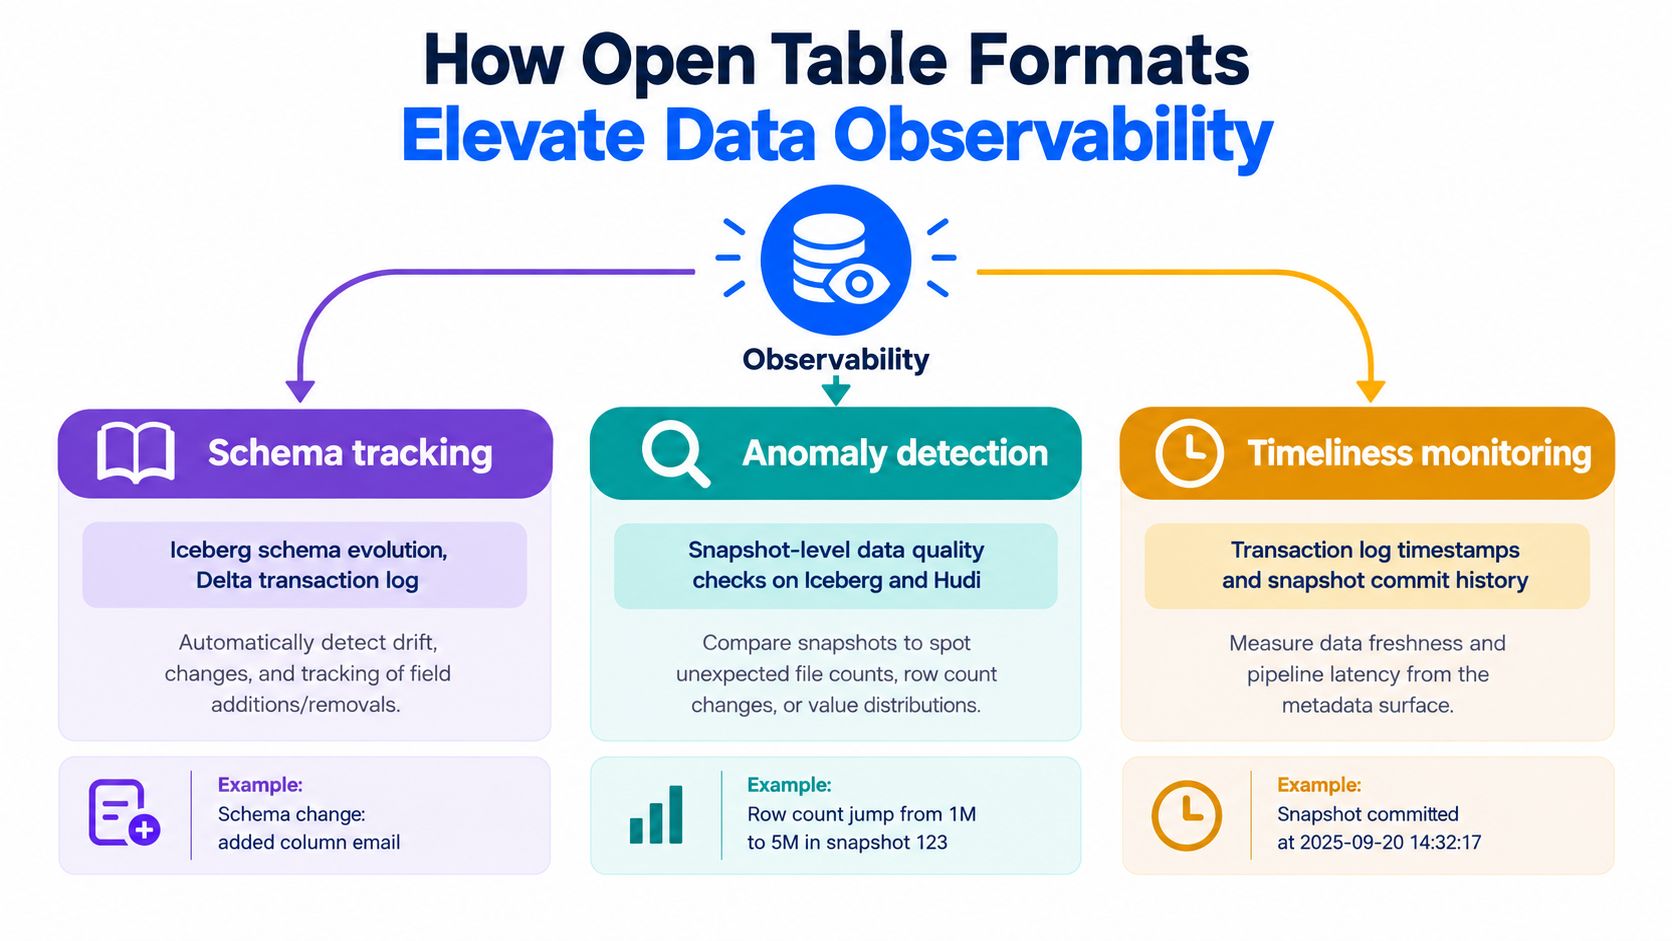
Otwarte formaty tabel nie tylko poprawiają semantykę składowania. Ujawniają też powierzchnię metadanych, którą narzędzia obserwowalności mogą czytać wprost.
Metadane stają się telemetrią
Migawki Iceberg, logi transakcji Delta i metadane zatwierdzeń Hudi tworzą maszynowo czytelny dowód zmiany tabeli. To ważne, bo wiele kontroli jakości i niezawodności nie musi najpierw skanować pełnych zbiorów.
Platforma może obejrzeć historię zatwierdzeń i zapytać:
Czy nieoczekiwanie pojawiła się zmiana schematu?
Czy dzisiejsza partycja wylądowała później niż zwykle?
Czy zapis opublikował znacznie mniej plików, niż potok zwykle produkuje?
Czy tabela przestała się posuwać, choć zadania powyżej działały?
Obserwowalność zbliża się do ścieżki zapisu
To zmienia model operacyjny monitorowania. Zamiast polegać wyłącznie na późniejszych awariach zapytań albo skargach na pulpity, zespoły mogą wykrywać problemy tam, gdzie zmienia się stan tabeli.
Gdy metadane mówią, że tabela się zmieniła, obserwowalność może sprawdzić tę zmianę, zanim użytkownicy odkryją awarię.
To jeden z powodów, dla których otwarte formaty tabel liczą się poza składowaniem i szybkością zapytań. Tworzą wspólną powierzchnię sterowania, którą mogą czytać silniki, systemy nadzoru i narzędzia obserwowalności.
Zastrzeżenie jest ważne. Metadane pomagają ujawnić sygnały. Nie interpretują ich za Ciebie. Zespoły wciąż potrzebują reguł, linii bazowych i procesów incydentów łączących zmianę tabeli z wpływem biznesowym.
Jak iść dalej
Otwarty format tabeli to nie meta. To fundament lepiej ułożonego lakehouse.
Zanim uznasz architekturę za gotową na produkcję, sprawdź kilka rzeczy:
Odporność katalogu: upewnij się, że katalog jest dość wysoko dostępny, by stać się częścią Twojej warstwy sterowania.
Zadania konserwacyjne: potwierdź, że kompaktowanie, wygaszanie migawek i czyszczenie metadanych są zaplanowane od pierwszego dnia.
Polityka retencji: dopasuj historię podróży w czasie do potrzeb zgodności i wycofywania.
Zachowanie silników: sprawdź, czy silniki czytają metadane tabeli wprost, zamiast polegać na skrótach przez listowanie katalogów.
Okablowanie obserwowalności: monitoruj sygnały zatwierdzeń i migawek, nie tylko wyniki zapytań.
Jeśli oceniasz Iceberg na istniejącym jeziorze, zacznij od tabeli, która już cierpi przez dryf schematu albo dostęp z wielu silników.
Jeśli wprowadzasz Delta do sklepu mocno opartego na Sparku, zacznij tam, gdzie bezpieczeństwo transakcyjne waży więcej niż spory o przenośność.
Jeśli testujesz Hudi dla obciążeń mocno CDC, wybierz tabelę, w której upserty i konsumpcja przyrostowa są już źródłem bólu operacyjnego.
Użyteczne pytanie nie brzmi tylko czym jest otwarty format tabeli. Brzmi, czy Twój zespół jest gotów eksploatować architekturę metadanych, która z nim przychodzi.
digna daje zespołom danych platformę jakości i obserwowalności działającą w ich środowisku, co naturalnie pasuje do otwartych formatów tabel, bo tak wiele użytecznego sygnału mieszka w zatwierdzeniach, zmianach schematu i metadanych świeżości. Jeśli zamieniasz surowe pliki jeziora w nadzorowane tabele produkcyjne, odwiedź dignę, by zobaczyć, jak monitoruje dryf schematu, Timeliness, anomalie i walidację bez wyprowadzania danych poza Twoje środowisko.
Warstwa metadanych ułatwia pracę planiście zapytań; sprawienie, by te same metadane odpowiadały na pytania operacyjne, dokłada obserwowalność platformy danych.
Najczęściej zadawane pytania
Co właściwie przechowuje warstwa metadanych?
Schemat i jego historię, listę plików danych tworzących każdą wersję tabeli, definicje partycji oraz statystyki dla każdego pliku, jak zakresy wartości i liczbę wartości pustych. To właśnie ta ostatnia część pozwala planiście zapytań odrzucić pliki, zanim je w ogóle otworzy.
Jak zapytanie dociera do danych?
Silnik pyta katalog o bieżący wskaźnik metadanych, czyta manifest, by dostać listę plików ze statystykami, odrzuca pliki, których statystyki nie mogą spełnić filtru, i dopiero wtedy otwiera pozostałe pliki Parquet. Większość szybkości bierze się z plików, których nigdy nie otwiera.
Czy otwarty format tabeli poprawia jakość danych?
Poprawia spójność, nie poprawność. Format gwarantuje, że każdy silnik widzi tę samą zatwierdzoną wersję tabeli z tym samym schematem; nie twierdzi nic o tym, czy wartości są dokładne, kompletne czy świeże. To pozostają osobne kontrole nałożone na format.
Co da się obserwować z metadanych tabeli?
Częstotliwość zatwierdzeń pokazuje, czy ładowania przychodzą zgodnie z planem, różnice migawek pokazują, których plików dotknęła zmiana, a historia schematu pokazuje, kiedy przesunął się typ kolumny. Te sygnały wychwytują pewną klasę problemów wcześniej niż testy na poziomie wierszy, bo pojawiają się, zanim ktokolwiek odpyta dane.
Czy wdrożenie coś kosztuje?
Tak, choć operacyjnie, a nie licencyjnie. Dziedziczysz wygaszanie migawek, kompaktowanie plików i dostępność katalogu jako rzeczy do utrzymania, a planowanie zapytań zyskuje dodatkową rundę po metadane. Dla małych, rzadko zmienianych zbiorów zwykły Parquet o stabilnym układzie wciąż może być właściwą odpowiedzią.



