Co to jest zarządzanie jakością danych: praktyczny przewodnik na rok 2026
|
9
min. czyt.

Zarządzanie jakością danych to ciągła praktyka mierzenia, monitorowania i poprawiania przydatności danych w całym cyklu ich życia, przy użyciu wymiarów takich jak dokładność, kompletność, terminowość (Timeliness), spójność, ważność i unikalność. W badaniu branżowym z 2024 r. podsumowanym przez firmę Precisely tylko około 25% przedsiębiorstw konsekwentnie mierzy i komunikuje metryki jakości danych, a średni wynik dojrzałości wyniósł 56 na 100, co plasuje typową organizację na etapie 3, Ugruntowanym (Established), z 5. Podsumowanie trendów w zarządzaniu jakością danych firmy Precisely na rok 2024
Tę lukę łatwo dostrzec, jeśli kiedykolwiek widziało się zespół finansowy ufający błędnemu pulpitowi nawigacyjnemu przychodów. Schemat przejściowy gubi kolumnę, zwroty są liczone podwójnie, zarząd otrzymuje złą liczbę, relacje z dostawcą zostają nadszarpnięte, a trzy dni znikają na uzgadnianie danych. Problemem nie był brak wysiłku w czyszczeniu danych. Był nim brak żywego systemu kontroli.
Spis treści
Robocza definicja, z której możesz skorzystać już dziś
Jak zarządzanie jakością danych stało się dyscypliną
Co zmieniło się w praktyce
Sześć wymiarów, które definiują jakość danych
Jak interpretować wymiary w środowisku produkcyjnym
Cykl życia jakości danych od źródła do konsumenta
Gdzie powinny znaleźć się punkty kontrolne
Zarządzanie jakością danych spotyka się z Observability
Co monitorować i jak to wdrażać
Wdrażanie zarządzania jakością danych w praktyce
Wzorzec wdrożenia, który nie utknie w martwym punkcie
Wybory architektoniczne, które się opłacają
Typowe pułapki i najlepsze praktyki, które naprawdę działają
Czego unikać
Co faktycznie się sprawdza
Często zadawane pytania dotyczące zarządzania jakością danych
Robocza definicja, z której możesz skorzystać już dziś
Zespół ds. danych może patrzeć na czysty pulpit nawigacyjny i nadal nie rozumieć sedna sprawy. Zarządzanie jakością danych to model operacyjny, który dba o to, by dane były zdatne do użytku od źródła do konsumenta. Wychwytuje defekty na wczesnym etapie, mierzy je za każdym razem w ten sam sposób i naprawia przyczynę źródłową, zamiast polerować uszkodzony zestaw danych, gdy szkody już się rozprzestrzenią.
Praktyczna definicja jest prosta: DQM to zapobieganie, wykrywanie i naprawianie błędów w całym cyklu życia danych. Gdy zespół platformy czyści rekordy dopiero wtedy, gdy analitycy zaczynają narzekać, zajmuje się konserwacją. Gdy dodaje reguły, kontrole świeżości, własność i alerty do potoków produkcyjnych, zarządza jakością.
Tryb awaryjny zmienia się wraz z potokiem. Zadanie atrybucji marketingowej może napotkać zmianę schematu, błędnie zmapować pole i skierować wydatki do niewłaściwego modelu kanału. Model liczenia subskrypcji może pozwolić, by zduplikowane klucze sztucznie zawyżyły liczbę aktywnych użytkowników, zmuszając zespoły ds. produktu i finansów do dyskusji o tym, która liczba jest prawdziwa. Oba przypadki to ta sama klasa problemu – brakowało kontroli jakości w miejscu, w którym przemieszczały się dane.
Praktyczna zasada: jeśli problem z danymi można naprawić tylko ręcznie po tym, jak zauważą go konsumenci, proces kontroli jakości jest spóźniony.
W celu uzyskania zwięzłego odniesienia do tego samego ujęcia operacyjnego, przegląd jakości danych digna jasno przedstawia ten temat. Dalsza część tego przewodnika przekłada tę definicję na mechanizmy kontrolne, które można uruchomić w środowisku produkcyjnym.
Jak zarządzanie jakością danych stało się dyscypliną
Jakość danych była kiedyś traktowana jak praca porządkowa, coś, co robiło się dopiero wtedy, gdy raport wyglądał podejrzanie. Ten model przestaje działać, gdy potoki danych się mnożą, produkty danych przekraczają granice zespołów, a każda ręczna naprawa generuje większe opóźnienie niż sam problem. Odpowiedzią branży stało się przejście w stronę governance, powtarzalnych pomiarów i odpowiedzialności, ponieważ koszt czekania stale rośnie.
Uzasadnienie ekonomiczne tej zmiany jest stare, ale wciąż przekonujące. MIT Sloan Management Review opublikował szacunki, według których złe dane mogą kosztować większość firm od 15% do 25% przychodów, a jedna z syntez cytowanych w artykule oszacowała roczną stratę gospodarki USA na 3,1 biliona dolarów. Wcześniejsze wytyczne odwoływały się również do znanej dziś drabiny kosztów: 1 USD na zapobieżenie problemowi z rekordem, 10 USD na jego naprawę po wejściu do systemu i 100 USD na jego skorygowanie, gdy wywoła już skutki u odbiorców końcowych. MIT Sloan Management Review o kosztach złych danych
Ta logika zmieniła zarządzanie jakością danych z zadania porządkowego w dyscyplinę całego cyklu życia. Wytyczne rządowe i branżowe traktują obecnie jakość danych jako coś, co monitoruje się na etapach pozyskiwania, przechowywania, przetwarzania, dystrybucji i archiwizacji, przypisując standardy i odpowiedzialność do każdego przekazania danych. Gdy zmiana schematu, opóźnione zasilenie lub złamana reguła mogą unieważnić pulpity nawigacyjne i raporty regulacyjne, czyszczenie danych po ich załadowaniu już nie wystarcza.
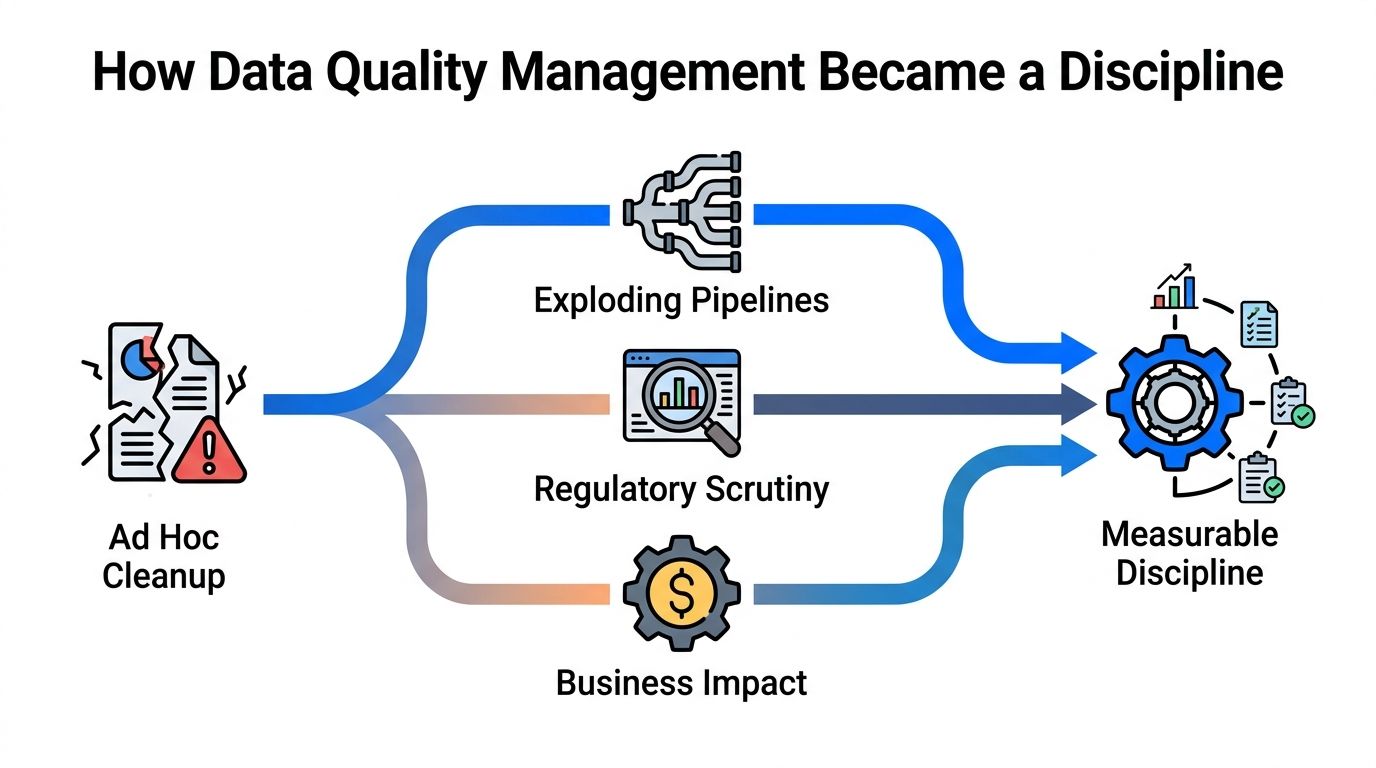
Co zmieniło się w praktyce
Reaktywne czyszczenie: zespoły naprawiają widoczne błędy po skargach użytkowników.
Monitorowanie z nadzorem (governed): zespoły definiują mechanizmy kontrolne, własność i ścieżki eskalacji, zanim błędy zaczną się rozprzestrzeniać.
Dyscyplina na poziomie przedsiębiorstwa: zespoły mierzą jakość, komunikują ją i traktują odchylenia jako ryzyko operacyjne.
Wzrost dojrzałości ma znaczenie, ponieważ zmienia miejsce, w którym wykonywana jest praca. Zamiast prosić analityków o wykrywanie złych danych, dojrzałe programy sprawiają, że jakość staje się widoczna blisko potoku danych, gdzie naprawa jest tańsza, a zasięg szkód mniejszy.
Sześć wymiarów, które definiują jakość danych
Sześć wymiarów jest użytecznych, ponieważ odpowiadają one różnym trybom awaryjnym. Zbiór danych może być dokładny, ale docierać za późno, lub kompletny, ale niespójny z systemem odbiorczym. Jeśli traktuje się jakość jako jeden ogólny wynik, umyka nam rzeczywisty defekt.
Wymiar | Przykład błędu | Kontrola operacyjna |
|---|---|---|
Dokładność | Geokoder adresów zwraca poprawne miasto, ale błędny kod pocztowy | Uzgadnianie z zaufanym źródłem i walidacja na poziomie pól |
Kompletność | Pole | Kontrola pól wymaganych, stosunek pól uzupełnionych do wymaganych |
Timeliness | Codzienne dane spływają po porannym spotkaniu, więc umowa SLA jest technicznie dotrzymana, ale operacyjnie bezużyteczna | Monitorowanie świeżości w odniesieniu do oczekiwanego okna dostawy |
Spójność | Ten sam identyfikator klienta odnosi się do różnych rekordów w systemie CRM i rozliczeniowym | Uzgadnianie między systemami i kontrole referencyjne |
Ważność | Status typu enum akceptuje literówkę, która powinna zostać odrzucona | Ograniczenie schematu lub walidacja regułowa względem dozwolonych wartości |
Unikalność | Zduplikowane wiersze sztucznie zawyżają liczbę aktywnych użytkowników miesięcznie | Reguła deduplikacji, ograniczenie unikalności klucza, wykrywanie duplikatów |
Jak interpretować wymiary w środowisku produkcyjnym
Dokładność sprawdza, czy wartość odzwierciedla rzeczywistość. Jeśli geokoder przypisuje poprawne miasto, ale błędny kod pocztowy, problemem nie jest formatowanie, lecz niezgodność między rekordem a obiektem rzeczywistym, który on opisuje. Zazwyczaj wymaga to uzgodnienia z głównym źródłem prawdy (source of truth), a nie tylko ładniejszej transformacji danych.
Kompletność dotyczy tego, czy obecne są dane potrzebne do danego zastosowania. Najczystszy wskaźnik operacyjny jest prosty: uzupełnione pola wymagane podzielone przez całkowitą liczbę pól wymaganych, co przenosi dyskusję z intuicji na mierzalne pokrycie. Szczegółowa analiza wymiarów jakości od BatchData jest przydatna, jeśli chcesz porównać definicje między zespołami, a przewodnik po wymiarach digna to poręczne wewnętrzne źródło odniesienia dla zespołów wdrażających.
Timeliness ma konkretne znaczenie. Wytyczne rządowe definiują ją jako czas upływający od końca okresu, którego dotyczą dane, do momentu, w którym stają się one dostępne dla potrzeb użytkowników. Mówią również, że dane są terminowe, gdy są dostępne wtedy, gdy są oczekiwane i potrzebne. Rządowe wytyczne dotyczące jakości danych
Ważność to zgodność z regułami. To nie kwestia przeczucia, ale tego, czy dany rekord jest zgodny z predefiniowanym formatem, typem lub regułą biznesową. Przewodnik po wymiarach jakości danych firmy Dagster mówi o tym wprost, i właśnie dlatego reguły walidacji powinny znajdować się blisko samego potoku danych.
Spójność i unikalność to obszary, w których ujawniają się problemy między systemami. Pojedynczy rekord może pomyślnie przejść lokalne kontrole, a jednocześnie być niezgodny z systemem rozliczeniowym, podczas gdy duplikaty mogą jednocześnie zawyżać sumy i pewność siebie.
Cykl życia jakości danych od źródła do konsumenta
Pojedynczy rekord klienta może pokazać, gdzie jest miejsce na działania związane z jakością. Zaczyna się w API SaaS, trafia do etapu pozyskiwania (ingestion), przechodzi przez etap przejściowy (staging) i transformację, aż wreszcie trafia do analityków, aplikacji i modeli. Każdy etap wymaga innej kontroli, ponieważ defekt może powstać na wczesnym etapie (upstream), a stać się widoczny dopiero na późniejszym (downstream).

Gdzie powinny znaleźć się punkty kontrolne
Na etapie zapisu, walidacja schematu wychwytuje krytyczne zmiany struktury, zanim się rozprzestrzenią. Podczas pozyskiwania (ingestion), kontrole świeżości informują, czy dane dotarły wtedy, gdy oczekiwali tego użytkownicy, co ma znacznie większe znaczenie niż ogólny sygnał „ładowanie powiodło się”. W fazie stagingu, audyty kompletności wychwytują brakujące wymagane wartości, zanim transformacje utrudnią wyśledzenie tych luk.
Na etapie transformacji, uzgadnianie dokładności porównuje przetworzone dane ze źródłem prawdy. To właśnie tam najczęściej ujawniają się zerwane złączenia, nieaktualne tabele referencyjne lub błędne reguły biznesowe. Przed udostępnieniem danych, reguły spójności i wymuszanie unikalności zapobiegają dotarciu sprzecznych lub zduplikowanych rekordów do warstwy odbiorców.
Role związane z Data Governance wpisują się w te punkty przekazywania danych, zamiast funkcjonować poza nimi. Data steward odpowiada za definicje i kontekst eskalacji, inżynier wdraża kontrole w potoku danych, a analityk ocenia, czy dostarczone dane nadają się do postawionego pytania. Przegląd potoku pozyskiwania danych digna idealnie wpisuje się w ten schemat, ponieważ cykl życia działa tylko wtedy, gdy punkty kontrolne znajdują się blisko danych, a nie są doklejane na samym końcu.
Jakość danych poprawia się, gdy każde przekazanie generuje sygnał, a nie tylko plik.
Najważniejszym modelem mentalnym jest to, że cykl życia ma charakter kołowy. Skargi konsumentów, rozbieżności w pulpitach nawigacyjnych i błędy modeli powinny trafiać z powrotem do umów dotyczących źródeł danych, a nie tylko do kolejki zgłoszeń wsparcia. Jeśli ten sam problem pojawia się po raz drugi, kontrola powinna zostać wdrożona na wcześniejszym etapie (upstream).
Zarządzanie jakością danych spotyka się z Observability
DQM i Observability nie są już osobnymi tematami. Klasyczne kontrole jakości danych skupiają się na znanych regułach, podczas gdy Observability obserwuje zachowanie systemu w czasie rzeczywistym pod kątem nieznanych anomalii, nagłych zmian schematu, nietypowych wahań wskaźnika wartości pustych (null-rate) i opóźnień w dostarczaniu danych. Obszar, w którym te podejścia się nakładają, przynosi nowoczesnym platformom największe korzyści.
Ten podział jest prosty. Walidacja mówi o tym, czy rekord spełnia regułę biznesową. Observability informuje, czy zachowanie zbioru danych zmieniło się w sposób wymagający uwagi. Platforma, która łączy oba te podejścia, potrafi wychwycić błędny kod statusu, opóźnioną partycję i nagłą zmianę liczby wierszy, bez konieczności ręcznego tworzenia tych samych mechanizmów kontrolnych przez każdy zespół.
Co monitorować i jak to wdrażać
Wymiar |
|---|
Najczęściej zadawane pytania
Jak brzmi robocza definicja DQM?
Zapobieganie, wykrywanie i naprawa w całym cyklu życia danych. Ta trzyczęściowa definicja jest użyteczniejsza niż lista wymiarów, bo nazywa trzy miejsca, w których może stanąć kontrola, a nie właściwości, które mierzy.
Jak dojrzała jest typowa organizacja?
W badaniu z 2024 r. podsumowanym przez Precisely tylko około 25 % przedsiębiorstw konsekwentnie mierzy i komunikuje wskaźniki jakości danych, a średni wynik dojrzałości wyniósł 56 na 100, co plasuje typową organizację na etapie 3 z 5, Established.
Kiedy proces jakości przychodzi za późno?
Gdy problem z danymi da się naprawić tylko ręcznie po tym, jak zauważą go odbiorcy. W tym momencie proces dokumentuje awarie, zamiast im zapobiegać, niezależnie od deklarowanego pokrycia.
Jaki jest ekonomiczny argument za tą zmianą?
MIT Sloan Management Review przytoczyła szacunki, według których złe dane potrafią pochłaniać od 15 % do 25 % przychodów większości firm. Liczby tego rzędu przeniosły DQM z zadania porządkowego do dyscypliny cyklu życia.
Jakie są trzy etapy praktyki?
Reaktywne porządkowanie, gdy zespoły naprawiają widoczne błędy po skargach; nadzorowany monitoring, gdy definiują kontrole, własność i eskalację, zanim usterki się rozejdą; oraz dyscyplina korporacyjna, gdy mierzą jakość, komunikują ją i traktują dryf jako ryzyko operacyjne.



