Co to jest symulacja Monte Carlo
|
7
min. czyt.

Jesteś na spotkaniu, goni Cię termin, pulpit nawigacyjny zaczyna szwankować, a ktoś prosi o podanie jednej konkretnej liczby. Właściciel platformy chce prognozy opóźnień potoku danych, lider ds. finansów potrzebuje zestawienia budżetowego na potrzeby wdrożenia, a menedżer ds. logistyki analizuje natężenie ruchu, pogodę i opóźnienia w dokach. Pojedynczy szacunek wydaje się uporządkowany, ale ukrywa to, co najważniejsze: rozrzut prawdopodobnych wyników.
Symulacja Monte Carlo to metoda, która zamienia to jedno przypuszczenie w rozkład możliwych scenariuszy przyszłości. Robi to poprzez zastąpienie pewności powtarzalnym próbkowaniem losowym, a następnie pozwala, aby wyniki pokazały, co jest prawdopodobne, co ryzykowne, a co jest tylko szumem. Właśnie dlatego metoda ta stale pojawia się w finansach, inżynierii i przedsiębiorstwach korzystających z systemów danych, które muszą podejmować decyzje w warunkach niepewności.
Spis treści
Pytanie, przy którym już teraz potrzebujesz metody Monte Carlo
Dlaczego zmienia to charakter dyskusji
Główna idea stojąca za symulacją Monte Carlo
Matematyka bez mgły
Jak w praktyce przebiega symulacja Monte Carlo
Cztery kroki prostym językiem
Metoda Monte Carlo a rozwiązania analityczne i analiza wrażliwości
Szybka reguła decyzyjna
Gdzie symulacja Monte Carlo pojawia się w rzeczywistej pracy
Cztery obszary, w których dowodzi swojej wartości
Uczciwe kompromisy i typowe pułapki
Pułapki, które po cichu zniekształcają wyniki
Lista kontrolna do notebooka, która pozwala zachować rzetelność
Od idei Monte Carlo do klasy enterprise Data Observability z digna
Dlaczego perspektywa Monte Carlo pasuje do observability
Co zespół może zrobić na początku
Pytanie, przy którym już teraz potrzebujesz metody Monte Carlo
Właściciel zespołu platformy zostaje zapytany o opóźnienia na koniec miesiąca podczas przeglądu kadry kierowniczej, ale zespół dysponuje tylko dwoma tygodniami pełnej szumów historii. Lider finansowy musi obronić budżet wdrożenia produktu, podczas gdy wydatki na reklamę i czasy dostaw u dostawców stale się zmieniają. Menedżer ds. logistyki potrzebuje przewidywanego czasu dostawy, gdy ruch drogowy, pogoda i dostępność doków zmieniają się jednocześnie. W każdym z tych przypadków pojedyncze przypuszczenie brzmi pewnie, ale prawdopodobnie jest błędne.
Pułapka polega na tym, że takie przypuszczenie sprowadza cały problem do jednej liczby. Nic nie mówi o tym, jak często dochodzi do opóźnień, jak poważne mogą być opóźnienia ani czy wynik jest wystarczająco stabilny, by mu zaufać. Symulacja Monte Carlo zastępuje tę jedną liczbę tysiącami prawdopodobnych scenariuszy przyszłości, z których wszystkie wynikają z tej samej niepewności.
Why that changes the conversation
Gdy zobaczysz rozkład zamiast szacunku punktowego, pytanie się zmienia. Przestajesz pytać: „Jaki jest wynik?”, a zaczynasz pytać: „Jak szerokie jest pasmo ryzyka i co je generuje?”. To znacznie lepsze pytanie w przypadku budżetów, harmonogramów i operacyjnych umów SLA.
Metoda ta jest prosta do opisania, nawet jeśli samo modelowanie wymaga staranności. Definiujesz niepewne dane wejściowe, wielokrotnie pobierasz z nich próbki, za każdym razem obliczasz wynik i podsumowujesz rozrzut. Jeśli chcesz przeczytać powiązane wprowadzenie o tym, jak rozkłady surowych danych wpływają na to myślenie, temat distribution of data ma kluczowe znaczenie, zanim jakakolwiek symulacja stanie się wiarygodna.
Model Monte Carlo nie gwarantuje pewności. Daje bardziej uczciwy obraz niepewności, z którą i tak już się mierzysz.
Główna idea stojąca za symulacją Monte Carlo
Dobry model mentalny zaczyna się od tarczy do rzutek. Rzucaj losowo punkty na kwadrat, policz, ile z nich wyląduje wewnątrz koła i użyj tego stosunku do oszacowania liczby π. To jest sedno myślenia opartego na metodzie Monte Carlo – powtarzane losowe próby mogą ujawnić coś, co jest trudne do bezpośredniego obliczenia. Wczesna historia tej metody obejmuje prekursorskie idee, takie jak igła Buffona z XVIII wieku, a następnie systematyczne stosowanie w XX wieku do trudnych problemów całkowania i niepewności PMC review.
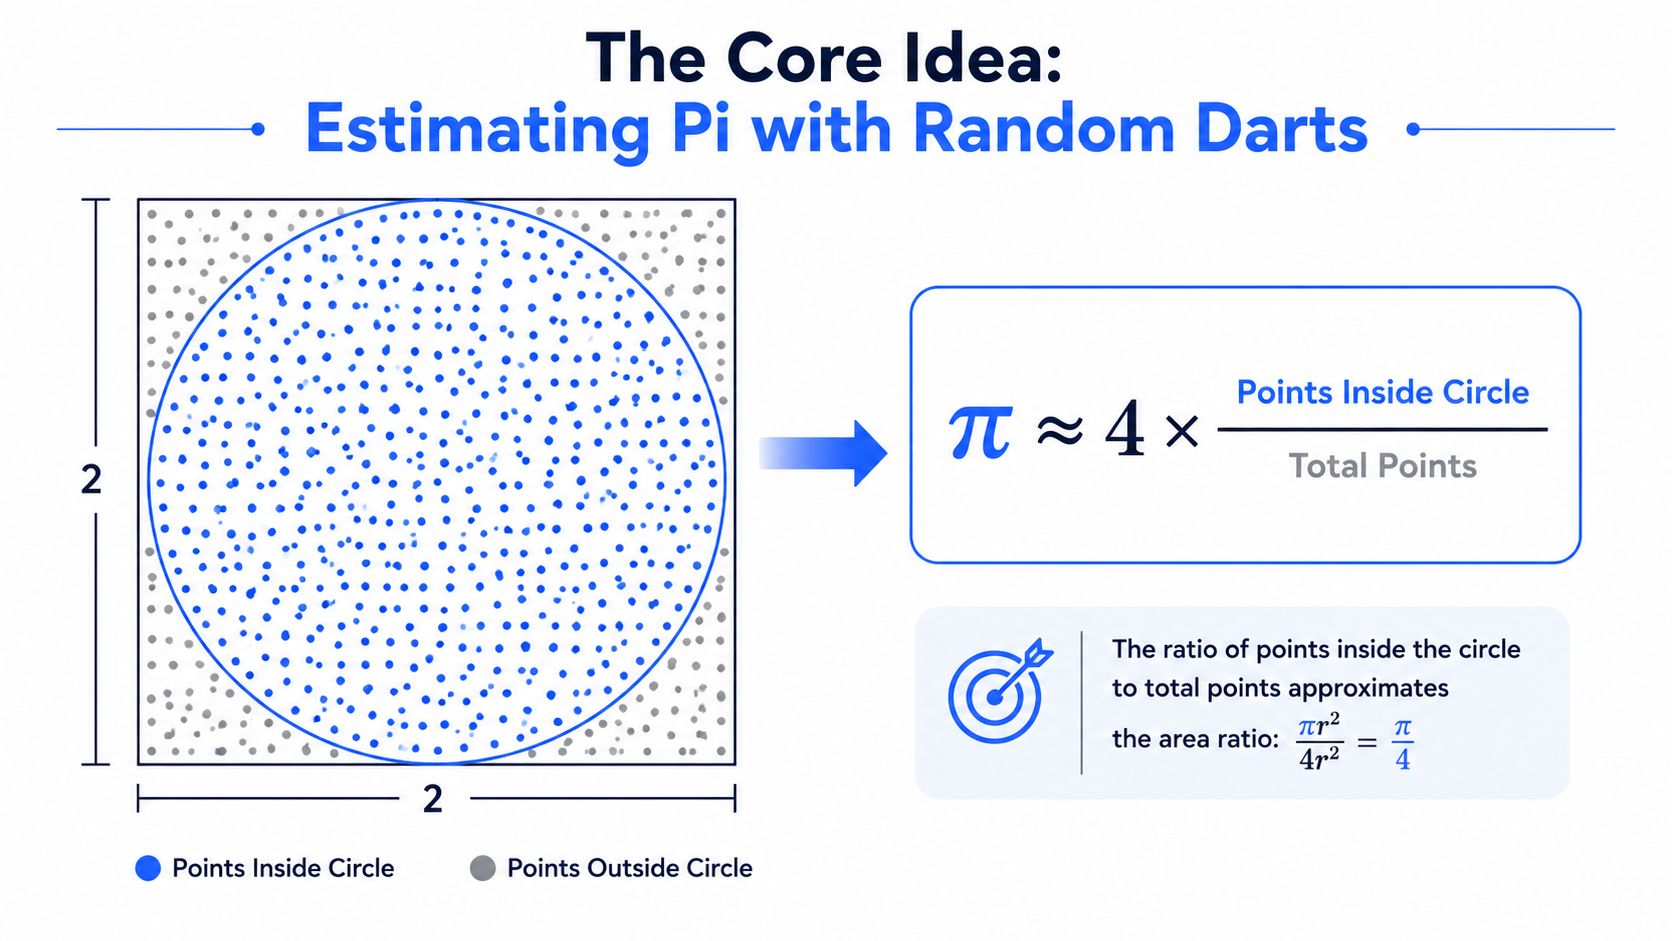
Na nowoczesnym poziomie technicznym symulacja Monte Carlo oznacza szacowanie wartości oczekiwanej, zapisywanej prosto jako E[f(X)], poprzez pobieranie wielu losowych próbek niepewnych danych wejściowych X, ocenę funkcji f za każdym razem i uśrednianie wyników. To ta sama podstawowa idea, którą stosuje się w finansach, inżynierii, analizie niezawodności oraz naukach fizycznych i społecznych, gdzie komputer przeprowadza tysiące lub miliony prób w celu zbadania zmienności PMC review.
Matematyka bez mgły
Nie potrzebujesz wzoru analitycznego dla całego systemu. Potrzebujesz tylko dwóch rzeczy: sposobu na próbkowanie danych wejściowych i sposobu na obliczenie danych wyjściowych dla każdej próby. Właśnie dlatego metoda Monte Carlo jest tak użyteczna w przypadku modeli nieliniowych i skomplikowanych systemów ze świata rzeczywistego – jej działanie nie zależy od eleganckiej algebry.
Prawo wielkich liczb mówi, że średnia z symulowanych wyników zbliża się do rzeczywistej wartości oczekiwanej wraz ze wzrostem wielkości próby. Centralne twierdzenie graniczne podaje praktyczny powód, dla którego wynik ten wydaje się stabilny: błąd standardowy kurczy się w przybliżeniu wraz z pierwiastkiem kwadratowym z wielkości próby. Notatki z wykładów finansowych MIT jasno pokazują to skalowanie: błąd bezpośredniego szacowania ma tendencję do spadku do około σ/√n, dlatego precyzja poprawia się powoli w miarę dodawania kolejnych przebiegów MIT OCW.
Zasada praktyczna: jeśli Twój problem można spróbkować i ocenić, metoda Monte Carlo zazwyczaj pozwala go oszacować, nawet gdy dokładna algebra staje się kłopotliwa lub niemożliwa.
Ta uniwersalność jest kluczowa. Metoda ta istnieje, ponieważ wiele rzeczywistych systemów nie daje się sprowadzić do prostego wzoru.
Jak w praktyce przebiega symulacja Monte Carlo
Praktyczny przykład ułatwia zrozumienie tej pętli. Załóżmy, że szacujesz całkowity koszt projektu, a niepewnymi elementami są roboczogodziny, stawka godzinowa i koszt materiałów. Nie znasz dokładnie żadnego z tych parametrów wejściowych, więc opisujesz każdy z nich jako rozkład prawdopodobieństwa zamiast stałej wartości, często korzystając z danych historycznych, opinii ekspertów lub obu tych źródeł.
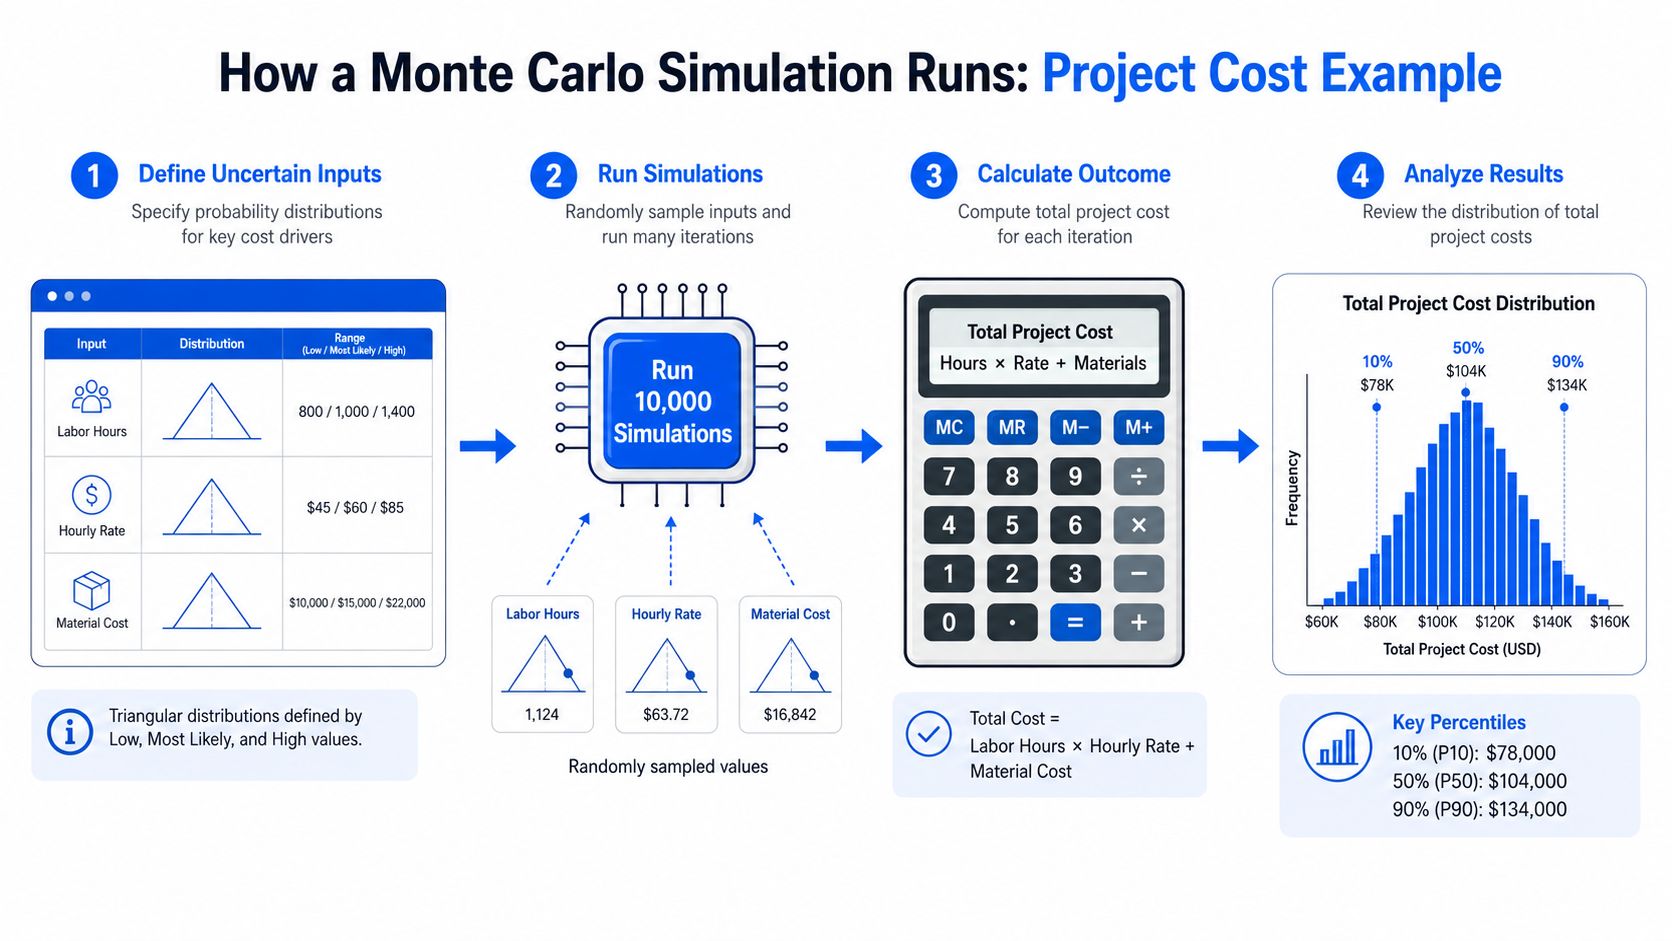
Cztery kroki prostym językiem
Najpierw zdefiniuj dane wejściowe i wybierz pasujące do nich rozkłady. Rozkład trójkątny jest powszechny w pracy projektowej, ponieważ ludzie często znają szacunek niski, najbardziej prawdopodobny i wysoki, nawet jeśli nie znają idealnie zmierzonej krzywej.
Po drugie, pobierz jedną wartość z każdego rozkładu wejściowego, aby zbudować pojedynczy scenariusz. Ten jeden scenariusz staje się jednym z możliwych światów, dla którego obliczasz wynik końcowy – w tym przypadku całkowity koszt.
Po trzecie, powtórz pętlę pobierania i oceny wiele razy. Nowoczesne źródła dydaktyczne i badawcze opisują to jako sterowaną komputerowo metodę eksperymentalną, która może generować tysiące lub miliony losowych prób w celu zbadania rozkładów i ryzyka PMC review.
Po czwarte, podsumuj listę wyników jako osobny rozkład. Możesz przeanalizować średnią, medianę, histogram oraz percentyle, które mają znaczenie dla podjęcia decyzji, ponieważ mówią one o tym, jak zachowuje się koszt w pełnym zakresie prawdopodobnych wyników.
Nawyk operacyjny: obserwuj średnią ruchomą podczas wykonywania symulacji. Jeśli nadal się zmienia, prawdopodobnie nie uruchomiono wystarczającej liczby prób, aby szacunek się ustabilizował.
Prosty szkic pseudokodu wygląda następująco:
Minimalna wersja w języku Python jest równie przejrzysta:
Aby dokładniej przyjrzeć się temu, jak kształtowane są założenia dotyczące danych przed uruchomieniem modelu, przydatnym uzupełnieniem jest strona statistical methods for data analysis. Kluczowym pytaniem wdrożeniowym jest zbieżność – gdy dodawanie kolejnych próbek przestaje w istotny sposób wpływać na wynik, zazwyczaj oznacza to osiągnięcie użytecznego punktu końcowego.
Metoda Monte Carlo a rozwiązania analityczne i analiza wrażliwości
Do modelu kosztów projektu można podejść na trzy różne sposoby, z których każdy odpowiada na inne pytanie. Rozwiązanie analityczne daje bezpośredni wynik, gdy wzory są łatwe do rozwiązania. Analiza wrażliwości modyfikuje jedną zmienną naraz, aby sprawdzić, które założenie ma największy wpływ na wynik. Symulacja Monte Carlo uruchamia wiele pełnych scenariuszy i zwraca rozrzut wyników, w tym prawdopodobieństwo przekroczenia budżetu.
Wymiar | Rozwiązanie analityczne | Analiza wrażliwości | Symulacja Monte Carlo |
|---|---|---|---|
Główne pytanie | Jaki jest dokładny wynik? | Które dane wejściowe mają największe znaczenie? | Jakie wyniki są prawdopodobne i jak często? |
Dane wejściowe | Stałe wzory, często dokładne | Jedna zmienna zmienia się w danym momencie | Wiele niepewnych danych wejściowych zmienia się jednocześnie |
Dane wyjściowe | Pojedyncza liczba lub dokładne wyrażenie | Sklasyfikowany wpływ lub kierunek zmian | Pełny rozkład wyników |
Najlepsze zastosowanie | Liniowe, łatwe do rozwiązania modele | Izolowanie czynników wpływających | Ryzyko, zachowanie ogona rozkładu, interakcje między niepewnościami |
Słaby punkt | Zawodzi, gdy matematyka staje się zbyt skomplikowana | Ignoruje interakcje między zmiennymi | Wymaga próbkowania, walidacji i mocy obliczeniowej |
Rozwiązania analityczne są wydajne, gdy model jest wystarczająco prosty. Analiza wrażliwości jest przydatna, gdy musisz wiedzieć, które założenie należy zweryfikować w pierwszej kolejności. Metoda Monte Carlo to właściwe narzędzie, gdy niepewność wynika z wielu współzależnych danych wejściowych, korelacje mają znaczenie lub model jest nieliniowy.
Przejrzystym sposobem myślenia o tym jest tradeoff between bias and variance. Deterministyczne uproszczenie może być wygodne, ale mylące, podczas gdy bogatsza symulacja pozwala uchwycić więcej rzeczywistości, o ile dane wejściowe są wiarygodne.
Szybka reguła decyzyjna
Jeśli potrzebujesz jedynie przybliżonego kierunku, analiza wrażliwości może być wystarczająca. Jeśli model ma postać analityczną, a dane wejściowe są stabilne, użyj dokładnych obliczeń matematycznych. Jeśli wynik zależy od wielu niepewnych czynników, a decyzja zależy od ogona rozkładu, symulacja Monte Carlo jest warta użycia zasobów obliczeniowych.
W przypadku zespołów budujących przepływy danych ta sama logika ma zastosowanie do przeglądu anomalii. Strona outlier identification methods jest przydatna, gdy pojedynczy błędny punkt może wprowadzić w błąd skądinąd prawidłowy model.
Gdzie symulacja Monte Carlo pojawia się w rzeczywistej pracy
Najsilniejsze przypadki użycia mają tę samą cechę: decyzja zależy od ogona rozkładu, a nie tylko od średniej. W finansach metoda Monte Carlo wspiera analizę wartości zagrożonej (Value-at-Risk) dla portfeli skorelowanych aktywów, ponieważ wspólne zachowanie tych aktywów wpływa na ryzyko strat. W inżynierii pomaga w analizie niezawodności, gdy różne komponenty ulegają awarii w różnym tempie, przez co widok całego systemu ma większe znaczenie niż jakakolwiek pojedyncza część.
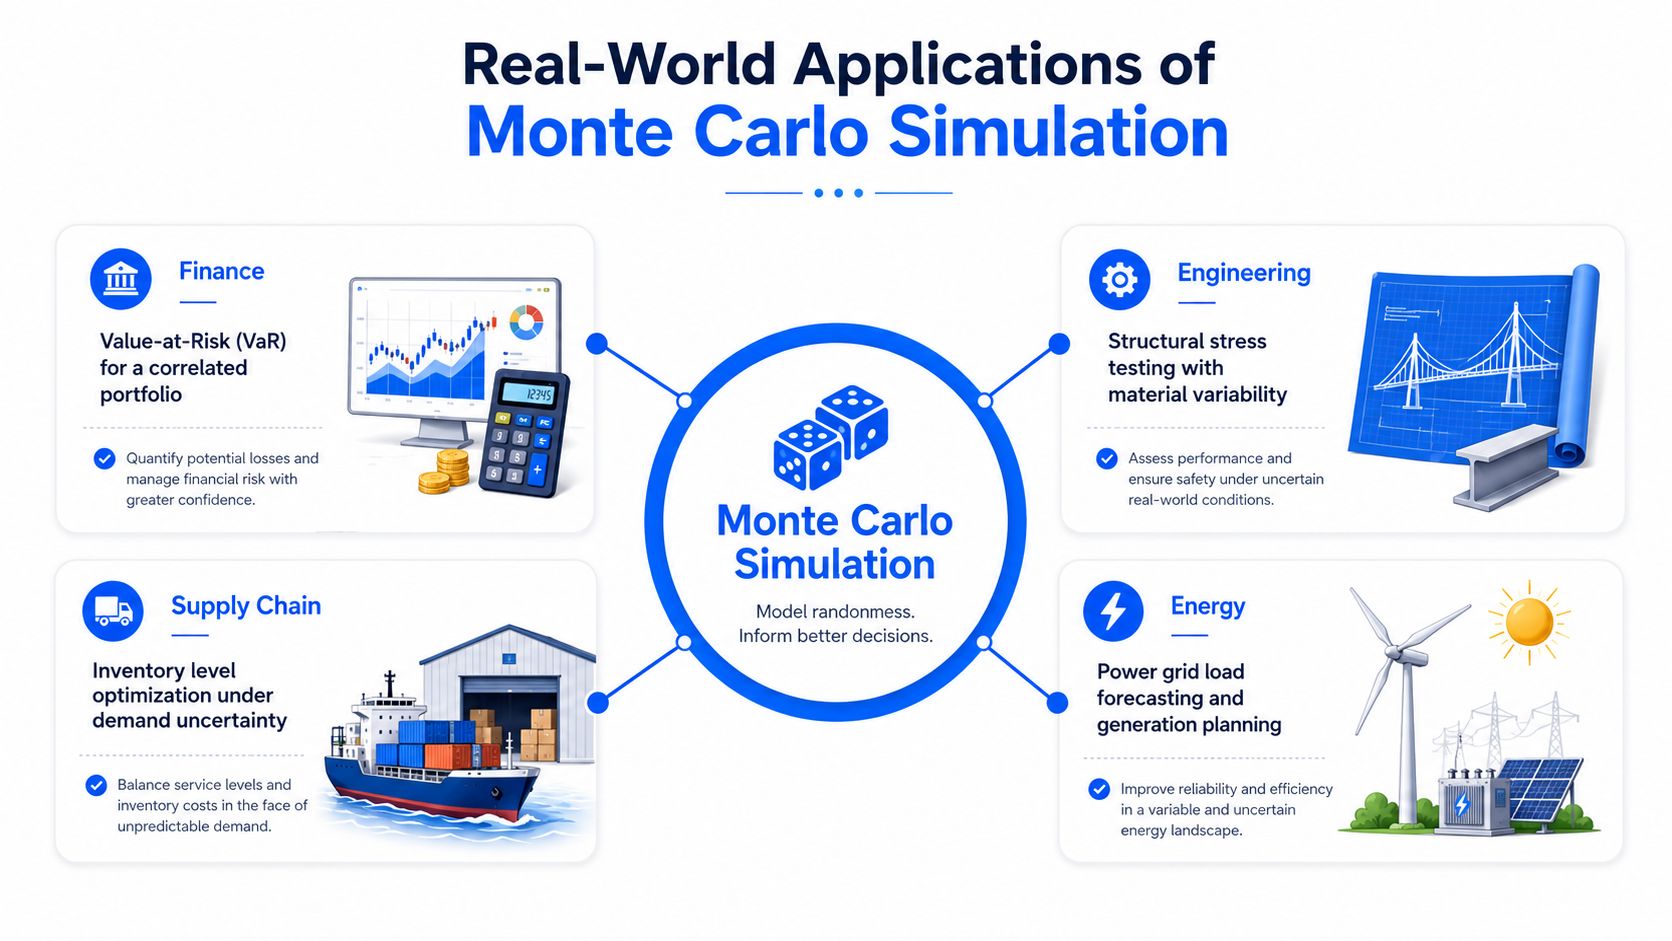
Cztery obszary, w których dowodzi swojej wartości
W planowaniu terminowości (Timeliness) model Monte Carlo może oszacować prawdopodobieństwo naruszenia umowy SLA, gdy każdy etap w potoku danych wykazuje wahania. Jest to bardziej użyteczne niż pojedynczy szacowany czas zakończenia, ponieważ operatorzy muszą wiedzieć, jak prawdopodobne są niekorzystne scenariusze.
W obszarze Data Observability ta sama idea pojawia się w wykrywaniu anomalii. Platforma może traktować sygnały dotyczące aktualności, wolumenu i schematu jako niepewne dane wejściowe, próbkowac prawdopodobne stany metryk i oceniać, czy alert odzwierciedla rzeczywisty incydent, czy tylko szum. To naturalne zastosowanie dla działań związanych z wykrywaniem anomalii w stylu Monte Carlo w systemie digna, a strona spotting data anomalies in your data platform with Monte Carlo simulations idealnie wpisuje się w ten przypadek użycia.
W łańcuchu dostaw i planowaniu energetycznym ten wzorzec się powtarza. Niepewność popytu, ryzyko zapasów i prognozowanie obciążenia stają się łatwiejsze do przeanalizowania, gdy model zwraca zakres prawdopodobnych wyników zamiast pojedynczej, optymistycznej prognozy.
Jeśli zmiana ogona rozkładu zmienia decyzję, szacunek punktowy jest zazwyczaj zbyt powierzchowny, aby mu zaufać.
Kryje się tu również ważna lekcja systemowa. Metoda Monte Carlo nie jest przeznaczona wyłącznie dla analityków finansowych czy naukowców. Każdy zespół, który musi odpowiedzieć na pytanie: „Co się stanie, gdy kilka niepewnych czynników zmieni się jednocześnie?”, już teraz porusza się w obszarze metody Monte Carlo.
Uczciwe kompromisy i typowe pułapki
Metoda Monte Carlo ma ogromną moc, ale to nie magia. Najważniejszym ograniczeniem jest powolne skalowanie błędu – błąd bezpośredniego szacowania spada wraz z σ/√n, więc zmniejszenie błędu o połowę kosztuje znacznie więcej mocy obliczeniowej, niż ludzie się spodziewają MIT OCW. Właśnie dlatego metody redukcji wariancji są tak ważne – zmniejszają one wariancję estymatora bez zmiany jego wartości oczekiwanej, co daje węższy przedział przy tym samym budżecie procesora Frontiers in Physics.
Pułapki, które po cichu zniekształcają wyniki
Pierwszą pułapką jest jakość danych wejściowych. Jeśli rozkłady nie odzwierciedlają rzeczywistości, symulacja wygeneruje jedynie bardziej dopracowaną, ale błędną odpowiedź. Ogon rozkładu Gaussa może wyglądać uspokajająco w modelu ryzyka, podczas gdy rzeczywisty świat ma znacznie „grubsze” ogony.
Drugą pułapką jest ślepa korelacja. Początkujący często próbkuje dane wejściowe niezależnie, ponieważ jest to łatwiejsze, a następnie otrzymuje wyniki, które są zbyt gładkie i zbyt korzystne. Ten błąd jest szczególnie kosztowny w pracach nad portfelem, modelach niezawodności i każdym systemie, w którym wspólne czynniki zmieniają się razem.
Trzecią pułapką jest zbieżność, która wygląda dobrze tylko na oko. Średnia krocząca, która wizualnie się stabilizuje, wciąż może ukrywać niestabilność w ogonie rozkładu, dlatego potrzebujesz reguły zatrzymania, a nie tylko przeczucia.
Czwartą pułapką jest ukryta wariancja wynikająca z rzadkich zdarzeń. Jeśli zdarzenie, na którym Ci zależy, występuje rzadko, zbyt mała liczba uruchomień może je całkowicie pominąć, co sprawia, że wynik wygląda na bezpieczniejszy, niż jest w rzeczywistości. Metoda Monte Carlo może zaniżać wartości skrajne, gdy wybrane rozkłady są zbyt łagodne, szczególnie w kontekście finansów i ryzyka systemowego Analytica on Monte Carlo in finance.
Lista kontrolna do notebooka, która pozwala zachować rzetelność
Zweryfikuj każde dane wejściowe pod kątem danych historycznych lub wiedzy domenowej przed przystąpieniem do symulacji.
Uwzględnij korelację tam, gdzie wspólne czynniki zmieniają się razem.
Wybierz regułę zatrzymania na podstawie stabilności wyniku, a nie tylko arbitralnej liczby przebiegów.
Raportuj przedział ufności, a nie tylko pojedynczą odpowiedź.
Traktuj model jako jeden z zestawów założeń, a nie jako ostateczną prawdę.
Poradnik guide to ETL migration strategies przypomina, że systemy danych niższego szczebla również zależą od jakości założeń. Jeśli struktura na wejściu jest błędna, odpowiedź na wyjściu będzie obarczona szumem, bez względu na to, jak elegancko wygląda kalkulacja.
Od idei Monte Carlo do klasy enterprise Data Observability z digna
W obszarze observability przedsiębiorstw podejście oparte na metodzie Monte Carlo przejawia się w nauce wzorców bazowych i probabilistycznym alertowaniu. Platforma digna monitoruje tabele, potoki danych, wzorce aktualności i metryki biznesowe bezpośrednio w środowisku klienta, a następnie uczy się, jak wygląda normalne zachowanie, bez zmuszania zespołów do ręcznego kodowania podatnych na błędy reguł. Ma to kluczowe znaczenie, ponieważ dane nie po prostu napływają – napływają z wahaniami, sezonowością i okazjonalnymi brakami.
Dlaczego perspektywa Monte Carlo pasuje do observability
Użytecznym krokiem jest traktowanie oczekiwanej aktualności, liczby wierszy i współczynników wartości pustych (null) jako rozkładów, a nie stałych progów. Gdy platforma pozna tę linię bazową, może porównać wartości rzeczywiste z wyuczonym zakresem i oszacować, czy obecny stan jest nietypowy. To dokładnie ta sama logika, którą metoda Monte Carlo stosuje w innych dziedzinach: powtarzane próbkowanie w celu zrozumienia rozrzutu prawdopodobnych wyników.
Praktyczna pętla jest łatwa do wdrożenia. digna uczy się linii bazowej aktualności na podstawie historycznych zachowań napływu danych, próbkuje oczekiwane stany opóźnień z tego wyuczonego rozkładu, a następnie ocenia bieżącą obserwację na tle tych stanów, aby zdecydować, czy opóźnienie wygląda na anomalne. Wynikiem jest sygnał oparty na stopniu pewności, a nie tylko alarm typu tak/nie.
Takie podejście naturalnie sprawdza się przy migracjach i zmianach w potokach danych. Jeśli zespół przenosi przepływy danych lub przebudowuje źródła, poradnik guide to ETL migration strategies zapewnia kontekst operacyjny, podczas gdy system observability w stylu Monte Carlo pomaga ocenić, czy nowe zachowanie nie odbiega od normy.
Co zespół może zrobić na początku
Włącz naukę linii bazowej dla kluczowych pulpitów nawigacyjnych i potoków danych, aby system znał normalne zachowanie, zanim zacznie zgłaszać wyjątki.
Porównaj zaobserwowane rozkłady z alertami opartymi na stałych progach, ponieważ same progi pomijają naturalną zmienność.
Używaj przedziałów ufności do ustalania priorytetów analizy zgłoszeń, aby najbardziej zaszumione sygnały nie zdominowały kolejki.
Dla zespołów, które chcą połączyć te idee w jednym miejscu, strona Monte Carlo data alternative for enterprise data observability pokazuje, jak ten wzorzec przekłada się na monitoring operacyjny.
Ogólny wniosek jest prosty. Myślenie w kategoriach Monte Carlo pomaga zadać lepsze pytanie: „Jak prawdopodobne jest, że ten stan jest rzeczywisty?”. W observability to pytanie często ma większe znaczenie niż to, czy metryka przekroczyła jedną stałą linię.
Jeśli próbujesz podejmować decyzje dotyczące niezawodności danych z mniejszą ilością domysłów, odwiedź stronę digna i zobacz, jak uczenie linii bazowej, monitorowanie terminowości (timeliness) oraz wykrywanie anomalii (Data Anomalies) współpracują ze sobą w ramach jednej platformy observability. To praktyczny sposób na zastosowanie myślenia opartego na niepewności w stylu Monte Carlo do potoków danych, pulpitów nawigacyjnych i metryk biznesowych, które nie mogą sobie pozwolić na zaszumione alerty.
Najczęściej zadawane pytania
Czym jest symulacja Monte Carlo?
To szacowanie wartości oczekiwanej, zapisywanej wprost jako E[f(X)], przez losowanie wielu prób niepewnych wejść X, obliczanie funkcji f za każdym razem i uśrednianie wyników. W praktyce zastępuje jedno przypuszczenie tysiącami prawdopodobnych przyszłości wyprowadzonych z tej samej niepewności.
Dlaczego rozkład bije pojedynczą wartość?
Bo zmienia zadawane pytanie. Gdy widzisz rozkład zamiast liczby, przestajesz pytać „jaka jest odpowiedź?”, a zaczynasz pytać „jak szerokie jest pasmo ryzyka i co je napędza?”, a to lepsze pytanie dla budżetów, harmonogramów i operacyjnych SLA.
Dlaczego powtarzane losowanie w ogóle działa?
Dzięki prawu wielkich liczb: średnia symulowanych wyników zbliża się do prawdziwej wartości oczekiwanej wraz ze wzrostem liczby prób. Dlatego tarcza trafiana wystarczająco wiele razy ujawnia pole, które bezpośrednio liczyłoby się niewygodnie.
Kiedy Monte Carlo bije wzór analityczny?
Gdy system opiera się eleganckiej algebrze. Nie potrzebujesz rozwiązania zamkniętego dla całego systemu i właśnie dlatego metoda pasuje do modeli nieliniowych i nieuporządkowanego zachowania świata rzeczywistego. Jeśli problem da się próbkować i obliczać, Monte Carlo zwykle potrafi go oszacować.
Czy Monte Carlo daje pewność?
Nie, a traktowanie go tak jest główną pułapką. Model Monte Carlo nie obiecuje pewności, lecz kwantyfikuje niepewność przy dostarczonych przez Ciebie założeniach. Uczciwym wynikiem jest więc pasmo ryzyka z nazwanymi czynnikami, a nie pewna siebie pojedyncza liczba.


