Co to jest platforma danych
|
8
min. czyt.

Platforma danych to zintegrowany zestaw narzędzi i infrastruktury, którego organizacja używa do pozyskiwania, przechowywania, przetwarzania, zarządzania (governance) i udostępniania danych do celów analitycznych oraz sztucznej inteligencji. Według przeglądu rynku platform danych przygotowanego przez 6Wresearch globalny rynek platform danych został oszacowany na 82,4 mld USD w 2024 r. i przewiduje się, że przekroczy 210 mld USD do 2031 r., przy skumulowanej rocznej stopie wzrostu wynoszącej 14,5% w tym okresie prognozy.
Twój zespół produktowy może już borykać się z tym problemem. Eksport z systemu CRM przychodzi w formacie arkusza kalkulacyjnego, replika bazy danych Postgres zawiera dane aplikacji, platformy reklamowe dostarczają pliki CSV, a pulpit nawigacyjny Looker nagle przestaje działać, ponieważ ktoś zmienił nazwę pola. Każde źródło działa samodzielnie, ale nikt nie potrafi łatwo wyjaśnić, która wersja jest aktualna, kto może z niej korzystać, czy dotarła na czas i dlaczego zmienił się dany wskaźnik.
Problem zazwyczaj nie leży w samych danych. Jest nim brak jednego, połączonego systemu operacyjnego dla danych.
Spis treści
Definicja platformy danych prostym językiem
Kluczowe warstwy dostarczane przez każdą platformę danych
Pozyskiwanie (Ingest) to rampa rozładunkowa
Przechowywanie (Storage) to spiżarnia i chłodnia
Przetwarzanie (Compute) to kuchnia
Zarządzanie (Governance) to inspektor i książka kucharska
Observability to panel sterowania w kuchni
Jak platformy danych ewoluowały do obecnej postaci
Porównanie hurtowni (Warehouses), jezior (Lakes) i jezioro-hurtowni (Lakehouses)
Dlaczego Observability powinno być częścią platformy
Awarie, których zespoły nie dostrzegają na czas
Jakość a observability – odpowiedzi na różne pytania
Platformy danych w praktyce w różnych branżach
Praktyczna lista kontrolna do oceny Twojej platformy
Pozyskiwanie i przechowywanie
Przetwarzanie i modelowanie
Zarządzanie (Governance) i dostęp
Observability i niezawodność
Definicja platformy danych prostym językiem
Pomyśl o platformie danych jak o wspólnym łańcuchu dostaw danych w organizacji. Odbiera ona informacje z systemów operacyjnych, przechowuje je w odpowiedniej formie, przygotowuje do użycia, stosuje reguły dostępu i znaczenia oraz udostępnia zaufane wyniki analitykom, aplikacjom i systemom AI.
Z tej definicji wynika ważny wniosek: platforma danych to niekoniecznie jeden produkt. To zintegrowany zbiór infrastruktury, usług, polityk i interfejsów. Hurtownia danych może zapewniać przechowywanie i przetwarzanie SQL, podczas gdy oddzielne usługi zajmują się pozyskiwaniem, transformacją, katalogowaniem, kontrolą dostępu i monitorowaniem. Elementy te stają się platformą dopiero wtedy, gdy współpracują ze sobą jako spójny system, a nie jako rozproszone narzędzia.
Na poziomie praktycznym warto zadać pięć pytań:
Czy dane docierają niezawodnie? To jest warstwa pozyskiwania (ingestion), obejmująca pliki, interfejsy API, zdarzenia aplikacji oraz śledzenie zmian w bazach danych (change data capture).
Gdzie są przechowywane? Warstwa przechowywania (storage) może obejmować tabele w hurtowni, pamięć obiektową, tabele w architekturze lakehouse lub wyspecjalizowane bazy danych czasu rzeczywistego.
Jak są przygotowywane? Warstwa przetwarzania (compute) uruchamia zapytania, transformacje, agregacje i zadania uczenia maszynowego.
Co oznaczają dane i kto może z nich korzystać? Zarządzanie (governance) odpowiada za definicje, pochodzenie danych (lineage), katalogowanie, uprawnienia i rejestry audytowe.
Skąd zespoły wiedzą, że system działa prawidłowo? Observability śledzi aktualność (freshness), zmiany schematów, anomalie, działanie potoków danych (pipelines) oraz ich wpływ na systemy docelowe.
Wskazówki dotyczące architektury przedsiębiorstwa powszechnie opisują tego typu platformę jako oprogramowanie, które pomaga użytkownikom przechowywać, uzyskiwać dostęp, zarządzać i nadzorować (govern) dane przedsiębiorstwa zarówno w płaszczyźnie danych (data plane), jak i płaszczyźnie kontroli danych (data control plane), jak opisano w analizie rynku platform danych IDC.
Platforma danych nie jest zatem tylko bazą danych, ponieważ baza danych może przechowywać dane bez zarządzania ich pełnym cyklem życia. Nie jest też tylko narzędziem klasy BI, ponieważ pulpity nawigacyjne korzystają z przygotowanych danych, zamiast zarządzać ich pozyskiwaniem i ładem (governance). Nie musi być również automatycznie pakietem od jednego dostawcy. Jej cechą definicyjną jest integracja.
W celu szerszego spojrzenia na poziom przedsiębiorstwa przydatny jest ten przegląd korporacyjnych platform danych. Główne pytanie pozostaje proste: czy Twoja organizacja może przejść od systemu źródłowego do zaufanej decyzji bez konieczności ręcznego łączenia każdego etapu?
Kluczowe warstwy dostarczane przez każdą platformę danych
Architekturę łatwiej zrozumieć na przykładzie restauracji. Dostawcy dostarczają składniki, personel je przechowuje, kucharze przygotowują potrawy, inspektorzy dbają o standardy, a menedżerowie obserwują pracę w poszukiwaniu ewentualnych problemów. Platforma danych działa według tego samego schematu.
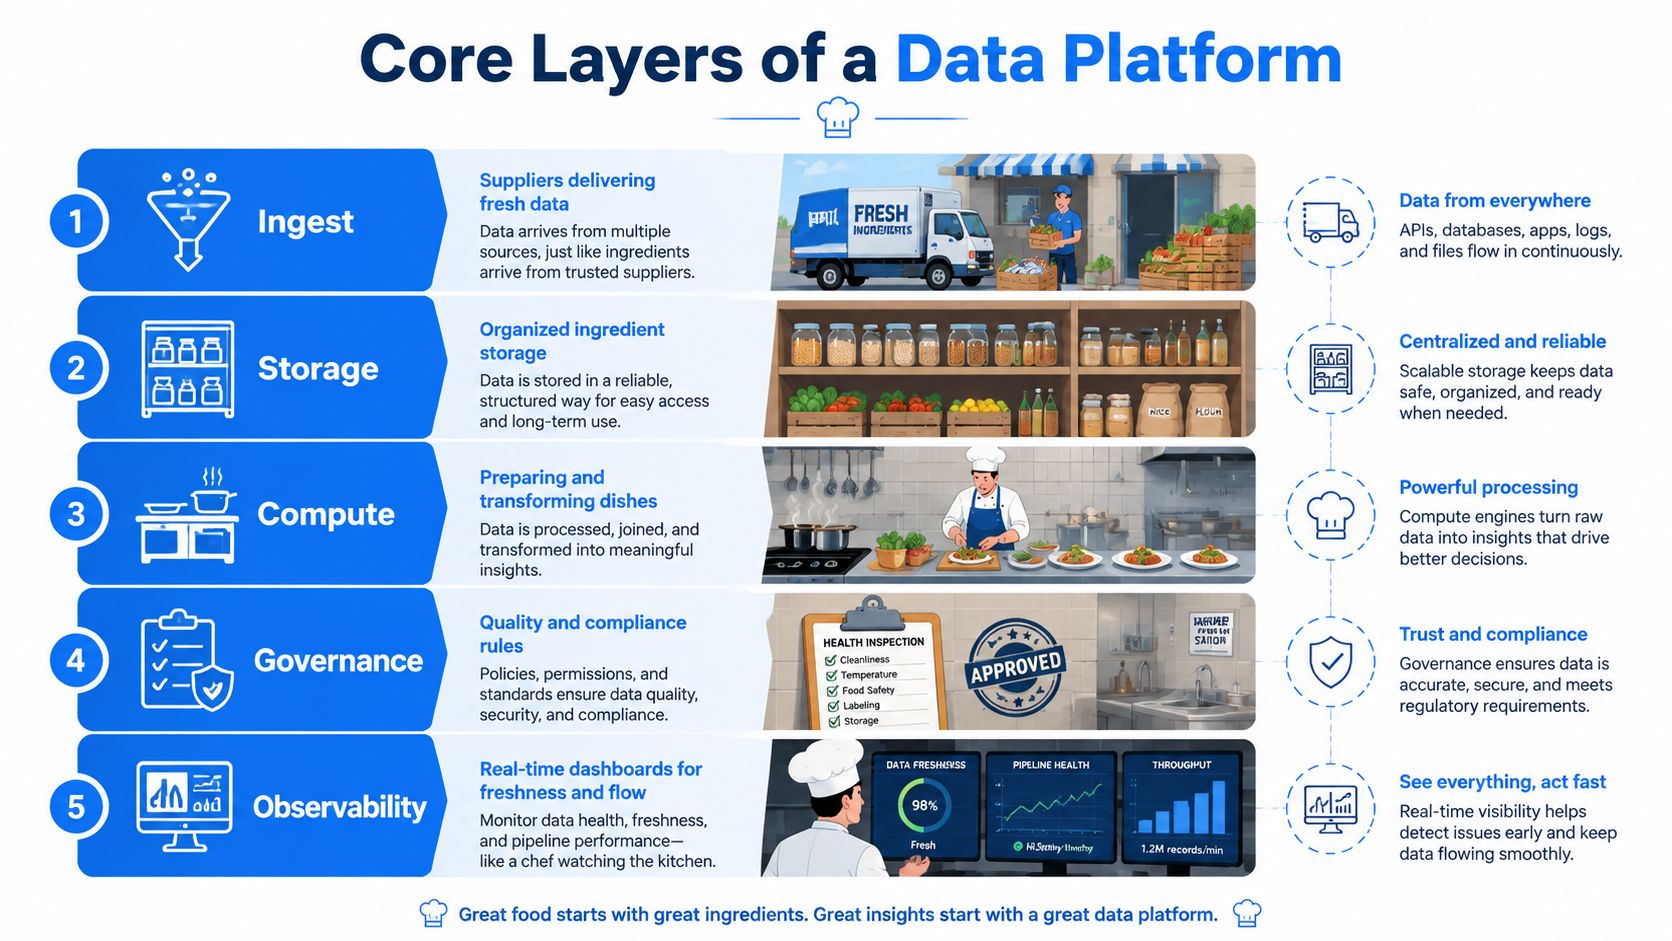
Pozyskiwanie (Ingest) to rampa rozładunkowa
Pozyskiwanie wprowadza surowiec do platformy. Źródłami mogą być zdarzenia aplikacji, API, pliki, repliki baz danych lub strumienie zmian (change data capture). Kafka może przesyłać strumienie zdarzeń, podczas gdy konektory i zaplanowane zadania mogą ładować pliki oraz rekordy operacyjne.
Rampa rozładunkowa potrzebuje czegoś więcej niż tylko drzwi. Wymaga rejestrowania czasu odbioru, identyfikacji źródeł, obsługi błędów oraz rejestru tego, co dotarło. Bez tych mechanizmów kontroli platforma może przyjąć dane, ale zespół nadal nie będzie w stanie stwierdzić, czy dostawa była kompletna.
Organizacje, które muszą łączyć systemy zewnętrzne, często oceniają usługi Data API równolegle z natywnymi konektorami i narzędziami do obsługi zdarzeń. Właściwy wybór zależy od różnorodności źródeł, wymagań dotyczących opóźnień oraz tego, jak dużą część logiki potoku danych chce kontrolować wewnętrzny zespół.
Przechowywanie (Storage) to spiżarnia i chłodnia
Przechowywanie chroni składniki w formach dostosowanych do różnych zadań. Amazon S3 może przechowywać obiekty ustrukturyzowane i nieustrukturyzowane, podczas gdy Snowflake pozwala organizować uporządkowane tabele analityczne. Architektura lakehouse może nakładać transakcyjne formaty tabel na pamięć obiektową, umożliwiając zespołom pracę z dużymi i zróżnicowanymi zestawami danych przy zachowaniu silniejszego zarządzania tabelami.
Decyzje dotyczące przechowywania wpływają na koszty, szybkość dostępu, retencję i ład danych (governance). Surowe dane mogą wymagać przechowywania w formie bliskiej oryginałowi do celów eksploracyjnych, podczas gdy dane przetworzone powinny być zorganizowane pod kątem powtarzalnego użytku biznesowego.
Przetwarzanie (Compute) to kuchnia
Przetwarzanie zmienia przechowywane dane w coś użytecznego. Silniki SQL odpowiadają na pytania, frameworki transformacji takie jak dbt budują modelowane zestawy danych, a silniki przetwarzania rozproszonego przygotowują dane do złożonych zadań lub uczenia maszynowego.
Istotne rozróżnienie polega na tym, że przechowywanie (storage) gromadzi składniki, podczas gdy przetwarzanie (compute) wykonuje pracę. Ich rozdzielenie pozwala zespołom niezależnie skalować moc obliczeniową i pojemność dyskową, ale tworzy też granice operacyjne, które wymagają jasnej odpowiedzialności.
Zarządzanie (Governance) to inspektor i książka kucharska
Zarządzanie (governance) definiuje, kto może mieć dostęp do danych, co oznacza dany wskaźnik, skąd pochodzi zestaw danych i jakie zasady kontroli go obowiązują. Unity Catalog, kontrola dostępu oparta na rolach (RBAC), kontrola oparta na atrybutach (ABAC), logowanie audytowe, katalogi i narzędzia do śledzenia pochodzenia danych (lineage) wspierają te zadania.
Zarządzanie chroni również spójność. Jeśli jeden zespół definiuje „aktywnego klienta” inaczej niż drugi, oba pulpity nawigacyjne mogą być technicznie poprawne, ale będą prowadzić do sprzecznych decyzji.
Observability to panel sterowania w kuchni
Observability pokazuje, czy dostawy dotarły, czy pamięć masowa jest dostępna, czy transformacje zakończyły się pomyślnie i czy wyniki pozostają wiarygodne. Narzędzia takie jak Monte Carlo mogą monitorować zachowanie danych, podczas gdy natywne metryki i alerty platformy zapewniają kontekst operacyjny.
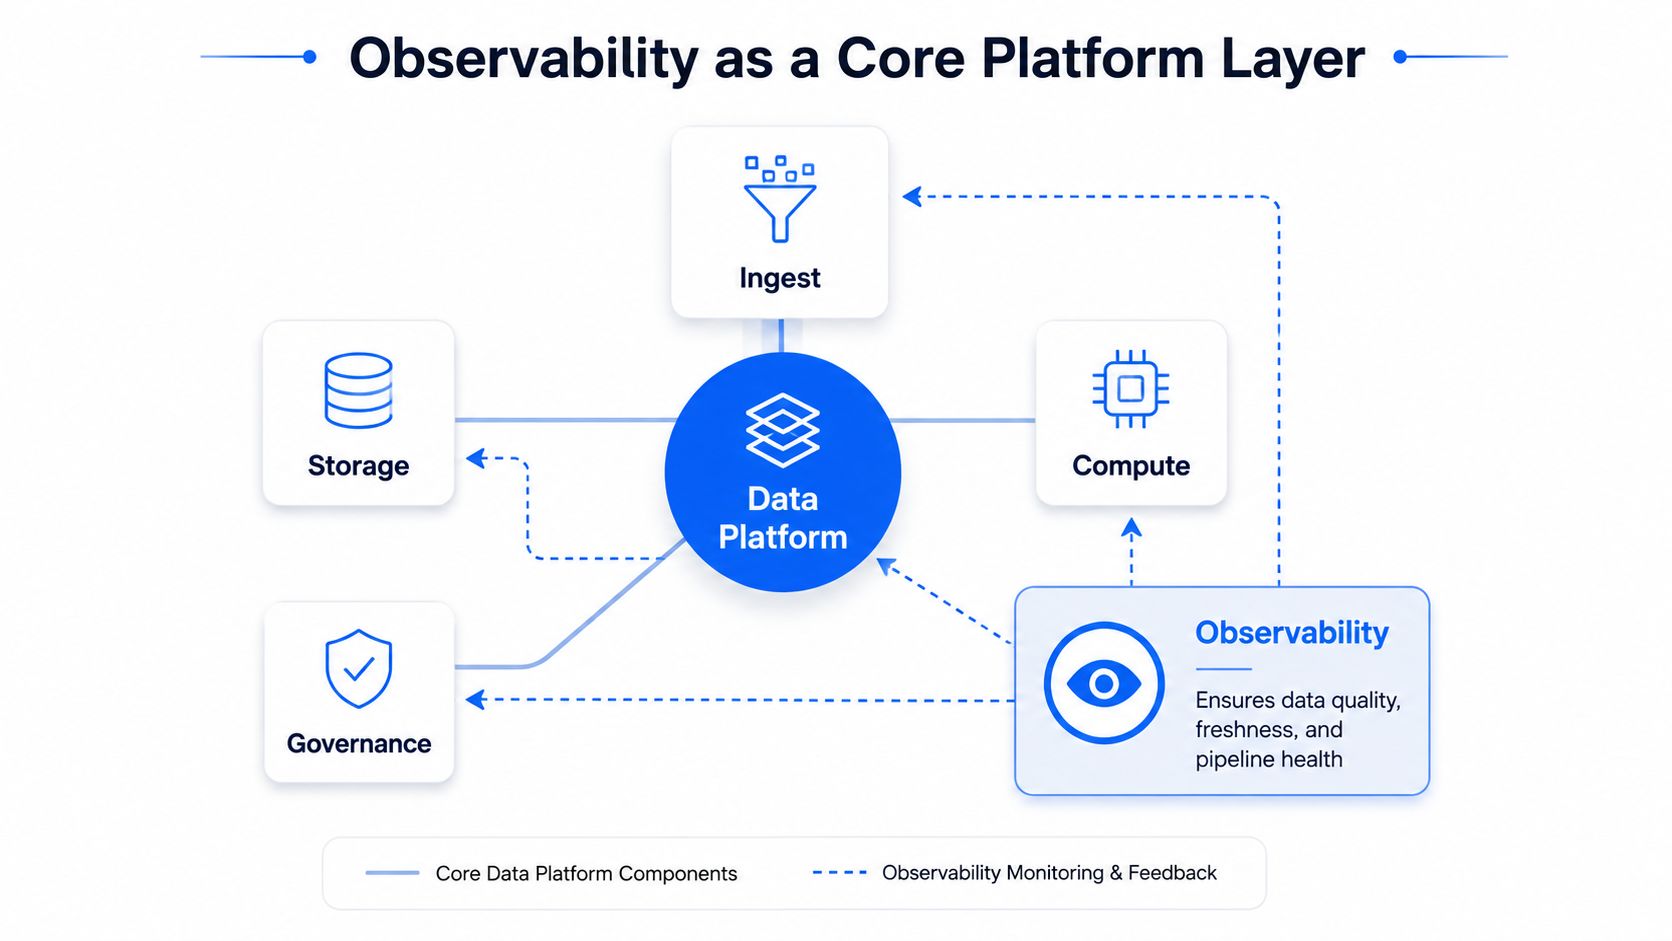
Wytyczne architektoniczne zorientowane na rozwiązania IBM traktują observability jako fundamentalną warstwę platformy danych, ponieważ zespoły potrzebują wglądu w wiarygodność, aktualność i zachowanie potoków danych, a nie tylko informacji o pomyślnym zakończeniu zadania. Potok danych może zakończyć się sukcesem, a mimo to opublikować dane nieaktualne, niekompletne lub zmienione strukturalnie.
Użyteczny widok architektoniczny przedstawiono w tym przewodniku po architekturze systemów danych. Wniosek jest prosty: przenoszenie danych to tylko część pracy. Funkcjonująca platforma musi również wyjaśniać, chronić i stale kontrolować to, co przesyła.
Jak platformy danych ewoluowały do obecnej postaci
Platformy danych ewoluowały w wyniku ciągłych kompromisów, a nie prostej sekwencji technologii zastępujących się nawzajem. Zespoły nieustannie szukały równowagi między dyscypliną schematów, elastycznością, szybkością analiz, kosztami infrastruktury i zarządzaniem (governance).
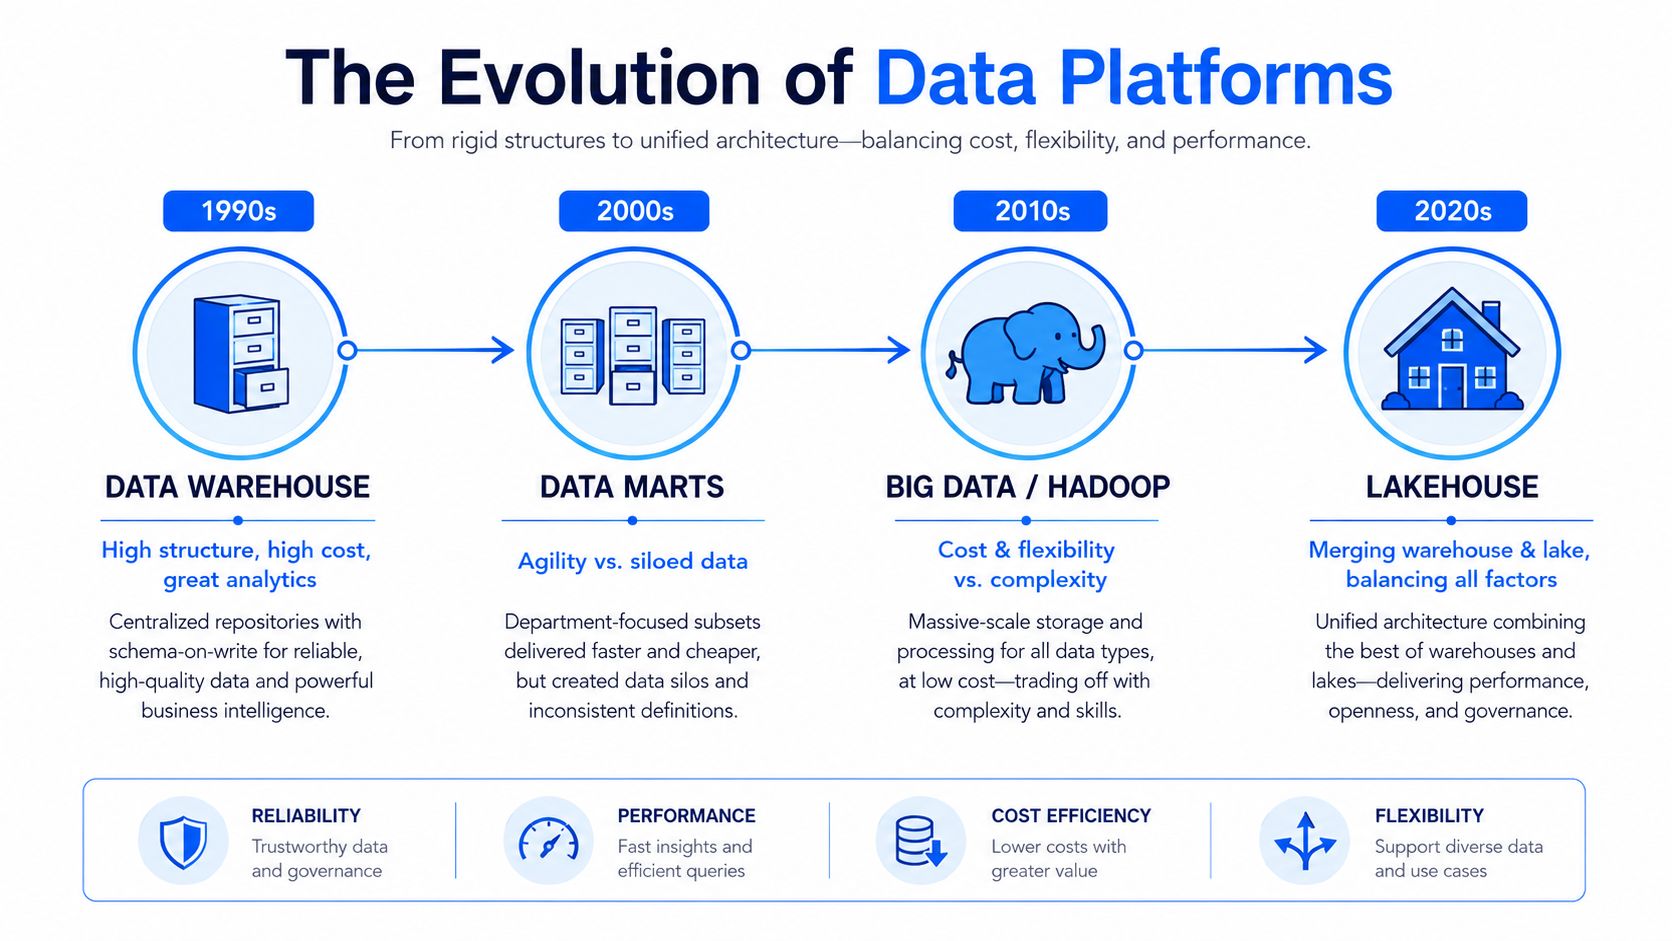
Hurtownia danych (data warehouse) ustanowiła scentralizowany model raportowania. Organizacje konsolidowały informacje z wielu systemów w ustrukturyzowane schematy, dając analitykom jednolity obraz firmy. Podejście to wspierało wiarygodne analizy SQL, ale sztywne schematy i kosztowne urządzenia lokalne (on-premises) sprawiały, że wprowadzanie zmian było trudne i powolne.
Wydzielone bazy danych (data marts) wprowadziły większą lokalną elastyczność. Poszczególne działy mogły kształtować dane na potrzeby własnych raportów, jednak ta sama elastyczność mogła prowadzić do powielania logiki i powstawania sprzecznych definicji. Dział finansowy i marketingowy mogły obliczać ten sam wskaźnik biznesowy w różny sposób, nawet jeśli oba korzystały z podobnych źródeł.
Jezioro danych (data lake) powstało w odpowiedzi na potrzebę tańszego i pojemniejszego przechowywania. Pamięć obiektowa i Hadoop umożliwiły praktyczne przechowywanie surowych plików, logów, zdarzeń i innych formatów bez konieczności modelowania wszystkiego przed zapisem. Kompromisem była jednak złożoność. Bez wyznaczonej odpowiedzialności, katalogowania, kontroli jakości i zasad cyklu życia, jezioro mogło stać się zbiorem plików, którym nikt nie ufał.
Architektura lakehouse pojawiła się jako pragmatyczna odpowiedź. Formaty tabel, takie jak Delta Lake, Apache Iceberg i Apache Hudi, wprowadzają zarządzanie schematem i właściwości transakcyjne do otwartych systemów przechowywania danych, pomagając jednemu środowisku obsługiwać zarówno zadania analityczne, jak i uczenie maszynowe.
Architektury te wciąż się zbliżają. Zarządzane hurtownie coraz częściej obsługują dane półstrukturyzowane i otwarte formaty plików, podczas gdy nowoczesne jeziora wdrażają znane z hurtowni transakcje, governance i zarządzanie tabelami. Historię tę podsumowano w przeglądzie historycznego rozwoju platform danych.
Wnioskiem nie jest to, że jedna architektura wygrała. Chodzi o to, że każda platforma niesie ze sobą kompromisy. Zespół wybierający architekturę powinien zadać sobie pytanie, które ograniczenia są najważniejsze: szybki, nadzorowany SQL, niedrogie przechowywanie danych surowych, elastyczny dostęp dla uczenia maszynowego, otwarte formaty czy prostota operacyjna.
Porównanie hurtowni (Warehouses), jezior (Lakes) i jezioro-hurtowni (Lakehouses)
Hurtownia, jezioro i lakehouse mogą obsługiwać analitykę, ale organizują tę pracę w inny sposób. Najlepszy wybór zależy od formatów danych, obciążeń (workloads), oczekiwań względem ładu (governance) oraz umiejętności posiadanych przez Twoje zespoły.
Wymiar | Hurtownia danych | Jezioro danych | Lakehouse |
|---|---|---|---|
Typowe formaty | Uporządkowane tabele strukturyzowane, z rosnącym wsparciem dla danych półstrukturyzowanych | Surowe pliki, logi, zdarzenia, obiekty strukturyzowane i nieustrukturyzowane | Tabele strukturyzowane i półstrukturyzowane w otwartej pamięci obiektowej |
Główne zadania | BI, raportowanie SQL, nadzorowana analiza biznesowa | Przechowywanie surowych danych, eksploracja, data science, zróżnicowane przetwarzanie | BI, analityka, uczenie maszynowe i wspólna inżynieria danych |
Podejście do schematu | Schemat jest zazwyczaj definiowany przed ładowaniem lub w jego trakcie | Schemat może być nałożony później, co zwiększa elastyczność | Kontrola schematów i tabel jest dodawana do elastycznej pamięci masowej |
Model zarządzania (Governance) | Często scentralizowany i dojrzały dla uporządkowanych zestawów danych | Może się znacznie różnić i wymaga celowego projektowania katalogów oraz polityk | Dąży do połączenia otwartego przechowywania z silniejszym zarządzaniem tabelami |
Profil kosztów | Zoptymalizowany pod kątem wydajności analitycznej, z kosztami kształtowanymi przez zużycie mocy obliczeniowej i pamięci | Często atrakcyjny przy masowym przechowywaniu, wymaga dodatkowej pracy inżynieryjnej w celu zapewnienia użyteczności | Równoważy ekonomię współdzielonej pamięci masowej z potrzebami przetwarzania i zarządzania |
Zespoły, które z tego korzystają | Analitycy, deweloperzy BI, inżynierowie analityczni, działy finansów i operacyjne | Inżynierowie danych, badacze danych (data scientists), analitycy i użytkownicy eksploracyjni | Interdyscyplinarne zespoły ds. platform, analityki, inżynierii i AI |
Hurtownia jest zazwyczaj najbardziej oczywistym wyborem, gdy większość zadań obejmuje przygotowane tabele i szybkie zapytania SQL. Daje analitykom kontrolowane środowisko, ale zespoły mogą potrzebować dodatkowych systemów do obsługi surowych plików, specjalistycznego przetwarzania lub eksperymentów z uczeniem maszynowym.
Jezioro danych jest przydatne, gdy organizacja musi zachować różnorodne dane przed poznaniem ich przyszłego zastosowania. Ta elastyczność wiąże się jednak z odpowiedzialnością. Katalogowanie, wyznaczona własność, śledzenie schematów i polityki dostępu muszą zapobiegać sytuacji, w której środowisko stanie się niezarządzanym archiwum.
Lakehouse stara się połączyć oba te modele. Może zapewnić otwarte przechowywanie i szeroki dostęp do danych, dodając jednocześnie silniejszą semantykę tabel, obsługę transakcji i governance. To jednak nie eliminuje złożoności. Zespoły wciąż muszą rozumieć strukturę plików, wybór mocy obliczeniowej, utrzymanie tabel, uprawnienia i izolację obciążeń.
Różnicę między jeziorem danych a bardziej ukierunkowaną bazą tematyczną (data mart) opisano w tym porównaniu jezior danych i baz tematycznych. Decyzja powinna wynikać z rzeczywistych potrzeb, a nie z panującej mody. Platforma hybrydowa może mieć sens, gdy finanse wymagają nadzorowanych raportów z hurtowni, data science potrzebuje dostępu do surowych zdarzeń, a dział operacyjny wymaga danych o niskim opóźnieniu ze specjalistycznej bazy.
Dlaczego Observability powinno być częścią platformy
Observability powinno znajdować się obok pozyskiwania, przechowywania, przetwarzania i ładu (governance), ponieważ każda warstwa może wprowadzić błąd, który z zewnątrz wygląda na poprawny wynik. Zielony status potoku danych nie dowodzi, że dane są aktualne, kompletne, strukturalnie zgodne ani użyteczne dla odbiorców.
Data Observability to ciągłe monitorowanie potoków, tabel, zadań i schematów konsumpcji danych. Wyszukuje ono zmiany w aktualności, zmiany schematów (schema drift), anomalie wolumenu, nieudane transformacje i przesunięcia w czasie wykonywania, zamiast polegać wyłącznie na informacji, czy zaplanowane zadanie się powiodło. Korporacyjny przewodnik po data observability opisuje ten szerszy zakres operacyjny.
Awarie, których zespoły nie dostrzegają na czas
Zmiana schematu (schema drift) to powszechna, cicha awaria. System źródłowy może dodać kolumnę, usunąć pole lub zmienić typ danych bez ostrzeżenia. Model docelowy może natychmiast przestać działać lub może kontynuować działanie, generując niekompletne lub błędne wyniki. Badania nad monitorowaniem schematów wskazują te strukturalne zmiany jako sygnały, które systemy observability powinny śledzić w czasie.
Aktualność (Timeliness) niesie ze sobą kolejne ryzyko. Zestaw danych może mieć poprawną strukturę, ale być bezużyteczny, ponieważ ostatnia dostawa dotarła z opóźnieniem. Zespoły porównują rzeczywisty czas dotarcia z oczekiwanym harmonogramem lub umowami SLA, aby wykryć opóźnienia, zanim nieaktualne dane trafią na pulpity nawigacyjne i do raportów operacyjnych – tę różnicę opisują wytyczne digna dotyczące timeliness.
Duplikaty, nieoczekiwane wahania wolumenu i zmieniające się rozkłady wartości mogą wywołać incydenty innego typu. Tabela przychodów może załadować się pomyślnie, zawierając jednak powtarzające się rekordy, a cecha w modelu ML może technicznie istnieć, choć odzwierciedla już nieaktualną populację.
Jakość a observability – odpowiedzi na różne pytania
Kontrole jakości weryfikują znane reguły. Na przykład test na poziomie rekordu może wymagać, aby identyfikator istniał lub aby wartość mieściła się w akceptowanym zakresie. Observability wykrywa nieoczekiwane zachowania, śledzi ich wpływ w całym pochodzeniu danych (lineage) i pomaga diagnozować zmiany, których wcześniej zdefiniowane reguły nie przewidziały.
Zasada praktyczna: Używaj deterministycznej walidacji dla reguł, które już rozumiesz, a observability dla zmian, których się nie spodziewasz.
Oba podejścia współpracują ze sobą. Zunifikowana strategia jakości danych i observability wyjaśnia, dlaczego przedsiębiorstwa łączą walidację z wykrywaniem anomalii, śledzeniem pochodzenia (lineage) i monitorowaniem schematów.
Włączenie observability do platformy zmienia strukturę odpowiedzialności. Inżynierowie danych otrzymują alerty z kontekstem źródłowym i docelowym, inżynierowie analityczni widzą, czy zmiana wpływa na dany model, a zespoły ds. governance zyskują dowody na zachowanie danych. Zamiast dowiadywać się o problemie z uszkodzonego pulpitu nawigacyjnego, zespoły mogą zbadać etap pozyskiwania lub granicę schematu, gdzie rozpoczęła się zmiana. Praktyki data observability dostarczają użytecznych ram do oceny tych możliwości.
Platformy danych w praktyce w różnych branżach
Architektura staje się wyraźniejsza, gdy te same warstwy rozwiązują różne problemy operacyjne.
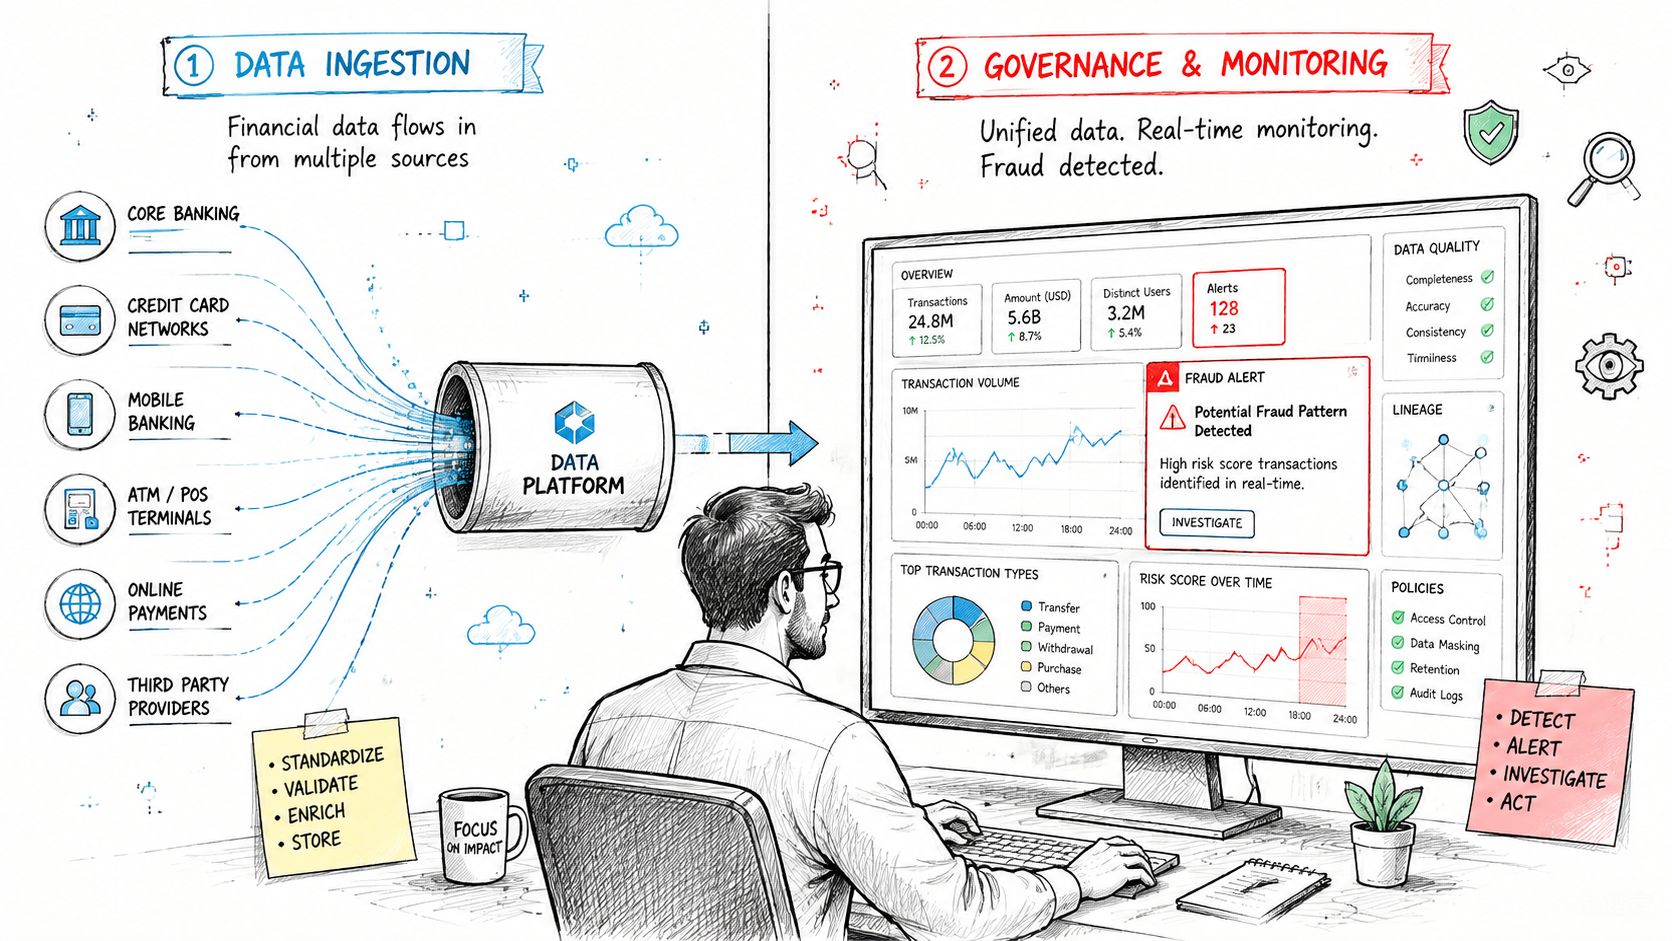
Bank detaliczny może pozyskiwać zdarzenia transakcyjne, dane klientów i sygnały z urządzeń do platformy obsługującej analizę nadużyć finansowych w czasie zbliżonym do rzeczywistego. Warstwa pozyskiwania musi obsługiwać zdarzenia na czas, warstwa przetwarzania musi porównywać bieżące zachowanie z odpowiednimi wzorcami, governance musi ograniczać dostęp do wrażliwych danych finansowych, a observability musi identyfikować brakujące dostawy lub zmiany strukturalne, zanim potoki wykrywania nadużyć przetworzą wadliwe dane wejściowe. Kompromisem jest złożoność operacyjna w zamian za szybsze wykrywanie i bardziej kontrolowane użycie wrażliwych informacji.
Sieć szpitali mierzy się z innym zestawem ograniczeń. Dokumentacja medyczna, dane o roszczeniach, systemy operacyjne i dane z urządzeń mogą wymagać połączenia, ale dostęp nie może być jednolity. Governance określa, które role mogą widzieć określone zestawy danych, lineage pomaga użytkownikom zrozumieć, jak powstał dany raport, a walidacja pomaga egzekwować reguły dotyczące kluczowych rekordów. Organizacja akceptuje większy narzut kontrolny, ponieważ identyfikowalność i ograniczony dostęp są rócenie ważne, co wygoda analityczna.
Zespoły telekomunikacyjne często potrzebują zarówno perspektywy klienta, jak i sieci. Lakehouse może stanowić wspólny fundament dla pulpitów prognozowania odejść klientów (churn) i modeli anomalii sieciowych, podczas gdy oddzielne procesy przetwarzania służą użytkownikom SQL i zespołom uczenia maszynowego. Observability pomaga inżynierom platformy odróżnić rzeczywistą zmianę w zachowaniu klientów od uszkodzonego potoku danych lub niekompletnego źródła.
Organizacje sektora publicznego mogą udostępniać dane między agencjami, zachowując jednocześnie wymagania dotyczące lokalizacji danych, dostępu i audytu. Modułowa platforma pozwala scentralizować katalogowanie i definicje polityk, umożliwiając jednocześnie różnym departamentom zachowanie własności swoich zestawów danych. Przyjętym kompromisem jest to, że dostęp międzyinstytucjonalny wymaga bardziej formalnych mechanizmów kontroli niż nieformalna wymiana plików, ale rezultatem jest bardziej powtarzalna analiza i jaśniejsza odpowiedzialność.
Przykłady te nie wskazują na jedną uniwersalną architekturę. Pokazują, dlaczego projektowanie platformy musi zaczynać się od analizy konsekwencji awarii. Opóźnione dane w telekomunikacji, ujawnione pole medyczne, niewyjaśniony wskaźnik bankowy i niekompletny zestaw danych sektora publicznego – wszystkie te sytuacje wymagają innych mechanizmów kontroli, nawet jeśli leżące u ich podstaw warstwy wyglądają podobnie.
Praktyczna lista kontrolna do oceny Twojej platformy
Użyj poniższych pytań, aby ocenić swoje obecne rozwiązania. Odpowiedź „nie” nie oznacza automatycznie, że architektura jest błędna. Wskazuje ona granicę, na której integracja, własność lub widoczność mogą być słabe.
Pozyskiwanie i przechowywanie
Pokrycie źródeł: Czy platforma może przyjmować dane zarówno wsadowo (batch), jak i strumieniowo, bez tworzenia osobnego modelu operacyjnego dla każdego źródła?
Rozmieszczenie danych: Czy wiesz, które zestawy danych powinny trafić do uporządkowanych tabel w hurtowni, elastycznego jeziora danych lub tabel lakehouse?
Kontrola cyklu życia: Czy właściciele potrafią określić wymagania dotyczące retencji, dostępu i aktualności dla ważnych zestawów danych?
Przetwarzanie i modelowanie
Wspólny fundament: Czy analizy SQL, procesy transformacji i zadania uczenia maszynowego mogą korzystać z nadzorowanych danych bez tworzenia niepotrzebnych kopii?
Powtarzalność: Czy analitycy mogą prześledzić wskaźnik od jego definicji semantycznej, przez transformacje, aż po dane źródłowe?
Dopasowanie do zadań: Czy warstwa przetwarzania obsługuje opóźnienia, skalę i wzorce obliczeniowe potrzebne Twoim zespołom?
Zarządzanie (Governance) i dostęp
Jasność uprawnień: Czy platforma może wymusić dostęp oparty na rolach lub atrybutach, zamiast polegać na nieformalnych ustaleniach?
Lineage i katalogowanie: Czy użytkownik może dowiedzieć się, co oznacza dany zestaw danych, kto jest jego właścicielem i jakie produkty docelowe od niego zależą?
Audytowalność: Czy Twój zespół może odtworzyć, kto miał dostęp do wrażliwych danych i jak powstała raportowana liczba?
Observability i niezawodność
Widoczność aktualności: Czy zespół dowie się o opóźnionej lub brakującej dostawie, zanim użytkownik pulpitu nawigacyjnego zgłosi problem?
Ochrona strukturalna: Czy platforma potrafi wykryć dodane kolumny, usunięte pola i zmiany typów danych?
Sygnały behawioralne: Czy system potrafi ujawnić anomalie w wolumenie, wartościach, metrykach biznesowych, wykonywaniu potoków danych i zużyciu zasobów platformy?
Dojrzała platforma nie musi pochodzić od jednego dostawcy. Wymaga jednak na tyle dobrej integracji, aby jeden zespół mógł odpowiedzieć na pytanie „skąd pochodzi ta liczba?” bez konieczności prowadzenia dochodzenia w sześciu różnych narzędziach. Lista kontrolna niezawodności danych dla zespołów ds. danych pomoże przekształcić te pytania w formalną ocenę.
digna dostarcza korporacyjną platformę jakości i observability danych, która działa bezpośrednio w środowisku klienta, oferując wbudowane kontrole bazy danych pod kątem anomalii, terminowości (timeliness), walidacji i zmian schematów w hurtowniach, jeziorach danych oraz potokach. Odwiedź digna, aby zobaczyć, jak jej modułowe podejście do monitorowania może wpasować się w nadzorowaną platformę danych.
Najczęściej zadawane pytania
Czym jest platforma danych?
To zintegrowany zestaw narzędzi i infrastruktury, którego organizacja używa do pobierania, składowania, przetwarzania, nadzorowania i udostępniania danych na potrzeby analityki i AI. Ważny wniosek: platforma danych nie musi być jednym produktem i nie jest wyłącznie bazą danych.
Jakie są warstwy podstawowe?
Pobieranie, składowanie, obliczenia, governance i observability, które odwzorowują restaurację: pobieranie to rampa dostawcza, składowanie to spiżarnia i chłodnia, a obliczenia to kuchnia. Każda warstwa niesie własne konsekwencje dla kosztów, szybkości dostępu, retencji i nadzoru.
Jakie pięć pytań pokazuje, czy ją masz?
Czy dane mogą docierać niezawodnie? Gdzie mieszkają? Jak są przygotowywane? Co znaczą i kto może z nich korzystać? Skąd zespoły wiedzą, że system jest zdrowy? Stos, który nie odpowiada na dwa ostatnie pytania, jest zbiorem narzędzi, a nie platformą.
Czym różni się od bazy danych?
Baza danych może składować dane, nie zarządzając ich pełnym cyklem życia. Wytyczne architektury korporacyjnej opisują platformę jako oprogramowanie pomagające składować, udostępniać, zarządzać i nadzorować dane firmowe zarówno w warstwie danych, jak i w warstwie kontroli, czego sama baza nie zapewnia.
Jak duży jest rynek platform danych?
Oszacowano go na 82,4 mld USD w 2024 r. i prognozuje się przekroczenie 210 mld USD do 2031 r., przy złożonej rocznej stopie wzrostu 14,5 % w tym okresie. Wzrost odzwierciedla konsolidację osobnych narzędzi w nadzorowane platformy, a nie po prostu więcej składowania.


