Bogaci w dane, ubodzy w informacje: praktyczny przewodnik
|
7
min. czyt.

Możesz siedzieć na poniedziałkowym przeglądzie z przejrzystym pulpitem na ekranie i nadal nie wiedzieć, czy liczba się zmieniła, bo kampania zadziałała, bo zepsuła się tabela źródłowa, czy dlatego, że ktoś w zeszłym tygodniu zmienił definicję. Wykresy wyglądają dopracowanie. A spotkanie i tak kończy się tym samym niepokojącym pytaniem: czemu możemy ufać?
Ta luka to stan, w którym organizacja jest bogata w dane, ale uboga w informacje (data rich, information poor). Pojawia się, gdy zespoły gromadzą mnóstwo wierszy, zdarzeń i logów, ale nadal nie potrafią wystarczająco szybko przekształcić ich w informacje gotowe do podejmowania decyzji. Problemem nie jest tylko wolumen. Chodzi o czas i zaufanie potrzebne do przekształcenia surowych sygnałów w coś, na podstawie czego menedżer może działać, nie kwestionując źródła.
Spis treści
Pułapka pulpitów i problem DRIP
Pulpit przychodów może wyglądać zdrowo, a mimo to nie przejść jedynego testu, który ma znaczenie: czy zespół potrafi wyjaśnić, dlaczego zmienił się lejek sprzedażowy? Marketing twierdzi, że popyt napędziła kampania, sprzedaż mówi, że zmienił się mix leadów, finanse widzą liczbę, która nie zgadza się z prognozą z zeszłego tygodnia, a analityk zostaje z zadaniem zszywania tabel z hurtowni, eksportów z aplikacji SaaS i ręcznych korekt w arkuszach kalkulacyjnych. To jest pułapka pulpitów: dużo prezentacji, za mało decyzji.
DRIP oznacza data rich, information poor, czyli bogactwo danych przy ubóstwie informacji. Określenie to opisuje pogłębiającą się lukę między ilością danych, które firma gromadzi, a ilością informacji gotowych do podejmowania decyzji, którym może ufać. Surowe dane to wiersz w tabeli, zdarzenie w strumieniu lub wiersz logu w pliku. Informacja to ten sam sygnał, gdy ma już kontekst, aktualność, właściciela i wystarczające wyjaśnienie, by wspierać działanie.
To rozróżnienie ma znaczenie, ponieważ zespoły często traktują więcej danych jako odpowiedź na brak wniosków. W praktyce może to jeszcze poszerzyć lukę. Więcej tabel oznacza więcej złączeń, więcej narzędzi oznacza więcej przekazań, a więcej przekazań oznacza więcej okazji, by ktoś zadał pytanie, na które nikt nie potrafi pewnie odpowiedzieć. Jeśli chcesz praktycznie zobaczyć, jak pulpity wpisują się w ten problem, wewnętrzny przewodnik po pulpitach jakości danych pokazuje, dlaczego powierzchowna widoczność często nie przekłada się na rzeczywistą kontrolę.
Praktyczna zasada: jeśli wyjaśnienie metryki wymaga spotkania, nie jest ona jeszcze informacją.
Właściwym modelem myślowym jest opóźnienie, a nie wolumen. Firma może dysponować mnóstwem danych, a mimo to wolno podejmować decyzje, ponieważ dane docierają z opóźnieniem, nie mają kontekstu lub nie zostały sprawdzone pod kątem reguł biznesowych, które czynią je wiarygodnymi. Dlatego DRIP dotyczy nie tyle przechowywania, ile drogi od sygnału do działania.
Skąd pochodzi to określenie i dlaczego wciąż jest aktualne
Określenie „bogaci w dane, ubodzy w informacje” funkcjonuje od dziesięcioleci, ponieważ ten tryb awarii wciąż powraca w nowej odsłonie. Spopularyzowała je wydana w 1983 roku książka biznesowa In Search of Excellence, w której opisano prosty problem zarządczy: organizacje mogą gromadzić dane, nie przekształcając ich w użyteczne informacje. Późniejsze komentarze do tej idei powiązały ją z szacunkiem z 2010 roku, według którego gospodarka USA traciła 997 mld USD rocznie z powodu przeciążenia informacyjnego, przyjmując za podstawę tego szacunku 78,6 mln pełnoetatowych pracowników umysłowych – dlatego to określenie wciąż trafia do sal zarządów i zespołów analitycznych (historyczny przegląd określenia i szacunku z 2010 roku).
Dlaczego to sformułowanie przetrwało każdy cykl narzędziowy
To sformułowanie przetrwało erę BI, big data, a teraz AI, ponieważ narzędzia zmieniały się szybciej niż leżący u podstaw problem. Hurtownia może scentralizować dane, pulpit może je podsumować, a model może je ocenić, ale żaden z tych kroków nie gwarantuje, że wynik będzie aktualny, wytłumaczalny lub na tyle wiarygodny, by na jego podstawie działać. Dlatego to określenie wciąż jest na miejscu w każdej poważnej dyskusji o analityce w 2025 roku, zwłaszcza gdy zespoły dodają systemy szybciej, niż usprawniają ścieżkę podejmowania decyzji.
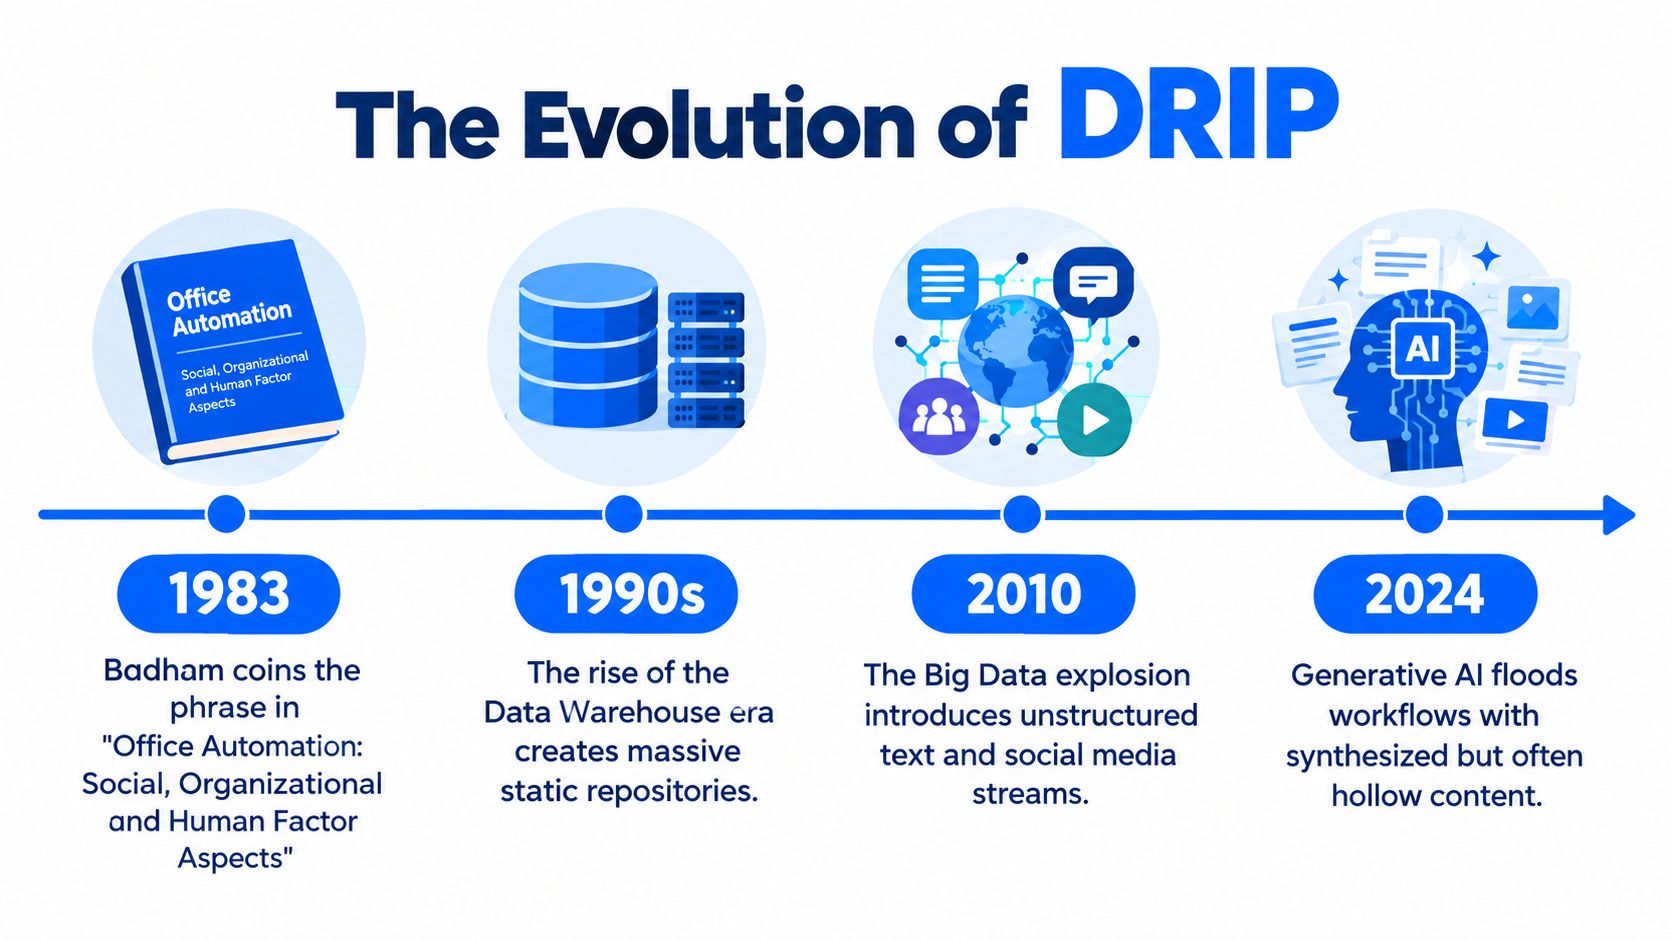
To określenie przetrwało, ponieważ objaw wciąż zmienia formę, a nie dlatego, że diagnoza jest nieaktualna.
Współczesnym zwrotem akcji jest AI. Narzędzia generatywne mogą tworzyć więcej podsumowań, więcej prognoz i więcej tekstu, ale jeśli dane bazowe są nieaktualne lub niewiarygodne, wynik nadal jest pusty. DRIP pozostaje trafnym skrótem, ponieważ wskazuje na rzeczywistą awarię: informacje nie docierają w formie, z której ludzie mogą bezpiecznie korzystać.
Co powoduje lukę między danymi a informacjami
Najczęstszą przyczyną jest fragmentacja. Pojedyncze pytanie biznesowe często zależy od danych rozproszonych po hurtowniach, aplikacjach SaaS, magazynach operacyjnych i arkuszach kalkulacyjnych, co oznacza, że odpowiedź musi przekroczyć wiele granic odpowiedzialności, zanim ktokolwiek będzie mógł jej zaufać. W takiej sytuacji opóźnienie ma charakter nie tylko techniczny, ale i interpretacyjny, ponieważ każde przekazanie to kolejna szansa na rozbieżność definicji.
Cztery przyczyny strukturalne występujące w rzeczywistych zespołach
Luka wynika zwykle z połączenia fragmentacji, rozrostu narzędzi, przeciążenia i opóźnień. Pomocnym sposobem przeglądu problemu jest zestawienie przyczyny strukturalnej z objawem, który ona wywołuje.
Przyczyna | Typowa skala w 2025 roku | Objaw operacyjny |
|---|---|---|
Fragmentacja danych | Wiele systemów, z których każdy zawiera część odpowiedzi | Zespoły spierają się, która tabela jest wiarygodna |
Rozrost narzędzi | Wiele równoległych narzędzi do analityki i obserwowalności | Brak wspólnego widoku jakości, aktualności i pochodzenia danych |
Przeciążenie informacyjne | Zbyt wiele pulpitów i metryk konkurujących o uwagę | Spotkania wypełniają się liczbami, ale nie zapada żadna decyzja |
Opóźnienie przetwarzania | Dane docierają po zamknięciu okna decyzyjnego | Liderzy działają na nieaktualnych liczbach lub czekają na ręczne odświeżenie |
Problem przeciążenia nie jest abstrakcyjny. Współczesne raporty dotyczące miejsc pracy wskazują, że pracownicy umysłowi są nieustannie rozpraszani, a wiele zespołów spędza czas na przeszukiwaniu aplikacji zamiast na działaniu na podstawie wyników (podsumowanie dotyczące przeciążenia w pracy). Innymi słowy, firma nie ma po prostu więcej danych – ma więcej tarcia między pytaniem a odpowiedzią.
Przydatną lekturą pokrewną jest analiza na blogu Artul.ai dotycząca tego, dlaczego podsumowania konferencji wynikowych zawodzą, ponieważ pokazuje ten sam wzorzec w innym kontekście: surowy materiał istnieje, ale użyteczna narracja nie wyłania się w przejrzysty sposób.
Dlaczego opóźnienie ma większe znaczenie niż wolumen danych
W wielu środowiskach nadal dominują potoki wsadowe, więc decyzja często zapada, zanim dotrą najświeższe dane. Powoduje to rozbieżność czasową. Menedżer widzi KPI, zakłada, że odzwierciedla ono teraźniejszość, i podejmuje decyzję na podstawie danych, które mogą być już nieaktualne. Problemem nie jest to, że firmie brakuje sygnałów. Chodzi o to, że sygnał dociera do decyzji zbyt późno i bez kontekstu potrzebnego do jego interpretacji.
Jeśli chcesz zmniejszyć tę lukę, przydatną perspektywę daje wewnętrzny przegląd rozproszonych źródeł danych, ponieważ ułatwia dostrzeżenie kosztów rozproszonych danych wejściowych.
Rzeczywisty koszt biznesowy bycia bogatym w dane i ubogim w informacje
Niska jakość danych nie tylko irytuje analityków. Tworzy drabinę kosztów, która staje się coraz bardziej stroma za każdym razem, gdy błędne dane przemieszczają się dalej. Często cytowany szacunek branżowy mówi, że niska jakość danych kosztuje organizacje średnio 12,9 mln USD rocznie, a przytoczone w tym samym źródle badanie D&B opisuje eskalację 1 USD, 10 USD, 100 USD, w której zapobieganie kosztuje około 1 USD za rekord, identyfikacja i rozwiązanie problemu około 10 USD za rekord, a korekta błędu po zdarzeniu około 100 USD za rekord (eskalacja kosztów i wpływ na przedsiębiorstwo).
Koszt zaczyna się od niewielkich kwot, a potem szybko rośnie
Ta eskalacja wyjaśnia, dlaczego późne wykrycie jest tak bolesne. Błędna wartość wychwycona podczas walidacji jest tania. Ta sama błędna wartość użyta w pulpicie jest droższa. Gdy trafi do silnika cenowego, raportu regulacyjnego lub procesu obsługi klienta, rachunek za naprawę gwałtownie rośnie, ponieważ trzeba prześledzić problem, wyjaśnić jego wpływ na biznes i odwrócić decyzje podjęte na dalszych etapach.
Etap | Koszt na rekord | Typowy wyzwalacz | Przykład |
|---|---|---|---|
Zapobieganie | 1 USD | Walidacja, zanim błędne dane trafią do potoku | Reguła blokuje nieprawidłowy kod przy pozyskiwaniu danych |
Identyfikacja i naprawa | 10 USD | Analitycy wykrywają i naprawiają problem, gdy już się pojawi | Nieudane ładowanie zostaje powiązane z błędnie sformatowanym plikiem |
Korekta po wystąpieniu skutków | 100 USD | Błąd trafia do raportu, procesu lub procedury regulacyjnej | Błędna wartość zmienia decyzję cenową lub dotyczącą zgodności |
Tania naprawa to taka, której dokonuje się, zanim problem się rozprzestrzeni.
Ukrytym kosztem są utracone szanse. Jeśli zespół spędza dni na uzgadnianiu prawdy, traci okazję do działania, gdy rynek wciąż się zmienia. Sprzedawca detaliczny, którego silnik cenowy jest powiązany z tabelą kosztów sprzed sześciu miesięcy, może nie zauważyć błędu, dopóki marże nie zaczną dryfować lub konkurent nie wymusi reakcji. Wtedy szkodą nie jest już tylko błędna cena. Jest nią zaufanie do liczb, które traci zarząd.
Dlatego DRIP to podatek od opóźnień decyzyjnych. Płaci się go wolniejszymi reakcjami, większą ilością pracy uzgadniającej i większą liczbą spotkań poświęconych udowadnianiu, że dane są prawdziwe, zamiast decydowaniu, co robić dalej. Wewnętrzny materiał uzasadnienie biznesowe jakości danych ma tu znaczenie, ponieważ ekonomia poprawia się dopiero wtedy, gdy zespoły ograniczają rozprzestrzenianie się błędów, a nie tylko sprzątają po nich.
Jak zdiagnozować stan DRIP we własnej organizacji
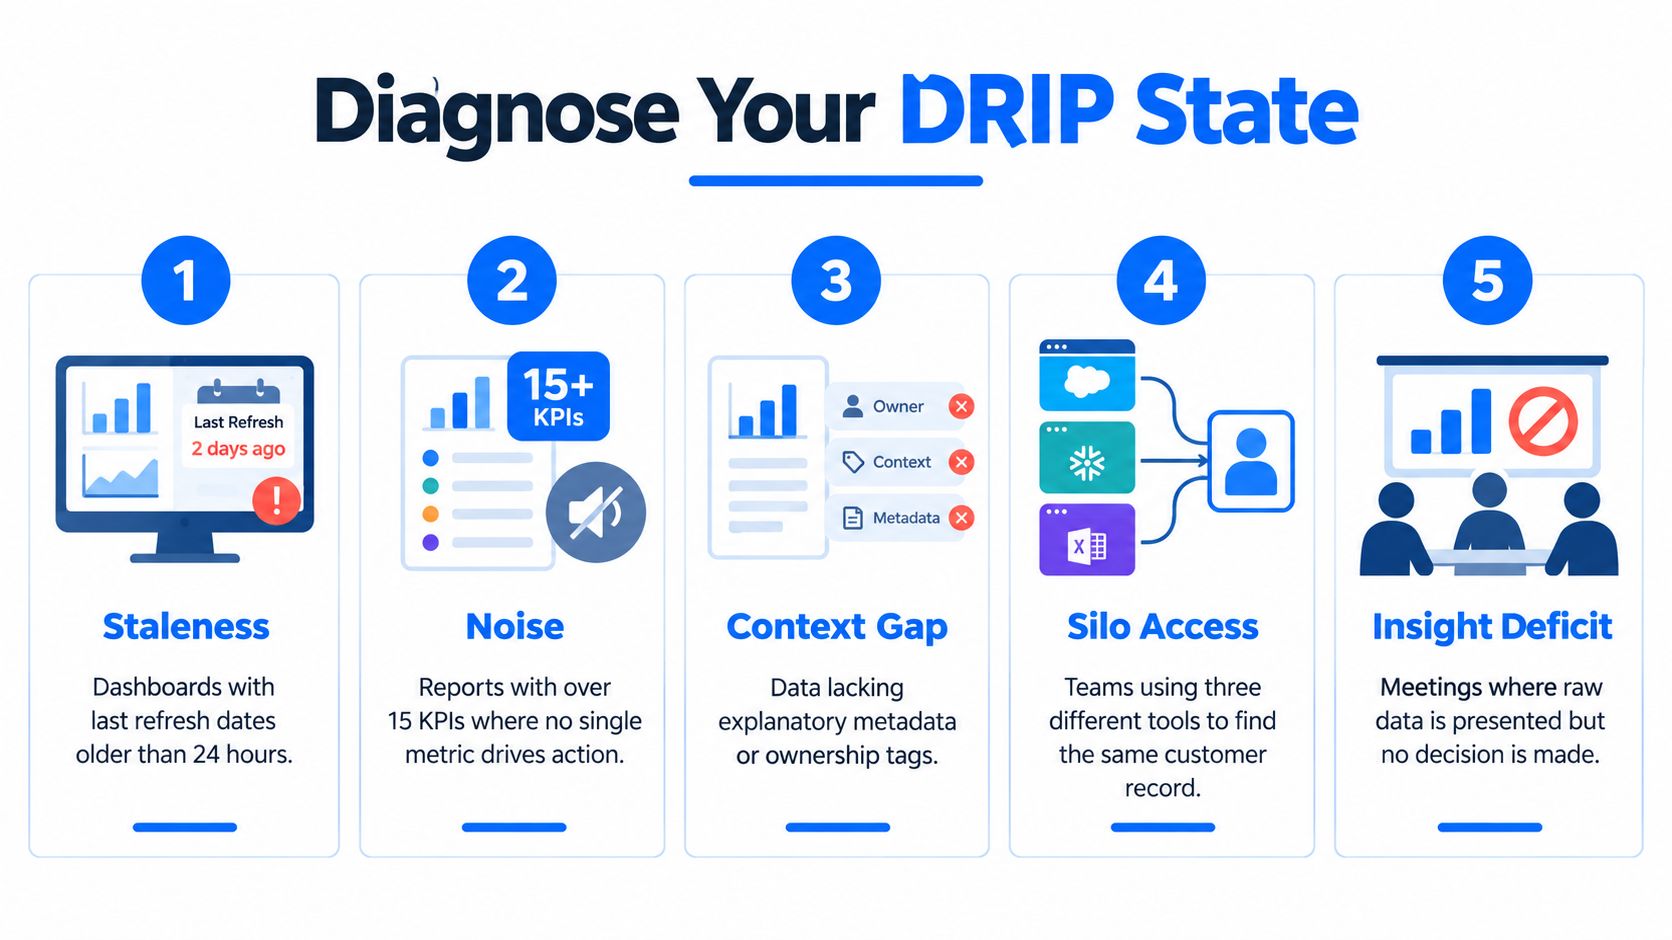
Nie potrzebujesz ankiety, by wiedzieć, czy Twój zespół znajduje się na terytorium DRIP. Musisz poszukać objawów, które pojawiają się w codziennej pracy. Najwyraźniejszym z nich jest nieaktualność, którą łatwo zauważyć, gdy odświeżenie pulpitu wykracza poza poziom usług i nikt tego nie zauważa albo znacznik czasu raportu nie zmienił się od tygodni. Jeśli liczba wygląda na aktualną, ale ładowanie za nią już nie, pulpit jest tylko dekoracją.
Pięć sygnałów, które zwykle występują razem
Nieaktualność: odświeżenie jest opóźnione, znacznik czasu się nie zmienił lub ostatnie uruchomienie nie zakończyło się na czas.
Ciche zmiany rozkładu: KPI zmienia kształt bez oczywistej przyczyny biznesowej.
Dryf schematu: tabela źródłowa dodaje, usuwa lub zmienia nazwy pól, a logika na dalszych etapach nadal działa.
Błędy dostarczania łatane ręcznie: ktoś ponownie ładuje plik, edytuje ekstrakt lub ponownie uruchamia zadanie bez usunięcia pierwotnej przyczyny.
Niewyjaśnione zmiany KPI: spotkania wciąż krążą wokół tej samej liczby, ponieważ nikt nie ufa jej wzrostowi lub spadkowi.
Najszybsze kontrole są zarazem najbardziej użyteczne. Kontrole aktualności mówią, czy dane dotarły w oczekiwanym czasie. Statystyczna ocena anomalii mówi, czy wzorzec zmienił się w sposób wymagający przeglądu przez człowieka. Porównywanie schematów pokazuje zmiany strukturalne, zanim zakłócą działanie odbiorców na dalszych etapach. Triaż oparty na pochodzeniu danych wskazuje, gdzie zaczęła się awaria, zamiast zmuszać zespoły do zgadywania. Wewnętrzny materiał o metrykach obserwowalności danych będzie dobrym uzupełnieniem, jeśli chcesz przypisać te kontrole do sygnałów operacyjnych.
Mały przykład z handlu detalicznego, który ujawnia ten wzorzec
Zespół analityczny w firmie detalicznej widzi spadek przychodów, opóźniony strumień danych do hurtowni i zmianę nazwy kolumny w tabeli produktów w systemie źródłowym. Żaden z tych sygnałów sam w sobie nie dowodzi, że potok jest uszkodzony. Razem wskazują jednak na jedno nieudane zadanie ETL, którego nikt nie zgłosił, ponieważ raport nadal się wyświetlał, a błąd był ukryty za ręczną poprawką.
Jeśli spełnione są więcej niż dwa z tych pięciu sygnałów, jesteś już na terytorium DRIP. Na tym etapie problemem nie jest to, czy dane istnieją. Problemem jest to, czy organizacja potrafi zaufać im wystarczająco szybko, by działać.
Pięć kontroli operacyjnych, które zamykają lukę
Pulpit może wyglądać zdrowo, podczas gdy potok, na którym się opiera, już dryfuje. Kontrole to właśnie to, co wychwytuje ten dryf, zanim ludzie zaczną się spierać, która liczba jest prawdziwa. Każda z nich obejmuje inny tryb awarii. Ład danych wyjaśnia odpowiedzialność i pochodzenie danych. Obserwowalność ujawnia nieoczekiwane zachowania. Terminowość utrzymuje opóźnienia w polu widzenia. Walidacja blokuje błędne rekordy, zanim się rozprzestrzenią. Śledzenie schematu wychwytuje zmiany strukturalne, zanim systemy na dalszych etapach błędnie odczytają dane.
Kontrola | Rozwiązywany objaw DRIP | Minimalne wdrożenie | Skutek pominięcia |
|---|---|---|---|
Ład danych | Niejasności co do odpowiedzialności i pochodzenia danych | Przypisanie właścicieli, zdefiniowanie krytycznych elementów danych, utrzymywanie informacji o pochodzeniu danych | Teatr papierologii bez odpowiedzialności operacyjnej |
Obserwowalność | Ciche anomalie i brakujące ładowania | Ciągłe kontrole anomalii i aktualności w krytycznych tabelach | Zespoły zauważają problemy dopiero wtedy, gdy pulpity zaczynają pokazywać błędne dane |
Terminowość | Nieaktualne wyniki | Ustalenie SLA aktualności dla kluczowych potoków i alertów o przekroczonych oknach czasowych | Dokładne dane nadal docierają zbyt późno, by miały znaczenie |
Walidacja | Rozprzestrzenianie się błędnych rekordów na dalsze etapy | Kontrole reguł biznesowych przy pozyskiwaniu danych i przed transformacją | Błędy przenikają do raportowania, procesów zgodności i danych wejściowych AI |
Śledzenie schematu | Dryf strukturalny | Porównywanie przychodzącego schematu z oczekiwaną strukturą przy każdym ładowaniu | Zadania na dalszych etapach po cichu zawodzą lub błędnie odczytują dane |
Kontrole działają razem, a nie stopniowo
Ład danych bez obserwowalności zamienia się w papierologię procesową. Obserwowalność bez walidacji wykrywa objaw, a mimo to przepuszcza błędne dane. Walidacja bez terminowości daje czyste dane, które docierają po zamknięciu okna decyzyjnego. Śledzenie schematu bez przypisanej odpowiedzialności generuje alert, ale nikt nie jest wyraźnie odpowiedzialny za naprawę.
Dlatego zespoły potrzebują zestawu kontroli, a nie pojedynczej poprawki. Jednym z praktycznych wzorców jest digna, która uruchamia kontrole jakości danych i obserwowalności w środowisku klienta, obejmując anomalie, terminowość, walidację, śledzenie schematu i monitorowanie biznesowe.
Celem jest skrócenie czasu między zmianą w danych a bezpieczną decyzją o tym, co robić dalej. Powolny potok, ukryta zmiana schematu lub nieudane ładowanie powinny ujawniać się jako problem z zaufaniem, a nie jako niespodzianka podczas cotygodniowego przeglądu. Gdy te kontrole działają razem, pulpit przestaje być dzwonkiem alarmowym, a zaczyna pełnić funkcję płaszczyzny zaufania dla biznesu.
Od fabryk reguł do obserwowalności opartej na AI w praktyce
Międzynarodowy producent może spędzać piątki na ręcznym pisaniu kontroli progowych dla strumieni danych z czujników, a w poniedziałek odkryć, że reguły już się zdezaktualizowały. Ten model nie skaluje się, gdy środowisko obejmuje miliony sygnałów, zwłaszcza że według niedawnych komentarzy branżowych do podejmowania decyzji wykorzystuje się mniej niż 1% codziennych danych fabrycznych (DRIP w produkcji i problem kontekstu). Ręczne fabryki reguł zamieniają inżynierów w personel utrzymaniowy, a i tak przeoczają momenty, które mają znaczenie.
Co się zmienia, gdy obserwowalność uczy się linii bazowej
Obserwowalność oparta na AI zastępuje sztywne progi wyuczonymi liniami bazowymi, dzięki czemu monitor może zasygnalizować nową awarię, gdy zachowanie kardynalności, aktualności lub schematu wykracza poza normalne wzorce. Ma to znaczenie, gdy awaria jest nowa. Reguła napisana dla potoku z zeszłego miesiąca nie wychwyci nowego układu pól ani nieoczekiwanego wzorca opóźnień, ale adaptacyjny monitor nadal może zwrócić na to uwagę, co opisano w przewodniku o tym, jak AI wykrywa anomalie danych w potokach danych.
Przydatne zestawienie wygląda następująco:
Możliwość | Fabryka reguł | Obserwowalność oparta na AI |
|---|---|---|
Konfiguracja progów | Ręcznie tworzone przez inżynierów | Uczy się normalnego zachowania na podstawie danych |
Wykrywanie zmian | Wychwytuje tylko znane tryby awarii | Sygnalizuje nowe zmiany wolumenu, aktualności lub schematu |
Nakład na utrzymanie | Wysoki, ponieważ reguły szybko się starzeją | Niższy, ponieważ linie bazowe aktualizują się wraz ze zbiorem danych |
Jakość alertów | Często hałaśliwe lub zawodne | Bardziej skoncentrowane na istotnych odchyleniach |
Wykorzystanie przez zespoły | Scentralizowane w zespole inżynierów | Na tyle modułowe, że mogą z niego korzystać zespoły domenowe |
Ten kompromis jest realny. AI ogranicza zmęczenie alertami i wychwytuje nieznane wzorce, ale nadal wymaga nadzoru. Linie bazowe mogą dryfować, modele mogą się starzeć, a nawet inteligentny system wciąż potrzebuje ludzi, którzy przeanalizują wyjątki, potwierdzą pierwotną przyczynę i przekażą wynik z powrotem do procesów ładu danych. Ta pętla informacji zwrotnej ma większe znaczenie niż sam alert.
Lepsza automatyzacja nie usuwa odpowiedzialności – sprawia, że pojawia się ona wcześniej.
Najlepsze konfiguracje łączą wykrywanie oparte na modelach z oceną aktualności uwzględniającą pochodzenie danych oraz modułowymi monitorami, które zespoły domenowe mogą składać bez zgłaszania ticketu dla każdej nowej reguły. Jest to praktyczne przy dużej skali, ponieważ koszt ręcznego sprawdzania już przewyższył wartość ręcznej kontroli.
Pierwsze kroki w stronę bogactwa informacji
Dodanie kolejnego pulpitu zwykle pogłębia DRIP, jeśli za nowym wykresem nie stoi walidacja, pochodzenie danych ani kontrakt dotyczący aktualności. Każdy dodatkowy widok może stać się kolejnym miejscem sporu o liczbę, a nie kolejnym sposobem, by jej zaufać. Pierwszym krokiem nie jest raportowanie większej ilości danych, lecz skrócenie pętli informacji zwrotnej.
Praktyczny plan na 90 dni
Wskaż właścicieli: przypisz konkretną osobę jako właściciela każdego krytycznego zbioru danych i każdego biznesowego KPI.
Spisz kontrakt: zdefiniuj, co oznacza „dobre” dla kluczowych tabel, w tym aktualność i akceptowane wartości.
Oprzyrząduj potok o najwyższym ryzyku: dodaj wykrywanie anomalii i kontrole aktualności do najważniejszego strumienia danych dotyczących przychodów lub operacji.
Dodaj walidację na wejściu: sprawdzaj rekordy w CI lub przy pozyskiwaniu danych, zanim błędne wartości się rozprzestrzenią.
Śledź zmiany schematu: generuj alerty o nowych, brakujących lub przemianowanych polach, zanim odbiorcy przestaną działać.
Wybierz jeden kompleksowy KPI: prześledź go od źródła do pulpitu, tak aby każdy krok był widoczny.
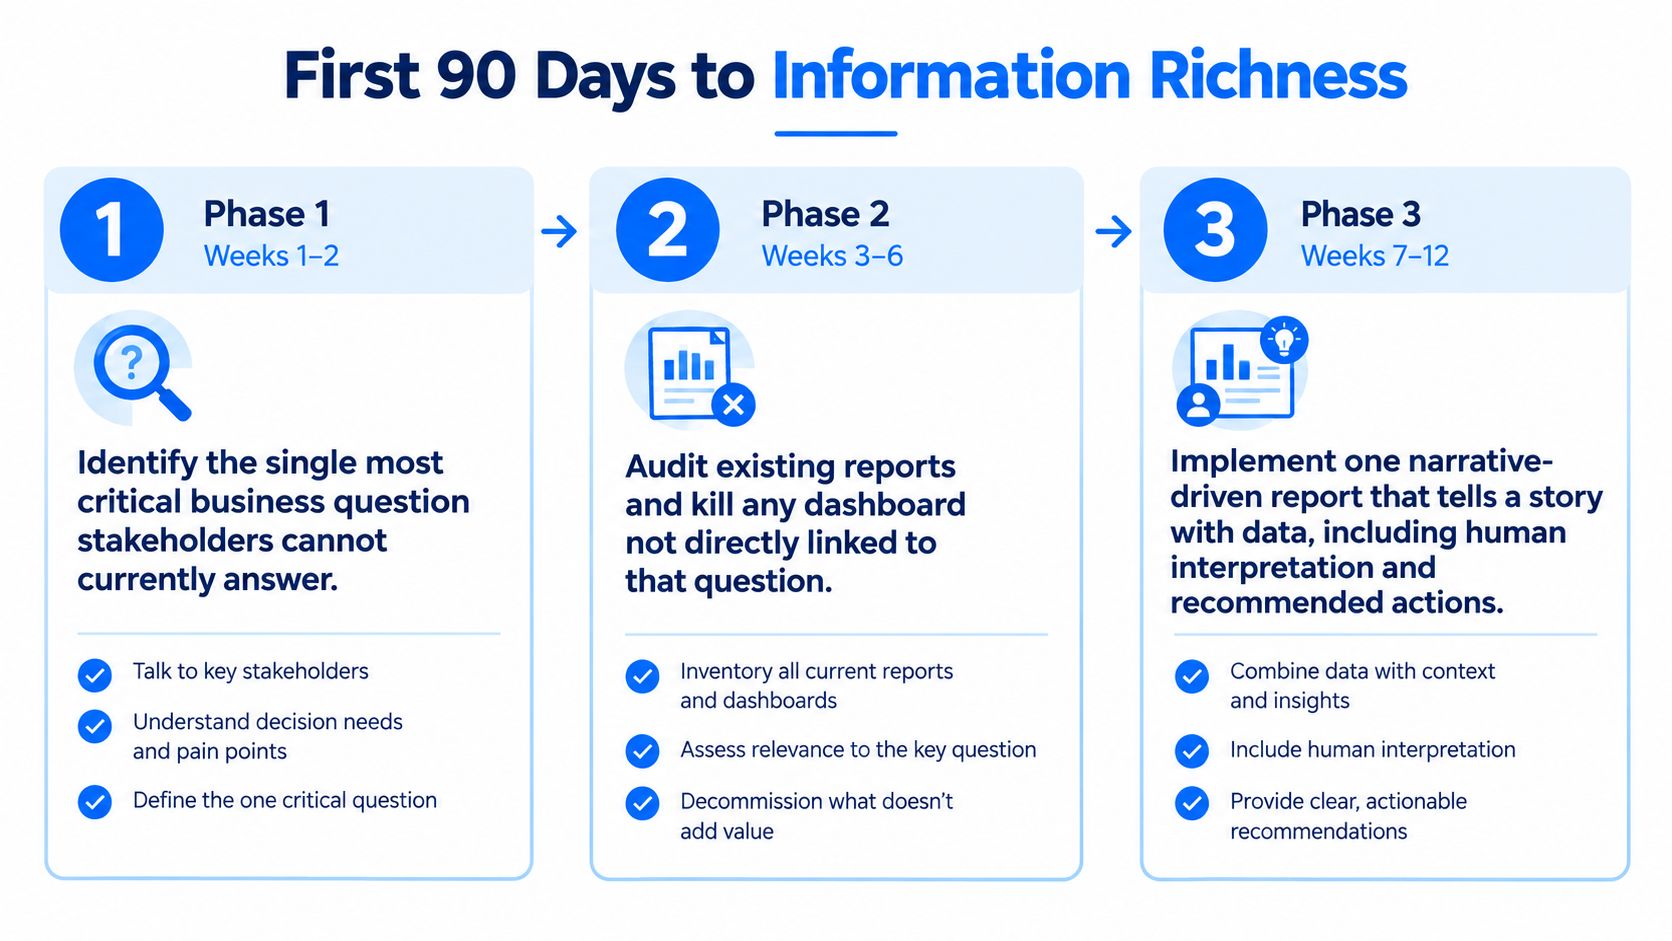
Najłatwiej zacząć od jednej cotygodniowej decyzji, którą zespół już podejmuje. Oprzyrząduj dane, na których się ona opiera, tak aby odpowiedź dało się obronić bez gorączkowego szukania. Jeśli zespół potrafi wyjaśnić liczbę, zaufać jej i podjąć na jej podstawie działania podczas tego samego spotkania, wychodzisz z DRIP i zmierzasz w stronę bogactwa informacji.
Jeśli próbujesz przekształcić dane w coś, czemu biznes może zaufać, digna daje Ci do tego potrzebne kontrole: wykrywanie anomalii, monitorowanie terminowości, walidację, śledzenie schematu i monitorowanie biznesowe we własnym środowisku. Odwiedź digna, aby zobaczyć, jak te kontrole mogą pomóc zamknąć lukę między surowymi danymi a kolejną decyzją.
Aby okna aktualności i pominięte ładowania były widoczne, zanim nieaktualny KPI trafi na cotygodniowy przegląd, zobacz, jak digna Timeliness uczy się, kiedy należy oczekiwać dostarczenia każdego zbioru danych.
Najczęściej zadawane pytania
Co oznacza określenie „bogaci w dane, ubodzy w informacje”?
Bogactwo danych przy ubóstwie informacji, czyli DRIP (data rich, information poor), opisuje lukę między ilością danych, które firma gromadzi, a ilością informacji gotowych do podejmowania decyzji, którym może ufać. Surowe dane to wiersz, zdarzenie lub wiersz logu; informacja to ten sam sygnał wraz z kontekstem, aktualnością, właścicielem i wyjaśnieniem wystarczającym do podjęcia działania.
Skąd pochodzi określenie „bogaci w dane, ubodzy w informacje”?
Spopularyzowała je wydana w 1983 roku książka biznesowa In Search of Excellence. Późniejsze komentarze powiązały je z szacunkiem z 2010 roku, według którego przeciążenie informacyjne kosztowało gospodarkę USA 997 mld USD rocznie, przy założeniu 78,6 mln pełnoetatowych pracowników umysłowych – dlatego to określenie wciąż przemawia do zespołów analitycznych.
Co sprawia, że organizacje są bogate w dane, ale ubogie w informacje?
Zwykle łączą się cztery przyczyny strukturalne: fragmentacja danych między hurtowniami, aplikacjami SaaS i arkuszami kalkulacyjnymi; rozrost narzędzi bez wspólnego widoku jakości i pochodzenia danych; przeciążenie informacyjne wynikające z nadmiaru pulpitów; oraz opóźnienie przetwarzania, gdy potoki wsadowe dostarczają dane po zamknięciu okna decyzyjnego.
Ile kosztuje firmę niska jakość danych?
Według często cytowanego szacunku średni koszt wynosi 12,9 mln USD rocznie. Koszt rośnie też z czasem: zapobieżenie błędowi to około 1 USD za rekord, jego identyfikacja i naprawa – 10 USD, a korekta po tym, jak trafi do raportu, silnika cenowego lub procesu zgodności – 100 USD.
Jak sprawdzić, czy mój zespół jest bogaty w dane, ale ubogi w informacje?
Zwróć uwagę na pięć sygnałów: nieaktualne pulpity, ciche zmiany rozkładu, dryf schematu, błędy dostarczania łatane ręcznie oraz zmiany KPI, których nikt nie potrafi wyjaśnić. Zgodnie z zasadą z artykułu, jeśli spełnione są więcej niż dwa z nich, Twój zespół jest już na terytorium DRIP i nie potrafi wystarczająco szybko zaufać swoim danym.



