Audyt jakości danych: jak przeprowadzić go rzetelnie
|
9
min. czyt.

O audyt danych zwykle nie prosi się wtedy, gdy jest spokojnie.
Zaczyna się, gdy pulpit przestaje zgadzać się z finansami, regulator pyta, jak powstała dana liczba, albo model zaczyna dziwnie się zachowywać po nieudokumentowanej zmianie w systemie źródłowym. Wtedy zespoły odkrywają, że robiły wyrywkowe sprawdzenia, a nie audyt jakości danych. Mogą powiedzieć, że tabela „wyglądała w zeszłym tygodniu dobrze”, ale nie pokażą, jakie przyjęto kryteria, jakie zebrano dowody, kto sprawdził wynik ani czy ta sama kontrola dałaby za miesiąc ten sam wniosek.
Ta luka waży więcej, niż wielu się spodziewa. Jednorazowe zapytanie może wykryć usterkę. Audyt musi się obronić, gdy ktoś poprosi o dowód.
Spis treści
Dlaczego audyt jakości danych liczy się, zanim sprawdzisz choć jeden rekord
Czego zespoły naprawdę potrzebują od audytu
Co daje pełny audyt
Zakres audytu i inwentaryzacja tego, co faktycznie trzeba sprawdzić
Zacznij od przydatności do użycia
Buduj inwentarz wstecz, od wyniku
Wyznacz granice, zanim ktokolwiek zacznie testować
Dokumentuj pochodzenie danych, póki system jest świeży w pamięci ludzi
Dobór właściwych kontroli i decyzja, jak je testować
Zacznij od wymiarów, a potem zamień je w kontrole
Próbkowanie, pełne skany i ciągłe monitorowanie — każde ma swoje miejsce
Przetestuj kontrole pilotażowo, zanim uznasz je za dowód
Przeprowadzenie audytu i zebranie dowodów, które się obronią
Wykonuj jak najbliżej danych
Traktuj pochodzenie i śledzalność jako dowód, nie ozdobę
Zapisuj też zdarzenia bliskie awarii i zmiany w źródłach
Zamiana ustaleń w poprawki, z jasną odpowiedzialnością i śledzeniem
Raport musi zrobić więcej niż podsumować usterki
Przypisuj odpowiedzialność po punkcie kontrolnym, nie po winie
Śledź do zamknięcia przez weryfikację, nie sam status
Uczynić audyty powtarzalnymi i gotowymi na ciągłe monitorowanie
Trzymaj cykl audytu krótki i bogaty w dowody
Pilnuj trybów awarii, które audyty wykrywają raz za razem
Skaluj przez standaryzację modelu kontroli
Dlaczego audyt jakości danych liczy się, zanim sprawdzisz choć jeden rekord
Moment presji jest znajomy. Interesariusz chce wiedzieć, czy raport jest wiarygodny, a odruchem jest skok prosto w liczniki wierszy, kontrole wartości pustych i duplikaty. To przydatne, ale to jeszcze nie audyt. Jeśli najpierw nie zdefiniujesz kryteriów, zostaje techniczna krzątanina bez obronnego wniosku.
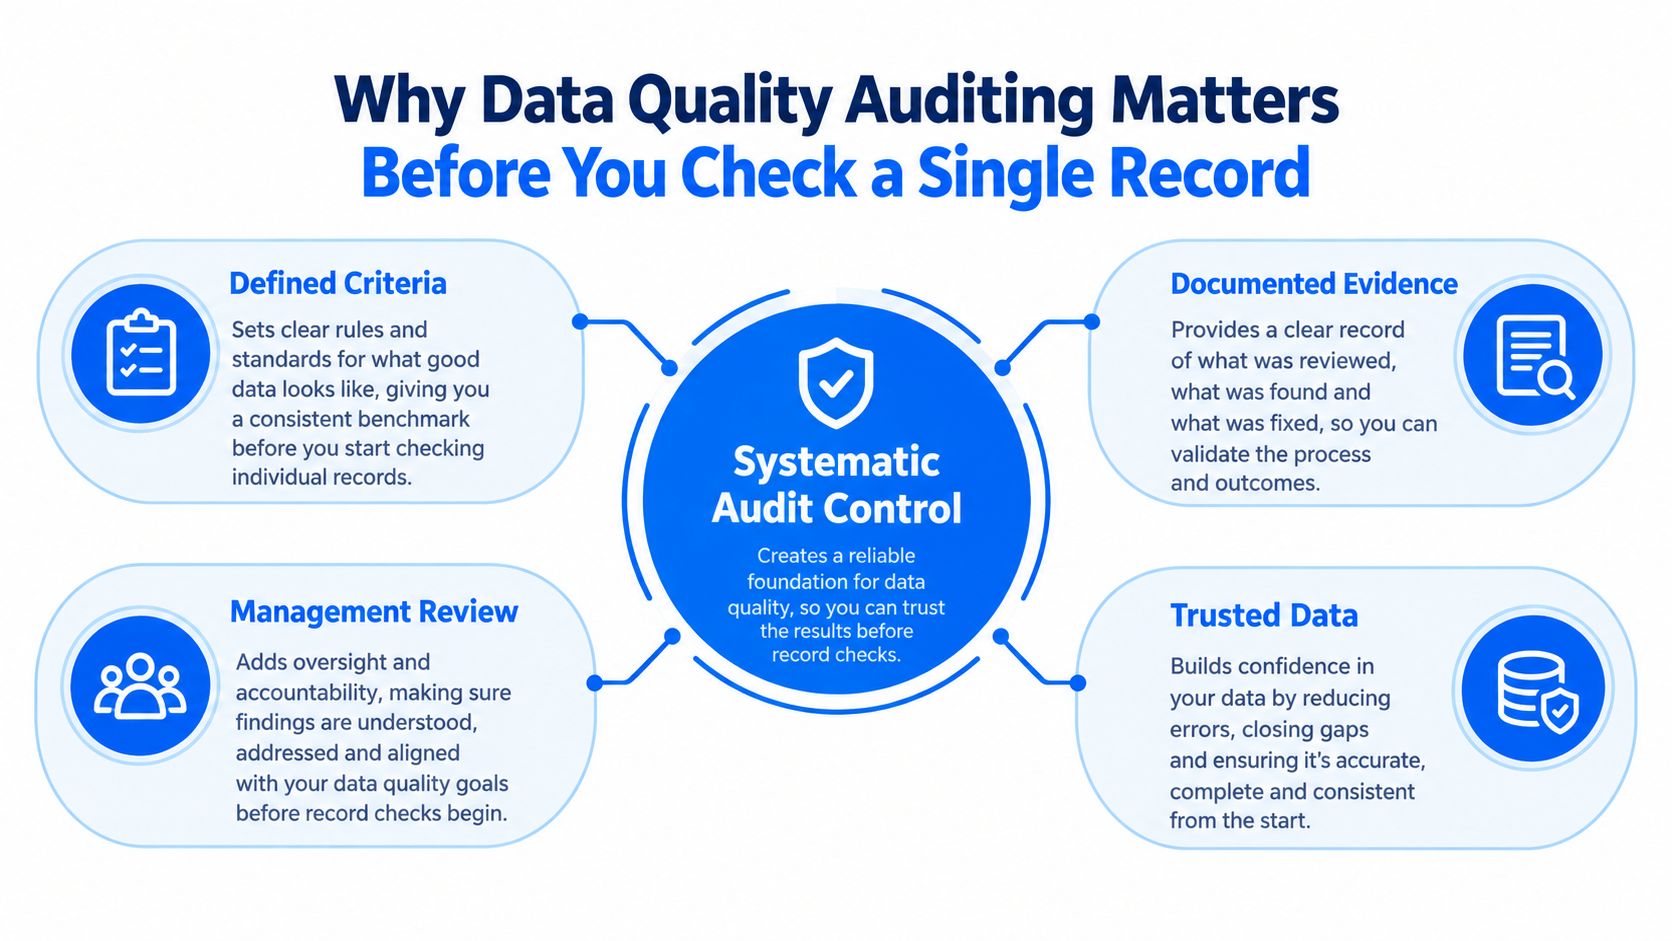
Istnieje dla tego trwały standard. ISO definiuje audyt jako „systematyczny, niezależny i udokumentowany proces” pozyskiwania dowodów i oceniania ich wobec kryteriów, co stanowi podstawę powtarzalnych audytów jakości danych w branżach i administracji, jak podsumowuje podręcznik ONZ i Eurostatu o metodach i narzędziach oceny jakości danych. Ta definicja jest praktyczniejsza, niż brzmi. Mówi, co prawdziwy audyt musi udowodnić:
Systematyczny znaczy, że kontrole nie są improwizowane.
Niezależny znaczy, że ustalenia przetrwają przegląd poza zespołem dostarczającym.
Udokumentowany znaczy, że ktoś inny może później obejrzeć dowody i dojść do tego samego wniosku.
Czego zespoły naprawdę potrzebują od audytu
W praktyce pierwszą wygraną jest wspólny język. Programy audytowe w sektorze publicznym zwykle porządkują ustalenia wokół dokładności, kompletności, spójności, Timeliness, poprawności i unikalności. Te wymiary nie są akademickie. Kończą zwykły spór, w którym inżynieria mówi „potok się udał”, finanse „raport jest zły”, a compliance „dane przyszły za późno”.
Zespół audytujący po wymiarach potrafi rozdzielić różne tryby awarii:
Dokładność pyta, czy wartość odzwierciedla rzecz.
Kompletność pyta, czy brakuje oczekiwanych rekordów lub pól.
Timeliness pyta, czy dane dotarły na czas dla decyzji.
Spójność pyta, czy ten sam fakt zgadza się między systemami.
Poprawność pyta, czy wartości odpowiadają regule i formatowi.
Unikalność pyta, czy jedna encja pojawia się raz, gdy powinna.
Jeśli twoja organizacja wciąż traktuje je jak abstrakcyjne etykiety jakości, pomaga powiązać je z tym, dlaczego jakość danych jest ważna dla organizacji. Każde pytanie zarządu o zaufanie ostatecznie ląduje na jednym z tych wymiarów.
Co daje pełny audyt
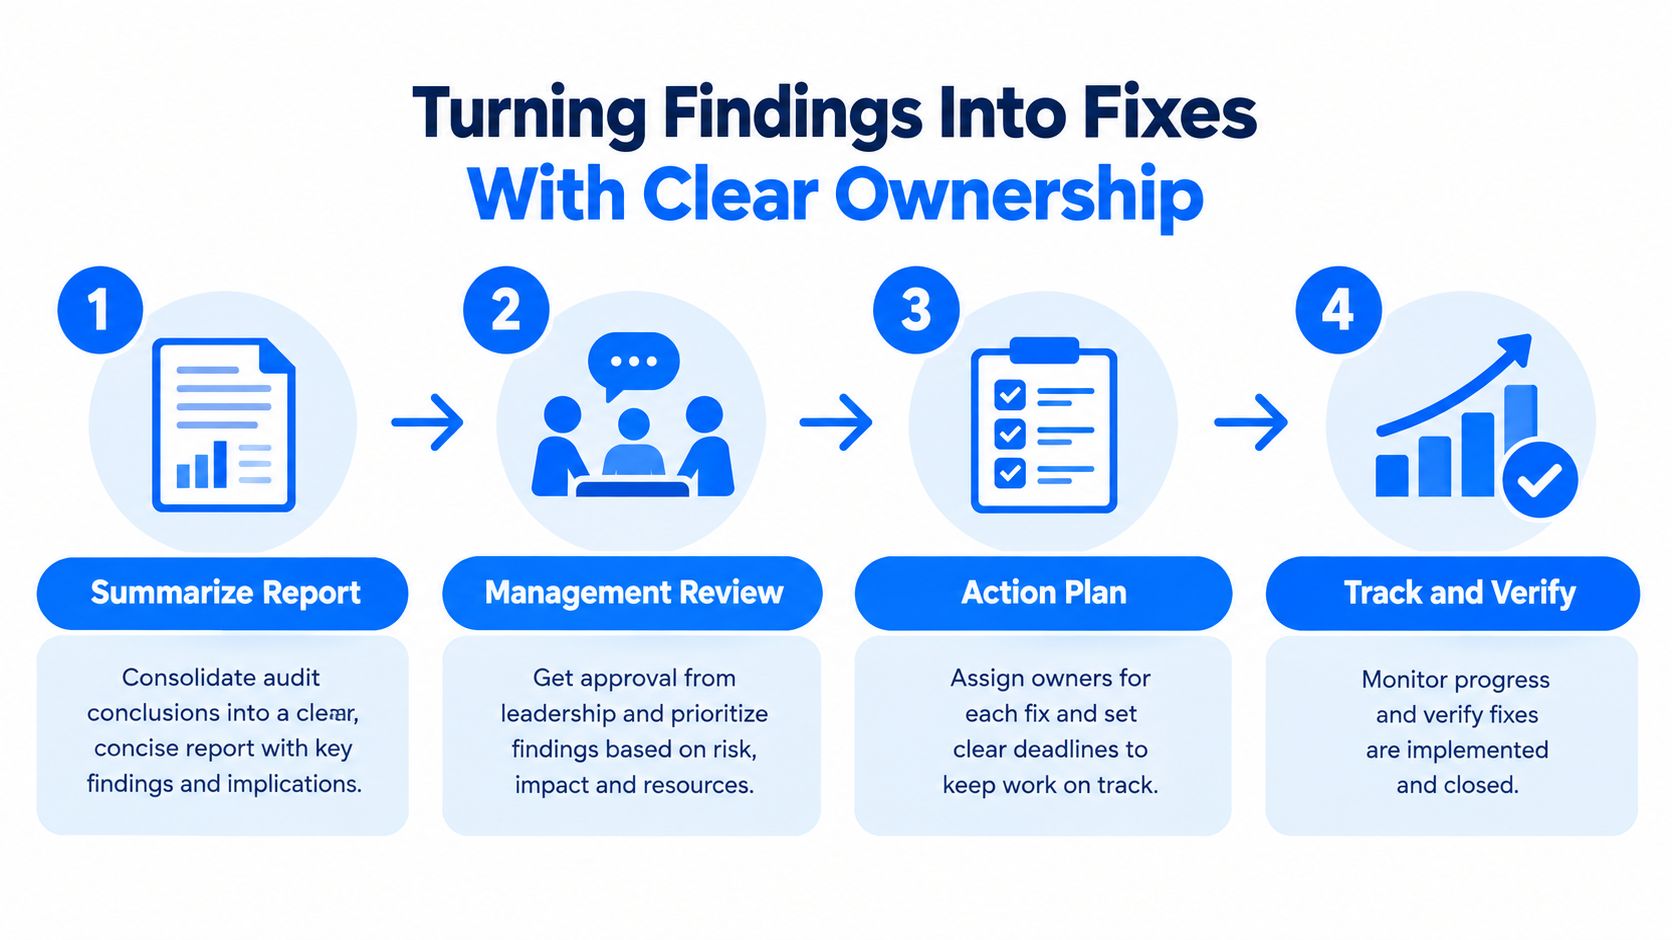
Pełny audyt nie kończy się na „znaleźliśmy złe wiersze”. Ten sam podręcznik ONZ i Eurostatu podkreśla, że wnioski audytu należy podsumować w raporcie, poddać przeglądowi zarządu i przekuć w plan działania. To właśnie ta pętla kontrolna bywa pomijana.
Reguła praktyczna: jeśli efektem pracy jest tylko arkusz z usterkami, przeprowadziłeś inspekcję. Jeśli efektem są dowody, wnioski, przegląd i działania korygujące, przeprowadziłeś audyt.
To rozróżnienie tłumaczy, dlaczego audyt jakości danych liczy się, zanim ktokolwiek sprawdzi choć jeden rekord. Ramy audytu określają, co liczy się jako dowód, co oznacza niepowodzenie, kto podpisuje i co dzieje się dalej. Bez nich nawet dobre kontrole techniczne nie dadzą wiarygodnych wyników.
Zakres audytu i inwentaryzacja tego, co faktycznie trzeba sprawdzić
Słaby audyt zwykle upada, zanim ruszą testy. Zakres jest mglisty, właściciele nieostrzy, a połowy danych z raportu nie ma nawet w inwentarzu. Zespoły tracą wtedy czas na walidację kolumn bez znaczenia, a umyka im dokładnie ta transformacja, która napędza decyzję ważną dla wszystkich.
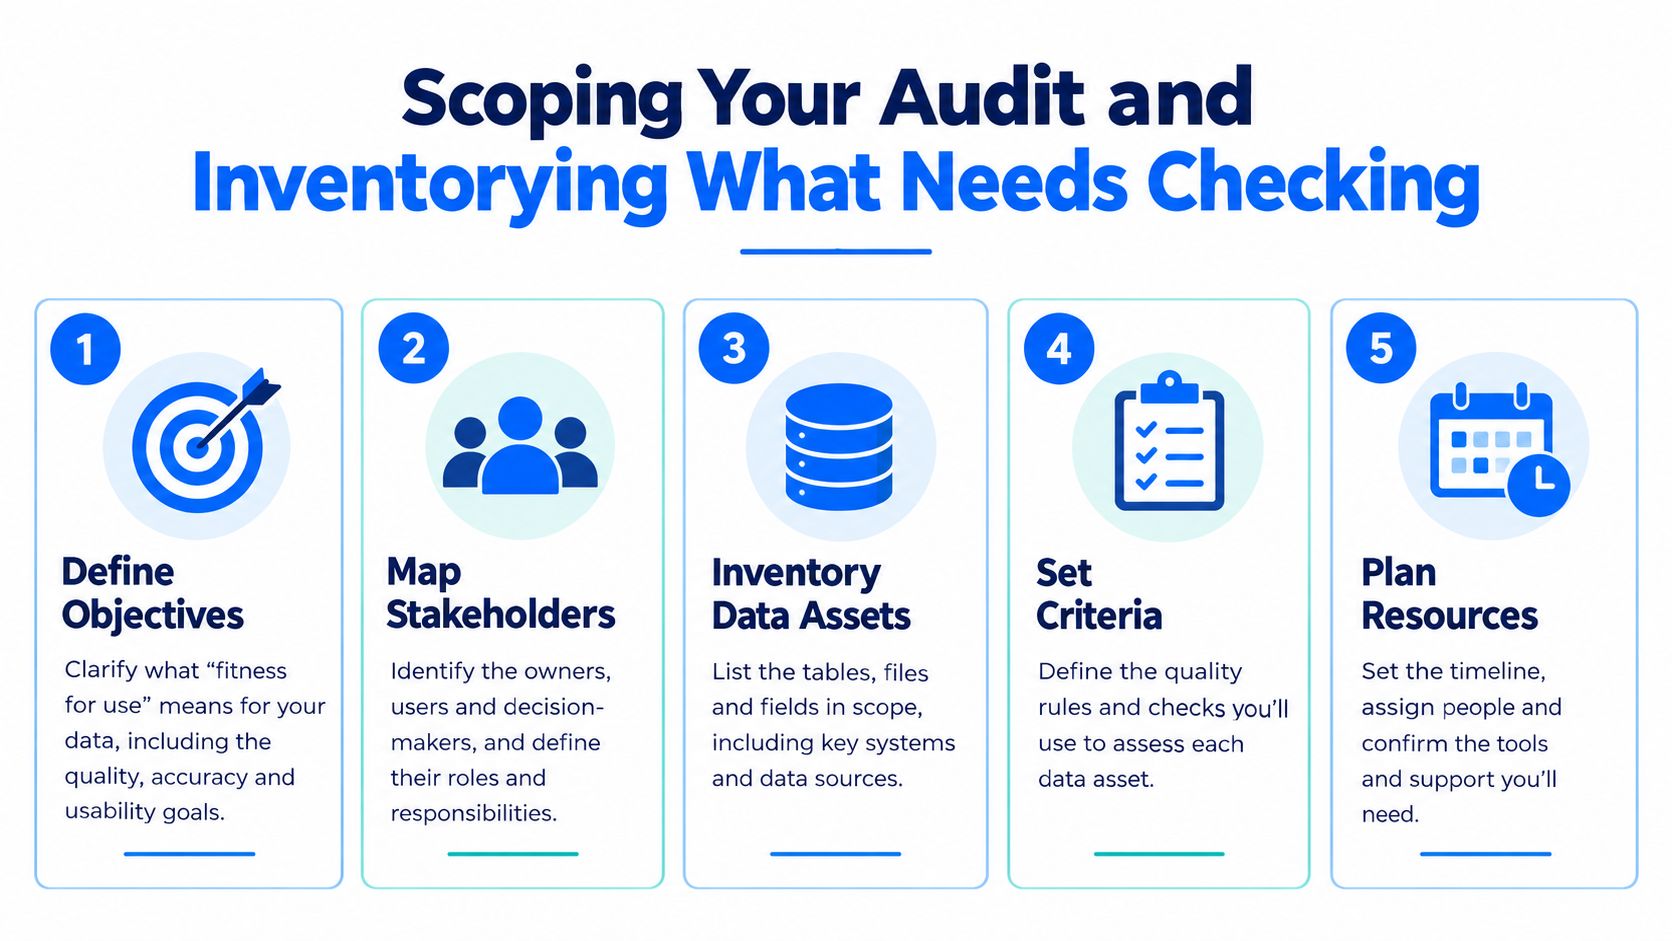
Pierwsza dyscyplina jest prosta. Wyznacz zakres audytu wokół zamierzonego użycia, a nie wokół tabel, do których najłatwiej sięgnąć.
Zacznij od przydatności do użycia
Prace NIST nad jakością danych podkreślają, że jakość jest kontekstowa i powinna być oceniana wobec zamierzonego użycia, a nie abstrakcyjnej uniwersalnej oceny, przy czym jakość definiuje się jako przydatność do użycia i wiąże z wymaganiami biznesowymi, jak w dyskusji w duchu NIST o kontekście i ocenie jakości danych. To znaczy, że ten sam zbiór danych może przejść jeden audyt i oblać inny, gdy zmieni się kontekst decyzyjny.
Zgłoszenie regulacyjne potrzebuje na przykład innych kryteriów kompletności i śledzalności niż wewnętrzny pulpit efektywności. Zbiór treningowy modelu może tolerować pewne opóźnienie, ale nie źle oznaczone klasy. Operacyjny strumień obsługi klienta może wymagać ścisłej świeżości, nawet gdy część pól wzbogacających jest opcjonalna.
Zanim wypiszesz zasoby, zanotuj trzy rzeczy:
Decyzję lub obowiązek biznesowy, które dane wspierają.
Konkretny wynik, któremu się ufa albo który jest kwestionowany.
Skutek niepowodzenia, jeśli dane są spóźnione, błędne, niekompletne lub zmienione strukturalnie.
Buduj inwentarz wstecz, od wyniku
Nie zaczynaj od katalogu hurtowni z nadzieją, że istotność sama się pojawi. Zacznij od raportu, pulpitu, zestawu cech modelu albo artefaktu zgłoszeniowego, a potem idź wstecz do tabel źródłowych, złączeń, transformacji, danych referencyjnych i zadań dostarczających.
Użyteczny inwentarz zawiera więcej niż nazwy tabel:
Krytyczne wyniki, takie jak raporty, modele, alerty czy zgłoszenia zewnętrzne.
Zasoby powyżej w łańcuchu, w tym tabele źródłowe, warstwy przejściowe, logikę transformacji i biznesowe tabele referencyjne.
Zależności operacyjne, takie jak harmonogramy, oczekiwania dostaw i odbiorcy niżej w łańcuchu.
Wskazanych właścicieli danych źródłowych, logiki transformacji i odbioru biznesowego.
Zespołom, które chcą to sformalizować, zdefiniowana lista krytycznych elementów danych zwykle najszybciej zatrzyma rozlewanie się zakresu. Nie każdy zbiór danych zasługuje na tę samą głębokość audytu. Te, które napędzają sprawozdawczość regulacyjną, decyzje o klientach, księgowania finansowe czy produkcyjną AI, zwykle tak.
Wyznacz granice, zanim ktokolwiek zacznie testować
Większość tarć w audycie bierze się z błędów granicznych. Zespół mówi, że „potok przychodów klientów” jest w zakresie, ale nikt nie precyzuje, czy obejmuje to ekstrakty z systemów źródłowych, logikę wzbogacania, wolno zmieniające się wymiary, ręczne korekty albo obsługę wyjątków.
Używaj wyraźnych granic takich jak te:
Obszar zakresu | Co zdefiniować |
|---|---|
Granica biznesowa | Która decyzja, raport, zgłoszenie lub model jest objęty |
Granica danych | Które zbiory danych, pola i okresy są objęte |
Granica procesu | Które transformacje, harmonogramy i przekazania są objęte |
Granica odpowiedzialności | Kto zatwierdza reguły, kto naprawia, kto podpisuje |
Zakres audytu powinien być na tyle wąski, by dało się go wykonać, i na tyle szeroki, by wyjaśnić liczbę na końcu.
Dokumentuj pochodzenie danych, póki system jest świeży w pamięci ludzi
Dokumentację pochodzenia odkłada się, bo zespoły zakładają, że odtworzą ją później. Zwykle nie potrafią. Osoba, która wie, dlaczego istnieje zapasowe złączenie, odchodzi, albo awaryjna obejście sprzed pół roku staje się niewidocznym normalnym zachowaniem.
Inwentaryzując zasoby, zapisz:
skąd pochodzi każde krytyczne pole
która transformacja je tworzy lub zmienia
czy istnieje ręczna korekta
jaki harmonogram lub zdarzenie je dostarcza
kto ma zauważyć, jeśli przestanie napływać
Taki poziom inwentarza wydaje się ciężki tylko do pierwszego spotkania przeglądowego. Potem stanowi różnicę między krótkim dochodzeniem a tygodniem zgadywania.
Dobór właściwych kontroli i decyzja, jak je testować
Gdy zakres jest realny, kolejnym błędem jest dobór kontroli z przyzwyczajenia. Zespoły domyślnie sięgają po odsetki wartości pustych, liczniki duplikatów i kilka reguł regex, bo łatwo je oskryptować. Do podstawowej higieny to wystarczy. Do obronnego audytu — nie.
Potrzebujesz kontroli pasujących do celu audytu i podejścia testowego pasującego do ryzyka, wolumenu i tempa zmian danych.
Zacznij od wymiarów, a potem zamień je w kontrole
Ramy jakości danych DAMA, powszechne w nadzorze korporacyjnym, wskazują sześć podstawowych wymiarów: dokładność, kompletność, spójność, Timeliness, unikalność i poprawność, a ten sam materiał definiuje Timeliness operacyjnie jako to, czy dane są dość świeże do użycia, z przykładowymi kontrolami ujętymi jako mierzalne progi, na przykład czas od ostatniej aktualizacji poniżej wybranego limitu, powiedzmy mniej niż godzina od ingestii, jak opisuje ten przegląd wymiarów jakości danych i kontroli operacyjnych.
To ma znaczenie, bo zamienia mgliste oczekiwania w testowalne kontrole. „Dane mają być aktualne” nie jest audytowalne. „Ta tabela musi się zaktualizować w uzgodnionym progu świeżości dla przebiegu raportu” — jest.
Oto zwięzły sposób wyboru.
Cel audytu | Zalecane kontrole | Podejście testowe |
|---|---|---|
Sprawozdawczość regulacyjna lub zarządcza | Kompletność, dokładność, Timeliness, kontrole uzgodnieniowe | Pełne skany kluczowych pól i rekordów oraz planowe monitorowanie Timeliness |
Dane podstawowe klientów lub encji | Unikalność, poprawność, spójność międzysystemowa | Pełne wykrywanie duplikatów dla identyfikatorów podstawowych i celowane kontrole reguł na krytycznych atrybutach |
Szybko zmieniające się pulpity operacyjne | Timeliness, stabilność schematu, anomalie wolumenu rekordów | Ciągłe monitorowanie z kontrolami progów i dryfu |
Cechy modeli lub zbiory wejściowe AI | Poprawność, kompletność, spójność etykiet lub atrybutów | Ciągłe kontrole krytycznych pól i okresowy głębszy przegląd reprezentatywnych wycinków |
Nowo podłączone systemy źródłowe | Poprawność formatu, wzorce wartości pustych, spójność referencyjna | Najpierw testy pilotażowe, potem szersze wykonanie, gdy wzorce się ustabilizują |
Próbkowanie, pełne skany i ciągłe monitorowanie — każde ma swoje miejsce
Próbkowanie wciąż działa, gdy wolumeny są duże, a proces stabilny, ale zawodzi, gdy schematy często się zmieniają albo gdy rzadka usterka ma duży wpływ. Pełne skany są mocniejsze dla reguł deterministycznych na danych krytycznych, zwłaszcza w nowoczesnych hurtowniach, gdzie wykonanie wewnątrz bazy jest praktyczne. Ciągłe monitorowanie jest właściwym wyborem, gdy spóźnione ładowania, dryf strukturalny lub zmiany operacyjne mogą zniszczyć zaufanie między formalnymi cyklami audytu.
Niezależne ramy audytowe też potwierdzają, że wybór metody ma znaczenie. Nowsza literatura podsumowana w ramach FAO opisuje cztery ogólne podejścia i 15 odrębnych metod, co dobrze przypomina, że dojrzały audyt to praca nad doborem metody, a nie jedna sztywna lista kontrolna, jak przedstawia materiał FAO o metodach oceny jakości danych.
Kilka kompromisów powraca regularnie:
Próbkowanie jest lżejsze, gdy ręczna inspekcja rekordów jest kosztowna, ale nie wyłapie każdego przypadku brzegowego.
Pełne skany są mocniejsze dla kompletności, poprawności, unikalności i deterministycznych reguł biznesowych.
Kontrole ciągłe są konieczne, gdy świeżość i zmiany schematu mogą unieważnić wyniki po stronie odbiorców między planowymi przeglądami.
Przetestuj kontrole pilotażowo, zanim uznasz je za dowód
Jednym z najczęstszych niepowodzeń w audytach jest zły projekt testów. Wytyczne audytu klinicznego wskazują niekompletne lub nieścisłe zapisy jako powracającą pułapkę i zalecają testy pilotażowe przed zbieraniem danych, czyszczenie ich w miarę napływu, rozpoznawanie wzorców obciążenia, takich jak systematycznie pomijane rekordy, oraz poprawianie formularzy lub protokołów, gdy błędy się powtarzają, jak podsumowuje ta sama referencja ram audytowych FAO.
To też dobra rada inżynierska. Przetestuj kontrole na mniejszym, lecz reprezentatywnym wycinku, zanim uruchomisz je na skalę. Szybko wyłapiesz złe założenia:
regułę poprawności, która odrzuca stare, lecz akceptowane wartości
regułę duplikatów, która myli tabele historyczne z tabelami stanu bieżącego
regułę Timeliness, która ignoruje znane kalendarze biznesowe
test kompletności, który bierze celowo rzadko wypełniane pola za usterki
Po praktyczne przykłady projektowania reguł i stałego egzekwowania sięgnij do tego przewodnika po regułach walidacji, kontrolach i ciągłej jakości danych — jest użyteczny, bo trzyma się wdrożenia, a nie teorii.
Kontrola nie jest dobra dlatego, że się wykonuje. Jest dobra, bo osoba przeglądająca widzi, po co istnieje, co oznacza jej niepowodzenie i czy próg pasuje do zastosowania biznesowego.
Przeprowadzenie audytu i zebranie dowodów, które się obronią
To przy wykonaniu wiele audytów staje się kruchych. Kontrole się uruchamiają, pojawiają się ustalenia, a potem nikt nie umie odpowiedzieć na podstawowe pytania przeglądu: która wersja reguły się wykonała? Wobec jakiego stanu zbioru danych? Czy źródło było spóźnione? Czy schemat zmienił się przed awarią? Czy to odosobniona usterka, czy skutek znanej zmiany powyżej w łańcuchu?
Dlatego projekt dowodów liczy się tak samo jak projekt testów.
Wykonuj jak najbliżej danych
W większości środowisk hurtowni i jezior najczystszym wzorcem jest wykonywanie kontroli wewnątrz bazy. Ogranicza to ruch danych, zachowuje granice bezpieczeństwa i pozwala uniknąć ubocznego problemu tworzenia kolejnej kopii danych wrażliwych na potrzeby audytu.
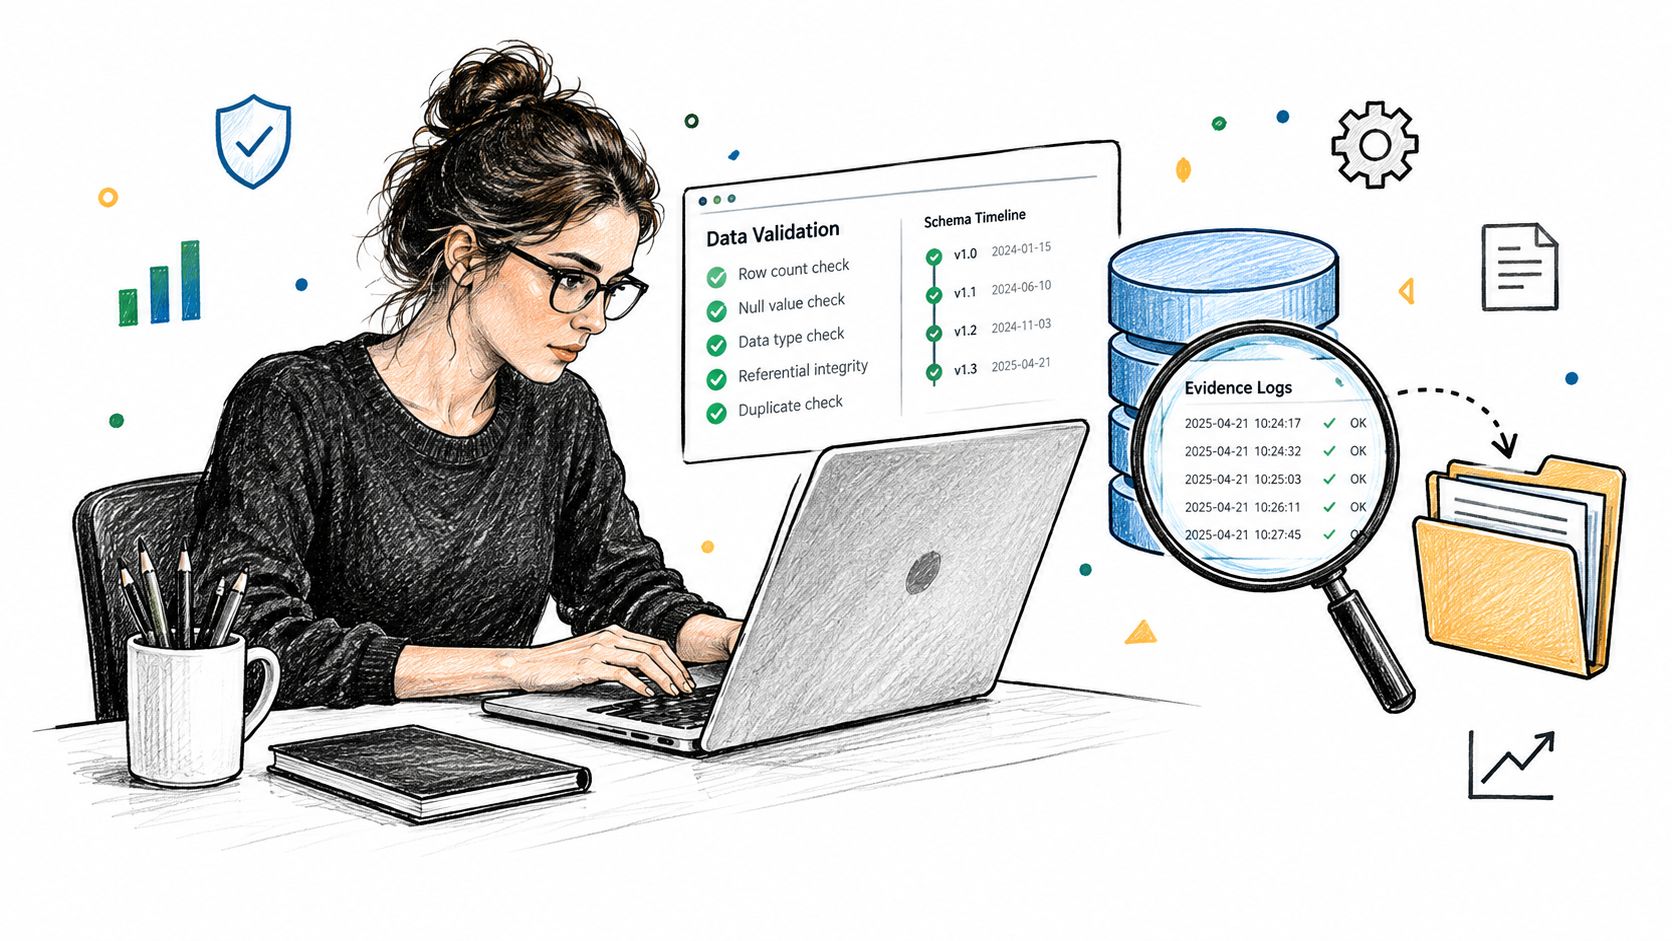
Podczas wykonania zapisuj więcej niż zaliczone lub niezaliczone:
Kontekst zbioru danych, taki jak środowisko, schemat, tabela oraz partycja lub okno czasowe
Kontekst reguły, w tym wersję logiki, próg i status zatwierdzenia
Kontekst wykonania, taki jak czas przebiegu, stan dostawy źródła i ewentualne ostrzeżenia o zależnościach
Kontekst wyniku, w tym liczbę dotkniętych rekordów, przykłady i klasyfikację istotności
Jeśli korzystasz z podejścia platformowego, jedna wzmianka jest uzasadniona: digna działa wewnątrz środowiska klienta, wykonuje monitorowanie i walidację w bazie oraz pokazuje incydenty, trendy, problemy z Timeliness i zmiany schematu we wspólnym interfejsie. Ten model wdrożenia dobrze pasuje do audytów, bo dowody zostają blisko badanych systemów, zamiast być odtwarzane na zewnątrz.
Traktuj pochodzenie i śledzalność jako dowód, nie ozdobę
Literatura o praktyce jakości danych w przedsiębiorstwach traktuje śledzalność i pochodzenie jako rdzeń mechaniki audytu, a nie opcjonalne metadane. Listy wymiarów wywodzone z DAMA wymieniają śledzalność wśród często przywoływanych wymiarów jakości, a źródła o nadzorze opisują pochodzenie jako niezbędne do zrozumienia, jak dane są przekształcane, skąd pochodzą i jak przepływają między systemami, jak omawia opracowanie o doborze właściwych wymiarów jakości danych.
Bez pochodzenia nieudana kontrola pola mówi ci, że jest dym. Nie mówi, gdzie zaczął się ogień.
Solidny zapis dowodowy powinien pozwolić osobie przeglądającej szybko odpowiedzieć na te pytania:
Pytanie przeglądu | Potrzebny dowód |
|---|---|
Skąd wzięło się to pole | Tabela źródłowa, pole źródłowe, ścieżka ingestii |
Co zmieniło się przed pojawieniem się problemu | Historia schematu, dziennik wdrożeń, powiadomienie o procesie źródłowym |
Jak pole zostało przekształcone | Logika transformacji, odwołanie do zadania lub modelu |
Kto odpowiada za naprawę | Właściciel źródła, właściciel potoku, zatwierdzający biznesowy |
Zespołom potrzebującym praktycznej dyscypliny wokół jakości dowodów warto polecić tekst Rivul AI o tym, jak audytować niepoparte twierdzenia przed złożeniem. Dotyczy twierdzeń, a nie potoków, ale nawyk jest ten sam: zwiąż każdy wniosek ze sprawdzalnym poparciem, zanim ktokolwiek podpisze.
Zapisuj też zdarzenia bliskie awarii i zmiany w źródłach
Wiele szkodliwych incydentów zaczyna się jako zdarzenia bliskie awarii. Źródło dostarcza z opóźnieniem, ale wciąż przed terminem raportu. Pole dopuszczające wartości puste nagle robi się rzadko wypełnione. Tabela słownikowa zmienia semantykę, nie łamiąc schematu. Jeśli zapisujesz wyłącznie twarde niepowodzenia, umyka ci wzorzec, który uczyniłby następną awarię przewidywalną.
Najmocniejsze zbiory dowodów obejmują więc:
twarde niepowodzenia
ostrzeżenia i zdarzenia bliskie awarii
powiadomienia o zmianach w procesie źródłowym
modyfikacje schematu
naruszenia świeżości
status naprawy powiązany z pierwotnym ustaleniem
Po wzorce wdrożeniowe wokół kontroli regułowych i śladów audytowych dedykowany weryfikator integralności danych pomoże zakotwiczyć dowody w rzeczywistych zbiorach i historii wykonania, zamiast w notatkach analityków rozsypanych po zgłoszeniach i czatach.
Zamiana ustaleń w poprawki, z jasną odpowiedzialnością i śledzeniem
Zakończony audyt bez modelu odpowiedzialności to tylko dobrze uporządkowana frustracja. Zespoły często wykonują trudną część: rozpoznają realne usterki, dowodzą wpływu, a nawet proponują rozwiązania. Potem ustalenia grzęzną, bo odpowiedzialność rozkłada się między zespoły systemów źródłowych, inżynierię danych, analitykę i operacje biznesowe.
Ta luka kontrolna jest powszechna. 44% badanych stwierdziło, że odpowiedzialność za jakość danych jest dzielona między wiele zespołów, 61% wciąż polega na ręcznych kontrolach lub walidacji w SQL, a jedynie 14% egzekwuje SLA w całej organizacji, według omówienia Thomson Reuters na temat luki walidacyjnej w zaufaniu do danych audytowych. Dzielona odpowiedzialność nie jest zła, nieprzypisany podpis — owszem.
Raport musi zrobić więcej niż podsumować usterki
Podręcznik audytu ONZ i Eurostatu stawia ważną tezę operacyjną: wnioski audytu należy podsumować w raporcie, poddać przeglądowi zarządu i przekuć w plan działania. Ta kolejność ma znaczenie, bo zamienia ustalenia w kontrolowaną zmianę, a nie nieformalne sprzątanie.
Użyteczny raport ustaleń powinien odpowiadać:
co zawiodło
dlaczego to ważne dla decyzji lub obowiązku
czy to kwestia wewnętrznej jakości danych, czy zachowania systemu
jakie istnieje tymczasowe złagodzenie
kto odpowiada za trwałą naprawę
jak zostanie zweryfikowane zamknięcie
Przypisuj odpowiedzialność po punkcie kontrolnym, nie po winie
Najszybszy sposób na utratę rozpędu to pytanie „czyja to wina?”. Lepsze pytanie: „który punkt kontrolny zapobiegnie powtórce?”.
Do przypisania działania użyj typu awarii:
Problem z rejestracją u źródła. Odpowiada zwykle właściciel procesu powyżej albo formularza.
Usterka transformacji. Naprawę bierze właściciel potoku lub inżynierii analitycznej.
Rozbieżność definicji. Musi ją rozstrzygnąć nadzór biznesowy albo właściciel metryki.
Awaria dostawy lub świeżości. Kontrolę operacyjną bierze właściciel platformy lub zadania.
Powtarzana ręczna korekta. To sama kontrola wymaga przeprojektowania, a nie kolejnej notatki o wyjątku.
Rada operacyjna: każde ustalenie potrzebuje jednej osoby odpowiedzialnej za naprawę i jednej za podpis. Mogą to być różne osoby. Nie powinny być komitetem.
Jeśli te same błędy wciąż pojawiają się w tym samym formularzu, ekstrakcie czy protokole, popraw formularz lub proces. Nie czyść po prostu wyniku po raz kolejny. To jeden z najwyraźniejszych wzorców zarówno w audytach klinicznych, jak i operacyjnych.
Śledź do zamknięcia przez weryfikację, nie sam status
Zgłoszenie ze statusem „zrobione” nie jest zamknięciem audytu. Zamknięcie znaczy, że usterkę naprawiono, kontrolę w razie potrzeby zaktualizowano, a kontrola przechodzi teraz przy tych samych kryteriach, które dały pierwotne ustalenie.
Jasność ról się opłaca. Udokumentowane ramy ról i odpowiedzialności w jakości danych pomagają rozdzielić opiekunów, inżynierów, właścicieli dziedzin i zatwierdzających, by ustalenia nie ginęły we wspólnych skrzynkach.
Najbardziej niezawodny model śledzenia jest prosty:
Element śledzenia | Co powinien pokazywać |
|---|---|
Identyfikator ustalenia | Stabilne odwołanie z powrotem do dowodu |
Przypisany właściciel | Wskazana osoba odpowiedzialna za naprawę |
Osoba podpisująca | Wskazany recenzent, który przyjmuje zamknięcie |
Termin lub SLA | Oczekiwany czas naprawy |
Metoda weryfikacji | Który ponowny test lub dowód potwierdza zamknięcie |
Tak ustalenia stają się poprawkami, a nie folklorem.
Uczynić audyty powtarzalnymi i gotowymi na ciągłe monitorowanie
Sprawdzianem audytu jakości danych nie jest to, czy pod presją przeprowadzisz jeden mocny przegląd. Jest nim to, czy te same kontrole działają jeszcze pół roku później, gdy schemat się przesunął, zespół systemu źródłowego zmienił zachowanie pola, a nikt nie pamiętał o aktualizacji dokumentacji.
Powtarzalność bierze się z zamiany logiki audytu w rytm eksploatacji.
Trzymaj cykl audytu krótki i bogaty w dowody
Praktyczny wzorzec to trzymać formalny zakres audytu skupiony i uruchamiać wokół niego lżejsze kontrole w trybie ciągłym. Okresowy głęboki przegląd wciąż jest ważny, zwłaszcza dla wyników regulowanych i zbiorów o dużym wpływie. Ale codzienna praca nad niezawodnością powinna wypatrywać zmian, które psują zaufanie między cyklami przeglądu: spóźnionych napływów, brakujących rekordów, dryfu strukturalnego i powtarzających się zdarzeń bliskich awarii.
Wiele zespołów przesadza z rozmachem. Projektują gigantyczne ćwiczenia kwartalne, które dają dopracowane prezentacje i niewiele nauki operacyjnej. Mniejsze, bogate w dowody cykle trzymają się lepiej, bo zespoły są w stanie je utrzymać.
Pilnuj trybów awarii, które audyty wykrywają raz za razem
Tradycyjne metody audytu też uginają się pod dzisiejszymi wolumenami i tempem zmian. Nowsze podsumowania zauważają, że ręczne próbkowanie i metody arkuszowe z trudem weryfikują duże wolumeny danych audytowych, a wdrażanie dedykowanej obserwowalności i egzekwowania SLA dopiero raczkuje, jak opisuje ten przegląd luk w audycie jakości danych i wyzwań ciągłego monitorowania. Zgadza się to z praktyką: kontrole nie zawodzą dlatego, że pomysł był zły, tylko dlatego, że metoda nie nadąża.
Powtarzalny rytm monitorowania zwykle obejmuje:
Kontrole świeżości dla krytycznych dostaw i zależności po stronie odbiorców
Monitorowanie schematu, by zmiany strukturalne były widoczne, zanim odbiorcy przestaną działać
Historię wykonania reguł, by pokazać, czy jakość rośnie, czy spada
Przegląd wyjątków, by ostrzeżenia i zdarzenia bliskie awarii nie były ignorowane
Zaplanowaną rewalidację po zmianach w procesach powyżej w łańcuchu
Dobre audyty z czasem lżeją, bo zespoły ponownie używają kryteriów, wzorców dowodowych i ścieżek odpowiedzialności. Złe audyty ciężknieją, bo każdy cykl zaczyna się od zera.
Skaluj przez standaryzację modelu kontroli
Nie potrzebujesz, by każda dziedzina używała identycznych reguł. Potrzebujesz, by każda używała tego samego modelu kontroli: wyraźnych kryteriów, udokumentowanych dowodów, wskazanej odpowiedzialności, zarządzanych wyjątków i weryfikacji po naprawie.
Ta standaryzacja pozwala jednej organizacji audytować strumienie finansowe, dokumentację kliniczną, dane operacyjne telekomunikacji czy publiczne zbiory sprawozdawcze bez wymyślania metody za każdym razem od nowa. Kontrole się różnią. System kontroli — nie.
Powtarzalny program audytowy to moment, w którym praca nad jakością przestaje być reaktywnym sprzątaniem i zaczyna zachowywać się jak infrastruktura.
Jeśli potrzebujesz, by ten system kontroli działał we własnym środowisku, digna oferuje walidację w bazie, monitorowanie Timeliness, śledzenie schematu, wykrywanie anomalii i dowody gotowe do audytu w hurtowniach, jeziorach i potokach. Powstała dla zespołów, które potrzebują powtarzalnego audytu jakości danych bez wynoszenia danych produkcyjnych poza swój stos. Odwiedź digna, by zobaczyć, jak platforma wspiera ciągłe, obronne kontrole audytowe.
Audyt to migawka; utrzymanie tych samych kontroli między audytami to krok w stronę ciągłego monitorowania jakości danych.
Najczęściej zadawane pytania
Co odróżnia audyt jakości danych od inspekcji?
Efekt. Jeśli wynikiem jest tylko arkusz z usterkami, to inspekcja; audyt daje dowody, wnioski, przegląd zarządczy i działania korygujące. ISO ujmuje audyt jako systematyczny, niezależny i udokumentowany proces oceniany wobec kryteriów.
Czego wymagają kolejno: systematyczny, niezależny i udokumentowany?
Systematyczny znaczy, że kontrole nie są improwizowane. Niezależny — że ustalenia przetrwają przegląd poza zespołem dostarczającym. Udokumentowany — że ktoś inny może później obejrzeć dowody i dojść do tego samego wniosku.
Jak wyznaczyć zakres audytu?
Od przydatności do użycia, nie od abstrakcyjnej oceny. Prace NIST wiążą jakość z zamierzonym użyciem i wymaganiami biznesowymi, więc zapisz decyzję lub obowiązek, który dane wspierają, konkretny wynik obdarzany zaufaniem oraz skutek, jeśli będzie spóźniony, błędny lub niekompletny.
Co należy do inwentarza audytu?
Buduj go wstecz od wyniku: krytyczne raporty, modele, alerty lub zgłoszenia; tabele źródłowe powyżej w łańcuchu, warstwy przejściowe, logikę transformacji i tabele referencyjne; zależności operacyjne, takie jak harmonogramy i odbiorcy niżej w łańcuchu; oraz wskazanych właścicieli źródła, logiki i odbioru biznesowego.
Które granice zapobiegają tarciom w audycie?
Cztery. Granica biznesowa nazywa objętą decyzję lub zgłoszenie, granica danych — zbiory, pola i okresy, granica procesu — transformacje i przekazania, a granica odpowiedzialności — kto zatwierdza reguły, kto naprawia i kto podpisuje.



