Self-Service Analytics: Kompleksowy przewodnik na rok 2026
|
6
min. czyt.
Większość porad dotyczących self service analytics zaczyna się od niewłaściwego problemu. Traktują one interfejs jako najtrudniejszą część, a następnie zakładają, że pulpity nawigacyjne typu „przeciągnij i upuść” w jakiś sposób same z siebie doprowadzą do wiarygodnych decyzji. W regulowanych przedsiębiorstwach jest zupełnie odwrotnie. Ograniczeniem jest to, czy organizacja posiada zarządzaną warstwę semantyczną (governed semantic layer), wiarygodne metadane, kontrole dostępu i kontrole jakości danych na tyle silne, aby umożliwić użytkownikom nietechnicznym szybkie działanie bez naruszania logiki raportowania lub Compliance.
Ta kategoria stała się popularna, ponieważ użytkownicy biznesowi chcieli zadawać pytania bez czekania na centralne zespoły, a nowoczesne platformy ułatwiają to obecnie dzięki zapytaniom w języku naturalnym, wizualnej eksploracji i automatycznemu przygotowaniu danych. Jednak historyczne przejście od raportów będących własnością IT do analiz biznesowych sprawdza się tylko wtedy, gdy środowisko danych jest uporządkowane, a nie wtedy, gdy użytkownicy są wrzucani do surowych tabel i każe im się samym do wszystkiego dochodzić.
Spis treści
Dlaczego większość inicjatyw Self Service Analytics kończy się niepowodzeniem
Najczęstszy powód niepowodzenia jest prosty. Zespoły kupują narzędzie BI, podłączają je do udostępnianych danych i nazywają to self service analytics. Pierwszy miesiąc wygląda obiecująco, ponieważ ludzie mogą klikać i tworzyć pulpity nawigacyjne. Drugi miesiąc ujawnia kluczowy problem: zaczyna się rozbieżność metryk, logika biznesowa rozgałęzia się w zależności od zespołu i nikt już nie ufa liczbom.
Narzędzie nie tworzy wspólnego znaczenia. Robi to zarządzana warstwa semantyczna. Bez niej jeden pulpit finansowy oblicza przychody w jeden sposób, regionalny zespół sprzedaży w inny, a kierownictwo otrzymuje dwie wersje tej samej odpowiedzi. W tym miejscu samoobsługa się załamuje – nie w interfejsie użytkownika, ale z powodu braku wspólnej warstwy definicji.
Interfejs to ta łatwa część
Projektowanie metodą przeciągnij i upuść obniża barierę umiejętności, ale obniża również barierę dla niespójności, jeśli governance jest słabe. Użytkownicy mogą tworzyć pulpity nawigacyjne szybciej, niż analitycy są w stanie je zweryfikować, co brzmi wydajnie, dopóki katalog nie zapełni się zduplikowanymi zestawami danych i podobnie wyglądającymi raportami, które odpowiadają na różne pytania biznesowe. Rezultatem jest niekontrolowany rozrost pulpitów, a nie autonomia.
Zasada praktyczna: jeśli użytkownik biznesowy może zbudować coś szybciej, niż steward danych jest w stanie to nazwać, zatwierdzić i sklasyfikować, organizacja nie ma jeszcze self service analytics. Ma niekontrolowane raportowanie.
Drugim ukrytym błędem jest dostęp. Kiedy użytkownicy wysyłają zapytania do surowych tabel produkcyjnych, każde pole staje się potencjalnym problemem z polityką prywatności, a każde zapytanie staje się zgłoszeniem do pomocy technicznej. Dlatego nowoczesne wdrożenia korporacyjne oddzielają prezentację od przechowywania danych i umieszczają egzekwowanie zasad pomiędzy nimi. Celem nie jest ograniczanie użytkowników. Chodzi o to, aby uniemożliwić im przypadkowe budowanie na danych, których nie powinni widzieć, lub korzystanie z metryki, której nikt nie będzie mógł później odtworzyć.
Kluczowe komponenty architektury Self Service Analytics
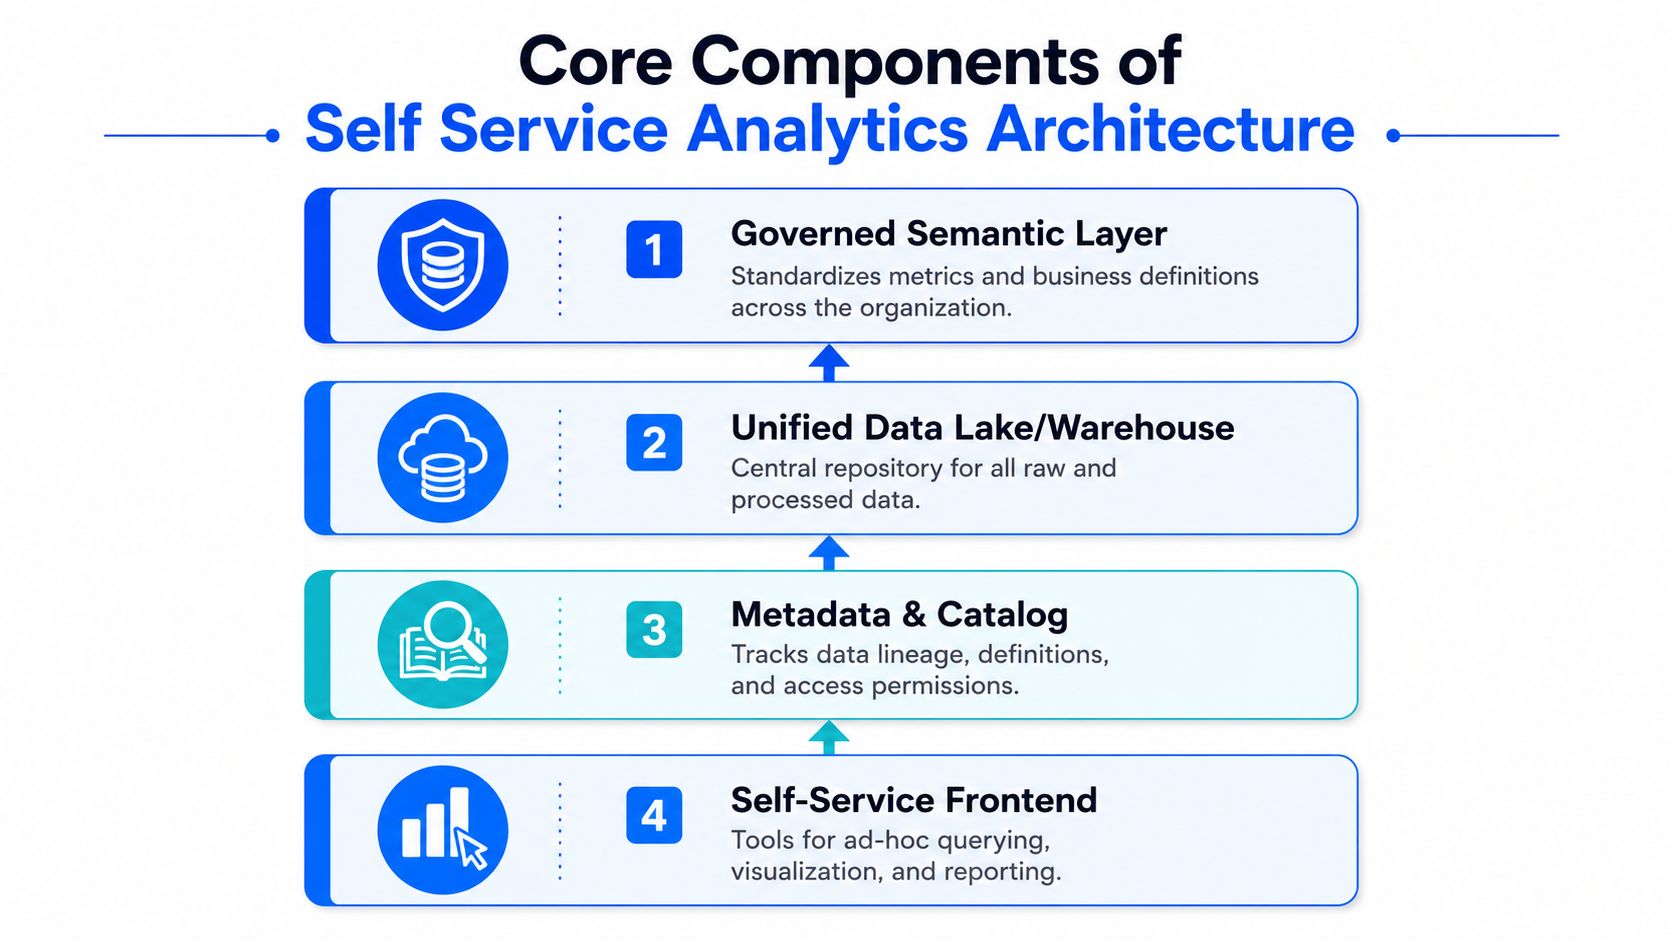
Działająca architektura przedsiębiorstwa potrzebuje czterech warstw, z których każda rozwiązuje inny problem. Stos technologiczny nie jest skomplikowany ze względu na modę; jest skomplikowany, ponieważ każda warstwa eliminuje określony problem. Celem jest umożliwienie użytkownikom samodzielnego działania przy jednoczesnym zachowaniu spójności znaczenia, bezpieczeństwa i wydajności platformy.
Zarządzane znaczenie przed szerokim dostępem
Zarządzana warstwa semantyczna to część, którą wiele organizacji odkłada na później, i zazwyczaj jest to powód, dla którego wdrożenie staje się później kłopotliwe. Standardyzuje ona definicje biznesowe, dzięki czemu kluczowy wskaźnik efektywności (KPI) oznacza to samo we wszystkich działach, nawet jeśli wizualizacje się różnią. Ma to większe znaczenie niż jakikolwiek dopracowany interfejs, ponieważ użytkownicy mogą tolerować nieco toporny interfejs, ale nie będą tolerować kłótni o to, co oznacza dana metryka.
Następna w kolejności jest warstwa katalogu i metadanych, ponieważ użytkownicy nie mogą odkryć tego, czego nie mogą znaleźć. Dobre metadane informują ich, kto jest właścicielem zestawu danych, jak świeże są to dane, co zawierają i jak przebiega historia ich pochodzenia (lineage). W praktyce zmienia to wyszukiwanie danych z polowania w proces wyboru, dlatego platformy i zespoły zajmujące się danymi stale naciskają na słowniki biznesowe i katalogi z możliwością wyszukiwania, a nie na kolejne arkusze kalkulacyjne ad hoc.
Warstwa kontroli dostępu to miejsce, w którym governance staje się rzeczywistością, a nie tylko aspiracją. Uprawnienia oparte na rolach, dostęp do konkretnych zestawów danych oraz procesy zatwierdzania wniosków o dostęp do danych o ograniczonym dostępie zapobiegają sytuacji, w której samoobsługa zamienia się w niekontrolowane ujawnianie informacji. Jest to szczególnie ważne w finansach, opiece zdrowotnej, telekomunikacji i sektorze publicznym, gdzie audytowalność jest częścią modelu operacyjnego.
Izolacja wydajności ma większe znaczenie, niż ludziom się wydaje
Ostatnią warstwą jest samodzielnie przydzielana moc obliczeniowa lub równoważny sposób na odizolowanie zadań ad hoc od współdzielonych obciążeń produkcyjnych. Bez limitów lub wyizolowanych środowisk obliczeniowych (sandboxes), kilka eksploracyjnych złączeń tabel może spowolnić hurtownię danych dla wszystkich innych. To nie tylko szkodzi wydajności, ale również niszczy zaufanie do platformy.
Silnym punktem odniesienia dla procesów wyszukiwania danych jest odkrywanie danych w zarządzanych środowiskach korporacyjnych, ponieważ ta sama dyscyplina, która pomaga użytkownikom znaleźć zestawy danych, pomaga im również uniknąć ich niewłaściwego użycia. Zespoły oceniające partnerów wdrożeniowych mogą również porównać, w jaki sposób oferty analizy danych Bidwell podchodzą do zarządzanych prac analitycznych, zwłaszcza gdy organizacja potrzebuje zarówno użyteczności biznesowej, jak i dyscypliny platformy.
Platforma, która udostępnia surowe tabele i nazywa to upodmiotowieniem (empowerment), oszczędza czas konfiguracji kosztem przyszłego zaufania.
Modele governance, które równoważą szybkość i kontrolę
Governance to nie jeden model. To zestaw kompromisów między spójnością, autonomią a kosztami operacyjnymi. Niewłaściwe podejście to zazwyczaj to, które brzmi najprościej na prezentacji. Scentralizowana kontrola jest bezpieczna, federacyjne governance jest praktyczne, a w pełni zdecentralizowane systemy są szybkie tylko do czasu pierwszego sporu o definicję KPI lub politykę dostępu.
Trzy modele, trzy różne zagrożenia
Scentralizowana kontrola sprawdza się, gdy presja związana z Compliance jest wysoka, a populacja użytkowników niewielka. Każde żądanie przechodzi przez centralny zespół ds. danych, co zapewnia spójność i ścisłą weryfikację, ale tworzy również kolejkę. Ten model chroni definicje, jednak spowalnia biznes i może sprawić, że samoobsługa będzie odbierana bardziej jako zabieg wizerunkowy niż rzeczywista zmiana operacyjna.
Federacyjne governance to model, na który decyduje się większość regulowanych przedsiębiorstw, ponieważ dzieli odpowiedzialność w użyteczny sposób. Centralne zespoły standaryzują kluczowe metryki, zasady dostępu i progi jakości. Zespoły domenowe tworzą raporty i wizualizacje w ramach tych ram ochronnych. Zapewnia to wystarczającą autonomię, aby zespoły mogły działać sprawnie, przy jednoczesnym zachowaniu standardów korporacyjnych, których potrzebują kierownictwo i audytorzy.
Zdecentralizowane i demokratyczne governance daje zespołom największą swobodę. Może sprawdzić się w małych środowiskach o niskim ryzyku, z bardzo zgodnymi użytkownikami, ale jest kruche w skali przedsiębiorstwa. Definicje stają się rozbieżne, zduplikowana logika się rozprzestrzenia i nikt nie potrafi określić, który pulpit nawigacyjny jest wiarygodny. Jeśli organizacja już teraz boryka się ze spójnością metryk, ten model tylko pogłębia problem.
Model | Zaleta | Wada | Najlepsze dopasowanie |
|---|---|---|---|
Scentralizowana kontrola | Maksymalna spójność | Najwolniejsze zatwierdzenia | Ściśle regulowane, wąskie przypadki użycia |
Federacyjne governance | Zbalansowana autonomia i standardy | Wymaga zdyscyplinowanego zarządzania (stewardship) | Duże przedsiębiorstwa z wieloma domenami |
Zdecentralizowane i demokratyczne | Najszybsze lokalne eksperymenty | Najwyższe ryzyko rozbieżności metryk | Małe zespoły, mniejsza presja na Compliance |
Przekształcanie polityki w reguły operacyjne
Dobre listy kontrolne governance są konkretne. Katalog powinien pokazywać własność, częstotliwość aktualizacji, uwagi dotyczące jakości i definicje biznesowe dla kluczowych pól. Procedury dostępu powinny jasno określać, kto co może widzieć, jak wnioskować o dane o ograniczonym dostępie oraz jakie kontrole prywatności lub Compliance mają zastosowanie przed zatwierdzeniem. Reguły walidacji powinny być widoczne dla osób korzystających z danych, a nie ukryte gdzieś w systemie zgłoszeniowym.
Dlatego data governance strategy musi być zaprojektowana jako model operacyjny, a nie dokument polityki. Jeśli zasady nie są wdrożone do codziennej analizy, użytkownicy tworzą obejścia. Kiedy to nastąpi, governance zaczyna istnieć tylko na papierze.
Najlepsze konfiguracje federacyjne nie próbują eliminować lokalnych różnic. Utrzymują stabilność kluczowych metryk i pozwalają zespołom dostosować warstwę prezentacji do własnych pytań. To właśnie ta równowaga pozwala zachować szybkość bez dopuszczania do tego, by raportowanie rozpadło się na konkurujące ze sobą wersje prawdy.
Wymagania dotyczące jakości danych i Observability
Samoobsługa kończy się niepowodzeniem, gdy jakość danych jest niewidoczna. Pulpit nawigacyjny może wyglądać dobrze, podczas gdy dane u podstaw są nieświeże, schemat zmienia się bez powiadomienia lub reguła na poziomie rekordów ulega awarii w sposób, który wpływa tylko na jeden zespół odbiorców. Użytkownicy nie widzą przyczyny źródłowej, widzą jedynie, że raport przestał odpowiadać rzeczywistości.
Co należy monitorować
Pierwszą bramą jest monitoring pobierania danych (ingestion). Jeśli dane docierają z opóźnieniem, są niekompletne lub w złym formacie, analiza na dalszych etapach natychmiast dziedziczy ten problem. Drugą bramą jest śledzenie schematów i pochodzenia danych (lineage), ponieważ dodawanie kolumn, zmiany typów danych i nadrzędne transformacje mogą unieważnić pulpity nawigacyjne bez ostrzeżenia. Trzecią bramą jest wykrywanie anomalii, które pomaga ujawnić odchylenia statystyczne pomijane przez proste progi. Czwartą bramą jest pulpit jakości (quality dashboard), który sprawia, że świeżość, dokładność i pokrycie danych są widoczne zarówno dla inżynierów, jak i interesariuszy biznesowych.
Te kontrole mają największe znaczenie w przedsiębiorstwach, które nie mogą po prostu przesłać wrażliwych danych do środowiska zewnętrznego dostawcy w celu inspekcji. Wykonywanie operacji wewnątrz bazy danych (in-database execution) utrzymuje analizę w systemach kontrolowanych przez klienta, co jest odpowiednim rozwiązaniem, gdy ograniczenia dotyczące prywatności, rezydentności danych lub Compliance są surowe. Zmniejsza to również ilość specjalistycznego wysiłku potrzebnego do rutynowego monitorowania, ponieważ platforma może obserwować dane tam, gdzie już się znajdują.
Praktyczna sekwencja monitorowania
Najpierw sprawdź świeżość. Opóźnienia w ładowaniu danych powodują, że raporty stają się nieaktualne, zanim ktokolwiek to zauważy. Jeśli terminowość nie jest widoczna, użytkownicy biznesowi zakładają, że pulpit nawigacyjny jest aktualny, nawet gdy tak nie jest.
Następnie śledź zmiany strukturalne. Śledzenie schematów pozwala wychwycić zmienione lub usunięte pola, zanim warstwa BI ulegnie uszkodzeniu.
Uważaj na wartości odstające i rozbieżności (drift). Anomalie w wolumenie, dystrybucji lub regułach biznesowych często pojawiają się zanim ludzie zauważą je na pulpicie nawigacyjnym.
Przedstaw wyniki we wspólnym widoku. Pulpity jakości pokazują wyraźnie, które zestawy danych są wystarczająco stabilne dla samoobsługi, a które wymagają uwagi.
Złota zasada: jakość danych w samoobsłudze nie jest zadaniem dla zaplecza (back-office). Jest to płaszczyzna kontrolna dla każdego raportu, modelu i decyzji, które zależą od współdzielonych danych.
Najsilniejsze programy Observability nie zalewają zespołów alertami. Zmniejszają szum informacyjny poprzez uczenie się bazowych zachowań i ujawnianie wyjątków, które naprawdę mają znaczenie. Na tym polega różnica między monitorowaniem na pokaz a monitorowaniem jako operacyjnym zabezpieczeniem.
Enterprise Use Cases Across Regulated Industries
Dostawca ubezpieczeń społecznych to przydatny przykład tego, co się zmienia, gdy governance jest odpowiednio zaprojektowane. Zespół odszedł od utrzymywania 9 000 ręcznie tworzonych reguł jakości danych na rzecz wykrywania anomalii opartego na sztucznej inteligencji, co zmniejszyło liczbę codziennych alertów ze ponad 140 do sygnałów wymagających działania. Dokładna lekcja nie dotyczy samej liczby alertów. Chodzi o to, że utrzymanie reguł przestało dominować w procesie zapewniania jakości, dzięki czemu inżynierowie mogli poświęcić czas na awarie, które wpływały na wyniki.
Ten schemat pojawia się w różnych sektorach regulowanych. W opiece zdrowotnej monitorowanie terminowości pozwala wychwycić opóźnienia w ładowaniu danych, zanim pulpity nawigacyjne dotyczące opieki nad pacjentami staną się nieaktualne. W telekomunikacji śledzenie schematów chroni analizę bilingową przed zmianami na wcześniejszych etapach, które w przeciwnym razie doprowadziłyby kaskadowo do uszkodzenia raportów. W finansach i sektorze publicznym potrzeba jest szersza, ponieważ powtarzalne raportowanie i audytowalność mają tak samo duże znaczenie, jak wygoda użytkownika.
Dla zespołów, które potrzebują ustrukturyzowanych ścieżek edukacyjnych wokół tych zmian operacyjnych, pomocne może być pursue an MBA in operations and supply, co pozwala profesjonalistom zrozumieć kontrolę procesów, choć sama praca analityczna nadal zależy od solidnego projektu platformy i dyscypliny governance.
What these deployments have in common
Organizacje, które sprawiają, że samoobsługa się przyjmuje, nie traktują każdego zestawu danych w ten sam sposób. Oddzielają wysoce zaufane, standardowe metryki od prac eksperymentalnych. Jasno przypisują też własność, dzięki czemu analitycy wiedzą, kto zarządza warstwą semantyczną, kto zatwierdza dostęp, a kto reaguje, gdy pojawia się problem z danymi.
Ważne jest nie to, że każda branża ma inne wykresy. Chodzi o to, że każda z nich ma inną tolerancję na błędy. Pulpit bilingowy, pulpit pacjenta i raport świadczeń publicznych wymagają niezależnych kontroli, nawet jeśli znajdują się na tej samej platformie.
Plan wdrożenia i wskaźniki sukcesu
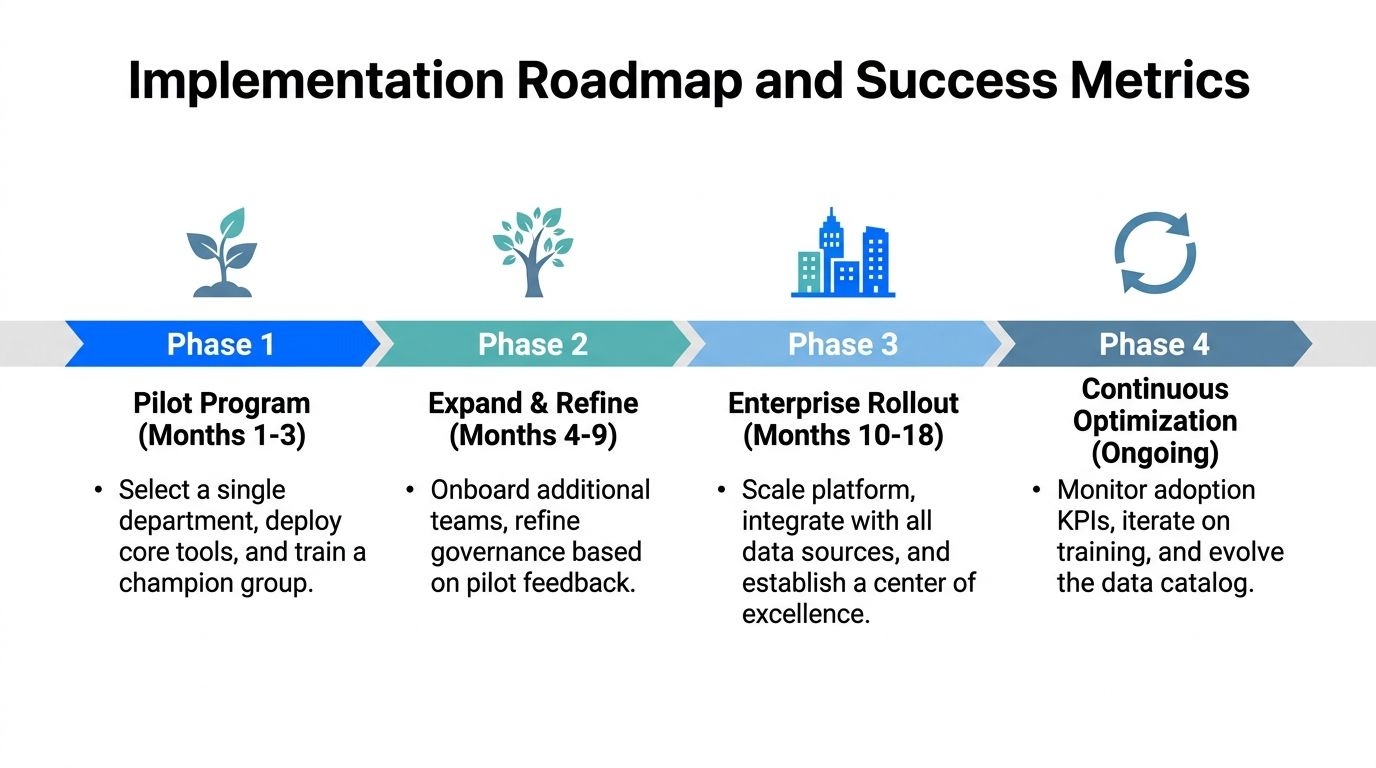
Najbardziej przejrzysta ścieżka wdrażania to taka, która pozostaje niewielka na tyle długo, by sprawdzić dany model. Zacznij od zespołu pilotażowego, który odczuwa realną presję biznesową, ale ma ograniczony promień rażenia (blast radius), a następnie rozwijaj projekt dopiero wtedy, gdy definicje, dostęp i kontrole jakości sprawdzą się w codziennym użytkowaniu. Jeśli pilotaż rozwinie się zbyt szybko, governance ulegnie rozmyciu, zanim proces stanie się stabilny.
Mierz wdrożenie jak program operacyjny
Właściwe wskaźniki mają charakter operacyjny, a nie kosmetyczny. Czas do uzyskania wglądu (time-to-insight) informuje o tym, czy użytkownicy działają szybciej. Obciążenie zespołu ds. danych pokazuje, czy analitycy są angażowani w mniejszą liczbę powtarzających się zapytań. Przyjęcie pulpitów nawigacyjnych (dashboard adoption) wskazuje, czy biznes ufa platformie na tyle, by z niej korzystać. Częstotliwość incydentów związanych z jakością danych pokazuje, czy środowisko staje się bezpieczniejsze, czy tylko bardziej zajęte.
Te miary sprawdzają się najlepiej, gdy są śledzone wspólnie. Jeśli czas do uzyskania wglądu się skraca, ale rośnie częstotliwość incydentów, organizacja może działać szybko kosztem zaufania. Jeśli wskaźnik wdrożenia jest niski, a obciążenie pracą nigdy nie spada, platforma może być użyteczna, ale nie jest zakorzeniona w codziennej pracy. Chodzi o to, by dbać o równowagę, a nie tylko o szybkość.
Typowe błędy przy wdrażaniu
Zbyt wczesne rozszerzanie pilotażu: Zespoły często dodają kolejne działy, zanim warstwa semantyczna i zasady governance będą stabilne.
Niedostateczne szkolenie użytkowników: Platforma samoobsługowa bez wdrożenia (onboardingu) jedynie przenosi dezorientację z zespołu ds. danych na użytkownika biznesowego.
Ignorowanie prac konserwacyjnych: Słowniki, uprawnienia i kontrole jakości wymagają stałego nadzoru, a nie jednorazowego uruchomienia.
Traktowanie pulpitów nawigacyjnych jako produktu: Produktem jest model operacyjny, który dba o to, by pulpity były wiarygodne.
Najlepsze programy ewoluują w centrum doskonałości (center of excellence), które dba o wspólne definicje, wspiera zespoły domenowe i utrzymuje katalog w dobrym stanie. To właśnie to zmienia self-service analytics z wdrożenia narzędzia w trwałą zdolność organizacyjną.
Lista kontrolna wyboru narzędzi i strategia wdrażania
Wybór narzędzia powinien zaczynać się od architektury, a nie od zrzutów ekranu. Dopracowany interfejs jest przydatny, ale nie zrekompensuje słabej obsługi semantycznej, kiepskiej automatyzacji governance ani platformy, która nie pasuje do Twojego modelu bezpieczeństwa. Nabywcy korporacyjni powinni oceniać narzędzia w taki sam sposób, w jaki oceniają infrastrukturę – pytając o to, co psuje się przy rzeczywistym użytkowaniu.
Co sprawdzić przed zakupem
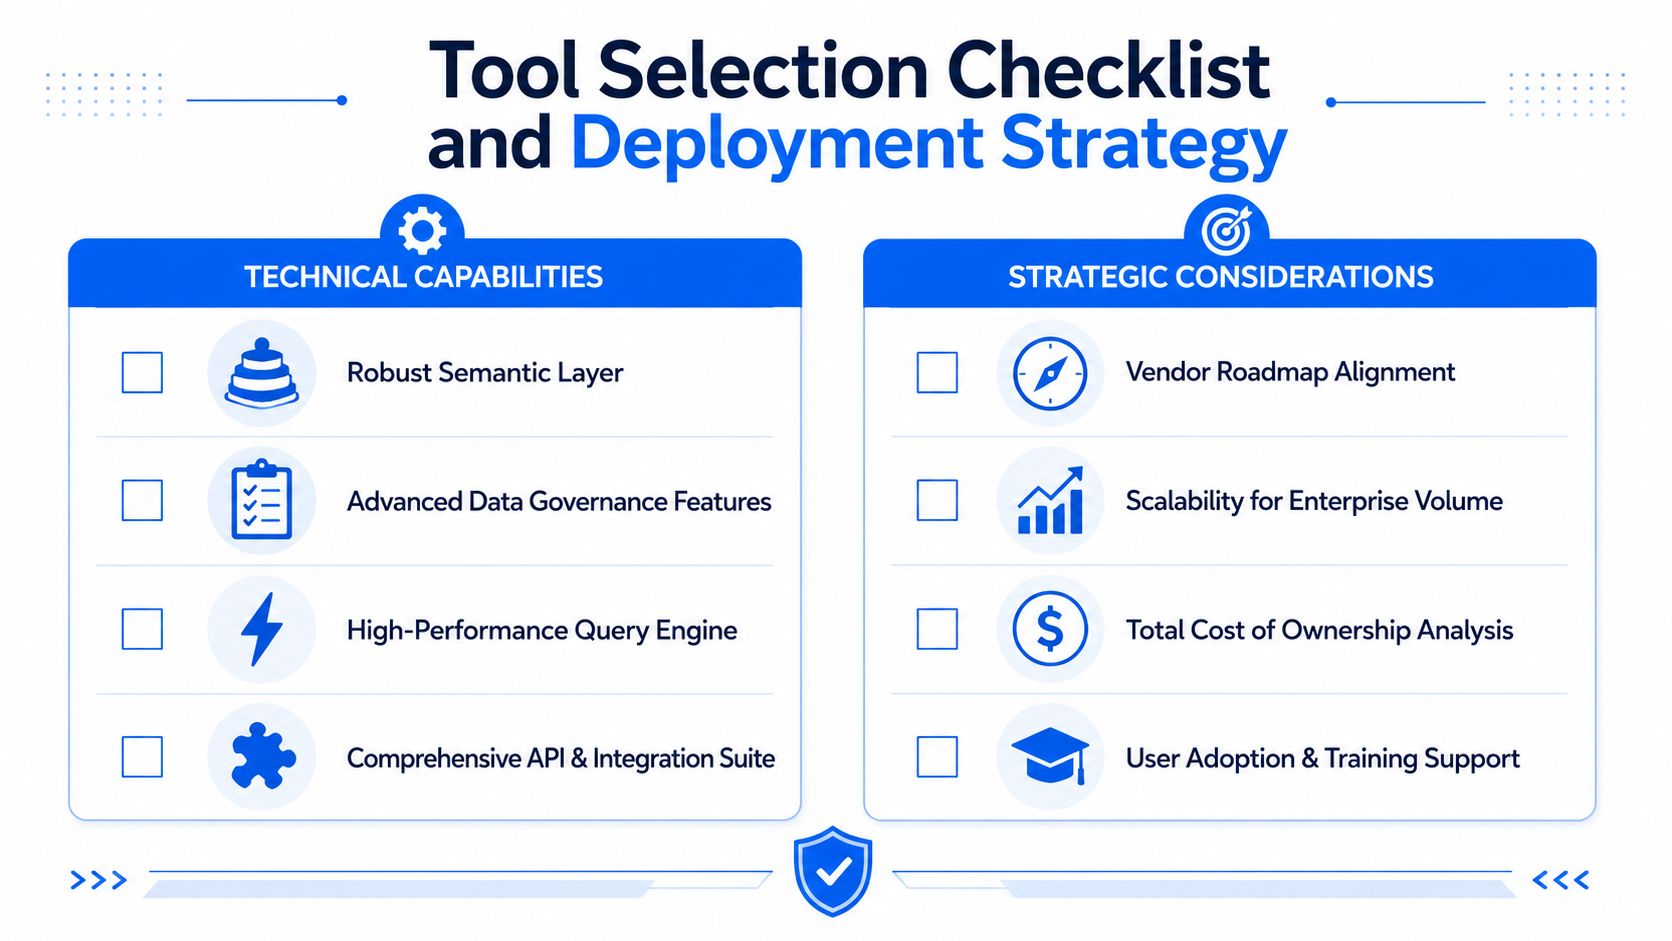
Silne wsparcie dla warstwy semantycznej. Upewnij się, że definicje biznesowe mogą być scentralizowane i ponownie wykorzystywane w różnych zespołach.
Funkcje data governance. Potwierdź, że dostęp oparty na rolach, zatwierdzenia i egzekwowanie zasad są wbudowane w system.
Integracja z Observability. Upewnij się, że śledzenie jakości, świeżości i schematów można połączyć z procesem analitycznym.
Elastyczność wdrożenia. Chmura prywatna, rozwiązania lokalne (on-premise) lub środowiska kontrolowane przez klienta mają znaczenie, gdy ograniczeniem jest rezydentność danych.
Głębokość integracji i API. Platforma powinna pasować do istniejących hurtowni danych, katalogów i narzędzi do rurociągów danych (pipelines).
Skalowalność dla wolumenów korporacyjnych. Sukces pilotażu nie oznacza, że platforma przetrwa wdrożenie na szeroką skalę.
Wsparcie szkoleniowe i adaptacyjne. Użytkownicy biznesowi potrzebują wsparcia wdrożeniowego, a nie tylko dostępu.
Całkowity koszt posiadania (TCO). Ukryte koszty zazwyczaj pojawiają się w postaci narzutu na governance i obciążenia wsparciem technicznym, a nie w samej linii licencyjnej.
Dobra strategia wdrażania jest etapowa. Uruchom nową platformę równolegle z obecnym zestawem raportowym na tyle długo, aby zweryfikować wyniki i wyłapać luki. Wprowadzaj użytkowników falami, zaczynając od grupy, która odniesie największe korzyści i może tolerować pewne zmiany w procesach. Pozostaw starą ścieżkę dostępną, dopóki nowy proces nie zyska zaufania.
Najważniejszym sprawdzianem jest to, czy narzędzie pomaga organizacji wymusić spójne znaczenie bez spowalniania pracy użytkowników. Jeśli tego nie potrafi, nie będzie miało znaczenia, jak dobrze wyglądała wersja demonstracyjna.
Jeśli budujesz self-service analytics dla regulowanego przedsiębiorstwa, digna może pomóc Ci wdrożyć warstwę jakości i Observability bez ujawniania wrażliwych danych środowisku zewnętrznemu. Odwiedź digna, aby zobaczyć, jak wykrywanie anomalii w bazie danych, monitorowanie terminowości, śledzenie schematów i walidacja wspierają wiarygodną analitykę na dużą skalę.


