Tecnica di simulazione Monte Carlo: guida pratica
|
7
min di lettura
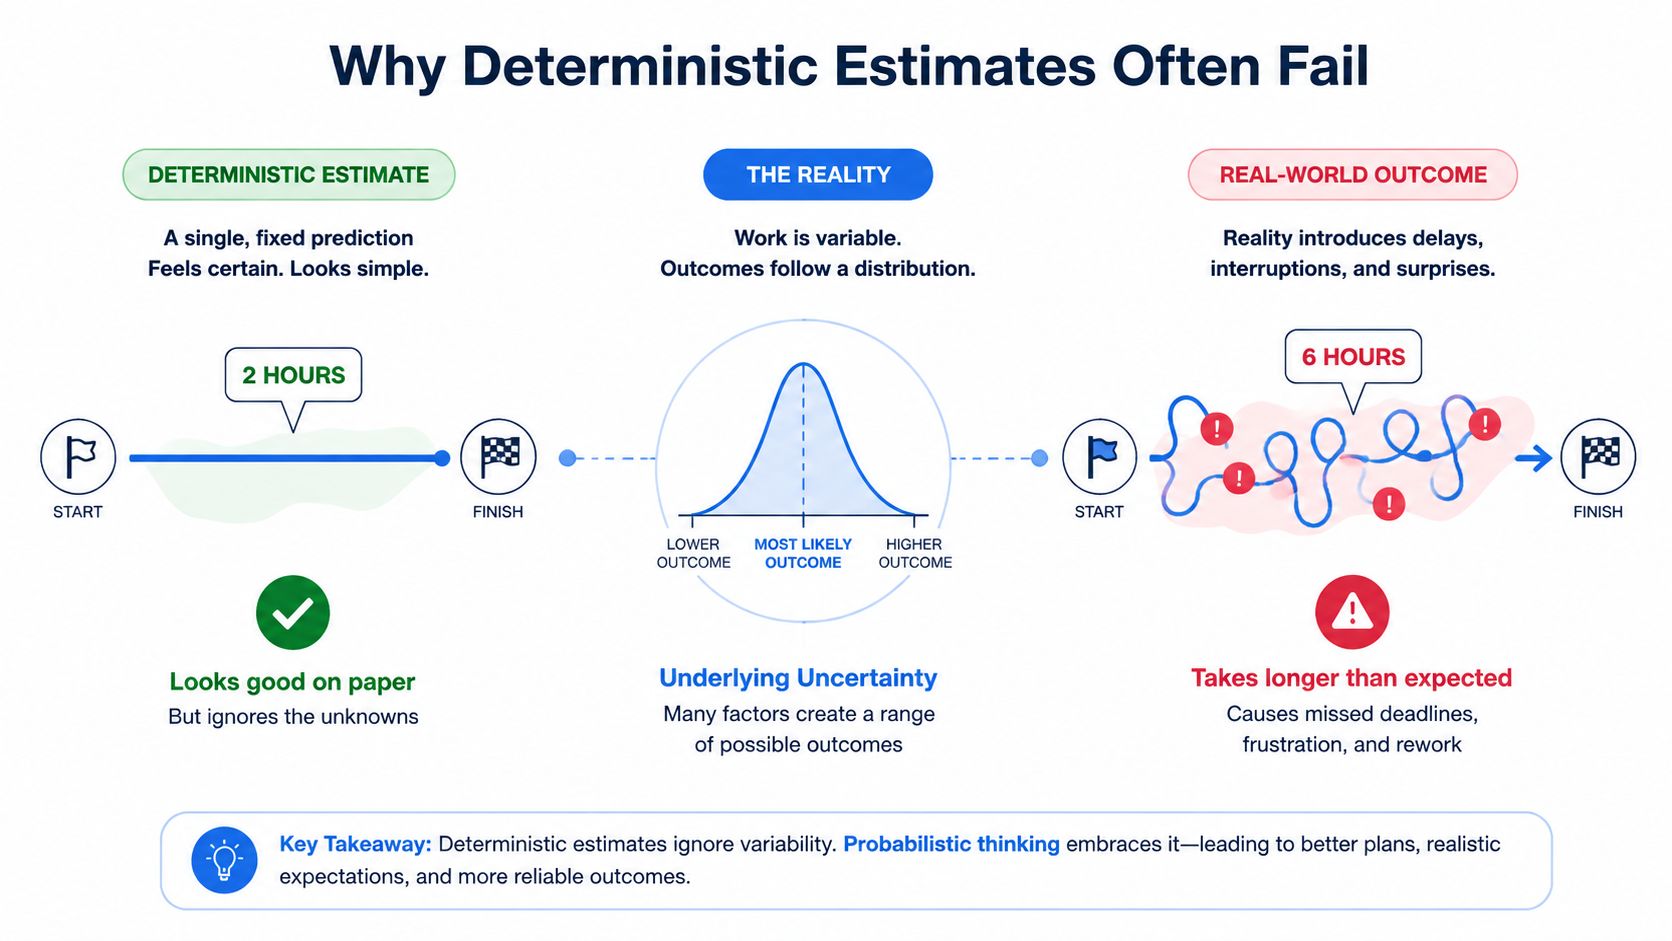
Il vostro job ETL di solito aggiorna la tabella clienti in circa due ore. Questa mattina, con una riunione del consiglio di amministrazione in arrivo, lo stesso aggiornamento è ancora in esecuzione dopo sei. Le dashboard sono diventate rosse, i report a valle sono obsoleti e l'ingegnere reperibile sta controllando contemporaneamente il carico del cluster, i log delle API e le code del data warehouse.
Il problema non è che il team abbia dimenticato come fare una stima. Il problema è che una singola stima nascondeva le condizioni che potevano rallentare il job. La tecnica di simulazione Monte Carlo rende esplicite queste condizioni, campiona dalla loro incertezza e trasforma un'unica risposta sicura in una distribuzione di possibili esiti.
Indice
Perché le stime deterministiche spesso falliscono
Una stima puntuale nasconde la dispersione
L'idea centrale della tecnica di simulazione Monte Carlo
Perché la ripetizione aiuta
Il ciclo di simulazione
Algoritmi e pseudocodice riutilizzabili
Pseudocodice generico
Pattern che vale la pena riutilizzare
Implementare Monte Carlo in Python, R e SQL
Python con NumPy
R con replicate
SQL all'interno del data warehouse
Casi d'uso in qualità dei dati, observability e gestione del rischio
Rilevamento delle anomalie nel numero di righe
Rischio di freschezza delle pipeline
Perdite finanziarie e operative
Errori da evitare e best practice
Casualità non significa automaticamente indipendenza
La convergenza richiede evidenze
Mettere Monte Carlo al lavoro in una piattaforma dati enterprise
Un'impostazione operativa pratica
Perché le stime deterministiche spesso falliscono
Una stima deterministica prende input fissi e produce un output fisso. Per un aggiornamento ETL, ciò può significare presupporre una dimensione del payload nota, una latenza a monte prevedibile e una capacità di calcolo stabile. La promessa che ne risulta sembra chiara: la tabella clienti sarà pronta entro due ore.
Questa promessa è utile solo quando gli input sono abbastanza stabili da giustificarla. In produzione, la contesa per le risorse del cluster può cambiare durante l'esecuzione, un'API a monte può rispondere lentamente e il payload in arrivo può essere molto più grande del solito. Una pipeline che normalmente termina rapidamente può incontrare una combinazione insolita di condizioni e mancare di molto la propria aspettativa di freschezza.
Una stima puntuale nasconde la dispersione
Supponiamo che un ingegnere registri la durata di ogni aggiornamento riuscito. La domanda utile non è solo: “Quale durata dobbiamo pianificare?”. È anche:
Comportamento tipico: quanto dura di solito l'aggiornamento?
Variazione operativa: quanto sono disperse le durate?
Comportamento delle code: con quale frequenza il job termina insolitamente tardi?
Soglia decisionale: a quale probabilità il team dovrebbe allertare qualcuno?
Una distribuzione di probabilità descrive questo comportamento in modo più accurato di una singola durata. Offre al team un modo per distinguere la variazione ordinaria da un evento che merita un'indagine. Per un inquadramento pratico di questa idea, leggete cosa rappresenta una distribuzione dei dati.
La casualità non equivale automaticamente a dati errati. Una parte della casualità riflette condizioni operative reali. Lo scheduler del data warehouse, la rete, il sistema sorgente e il carico di lavoro contribuiscono tutti a una variazione che la pipeline deve tollerare. Ignorare questa variazione non la elimina. Sposta solo l'incertezza dentro un incidente.
Regola pratica: se una decisione dipende da un intervallo di esiti plausibili, modellate direttamente l'intervallo invece di nasconderlo dietro una media.
Uno SLA deterministico può comunque essere utile come contratto, ma non va scambiato per una previsione completa. Il contratto stabilisce cosa si aspetta il business. Un modello probabilistico stima con quale frequenza la piattaforma riuscirà probabilmente a rispettarlo nelle condizioni osservate.
La tecnica di simulazione Monte Carlo tratta la dispersione come un input, non come un nemico.
L'idea centrale della tecnica di simulazione Monte Carlo
Il metodo diventa molto più semplice una volta che si tengono a mente tre elementi. Primo, ogni input incerto ha una distribuzione di probabilità. Secondo, la simulazione effettua un'estrazione casuale da ciascuna distribuzione. Terzo, un modello combina queste estrazioni e produce un output.
Per una pipeline di dati, gli input potrebbero includere il tempo di estrazione dalla sorgente, il tempo di trasformazione, il ritardo in coda nel data warehouse e il tempo di pubblicazione finale. Il modello potrebbe sommare queste durate oppure includere logiche di diramazione, nuovi tentativi, task paralleli e regole di dipendenza. Il modello resta strutturalmente lo stesso, mentre gli input campionati cambiano da un'iterazione all'altra.

Perché la ripetizione aiuta
Una singola estrazione casuale non dice quasi nulla. Potrebbe cadere vicino al centro della distribuzione oppure in una coda. Ripetere il processo fornisce alla distribuzione dell'output abbastanza osservazioni da rivelarne la forma.
È questa l'intuizione alla base della legge dei grandi numeri. I singoli campioni restano rumorosi, ma il comportamento aggregato diventa più stabile man mano che cresce il numero di campioni indipendenti. Immaginate di partire da un istogramma approssimativo con barre che saltano qua e là. Man mano che arrivano altre iterazioni, le barre si livellano e il pattern centrale diventa più facile da vedere.
Il risultato non è la certezza. È un'approssimazione più affidabile del modello implicito nei vostri input.
Il ciclo di simulazione
Ogni iterazione segue lo stesso ciclo:
Campionare gli input: estrarre un valore da ciascuna distribuzione di input.
Eseguire il modello: passare questi valori alla logica di aggregazione o di business.
Memorizzare l'output: conservare la durata, la perdita, il numero di righe o un'altra metrica risultante.
Ripetere il processo: continuare finché l'output non è abbastanza stabile per la decisione.
Riepilogare i risultati: esaminare la media, i percentili e la probabilità di superare una soglia.
La distribuzione dell'output risponde a domande a cui una stima puntuale non può rispondere. Potete chiedervi quanto dura di solito un aggiornamento, quanto possono ritardare i percorsi plausibili più lenti o quanto è probabile che una dashboard non rispetti il proprio contratto di freschezza.
Per una prospettiva di data engineering su questo flusso di lavoro, i metodi Monte Carlo per una migliore data observability collegano il campionamento ripetuto al monitoraggio operativo.
La tecnica offre tre vantaggi pratici: risposte in forma di distribuzione, visibilità sul rischio di coda e variabilità riproducibile quando il generatore casuale è controllato. L'algoritmo che segue trasforma questi vantaggi in passi di implementazione riutilizzabili.
Algoritmi e pseudocodice riutilizzabili
Partite dall'algoritmo, non dal linguaggio di programmazione. Il linguaggio è solo il meccanismo usato per eseguire il ciclo.
Pseudocodice generico
La separazione importante è tra campionamento e modellazione. Il campionamento risponde alla domanda: “Quali valori di input plausibili deve usare questa iterazione?”. Il modello risponde alla domanda: “Quale esito deriva da questi valori?”. Mescolare queste responsabilità rende più difficili test e debugging.
Un esempio pratico in Python può stimare la probabilità che la somma di tre durate di job con distribuzione lognormale superi uno SLA di quattro ore. La distribuzione è adatta a un modello di durata positivo e asimmetrico a destra, ma i parametri riportati sotto sono segnaposto illustrativi a scopo dimostrativo, non stime per la produzione.
Pattern che vale la pena riutilizzare
Campionamento vettorizzato:
numpy.random.default_rnggenera array in modo efficiente invece di costringere Python a gestire ogni estrazione in un ciclo lento.Casualità controllata: un
seedrende un'esecuzione riproducibile, il che è importante quando un ingegnere deve spiegare un alert o confrontare versioni del modello.Visibilità sull'avanzamento: per un modello volutamente iterativo o dipendente dal percorso, avvolgete il ciclo con
tqdmcosì che un job di lunga durata mostri il proprio avanzamento.
Chi passa dagli schemi di algoritmo a codice Python funzionante può usare questi esempi di conversione da pseudocodice a Python come riferimento per tradurre la logica in modo pulito.
In seguito potete esplorare le variabili antitetiche e le variabili di controllo come tecniche di riduzione della varianza. Non sono necessarie per un primo modello, ma possono ridurre il rumore della simulazione quando ogni esecuzione è costosa. Per i flussi di lavoro sulle anomalie, gli stessi riepiloghi dell'output possono supportare il rilevamento delle anomalie nei dati con Python.
Implementare Monte Carlo in Python, R e SQL
La stessa simulazione non diventa matematicamente diversa perché passa da Python a R o a SQL. Il compromesso è operativo: dove deve avvenire il campionamento, dove deve essere eseguito il modello e dove verranno consumati i risultati?
Python con NumPy
Python è di solito il luogo più rapido per la prototipazione. NumPy gestisce il campionamento vettorizzato, l'estrazione dei percentili è semplice e l'ecosistema circostante supporta l'adattamento delle distribuzioni, i grafici diagnostici e il test del comportamento del modello.
R con replicate
R è una scelta solida quando il lavoro è incentrato sull'analisi statistica e sulla visualizzazione. replicate() rende leggibile la valutazione ripetuta, mentre pacchetti come dplyr possono strutturare i riepiloghi dopo la simulazione.
SQL all'interno del data warehouse
SQL è la scelta migliore quando la simulazione dipende da dati già archiviati nel data warehouse. Trasferire in Python grandi campioni storici aggiunge traffico di rete, pressione sulla memoria e un ulteriore confine di esecuzione. Un'implementazione nel data warehouse può unire i record storici delle durate a una tabella di riferimento casuale, calcolare gli esiti simulati accanto ai dati sorgente e salvare i riepiloghi senza esportare le righe grezze.
La funzione casuale esatta varia da un database all'altro, quindi isolatela dietro un piccolo adattatore. Una CTE ricorsiva può generare gli identificativi delle iterazioni, mentre una join con righe di riferimento campionate fornisce i valori di input. Per i controlli giornalieri ad alto volume sul numero di righe, questo mantiene il calcolo vicino alle partizioni da verificare.
Dimensione | Python (NumPy) | R | SQL (nel database) |
|---|---|---|---|
Uso ideale | Prototipazione e servizi riutilizzabili | Analisi statistica e visualizzazione | Simulazioni accanto ai dati del data warehouse |
Punto di forza principale | Vettorizzazione e librerie ampie | Flusso di lavoro statistico espressivo | Spostamento di dati ridotto |
Criticità di memoria | Array di grandi dimensioni possono mettere sotto pressione la memoria dei worker | La replicazione può creare oggetti di grandi dimensioni | Carico sul data warehouse e rischio di spill |
Riproducibilità | Impostate esplicitamente il seed del generatore | Impostate esplicitamente il seed casuale | Dipende dalle funzioni del database e dal piano di esecuzione |
Scelta operativa | Da usare per modelli complessi o dipendenti dal percorso | Da usare per lavori guidati dall'analisi | Da usare per controlli semplici e ad alto volume |
Un servizio Python può anche usare il Python SDK di digna quando il flusso di lavoro circostante deve collegare gli output della simulazione al monitoraggio della piattaforma. La decisione dovrebbe dipendere dalla località dei dati e dalla complessità del modello, non solo dalle preferenze del team.
Casi d'uso in qualità dei dati, observability e gestione del rischio
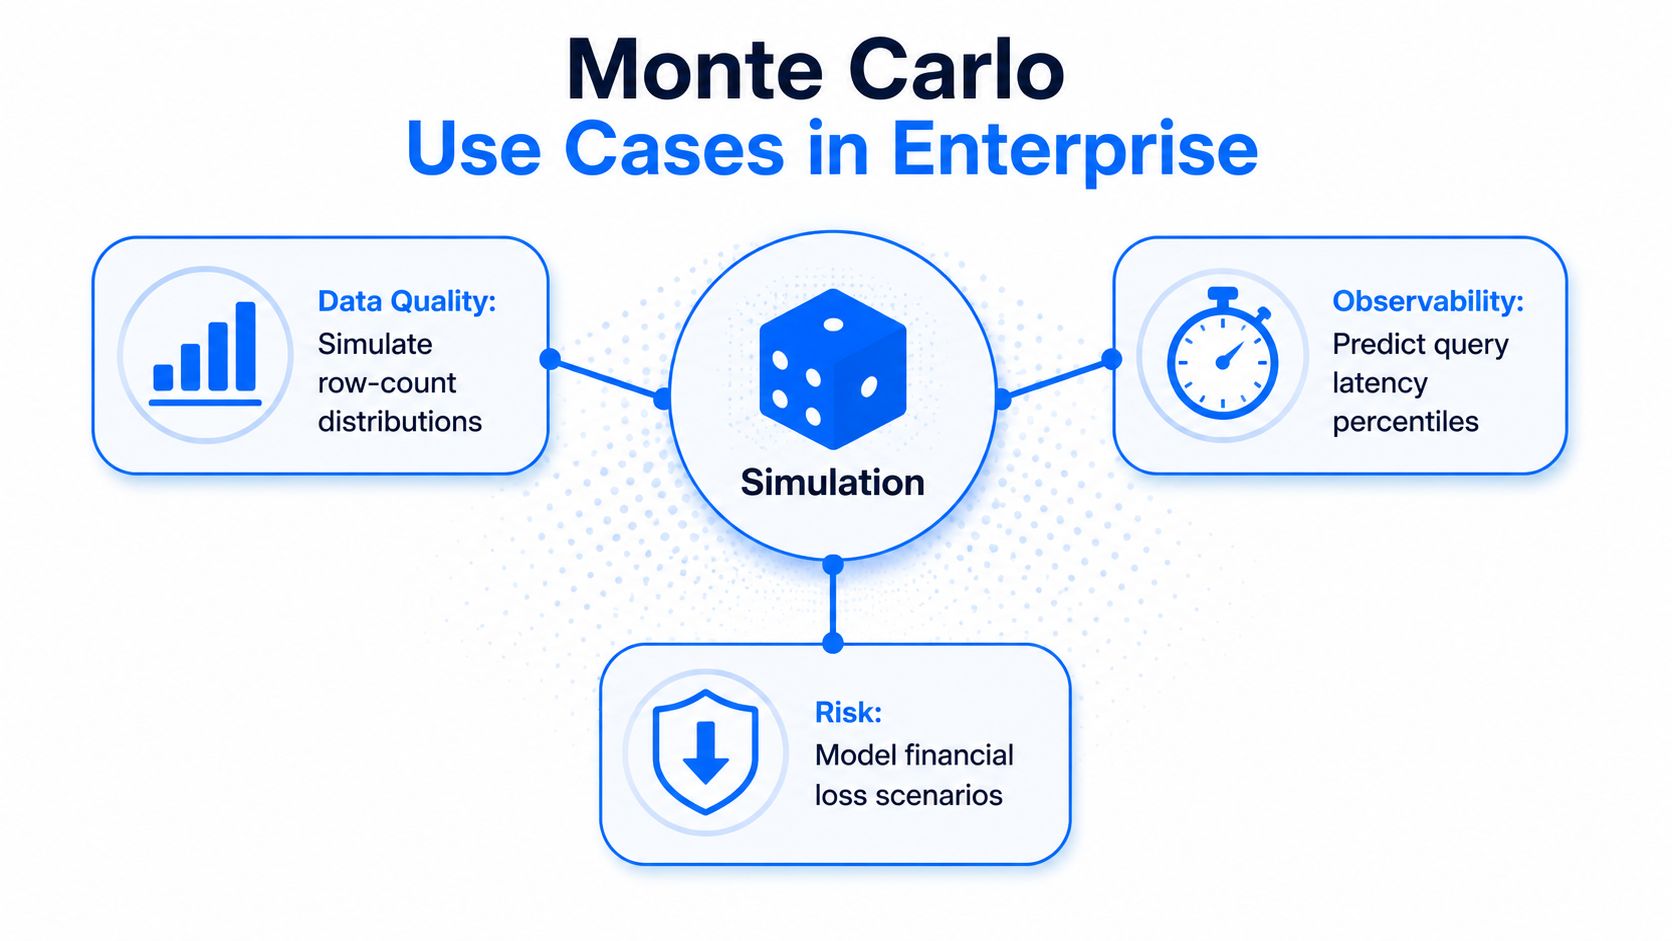
Monte Carlo diventa prezioso in una piattaforma dati quando una soglia statica è troppo grossolana. Un numero di righe può essere valido in un periodo operativo e sospetto in un altro. Una pipeline può essere in ritardo a causa di un carico di lavoro insolito ma legittimo. Una distribuzione delle perdite da frode può sembrare innocua al centro pur nascondendo un'esposizione significativa nella coda.
Rilevamento delle anomalie nel numero di righe
Partite dai conteggi storici delle partizioni orarie o giornaliere. Invece di fissare un minimo e un massimo, adattate una distribuzione che rifletta il volume normale per il periodo, il tipo di giorno o il comportamento della sorgente pertinenti. Simulate i conteggi attesi e confrontate la partizione osservata con l'intervallo risultante.
L'azione dovrebbe dipendere dal confine decisionale. Un conteggio al di fuori dell'intervallo atteso può avviare un'indagine, mentre un conteggio molto in profondità nella coda simulata può generare un incidente a priorità più alta. Questo approccio può intercettare picchi e cali insoliti che un intervallo statico ampio ignorerebbe.
Rischio di freschezza delle pipeline
Per la tempestività, la distribuzione di input è la durata storica delle fasi o il ritardo di arrivo. Il modello combina questi ritardi campionati con la catena di dipendenze pianificata e stima se la dashboard a valle sarà pronta prima della scadenza del suo contratto di freschezza.
Il risultato è una probabilità operativa anziché un avviso vago. Se il rischio simulato di arrivo in ritardo supera la soglia configurata dal team, la piattaforma può avvisare il responsabile prima che uno stakeholder noti i dati obsoleti. Gli ingegneri possono quindi esaminare la fase più lenta invece di aspettare che la dashboard finale fallisca.
Perdite finanziarie e operative
Gli stessi meccanismi si applicano a mancati ricavi, perdite da frode o esposizione di portafoglio. La distribuzione di input può provenire da osservazioni storiche delle perdite, da rendimenti finanziari stimati o da uno scenario volutamente sottoposto a stress. L'output è una distribuzione delle perdite, da cui un team di risk management può esaminare un percentile o stimare la probabilità di superare una tolleranza definita.
Un percentile non è una garanzia. È un'affermazione sulle ipotesi e sul processo di campionamento usati per produrlo.
Lo schema drift segue lo stesso schema. Campionate i tassi di valori nulli o il comportamento dei cambi di tipo su dataset comparabili, quindi segnalate un tasso appena osservato che si colloca insolitamente lontano nella distribuzione simulata. Questo può far emergere rotture silenziose anche quando la pipeline tecnicamente termina.
Errori da evitare e best practice
Il codice Monte Carlo può essere eseguito senza errori e produrre comunque una risposta fuorviante. I guasti in produzione derivano di solito da ipotesi, dipendenze o diagnostica, più che dal ciclo in sé.
Casualità non significa automaticamente indipendenza
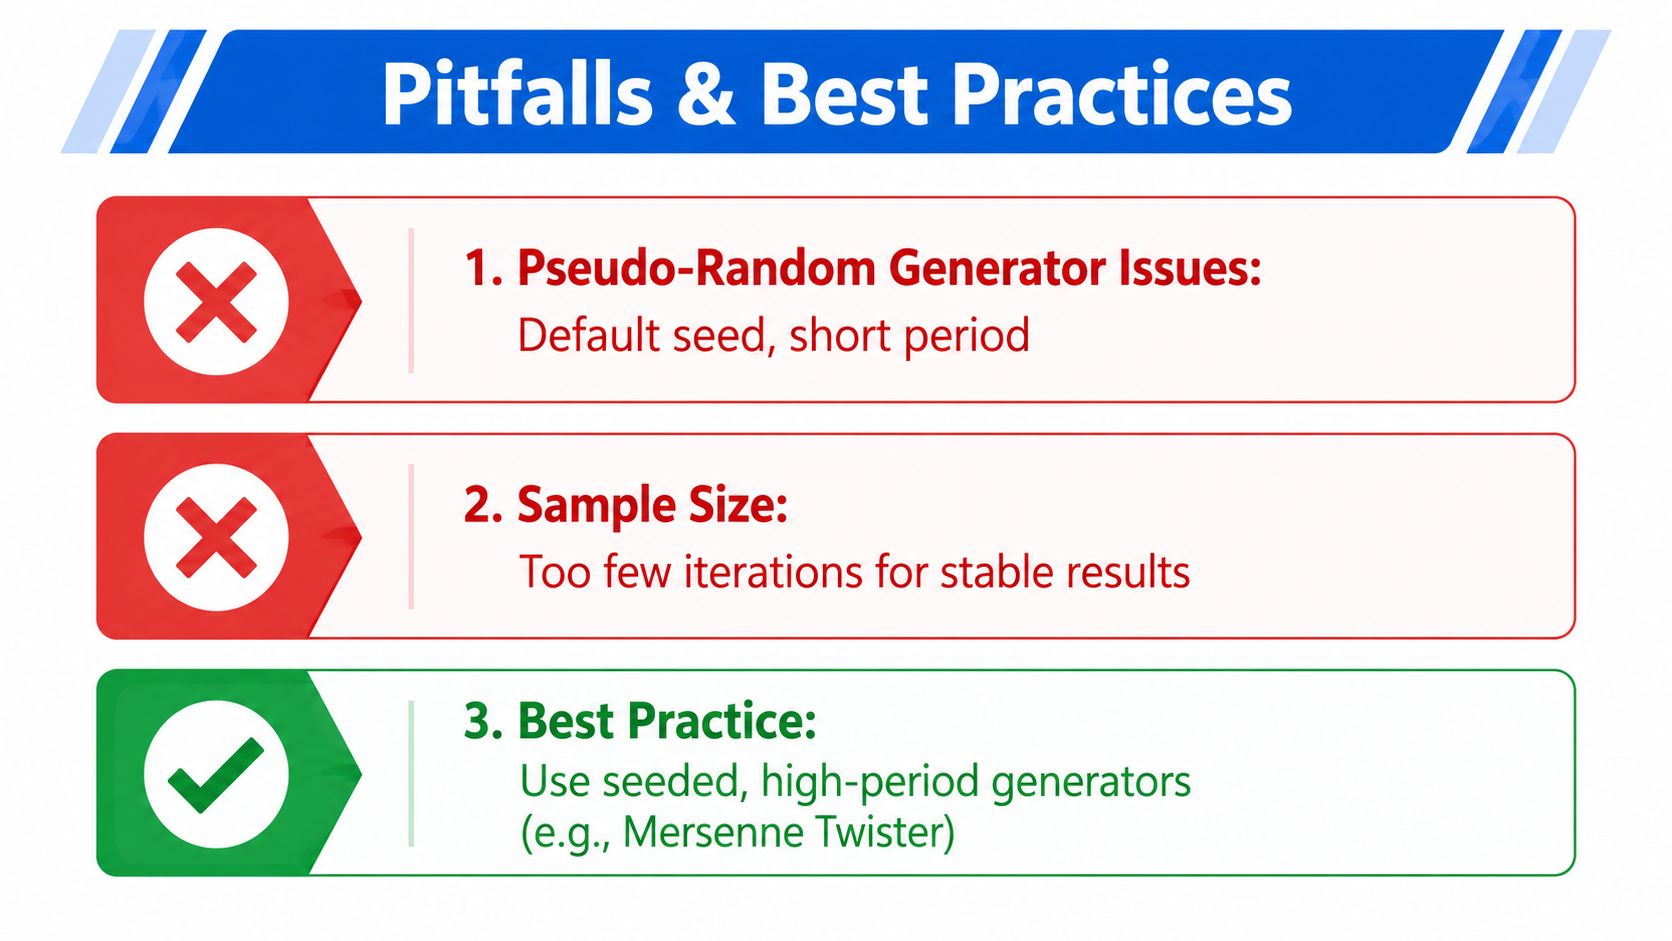
Un generatore pseudo-casuale è un meccanismo deterministico progettato per comportarsi come un campionamento casuale. Impostazioni predefinite scadenti, periodi brevi o il comportamento di rand() specifico del database possono creare pattern che contaminano i risultati. Impostate il seed del generatore in modo consapevole, usate un'implementazione ben conosciuta e verificate la distribuzione campionata invece di dare per scontato che la funzione sia adatta.
Gli input correlati sono un errore di modellazione più grave. Se la latenza a monte e il tempo di attesa in coda nel data warehouse aumentano insieme sotto carico, campionarli in modo indipendente farà sembrare la coda più tranquilla di quanto sia in realtà. Usate campioni storici congiunti, un modello di dipendenza o una copula quando la relazione è rilevante.
La convergenza richiede evidenze
Una media mobile che appare piatta non dimostra che le code si siano stabilizzate. Monitorate le statistiche che guidano la decisione, esaminate i trace plot e confrontate i risultati tra batch indipendenti. Per i modelli che usano un campionamento iterativo formale, la diagnostica di Gelman-Rubin può aiutare a valutare se le catene si sono mescolate adeguatamente, anche se non corregge un modello specificato male.
I quantili di coda richiedono un'attenzione particolare. Se il vostro alert dipende da un confine raro, un centro apparentemente regolare può coesistere con una coda instabile. Aumentate lo sforzo di simulazione, usate metodi di riduzione della varianza dove opportuno e riportate l'incertezza intorno al percentile stimato.
Adattate le distribuzioni con attenzione: usate uno storico pertinente, segmentate condizioni operative diverse e documentate le ipotesi degli esperti.
Controllate la riproducibilità: memorizzate il seed, i dettagli del generatore, la versione del modello e i parametri di input per ogni esecuzione.
Validate in modo indipendente: confrontate modelli semplici con risultati analitici o casi di test noti prima di fidarvi degli output di produzione.
Verificate le dipendenze: misurate le relazioni tra gli input e preservatele durante il campionamento.
Registrate i metadati di audit: conservate insieme impostazioni delle iterazioni, scelte delle distribuzioni, versioni del codice e risultati riepilogativi.
Non trattate mai la media come verità assoluta. Un risultato Monte Carlo è condizionato dal modello, dai dati e dal processo di campionamento. Più iterazioni possono far sembrare più preciso un modello sbagliato, non renderlo più corretto.
Mettere Monte Carlo al lavoro in una piattaforma dati enterprise
Il Monte Carlo operativo appartiene al normale percorso di esecuzione della piattaforma, non a un notebook abbandonato. Pianificate le simulazioni insieme all'ETL, versionatene i parametri e riscrivete i riepiloghi risultanti come metriche monitorate. Un modello che non può essere rieseguito e spiegato non è pronto per un alert enterprise.
Un'impostazione operativa pratica
Mantenete sottile il confine del servizio. L'ingestion dovrebbe fornire le osservazioni storiche, il componente di simulazione dovrebbe campionare e calcolare, e il livello di alerting dovrebbe valutare le soglie e avvisare i responsabili. Questa separazione permette agli ingegneri di modificare il modello senza riscrivere ogni consumatore a valle.
Preferite l'esecuzione nel database per i controlli ad alto volume, come conteggi delle partizioni, distribuzioni dei tassi di nulli e intervalli di freschezza. Usate Python o R per modelli dipendenti dal percorso, flussi di bootstrap o simulazioni che richiedono librerie statistiche specializzate. Il confine giusto è di solito determinato dallo spostamento dei dati e dalla complessità del modello.
Conservate metadati sufficienti a riprodurre ogni decisione:
Distribuzione di input: registrate il metodo di adattamento, i parametri, la finestra temporale della sorgente e la logica di segmentazione.
Configurazione della simulazione: salvate il numero di campioni, il generatore casuale, il seed e la versione del modello.
Riepiloghi dell'output: salvate percentili, probabilità di coda, medie e diagnostica di convergenza.
Contesto dell'alert: allegate la soglia, il valore osservato, il dataset coinvolto e la risposta del responsabile.
Evidenze di esecuzione: conservate stato dell'esecuzione, timestamp e dettagli dell'ambiente per le revisioni di audit.
Una piattaforma come la piattaforma dati enterprise di digna può fornire il contesto di monitoraggio circostante per comportamento dei dati, tempestività, validazione e modifiche di schema. L'output della simulazione dovrebbe comparire accanto ai normali segnali di freschezza e qualità, così i team possono confrontare il rischio previsto con gli incidenti osservati.
Prima del rilascio, verificate che il modello gestisca storico mancante, record in arrivo tardivo, schemi che cambiano, nuovi tentativi e guasti parziali del data warehouse. Poi eseguitelo in shadow mode, confrontate gli alert con il giudizio degli ingegneri e regolate le soglie solo dopo aver esaminato falsi positivi ed eventi non rilevati.
digna combina rilevamento delle anomalie nei dati, monitoraggio della tempestività, validazione e tracciamento dello schema, così i team possono trasformare segnali probabilistici in azioni operative. Visitate digna per scoprire come un'observability basata su Monte Carlo può inserirsi nel vostro ambiente dati enterprise.
Domande frequenti
Perché le stime deterministiche falliscono?
Perché una stima deterministica prende input fissi e produce un output fisso, e questa promessa regge solo quando gli input sono abbastanza stabili da giustificarla. Una stima puntuale nasconde la dispersione, che di solito è proprio la parte da cui dipende la decisione.
A quali quattro domande risponde una distribuzione e non una media?
Comportamento tipico, cioè quanto dura di solito l'aggiornamento; variazione operativa, cioè quanto sono disperse le durate; comportamento delle code, cioè con quale frequenza il job termina insolitamente tardi; e soglia decisionale, cioè a quale probabilità il team dovrebbe allertare qualcuno. Una media risponde solo alla prima.
Quali tre elementi bisogna tenere a mente?
Gli input incerti, il modello che li combina e l'output che si aggrega. Per una pipeline di dati gli input potrebbero essere il tempo di estrazione dalla sorgente, il tempo di trasformazione, il ritardo in coda nel data warehouse e il tempo di pubblicazione finale, ciascuno descritto come una distribuzione anziché come un numero.
La casualità negli input significa che i dati sono errati?
No. La casualità non equivale automaticamente a dati errati, e la tecnica Monte Carlo tratta la dispersione come un input anziché come un nemico. Uno SLA deterministico resta utile come contratto, ma non va scambiato per una previsione completa.
Quando conviene modellare l'intervallo anziché la media?
Ogni volta che una decisione dipende da un intervallo di esiti plausibili. Una singola estrazione casuale non dice quasi nulla, ed è per questo che la ripetizione conta: è la legge dei grandi numeri a trasformare molte estrazioni in una stima utilizzabile anziché in rumore.


