10 strumenti gratuiti di validazione dei dati per i data stack moderni
|
6
min di lettura

Una dashboard si rompe proprio prima della review settimanale con il management. Un modello di ML inizia a subire drift, ma nessuno se ne accorge finché le previsioni in produzione non appaiono sbagliate. Un report sul fatturato arriva con cifre assurde perché una colonna sorgente ha cambiato tipo tre job a monte. I team dati conoscono bene questo schema. I dati errati di solito falliscono prima in modo sottile, poi in modo pubblico.
I controlli manuali non scalano. E non sopravvivono alla crescita del team, ai passaggi di consegne o alla proliferazione delle pipeline. Allo stesso tempo, una piattaforma completa può sembrare eccessiva quando dovete solo validare DataFrame in Python, aggiungere test sul warehouse in dbt o intercettare lo schema drift in una pipeline di ML. È questo il divario in cui si trovano oggi molte organizzazioni.
Questa guida si concentra su strumenti gratuiti di validazione dei dati che risolvono problemi reali senza imporre troppo presto la scelta di una piattaforma. Spiega in che cosa eccelle ciascuno strumento, dove diventa scomodo e quando la strada gratuita smette di essere efficiente. Se state costruendo un primo livello di qualità, spesso basta per prevenire i guasti più comuni e ripristinare la fiducia nella pipeline.
Per trovare la soluzione giusta conviene scegliere in base al livello di esecuzione anziché a una checklist di funzionalità. Le categorie più comuni sono la validazione nel codice e sui DataFrame per i workflow Python, la validazione incentrata su warehouse e pipeline per gli stack SQL e di trasformazione, e la validazione per ML o big data per Spark e le pipeline di feature. Se vi serve anche un contesto analitico più ampio, questa roadmap per founder sulla data analytics è un utile complemento.
Indice
1. GX (in precedenza Great Expectations)
GX resta uno degli strumenti gratuiti di validazione dei dati più completi se volete un vero framework basato sulle expectation invece di qualche asserzione improvvisata. Si adatta a pipeline di warehouse, notebook, file, job Spark e workflow di CI. Il core open source fornisce il motore di validazione. Il livello cloud a pagamento è dove collaborazione e governance salgono di livello.
Ciò che rende GX utile nella pratica è la sua ampiezza. Potete validare schema, comportamento dei null, unicità, intervalli, pattern e regole di business personalizzate, poi pubblicare Data Docs leggibili dalle persone invece di seppellire gli errori nei log. Per i team che hanno bisogno di artefatti di validazione strutturati, è un vantaggio concreto rispetto a librerie più semplici basate solo sul codice.
Dove GX funziona meglio
GX dà il meglio quando la qualità dei dati diventa una responsabilità ingegneristica condivisa anziché un'abitudine confinata ai notebook. Funziona bene quando volete test versionati, revisionabili e collegati ai gate di deployment.
Profondità delle expectation: le expectation integrate coprono bene i controlli comuni e quelle personalizzate vi permettono di codificare la logica di business.
Output leggibili: i Data Docs aiutano analisti e ingegneri a esaminare gli errori senza leggere traceback grezzi.
Ampiezza delle integrazioni: sistemi SQL, file, Spark e Databricks sono tutti target di deployment comuni.
Una buona panoramica tecnica sul perché gli strumenti di verifica della validità siano importanti nelle pipeline moderne si trova in questa guida per padroneggiare la validazione dei dati.
Regola pratica: scegliete GX quando vi serve un framework, non solo una libreria. Se il vostro team vuole expectation revisionabili, output documentati e azioni sulla pipeline in caso di errore, GX è adatto. Se dovete solo validare un DataFrame pandas all'interno di uno script, di solito è troppo pesante.
Il compromesso è l'attrito di configurazione. GX ha concetti, struttura di progetto e configurazione che risultano impegnativi per i lavori piccoli. Non lo userei per validare una singola importazione CSV. Lo userei quando il livello di validazione deve sopravvivere a onboarding, code review, CI e passaggi di consegne tra più ingegneri.
Sito del prodotto: GX
2. Soda Core
Soda Core è un punto di partenza più snello per i team che amano i controlli dichiarativi e non vogliono l'impalcatura che accompagna GX. I controlli sono scritti in SodaCL, un linguaggio basato su YAML e accessibile per warehouse engineer, analytics engineer e team di piattaforma che eseguono la validazione in CI.
Il vantaggio pratico è la rapidità con cui si arriva al primo test utile. Potete attivare controlli sui null, sullo schema, sulla freschezza e sulle distribuzioni senza costruirci intorno molto framework. Questo rende Soda Core uno dei migliori strumenti gratuiti di validazione dei dati per i workflow basati su Git.
Perché i team scelgono Soda Core
Soda Core funziona meglio quando il team vuole file di policy leggeri invece di una logica di validazione pesantemente basata su Python. È adatto anche quando la validazione deve stare vicino all'automazione del deployment.
Modello di scrittura semplice: i controlli YAML sono facili da rivedere nelle pull request.
Esecuzione adatta ai warehouse: si collega ai warehouse più comuni, ai data lake e alle sorgenti basate su file.
Integrazione con la CI: il modello a CLI rende semplice eseguire i controlli durante i flussi di build o di rilascio.
Se state cercando di distinguere i test puntuali da un monitoraggio più ampio, vale la pena leggere questo confronto tra data observability e qualità dei dati.
Soda Core ha comunque dei limiti. La versione open source è solida per test e automazione, ma la collaborazione e gli alert più evoluti spingono verso il prodotto cloud. Rispetto a cataloghi di expectation più ampi, la sintassi di Soda è più leggera ma a volte più limitata.
Usate Soda Core quando il team preferisce file di test dichiarativi e un'adozione rapida. Evitatelo se vi serve un framework di validazione nativo Python e approfondito, con ampi pattern di expectation personalizzate.
Partite dalla documentazione: documentazione di Soda Core
3. Amazon Deequ

Deequ ha senso nel momento in cui il vostro problema di validazione diventa un problema di Spark. È stato creato per dataset su larga scala e offre vincoli dichiarativi, profilazione e suggerimento di vincoli sopra Spark. Se eseguite già carichi di data engineering nell'ecosistema JVM, Deequ risulta nativo.
Non è uno strumento generico per principianti. È una libreria di validazione per big data destinata a team che ragionano già in termini di job Spark, metriche distribuite e profilazione scalabile. In quell'ambiente, Deequ è una delle opzioni gratuite più pratiche disponibili.
Dove Deequ dà il meglio
Deequ è più forte quando la dimensione del dataset rende irrealistica una validazione riga per riga o incentrata sui notebook. Vi permette di dichiarare controlli come completezza, unicità e vincoli numerici, profilando nel contempo i dati per ottenere segnali aggiuntivi.
Ciò che apprezzo di più è il workflow di suggerimento dei vincoli. Su dataset poco conosciuti, impostare le prime regole di qualità è spesso la parte lenta. Deequ può aiutarvi a ricavare una prima versione invece di scrivere tutto da zero.
I suoi punti deboli sono prevedibili. È pensato prima di tutto per JVM e Spark, il reporting è più orientato al codice che al business e non offre il livello di presentazione curato che alcuni team si aspettano dagli strumenti moderni.
Se i vostri dati vivono in Spark e i vostri ingegneri gestiscono già job su cluster, Deequ è un'ottima scelta predefinita. Se il vostro team lavora in SQL, dbt o pandas, passerete troppo tempo ad adattare il workflow.
Sito ufficiale: Amazon Deequ
4. PyDeequ
PyDeequ esiste per una conformazione di team molto specifica: ingegneri fortemente orientati a Python che vogliono i controlli su scala Spark di Deequ, ma non vogliono spostare la loro interfaccia quotidiana su Scala. Se questo è il vostro stack, PyDeequ è il ponte.
Espone i concetti di Deequ tramite un'API Python continuando ad affidarsi a Spark dietro le quinte. Questo significa che mantenete l'accesso a vincoli, profilazione e controlli basati sullo storico delle metriche senza rinunciare alla struttura di progetto incentrata su Python che molti team dati preferiscono.
La scelta ideale per i team Python e Spark
PyDeequ è utile quando il codice della pipeline, il collante dell'orchestrazione e la configurazione della validazione vivono tutti in Python, ma il volume effettivo dei dati richiede l'esecuzione su Spark. Aiuta anche i team con competenze miste, in cui non tutti vogliono scrivere la logica di validazione nell'ecosistema JVM.
Prima di adottarlo, contano alcune realtà:
Spark resta necessario: PyDeequ non elimina la complessità infrastrutturale.
Il wrapper può restare indietro: i wrapper Python possono seguire in ritardo i rilasci di Deequ.
Gli output restano tecnici: otterrete risultati orientati al codice, non un'interfaccia curata.
È un buon strumento per una validazione guidata dall'ingegneria, non per comunicare lo stato di salute dei dati agli stakeholder. Se i vostri utenti sono data engineer che leggono log e metriche, non è un problema. Se gli analisti hanno bisogno di descrizioni leggibili degli errori, probabilmente vorrete un ulteriore livello intorno.
Documentazione: documentazione di PyDeequ
5. TensorFlow Data Validation (TFDV)
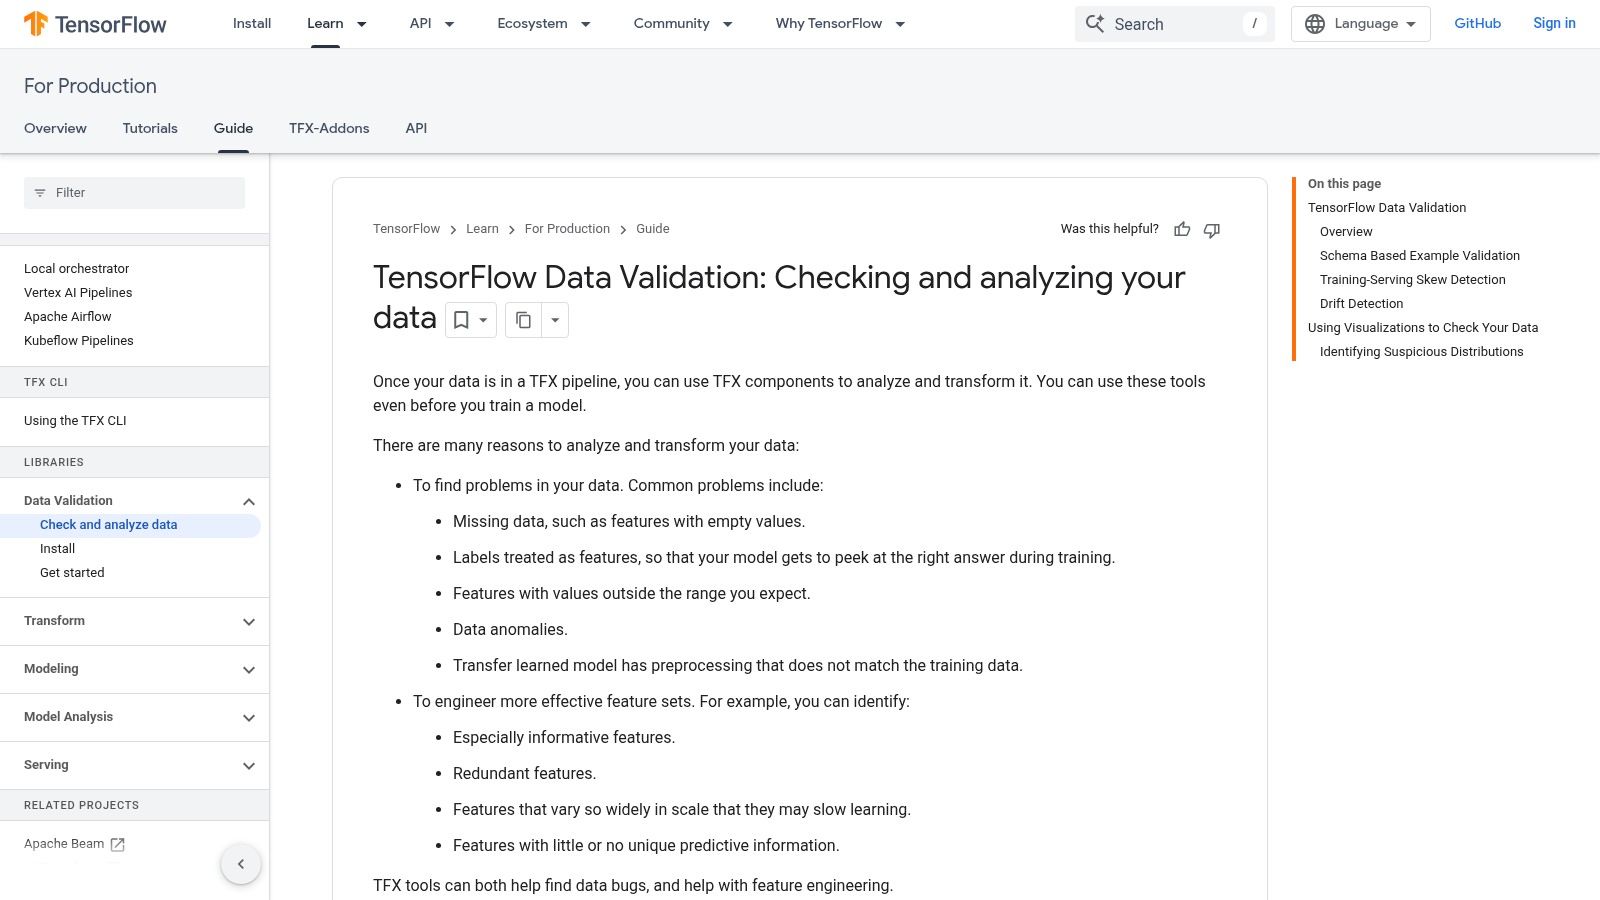
TFDV è costruito appositamente per i dati di ML, e questa focalizzazione conta. Un test sul warehouse può dirvi che una colonna è nulla troppo spesso. Di solito non vi dirà se le distribuzioni delle feature tra training e serving sono divergenti in un modo che minaccia l'affidabilità del modello. TFDV è stato creato per questa classe di problemi.
All'interno di workflow in stile TFX, TFDV profila i dati, inferisce gli schemi e segnala anomalie, drift e skew. Può anche scalare con Apache Beam, il che lo rende adatto a pipeline di ML più grandi invece di restare confinato all'ispezione nei notebook.
Che cosa intercetta TFDV che i test SQL non vedono
TFDV è più adatto dei comuni strumenti gratuiti di validazione dei dati quando il rischio principale riguarda le feature, non le tabelle. Training-serving skew, drift delle feature e incongruenze di schema colpiscono direttamente la qualità del modello, e TFDV è costruito per esaminare proprio questi pattern.
I sistemi di rilevamento delle anomalie basati su AI possono apprendere il comportamento normale, inclusi stagionalità e trend, e usare soglie dinamiche che riducono i falsi positivi dal 30 al 50 percento rispetto ai metodi statici basati su regole, secondo la panoramica di digna sulle tecniche di rilevamento delle anomalie con AI. Questo principio è particolarmente rilevante nelle pipeline di ML, dove le soglie statiche invecchiano spesso male.
Lo svantaggio è il peso dello stack. Se non siete già nel mondo TensorFlow e TFX, TFDV può sembrare un apparato eccessivo per un piccolo team. Non è lo strumento che sceglierei per un'analytics engineering incentrata su SQL.
Pagina del prodotto: TensorFlow Data Validation
6. Frictionless Framework
Frictionless è lo strumento a cui ricorro quando il problema di qualità dei dati è in realtà un problema di confezionamento dei dati tabellari. I CSV arrivano dai fornitori. I file Excel passano da un team all'altro. I payload JSON devono rispettare uno schema documentato. In queste situazioni Frictionless è veloce, pratico e molto meno vincolante dei framework incentrati sul warehouse.
Il suo punto di forza sono gli standard. Le convenzioni Table Schema e Data Package rendono lo scambio di dati più ripetibile, il che è utile quando la governance conta quanto l'ingegneria. Per i workflow ricchi di file, questo orientamento agli standard è un vantaggio reale.
Ideale per lo scambio di file e i contratti tabellari
Frictionless offre una CLI e un'API Python per validare file e dataset tabellari in formati come CSV, Excel, JSON e tabelle basate su SQL. È facile da adottare perché il modello mentale è semplice: definite schema e metadati, poi validate rispetto a essi.
Questo tipo di capacità orientata agli standard è un requisito comune nelle valutazioni degli strumenti open source per la qualità dei dati, soprattutto quando i dati attraversano i confini organizzativi.
Dove non basta è la logica relazionale complessa. Se vi servono regole di business tra più tabelle, controlli di freschezza su scala di warehouse o un reporting visivo più ricco, Frictionless non sostituirà un livello di validazione più ampio.
Il risultato più rapido con Frictionless si ottiene al confine. Validate i file in ingresso prima che entrino nella pipeline. È lì che intestazioni errate, tipi corrotti e righe malformate costano meno da intercettare.
Sito ufficiale: Frictionless Framework
7. Test di dbt Core
Se le vostre trasformazioni girano già in dbt, aggiungere un altro runtime di validazione è spesso superfluo. I test integrati di dbt Core coprono bene le basi: not_null, unique, relationships e accepted_values. Combinandoli con test SQL personalizzati e package come dbt_utils o dbt_expectations, potete costruire un solido livello di qualità nativo del warehouse.
Il grande vantaggio è la semplicità operativa. I test vivono accanto al codice di trasformazione, condividono lo stesso processo di version control e girano nello stesso workflow di deployment. Per i team di analytics engineering, questo stretto accoppiamento di solito vale più di un reporting appariscente.
Il modo giusto di usare i test dbt
I test dbt funzionano meglio quando proteggono i contratti dei modelli e le ipotesi sul warehouse. Non dovrebbero diventare un deposito per ogni possibile problema di qualità. Teneteli vicino al confine della trasformazione e usate SQL personalizzato solo dove quelli integrati non arrivano.
Alcune pratiche funzionano bene:
Testate le garanzie del modello: usate i test integrati per il comportamento delle chiavi primarie, l'intolleranza ai null, le dimensioni ammesse e l'integrità referenziale.
Versionate la qualità insieme alle trasformazioni: mantenete i test nello stesso processo di review delle modifiche allo schema e alla logica di business.
Estendete con cautela: i controlli comportamentali complessi possono diventare difficili da mantenere se ogni caso limite si trasforma in logica di macro.
Se la freschezza è un problema ricorrente nel vostro warehouse, questa guida alla source freshness di dbt spiega dove dbt aiuta e dove potrebbe servirvi un monitoraggio più attivo.
I test di dbt Core non vi danno un livello di osservabilità completo. Vi dicono se le condizioni dichiarate erano soddisfatte al momento dell'esecuzione dei test. Non costruiscono automaticamente un quadro ampio di distribuzioni che cambiano, volumi insoliti o pattern di arrivo in ritardo su tutta la piattaforma.
Documentazione del prodotto: documentazione di dbt
8. Pandera

Pandera è uno dei migliori strumenti gratuiti di validazione dei dati per i team Python che passano il loro tempo su pandas, Dask o Polars. Tratta i DataFrame come oggetti tipizzati e testabili e vi permette di dichiarare schema e controlli in un modo naturale per ingegneri che scrivono già unit test in Python.
È un workflow molto diverso da quello dei validatori per warehouse. Pandera vive all'interno di script, librerie, notebook e suite di test. Se le vostre trasformazioni dei dati avvengono prima del warehouse, o al di fuori di esso, Pandera è spesso la scelta più pulita.
Dove Pandera è più forte
Pandera brilla quando volete un feedback immediato all'interno del codice. Potete definire tipi di colonna, comportamento dei nullable, controlli statistici e validatori personalizzati, poi fallire subito, prima che frame errati proseguano lungo la pipeline.
Questo feedback precoce conta perché gli strumenti più economici comportano spesso dei compromessi. In un benchmark di nove strumenti di validazione dei dati su un set standardizzato di 500 record, i piani gratuiti o a basso costo variavano dal 65 al 99 percento di accuratezza, mentre la velocità di esecuzione andava da 2 a 60 secondi per record, secondo questo confronto tra strumenti di validazione dei dati. La lezione non è che ogni strumento vada confrontato direttamente con Pandera, ma che gli strumenti gratuiti differiscono molto in ciò per cui sono ottimizzati.
Il compromesso di Pandera è l'ambito. Non è un orchestratore per warehouse e i suoi output sono pensati per gli sviluppatori più che per una revisione allargata agli stakeholder. Va benissimo se chi consuma la validazione è l'ingegnere che scrive la pipeline.
Documentazione: documentazione di Pandera
9. whylogs
whylogs segue una strada diversa dai framework basati sulle asserzioni. Invece di partire da test pass/fail, si concentra su profili statistici leggeri che potete confrontare nel tempo. Questo lo rende prezioso nel monitoraggio dei dati in produzione, in particolare per i sistemi di ML e quelli vicini allo streaming, dove il drift conta quanto la rigorosa validità dello schema.
Questo modello basato prima di tutto sulla profilazione è utile quando non conoscete ancora le soglie rigide giuste. Raccogliete i riepiloghi, seguite i cambiamenti nel tempo e poi decidete quali deviazioni meritano un'escalation.
Prima la profilazione, poi le asserzioni
whylogs è particolarmente adatto quando i dati cambiano continuamente e vi interessano trend, intervalli e variazioni più che sole regole deterministiche. Funziona con input strutturati e non strutturati, e l'overhead della profilazione è abbastanza basso da inserirsi nei workflow ricorrenti.
Il rilevamento delle anomalie basato su AI segue in genere uno schema: raccolta e normalizzazione dei dati da sorgenti come log, sensori e traffico di rete, addestramento di una baseline sul comportamento normale, valutazione in tempo reale dei nuovi dati rispetto alle soglie apprese e infine interpretazione nel contesto delle deviazioni segnalate, come illustrato nella spiegazione di Plixer sul rilevamento delle anomalie basato su AI. whylogs non equivale a una piattaforma di osservabilità completa, ma questo ciclo è un utile modello mentale per il monitoraggio basato sui profili.
Ciò che non funziona bene con whylogs è aspettarsi che si comporti come un classico strumento di asserzioni. Non è il primo strumento a cui ricorrere quando serve applicare rigorosamente regole di business al caricamento di una tabella. Lo si sceglie quando il team ha bisogno di profilazione continua e di consapevolezza del drift.
Documentazione: documentazione di whylogs
10. Pydantic (v2)
Pydantic è la risposta giusta sorprendentemente spesso, anche se molti team non lo considerano in primo luogo uno strumento di validazione dei dati. Se il vostro problema principale è validare record, payload, configurazioni e oggetti di ingestione prima che raggiungano i sistemi a valle, Pydantic è difficile da battere.
Il suo approccio basato sui modelli è semplice. Definite campi tipizzati, imponete la rigidità dove serve, aggiungete validatori personalizzati e rifiutate gli input non validi vicino al confine dell'applicazione. Per le pipeline alimentate da API e l'ingestione guidata dagli eventi, è esattamente lì che vanno messi i controlli di qualità.
Ideale per i controlli a livello di record
Pydantic (v2) è la scelta migliore quando ogni singolo oggetto conta più delle proprietà aggregate della tabella. È una situazione comune nei servizi di ingestione, nei consumer CDC, nelle configurazioni di orchestrazione e negli input dei servizi di ML.
Usatelo quando vi serve:
Validazione tipizzata: imporre una struttura ai record prima che arrivino nello storage.
Logica personalizzata: aggiungere validatori per regole di dominio che i soli type hint non possono esprimere.
Adozione rapida: i team Python possono introdurlo senza riprogettare l'intero stack.
Il limite è evidente. Pydantic non valida lo stato del warehouse, la freschezza delle tabelle o il drift delle distribuzioni su grandi dataset. Valida oggetti. Ecco perché completa gli strumenti per pipeline e warehouse invece di sostituirli.
Il mercato degli strumenti per la qualità dei dati continua a espandersi man mano che i team adottano livelli di validazione e osservabilità più automatizzati. Fortune Business Insights prevede che il mercato globale degli strumenti per la qualità dei dati raggiunga 15,96 miliardi di USD entro il 2034, partendo da 3,94 miliardi di USD nel 2026, con un CAGR superiore al 17 percento, secondo la sua analisi del mercato degli strumenti per la qualità dei dati. È un segnale a livello di mercato, ma la conclusione ingegneristica è più semplice: la validazione non è più un'infrastruttura facoltativa.
Sito del prodotto: Pydantic
I 10 migliori strumenti gratuiti di validazione dei dati: confronto delle funzionalità
Strumento | Funzionalità principale | Pubblico di riferimento 👥 | Punto di forza distintivo ✨/🏆 | Qualità della UX ★ | Prezzo/valore 💰 |
|---|---|---|---|---|---|
GX (Great Expectations) | Validazione di tabelle e record basata su expectation; Data Docs leggibili dalle persone | Data engineer, QA, team di governance 👥 | Ricco catalogo di expectation + Data Docs; gate sulla pipeline 🏆✨ | ★★★★, maturo, orientato alla governance | 💰 Core open source; GX Cloud a pagamento |
Soda Core | Controlli YAML per schema, null, freschezza; adatto alla CI | Ingegneri orientati a Git, SRE 👥 | YAML leggero e facile integrazione con la CI ✨ | ★★★, avvio semplice, catalogo più ridotto | 💰 Open source; Soda Cloud a pagamento per UI/alert |
Amazon Deequ | Vincoli dichiarativi sulle colonne, profilazione su scala Spark | Team big data su Spark 👥 | Scala su Spark; suggerimento dei vincoli 🏆 | ★★★★, forte per job ad alto volume | 💰 Open source; gira sulla vostra infrastruttura |
PyDeequ | Wrapper Python per eseguire i vincoli Deequ su DataFrame Spark | Team Python + Spark 👥 | Porta Deequ nei workflow Python ✨ | ★★★, utile ma dipendente da Spark/runtime | 💰 Open source; richiede Spark |
TensorFlow Data Validation (TFDV) | Profilazione delle feature di ML, inferenza dello schema, rilevamento di drift/skew | ML engineer, utenti TFX 👥 | Rilevamento del drift training/serving su larga scala 🏆 | ★★★★, potente per il ML, stack più pesante | 💰 Open source; serve infrastruttura Beam/TFX |
Frictionless Framework | Validazione di file/dati tabellari tramite Table Schema e Data Package | Team di scambio dati, governance e file 👥 | Orientato agli standard, adozione rapida ✨ | ★★★, eccellente per i file, visualizzazione limitata | 💰 Open source; leggero |
Test di dbt Core | Test dichiarativi SQL/YAML versionati con le trasformazioni | Warehouse/analytics engineer che usano dbt 👥 | I test vivono con il codice e con i gate di CI 🏆 | ★★★★, integrato nel workflow di trasformazione | 💰 dbt Core gratuito; piani dbt Cloud a pagamento |
Pandera | Schemi e controlli dichiarativi sui DataFrame per pandas/Dask/Polars | Data scientist, sviluppatori ETL, autori di unit test 👥 | Schemi pythonici + integrazione con i test ✨ | ★★★★, ergonomia pensata per gli sviluppatori | 💰 Open source; focalizzato sull'elaborazione in memoria |
whylogs | Profilazione leggera dei dataset e riepiloghi in serie temporali | Team MLOps e di monitoraggio, dati in streaming 👥 | Profili a basso overhead per il rilevamento di drift e anomalie ✨ | ★★★, ottimo per la profilazione, nessuna UI nativa | 💰 Open source; si integra con altri strumenti |
Pydantic (v2) | Validazione tipizzata ad alte prestazioni di record e payload (core in Rust) | App Python, validazione dei record ETL, ingegneri 👥 | Validazione a runtime veloce e ampia diffusione 🏆 | ★★★★, veloce, ottima documentazione e community | 💰 Open source; focus a livello di record |
Quando passare a una piattaforma di data observability
Gli strumenti open source e gratuiti sono eccellenti quando la superficie di validazione è ristretta e l'owner è chiaro. Un team Python può usare Pandera o Pydantic in modo efficace. Un team dbt può andare lontano con i test integrati. Un gruppo di piattaforma fortemente basato su Spark può coprire molto terreno con Deequ o PyDeequ. I problemi iniziano quando queste sacche di validazione crescono in modo indipendente.
A quel punto il costo cambia natura. La questione non è se gli strumenti funzionano, ma se il team riesce ancora a gestirli in modo efficiente. I test si accumulano tra notebook, file YAML, modelli dbt, job Spark e step di CI. Qualcuno deve mantenerli, spiegare gli errori, instradare gli alert, sopprimere il rumore e capire quale incidente conta. Di solito è il momento in cui i team si rendono conto di non avere più un problema di validazione, ma un problema di coordinamento.
Un'altra modalità di guasto comune è l'alert fatigue. Le regole statiche invecchiano male nei sistemi in esercizio. I volumi di dati cambiano, compare la stagionalità, le tempistiche delle sorgenti variano e soglie che sembravano sensate in fase di configurazione diventano rumorose o cieche in seguito. Gli ingegneri finiscono così per passare il tempo a regolare le regole invece di costruire prodotti. Peggio ancora, gli utenti di business continuano a essere i primi ad accorgersi di dashboard rotte o report non aggiornati. È il segnale più chiaro che lo stack attuale non offre abbastanza visibilità.
Una piattaforma come digna diventa utile quando vi serve un unico sistema per rilevamento delle anomalie, tempestività, tracciamento dello schema e validazione a livello di record, invece di strumenti separati per ciascun livello. digna è progettata per eseguire le analisi all'interno dell'ambiente database del cliente, un aspetto importante per i team attenti alla privacy che non possono spostare i dati di produzione in un altro sistema controllato da un fornitore. Offre inoltre a ingegneri e utenti di business un'interfaccia condivisa per trend, tempi di consegna, modifiche dello schema ed esiti delle validazioni.
La differenza pratica è che smettete di affidarvi solo ad asserzioni predefinite. digna apprende il comportamento di base e segnala variazioni insolite di freschezza, volume e distribuzioni senza costringervi a scrivere prima ogni regola a mano. Questo conta nei grandi patrimoni di dati, dove le modalità di guasto sconosciute sono spesso più pericolose di quelle note. Una regola a livello di record può intercettare un valore errato. Non intercetterà necessariamente una sottile variazione di distribuzione o un pattern di arrivo inaspettatamente in ritardo su un dataset critico.
Questo non significa che gli strumenti gratuiti di validazione dei dati siano un vicolo cieco. Non lo sono. Sono il punto di partenza giusto per molti team e, in alcuni ambienti, resteranno la scelta giusta anche nel lungo periodo. Ma esiste una chiara soglia di maturità. Se il vostro team passa più tempo a mantenere i test che a rilasciare data product, se il contesto sulla qualità è frammentato tra gli strumenti o se gli stakeholder non hanno ancora una visione centralizzata dello stato di salute dei dati, avete superato l'approccio strumento per strumento.
È allora che una piattaforma di osservabilità più ampia smette di essere un "nice to have" e diventa infrastruttura operativa. Se volete un complemento pratico a questa discussione, questi consigli di Surnex per l'implementazione delle dashboard sono utili per riflettere su come una qualità dei dati monitorata supporti la produzione di analisi affidabili.
digna è adatta ai team che sono andati oltre i controlli isolati e hanno bisogno di un unico sistema operativo per anomalie dei dati, tempestività, tracciamento dello schema e validazione a livello di record. Se il vostro stack attuale intercetta alcuni problemi ma lascia ancora gli ingegneri a inseguire alert rumorosi e gli utenti di business a scoprire per primi i guasti, scoprite digna come passo successivo.
Guardate come digna lo fa nella pratica: piattaforma di gestione della qualità dei dati.
Qualunque strumento scegliate, assicuratevi che copra le relazioni tra le tabelle, non solo le singole colonne. Ecco come configurare un controllo di integrità referenziale passo dopo passo.
Domande frequenti
Quali sono i migliori strumenti gratuiti di validazione dei dati?
Le opzioni open source più diffuse sono GX (in precedenza Great Expectations), Soda Core, Amazon Deequ e PyDeequ, e TensorFlow Data Validation, ciascuna più forte in uno stack diverso: Python, Spark o SQL.
Gli strumenti gratuiti di validazione dei dati bastano per l'uso enterprise?
Funzionano bene per controlli definiti e gestiti nel codice all'interno di una pipeline. Ciò che in genere non offrono sono baseline apprese, copertura multipiattaforma, gestione degli alert e il reporting operativo di cui un team dati enterprise ha bisogno intorno a essi.
Qual è la differenza tra validazione dei dati e monitoraggio della qualità dei dati?
La validazione risponde a una domanda che sapete già di dover porre: una colonna non deve essere NULL, un valore deve rispettare un formato. Il monitoraggio sorveglia i cambiamenti per cui nessuno ha scritto una regola, come una tabella che perde silenziosamente un terzo delle sue righe.
Quale strumento gratuito funziona meglio con Spark?
Deequ e PyDeequ sono costruiti per i carichi di lavoro Spark, mentre TensorFlow Data Validation si adatta alle pipeline di machine learning. Soda Core e GX sono usati più spesso dove dominano SQL e Python.
Qual è il costo nascosto degli strumenti gratuiti di validazione?
La manutenzione. Regole, soglie e suite di test devono essere scritte e mantenute aggiornate per ogni dataset, e questo impegno cresce con ogni nuova tabella aggiunta alla piattaforma.


