Come configurare un controllo di integrità referenziale (passo dopo passo)
|
6
min di lettura

Una foreign key che non punta a nulla non genera alcun errore. La riga viene caricata, il successivo inner join la scarta e un report mostra zero dove dovrebbe esserci 82. Un controllo di integrità referenziale è una regola di validazione dei dati che verifica che ogni valore di una colonna figlia, o di un insieme di colonne, esista nella tabella padre di riferimento, e segnala le righe per cui non è così.
La maggior parte delle piattaforme analitiche non lo esegue al posto vostro. Snowflake tratta le foreign key sulle tabelle standard come facoltative e non applicate, e BigQuery afferma chiaramente che la responsabilità di mantenerle è vostra. Redshift e Databricks si comportano allo stesso modo. Il controllo deve trovarsi altrove.
Questa guida spiega come verificare l'integrità referenziale nella pratica: prima le decisioni da prendere (relazioni, colonne, NULL, soglie, tempistiche), poi la configurazione in digna: pochi campi, nessuna riga di SQL. Se volete partire dal concetto, iniziate dalla nostra guida all'integrità referenziale e ai record orfani.
Punti chiave
Verificate prima le relazioni su cui si basano i join dei vostri report: tabelle dei fatti verso le dimensioni e record figli verso i padri, ordinati in base a ciò che si rompe quando falliscono.
Usate esattamente le colonne di join su entrambi i lati. Una chiave composta viene verificata come combinazione ed entrambi gli elenchi di colonne devono avere la stessa lunghezza e lo stesso ordine.
Una foreign key NULL non fa fallire un controllo di integrità referenziale. Se il riferimento è obbligatorio, aggiungete una regola not-null separata.
Usate una tolleranza zero per i dati finanziari e clinici e una soglia relativa per le tabelle di grandi dimensioni con una coda nota di riferimenti in arrivo tardivo.
In digna il controllo è una regola di tipo Referential Integrity: scegliete le colonne, scegliete dove devono esistere, impostate due soglie e salvate. Viene eseguito all'interno del vostro database a ogni ispezione.
Indice
Che cos'è un controllo di integrità referenziale?
Quali relazioni conviene verificare per prime?
Come si scelgono le colonne e le chiavi composte?
Che cosa dovrebbe significare una foreign key NULL?
Quale soglia dovrebbe usare un controllo di integrità referenziale?
Quando dovrebbe essere eseguito un controllo di integrità referenziale?
Come si configura un controllo di integrità referenziale in digna?
Come appare l'SQL equivalente?
Come si interpreta un controllo di integrità referenziale fallito?
Da dove iniziare?
Che cos'è un controllo di integrità referenziale?
Un controllo di integrità referenziale prende una colonna, o un insieme di colonne, di una tabella figlia e verifica che ogni valore valorizzato esista anche nella tabella padre di riferimento. Le righe che trovano un padre superano il controllo. Quelle che non lo trovano sono orfane e falliscono. Il risultato è un conteggio dei superati, un conteggio dei falliti e, se li richiedete, le righe che falliscono. Lo troverete anche chiamato controllo delle foreign key o validazione dell'integrità referenziale.
Un vincolo di foreign key agisce in fase di scrittura e rifiuta l'inserimento. Un controllo agisce dopo il caricamento e vi dice quanta parte dei dati caricati non punta a nulla. Dove le chiavi dichiarate sono solo informative, il controllo è l'unica verifica di cui disponete davvero.
Approccio | Quando agisce | Cosa succede a un orfano | Funziona dove le FK non sono applicate | Cosa si ottiene |
|---|---|---|---|---|
Vincolo di foreign key | All'inserimento o all'aggiornamento | Rifiutato; il caricamento fallisce | No, la dichiarazione è solo un'indicazione | Un messaggio di errore |
Query SQL ad hoc | Quando qualcuno si ricorda di eseguirla | Nulla, finché qualcuno non controlla | Sì | Un result set nel client SQL di qualcuno |
Controllo di integrità referenziale in digna | A ogni ispezione, pianificata o su richiesta | Caricato, conteggiato ed elencato | Sì, anche tra connessioni a database diversi | Conteggi di superati/falliti, uno stato rispetto alla vostra soglia, le righe che falliscono |
Quali relazioni conviene verificare per prime?
Verificate per prime le relazioni su cui si basano effettivamente i join dei vostri report e dei job a valle: tabelle dei fatti verso le loro dimensioni e record figli verso i loro padri. Un collegamento interrotto in questi punti cambia i numeri che le persone leggono e firmano. Una relazione che nessuno interroga può aspettare.
Un rapido inventario vi fornisce un elenco ordinato per priorità:
Elencate i join tra fatti e dimensioni. Registrazioni contabili verso conti, sinistri verso pazienti, record di chiamata verso abbonati, somministrazioni di farmaci verso l'anagrafica prodotti.
Elencate i join tra figli e padri. Righe d'ordine verso ordini, diagnosi verso ricoveri, garanzie verso prestiti.
Contrassegnate quelli che alimentano report, fatturazione o segnalazioni regolamentari. Un inner join in queste query scarta gli orfani senza lasciare traccia.
Contrassegnate quelli caricati da job o sistemi diversi. Un figlio che arriva prima del suo padre è un orfano.
Iniziate dai primi cinque-dieci. Aggiungete gli altri quando qualcuno è responsabile dei risultati.
Se volete dimensionare il problema prima di configurare qualsiasi cosa, le query in trovare i record orfani con SQL vi forniscono un conteggio una tantum per ciascuna relazione.
Come si scelgono le colonne e le chiavi composte?
Usate esattamente le colonne utilizzate dal join, su entrambi i lati e nello stesso ordine. Se il padre è identificato da due colonne, verificatele insieme come chiave composta. Verificare ogni colonna singolarmente lascia passare combinazioni che non esistono da nessuna parte nel padre.
I codici di reparto sono un buon esempio. Se ogni ospedale di un gruppo ha un reparto chiamato ICU-1, una riga con ospedale 2 e ICU-1 supera un controllo su una sola colonna ward_code purché l'ospedale 1 abbia quel reparto. Solo la coppia (hospital_id, ward_code) lo intercetta. digna verifica la combinazione quando scegliete più colonne e rifiuta elenchi di colonne di lunghezza diversa invece di verificare una condizione più debole.
Altri due aspetti da definire prima:
Puntate alla chiave del padre, non a un'etichetta. Verificate
product_coderispetto alproduct_codedell'anagrafica, non rispetto a un nome prodotto che qualcuno potrebbe modificare.Rendete confrontabili entrambi i lati. Un codice memorizzato come testo con zeri iniziali da un lato e come numero dall'altro produce orfani che non sono reali. Normalizzatelo in una vista e verificate la vista: in digna una data source può essere una tabella, una vista o un'istruzione SQL personalizzata.
Che cosa dovrebbe significare una foreign key NULL?
Decidete in anticipo se una foreign key NULL è consentita. Un controllo di integrità referenziale verifica se un valore esiste nel padre, e un NULL non ha alcun valore da cercare, quindi digna ignora i NULL in questo controllo. Se il riferimento è obbligatorio, aggiungete una regola not-null separata, così un valore mancante e un valore orfano emergono come risultati distinti.
Alcuni riferimenti sono legittimamente facoltativi: un medico inviante, un codice promozionale, un conto padre per un cliente di primo livello. Altri non lo sono mai: ogni registrazione contabile ha un conto, ogni dose somministrata ha un prodotto. Tenerli separati rende evidente la correzione: un riferimento mancante torna al sistema di acquisizione, uno orfano ai master data o all'ordine di caricamento.
Cosa volete intercettare | Tipo di regola digna | Esempio |
|---|---|---|
Valore presente ma non nel padre | Referential Integrity |
|
Valore mancante dove è obbligatorio | Rule |
|
Chiave presente più di una volta nel padre | Uniqueness |
|
Anche la terza riga è importante: una chiave padre duplicata non crea orfani, ma raddoppia ogni riga che vi si collega tramite join.
Quale soglia dovrebbe usare un controllo di integrità referenziale?
Usate una tolleranza zero per i dati finanziari e clinici, dove un orfano corrisponde a un numero sbagliato in un rendiconto o a una dose mancante nella cartella di un paziente. Usate una soglia relativa per le tabelle molto grandi in cui una piccola coda nota di riferimenti in arrivo tardivo è normale e solo un salto oltre quella coda merita attenzione.
digna assegna a ogni regola una Threshold Mode. Absolute confronta il numero di record falliti. Relative confronta i record falliti divisi per i record valutati, come frazione, quindi 0.01 significa l'uno per cento. Ogni modalità ha due livelli: sopra l'Info threshold lo stato è Uncertain, sopra il Warn threshold è Failed, altrimenti Passed. Entrambi sono impostati a zero per impostazione predefinita, quindi una nuova regola fallisce con un solo record errato finché non decidete diversamente.
Situazione | Threshold Mode | Info | Warn | Effetto |
|---|---|---|---|---|
Registrazioni contabili verso conti, dosi verso l'anagrafica prodotti | Absolute | 0 | 0 | Un solo orfano fa fallire l'esecuzione |
Stessi dati, un record isolato dovrebbe essere segnalato prima di far fallire il controllo | Absolute | 0 | 1 | Un orfano è Uncertain, due o più Failed |
Record di eventi o di chiamate con dimensioni note in arrivo tardivo | Relative | 0.001 | 0.01 | Oltre lo 0,1% Uncertain, oltre l'1% Failed |
Partite con regole rigorose e allentatele solo per un motivo che potete mettere per iscritto.
Quando dovrebbe essere eseguito un controllo di integrità referenziale?
Eseguitelo dopo ogni caricamento della tabella figlia e anche dopo i caricamenti del padre, perché gli orfani compaiono ogni volta che le due tabelle arrivano in ordine sbagliato. In digna la regola viene eseguita a ogni ispezione della sua data source, pianificata o su richiesta, quindi allineate l'ispezione al caricamento anziché al calendario della reportistica.
Un controllo di fine mese trova un mese intero di orfani tutti insieme, con il report già in scadenza. Un controllo dopo ogni caricamento ne trova quelli di un solo giorno, mentre chi ha eseguito il caricamento ricorda ancora cosa è cambiato. Il costo è un join per esecuzione, eseguito all'interno del database sorgente, senza copiare nulla all'esterno. Quando fallisce, avvisate il team responsabile dei dati.
Come si configura un controllo di integrità referenziale in digna?
In digna un controllo di integrità referenziale è una regola di digna Data Validation di tipo Referential Integrity. Scegliete le colonne della vostra data source, scegliete la data source e le colonne in cui devono esistere, impostate due soglie e salvate. Non c'è SQL da scrivere e la configurazione richiede meno di un minuto.
Andate in Configuration, selezionate la data source (qui
hospital_medication_administrations), aprite la scheda Data Validation e fate clic su Add Rule. Si apre la finestra di dialogo Add Data Validation Rule.Inserite un Name e una Description:
hc_product_in_master, "Ogni prodotto somministrato esiste nell'anagrafica prodotti della farmacia".Impostate Type su Referential Integrity. Le altre opzioni sono Rule e Uniqueness.
In Attributes, scegliete la colonna di questa data source:
product_code.In must exist in, scegliete la Data Source (
hospital_medications) e i relativi Attributes (product_code). Per una chiave composta, scegliete più colonne su entrambi i lati nello stesso ordine.Scegliete la Threshold Mode e impostate l'Info threshold e il Warn threshold. L'esempio usa Absolute, Info 0, Warn 1.
Salvate. Da questo momento la regola viene eseguita a ogni ispezione della data source.
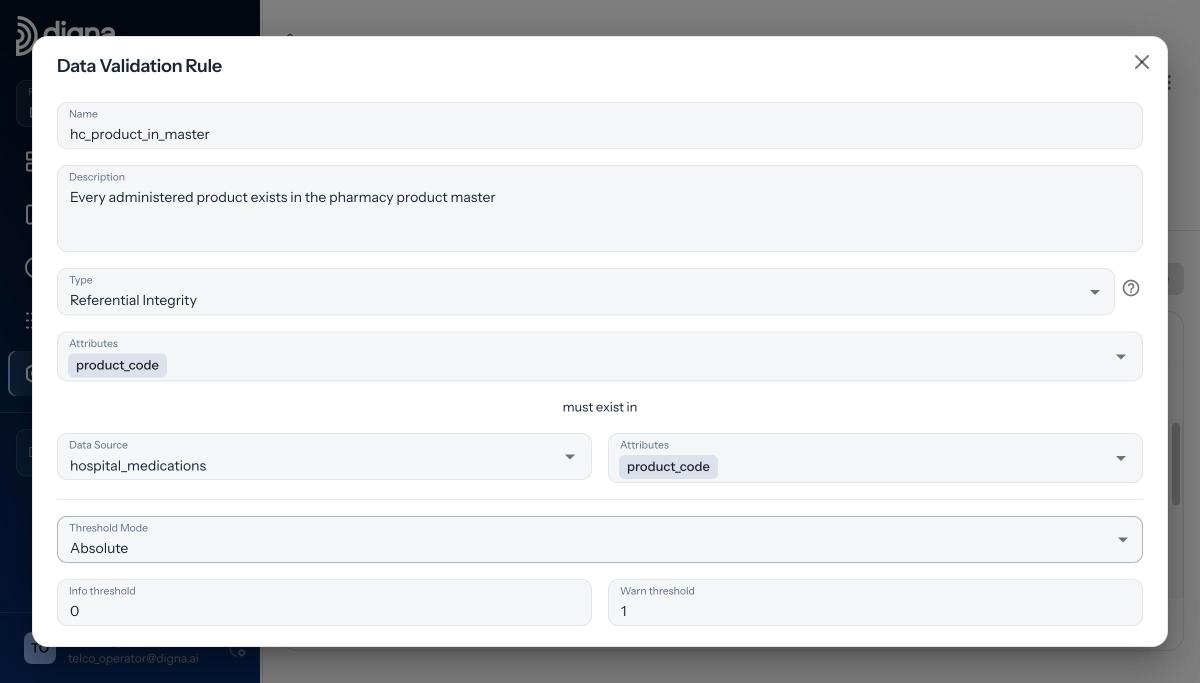
La regola completa: tipo, attributi, la data source in cui devono esistere e due soglie. Dati demo di Danubia Kliniken, un gruppo ospedaliero austriaco fittizio.
Con Info 0 e Warn 1, un solo orfano porta già lo stato a Uncertain e qualsiasi quantità superiore lo porta a Failed. Lasciate Warn a 0 se un singolo orfano deve far fallire l'esecuzione. Inoltre, il padre non deve necessariamente trovarsi accanto al figlio: dalla Release 2026.01 l'altro lato può essere una tabella o una vista in un altro schema o su un'altra connessione a database nello stesso progetto, come illustrato in integrità referenziale tra database. Il video di 2:26 Referential Integrity in digna: Set Up in Under a Minute mostra gli stessi passaggi.
Quando avete molte di queste regole, gestitele come codice: la Release 2026.06 ha aggiunto un Python SDK (pip install digna-sdk) e l'importazione ed esportazione delle regole di validazione tra ambienti.
Come appare l'SQL equivalente?
Dietro le quinte, un controllo di integrità referenziale è un left join dalle righe figlie alle chiavi distinte del padre, che conta le righe senza corrispondenza e ignora le chiavi NULL. digna genera ed esegue questa logica all'interno del vostro database. Scritta a mano per l'esempio precedente, la logica è la seguente:
Si tratta di un'illustrazione della logica, non dell'istruzione letterale inviata da digna. Per una chiave composta, la condizione di join contiene un'uguaglianza per ogni coppia di colonne. La query è la parte facile. Il lavoro è tutto ciò che le sta intorno: eseguirla dopo ogni caricamento, confrontarla con una soglia, conservare lo storico, far arrivare le righe alle persone giuste. La documentazione di digna descrive come ciascun tipo di regola diventa SQL.
Come si interpreta un controllo di integrità referenziale fallito?
Interpretate un errore in tre passaggi: lo stato vi dice che la soglia è stata superata, i conteggi vi dicono quanto è ampio il divario e i record che falliscono vi dicono perché. Orfani che condividono un'unica chiave indicano di solito master data mancanti. Orfani distribuiti su molte chiavi indicano di solito un caricamento del padre fallito o una discrepanza nel formato delle chiavi.
Torniamo all'esempio di Danubia Kliniken. Il 2026-04-22 sono state registrate nei reparti 82 somministrazioni di un nuovo prodotto prima che il prodotto arrivasse nell'anagrafica prodotti della farmacia. La regola hc_product_in_master è fallita: 4.244 righe su 4.326 hanno superato il controllo.
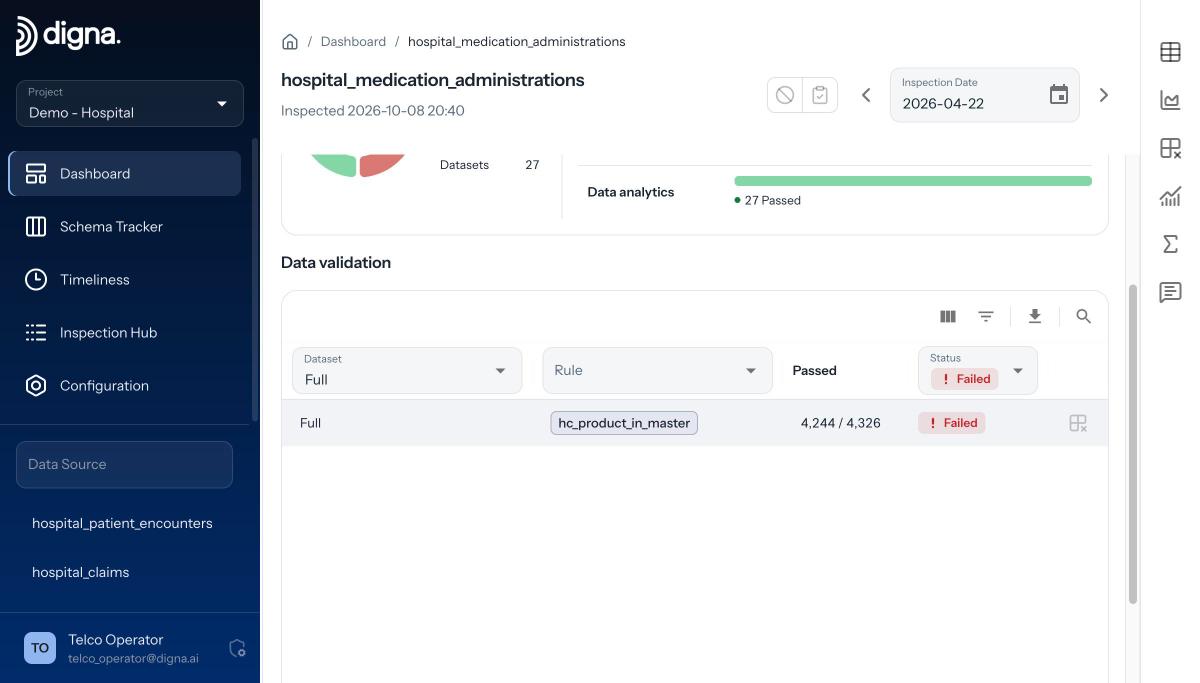
Il risultato nella dashboard: 4.244 su 4.326 superati, stato Failed.
Per capirne il motivo, aprite la vista Invalid Records, filtrate per Failed, scegliete il controllo e digna elenca ogni riga che fallisce. Qui tutte le 82 righe riportano lo stesso product_code, 3858646 (Coavira 2.5 mg). Non si tratta di 82 errori di inserimento, ma di un solo prodotto mancante nell'anagrafica. Ogni report che collegava le dosi ai prodotti tramite join ne mostrava 0 dosi, mentre il personale infermieristico ne aveva somministrate 82.

Invalid Records: ogni dose che fallisce con ospedale, reparto, codice prodotto e nome del farmaco.
I pattern più comuni:
Una chiave, molte righe: il record padre non esiste ancora. Aggiungetelo ai master data ed eseguite di nuovo l'ispezione.
Molte chiavi, un caricamento: il caricamento del padre è fallito o è avvenuto in ritardo. Correggete l'ordine di caricamento.
Chiavi quasi corrette: zeri iniziali, maiuscole/minuscole o spazi differiscono tra i sistemi. Normalizzate in una vista.
Chiavi obsolete: i record padre sono stati eliminati o archiviati mentre i figli vi fanno ancora riferimento.
Le righe che falliscono sono esportabili, quindi il team responsabile riceve i record, non solo un numero.
Da dove iniziare?
Scegliete la relazione i cui orfani farebbero più danni se arrivassero in un report questo mese e applicatele un controllo dopo il prossimo caricamento. Ogni controllo richiede pochi campi, viene eseguito all'interno del vostro database e i vostri dati non lasciano mai la vostra infrastruttura. Se volete vederlo sulle vostre tabelle, prenotate una demo con il team di digna.
Domande frequenti
Come si verifica l'integrità referenziale con SQL?
Eseguite un left join della tabella figlia sui valori distinti della chiave del padre e contate le righe in cui il lato padre è NULL, escludendo le righe la cui foreign key è a sua volta NULL. Quelle righe sono orfane. Selezionatele invece di contarle per ottenere i record da correggere; pianificazione, soglie e storico dovrete costruirli da soli.
Un controllo di integrità referenziale fallisce sulle foreign key NULL?
No. In digna i controlli di integrità referenziale ignorano i valori NULL, perché un NULL non ha nulla da cercare nella tabella padre. Quando il riferimento è obbligatorio, aggiungete una Rule separata come product_code IS NOT NULL, così un valore mancante e un valore orfano emergono come risultati distinti.
Un controllo di integrità referenziale può usare una chiave composta?
Sì. Selezionate più attributi sulla data source e lo stesso numero sul padre, nello stesso ordine, e digna verifica la combinazione. Gli elenchi di colonne di lunghezza diversa vengono rifiutati, perché confrontare una chiave a due colonne con una sola colonna lascerebbe passare righe che la chiave completa intercetterebbe.
Quale soglia dovrebbe usare un controllo di integrità referenziale?
Per i dati finanziari e clinici, usate la modalità Absolute con tolleranza zero, così un singolo orfano fa fallire l'esecuzione. Le tabelle molto grandi con una coda nota di riferimenti in arrivo tardivo si prestano invece a una soglia Relative; in digna è una frazione, quindi 0.01 significa l'uno per cento delle righe valutate.
Quanto tempo serve per configurare un controllo di integrità referenziale in digna?
Meno di un minuto. Aprite la data source in Configuration, andate alla scheda Data Validation, fate clic su Add Rule, impostate Type su Referential Integrity, scegliete gli attributi e la data source in cui devono esistere, impostate due soglie e salvate. digna genera l'SQL e lo esegue all'interno del vostro database.


