Come usare la simulazione e il metodo Monte Carlo
|
7
min di lettura

Una previsione dei costi di una pipeline può sembrare precisa fino al momento in cui il sistema a monte rallenta, i tentativi di ripetizione si moltiplicano o una sorgente inizia a inviare record incompleti. Il management può chiedere un unico numero per il prossimo trimestre, mentre il data team sa soltanto che latenza, comportamento dei retry e tassi di null rientrano in intervalli ampi e incerti. Le medie rendono la previsione facile da presentare, ma possono nascondere gli scenari che generano il rischio operativo più elevato.
La simulazione vi offre un modo per riprodurre queste condizioni incerte prima che abbiano effetto sulla produzione. Invece di chiedervi soltanto «Quanto costerà la pipeline in condizioni tipiche?», potete chiedervi «Come cambia il costo al variare di molte combinazioni plausibili di latenza, retry e dati mancanti?». Il risultato è una distribuzione che mette in luce il rischio, verifica le soglie di alert e trasforma le ipotesi in qualcosa che il vostro team può esaminare.
Il metodo Monte Carlo è il motore più utilizzato per questa traduzione. Campiona ripetutamente gli input incerti, esegue un modello e aggrega i risultati. Il metodo è nato a Los Alamos a metà degli anni Quaranta ed è passato rapidamente dalla fisica di guerra a una tecnica computazionale di ampia applicazione, come documentato dal resoconto di Los Alamos sulla nascita del metodo. Questa guida collega i suoi fondamenti alla data observability, con pattern pratici in Python e R per intervalli delle metriche, stress test delle pipeline, sensibilità ai dati mancanti e validazione della rilevazione delle anomalie.
Indice
Perché i data team hanno bisogno della simulazione
Dalle stime puntuali alle distribuzioni del rischio
Una mentalità orientata alla produzione
Comprendere la simulazione e il metodo Monte Carlo
L'analogia del bersaglio per freccette
Applicare il ciclo all'osservabilità
Fondamenti statistici chiave
Pianificare le prove a partire da un intervallo obiettivo
Ridurre la varianza con attenzione
Implementare il metodo Monte Carlo
Un pattern di implementazione compatto
Python con NumPy
R con le funzioni di base
Le scelte ingegneristiche che contano
Applicazioni pratiche per i data team
Intervalli delle metriche invece di una falsa precisione
Stress e sensibilità
Testare i rilevatori di anomalie
Errori comuni e best practice
Riproducibilità e qualità degli input
Dipendenza e convergenza
Evitare l'eccessiva fiducia nella validazione
Costruire studi di simulazione affidabili
Perché i data team hanno bisogno della simulazione
Un team di piattaforma dati sta preparando una previsione dei costi delle pipeline per il prossimo trimestre. Il modello finanziario richiede il carico di lavoro previsto, ma gli input non sono fissi. Un'API a monte può rispondere in anticipo o in ritardo, il comportamento dei retry cambia sotto carico e le tabelle di origine possono contenere più null di quanto il team si aspetti. Una singola media per ogni variabile produce un foglio di calcolo ordinato, ma dice poco sulle combinazioni che spingono la piattaforma oltre il budget o l'obiettivo di servizio.
La simulazione cambia la domanda. Il team può generare molte riproduzioni sintetiche, campionando per ogni prova ritardi di arrivo, tassi di retry e percentuali di null plausibili. Ogni riproduzione produce un risultato, come il tempo di elaborazione, il consumo di risorse di calcolo, i record falliti o il costo stimato. L'insieme dei risultati mostra se la decisione è stabile o se una piccola modifica delle ipotesi crea una coda significativa di esiti negativi.

Dalle stime puntuali alle distribuzioni del rischio
Un calcolo deterministico usa input fissi e restituisce un unico risultato. Questo approccio è utile quando gli input sono noti e stabili, ma le decisioni di osservabilità raramente corrispondono a questa descrizione. Una soglia di freschezza può dipendere da un comportamento di arrivo variabile. Un alert di volume può dipendere dalla stagionalità, da caricamenti ritardati e da filtri a monte. Un controllo di qualità può reagire in modo diverso a seconda che i valori mancanti siano casuali o concentrati in un segmento di alto valore.
La simulazione consente agli ingegneri di far variare questi input insieme. Potete quindi esaminare una mediana, un esito nella fascia alta, una probabilità di errore o l'intervallo in cui ricade la maggior parte delle prove. Lo scopo non è far sparire l'incertezza, ma renderla visibile prima che una dashboard, un alert o un piano di capacità incorporino un'ipotesi ingiustificata.
Regola pratica: se una decisione dipende da input che potete descrivere solo come intervalli o distribuzioni, una singola stima probabilmente nasconde informazioni di cui i vostri stakeholder hanno bisogno.
Una mentalità orientata alla produzione
Uno studio di simulazione utile parte da una decisione, non da un generatore di numeri casuali. Definite il risultato che conta, identificate gli input incerti, documentate come questi input sono correlati e conservate i risultati delle prove per la revisione. Lo stesso framework può supportare una previsione dei costi, uno stress test della pipeline o la verifica che una soglia di anomalia resti utile quando il traffico cambia.
Le sezioni seguenti trasformano questa mentalità in un pattern funzionante. Vedrete in che cosa l'idea generale di simulazione differisce dal metodo Monte Carlo, come la convergenza influisce sull'affidabilità, come implementare il ciclo in Python e R e come collegare l'output ai flussi di lavoro di osservabilità.
Comprendere la simulazione e il metodo Monte Carlo
La simulazione è la pratica generale di imitare un processo reale con un modello. Un data engineer può simulare una pipeline generando arrivi, applicando trasformazioni, introducendo errori e misurando il tempo di completamento. Il modello può rappresentare eventi nel tempo, dipendenze tra servizi o l'effetto delle regole operative.
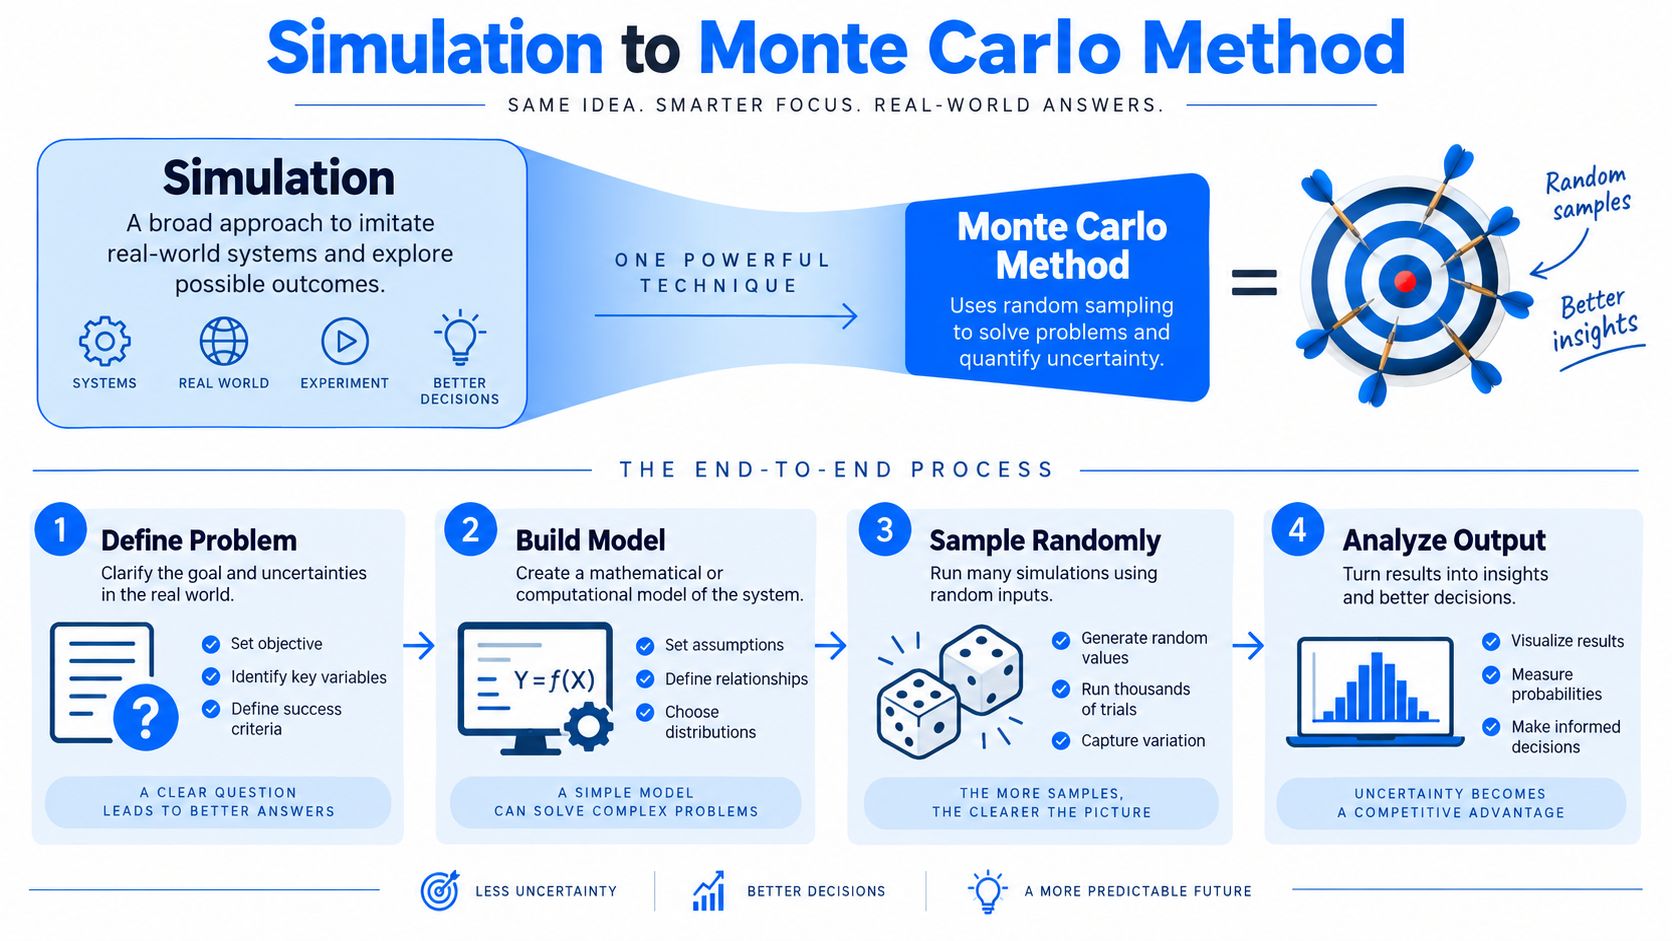
Il metodo Monte Carlo è una famiglia di tecniche che utilizza il campionamento casuale ripetuto per stimare un risultato numerico o una distribuzione di output. Una simulazione può essere deterministica, guidata dagli eventi o basata su regole. Il Monte Carlo aggiunge casualità agli input, al processo o a entrambi, quindi usa prove ripetute per approssimare ciò che un calcolo diretto potrebbe non riuscire a risolvere in modo pratico.
L'analogia del bersaglio per freccette
Immaginate un quadrato che contiene un bersaglio circolare per freccette. Lanciate punti casuali all'interno del quadrato e registrate se ciascun punto cade dentro il cerchio. La frazione di punti all'interno del cerchio stima l'area del cerchio rispetto al quadrato, da cui si può poi stimare pi greco quando la geometria è definita in modo appropriato.
L'esempio è utile perché mette in evidenza il ciclo fondamentale:
Definire il dominio. Stabilite il quadrato e il cerchio.
Campionare gli input. Generate coordinate casuali.
Valutare il modello. Verificate se ciascun punto cade all'interno del cerchio.
Aggregare i risultati. Convertite il conteggio dei colpi a segno in una stima.
Le freccette non scoprono una formula nascosta: approssimano una risposta attraverso osservazioni ripetute. Un numero maggiore di prove rende in genere la stima meno sensibile alla particolare sequenza casuale, anche se la qualità del risultato dipende comunque dal modello e dal disegno di campionamento.
Applicare il ciclo all'osservabilità
In una piattaforma dati, il quadrato diventa lo spazio delle condizioni operative plausibili. Le coordinate casuali diventano tassi di arrivo, tempi di elaborazione, eventi di errore o pattern di dati mancanti campionati. Il test del cerchio diventa la pipeline, la regola di validazione o il rilevatore di anomalie che volete valutare. Il risultato aggregato può essere un quantile di latenza, un tasso di alert mancati o l'intervallo di una metrica di business.
Una prova è un'esecuzione del modello con un insieme di input campionati. Una replica è un'esecuzione ripetuta destinata a produrre un'altra osservazione confrontabile, spesso con lo stesso modello e le stesse ipotesi di campionamento. Uno stimatore è il calcolo applicato ai risultati delle prove, come una media, un quantile o la frazione che supera una soglia.
La distribuzione campionaria descrive come varia lo stimatore tra campioni ripetuti. La convergenza significa che lo stimatore diventa sufficientemente stabile per la decisione che state prendendo. Non significa che il modello sia corretto. Una simulazione convergente con ipotesi di input scadenti può produrre una risposta precisa alla domanda sbagliata.
Per un inquadramento pratico in chiave di osservabilità, consultate la guida di digna ai metodi Monte Carlo per una migliore data observability. L'abitudine ingegneristica importante è mantenere gli input stocastici separati dalla logica di business deterministica. Questa separazione consente di sostituire un'ipotesi di input, rieseguire lo stesso modello e vedere quali conclusioni cambiano.
Fondamenti statistici chiave
I risultati del Monte Carlo sono stime, non garanzie. Se ogni prova produce un output (Y_i), uno stimatore semplice dell'output atteso è la media campionaria:
[
\hat{\mu} = \frac{1}{N}\sum_{i=1}^{N}Y_i
]
In presenza di adeguate ipotesi di indipendenza e varianza finita, l'errore standard di questa stima è approssimativamente:
[
SE(\hat{\mu}) = \frac{s}{\sqrt{N}}
]
Qui (s) è la deviazione standard campionaria osservata e (N) è il numero di prove. La relazione è importante dal punto di vista operativo. L'errore diminuisce a un ritmo proporzionale a uno diviso la radice quadrata di N, quindi quadruplicare la dimensione del campione dimezza l'errore standard. Più prove aiutano, ma di solito non producono guadagni lineari.
Pianificare le prove a partire da un intervallo obiettivo
Iniziate con un'esecuzione pilota e misurate la varianza dell'output. Se volete un intervallo di confidenza bilaterale con semi-ampiezza approssimativa (h) e usate un valore critico normale (z), una formula di pianificazione pratica è:
[
N \approx \left(\frac{z s}{h}\right)^2
]
La formula è un'approssimazione, non un sostituto della verifica della convergenza. È particolarmente utile quando lo stimatore è una media e l'output si comporta in modo ragionevole. Quantili, probabilità di eventi rari, output a coda pesante e campioni dipendenti richiedono diagnostiche più accurate, perché la loro incertezza può essere molto maggiore di quanto suggerisca un calcolo basato sulla media.
Seguite la stima in modo cumulativo invece di esaminare solo il valore finale. Tracciate la media progressiva o il quantile obiettivo rispetto al numero di prove e confrontate lotti indipendenti. Se il risultato si sposta in modo sostanziale all'arrivo di un nuovo lotto, la simulazione non è pronta per una conclusione operativa solida.
Una questione separata è la dimensione campionaria effettiva. Se le prove sono correlate, il valore nominale di (N) sovrastima la quantità di informazione indipendente. Questo accade spesso quando gli ingegneri riutilizzano una traccia di serie temporali, mantengono lo stato tra una prova e l'altra o campionano in modo indipendente input correlati, anche se in produzione si muovono insieme.
Ridurre la varianza con attenzione
I metodi di riduzione della varianza possono migliorare la precisione senza limitarsi a eseguire più prove. Possono però anche rendere il modello più difficile da spiegare, quindi usateli quando la simulazione di base è corretta e vale la pena ottimizzare l'incertezza residua.
Tecnica | Idea di base | Caso d'uso ideale | Complessità | Riduzione dell'errore attesa |
|---|---|---|---|---|
Variabili antitetiche | Abbinare un'estrazione casuale a un'estrazione complementare | Modelli regolari in cui gli output abbinati tendono a compensarsi | Bassa | Dipende dalla correlazione negativa tra gli output abbinati |
Variabili di controllo | Correggere la stima usando una grandezza correlata dal comportamento noto | Modelli con un solido calcolo di riferimento | Media | Dipende dalla relazione con la variabile di controllo |
Importance sampling | Campionare più spesso le regioni influenti e ripesare i risultati | Eventi rari e probabilità nelle code | Alta | Può essere sostanziale se la distribuzione proposta è scelta bene |
Campionamento stratificato | Suddividere lo spazio degli input in gruppi e campionare ciascuno in modo mirato | Popolazioni eterogenee o intervalli di input irregolari | Media | Dipende dalla varianza all'interno degli strati |
Per un contesto più ampio sulla scelta delle tecniche statistiche, usate il riferimento di digna sui metodi statistici per l'analisi dei dati. In una revisione del design, spiegate non solo che la varianza è diminuita, ma quale ipotesi rende valida la tecnica e come avete verificato la logica di ponderazione o di abbinamento.
Implementare il metodo Monte Carlo
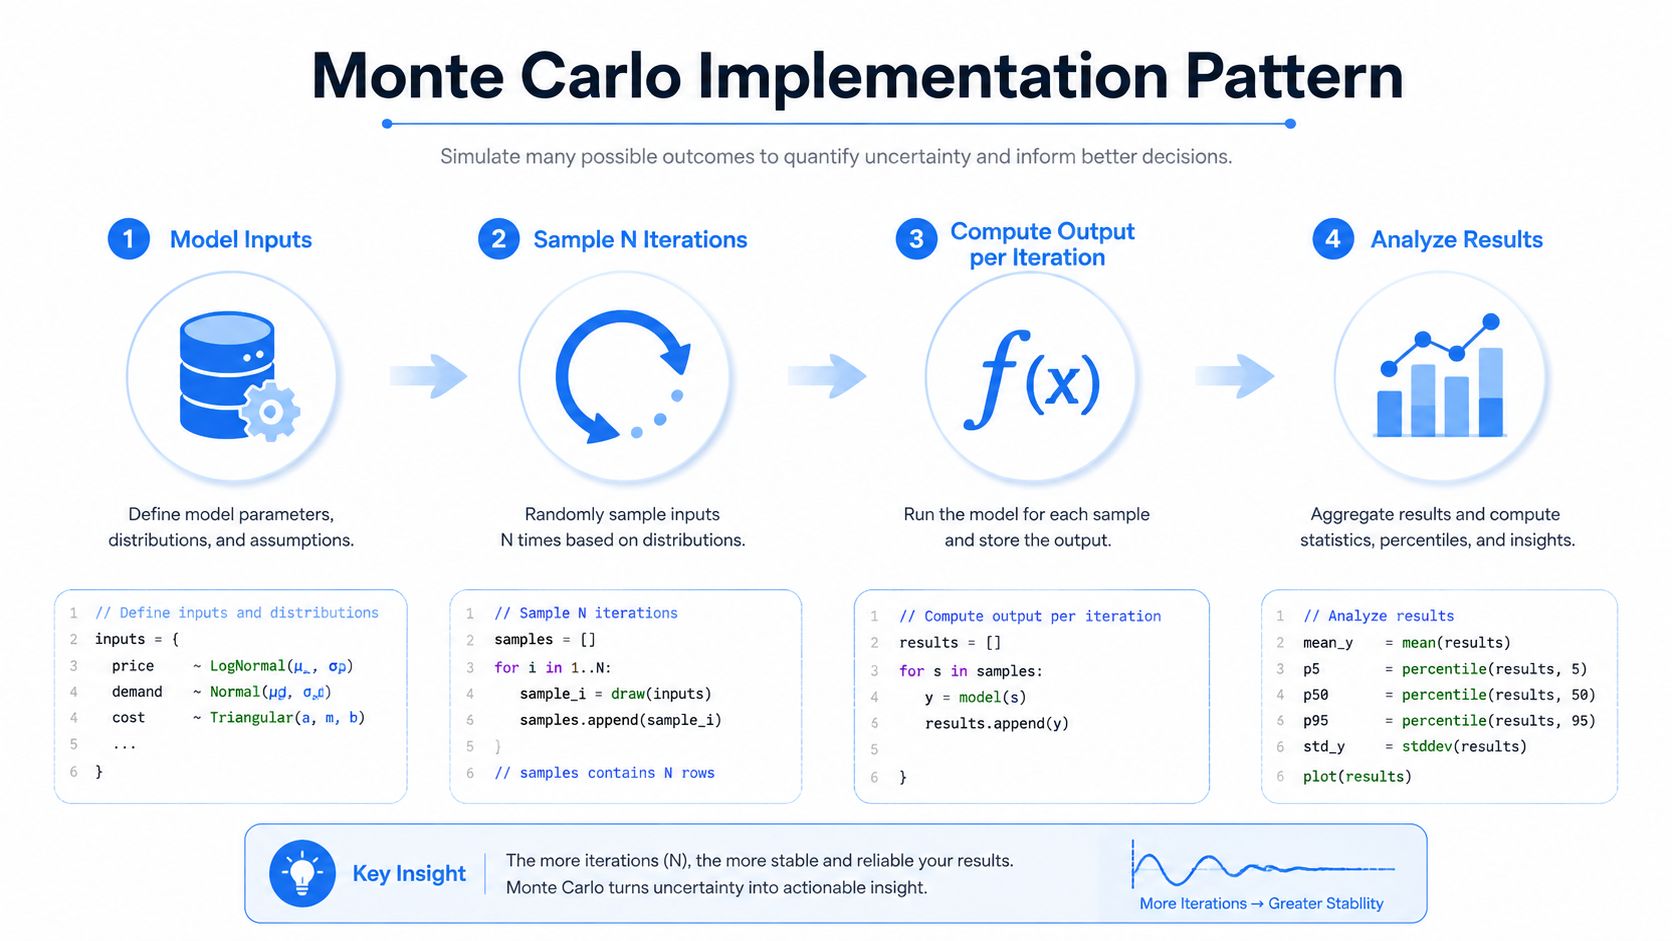
Un'implementazione ripetibile separa il modello dagli input casuali. Questo design consente di testare distribuzioni alternative senza riscrivere la logica della pipeline.
Un pattern di implementazione compatto
Usate questo pseudocodice come struttura di base:
Definire gli input del modello e le loro distribuzioni.
Stabilire una strategia per il seed e scegliere (N) iterazioni.
Campionare gli input incerti.
Calcolare un output per ogni iterazione.
Aggregare gli output delle prove.
Riportare la stima e un intervallo di incertezza.
Salvare gli output grezzi e le informazioni diagnostiche.
Il modello dovrebbe essere deterministico una volta forniti gli input campionati. Se il calcolo dell'output include una casualità nascosta, esponetela come un ulteriore flusso di input, in modo da poterla riprodurre e verificare.
Python con NumPy
L'esempio seguente stima un quantile della latenza di una pipeline quando il tempo di servizio presenta un'asimmetria a destra. Una distribuzione lognormale è una dimostrazione ragionevole per tempi di servizio positivi e asimmetrici, ma i parametri di produzione dovrebbero provenire da dati osservati o da un'ipotesi documentata.
Questo codice tratta ogni esecuzione come un lotto sintetico contenente molti tempi di servizio, quindi calcola la latenza totale per esecuzione. Il quantile finale descrive la distribuzione dell'output simulato, mentre l'intervallo mostra l'ampiezza tra i quantili di output selezionati. Non chiamate questo intervallo un intervallo di confidenza formale senza aver verificato lo stimatore e il disegno di campionamento. Per uno studio formale, stimate l'incertezza attorno al quantile stesso, spesso tramite batching o ricampionamento.
R con le funzioni di base
La stessa struttura funziona in R. rlnorm() genera valori positivi e asimmetrici e quantile() riassume il vettore di output risultante.
Un seed fisso rende riproducibile un'esecuzione di sviluppo, ma una strategia per il seed in produzione richiede documentazione. Potete usare un seed fisso registrato per la verificabilità, seed distinti per i worker paralleli o un seed controllato generato dal sistema di orchestrazione. Memorizzate il seed insieme alla configurazione e alla versione del modello.
Le scelte ingegneristiche che contano
Le operazioni vettorializzate di NumPy sono in genere più veloci dei cicli a livello di Python per carichi numerici di grandi dimensioni. Se la matrice è troppo grande per la memoria, estraete ed elaborate i dati a lotti, conservando solo le statistiche o gli output grezzi richiesti dal vostro processo di governance. Mantenete il campionatore delle distribuzioni, il modello deterministico, lo stimatore e il codice di reporting in funzioni separate, in modo che i revisori possano testare ogni livello in modo indipendente.
Per i flussi di lavoro di rilevamento delle anomalie basati su Python, il materiale di digna sulla rilevazione delle anomalie nei dati con Python offre un punto di integrazione pertinente. Il framework di simulazione può affiancare il monitoraggio anziché sostituirlo, generando scenari di stress che vi aiutano a valutare come si comporta un rilevatore prima di regolare una soglia di produzione.
Applicazioni pratiche per i data team
Il Monte Carlo diventa utile quando risponde a una domanda decisionale a cui la vostra dashboard attuale non sa rispondere. Una dashboard può mostrare la metrica attuale di freschezza, volume o qualità. Una simulazione può mostrare come si comporta quella metrica quando più condizioni incerte si verificano contemporaneamente.
Le quattro applicazioni seguenti utilizzano lo stesso framework di base, ma ciascuna richiede ipotesi di input diverse e produce un artefatto diverso per gli stakeholder.
Caso d'uso | Modello di input | Iterazioni tipiche | Artefatto prodotto |
|---|---|---|---|
Intervalli degli utenti attivi giornalieri | Pattern storici di attività, ritardi di reporting e dati mancanti plausibili | Scelte tramite verifiche di convergenza | Grafico a intervalli con stima centrale e limiti di incertezza |
Stress test ETL | Variazione del tasso di arrivo, tempo di elaborazione e comportamento di errori o retry | Scelte per stabilizzare le metriche di coda | Report su capacità e rischio di errore |
Sensibilità ai dati mancanti | Pattern di righe mancanti per segmento del dataset e contributo alla metrica | Scelte per confrontare gli scenari di dati mancanti | Tabella di sensibilità dei KPI e distribuzione dell'impatto |
Validazione delle soglie di anomalia | Variazioni sintetiche del traffico, variazione della baseline e anomalie iniettate | Scelte per confrontare gli esiti del rilevamento | Revisione di precisione e recall nei diversi scenari |
Intervalli delle metriche invece di una falsa precisione
Supponiamo che un report per il management richieda un intervallo di utenti attivi giornalieri. Il team può campionare l'attività da una distribuzione empirica, poi far variare i caricamenti ritardati e i record mancanti. L'output non sostituisce la metrica osservata: è un modo per mostrare quanto potrebbe variare il valore riportato in condizioni plausibili dei dati.
L'artefatto dovrebbe dichiarare chiaramente le ipotesi. Gli stakeholder devono sapere se l'intervallo riflette la naturale variabilità dei comportamenti, il degrado della pipeline, i dati mancanti o tutti e tre. Se la simulazione usa estrazioni indipendenti per input che normalmente si muovono insieme, l'intervallo può risultare ingannevolmente stretto o inutilmente ampio.
Stress e sensibilità
Per lo stress test ETL, introducete variabilità nei tassi di arrivo e nei tempi di elaborazione, quindi modellate i retry e i percorsi di errore. Esaminate non solo il tempo medio di completamento, ma anche la coda, la crescita delle code di elaborazione e il punto in cui gli SLA a valle vengono violati. Uno stress test è prezioso perché rivela interazioni che una riproduzione di una giornata normale non mostrerebbe.
L'analisi dei dati mancanti merita un trattamento a sé. Rimuovere righe a caso può sottostimare il danno quando i dati mancanti sono concentrati in un prodotto, una regione, una fascia di clienti o una finestra temporale. Eseguite meccanismi di dati mancanti separati e confrontate le distribuzioni risultanti dei KPI di ricavi o di churn. L'artefatto pubblicato dovrebbe identificare quali segmenti determinano la variazione, non limitarsi a presentare un'unica correzione complessiva.
Testare i rilevatori di anomalie
Un rilevatore di anomalie ha bisogno di qualcosa di più di una soglia che sembri ragionevole sui dati storici. Generate traffico sintetico che includa variabilità normale, arrivi ritardati, variazioni di volume e anomalie note iniettate. Misurate se il rilevatore genera alert quando dovrebbe, resta silenzioso durante le variazioni previste e rimane utile quando la baseline cambia.
Il Monte Carlo integra l'osservabilità anziché sostituirla. Il monitoraggio in produzione registra ciò che è accaduto. La simulazione esplora ciò che potrebbe accadere in base a ipotesi dichiarate. Per un esempio pratico di questo collegamento, consultate come individuare le anomalie nei dati con le simulazioni Monte Carlo.
Errori comuni e best practice
Una simulazione può fallire silenziosamente: il codice viene eseguito correttamente mentre le ipotesi si allontanano dalla realtà della produzione. La casualità aggiunge flessibilità, ma crea anche più modi in cui un risultato apparentemente rigoroso può nascondere un errore di modellazione.
Riproducibilità e qualità degli input
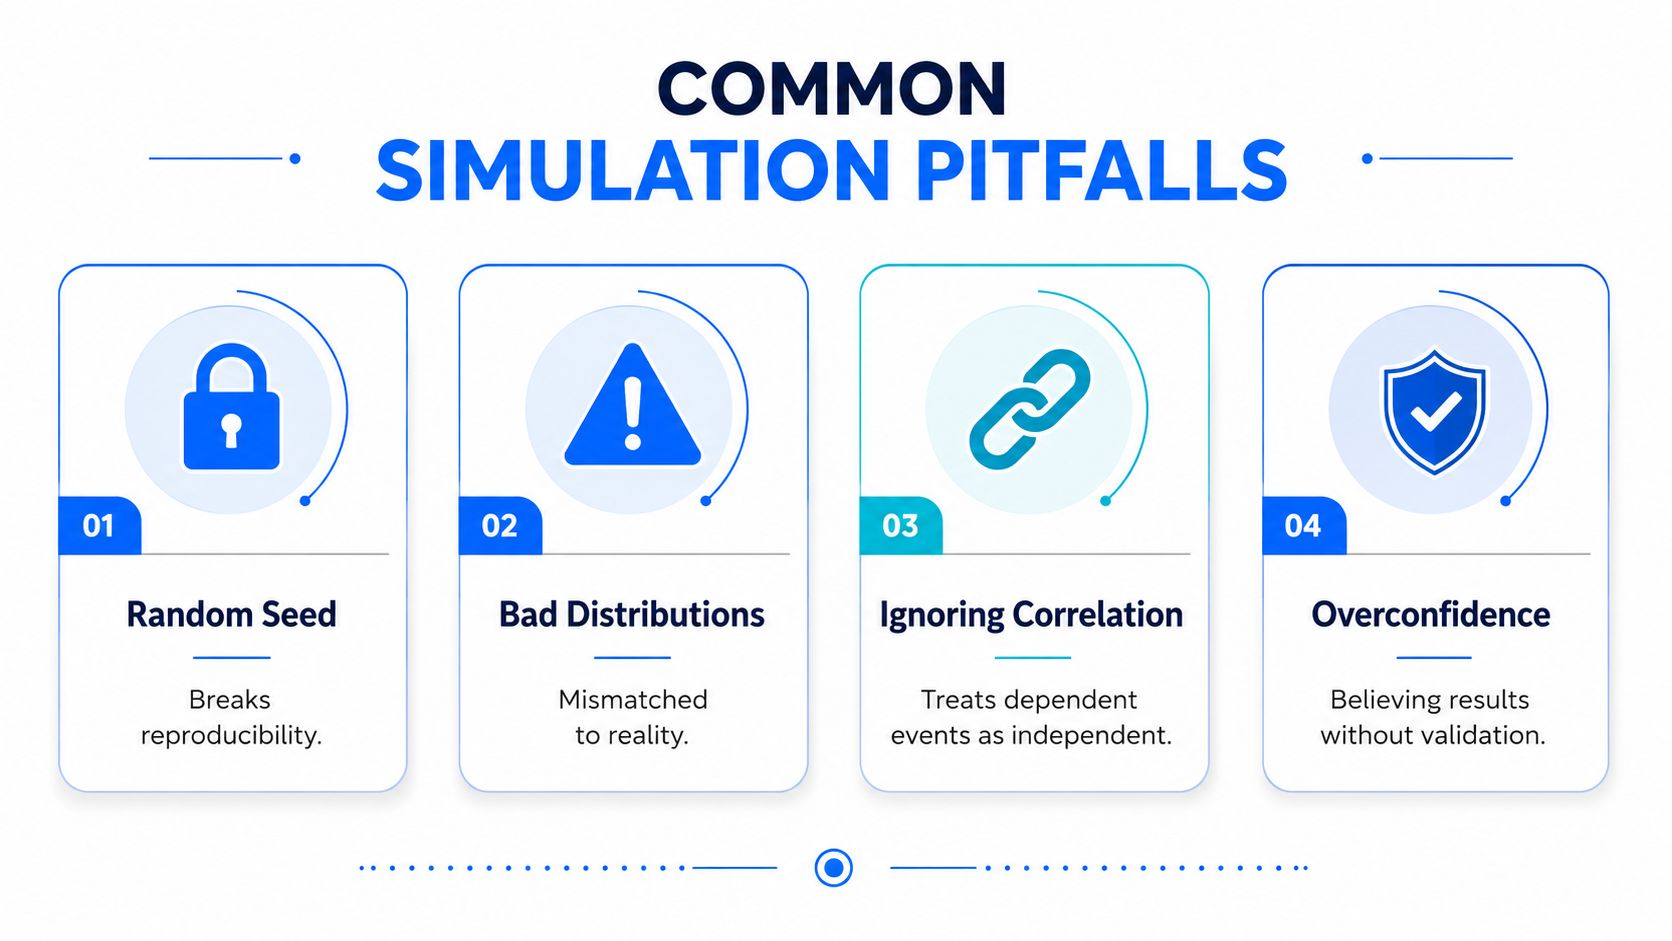
Un seed non dichiarato rende difficile riprodurre un risultato. Un revisore può rieseguire lo stesso codice, ottenere un output diverso e scambiare la normale variabilità di campionamento per una modifica della logica. Registrate insieme il seed, il generatore, la versione del modello, la configurazione e lo snapshot dei dati di input.
Una distribuzione dovrebbe avere una giustificazione empirica o di dominio. Tracciate gli istogrammi dei dati di origine, esaminate asimmetria e outlier e confrontate le estrazioni simulate con i dati osservati. Una distribuzione normale può essere comoda, ma la comodità non la rende appropriata per arrivi ritardati, tempi di servizio o intervalli tra guasti che presentano una lunga coda a destra.
Regola di validazione: non descrivete mai una distribuzione come realistica finché le estrazioni simulate non sono state confrontate con il comportamento che dovrebbero rappresentare.
Dipendenza e convergenza
Le estrazioni indipendenti non sono automaticamente corrette. Il volume degli arrivi e il ritardo di elaborazione possono aumentare insieme. Le righe mancanti possono concentrarsi durante un particolare guasto a monte. Se il modello campiona queste variabili in modo indipendente, può cancellare proprio l'evento composto che il team vuole studiare.
Usate grafici a dispersione, analisi delle serie temporali o un modello congiunto documentato per esaminare la dipendenza. Per le simulazioni basate su catene o iterative, i grafici di autocorrelazione possono rivelare che i campioni adiacenti non sono indipendenti. La diagnostica di Gelman-Rubin può aiutare a confrontare più catene quando è appropriato un metodo basato su catene, ma non è un test di convergenza universale per ogni framework Monte Carlo a estrazioni indipendenti.
Un numero insufficiente di iterazioni produce stime instabili delle code. Tracciate le stime progressive, confrontate i lotti e pianificate il numero di prove in base a un'ampiezza dell'intervallo obiettivo. Riportate gli intervalli di incertezza accanto alle stime puntuali, soprattutto quando gli stakeholder potrebbero altrimenti considerare il valore centrale come una promessa.
Evitare l'eccessiva fiducia nella validazione
Un rilevatore validato solo sui dati usati per regolarlo può sembrare più efficace di quanto sia. Suddividete i dati per periodo o per condizione operativa, validate su un periodo di holdout e testate scenari sintetici che non sono stati usati per scegliere la soglia. L'obiettivo non è fabbricare un risultato favorevole, ma scoprire dove il modello smette di supportare la decisione operativa.
Costruire studi di simulazione affidabili
Trattate uno studio di simulazione come un data product da mettere in produzione. Prima di fidarvi del suo output, verificate che:
Il seed sia registrato: annotate il generatore casuale, il seed, la versione del modello e la configurazione.
Le distribuzioni siano giustificate: conservate i dati di origine, il metodo di fitting o la motivazione di dominio per ogni input incerto.
La convergenza sia verificata: confrontate le stime progressive e i lotti con la precisione richiesta dalla decisione.
Esista una baseline: confrontate la simulazione con una stima analitica, una riproduzione storica o un riferimento deterministico, ove disponibile.
Le prove grezze siano conservate: preservate abbastanza output da poter riprodurre i riepiloghi, indagare le code ed esaminare scenari inattesi.
Gli input siano monitorati: rieseguite lo studio quando cambiano le distribuzioni dei dati a monte, i pattern dei carichi di lavoro o il comportamento della pipeline.

Scegliete il Monte Carlo quando la distribuzione degli input è nota ma quella dell'output no, quando la matematica in forma chiusa non è praticabile o quando avete bisogno di intervalli di confidenza empirici invece di un'unica stima puntuale. Per i team di produzione, questa decisione si inserisce in pratiche di data observability più ampie, in cui il comportamento osservato può orientare le ipotesi e rivelare quando una simulazione non riflette più la realtà.
digna offre funzionalità modulari di data observability per anomalie, tempestività, validazione, modifiche di schema e metriche di business o di piattaforma, all'interno del vostro ambiente. Visitate digna per collegare il comportamento osservato delle pipeline all'analisi del rischio basata sulla simulazione e prendere decisioni sull'affidabilità più solide.
Domande frequenti
Qual è la differenza tra simulazione e metodo Monte Carlo?
La simulazione è la pratica generale di imitare un processo reale con un modello. Il metodo Monte Carlo è una famiglia di tecniche all'interno di questa pratica che utilizza il campionamento casuale ripetuto per stimare un risultato numerico o una distribuzione di output.
Dove è nato il metodo Monte Carlo?
A Los Alamos a metà degli anni Quaranta, da dove è passato rapidamente dalla fisica di guerra a una tecnica computazionale di ampia applicazione. Questa origine ne influenza ancora l'uso: è stato creato per sistemi che resistevano al calcolo diretto, non per problemi che avevano già formule ordinate.
Com'è fatto il ciclo fondamentale di una simulazione?
Quattro passaggi ripetuti: definire il dominio, campionare gli input, valutare il modello e aggregare i risultati. L'esempio del bersaglio per freccette mette in evidenza il ciclo con chiarezza, perché la geometria è ovvia mentre il calcolo diretto non lo è.
Quando una singola stima nasconde informazioni di cui gli stakeholder hanno bisogno?
Ogni volta che una decisione dipende da input che potete descrivere solo come intervalli o distribuzioni. Un calcolo deterministico usa input fissi e restituisce un unico risultato, mentre la simulazione consente agli ingegneri di far variare questi input insieme e di vedere come si distribuiscono gli esiti.
Come dovrebbe iniziare uno studio di simulazione?
Con una decisione, non con un generatore di numeri casuali. Una mentalità orientata alla produzione parte dall'uso che verrà fatto del risultato, quindi risale a quali input meritano una distribuzione e a quanta convergenza la decisione richiede davvero.


