S3 come file system
|
7
min di lettura

Montare S3 come file system è di solito la scelta predefinita sbagliata. I team vi ricorrono perché il percorso sembra familiare, gli strumenti legacy continuano a funzionare e la promessa di “montare semplicemente il bucket” sembra più economica che riscrivere le pipeline. Questa scorciatoia nasconde una discrepanza semantica, e nelle analytics enterprise tale discrepanza si manifesta con picchi di latenza, comportamenti di consistenza anomali, governance disordinata e costi operativi inattesi.
La regola più sicura è semplice. Usate S3 per ciò che è, un object storage, a meno che non abbiate un workload circoscritto che richiede la semantica dei file. Se trattate il mount come un layer di comodità anziché come una decisione architetturale, finirete per fare il debug dell'astrazione invece di consegnare dati.
Indice
Perché montare S3 come file system è di solito la scelta predefinita sbagliata
Object storage e file system POSIX a confronto
Associate l'operazione sui file al comportamento di S3
Il comportamento di consistenza che non potete ignorare
Le operazioni che mettono ancora in difficoltà
Opzioni di mount: da s3fs e FUSE a S3 Files
Confrontate lo stack, non il marketing
Workload di analytics su un layer di file system S3
Ottimizzate per il workload che avete davvero
Governance enterprise e observability per l'accesso ai file su S3
Sottoponete a audit il layer degli oggetti, non solo il mount
Quando S3 come file system ha davvero senso
Usatelo quando il compromesso è intenzionale
Perché montare S3 come file system è di solito la scelta predefinita sbagliata
L'errore comune è presumere che, se un bucket può sembrare una directory, debba anche comportarsi come tale. Questa ipotesi mette in difficoltà i team perché il mount nasconde il fatto che sotto S3 resta un object store, con prestazioni, consistenza e gestione dei metadati diverse da quelle di un disco locale o di una condivisione NFS. L'object store memorizzerà volentieri i vostri byte, ma non erediterà le garanzie su cui la vostra applicazione potrebbe contare.
In produzione, è proprio in questo divario che iniziano i problemi. Gli ingegneri usano i mount per mantenere in vita vecchi script, poi scoprono che job con molti rename, scritture condivise e attraversamenti dei metadati si comportano come un layer di traduzione, non come un file system nativo. Il risultato è spesso un numero maggiore di componenti, più tentativi nascosti e più punti in cui i costi sfuggono attraverso il moltiplicarsi delle richieste e il ricambio della cache.
Regola pratica: se il workload “ha solo bisogno di una cartella”, non significa che abbia bisogno di un file system.
È la stessa AWS ad aver fatto evolvere S3 in un modo che lo dimostra. Dal lancio il 14 marzo 2006, con circa 1 petabyte di capacità distribuito su circa 400 nodi di storage in 15 rack e 15 Gbps di banda totale, S3 è cresciuto fino a diventare una piattaforma che memorizza oltre 500 trilioni di oggetti e gestisce oltre 200 milioni di richieste al secondo a livello globale a marzo 2026, su 123 Availability Zone in 39 AWS Region (storia e scala di AWS S3). Questa scala rende S3 eccellente per i workload a oggetti, ma non lo trasforma magicamente in un disco POSIX. Se la vostra architettura dipende dal comportamento dei file locali, dovete dimostrare perché il mount debba starci.
Per i team che progettano una piattaforma da zero, la prima domanda non è “possiamo montarlo?”. È “quale modalità di errore stiamo acquistando?”. Se volete una revisione rigorosa del design di sistema attorno a questa domanda, il punto di partenza giusto è questa guida all'architettura dei sistemi di dati.
Object storage e file system POSIX a confronto
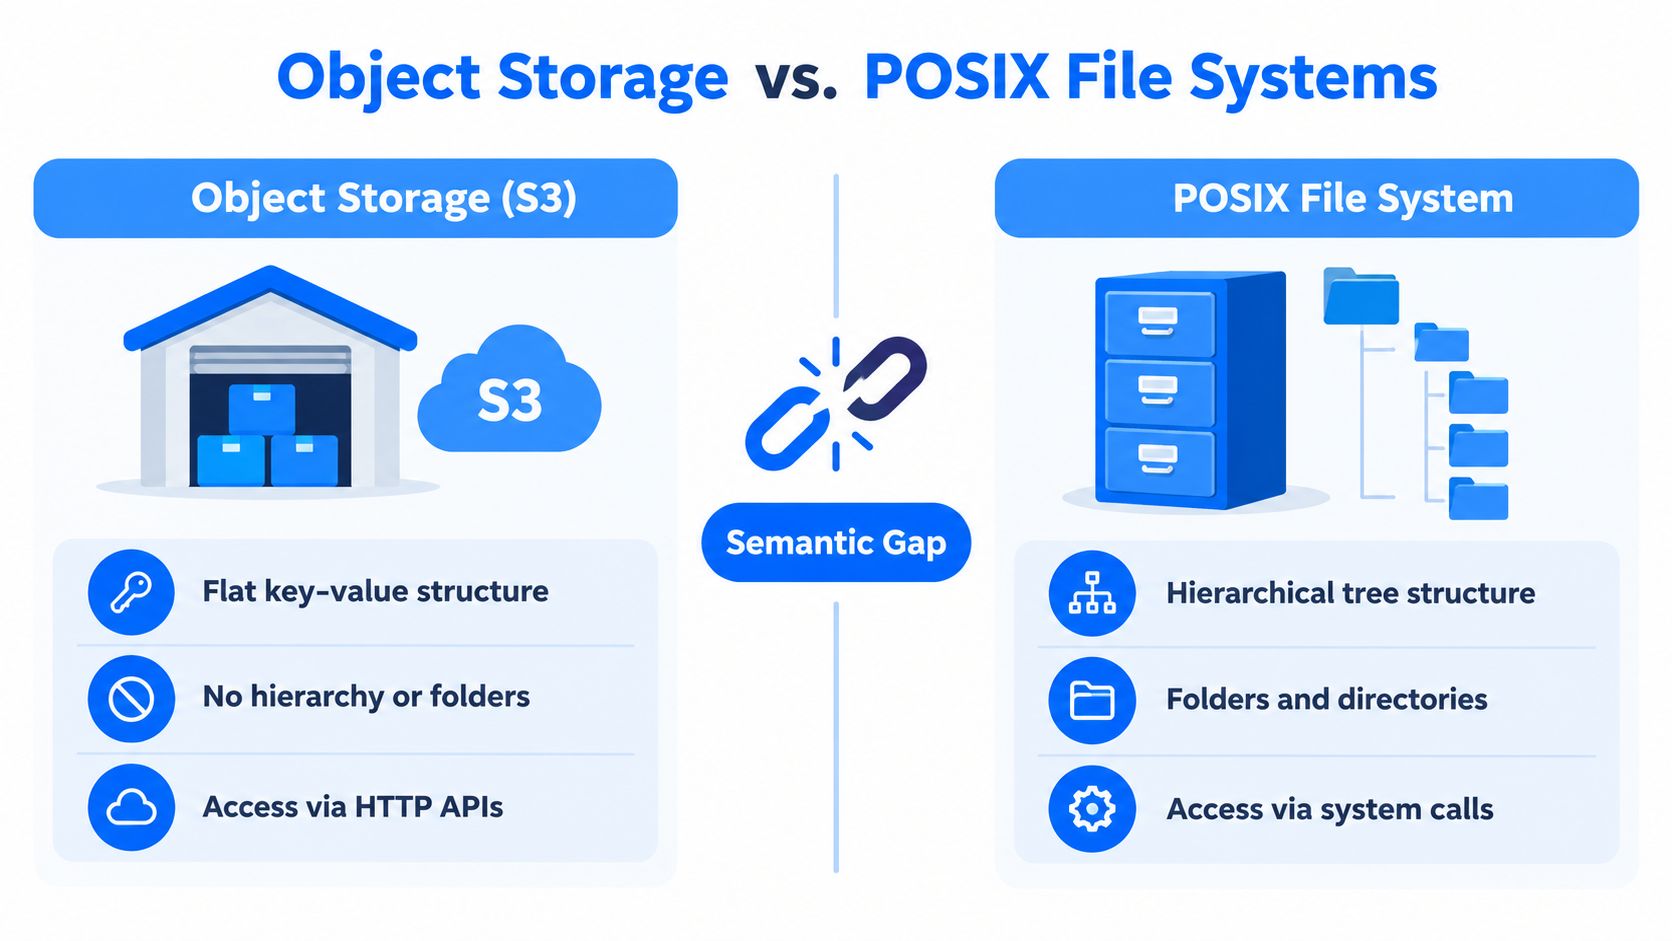
Ragionate in termini di magazzino. Un bucket è un magazzino, un oggetto è una cassa sigillata e la chiave è l'etichetta sulla cassa. Potete spostare casse, sostituirle ed elencare le etichette, ma non potete aprire una cassa e modificare una pagina al suo interno come fareste con un documento sul portatile. È questo il divario semantico che ogni layer di mount deve nascondere.
Associate l'operazione sui file al comportamento di S3
Partite da open. In POSIX, aprire un file è una normale chiamata di sistema verso un file system gerarchico. In S3, “aprire” è in realtà una decisione del client di recuperare un oggetto o di preparare un percorso di scrittura attraverso un layer di traduzione. Il sistema può farlo sembrare familiare, ma il meccanismo resta basato sugli oggetti.
Passate ora a scrittura parziale e sovrascrittura. In un file system potete spesso modificare i byte sul posto. In S3, l'oggetto viene sostituito. Per questo i workflow orientati ai file che presuppongono modifiche incrementali possono diventare costosi o scomodi quando vengono tradotti in operazioni sugli oggetti (comportamento degli object store e differenze nella sovrascrittura). Il modello di storage non si comporta come un blocco mutabile di memoria condivisa.
Infine, considerate rename e rename atomico. In POSIX, la semantica del rename fa parte del contratto del file system. In S3, il rename è un pattern emulato, di solito una copia seguita da una cancellazione oppure una riscrittura dei metadati nel layer di mount. È lì che emergono le sorprese, perché lo spostamento di una directory può trasformarsi in una raffica di operazioni sugli oggetti invece di una singola azione atomica.
Un mount può tradurre i nomi. Non può inventare la semantica.
La spiegazione in un minuto per uno stakeholder è diretta. S3 è un namespace di oggetti piatto con una presentazione simile a quella dei file sovrapposta. POSIX è un file system gerarchico con semantica nativa di directory e modifica. Più il vostro workload si affida a modifiche atomiche, locking e comportamento del rename, più il layer di traduzione deve simulare ciò che il backend di storage non ha mai promesso.
Il comportamento di consistenza che non potete ignorare
La consistenza di S3 è il punto in cui molte ipotesi da file system iniziano a incrinarsi. Amazon S3 offre oggi una forte consistenza read-after-write per GET, PUT e LIST in tutte le AWS Region, e AWS afferma che ciò che scrivete è ciò che leggerete (modello di consistenza di S3). Questo elimina un'importante categoria di sorprese, ma non trasforma S3 in un file system POSIX.
Le operazioni che mettono ancora in difficoltà
Un lettore può comunque trovarsi in difficoltà quando l'applicazione presuppone un coordinamento da file system che non esiste. I workflow di sovrascrittura, i pattern di rename in stile directory e i percorsi di accesso ricchi di metadati dipendono ancora dal layer di mount per aggiungere sincronizzazione o caching che S3 stesso non fornisce. Quando i team lo ignorano, prima o poi vedono letture obsolete, race condition o pattern di split-brain nei workflow multi-client, soprattutto quando più writer agiscono sullo stesso namespace.
Il rischio non è teorico. Un job può scrivere dati, un secondo job può elencare lo stesso prefisso ed entrambi possono ritenere di possedere lo stesso percorso logico. Se la pipeline si aspetta la sostituzione atomica di una directory o il locking dei file, l'astrazione deve fornire un coordinamento sopra la semantica degli oggetti, e quel coordinamento diventa un'ulteriore superficie di errore.
Operazione | Comportamento POSIX | Comportamento S3 | Rischio per chi usa il file system |
|---|---|---|---|
Creazione e lettura | Creazione nativa del file, poi lettura immediata | Fortemente consistente per i nuovi oggetti | Rischio più basso, ma il comportamento del mount conta comunque |
Sovrascrittura | Semantica di aggiornamento del file sul posto | Semantica di sostituzione dell'oggetto | I lettori potrebbero non ottenere un comportamento di aggiornamento simile a quello dei file |
Rename di directory | Spostamento del namespace apparentemente atomico | Emulato tramite operazioni sugli oggetti o layer di metadati | Chiavi orfane, spostamenti parziali, tentativi nascosti |
Elenco della directory | Metadati di directory nativi | Elenco delle chiavi degli oggetti basato sul prefisso | Gli elenchi di grandi dimensioni possono diventare lenti e rumorosi dal punto di vista operativo |
AWS S3 Files aggiunge un ulteriore segnale che l'astrazione ha dei limiti. La documentazione espone quote esplicite come 25.000 connessioni per file system e 10.000 access point per file system, a ricordare che il mount non è la stessa cosa di un disco locale (limiti e comportamento di S3 Files). Progettate tenendo conto di questi limiti, non sperate che spariscano.
Per i team che gestiscono le pipeline, l'abitudine più sicura è far passare ogni workflow sensibile alla consistenza attraverso un responsabile chiaro e una fase di validazione esplicita. Se vi serve una checklist pratica per questo tipo di rilevamento del drift, usate i controlli di consistenza dei dati come modello per impostare il problema.
Opzioni di mount: da s3fs e FUSE a S3 Files
Non tutti i mount di S3 sono costruiti allo stesso modo. Alcune opzioni esistono per mantenere in vita strumenti legacy, altre per ridurre gli attriti operativi, e altre ancora sono più correttamente descrivibili come layer di accesso che come veri file system. La scelta giusta dipende dal fatto che vi serva accesso in lettura, comportamento write-through, modifica condivisa o un modo più pulito per alimentare motori di analytics che parlano già il linguaggio dell'object storage.
Confrontate lo stack, non il marketing
s3fs e mount simili basati su FUSE sono di solito la prima tappa per i team che hanno bisogno di un rapido ponte di compatibilità. Sono comodi, ma aggiungono un ulteriore layer di processo, latenza aggiuntiva e più spazio per colli di bottiglia quando un singolo nodo diventa il punto di strozzatura. Possono andare bene per un uso interattivo leggero o come impalcatura per una migrazione, ma sono una scelta predefinita sbagliata per pipeline enterprise molto attive.
Goofys e Mountpoint for S3 appartengono alla stessa ampia famiglia di layer di compatibilità. Possono migliorare pattern di accesso specifici, ma non eliminano la discrepanza semantica tra object storage e semantica dei file. Usateli quando l'obiettivo principale è “far funzionare questo strumento adesso”, non “costruire la piattaforma attorno a questo a tempo indeterminato”.
Il più recente S3 Files di AWS ha un intento diverso. AWS lo posiziona come file system condiviso per EC2, Lambda, EKS ed ECS, con accesso NFS 4.1 e 4.2 e sincronizzazione bidirezionale tra il file system montato e il bucket (comportamento e regioni di S3 Files). Questo lo rende più nativo di un semplice shim FUSE, ma non è comunque un disco POSIX. Il compromesso di design è più adatto all'accesso condiviso che alle scritture casuali in stile database.
Le API native dell'object store sono la risposta più pulita quando il vostro motore le supporta già. Spark, Trino e DuckDB ottengono un parallelismo migliore e una scalabilità più pulita quando dialogano direttamente con S3 invece di passare per un mount che cerca di imitare le directory. Se lo strumento sa già eseguire listing parallelo, letture vettorizzate o predicate pushdown, non costringetelo a passare attraverso una patina da file system.
Opzione | Stack | Supporto in scrittura | Limite di throughput | Caso d'uso ideale |
|---|---|---|---|---|
s3fs | Client basato su FUSE | Limitato, orientato alla compatibilità | Spesso limitato dal nodo client | Strumenti legacy e attività di migrazione di breve durata |
Altri mount FUSE | Layer di compatibilità | Varia in base all'implementazione | Dipende dall'overhead di traduzione | Accesso prevalentemente in lettura con bassa concorrenza |
S3 Files | Interfaccia di file system gestita da AWS sopra S3 | Sincronizzazione bidirezionale | Migliore per l'accesso condiviso, ma comunque non nativo POSIX | Compute condiviso e collaborazione orientata ai file |
API native per oggetti | SDK S3 diretto o integrazione nel motore | Semantica completa degli oggetti | Scala con il parallelismo dell'object store | Spark, Trino, DuckDB e analytics moderne |
La raccomandazione è semplice. Usate mount in sola lettura quando dovete preservare vecchi strumenti. Usate mount write-through solo con tentativi espliciti, regole di responsabilità e percorsi di rollback. Preferite le API native per oggetti ogni volta che lo strumento le supporta, perché è il percorso che scala in modo pulito per le analytics. Se volete una prospettiva più ampia sul design delle pipeline, la guida alle pipeline di dati ETL offre il tipo di impostazione che il vostro team di piattaforma dovrebbe adottare prima di approvare un mount.
Workload di analytics su un layer di file system S3
I workload di analytics fanno emergere rapidamente i punti deboli perché toccano sia i byte sia i metadati. I job Spark e Hive possono tollerare letture a stadi se il pattern di accesso è prevalentemente sequenziale, ma quando il workload inizia a scansionare directory, rinominare partizioni o generare continuamente piccoli file, il layer di mount diventa costoso sia in termini di tempo sia di traffico sul control plane. Trino e DuckDB si comportano di solito meglio quando possono dialogare direttamente con S3, perché evitano un'astrazione da file system che non è mai stata pensata per metadati in continuo cambiamento.
Ottimizzate per il workload che avete davvero
Se il job è orientato al batch, appoggiare i dati su S3 può ancora avere senso quando il pattern di lettura è prevedibile e l'output viene scritto una sola volta. In questo caso, concentratevi sulla riduzione degli attraversamenti di directory non necessari e lasciate che il motore legga blocchi più grandi invece di fingere che ogni riga meriti un accesso indipendente a un file. Gli strumenti che supportano read-ahead, GET parallele per intervalli o predicate pushdown supereranno di solito un mount generico, perché restano più vicini alla semantica degli oggetti.
L'altro punto critico sono i piccoli file. Un layer di file system fa sembrare innocua la proliferazione di piccoli file finché le operazioni di listing e sui metadati non dominano il job. Anche le scritture di tabelle con molti rename diventano un problema, perché il mount deve emulare un comportamento che l'object storage non offre nativamente. È qui che table format come Iceberg e Hudi dimostrano il loro valore, perché codificano i propri layer di consistenza e di metadati invece di affidarsi a trucchi sulle directory.
Regola pratica: se la disposizione dei vostri dati si basa sul rename come meccanismo di commit, state risolvendo un problema di table format con l'idraulica dello storage.
Anche la questione dei costi conta. Operazioni LIST frequenti su bucket di grandi dimensioni sono un anti-pattern per le analytics basate su mount, perché ogni comodità orientata ai file può tradursi in richieste e latenza aggiuntive. Per questo un percorso S3 diretto è di solito la scelta migliore per i grandi dataset enterprise, soprattutto quando il team di piattaforma dispone già di un monitoraggio su pattern di query, numero di file e ricambio degli oggetti.
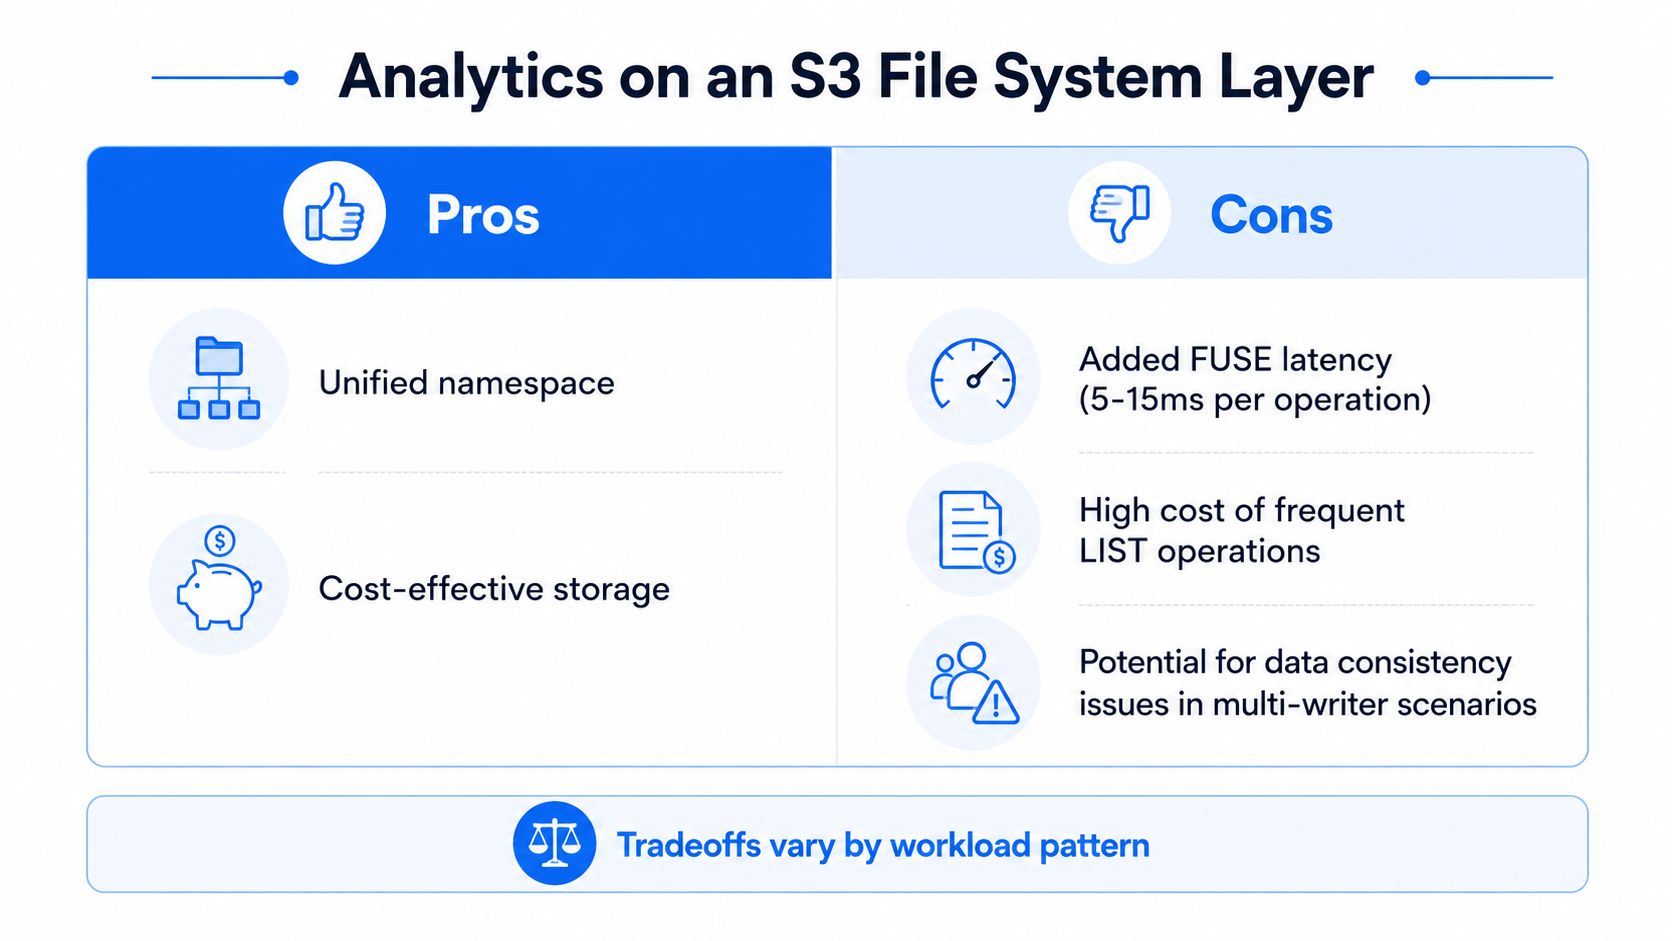
Per i team che hanno bisogno di strumentazione attorno a questi compromessi, la vista operativa conta quanto il motore di query. Il pattern di monitoraggio corretto appartiene al monitoraggio del data lake, non a uno script di mount occasionale.
Governance enterprise e observability per l'accesso ai file su S3
Una volta che S3 è esposto come file system, la governance deve seguire i dati, non l'illusione delle cartelle. I confini IAM contano ancora a livello di bucket o di prefisso, la crittografia KMS conta ancora per i dati a riposo e le policy degli endpoint VPC contano ancora se volete impedire un'uscita pubblica accidentale. Il percorso del file può sembrare familiare agli utenti, ma il control plane sottostante resta un object storage, quindi il vostro modello di policy deve corrispondere alla semantica degli oggetti.
Sottoponete a audit il layer degli oggetti, non solo il mount
I log di audit del file system qui non bastano. Il mount può nascondere le operazioni a livello di oggetto a chi guarda solo tracce in stile POSIX, il che significa che il team di sicurezza ha bisogno di log di accesso S3, eventi di dati CloudTrail e telemetria dello storage nella stessa pipeline di monitoraggio. Senza di essi, potete non accorgervi di drift, mount obsoleti, credenziali esposte sui bastion host e pattern di GET che sembrano normali al client dei file ma sospetti a chi gestisce un incidente.
Anche la classificazione dei dati diventa più difficile. Un percorso di file in un namespace montato non corrisponde uno a uno a un'ACL o a una policy sugli oggetti, quindi i team hanno bisogno di regole esplicite su chi può vedere che cosa e su dove tali regole vengono applicate. Se lo stesso bucket è usato da più strumenti, servono anche convenzioni di responsabilità che evitino percorsi di scrittura ambigui e collisioni accidentali nel namespace.
AWS S3 Files aggiunge una regola operativa particolarmente utile. Se lo stesso elemento viene modificato sia nel file system sia direttamente nel bucket, AWS considera il bucket come fonte di verità e sposta il file in conflitto in una directory lost-and-found, e raccomanda di scegliere come writer principale o il file system o S3 (best practice di S3 Files). È una policy di governance tanto quanto un dettaglio tecnico, perché costringe i team a scegliere una fonte di verità prima di creare confusione.
Per le data platform enterprise, il compito è il monitoraggio continuo del layer stesso. Se un mount va in deriva, una credenziale viene esposta o un workload inizia a bombardare di GET in un modo che non corrisponde al pattern atteso, il team di piattaforma dovrebbe accorgersene prima del business. È esattamente il tipo di visibilità che una piattaforma di Data Observability è pensata per offrire.
Quando S3 come file system ha davvero senso
Usate S3 come file system solo quando il workload giustifica l'astrazione. Lo staging temporaneo per un singolo job batch va bene. Gli strumenti legacy vincolati a POSIX che non possono essere riscritti entro i tempi del progetto vanno bene. Anche le analytics prevalentemente in lettura su Parquet o su table format che gestiscono già i propri metadati vanno bene, soprattutto quando l'obiettivo è evitare copie duplicate e spostamenti di dati non necessari.
Usatelo quando il compromesso è intenzionale
Ciò che non appartiene a un mount basato su S3 è un database con scritture casuali, uno spazio di lavoro condiviso con modifiche continue o un'architettura a microservizi che usa il mount come se fosse un disco condiviso a bassa latenza. Questi sistemi richiedono una semantica dei file più forte di quella che l'object storage può offrire attraverso un layer di traduzione, e tendono a fallire proprio nei punti in cui concorrenza e modifiche contano di più.
Lo schema decisionale più pulito consiste nel valutare il workload candidato rispetto a sei domande.
Frequenza di scrittura. Se le scritture sono frequenti e piccole, lasciate perdere.
Pattern di listing. Se l'applicazione attraversa continuamente le directory, lasciate perdere.
Tolleranza alla latenza. Se qualche round trip in più compromette il workflow, lasciate perdere.
Tetto di costo. Se la crescita delle richieste conta più del costo dello storage, lasciate perdere.
Postura di sicurezza. Se l'applicazione delle policy dipende solo dalla semantica dei percorsi, lasciate perdere.
Percorso di rollback. Se non potete tornare alle API dirette di S3 o a un altro storage, non iniziate.
La raccomandazione onesta è semplice. Usate il mount quando l'obiettivo è la compatibilità e il workload è circoscritto. Evitatelo quando il requisito è la modifica condivisa, una concorrenza complessa o un comportamento da database. S3 è un'eccellente primitiva per le data platform, ma un wrapper da file system non lo trasforma in un NAS generico.

Se il vostro team sta decidendo se esporre S3 come mount, digna può aiutarvi a mantenere affidabile il layer dei dati con un'observability che traccia tempestività, modifiche di schema, anomalie e comportamento della piattaforma all'interno del vostro ambiente. Visitate digna per scoprire come la sua piattaforma di Data Observability può aiutarvi a monitorare gli effetti a valle di scelte architetturali come questa, prima che un mount si trasformi in un incidente di produzione.
Domande frequenti
Conviene montare S3 come file system?
Di solito no. Il mount è la scelta predefinita sbagliata perché nasconde il fatto che sotto S3 resta un object store, con prestazioni, consistenza e gestione dei metadati diverse da quelle di un disco locale o di una condivisione NFS. Usate S3 come object storage, a meno che un workload circoscritto non richieda davvero la semantica dei file.
Perché un bucket che sembra una directory non si comporta come tale?
Perché l'aspetto di directory è un'emulazione. L'errore comune è presumere che, se un bucket può sembrare una cartella, debba anche comportarsi come tale, e in produzione è proprio da questa ipotesi che iniziano i problemi.
Come si traducono le operazioni sui file POSIX in S3?
In modo imperfetto. L'apertura è in realtà una decisione del client di recuperare un oggetto o di preparare un percorso di scrittura attraverso un layer di traduzione, la scrittura parziale e la sovrascrittura sostituiscono l'intero oggetto, e il rename è un pattern emulato, di solito una copia seguita da una cancellazione oppure una riscrittura dei metadati nel layer di mount.
Quale domanda dovrebbe sostituire “possiamo montarlo?”
“Quale modalità di errore stiamo acquistando?” Se un workload ha bisogno solo di una cartella, non significa che abbia bisogno di un file system, e rispondere prima alla domanda sulla modalità di errore di solito elimina del tutto il mount dal design.
Quanto è cresciuto S3 dal lancio?
Da circa 1 petabyte distribuito su circa 400 nodi di storage in 15 rack con 15 Gbps di banda totale al lancio, il 14 marzo 2006, a oltre 500 trilioni di oggetti e oltre 200 milioni di richieste al secondo a livello globale a marzo 2026, su 123 Availability Zone in 39 AWS Region.


