Rilevamento delle anomalie nei dati con Python: guida completa 2026
|
8
min di lettura

Di solito ci si accorge del problema dopo che qualcuno vi scrive per una dashboard che “sembra strana”. I ricavi derivano da settimane, una pipeline è arrivata in ritardo tre mattine di fila oppure una modifica dello schema ha rotto un modello a valle mentre tutti continuavano a fidarsi del grafico. Il rilevamento delle anomalie nei dati con Python funziona al meglio quando smette di essere una demo in un notebook e diventa parte della routine operativa, con soglie, baseline e percorsi di escalation con cui i team reali possono convivere.
Indice
Perché il rilevamento delle anomalie conta oltre il notebook
Preparare dati tabellari e serie temporali per il rilevamento
Perché il rilevamento delle anomalie conta oltre il notebook
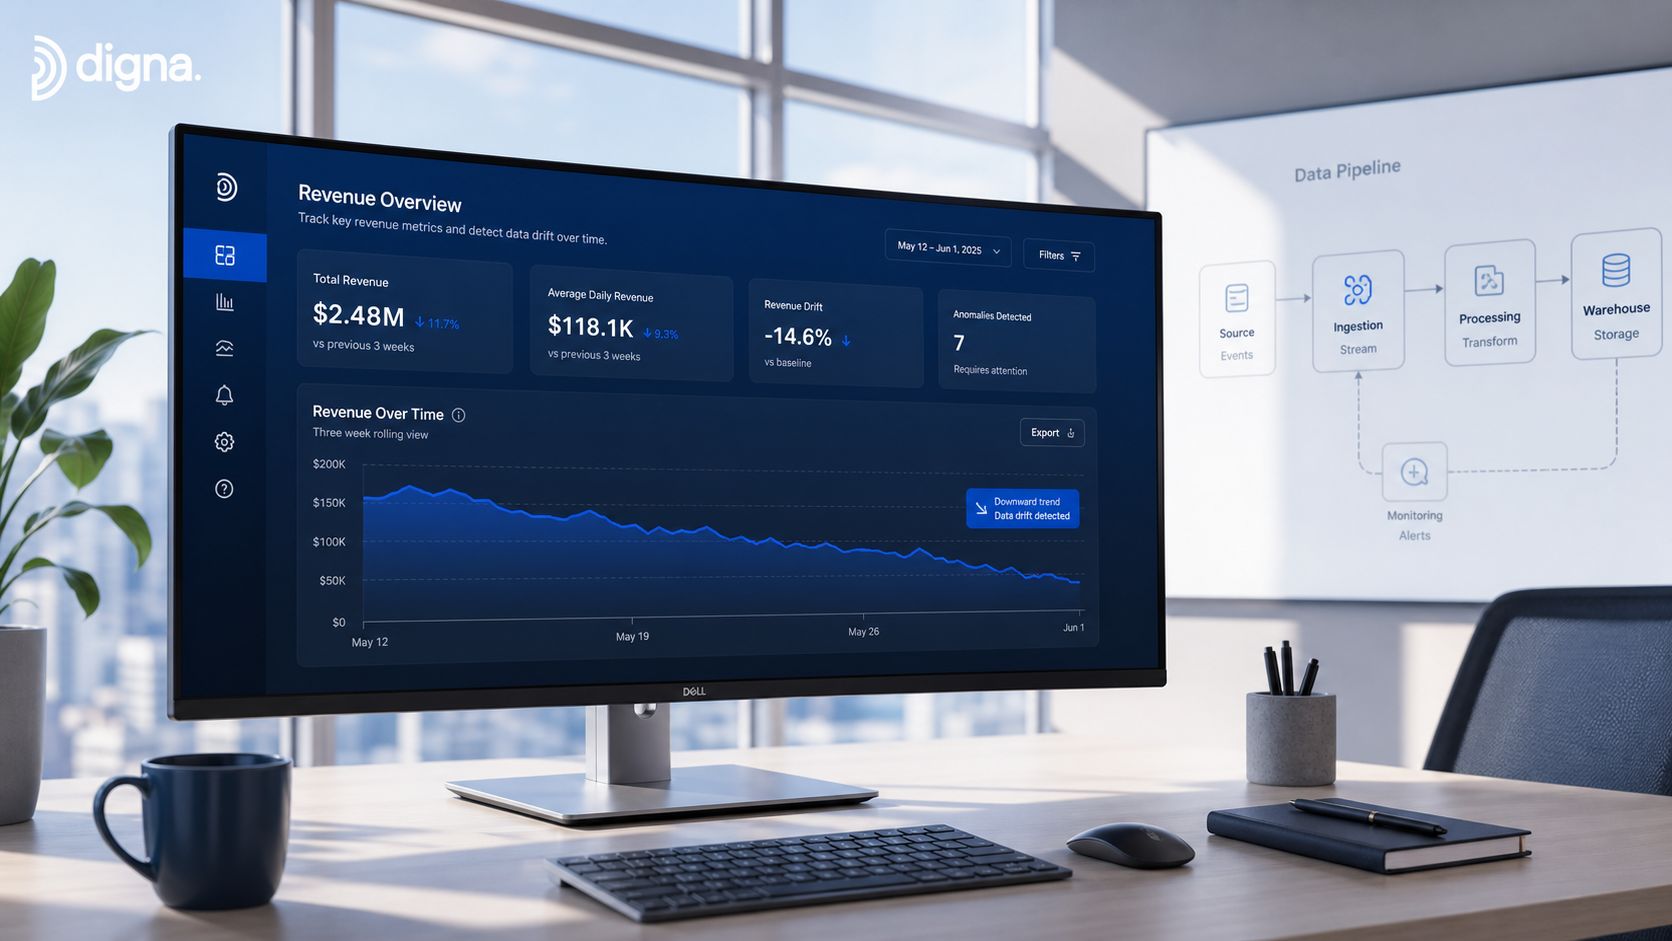
Un notebook può segnalare un outlier. Un sistema di produzione deve sopravvivere a caricamenti errati, partizioni mancanti, file in ritardo e persone che devono fidarsi dell'alert abbastanza da agire. La differenza conta perché lo stesso picco su un grafico locale potrebbe essere un innocuo rialzo stagionale, mentre lo stesso picco in un feed del warehouse potrebbe indicare un job rotto o un evento di business che richiede una revisione immediata.
I flussi di lavoro Python più solidi che ho messo in produzione partono da un'EDA guidata dal dominio e poi scelgono un rilevatore adatto alla forma dei dati. Per i campi tabellari, questo significa spesso soglie univariate come z-score o IQR per segnali quasi normali, oppure metodi multivariati come la distanza di Mahalanobis, EllipticEnvelope, One-Class SVM o Isolation Forest quando i campi si muovono insieme [Analytics Vidhya]. Per le serie temporali, una soglia unica valida per tutto di solito fallisce quando la serie è non stazionaria o eteroschedastica, quindi il lavoro pesante lo fanno baseline locali, finestre mobili e punteggi che tengono conto della dispersione [Towards Data Science].
Regola pratica: se l'alert non può essere spiegato in parole semplici a un analista, a un responsabile delle operazioni o al titolare della BI, è troppo presto per metterlo in produzione.
Il cambiamento architetturale arriva quando smettete di trattare il rilevamento come un artefatto da notebook e iniziate a trattarlo come un servizio operativo. Questo può significare eseguirlo nell'ambiente del cliente, all'interno della VPC o persino nel database, così che i dati restino dove la governance si aspetta che restino. Per i team che lavorano sul monitoraggio del traffico e del business, gli approfondimenti di analytics di Data Hunters Agency sono un utile riferimento per riflettere su come qualità del segnale, lettura dei trend e contesto di business cambino ciò che conviene monitorare.
In questo design i falsi positivi non sono un difetto. Fanno parte del sistema, perché un rilevatore che non mette mai in discussione il business è di solito un rilevatore troppo silenzioso per essere utile.
Preparare dati tabellari e serie temporali per il rilevamento
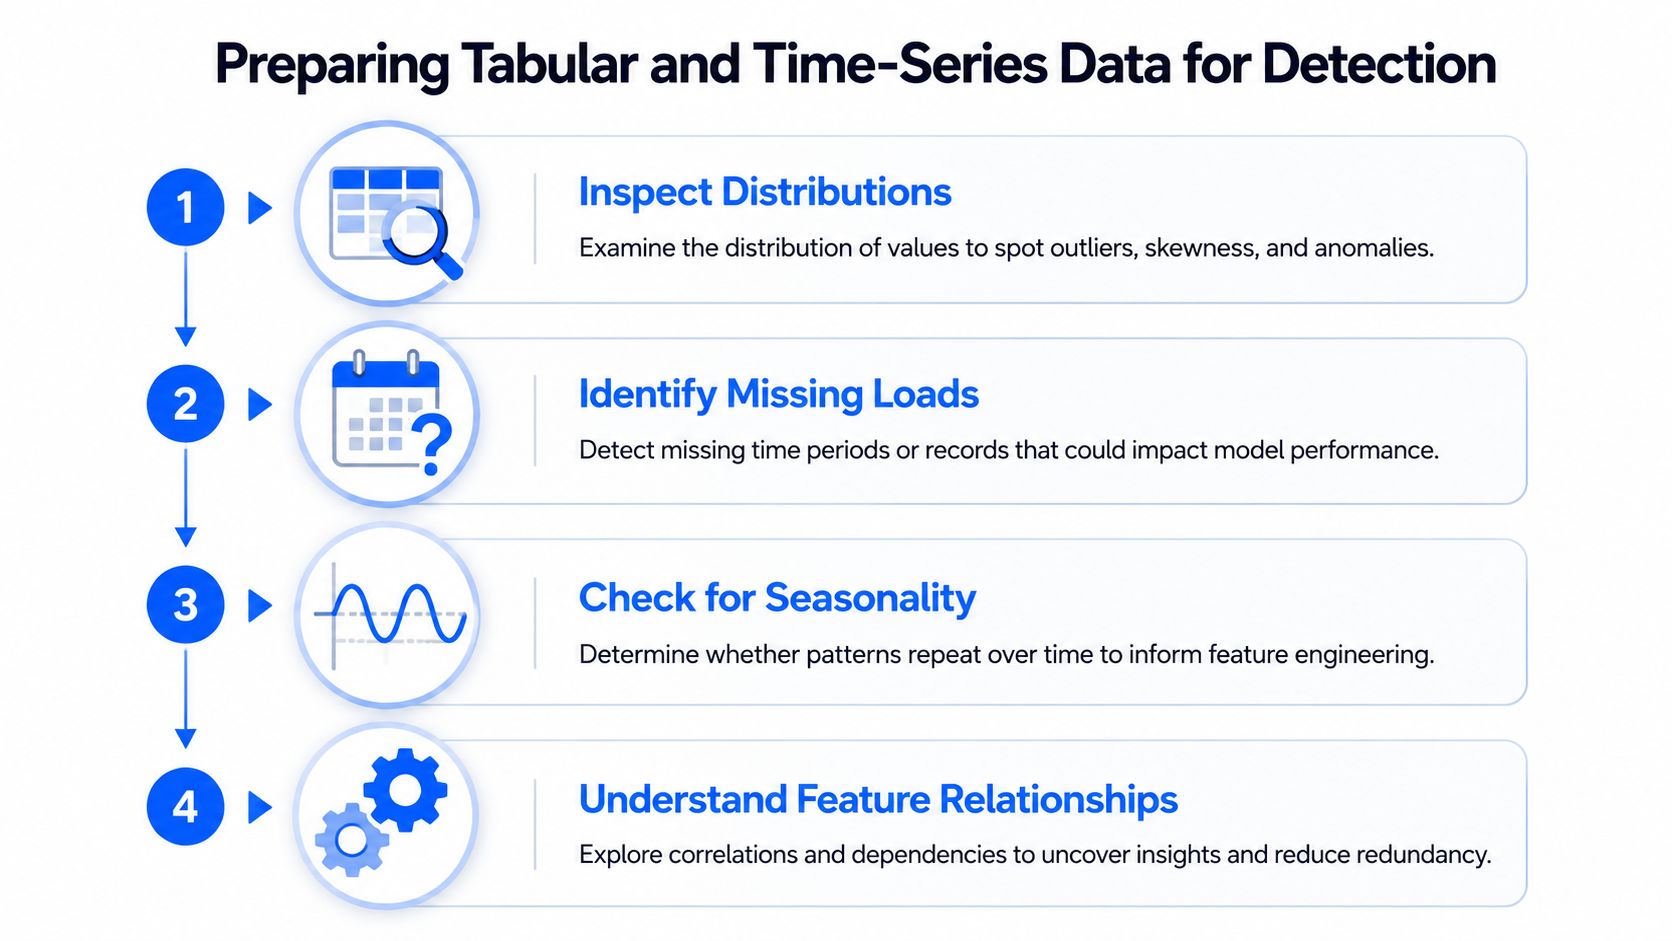
Prima che qualsiasi modello venga eseguito, i dati devono essere onesti. Inizio controllando distribuzioni, caricamenti mancanti e relazioni tra le feature, perché un rilevatore che vede input sporchi etichetterà con sicurezza la cosa sbagliata. Per i KPI di business, questo significa di solito separare le metriche stabili dalle metriche stagionali e decidere se il segnale si comporta più come un'istantanea o come una sequenza.
Partire dalla forma dei dati
Per i campi tabellari, le singole metriche quasi normali funzionano spesso bene con soglie basate su z-score o IQR. Quando i campi sono correlati, la scelta migliore è il rilevamento multivariato, dove distanza di Mahalanobis, EllipticEnvelope, One-Class SVM o Isolation Forest possono rispettare la struttura tra le colonne [Analytics Vidhya]. EllipticEnvelope è particolarmente pratico quando si vogliono stime affidabili di centro e covarianza tramite FastMCD prima di assegnare il punteggio con la distanza di Mahalanobis, mentre un parametro di contamination aiuta ad allineare il modello alla frazione di anomalie attesa.
Costruire un contesto locale per le serie temporali
Per le serie temporali, una soglia globale è spesso troppo grossolana. Finestre mobili, detrending e statistiche di dispersione locale vi danno una baseline che segue la serie invece di combatterla, e il punteggio basato sulla MAD è spesso una scelta più sicura quando il rumore farebbe scattare troppi alert con una regola a 3 sigma [Towards Data Science]. Questo conta perché le anomalie possono presentarsi come punti singoli, cambi di trend, variazioni di volatilità o eventi a livello di dataset, non solo come picchi.
Condizione dei dati | Approccio migliore | Perché funziona |
|---|---|---|
Singola metrica quasi normale | z-score o IQR | Semplice, veloce, facile da spiegare |
Campi tabellari correlati | EllipticEnvelope, Mahalanobis, Isolation Forest | Sfrutta le relazioni tra le colonne |
Serie temporali non stazionarie | Finestre mobili, detrending, MAD | Si adatta al comportamento locale |
Segnali di produzione rumorosi | Baseline locali | Riduce i falsi positivi |
Non imponete una soglia statica a una serie che cambia. Se i dati hanno stagionalità o drift, la soglia deve muoversi con loro.
La guida interna su https://www.digna.ai/anomaly-detection-time-series è un complemento pratico se state lavorando al rilevamento sulle serie temporali basato su baseline in un contesto di produzione.
Scegliere il rilevatore giusto per il compito
La scelta del rilevatore deve seguire la forma dei dati, non il contrario. Nelle pipeline reali, il risultato migliore arriva di solito dal metodo più semplice che sa spiegarsi e sopravvivere a input errati.
Isolation Forest e strumenti Python dedicati
Un solido cavallo di battaglia non supervisionato è Isolation Forest. Il meccanismo è semplice: costruisce alberi binari casuali, isola i punti in modo ricorsivo e considera più normale un isolamento più profondo, mentre un isolamento più superficiale segnala anomalie dopo la correzione del segno. Il talk Python citato descrive una configurazione con 100 alberi, un promemoria concreto del fatto che il modello è un ensemble e non un generatore magico di punteggi [YouTube].
Per i flussi di lavoro sugli outlier multivariati, PyOD è una libreria dedicata, e un percorso di installazione pratico è pip install pyod [GeeksforGeeks]. Il flusso di lavoro tipico di PyOD è familiare: generare o caricare i dati, addestrare un modello e poi esaminare labels_ e decision_scores_. È utile perché offre un'interfaccia ripetibile tra più rilevatori, invece di dover scrivere a mano ogni percorso di scoring.
Famiglie di rilevatori a confronto
Famiglia | Ideale per | Libreria | Output principale |
|---|---|---|---|
Metodi statistici classici | Segnali stabili, KPI semplici | Flussi in stile pandas, NumPy, SciPy | Flag o punteggio con soglia |
Isolation Forest | Dati tabellari correlati, comportamento misto | scikit-learn, PyOD | Punteggio di anomalia, etichetta |
Metodi basati sulla densità | Dati raggruppati in cluster con outlier sparsi | DBSCAN, LOF | Punteggio di outlier, appartenenza al cluster |
Autoencoder | Dati di business ad alta dimensionalità | TensorFlow, PyTorch | Errore di ricostruzione |
Gli autoencoder sono utili quando lo spazio delle feature è ampio e l'errore di ricostruzione contiene più segnale di una soglia costruita a mano. Li uso quando la struttura tabellare è reale, ma le relazioni sono troppo intricate perché una semplice regola statistica resti affidabile.
Librerie specifiche per serie temporali
Per i dati sequenziali, statsmodels, Prophet e ADTK sono i nomi noti, mentre dtaianomaly si distingue perché punta esplicitamente a fare da ponte tra ricerca accademica e applicazioni reali [arXiv]. È un cambiamento significativo, perché la maggior parte dei contenuti su Python si ferma ancora a outlier isolati da esempio giocattolo, mentre i team di produzione hanno bisogno di monitorare ricavi, attività dei clienti, tempestività e salute delle pipeline.
Se dovete scegliere tra rilevatori, la domanda è di solito se vi servono velocità, spiegabilità o resilienza al drift. Raramente si possono avere tutte e tre insieme, quindi scegliete quello che nel vostro ambiente si rompe nel modo meno grave.
Soglie, valutazione e gestione del drift
Un punteggio di anomalia grezzo non è un sistema. Diventa utile solo dopo aver deciso quanto rumore siete disposti a tollerare, come misurerete la qualità e cosa succede quando il business cambia intorno al modello.
Scegliere le soglie assecondando i dati, non contro di essi
Nei flussi di lavoro non supervisionati, il parametro di contamination è spesso la prima leva per le soglie. Questa scelta dovrebbe riflettere la frazione di anomalie che vi aspettate, non quella che sperate esista, perché un rilevatore tarato in modo troppo aggressivo sommergerà il team di falsi positivi. Sui dati di produzione preferisco partire da una soglia conservativa e poi esaminare i campioni segnalati insieme alle persone responsabili della metrica.
La fase di valutazione richiede un holdout etichettato ogni volta che è possibile ottenerlo. Precision e recall contano perché sia il volume di alert sia gli incidenti mancati sono costosi, e l'una senza l'altra dà un quadro fuorviante della qualità. Se le etichette scarseggiano, mantengo comunque un set di revisione e uso il feedback degli analisti come ciclo di calibrazione, invece di fingere che il punteggio si convalidi da solo.
Drift e modifiche allo schema richiedono controlli propri
Il concept drift cambia il comportamento di fondo, mentre lo schema drift cambia il significato stesso dei dati. Una colonna aggiunta o rimossa, o un cambio di tipo in un campo di business, può rompere un rilevatore altrimenti sano, quindi il tracciamento dello schema appartiene allo stesso percorso operativo del punteggio di anomalia. Per le pipeline di serie temporali, il riaddestramento periodico e lo scoring locale mantengono il modello più vicino al comportamento attuale.
L'articolo sul rilevamento del data drift su https://www.digna.ai/data-drift-detection è un buon complemento se state costruendo un ciclo di controllo consapevole del drift attorno ad alerting e riaddestramento.
Verità operativa: i falsi positivi fanno parte del concetto, semplicemente esistono. Il compito è instradarli in modo intelligente, non fingere che spariranno.
Un pattern di alerting a livelli funziona meglio di un unico blocco rigido. Gli alert a bassa confidenza possono finire in una dashboard, quelli a media confidenza possono avvisare un analista e gli eventi ad alta confidenza possono aprire un incidente operativo. Questa struttura vi dà un audit trail e impedisce alle persone di tarare il rilevatore fino al silenzio solo per proteggersi dal rumore.
Rendere operativo il rilevamento nell'ambiente del cliente
La maggior parte dei contenuti sulle anomalie in Python tratta ancora il modello come il traguardo. In pratica, il traguardo è il punto in cui il modello può girare dove risiedono i dati, rispettare la governance e continuare a produrre segnali utili quando l'ambiente si complica.
Perché i vincoli di deployment cambiano il design
Se i dati non possono lasciare il warehouse, l'architettura deve funzionare sul posto. Questo rende l'esecuzione nel database più di una comodità, perché riduce lo spostamento dei dati e mantiene i record sensibili all'interno dell'ambiente del cliente. Sposta inoltre l'accento dall'esplorazione in notebook a un'osservabilità ripetibile, in cui gli stessi controlli monitorano insieme data quality, modifiche allo schema, tempestività e KPI di business.
È questo il vuoto che la maggior parte dei tutorial trascura. Mostrano uno script locale, ma non come rendere l'output verificabile, revisionabile e collegato alle persone responsabili della metrica. In produzione, il segnale di anomalia ha bisogno di contesto, perché lo stesso punteggio potrebbe indicare un caricamento rotto, un feed in ritardo o un cambiamento reale nel comportamento del business.
Costruire un unico stack di osservabilità
Un modello mentale migliore è uno stack a tre livelli: ingestione e storage dei dati, model serving e API, e osservabilità e alerting. Il flusso di lavoro Python alimenta tutti e tre, ma non dovrebbe vivere come uno script isolato sul portatile di qualcuno. Dovrebbe stare all'interno di una piattaforma modulare in grado di esporre gli alert, conservare lo storico e permettere a ingegneri e analisti di esaminare insieme gli incidenti.
Per i team che riflettono sul monitoraggio proattivo in ambienti gestiti, il monitoraggio proattivo di AITS è un utile riferimento su come il linguaggio del monitoraggio si traduce nella pratica operativa reale.
Il punto è semplice. Un rilevatore che gira in locale è un prototipo. Un rilevatore integrato nell'infrastruttura del cliente fa parte del modello operativo.

Integrazione con digna tramite il digna-sdk
L'integrazione Python di digna usa il digna-sdk, e questo conta perché si tratta di un vero percorso SDK e non di un generico wrapper HTTP. L'implementazione di esempio recupera una sorgente dati per ID tramite un oggetto filtro, il che si adatta al modo in cui i controlli di produzione vengono di solito pianificati, registrati e revisionati.
Il pattern SDK interno nella guida al Python SDK di digna è utile perché mostra chiaramente il namespace e la forma degli oggetti. Il dettaglio importante è che la chiamata usa digna_sdk e che la query è costruita attorno a un identificatore della sorgente dati e a un oggetto filtro, non a una stringa di query libera.
Come eseguirlo in produzione
Inserite quella chiamata in uno scheduler, poi registrate la risposta prima di decidere se avvisare qualcuno. Se l'alert ha bassa confidenza, mantenetelo visibile nella dashboard condivisa e lasciate che il responsabile ne confermi il contesto. Se si tratta di un pattern ricorrente, consideratelo un segnale che la baseline deve adattarsi, invece di alzare semplicemente la soglia.
Regola pratica: se il vostro percorso di escalation non sa distinguere tra un'anomalia interessante e un feed rotto, la pipeline genererà rumore più velocemente di quanto generi valore.
La migliore configurazione di produzione è noiosa nel modo giusto. Il job Python recupera l'alert, la piattaforma lo registra e il team ottiene una visione chiara di cosa è cambiato, dove è cambiato e se si tratta di un problema dei dati o di un evento di business.
Adattare il metodo alla realtà e scalare
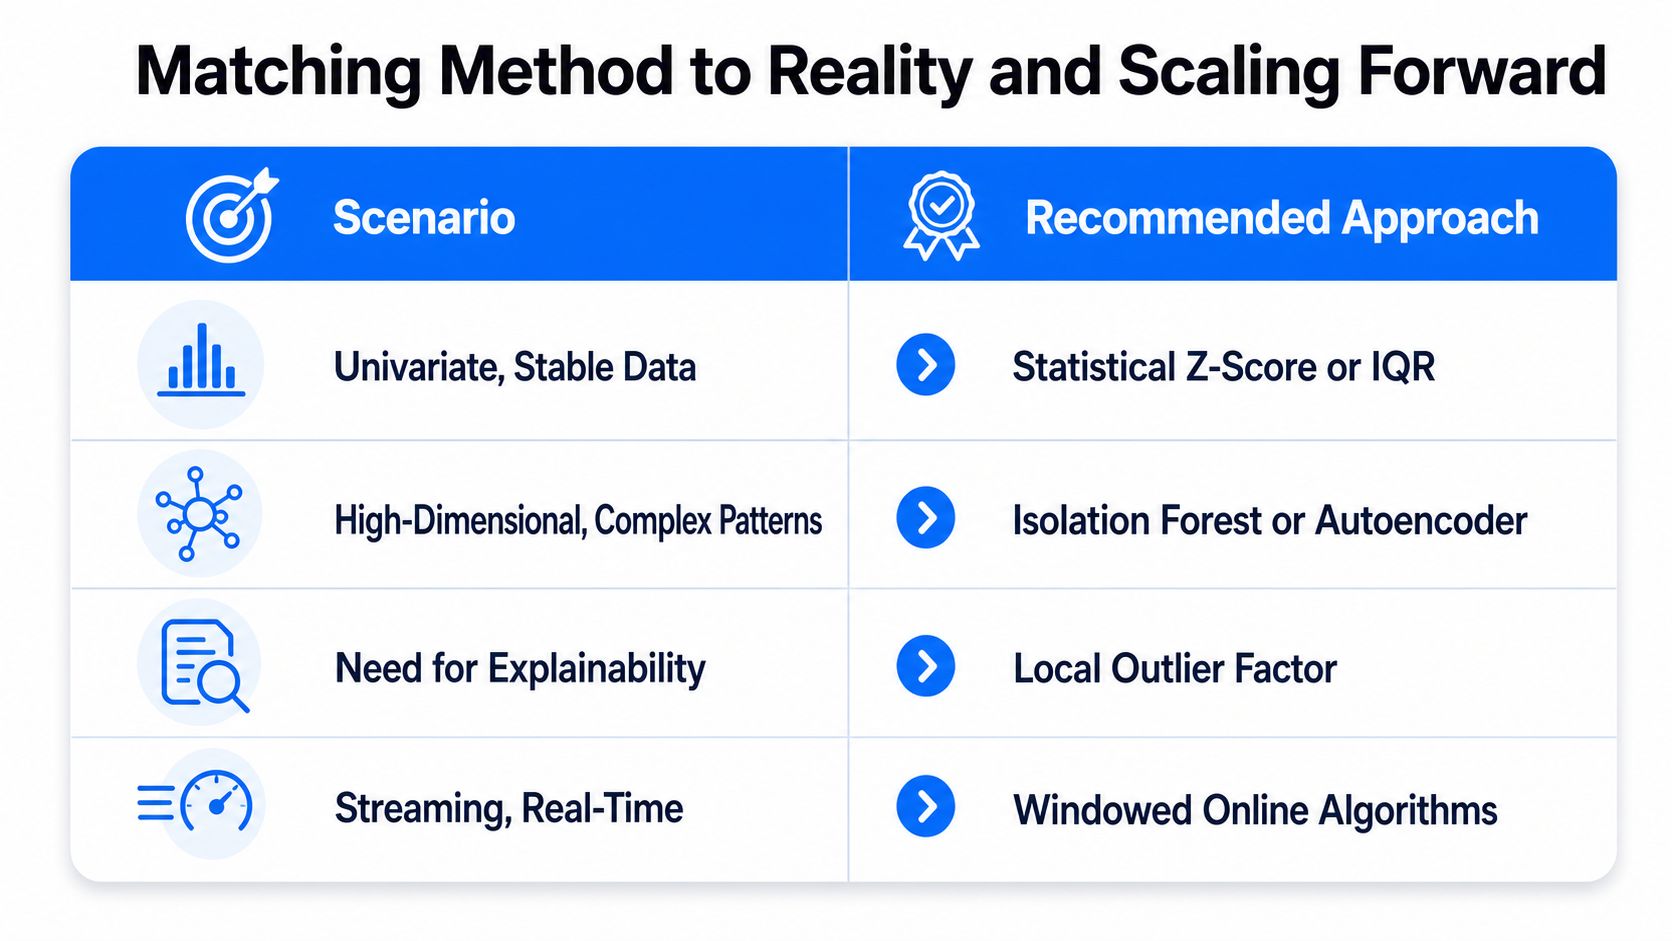
I KPI stabili meritano di solito prima di tutto statistiche semplici, perché una regola pulita basata su z-score o IQR è facile da esaminare ed economica da eseguire. I campi tabellari correlati si adattano meglio a Isolation Forest o PyOD, mentre i dati di business ad alta dimensionalità richiedono spesso un autoencoder, perché l'errore di ricostruzione cattura una struttura che una soglia non può vedere. Per i problemi di streaming o di pattern di arrivo vincono gli strumenti per serie temporali, perché la baseline deve muoversi con i dati.
I team di produzione più solidi non sostengono un unico rilevatore ovunque. Adattano il metodo allo scenario e poi costruiscono i controlli circostanti in modo che i falsi positivi siano attesi, revisionati e instradati verso le persone giuste. È questa la differenza tra una demo che attira l'attenzione e un livello di monitoraggio che protegge dashboard, modelli e decisioni di business.
Quale metodo per quale scenario
Scenario | Approccio consigliato |
|---|---|
Dati univariati e stabili | z-score statistico o IQR |
Pattern complessi ad alta dimensionalità | Isolation Forest o autoencoder |
Necessità di spiegabilità | Local Outlier Factor |
Streaming, tempo reale | Algoritmi online a finestra |
Il percorso più chiaro consiste nel combinare apprendimento di baseline, tracciamento dello schema ed esecuzione nel database all'interno dell'ambiente del cliente. Questo trasforma il rilevamento delle anomalie da esercizio in notebook a sistema di controllo capace di tenere il passo con i cambiamenti del business, anche quando i dati sono disordinati e la coda degli alert non lo è da meno.
Se state costruendo un flusso di lavoro di questo tipo e volete una piattaforma che monitori anomalie, tempestività, modifiche allo schema e metriche di business all'interno del vostro ambiente, visitate digna e vedete come i suoi moduli si inseriscono in uno stack dati di produzione.
Domande frequenti
Quale metodo Python di rilevamento delle anomalie conviene usare per i dati tabellari?
Adattate il metodo alla forma dei dati. Per una singola metrica quasi normale, le soglie basate su z-score o IQR sono semplici, veloci e facili da spiegare. Quando i campi sono correlati, passate a metodi multivariati come la distanza di Mahalanobis, EllipticEnvelope, One-Class SVM o Isolation Forest, che rispettano la struttura tra le colonne.
Come si rilevano le anomalie nelle serie temporali con Python?
Usate baseline locali invece di un'unica soglia globale. Finestre mobili, detrending e statistiche di dispersione locale permettono alla baseline di seguire la serie, e il punteggio basato sulla MAD è spesso più sicuro di una regola a 3 sigma su dati rumorosi. Librerie come statsmodels, Prophet, ADTK e dtaianomaly coprono il rilevamento specifico per le sequenze.
Come si installa e si usa PyOD per il rilevamento degli outlier?
Installatelo con pip install pyod, poi seguite il flusso standard: generate o caricate i dati, addestrate un rilevatore ed esaminate labels_ e decision_scores_. PyOD è pensato appositamente per gli outlier multivariati, e la sua interfaccia comune vi permette di cambiare rilevatore senza scrivere a mano un percorso di scoring separato per ciascuno.
Come va impostata la soglia di contamination in un rilevatore non supervisionato?
Impostate la contamination sulla frazione di anomalie che vi aspettate davvero, non su quella che sperate esista, perché un'impostazione aggressiva sommerge il team di falsi positivi. Partite in modo conservativo, esaminate i campioni segnalati con le persone responsabili della metrica e misurate precision e recall su un holdout etichettato ogni volta che è possibile ottenerlo.
Come si collega un flusso Python di rilevamento delle anomalie a digna?
Usate il digna-sdk, un SDK Python dedicato e non un generico wrapper HTTP. L'esempio importa GetDataSourceData e GetDataSourceDataFilter da digna_sdk.models e recupera una sorgente dati per ID, ad esempio id=7, tramite sdk.configuration.get_data_source. Inserite la chiamata in uno scheduler e registrate la risposta prima di avvisare qualcuno.


