Statistical pattern recognition: una guida pratica
|
6
min di lettura

Avete una dashboard che alle 9 del mattino sembrava a posto, poi un problema silenzioso in una pipeline rende sospetto ogni numero settimanale prima di pranzo. Nessun allarme scatta, la tabella si carica ancora e l'unica cosa peggiore di un report rotto è un report che le persone continuano a usare perché sembra normale. È esattamente il tipo di problema che lo statistical pattern recognition (riconoscimento statistico di pattern) è pensato per intercettare, perché cerca una struttura nei dati rumorosi invece di aspettare che scatti una regola fragile.
Sul piano pratico, questa disciplina rientra nel più ampio campo del machine learning. Un articolo di rassegna descrive il pattern recognition come “quasi sinonimo di machine learning” in alcuni contesti, mentre Bishop lo definisce come la scoperta automatica di regolarità nei dati per azioni come la classificazione articolo di rassegna, la definizione e il workflow di Bishop.
Indice
Che cos'è lo statistical pattern recognition
Una dashboard rotta raramente nasce da un guasto clamoroso. Più spesso un feed arriva in ritardo, uno schema cambia in modo impercettibile o un servizio a monte modifica la forma di un record senza avvisare nessuno. I numeri vengono ancora visualizzati, ma il loro significato è falsato, e il danno alla fiducia inizia molto prima che qualcuno se ne accorga.
Lo statistical pattern recognition è la pratica di individuare una struttura significativa nei dati trattando l'incertezza come parte del problema, non come un fastidio da ignorare. Il campo è nato negli anni Sessanta e Settanta, quando i ricercatori hanno iniziato a impostare la classificazione come un problema decisionale probabilistico anziché puramente simbolico, e il lavoro di Bishop lo ha poi formalizzato come la scoperta automatica di regolarità nei dati ai fini della classificazione il testo fondamentale di Bishop.
Perché conta nelle data operations
I controlli basati su regole sono utili quando il tipo di guasto è evidente. Faticano quando il problema è sottile, in deriva o stagionale. I metodi statistici apprendono dai dati osservati che aspetto ha la “normalità”, quindi confrontano il nuovo comportamento con quella baseline invece di affidarsi a una soglia fissa che invecchia male.
Ecco perché il campo è importante per i team di observability. La stessa logica che distingue una classe di email da un'altra, o un'immagine medica da un'altra, aiuta anche a individuare pattern anomali nelle metriche, modifiche dello schema e arrivi in ritardo prima che gli stakeholder vedano il danno. In altre parole, il metodo non è un ornamento accademico: è il meccanismo centrale del monitoraggio automatizzato moderno.
Un modo utile per pensarci è semplice. Se una regola codificata dice “invia un avviso quando il valore X supera 100”, lo statistical pattern recognition si chiede “che cosa fa di solito questa metrica, quale contesto ne modifica il comportamento e quando il pattern di oggi è insolito?”. Questo passaggio da una regola rigida a un'aspettativa appresa è ciò che rende la disciplina solida in pipeline, forme di dati e workflow di business diversi.
Concetti chiave alla base del pattern recognition
Il modo più semplice per capire questo campo è smettere di ragionare per singoli valori e iniziare a ragionare per distribuzioni. Una metrica raramente è solo un numero: ha un intervallo abituale, un ritmo e una relazione con altre metriche. Il ragionamento statistico funziona perché si chiede se una nuova osservazione sia coerente con la storia che i dati hanno raccontato finora.
La mentalità statistica in parole semplici
Pensate alle distribuzioni di probabilità come a una previsione meteo per i vostri dati. Una previsione non vi dice esattamente quale sarà la temperatura alle 15, ma vi dice che cosa è probabile. Il pattern recognition usa la stessa idea per attribuire un significato ai valori osservati, ed è per questo che un valore può sembrare strano senza essere sbagliato, oppure sembrare accettabile pur facendo parte di un guasto più ampio.
Il test di ipotesi è la fase in cui si mette in discussione la spiegazione più ovvia. Un calo in una dashboard può sembrare un problema di prodotto, ma i dati potrebbero anche riflettere un batch in ritardo, una modifica dello schema o un'ingestion parzialmente fallita. I buoni sistemi di monitoraggio non si fermano al primo segnale sospetto: verificano se il cambiamento è abbastanza forte da meritare attenzione.
Regola pratica: non confondete un valore raro con un segnale utile. Un numero conta solo quando rompe il pattern che ha senso per quel dataset.
Il model fitting è la fase in cui il sistema apprende la forma del comportamento normale. Invece di regolare a mano ogni soglia di avviso, il modello confronta i dati in arrivo con la baseline appresa dallo storico. In una piattaforma dati reale, significa che la stessa metrica può comportarsi diversamente nei giorni feriali, durante le finestre di batch o dopo il lancio di un prodotto, e il modello riesce comunque a seguirla.
Perché la riduzione delle feature semplifica la vita ai team
La riduzione della dimensionalità sembra un concetto astratto, ma l'intuizione è semplice. I grandi dataset contengono molti segnali sovrapposti e non tutti aiutano a distinguere il comportamento normale da quello anomalo. Metodi come la PCA comprimono i dati in modo che la variazione importante emerga più chiaramente, il che aiuta a separare il segnale dal rumore quando gli ingegneri esaminano distribuzioni, trend o campi correlati.

L'analogia meteorologica vale anche qui. Un singolo giorno freddo non definisce una stagione e un singolo picco non definisce un sistema. Il compito pratico è separare il rumore passeggero dal pattern che merita una risposta operativa.
Metodi statistici comuni per individuare pattern
Un modello di produzione raramente parte da un mistero senza etichette. Di solito parte da un workflow supervisionato: definire il problema, raccogliere i dati giusti, estrarre feature utili, classificare ciò che conta e valutare il risultato su esempi tenuti da parte. Il workflow e l'impostazione supervisionata di Bishop rendono esplicita questa sequenza, e questa disciplina è importante perché distingue un modello che ha appreso un pattern da uno che ha semplicemente memorizzato le stranezze storiche il workflow e l'impostazione supervisionata di Bishop. Per la data observability, questa distinzione fa la differenza tra intercettare un drift reale e inviare avvisi sul rumore di ieri.
Metodi per diversi tipi di struttura
La Principal Component Analysis, o PCA, è utile quando un dataset è affollato di variabili correlate. Riduce la dimensionalità in modo che le direzioni di variazione più forti siano più facili da esaminare, il che rende più semplice confrontare segnali correlati di freschezza, volume o latenza senza controllare ogni campo separatamente. In un sistema di monitoraggio, questo conta quando diverse metriche si muovono insieme e un solo cambiamento sottostante sta causando il problema.
Il clustering raggruppa le osservazioni che si comportano in modo simile. Funziona bene quando mancano le etichette e l'obiettivo è trovare segmenti naturali nei dati invece di imporre una classe predefinita. Per l'observability, può significare raggruppare tabelle con un comportamento di ingestion simile, oppure separare il rumore ricorrente dai pattern operativi insoliti che meritano attenzione.
Gli Hidden Markov Model, o HMM, sono più adatti quando conta la sequenza. Modellano sistemi che attraversano stati nascosti nel tempo, il che li rende una scelta pratica per processi con modalità, transizioni ed effetti ritardati. In una pipeline, aiutano a distinguere un'anomalia reale da un normale cambio di stato avvenuto gradualmente nel corso di diverse esecuzioni.
PCA: comprime misurazioni correlate in un numero minore di componenti, rendendo l'analisi dei pattern meno rumorosa.
Clustering: trova gruppi senza etichette, aiutando a individuare comportamenti ricorrenti che le regole non vedrebbero.
HMM: coglie i cambi di stato nel tempo, utile quando l'ordine degli eventi conta più di qualsiasi singola metrica.
Il compromesso è chiaro. La PCA può nascondere dettagli mentre chiarisce la variazione dominante, il clustering può rivelare una struttura utile senza spiegare perché esista e gli HMM possono modellare il comportamento temporale senza rendere la logica evidente a ogni operatore. In un workflow di observability reale, i team usano spesso questi metodi insieme, perché ciascuno risponde a una domanda diversa sullo stesso flusso di dati.
Un semplice esempio mostra la differenza. Se una tabella del data warehouse cambia improvvisamente il proprio profilo di arrivo, il clustering potrebbe mostrare che non appartiene più allo stesso gruppo comportamentale di prima, mentre un HMM potrebbe mostrare che la pipeline è passata a un nuovo stato invece di aver avuto un solo caricamento errato. Sono problemi diversi e richiedono strumenti diversi. Se volete una corrispondenza pratica tra questi metodi e le scelte di implementazione, questa guida pratica ai metodi statistici per l'analisi dei dati è un riferimento utile.
La stessa logica conta anche al di fuori del data warehouse. I team che si affidano allo scraping hanno bisogno di input stabili prima di potersi fidare degli avvisi a valle, ed è per questo che i vantaggi delle API di scraping si vedono spesso per primi in feed di dati più puliti e prevedibili.
Dalla teoria alla pratica nel rilevamento delle anomalie
I sistemi di observability più utili non aspettano che qualcuno noti una dashboard rotta. Confrontano il comportamento attuale con le aspettative apprese e segnalano lo scostamento in anticipo, spesso prima che un livello di BI o un modello a valle trasformi il problema in una discussione di business. È a quel punto che lo statistical pattern recognition diventa operativo, e non solo accademico.
Che cosa osserva davvero il rilevamento delle anomalie
Un dataset che arriva in ritardo è un problema di sequenza, quindi il change-point detection è la scelta naturale. Cerca i momenti in cui il comportamento sottostante cambia, invece di presumere che il processo resti stabile per sempre. È un approccio più adatto ai dati di produzione rispetto a una singola soglia, soprattutto quando tempi di caricamento, volumi o cardinalità cambiano per ragioni legittime.
Un ciclo di monitoraggio di base funziona così:
Apprendere dallo storico il pattern abituale di arrivo e dei valori.
Confrontare il batch o la metrica più recente con quella baseline.
Segnalare una deviazione quando la differenza è abbastanza grande da contare sul piano operativo.
Inoltrare l'avviso al team in grado di confermare se la causa è a monte, a valle o un problema di schema.
Un modello è utile solo se si adatta alla domanda operativa, non solo al dataset.
Qui l'esecuzione in-database è importante. Se la logica di monitoraggio viene eseguita dove i dati risiedono già, i team evitano di spostare tabelle sensibili solo per esaminarle. Gli strumenti di questa categoria, tra cui digna, eseguono controlli statistici all'interno dell'ambiente del cliente e si concentrano su pattern come anomalie, tempestività e modifiche dello schema.
Lo stesso schema si ritrova in tutto uno stack di data observability più solido. Le variazioni di distribuzione possono segnalare che un input del modello sta andando alla deriva, mentre il monitoraggio della tempestività può intercettare dati che sono arrivati, ma non in tempo. Per uno sguardo pratico ai metodi usati per separare gli outlier dai record normali, la panoramica sui metodi di identificazione degli outlier è un riferimento utile.
L'affidabilità delle sorgenti inizia a monte, e l'articolo sui vantaggi delle API di scraping rende chiaro questo compromesso. La stessa logica si applica all'interno dei sistemi di analytics: input instabili rendono rapidamente costosa la fiducia a valle.
Scalare il pattern recognition in produzione
Su piccola scala, ci si può permettere di esportare i dati in un notebook, eseguire qualche controllo e rivedere manualmente il risultato. Su scala di produzione, questo approccio trasforma il monitoraggio in un ulteriore problema di spostamento dei dati, che aggiunge latenza, attriti di governance e un altro punto da cui i dati sensibili possono trapelare. Un'architettura migliore mantiene l'analisi vicina ai dati e mette al centro la domanda operativa.
Perché l'analisi in-database vince nella pratica
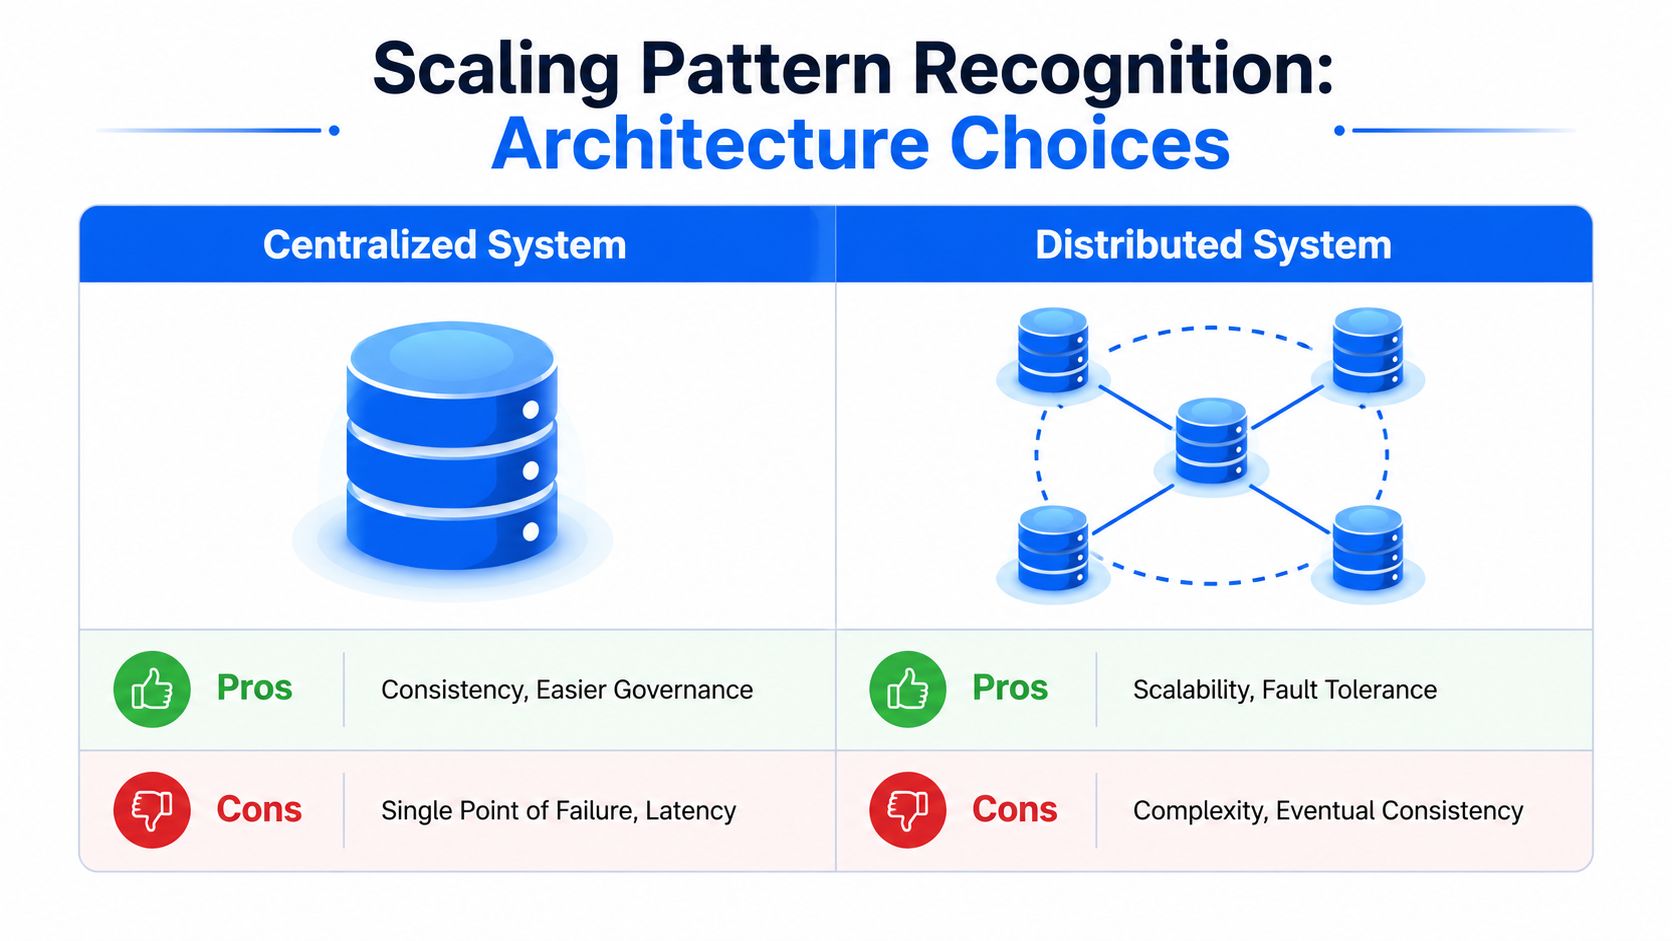
Il monitoraggio centralizzato spesso sembra ordinato su un diagramma. In produzione, può creare un unico punto in cui la latenza si accumula e la governance diventa più difficile. L'esecuzione distribuita, in particolare l'analisi in-database, mantiene l'elaborazione accanto al sistema sorgente, ed è per questo che di solito si adatta meglio all'observability moderna.
Questa scelta di design conta per tre motivi pratici. Primo, riduce la quantità di dati da spostare. Secondo, preserva i confini della privacy, perché i record restano nell'ambiente controllato dal cliente. Terzo, rende più facile monitorare molte tabelle e metriche senza trasformare il livello di observability in un collo di bottiglia.
Preferenza di engineering: quando la piattaforma dati sa già dove risiede la verità, non copiate tutto altrove solo per porre domande statistiche di base.
È anche qui che i team hanno bisogno di disciplina. Un modello che si adatta troppo strettamente al comportamento di ieri può andare in overfitting e non vedere pattern nuovi ma legittimi. D'altra parte, un modello che ignora gli effetti della pianificazione scatterà a ogni normale ritardo di batch e perderà rapidamente credibilità. Stagionalità, ingestion ritardata e cambiamenti strutturali devono far parte del design del monitoraggio, non essere trattati come eccezioni a posteriori.
Per i team che cercano un riferimento operativo più ampio, la guida pratica al rilevamento delle anomalie è un utile complemento, perché si concentra sulle realtà del deployment più che su discorsi astratti sui modelli. Lo stesso principio vale qui: il sistema deve funzionare dove girano i vostri dati.
Come i metodi statistici prevengono i disastri sui dati
Un report obsoleto raramente è il problema di fondo. Il vero problema, di solito, è che qualcuno ha preso una decisione sulla base di dati già errati o incompleti e nessuno aveva un segnale statistico abbastanza forte da fermarlo. È qui che il pattern recognition automatizzato diventa una salvaguardia per il business, non solo una funzionalità tecnica.
Tre tipi di guasto che un buon sistema intercetta
Un team finance può pensare che il mese sia in linea con le attese perché la dashboard si è caricata, anche se una tabella sorgente ha smesso di arrivare in tempo. Un modello di tempestività addestrato sulle pianificazioni storiche segnalerebbe questa deviazione prima che il report venga condiviso, un guasto molto meno costoso da gestire di una correzione davanti al management dopo la riunione.
Un team di ML può addestrare un modello su dati che sembrano validi ma che sono andati alla deriva in modo sottile. Un problema del genere non sempre rompe una pipeline, ma può contaminare gli input del modello e ridurne l'affidabilità in modi difficili da ricostruire in seguito. Il monitoraggio delle distribuzioni e il rilevamento delle anomalie sono utili qui, perché fanno emergere il cambiamento prima che venga sepolto sotto la complessità a valle.
Un analista può non vedere un trend di business reale perché il segnale si nasconde in una sequenza rumorosa di valori dall'aspetto ordinario. I metodi statistici aiutano a separare lo sfondo ricorrente dal cambiamento che conta, ed è per questo che sono utili per stabilire le priorità delle indagini. Il valore non sta solo negli avvisi, ma nell'indirizzare l'attenzione.
Una piattaforma come digna può rendere tutto questo operativo apprendendo le baseline, tracciando i trend e verificando in modo continuo il comportamento a livello di record all'interno del database. È la versione moderna del workflow classico, dalla formulazione del problema all'estrazione delle feature fino alla valutazione, solo che ora gira in background invece che in un notebook di laboratorio.
Il futuro della data quality è statistico
Il vecchio modello di data quality si basava su controlli fragili e su molta pulizia manuale. Ha ancora un ruolo per le regole di business esplicite, ma non regge quando il guasto è sottile, contestuale o in continua evoluzione. Lo statistical pattern recognition offre ai team dati un modo per stare al passo con questa realtà, apprendendo il comportamento invece di codificare ogni ipotesi.
La lezione più ampia è semplice. Un'observability affidabile dipende da metodi in grado di adattarsi a pipeline che cambiano, distribuzioni che si spostano e dati in ritardo, senza che una persona debba riscrivere le regole ogni settimana. Ecco perché questa disciplina è rimasta rilevante fin dalle sue prime radici probabilistiche negli anni Sessanta e Settanta, e perché oggi è al centro del rilevamento pratico delle anomalie nelle piattaforme dati moderne l'inquadramento storico di Bishop.
Per i team responsabili di fiducia, disponibilità e supporto alle decisioni, la domanda non è se usare metodi statistici. La domanda è se questi metodi vivono in un notebook o nel percorso di produzione, dove possono prevenire i danni.
Se state costruendo una piattaforma dati che deve intercettare anomalie, cambiamenti dello schema e problemi di tempestività prima che raggiungano dashboard o modelli, date un'occhiata a digna. Esegue il monitoraggio statistico all'interno del vostro database, mantenendo i dati sensibili dove sono e facendo emergere i pattern che contano. Se volete un'observability basata sul comportamento appreso invece che su regole fragili, iniziate da lì.
Per vedere le baseline apprese applicate alle tabelle di produzione invece che a un notebook di laboratorio, guardate come digna Data Anomalies rileva i cambiamenti inattesi nei vostri dati.
Domande frequenti
Che cos'è lo statistical pattern recognition?
Lo statistical pattern recognition è la pratica di individuare una struttura significativa nei dati trattando l'incertezza come parte del problema. È nato negli anni Sessanta e Settanta, quando i ricercatori hanno iniziato a impostare la classificazione come una decisione probabilistica, e Bishop lo ha poi formalizzato come la scoperta automatica di regolarità nei dati ai fini della classificazione.
In che cosa lo statistical pattern recognition è diverso dai controlli sui dati basati su regole?
I controlli basati su regole scattano su condizioni fisse, per esempio un avviso ogni volta che il valore X supera 100. Lo statistical pattern recognition invece apprende dai dati osservati che aspetto ha la normalità, chiedendosi che cosa fa di solito una metrica e quale contesto la modifica. Per questo è più efficace nell'intercettare problemi sottili, in deriva o stagionali che le soglie fisse non vedono.
Quali metodi statistici si usano per il pattern recognition nel monitoraggio dei dati?
Spiccano tre metodi. La PCA comprime misurazioni correlate come freschezza, volume e latenza in un numero minore di componenti; il clustering trova gruppi senza etichette, per esempio tabelle con un comportamento di ingestion simile; e gli Hidden Markov Model colgono i cambi di stato nel tempo, separando un'anomalia reale da un normale cambio di stato graduale.
In che modo il rilevamento delle anomalie sfrutta lo statistical pattern recognition?
Il rilevamento delle anomalie confronta il comportamento attuale con le aspettative apprese in un ciclo in quattro fasi: apprendere dallo storico il pattern abituale di arrivo e dei valori, confrontare il batch più recente con quella baseline, segnalare le deviazioni abbastanza grandi da contare sul piano operativo e inoltrare l'avviso al team in grado di confermare una causa a monte, a valle o di schema.
Perché eseguire il monitoraggio statistico dei dati all'interno del database?
Eseguire l'analisi in-database mantiene l'elaborazione accanto al sistema sorgente invece di esportare i dati nei notebook. I vantaggi pratici sono tre: si spostano meno dati, i confini della privacy restano intatti perché i record rimangono nell'ambiente controllato dal cliente e si possono monitorare molte tabelle e metriche senza che il livello di observability diventi un collo di bottiglia.