Record orfani: come trovarli con SQL (e tenerli fuori)
|
6
min di lettura

Una riga di pagamento riporta account_id = 884213. La tabella accounts non contiene nessun conto con quell'ID. Nessun errore, il caricamento si chiude in verde e il report di filiale della mattina successiva risulta inferiore esattamente di quel pagamento, perché il report unisce i pagamenti ai conti e la join lo scarta in silenzio. Un record orfano è una riga figlia il cui valore di foreign key non ha una riga corrispondente nella tabella genitore a cui fa riferimento.
I record orfani, o righe orfane, compaiono ovunque le foreign key non vengano applicate: data warehouse, livelli di staging, repliche, pipeline che caricano i figli prima dei genitori. Trovarli è un compito SQL standard: l'anti join. Ci sono quattro modi comuni per scriverlo, e uno di questi segnala "nessun orfano" non appena compare un solo NULL.
Questa guida tratta i pattern, le trappole e come trasformare la query in un controllo eseguito a ogni caricamento. Per il concetto in sé, consultate I vostri dati trovano ancora i loro genitori? Capire l'integrità referenziale.
Punti chiave
Le inner join nascondono i record orfani: le righe figlie senza corrispondenza scompaiono dal risultato invece di generare un errore.
Trovate gli orfani con un anti join:
LEFT JOIN … IS NULL,NOT EXISTSoppureEXCEPTsulle chiavi distinte.Evitate
NOT INsu una colonna nullable: un solo NULL nella subquery restituisce zero righe, che sembra un risultato pulito.Confrontate le chiavi composite su tutte le colonne insieme e decidete consapevolmente se una foreign key NULL è un errore.
Una query che vi ricordate di eseguire non è un controllo. In digna lo stesso anti join è un'unica regola Referential Integrity che viene eseguita a ogni ispezione.
Indice
Che cos'è un record orfano?
Perché le inner join nascondono i record orfani?
Come si trovano i record orfani con SQL?
LEFT JOIN … IS NULL
NOT EXISTS
EXCEPT (MINUS) sulle chiavi distinte
Perché NOT IN non restituisce righe quando c'è un NULL?
Quale pattern di anti join conviene usare?
Come si gestiscono le chiavi composite e le foreign key NULL?
Come si trovano i record orfani nelle tabelle di grandi dimensioni?
E se la tabella genitore si trova in un altro database?
Come si trasforma una query sugli orfani in un controllo permanente?
Trovateli una volta, poi teneteli fuori
Che cos'è un record orfano?
Un record orfano è una riga di una tabella figlia la cui foreign key punta a una chiave genitore inesistente: un pagamento il cui account_id non è presente in accounts, oppure una somministrazione di farmaco il cui product_code non è presente in medications. La riga può essere perfettamente valida di per sé. Ciò che è rotto è la relazione.
Gli orfani si trovano sempre dal lato figlio; un conto senza pagamenti è normale. Le cause abituali sono banali: il genitore è stato eliminato o non è mai stato caricato, il figlio è arrivato prima del caricamento dei dati anagrafici del giorno dopo, oppure i formati delle chiavi differiscono ('00884213' rispetto a 884213, o uno spazio finale).
I database operativi come PostgreSQL o Oracle applicano le foreign key dichiarate, ma le copie nel data warehouse di solito non riportano i vincoli. La maggior parte dei data warehouse cloud accetta una dichiarazione FOREIGN KEY senza applicarla; la documentazione di BigQuery afferma che non applica i vincoli di primary key e foreign key. Spieghiamo a parte perché Snowflake, BigQuery, Redshift e Databricks non applicano le foreign key.
Perché le inner join nascondono i record orfani?
Una inner join restituisce solo le righe che hanno una corrispondenza su entrambi i lati, quindi una riga figlia senza genitore semplicemente non compare nel risultato. Non c'è alcun errore, alcun avviso e nessun NULL da notare. I totali risultano più bassi del dovuto e nulla nel report stesso mostra la differenza.
Ogni pagamento il cui account_id manca da accounts viene escluso prima della SUM. Il modo più rapido per vedere la differenza è contare in entrambi i modi:
Se account_id è univoco in accounts, la differenza corrisponde ai vostri orfani più le eventuali righe con account_id NULL.
Le chiavi dichiarate ma non verificate possono peggiorare la situazione. Il planner di Amazon Redshift presume che le chiavi dichiarate siano valide, e AWS avverte che chiavi non valide possono far restituire risultati errati ad alcune query.
Come si trovano i record orfani con SQL?
I record orfani si trovano con un anti join: una query che restituisce le righe figlie per le quali non esiste una riga genitore corrispondente. In SQL lo si scrive come LEFT JOIN … WHERE parent_key IS NULL, come NOT EXISTS oppure come EXCEPT sui valori distinti della chiave. Su chiavi non nulle, tutti e tre danno lo stesso risultato.
LEFT JOIN … IS NULL
Verificate una colonna del genitore che non può essere NULL in una riga con corrispondenza, idealmente la chiave di join. Inserite le condizioni sul genitore nella clausola ON: WHERE a.status = 'ACTIVE' non è mai vera per una riga senza corrispondenza, quindi la query non restituirebbe nulla.
NOT EXISTS
Si legge esattamente come la domanda. Le chiavi genitore duplicate non moltiplicano le righe e i NULL in accounts.account_id non possono comprometterla: un'uguaglianza con NULL non trova mai corrispondenza.
EXCEPT (MINUS) sulle chiavi distinte
Questa query restituisce i valori distinti delle chiavi mancanti, non le righe. Spesso è la prima domanda migliore da porsi: una manciata di conti mancanti può spiegare migliaia di pagamenti orfani. Oracle ha tradizionalmente chiamato l'operatore MINUS; BigQuery richiede EXCEPT DISTINCT. Gli operatori insiemistici considerano uguali due NULL: un motivo in più per filtrare esplicitamente le chiavi NULL.
Perché NOT IN non restituisce righe quando c'è un NULL?
NOT IN non restituisce alcuna riga se la sua subquery contiene anche un solo NULL, perché la logica a tre valori di SQL rende sconosciuto ogni confronto con quel NULL. x NOT IN (1, 2, NULL) significa x <> 1 AND x <> 2 AND x <> NULL. L'ultimo termine non è mai vero, quindi l'intera condizione non è mai vera.
Per un pagamento il cui conto esiste, un confronto è falso e la riga viene correttamente esclusa. Per un conto mancante, ogni confronto con una chiave reale è vero ma quello con NULL è sconosciuto, quindi la condizione è sconosciuta, e WHERE mantiene solo le righe vere. Il risultato è un insieme vuoto, indistinguibile da "nessun orfano".
Fallisce in silenzio, con un falso via libera, e le colonne chiave nei data warehouse spesso non sono dichiarate NOT NULL. Nemmeno i pagamenti il cui account_id è NULL vengono mai inclusi. Usate NOT EXISTS, o almeno aggiungete WHERE a.account_id IS NOT NULL all'interno della subquery.
Quale pattern di anti join conviene usare?
Usate NOT EXISTS come scelta predefinita per i controlli sugli orfani a livello di riga, EXCEPT quando volete l'elenco dei valori di chiave mancanti e LEFT JOIN … IS NULL quando volete anche i conteggi delle corrispondenze nello stesso passaggio. Usate NOT IN solo quando entrambe le colonne sono garantite non nulle.
Pattern | Restituisce | NULL nella chiave genitore | Foreign key NULL nel figlio | Leggibilità | Prestazioni tipiche |
|---|---|---|---|---|---|
LEFT JOIN … IS NULL | Righe figlie | Sicuro | Segnalata come orfana se non filtrata | Familiare; l'intento sta nella clausola WHERE | Di solito pianificata come anti join |
NOT EXISTS | Righe figlie | Sicuro | Segnalata come orfana se non filtrata | Si legge come la domanda | Di solito pianificata come anti join |
EXCEPT / MINUS | Valori distinti della chiave | Sicuro | Restituita una volta come NULL se non filtrata | Breve e chiaro per gli elenchi di chiavi | Deduplica entrambi i lati; ottimo per riepiloghi a livello di chiave |
NOT IN | Righe figlie | Non sicuro: un solo NULL restituisce zero righe | Esclusa in silenzio | Si legge bene, ma trae in inganno | Va bene su colonne non nulle; può ottenere un piano peggiore su quelle nullable |
La maggior parte degli optimizer pianifica LEFT JOIN e NOT EXISTS allo stesso modo; verificate il piano sulla vostra piattaforma.
Come si gestiscono le chiavi composite e le foreign key NULL?
Per una chiave composita, confrontate tutte le colonne della chiave insieme in un unico predicato, mai colonna per colonna: una riga è orfana quando manca la sua combinazione, anche se ogni singolo valore esiste da qualche parte. Le foreign key NULL richiedono una decisione consapevole prima di contarle: riferimento mancante o valore legittimamente vuoto.
Supponiamo che ogni ospedale abbia il proprio prontuario, con chiave (hospital_id, product_code):
Due controlli separati, "l'ospedale esiste" e "il prodotto esiste", vengono entrambi superati da un prodotto presente solo nel prontuario dell'ospedale A e somministrato nell'ospedale B. Solo il predicato combinato lo intercetta. EXCEPT gestisce in modo naturale le chiavi composite. Non concatenate le chiavi in un'unica stringa: '1' || '23' e '12' || '3' collidono.
Un pagamento con account_id NULL non punta a un conto mancante: non punta da nessuna parte. Un pagamento deve avere un conto, mentre un riferimento facoltativo come referring_doctor_id può essere vuoto. Escludete i NULL dalla query sugli orfani e contateli separatamente:
Come si trovano i record orfani nelle tabelle di grandi dimensioni?
Sulle tabelle di grandi dimensioni, contate prima di elencare, confrontate i valori distinti della chiave anziché ogni riga e limitate il lato figlio all'ultimo caricamento o all'ultima partizione. Mantenete completo il lato genitore: un pagamento registrato oggi può fare riferimento a un conto aperto anni fa, quindi non filtrate mai il genitore per data di caricamento.
Contate prima. Eseguite l'anti join come
COUNT(*). Recuperate le righe solo quando il conteggio è diverso da zero, e in quel caso con un limite.Confrontate le chiavi distinte. Riducete prima il lato figlio a
SELECT DISTINCT account_id. Le chiavi distinte sono di solito molte meno delle righe.Filtrate sull'ultimo caricamento. Limitate il figlio alla partizione più recente o alla
load_datepiù recente, così il motore può effettuare il pruning.Mantenete confrontabile la colonna di join. Stesso tipo di dato su entrambi i lati, nessun
CASToTRIMnel predicato, che possono impedire l'uso degli indici e il pruning. Correggete invece i formati in fase di caricamento; consultate la nostra guida alla pulizia dei dati in SQL.Registrate il risultato. Memorizzate data, righe valutate e orfani trovati per osservarne l'andamento.
Questa query conta le chiavi mancanti, non le righe orfane; estraete in seguito le righe relative a quelle chiavi.
E se la tabella genitore si trova in un altro database?
Un anti join funziona solo quando un unico motore di query può leggere entrambe le tabelle. Se i pagamenti si trovano nel data warehouse e i conti nel database del core banking, il semplice SQL non può vederli entrambi: dovete quindi copiare uno dei due lati, usare un database link o una query federata, oppure eseguire il controllo con uno strumento in grado di raggiungere entrambe le connessioni.
Una tabella anagrafica copiata è un'ulteriore pipeline con il proprio ritardo: una copia non aggiornata segnala falsi orfani o non rileva quelli reali. I database link dipendono dal supporto della piattaforma e richiedono un'approvazione di sicurezza per ogni nuova connessione.
Come si trasforma una query sugli orfani in un controllo permanente?
Una query sugli orfani diventa un controllo permanente quando la si esegue a ogni caricamento, si registrano i conteggi delle righe superate e non superate, si imposta una soglia di fallimento e si conservano le righe non conformi dove il team responsabile può vederle. In digna si tratta di un'unica regola Referential Integrity, configurata in una finestra di dialogo, senza scrivere SQL.
digna Data Validation prevede tre tipi di regola: Rule, Uniqueness e Referential Integrity. Quella referenziale è l'anti join di questo articolo: date alcune colonne di una data source e un insieme corrispondente su un'altra, digna mantiene i valori distinti dell'altra tabella e segnala come non conforme ogni riga che non trova corrispondenza. Viene eseguita all'interno del vostro database sorgente; i vostri dati non lasciano mai la vostra infrastruttura. Dalla Release 2026.01 funziona anche tra connessioni a database diversi all'interno dello stesso progetto, senza replicare i dati.
Gli screenshot che seguono usano i dati demo di digna per Danubia Kliniken, un gruppo ospedaliero austriaco fittizio.
Il 22-04-2026 i reparti hanno registrato 82 somministrazioni di Coavira 2,5 mg (codice prodotto 3858646), non ancora presente nell'anagrafica prodotti della farmacia. Ogni report che univa le dosi ai prodotti ne mostrava 0, mentre gli infermieri ne avevano somministrate 82. La regola hc_product_in_master non è stata superata: 4.244 righe su 4.326 sono risultate conformi. A mano, servirebbe:
La vista Invalid Records mostra quel set di risultati senza che nessuno debba scriverlo:

Invalid Records, filtrata su Failed: ogni dose orfana con ospedale, reparto, dipartimento, codice prodotto e nome del farmaco.
Configurazione della regola:
Configuration → data source
hospital_medication_administrations→ scheda Data Validation → Add Rule. Si apre la finestra di dialogo Add Data Validation Rule.Inserite un Name (
hc_product_in_master) e una Description.Impostate Type su Referential Integrity e scegliete gli Attributes
product_code.In must exist in, scegliete la Data Source
hospital_medicationse i relativi Attributesproduct_code. Per una chiave composita, scegliete più colonne su entrambi i lati nello stesso ordine; elenchi di lunghezza diversa vengono rifiutati.Scegliete il Threshold Mode Absolute o Relative e impostate l'Info threshold e il Warn threshold (qui: Absolute, Info 0, Warn 1). Salvate. La regola viene eseguita a ogni ispezione, pianificata o su richiesta.
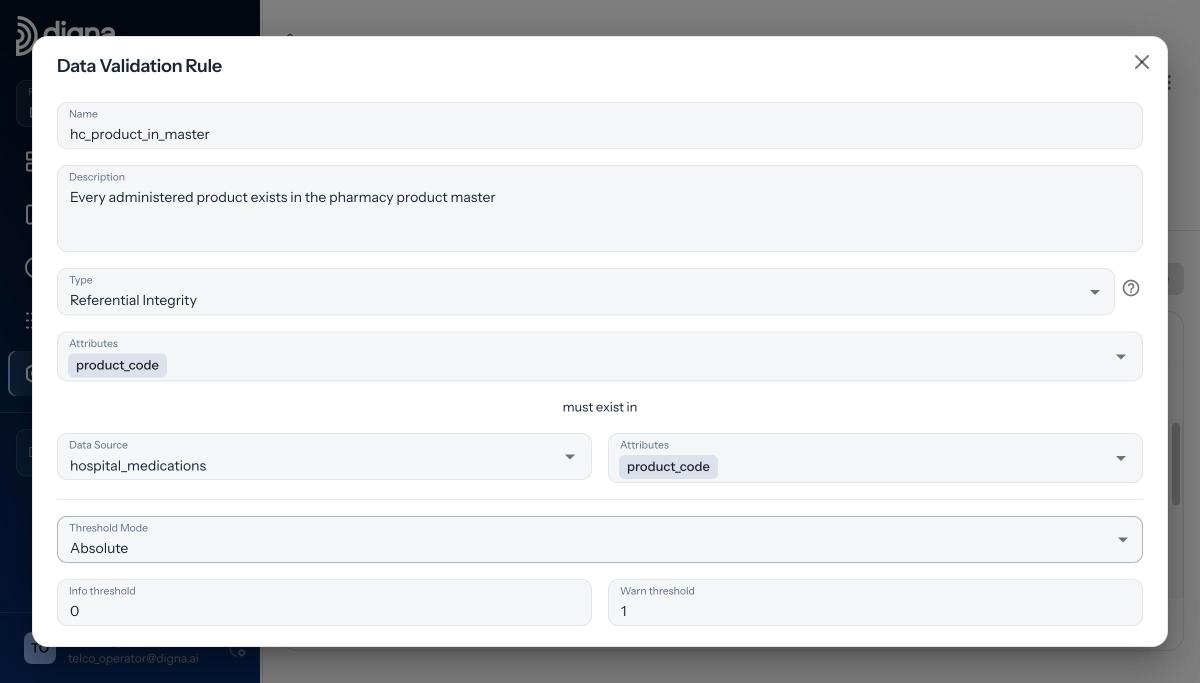
L'intera regola: due elenchi di attributi, una data source di destinazione e due soglie.
Referential Integrity ignora i NULL, come il filtro IS NOT NULL visto sopra; se la presenza del valore è obbligatoria, aggiungete una Rule separata con product_code IS NOT NULL. Oltre l'Info threshold lo stato è Uncertain, oltre il Warn threshold è Failed, quindi con Info a 0 qualsiasi orfano fa uscire la regola dallo stato Passed. I record non conformi corrispondono alla stessa query con la condizione di superamento negata, sono esportabili e i risultati possono notificare il team responsabile dei dati.
Dalla Release 2026.06 le regole possono anche essere gestite come codice tramite il Python SDK (pip install digna-sdk). Per la procedura completa, consultate come configurare un controllo di integrità referenziale in digna oppure il video di configurazione di 2:26.
Trovateli una volta, poi teneteli fuori
Per indagare sui record orfani: NOT EXISTS per le righe, EXCEPT per le chiavi mancanti, mai NOT IN su una colonna nullable e una decisione consapevole sui NULL. Tenerli fuori richiede di più: applicate le foreign key dove il database lo consente, caricate prima i genitori, gestite esplicitamente i dati anagrafici in arrivo tardivo ed eseguite il controllo referenziale a ogni caricamento.
Per vedere quel controllo in esecuzione sulle vostre tabelle, all'interno della vostra infrastruttura, prenotate una demo con il team di digna.
Domande frequenti
Come si trovano i record orfani in SQL?
Usate un anti join che restituisca le righe figlie senza un genitore corrispondente. La forma più robusta è NOT EXISTS con una subquery correlata sulla chiave; LEFT JOIN … WHERE parent_key IS NULL dà lo stesso risultato. Escludete prima le foreign key NULL e contatele con un controllo di completezza separato.
Perché NOT IN non restituisce righe quando la subquery contiene un NULL?
Il motivo è la logica a tre valori. x NOT IN (1, 2, NULL) si espande in x <> 1 AND x <> 2 AND x <> NULL, e l'ultimo confronto è sconosciuto, mai vero. WHERE mantiene solo le righe vere, quindi la query non restituisce nulla, il che sembra esattamente un risultato pulito.
NOT EXISTS è più veloce di LEFT JOIN IS NULL?
Di solito nessuno dei due è più veloce: la maggior parte degli optimizer moderni pianifica entrambi come anti join, quindi la scelta dipende dalla leggibilità. L'eccezione è NOT IN: sulle colonne nullable può ottenere un piano peggiore e non restituisce alcuna riga quando la subquery contiene un NULL.
Qual è la differenza tra un record orfano e una foreign key NULL?
Un record orfano punta a una chiave genitore che non esiste, mentre una foreign key NULL non punta da nessuna parte. Richiedono controlli diversi: l'integrità referenziale per gli orfani e una regola IS NOT NULL dove il riferimento è obbligatorio. Proprio per questo la regola Referential Integrity di digna ignora i NULL.
Come posso verificare automaticamente la presenza di record orfani dopo ogni caricamento?
Trasformate l'anti join in un controllo pianificato con soglie e risultati memorizzati. In digna si tratta di un'unica regola Referential Integrity in Data Validation: scegliete le colonne, scegliete la data source in cui devono esistere, impostate le soglie Info e Warn e salvate. La regola viene eseguita all'interno del vostro database a ogni ispezione.


