Pulizia dei dati in SQL: schemi pratici
|
9
min di lettura
Una dashboard registra un picco durante la notte e la prima spiegazione è di solito l'attività di business. Poi qualcuno controlla il warehouse e trova ordini duplicati, chiavi esterne mancanti o date interpretate in due formati diversi. Il report non era “quasi giusto”. I suoi input erano incoerenti e ogni calcolo a valle ha ereditato il problema.
Questa è la realtà operativa della pulizia dei dati in SQL. Il lavoro riguarda meno la sintassi ingegnosa e più la misurazione dei difetti, l'isolamento dei record a rischio, l'applicazione di correzioni deterministiche e la prevenzione del ritorno degli stessi difetti. Su scala di warehouse, un UPDATE avventato può danneggiare più dati di quanti ne corregga, mentre un flusso di lavoro SQL ben strutturato in fasi può rendere la logica di qualità ripetibile, revisionabile ed efficiente.
Indice
Perché SQL resta la spina dorsale della pulizia dei dati
Profilare i dati prima di scrivere una sola correzione
Stabilire una baseline dei difetti
Trovare i duplicati senza toccare la produzione
Gestire i null e rimuovere i duplicati su larga scala
Deduplicare con una regola esplicita per il record superstite
Sapere come l'unicità tratta i null
Standardizzare i formati di testo e correggere i tipi di dati
Rendere esplicite le conversioni
Standardizzare prima di deduplicare
Consolidare la qualità con vincoli e regole di validazione
Scegliere tra rifiuto rigido e quarantena morbida
Andare oltre gli script una tantum verso il monitoraggio continuo
Perché SQL resta la spina dorsale della pulizia dei dati
Un grande carico di lavoro analitico può dedicare più tempo alla preparazione dei dati che alla loro analisi. Un benchmark molto citato afferma che analisti e data scientist possono dedicare fino all'80% del loro tempo alla pulizia e alla preparazione dei dati, un dato discusso in questa panoramica di Domo sulla pulizia dei dati in SQL. Questa ripartizione spiega perché operazioni come filtrare i null, rimuovere i duplicati, standardizzare i formati e validare gli intervalli sono diventate competenze di base per data engineer e analytics engineer.
SQL lavora vicino ai dati, e questo conta nelle moderne architetture ELT. I record grezzi possono essere caricati in un warehouse e trasformati là dove già risiedono, invece di essere ripetutamente estratti, spostati ed elaborati in un altro sistema. Il database diventa il livello di esecuzione della logica di qualità, mentre le istruzioni SQL forniscono una registrazione deterministica di che cosa è cambiato e perché.
Un incidente tipico inizia con un piccolo difetto che diventa un grande problema di reporting:
Eventi di business duplicati: un nuovo tentativo in un job di ingestion crea due righe per una sola transazione, gonfiando ricavi o volumi.
Chiavi di relazione mancanti: una chiave cliente o prodotto null impedisce la corrispondenza di un join, quindi la dashboard sottostima l'attività.
Deriva del formato: una sorgente invia una data come testo secondo una convenzione diversa, spostando i record nel periodo di reporting sbagliato.
Valori sentinella: stringhe vuote, date segnaposto o zeri sostituiscono informazioni mancanti e superano i controlli superficiali sui null.
Regola di produzione: trattate la pulizia come un'operazione controllata sui dati, non come una serie improvvisata di correzioni all'interno di una query di dashboard.
La distinzione è importante perché SQL può sia riparare sia nascondere i difetti. Un COALESCE può far visualizzare un report mascherando un valore mancante che dovrebbe far scattare un incidente a monte. Un DELETE troppo ampio può rimuovere i duplicati eliminando anche il record valido che avrebbe dovuto essere conservato. Una buona logica di pulizia classifica prima gli errori, isola le righe interessate e conserva evidenze sufficienti per verificare la decisione.
Per chi desidera esempi SQL più ampi e prospettive pratiche, le risorse SQL di Wonderment Apps offrono un contesto utile sul linguaggio e sulle sue applicazioni. Per i team che valutano l'esecuzione della qualità nativa nel warehouse, le indicazioni di digna sulla qualità dei dati in-database sono pertinenti, perché mantenere i controlli vicino ai dati riduce gli spostamenti non necessari e separa la logica di validazione da fragili script esterni.
Profilare i dati prima di scrivere una sola correzione
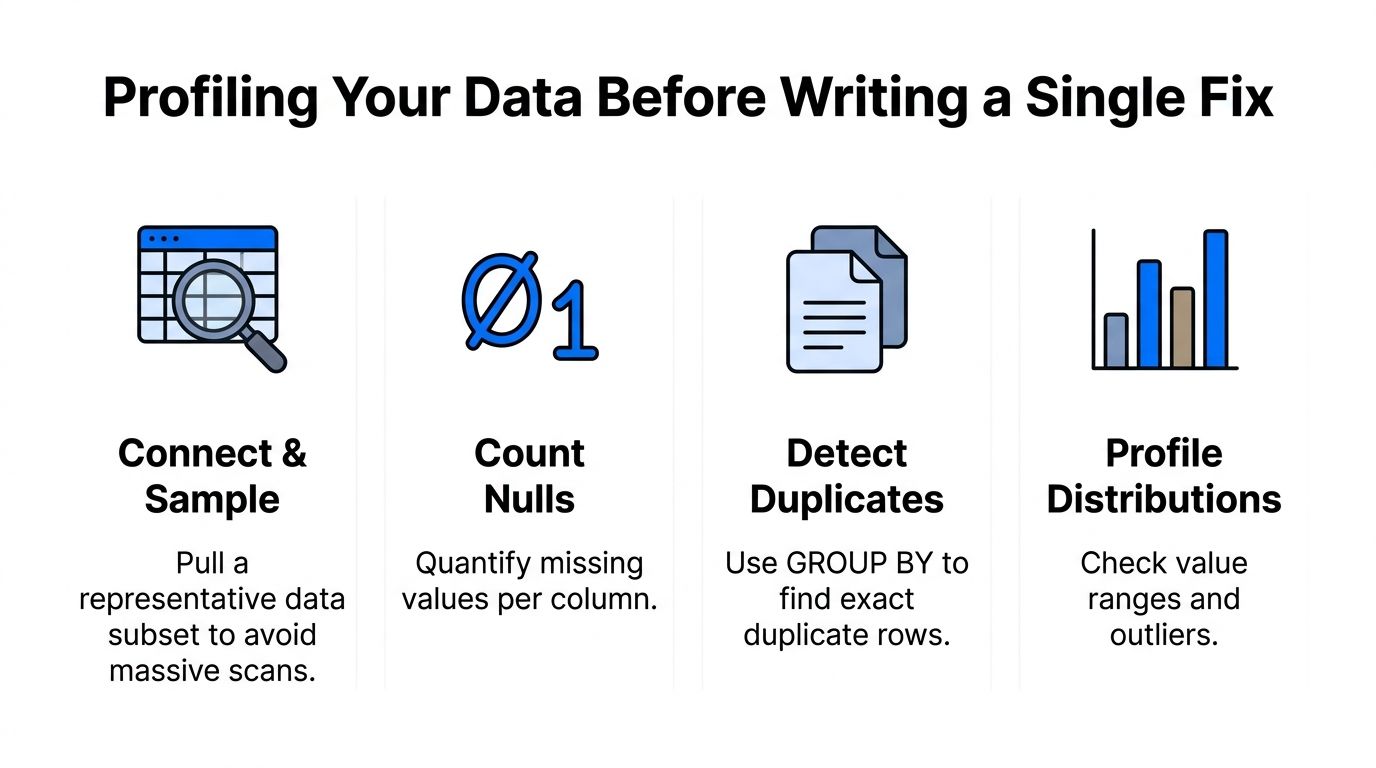
L'errore di pulizia più costoso è spesso il primo: scrivere un UPDATE prima di aver misurato il problema. Un profilo vi fornisce una baseline, rivela se il problema è isolato o sistemico e vi consente di confrontare il dataset prima e dopo la correzione.
Quando la tabella è grande, partite da un campione rappresentativo. Un campione non sostituisce un passaggio di validazione completo, ma vi aiuta a esaminare formati e valori di business senza imporre subito una scansione massiccia. Eseguite aggregazioni mirate sull'intera tabella quando il motore del warehouse e il partizionamento rendono praticabili questi controlli.
Stabilire una baseline dei difetti
Per le colonne nullable, contate direttamente i valori mancanti invece di affidarvi a un campione visivo:
Il tasso di null è utile perché rende il difetto misurabile e confrontabile tra le esecuzioni della pipeline. Potete anche raggruppare i valori mancanti per sistema sorgente, partizione o data di ingestion, per distinguere una caratteristica di lunga data dei dati da un guasto recente.
I controlli sui valori distinti fanno emergere categorie inattese:
Cercate varianti ortografiche, maiuscole e minuscole incoerenti, stringhe vuote e valori che violano il vocabolario di business. Una colonna che sembra contenere un piccolo insieme di stati può contenere diverse rappresentazioni dello stesso stato.
Trovare i duplicati senza toccare la produzione
Il rilevamento dei duplicati esatti parte dal raggruppamento delle colonne che definiscono il record:
Questa query vi dice dove si trovano i duplicati, ma non quale riga debba sopravvivere. Raccogliete i record sospetti in una tabella di staging separata e includete i metadati di ingestion, la priorità della sorgente, il timestamp di aggiornamento e, se disponibile, una chiave surrogata stabile.
La sintassi esatta varia a seconda del warehouse, ma il principio operativo è costante: non sperimentate mai direttamente sulla relazione di produzione quando potete isolare prima i candidati. Le indicazioni pratiche sulla pulizia in SQL raccomandano inoltre di validare le trasformazioni su piccoli sottoinsiemi prima di applicarle su larga scala, il che riduce il raggio d'impatto di un predicato errato. Le tecniche di data profiling usate nella pulizia del warehouse completano questo approccio rendendo esplicita la fase di ispezione invece di trattarla come una preparazione facoltativa.
Prima misurate, poi riparate. Se non sapete dire quante righe sono interessate, non potete revisionare la modifica in sicurezza.
Gestire i null e rimuovere i duplicati su larga scala
La gestione dei null è una decisione di business travestita da espressione SQL. Sostituire ogni valore mancante con un valore predefinito può semplificare le query a valle, ma può anche trasformare un “sconosciuto” in un'affermazione falsa. Mantenete disponibile il valore originale quando la distinzione è importante.
COALESCE è appropriato quando un valore di fallback ha un significato chiaro:
Questo schema è più sicuro per la presentazione che per l'archiviazione irreversibile. Se una valuta assente significa che la sorgente non ha fornito un'informazione obbligatoria, un flag di validazione è più onesto:
NULLIF aiuta a convertire i segnaposto noti in veri null prima della profilazione:
Potete anche usare una logica condizionale quando la sostituzione corretta dipende da una regola documentata. Non deducete un attributo del cliente da un campo non correlato solo perché la query ha bisogno di un valore non null.
Deduplicare con una regola esplicita per il record superstite
ROW_NUMBER() è lo schema affidabile per identificare un solo record superstite all'interno di ciascun gruppo di duplicati:
La clausola ORDER BY è la parte importante. “Mantenere il più recente” funziona solo se il timestamp è affidabile e i pareggi hanno un criterio di fallback deterministico. Se i record differiscono per completezza, ordinateli secondo una regola di completezza documentata invece di presumere che l'ultima riga arrivata sia la migliore.
Per le tabelle su scala di warehouse, materializzate ove possibile il risultato ordinato in una nuova relazione o in una partizione sostitutiva. Ricostruire una partizione pulita può essere più sicuro che eseguire una massiccia cancellazione riga per riga, soprattutto quando la tabella è clusterizzata o partizionata. Conservate le righe scartate in una tabella di audit se i duplicati potrebbero richiedere una correzione nel sistema sorgente.
Sapere come l'unicità tratta i null
SQL Server ha un comportamento particolarmente importante: un vincolo UNIQUE ammette NULL, ma è consentito un solo NULL per colonna vincolata, come documentato nel riferimento Microsoft sui vincoli UNIQUE e CHECK. Questo comportamento può sorprendere i team che puliscono campi facoltativi, perché la gestione dei null influisce sull'accettazione o sul rifiuto dei record successivi.
Usate i controlli di completezza dei dati per distinguere tra “mancante ma consentito” e “mancante e non valido”. Eliminate i duplicati solo quando la regola di identità non è ambigua. Altrimenti, contrassegnate il gruppo per la revisione e conservate le evidenze necessarie a spiegare perché è stato selezionato un determinato record.
Standardizzare i formati di testo e correggere i tipi di dati
Le incoerenze nel testo sopravvivono spesso ai test di base perché a una persona sembrano corrette. Uno spazio finale in una chiave di join, maiuscole diverse in uno stato o un carattere Unicode simile a un carattere ASCII possono produrre join senza corrispondenza e aggregati frammentati.
Normalizzate prima i valori in una proiezione controllata:
TRIM rimuove gli spazi iniziali e finali, mentre UPPER e LOWER stabiliscono una forma di confronto coerente. REPLACE può rimuovere caratteri di formattazione noti, ma le sostituzioni generalizzate sono rischiose quando la punteggiatura ha un significato. Le espressioni regolari sono utili per la validazione dei pattern e per correzioni mirate dove il warehouse le supporta, ma vanno testate sulle varianti reali delle sorgenti anziché applicate come strumento di pulizia universale.
Rendere esplicite le conversioni
I cast impliciti sono comodi durante l'esplorazione e pericolosi in produzione. Un valore di testo può essere convertito in modo diverso a seconda del motore, delle impostazioni di sessione, della localizzazione o del tipo di destinazione. Le istruzioni esplicite CAST o CONVERT rendono visibile la rappresentazione prevista:
Prima di convertire, profilate i valori che non rispettano il formato atteso. Un cast non riuscito va registrato come eccezione di qualità, non scartato. Verificate anche precisione e scala, perché un tipo numerico di destinazione può perdere dettagli significativi se è più ristretto della sorgente.
I dati temporali richiedono ancora più attenzione. Un timestamp senza contesto di fuso orario può slittare quando i sistemi lo interpretano con impostazioni di sessione diverse. Standardizzate la convenzione della sorgente, convertite secondo una policy esplicita sui fusi orari e conservate il valore grezzo originale finché il risultato non supera la validazione.
Standardizzare prima di deduplicare
L'ordine conta. Una sequenza di pulizia pratica consiste nell'esaminare null, duplicati e formati insoliti, poi standardizzare il testo, correggere i tipi e deduplicare dopo aver ricondotto i valori equivalenti a una forma comune. Questo ordine è descritto nelle indicazioni sulla pulizia dei dati in SQL relative a ispezione e standardizzazione.
Se deduplicate prima di eliminare gli spazi e normalizzare, record come ACME e ACME restano separati anche se il business li considera un'unica chiave. Se aggiungete vincoli prima della conversione dei tipi, il database potrebbe rifiutare record validi in arrivo o conservare una rappresentazione inadatta. Durante lo sviluppo, mantenete distinte le colonne grezze, normalizzate e validate, così che i revisori possano confrontare ogni trasformazione.
Consolidare la qualità con vincoli e regole di validazione
Uno script di pulizia corregge il batch attuale. Un vincolo protegge il batch successivo. Usate le protezioni del database quando la regola è stabile, circoscritta al record e abbastanza importante da rifiutare i dati non validi in fase di ingestion.
Vincolo | Ambito | Caso d'uso ideale |
|---|---|---|
| Presenza della colonna | Identificativi, date e chiavi obbligatori |
| Singola colonna o combinazione | Controllo dell'identità e prevenzione dei duplicati |
| Regola booleana a livello di riga | Intervalli consentiti, stati e ordine delle date |
NOT NULL è semplice, ma dovrebbe riflettere un requisito reale. Applicarlo a un attributo facoltativo crea attriti operativi senza migliorare la correttezza. UNIQUE funziona bene per identificativi naturali o chiavi di business composte, a patto di aver definito come devono comportarsi i null e gli aggiornamenti in ritardo.
I vincoli CHECK esprimono regole come:
Le espressioni CHECK dell'ANSI SQL possono restituire TRUE, FALSE o UNKNOWN e sono limitate all'integrità di dominio. Possono validare i valori di una riga, ma non possono esaminare altre righe per verificare la coerenza tra righe, come spiegato in questo riferimento sulla migrazione dei vincoli SQL. Un CHECK può rifiutare un importo negativo o un ordine di date non valido. Non può confermare che il totale di un conto quadri con una tabella separata.
Scegliere tra rifiuto rigido e quarantena morbida
I vincoli rigidi sono appropriati quando accettare una riga errata corromperebbe una tabella critica e la sorgente può correggere rapidamente gli errori. Sono meno adatti quando i sistemi a monte inviano regolarmente record parziali che richiedono un'indagine prima della finalizzazione.
Uno schema morbido archivia il record aggiungendo colonne di validazione come is_valid, failure_reason o rule_name. I modelli a valle possono escludere le righe non valide, mentre i team operativi mantengono la visibilità sul difetto della sorgente. Questo approccio richiede un maggiore sforzo di progettazione, ma evita di trasformare un problema temporaneo della sorgente in un caricamento fallito privo di contesto diagnostico.
Le indicazioni su regole di validazione dei dati in SQL e qualità continua offrono un framework utile per distinguere valori obbligatori, formati, completezza, unicità e integrità referenziale. Nella pratica, combinate i vincoli con la validazione in staging. I vincoli sono l'ultimo controllo, non un sostituto della profilazione, della classificazione degli errori o di un audit trail.
Andare oltre gli script una tantum verso il monitoraggio continuo
La pulizia in SQL è reattiva. Ripara i record dopo che un difetto è entrato nella pipeline, mentre il monitoraggio continuo cerca le condizioni che indicano una regressione.
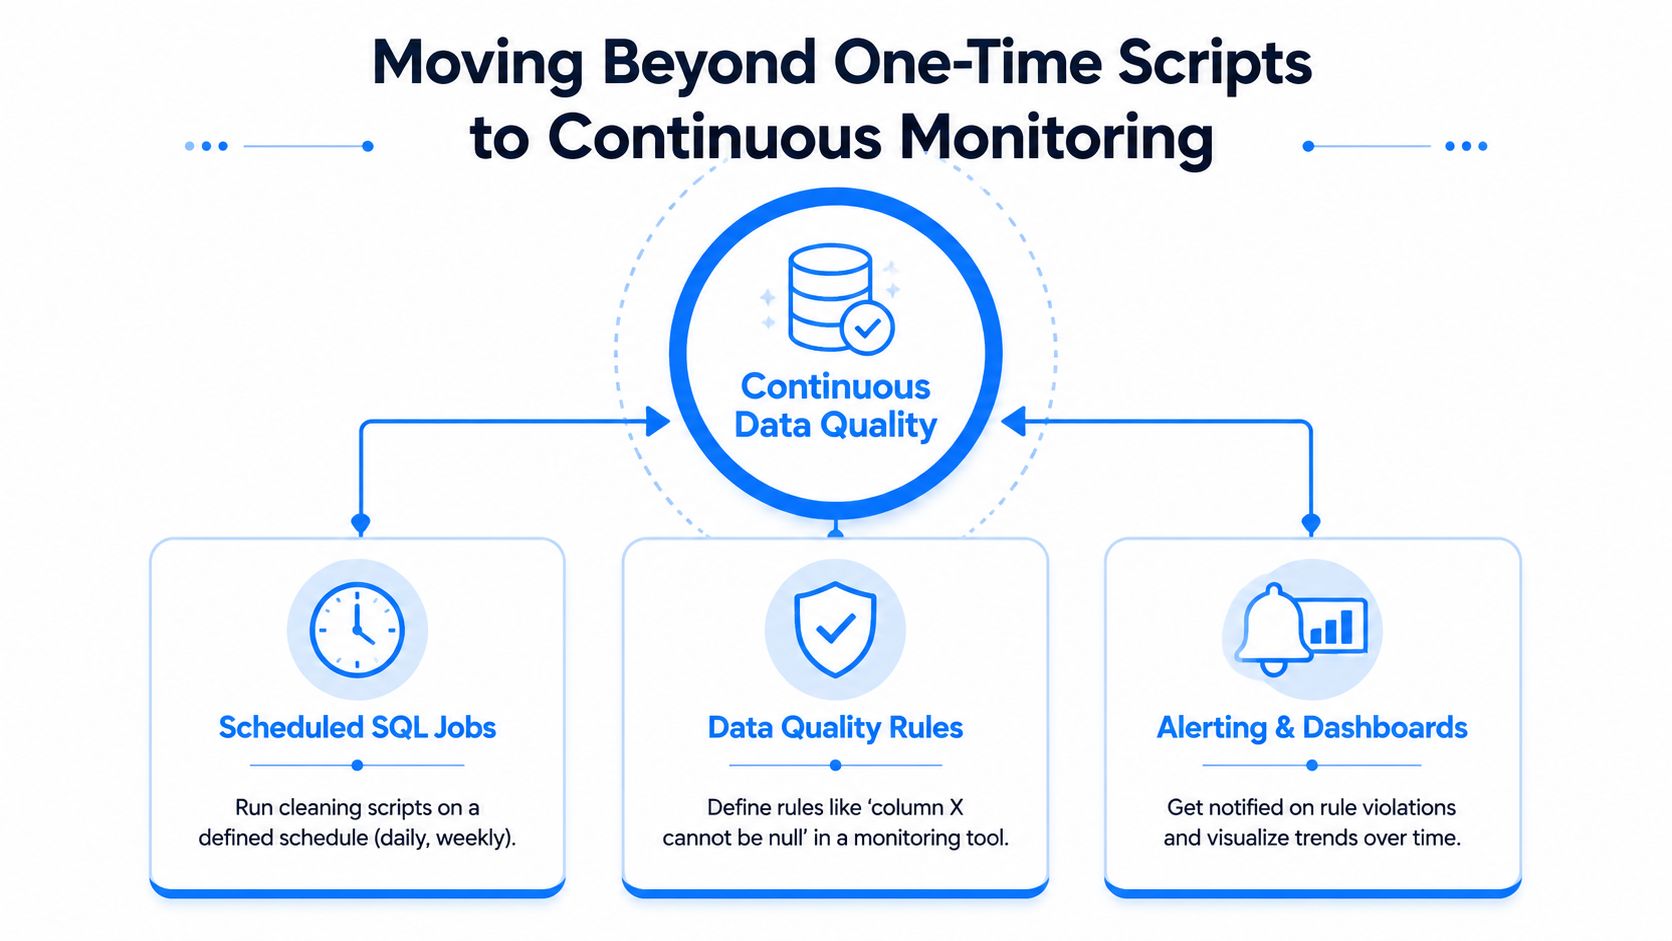
Un flusso di lavoro maturo sovrappone diversi segnali al dataset ripulito:
Job SQL pianificati: eseguono trasformazioni deterministiche secondo una pianificazione definita e registrano il numero di righe interessate.
Regole di qualità: verificano valori obbligatori, formati validi, unicità, integrità referenziale e condizioni di business.
Rilevamento delle anomalie: confronta distribuzioni e volumi attuali con il comportamento consolidato per far emergere variazioni insolite.
Controlli di tempestività: rilevano consegne mancanti, in ritardo o inaspettatamente anticipate.
Schema tracking: individua colonne aggiunte o rimosse e modifiche ai tipi di dati prima che le query a valle falliscano.
L'investimento giusto dipende dalla modalità di guasto. Scrivete uno script SQL quando la regola è deterministica, la trasformazione è ripetibile e il dataset interessato è ben delimitato. Aggiungete un'observability automatizzata quando i difetti si ripetono, il comportamento delle sorgenti cambia, i tempi di consegna contano o un malfunzionamento della dashboard verrebbe scoperto troppo tardi con la revisione manuale.
Piattaforme come digna eseguono i controlli di qualità e di anomalia all'interno dell'ambiente di database del cliente, consentendo ai team di monitorare il comportamento dei dati senza spostare i record di produzione in un livello di elaborazione esterno. Le sue funzionalità di monitoraggio della qualità dei dati colmano il divario tra la pulizia pianificata e il rilevamento continuo, combinando validazione, anomalie, tempestività e monitoraggio strutturale.
Usate digna per eseguire validazione in-database, rilevamento delle anomalie, controlli di tempestività e schema tracking sui dataset da cui dipendono le vostre pipeline SQL. Visitate digna per scoprire come il monitoraggio continuo può trasformare una logica di pulizia una tantum in un sistema operativo di qualità dei dati.
Domande frequenti
Perché SQL resta la spina dorsale della pulizia dei dati?
Perché lavora vicino ai dati, e questo conta nelle moderne architetture ELT in cui la trasformazione avviene dopo il caricamento. Un benchmark molto citato afferma che analisti e data scientist possono dedicare fino all'80% del loro tempo alla pulizia e alla preparazione dei dati, quindi decidere dove viene eseguito questo lavoro non è una scelta di poco conto.
Quali difetti causano più danni al reporting?
Quattro si ripetono: eventi di business duplicati, quando un nuovo tentativo di ingestion crea due righe e gonfia i ricavi; chiavi di relazione mancanti, quando una chiave null impedisce la corrispondenza di un join e la dashboard sottostima i dati; deriva del formato, quando una data arriva secondo una convenzione diversa e sposta i record nel periodo sbagliato; e valori sentinella che superano i controlli superficiali sui null.
Perché i valori sentinella sono particolarmente pericolosi?
Perché sembrano dati. Stringhe vuote, date segnaposto e zeri sostituiscono informazioni mancanti e superano senza problemi un controllo sui null, così il record risulta completo pur non contenendo nulla di utilizzabile nel campo che conta.
SQL può nascondere i difetti oltre a correggerli?
Sì, ed è per questo che la pulizia va trattata come un'operazione controllata sui dati anziché come una serie improvvisata di correzioni all'interno di una query di dashboard. Un COALESCE nel livello di reporting elimina il sintomo e, allo stesso tempo, le evidenze.
Che cosa occorre fare prima di scrivere la prima correzione?
Profilare i dati. Comprendere volume attuale, distribuzione, tassi di null e pattern dei valori vi dice quali difetti sono effettivamente presenti, anziché quelli a cui l'ultimo incidente ha fatto pensare tutti.


