Chiavi esterne non applicate: perché il data warehouse accetta record orfani
|
6
min di lettura

Aggiungete nel vostro data warehouse una chiave esterna da fact_sales.customer_id a dim_customer. Il DDL viene eseguito, il caricamento notturno anche, e la mattina dopo un gruppo di nuove righe di vendita punta a clienti che non esistono. Nulla è fallito, perché nulla ha controllato. In Snowflake, BigQuery, Amazon Redshift e Databricks una chiave esterna non viene applicata: la piattaforma memorizza la dichiarazione come metadato ma accetta righe la cui chiave non ha corrispondenza nella tabella padre.
Lo stesso vale per le chiavi primarie e i vincoli di unicità. È una sorpresa per chi si è formato su PostgreSQL, Oracle o SQL Server, dove una chiave esterna dichiarata rifiuta la riga errata già in fase di inserimento. In un data warehouse cloud la dichiarazione è una promessa che fate voi, non una regola che il database fa rispettare al posto vostro. Alcuni query planner arrivano persino a credere alla promessa e la usano per semplificare i join.
Questo articolo elenca che cosa applica ciascuna piattaforma, con i link alla documentazione dei fornitori, spiega perché i data warehouse fanno questo compromesso, mostra come una chiave violata possa trasformarsi in un numero sbagliato e descrive che cosa eseguire al suo posto. Per il concetto generale di righe padre e figlie e di che cos'è un record orfano, partite dall'articolo di riferimento I vostri dati trovano ancora i loro genitori? Capire l'integrità referenziale.
Punti chiave
Snowflake (tabelle standard), BigQuery, Redshift e Databricks accettano dichiarazioni di chiavi primarie, esterne e univoche ma non le applicano. Le hybrid table di Snowflake sono l'eccezione.
NOT NULL viene applicato su Snowflake, Redshift e Databricks; Databricks applica anche i vincoli CHECK.
Redshift e BigQuery usano le chiavi dichiarate per pianificare le query. Se le chiavi sono sbagliate, alcune query possono restituire risultati errati senza alcun errore.
Dichiarate le chiavi solo quando i dati sono stati validati, e validateli di nuovo dopo ogni caricamento con un controllo di integrità referenziale.
Mantenete NOT NULL come regola a sé e tenete d'occhio i riferimenti tra sistemi diversi, dove non può esistere alcun vincolo.
Indice
Che cosa significa "chiave esterna non applicata"?
Quali data warehouse applicano chiavi primarie ed esterne?
Perché i data warehouse non applicano le chiavi esterne?
Come può una chiave non applicata restituire risultati di query errati?
Come si protegge l'integrità referenziale in un data warehouse?
Il controllo anti-join in SQL
Come si presenta un controllo di integrità referenziale in digna?
Come proseguire
Che cosa significa "chiave esterna non applicata"?
Una chiave esterna non applicata è una dichiarazione che il database registra ma non verifica mai. Potete scrivere FOREIGN KEY (customer_id) REFERENCES dim_customer (customer_id) e la piattaforma la memorizzerà, la mostrerà nel catalogo e la esporrà agli strumenti, ma caricherà comunque una riga il cui customer_id non ha un padre.
I fornitori li chiamano vincoli informativi. Descrivono la forma prevista dei dati: quale colonna identifica una riga, quale colonna punta a quale tabella. Strumenti di BI, data catalog e strumenti di modellazione li leggono per disegnare diagrammi e suggerire join. Anche alcuni ottimizzatori di query li leggono. Ciò che non fanno è bloccare un caricamento, sollevare un errore o segnalare un orfano.
Quindi in un data warehouse "la chiave è dichiarata" e "la chiave è rispettata" sono due affermazioni diverse. La prima è un frammento di DDL. La seconda è un fatto relativo ai dati che solo un controllo può stabilire, e che può cambiare a ogni caricamento.
Quali data warehouse applicano chiavi primarie ed esterne?
Nessuno dei quattro principali data warehouse cloud applica chiavi primarie, esterne o univoche sulle tabelle standard. Le hybrid table di Snowflake sono l'unica eccezione in questo elenco. NOT NULL viene applicato su Snowflake, Redshift e Databricks, e Databricks applica anche i vincoli CHECK. La tabella riassume la documentazione di ciascun fornitore; seguite i link per la formulazione aggiornata.
Piattaforma | PK / FK / UNIQUE applicati? | Che cosa viene applicato | Che cosa fa il planner con le chiavi dichiarate | Documentazione |
|---|---|---|---|---|
Snowflake | No sulle tabelle standard ("facoltativi, non applicati"). Sì sulle hybrid table. | NOT NULL; PK, FK e UNIQUE sulle hybrid table | Le chiavi sulle tabelle standard sono metadati informativi; consultate la documentazione prima di farvi affidamento per l'ottimizzazione | |
Google BigQuery | No. "BigQuery non applica i vincoli di chiave primaria ed esterna." | Non applicati per PK/FK; "Siete responsabili di mantenere i vincoli in ogni momento." | Usa le chiavi dichiarate per eliminare inner e outer join e per riordinare i join | |
Amazon Redshift | No. I vincoli di unicità, di chiave primaria e di chiave esterna sono solo informativi. | NOT NULL | Usa le chiavi come suggerimenti di pianificazione e presume che siano valide così come caricate; chiavi non valide possono far restituire risultati errati ad alcune query | |
Databricks | No. "I vincoli di chiave primaria, chiave esterna e unicità sono solo informativi e non vengono applicati." | NOT NULL e CHECK | Le chiavi sono informative; consultate la documentazione prima di farvi affidamento per l'ottimizzazione |
Nella pratica contano due dettagli. Primo, NOT NULL è il vincolo di cui di solito potete fidarvi: su Snowflake, Redshift e Databricks un null in una colonna NOT NULL viene rifiutato. Secondo, le hybrid table di Snowflake sono un tipo di tabella diverso con un comportamento diverso; una chiave esterna su una normale tabella Snowflake non vi offre nulla di quell'applicazione.
I database OLTP classici come PostgreSQL, Oracle, SQL Server e MySQL con InnoDB applicano invece le chiavi esterne dichiarate. Ma un data warehouse alimentato da essi di solito non eredita quei vincoli, e molti job di caricamento disattivano i vincoli per guadagnare velocità. L'integrità che avevate nel sistema sorgente non viaggia da sola insieme ai dati.
Perché i data warehouse non applicano le chiavi esterne?
Applicare una chiave esterna significa cercare ogni chiave in arrivo nella tabella padre prima di accettare la riga. I data warehouse sono costruiti per caricare batch molto grandi in modo rapido e parallelo, e questa ricerca riga per riga va contro entrambi gli obiettivi. La documentazione dei fornitori descrive il comportamento; i motivi seguenti rappresentano il compromesso ingegneristico generale, non dichiarazioni dei fornitori.
Velocità di caricamento. Un caricamento massivo di milioni di righe di fatti richiederebbe milioni di ricerche nella tabella padre. Saltarle mantiene prevedibili i tempi di caricamento.
Caricamenti distribuiti e paralleli. Storage e calcolo sono distribuiti su molti nodi e file. Verificare una chiave rispetto a una tabella padre che a sua volta viene caricata in parallelo richiede coordinamento, e questo rallenta tutto.
Ordine di caricamento. Le pipeline spesso caricano i fatti prima delle dimensioni, oppure ricevono righe di dimensione in ritardo. Un'applicazione rigorosa rifiuterebbe righe che sarebbero state valide un'ora dopo.
Pipeline prevalentemente in append. La maggior parte delle tabelle di un data warehouse viene accodata, non modificata riga per riga. Il modello presuppone che i dati siano stati preparati a monte, quindi il database non li ricontrolla.
Il compromesso è ragionevole. Il problema è che il controllo non scompare: si sposta. Qualcuno deve eseguirlo dopo il caricamento, e in molti team nessuno lo fa.
Come può una chiave non applicata restituire risultati di query errati?
Una chiave non applicata diventa pericolosa quando il query planner si fida di essa. Amazon Redshift documenta che il suo planner presume che le chiavi siano valide così come caricate e che, se la vostra applicazione consente chiavi esterne o primarie non valide, alcune query potrebbero restituire risultati errati. Una chiave dichiarata ma violata è peggio di nessuna chiave.
BigQuery usa le chiavi primarie ed esterne dichiarate per eliminare inner e outer join e per riordinare i join, e la sua documentazione mette l'onere su di voi: "Siete responsabili di mantenere i vincoli in ogni momento."
Ecco il meccanismo in termini generali. Prendete una query che unisce fact_sales a dim_customer ma seleziona solo colonne di fact_sales. Se il planner si fida della chiave esterna, può decidere che il join non può eliminare alcuna riga e saltarlo. Eseguite la stessa query senza la chiave dichiarata e l'inner join scarta tutte le vendite orfane. Ora lo stesso report fornisce due totali diversi a seconda del piano, e nessuna delle due esecuzioni solleva un errore.
Le chiavi primarie duplicate causano un problema analogo: un join che tutti presumono restituisca una riga per chiave ne restituisce diverse, e i totali raddoppiano. In entrambi i casi la dashboard sembra normale. Il numero è semplicemente sbagliato, e ve ne accorgete settimane dopo grazie a una riconciliazione, se mai ve ne accorgete.
Come si protegge l'integrità referenziale in un data warehouse?
Si protegge l'integrità referenziale in un data warehouse trattando le chiavi dichiarate come affermazioni da verificare dopo ogni caricamento. Dichiarate una chiave solo quando i dati sono stati validati, eseguite un controllo di integrità referenziale a ogni esecuzione della pipeline e avvisate il team responsabile quando fallisce. Questi passaggi funzionano su tutte e quattro le piattaforme.
Elencate le chiavi che avete dichiarato. Sappiate quali chiavi esterne e primarie esistono nel catalogo, perché sono quelle di cui un planner può fidarsi e su cui uno strumento di BI può basare i join.
Dichiarate le chiavi solo dopo averle validate. Prima di aggiungere una chiave, dimostrate che è rispettata sui dati attuali. Se non potete continuare a verificarla, pensateci due volte prima di dichiararla.
Validate dopo ogni caricamento. Eseguite un controllo di integrità referenziale per ogni coppia figlio-padre importante come parte della pipeline, non come audit una tantum. Un caricamento che introduce orfani deve essere visibile il giorno stesso.
Mantenete NOT NULL come regola separata. Un controllo referenziale di solito ignora le chiavi nulle, perché un null non punta a nulla. Se ogni riga deve avere un padre, verificate
customer_id IS NOT NULLa parte, oppure affidatevi al vincolo NOT NULL applicato dove la piattaforma lo offre.Tenete d'occhio i riferimenti tra sistemi. L'anagrafica prodotti può trovarsi in un database e le transazioni in un altro. Nessuna chiave esterna può estendersi su due sistemi, quindi questi riferimenti sono protetti solo da un controllo.
Stabilite una soglia e un responsabile. Decidete se un solo orfano è un fallimento o se una piccola quota è tollerabile, e instradate il risultato al team responsabile dei dati.
Il controllo anti-join in SQL
Il cuore di ogni controllo di integrità referenziale è un anti-join: trovare le righe figlie la cui chiave non ha corrispondenza nella tabella padre.
Il filtro IS NOT NULL esclude le chiavi nulle dal conteggio degli orfani, in linea con il passaggio 4. Per le chiavi composite, le varianti con NOT EXISTS, le prestazioni sulle tabelle di grandi dimensioni e come tenere fuori gli orfani già in fase di caricamento, consultate record orfani: trovarli con SQL e tenerli fuori.
Scrivere la query è la parte facile. Eseguirla dopo ogni caricamento, per ogni chiave, memorizzare i conteggi, avvisare qualcuno e tenere le righe non conformi a disposizione di chi deve correggerle è il punto in cui l'SQL scritto a mano tende a restare indietro.
Come si presenta un controllo di integrità referenziale in digna?
In digna un controllo di integrità referenziale è una regola di digna Data Validation: scegliete la colonna su una data source, scegliete la colonna corrispondente su un'altra e impostate una soglia. Non c'è SQL da scrivere. digna genera il controllo e lo esegue all'interno del vostro data warehouse a ogni ispezione di quella data source.
La configurazione richiede pochi campi nella finestra Add Data Validation Rule (Configuration → data source → Data Validation → Add Rule):
Name e Description, per esempio
hc_product_in_master: "Ogni prodotto somministrato esiste nell'anagrafica prodotti della farmacia".Type: Referential Integrity (gli altri tipi sono Rule e Uniqueness).
Attributes: la colonna su questa data source, qui
product_code.must exist in: la Data Source padre (
hospital_medications) e i suoi Attributes (product_code). Per una chiave composita, scegliete più colonne su entrambi i lati nello stesso ordine; elenchi di colonne non corrispondenti vengono rifiutati.Threshold Mode Absolute o Relative, con una Info threshold e una Warn threshold. Absolute, Info 0, Warn 1 significa che già un solo orfano genera lo stato Uncertain e due o più fanno fallire la regola; lasciate Warn a 0 se anche un solo orfano deve causare il fallimento.
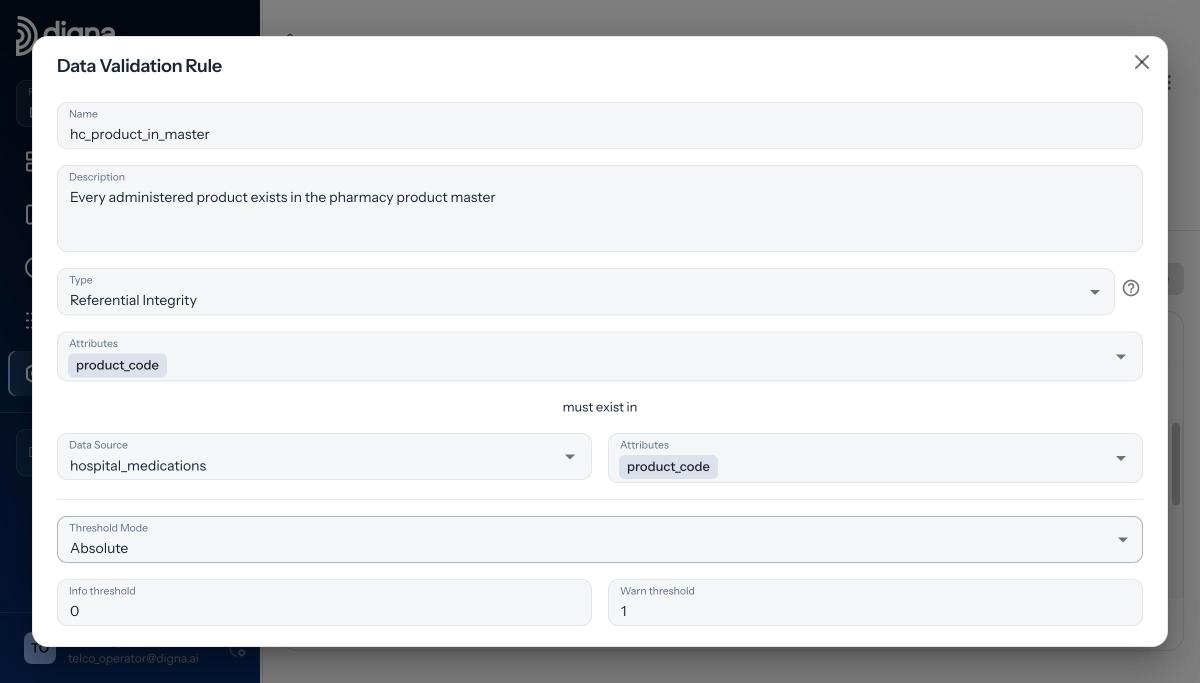
La regola di integrità referenziale in digna: ogni product_code della data source delle somministrazioni deve esistere in hospital_medications.
L'esempio usa dati demo fittizi di Danubia Kliniken, un gruppo ospedaliero austriaco immaginario.
Il 2026-04-22 sono state registrate nei reparti 82 somministrazioni di Coavira 2.5 mg (codice prodotto 3858646) prima che il prodotto venisse inserito nell'anagrafica prodotti della farmacia. La regola ha riportato 4.244 righe superate su 4.326 ed è passata allo stato Failed. Nella vista Invalid Records filtrate su Failed, scegliete il controllo e vedete ogni riga orfana con ospedale, reparto e codice prodotto, pronta da esportare per chi deve correggere l'anagrafica. Senza il controllo, ogni report che collega le dosi ai prodotti avrebbe mostrato zero dosi di quel prodotto.
Tre caratteristiche corrispondono ai passaggi descritti sopra. Il controllo gira all'interno del data warehouse stesso: digna invia SQL, riceve conteggi e recupera le righe non conformi solo quando le richiedete; nessuna tabella viene copiata all'esterno e i vostri dati non lasciano mai la vostra infrastruttura. Le chiavi nulle vengono saltate, quindi la presenza è una Rule separata come product_code IS NOT NULL. E dalla Release 2026.01 il padre può trovarsi in uno schema diverso o persino in una connessione di database diversa all'interno dello stesso progetto, il che copre i riferimenti tra sistemi che nessun vincolo può raggiungere. Per un quadro più ampio su come riunire le sorgenti in un data warehouse, consultate la nostra guida all'integrazione del data warehouse; la spiegazione completa, campo per campo, della regola si trova in come configurare un controllo di integrità referenziale.
Come proseguire
Una chiave esterna non applicata non è un bug del vostro data warehouse. È una scelta di progettazione che vi restituisce il compito del controllo. Continuate a dichiarare le chiavi dove aiutano strumenti e planner, ma solo dopo aver dimostrato che i dati le rispettano, e dimostratelo di nuovo dopo ogni caricamento. Un controllo di integrità referenziale che gira a ogni ispezione, all'interno del data warehouse, con una soglia e un responsabile, colma il vuoto lasciato aperto dalla piattaforma.
Se volete vederlo all'opera sulle tabelle del vostro data warehouse, prenotate una demo con il team di digna.
Domande frequenti
Snowflake applica le chiavi esterne?
Non sulle tabelle standard. Snowflake documenta che lì le chiavi primarie, esterne e univoche sono facoltative e non applicate, mentre NOT NULL viene applicato. Le hybrid table sono l'eccezione: su di esse i vincoli PK, FK e UNIQUE vengono applicati. Le righe orfane in una tabella standard vengono quindi caricate senza alcun errore.
Le chiavi esterne non applicate possono causare risultati di query errati?
Sì, quando il planner si fida di esse. Amazon Redshift dichiara che il suo planner presume che le chiavi siano valide così come caricate, quindi chiavi non valide possono far restituire risultati errati ad alcune query. BigQuery usa le chiavi dichiarate per eliminare e riordinare i join e afferma che la responsabilità di mantenere i vincoli è vostra.
Che cosa sono i vincoli informativi in un data warehouse?
I vincoli informativi sono chiavi primarie, esterne o univoche che la piattaforma registra come metadati ma non verifica. Databricks e Amazon Redshift descrivono i propri vincoli di chiave come puramente informativi. Strumenti e planner possono leggerli, ma le righe che li violano vengono comunque caricate, quindi serve un controllo di validazione separato.
Conviene ancora dichiarare chiavi esterne in Redshift o BigQuery?
Dichiaratele solo quando i dati sono stati validati e continuate a validarli. Entrambe le piattaforme usano le chiavi dichiarate nella pianificazione delle query, quindi una chiave dichiarata ma violata può cambiare i risultati. Eseguite un controllo di integrità referenziale dopo ogni caricamento prima di fidarvi della dichiarazione.
Come si verifica l'integrità referenziale quando il data warehouse non la applica?
Eseguite un anti-join dopo ogni caricamento: selezionate le righe figlie la cui chiave non ha un genitore corrispondente, escludendo i null. In digna Data Validation si tratta di una regola Referential Integrity con una soglia, eseguita all'interno del data warehouse a ogni ispezione, e le righe non conformi compaiono nella vista Invalid Records.


