Guida alla pipeline di data ingestion, dalle sorgenti alla scalabilità
|
7
min di lettura
Il lunedì mattina aprite la dashboard direzionale e i numeri sono quelli di giovedì scorso. Il reparto finance sostiene che il caricamento nel data warehouse deve essere fallito, gli analytics dicono che il team della sorgente ha cambiato qualcosa e l'engineering sta fissando tre log diversi che non coincidono. Di solito è in quel momento che ci si rende conto che il problema non sono solo i “dati sbagliati”. È la pipeline di data ingestion, il livello che decide se il business sta guardando informazioni aggiornate e affidabili o una bugia ben confezionata.
Negli ambienti maturi l'ingestion non è un semplice compito di trasporto. È un control plane guidato dai contratti tra i sistemi sorgente e ogni decisione a valle che da essi dipende. Questo è importante perché i volumi di dati moderni hanno costretto l'ingestion a evolvere da semplici loader batch a pipeline scalabili, capaci di gestire molte più sorgenti, aspettative di freschezza più stringenti e validazione continua: un passaggio diventato inevitabile quando la datasfera globale si è avviata verso i 175 zettabyte entro il 2025, partendo dai 33 zettabyte del 2018 (contesto storico sull'evoluzione delle pipeline di data ingestion).
Indice
Perché la data ingestion è la fonte silenziosa dei problemi di fiducia
Che cos'è una pipeline di data ingestion, in parole semplici
I principi di progettazione che decidono se la pipeline regge
Architetture di riferimento per data warehouse e data lake enterprise
Perché la data ingestion è la fonte silenziosa dei problemi di fiducia
A prima vista la dashboard sembra a posto. I grafici si caricano, i filtri funzionano e la riunione inizia in orario. Poi qualcuno chiede perché la vista sul fatturato mostri ancora giovedì quando oggi è lunedì, e la sala si divide tra teorie contrapposte su quale caricamento sia fallito, quale trasformazione si sia rotta e se la sorgente abbia inviato i dati.
È proprio questo tipo di confusione a spiegare perché l'ingestion meriti più attenzione di quanta ne riceva di solito. Il livello di ingestion è il punto in cui si fa rispettare il contratto di business, perché è il primo luogo in cui i dati vengono ricevuti, controllati e poi lasciati proseguire o bloccati. L'impostazione di IBM sulle pipeline è utile in questo senso, perché tratta l'ingestion come la parte iniziale di un flusso più ampio che acquisisce dati grezzi, li trasforma e li sposta in un archivio per l'analisi (IBM sulle pipeline di dati).
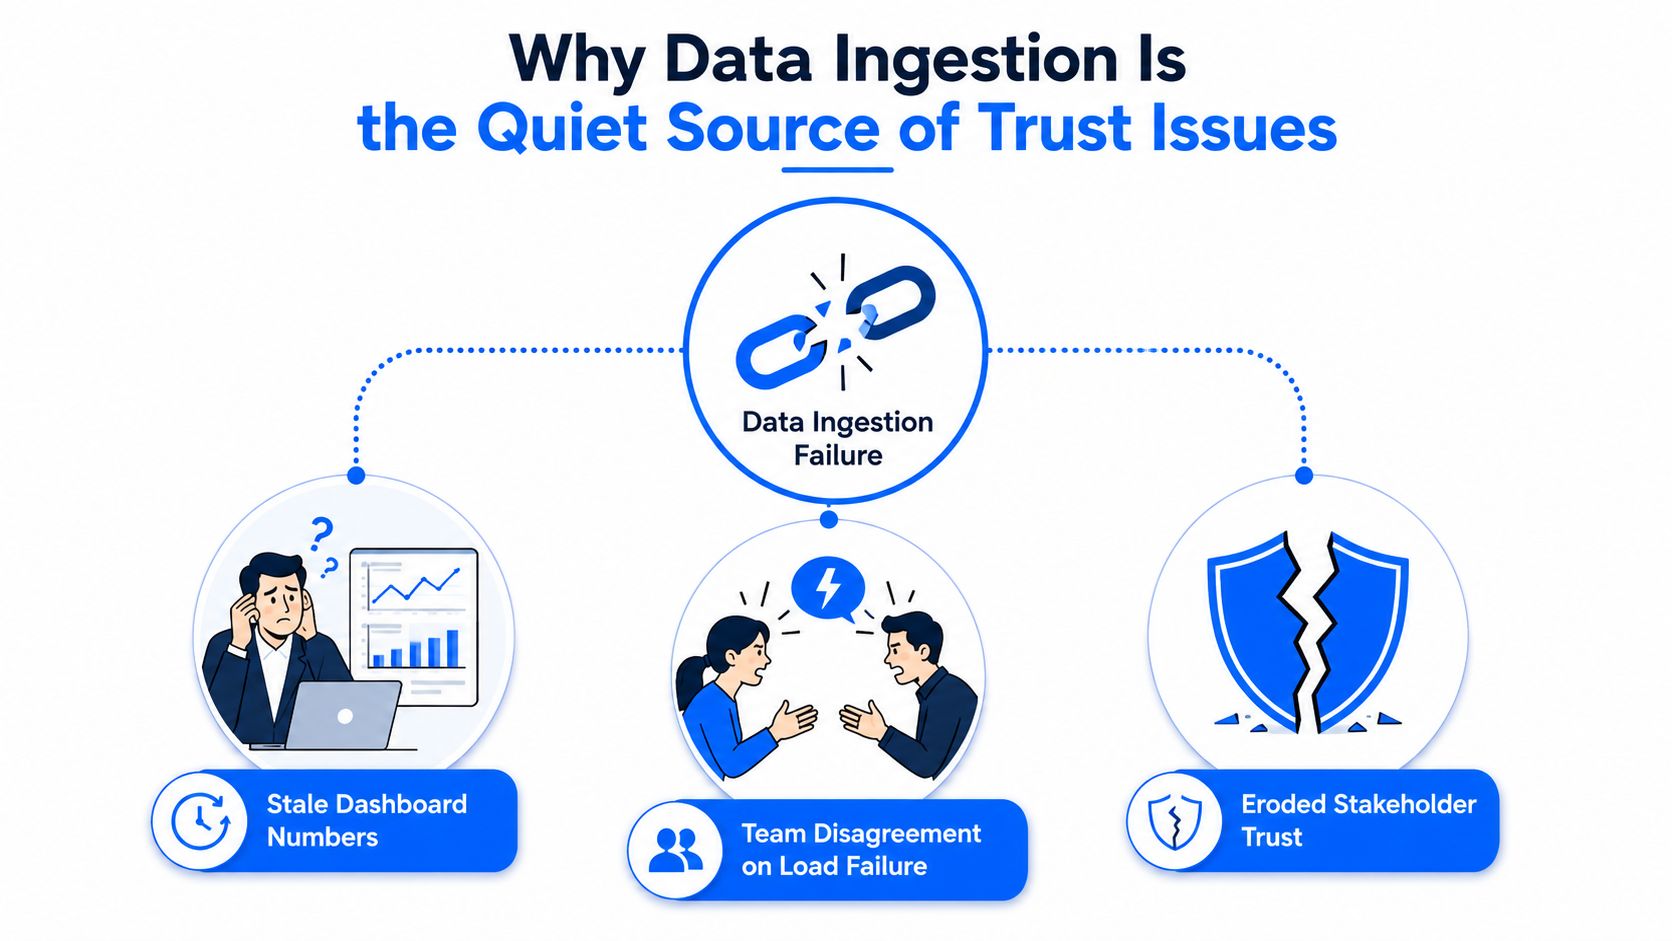
Il problema di fiducia inizia prima degli analytics
Se un file sorgente arriva in ritardo, la dashboard non si limita a sembrare obsoleta. Le persone prendono comunque decisioni basandosi su di essa. Un file mancante, un flusso di eventi in ritardo o un payload malformato possono produrre lo stesso risultato: un report tecnicamente presente ma fuorviante sul piano operativo.
Per questo lo stato di salute di una pipeline si valuta di solito in base a throughput, latenza, tasso di errore e freschezza: sono i segnali che indicano se i dati sono arrivati, se sono arrivati in tempo, se sono arrivati corretti e abbastanza presto da essere utili (linee guida sul monitoraggio delle pipeline).
Regola pratica: se il vostro livello di ingestion non sa dirvi che cosa è arrivato, quando è arrivato e se corrispondeva alla struttura attesa, i vostri analytics a valle stanno già tirando a indovinare.
Passare dall'idea di “idraulica” a quella di “prodotto” cambia le domande che i team si pongono. Invece di chiedersi se il file è arrivato, i team si chiedono se i record rispettavano il contratto, se il ritardo è stato rilevato correttamente e se i dati malformati sono stati fermati prima di inquinare le dashboard. Questo approccio evita ai team regolamentati di combattere ogni settimana lo stesso incidente e impedisce anche la crescita dei costi unitari quando retry, rielaborazioni e pulizia manuale diventano il prezzo nascosto di controlli di ingestion deboli.
Che cos'è una pipeline di data ingestion, in parole semplici
Un modo semplice per pensare all'ingestion è immaginare un centro di smistamento. I pacchi arrivano da molti camion, qualcuno controlla le etichette, il centro instrada ogni collo verso la destinazione giusta e solo allora altri sistemi ne utilizzano il contenuto. Una pipeline di data ingestion funziona allo stesso modo. Riceve dati grezzi, li valida e li instrada verso un data warehouse, un data lake, un database o un altro sistema a valle.
Che cosa è una sorgente e che cosa è una destinazione
Le sorgenti sono i sistemi che emettono dati. In pratica includono database, API, flussi di eventi, file e dispositivi IoT. Le destinazioni sono i luoghi in cui i dati vengono resi disponibili all'uso, come un data warehouse, un data lake, un lakehouse, un indice di ricerca o un feature store. Il punto non è memorizzare le etichette, ma capire dove nascono i dati e dove l'ingestion li passa di mano.
Questo passaggio di consegne è il confine principale. Un livello di ingestion presidia la porta d'ingresso, non ogni trasformazione o report. La pipeline più ampia può includere pulizia, modellazione, arricchimento e distribuzione, ma l'ingestion è la parte che raccoglie, deposita e valida prima che il resto dello stack prenda il controllo (panoramica sulla data ingestion).
La porta d'ingresso ha le sue regole
Anche le linee guida moderne considerano l'ingestion qualcosa di più di un semplice trasferimento di dati grezzi. Spesso comprende validazione automatizzata, trasformazione e caricamento in una destinazione centrale come un data warehouse, un data lake o una piattaforma di streaming. Ecco perché i controlli sullo schema e la gestione degli errori sono così importanti alla porta d'ingresso, e non dopo che i dati hanno già contaminato le tabelle a valle (inquadramento storico delle pipeline).
L'ingestion termina quando dati affidabili sono stati depositati e controllati, non quando i byte hanno finito di essere copiati.
Un buon modello mentale è questo. Se uno strumento si limita a spostare file, è un meccanismo di trasferimento. Se sa ricevere, ispezionare, instradare e dimostrare che i dati soddisfano le aspettative, appartiene al livello di ingestion.
Batch, micro-batch e streaming a confronto
Il modo più pulito per scegliere una cadenza di ingestion è partire dalla domanda di business, non dalla tecnologia. Se il business può permettersi di aspettare fino al mattino, il batch spesso basta. Se un team ha bisogno di aggiornamenti durante la giornata ma non al secondo, il micro-batch di solito è più adatto. Se una decisione cambia nell'istante in cui si verifica l'evento, entra in gioco lo streaming.
Per l'ingestion batch su larga scala, le linee guida di Microsoft raccomandano di depositare i dati in ADLS o Blob in formato Parquet quando possibile e di raggruppare i payload in blocchi di circa 100 MB - 1 GB non compressi, distinguendo inoltre la queued ingestion per il throughput dalla streaming ingestion per i casi d'uso a bassa latenza (linee guida Microsoft sull'ingestion ETL). È un utile promemoria del fatto che la cadenza non riguarda solo la velocità, ma anche l'adeguatezza operativa.
Compromessi sulla cadenza di ingestion
Dimensione | Batch | Micro-batch | Streaming |
|---|---|---|---|
Freschezza | Più grossolana, spesso programmata | Quasi in tempo reale, a brevi intervalli | Latenza minima, guidata dagli eventi |
Throughput | Efficiente per grandi caricamenti | Buon compromesso | Può essere efficiente, ma è delicato sul piano operativo |
Costo | Di solito il più semplice da gestire | Complessità moderata | Di solito il più difficile da mantenere prevedibile |
Complessità | La più bassa | Media | La più alta |
Rischio operativo | Più facile da governare | Richiede una pianificazione e retry accurati | Richiede idempotenza, gestione della backpressure e un monitoraggio stretto |
La cadenza deve seguire lo SLA
Uno SLA di freschezza non deve essere sofisticato. Può essere espresso in semplici termini di business, come “la dashboard finance deve riflettere la chiusura di ieri entro le 8 del mattino”. Una volta chiarita questa aspettativa, la cadenza ne discende. Se potete rispettare lo SLA con il batch, non rendete il sistema real-time solo perché suona moderno.
Questo vale soprattutto nelle aziende in cui sistemi batch e real-time convivono. Le linee guida attuali dicono ancora che molte pipeline dovrebbero restare batch o micro-batch, a meno che la latenza non incida direttamente su una decisione: una regola più realistica, per molte organizzazioni, di “mettere tutto in streaming” (compromessi dell'ingestion moderna).
I componenti chiave di un'architettura di ingestion
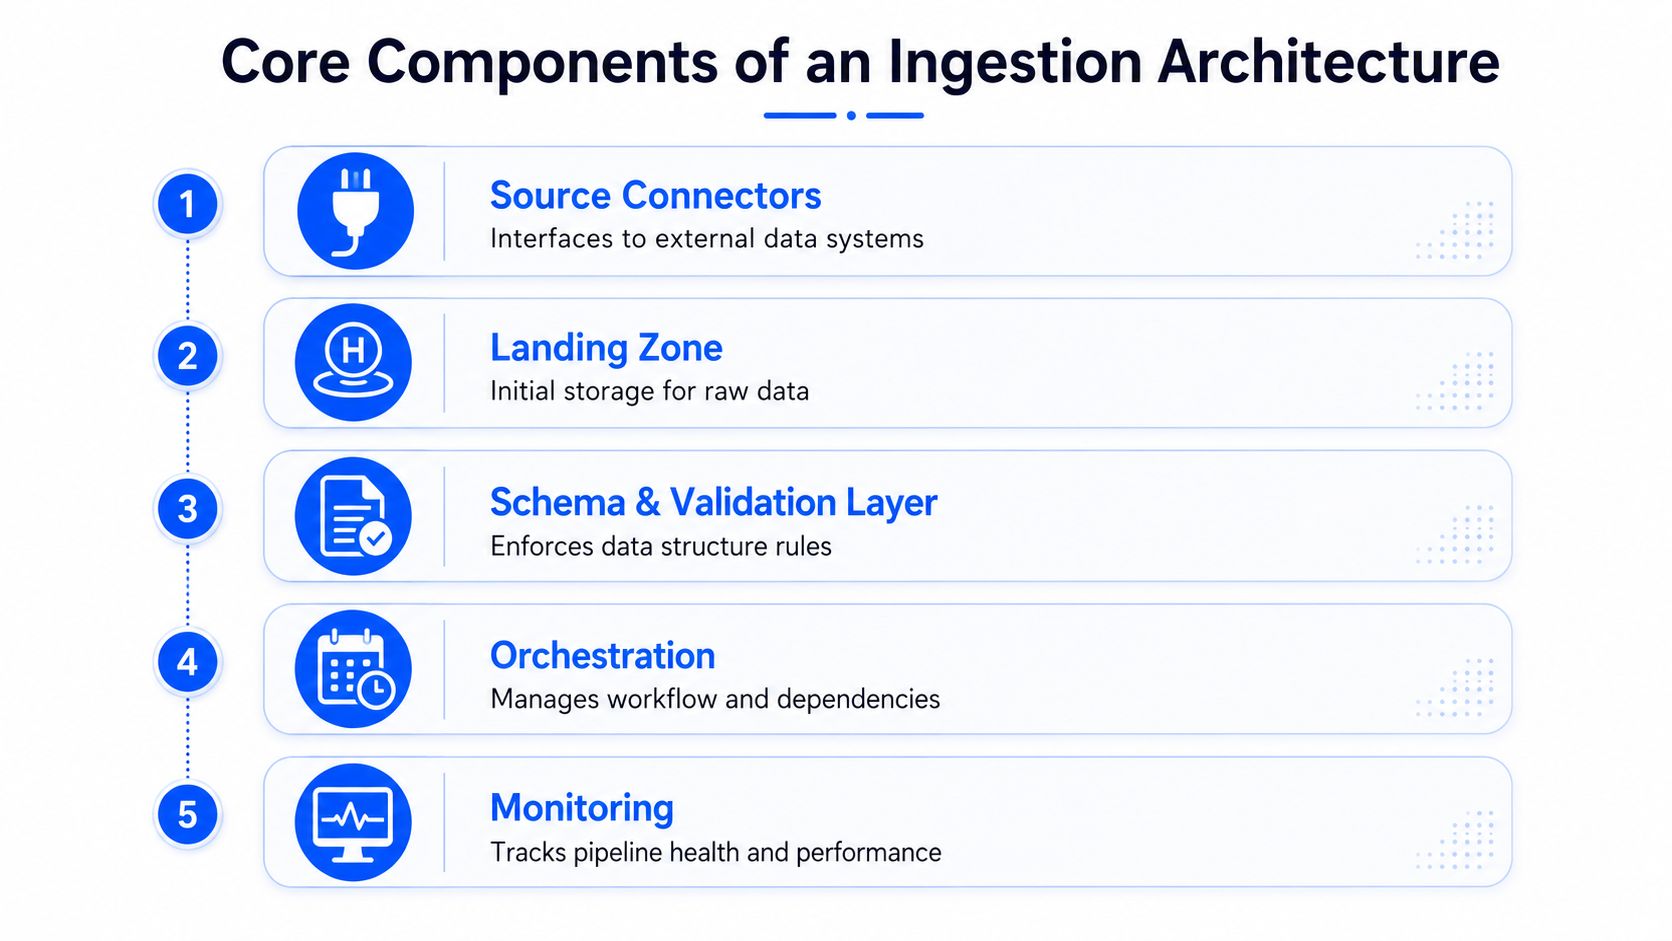
Uno stack di ingestion in produzione ha alcuni componenti, ciascuno dei quali comporta un rischio specifico. Quando uno è debole, la modalità di guasto è di solito evidente per chi riceve la chiamata di reperibilità e invisibile a tutti gli altri finché la dashboard non diventa obsoleta. I cinque elementi da nominare sono connettori sorgente, landing zone, livello di schema e validazione, orchestrazione e monitoraggio.
Dove cede ciascun livello quando è debole
Un connettore sorgente fragile si rompe quando un'API cambia o una credenziale del database scade. Una landing zone debole crea problemi di costo e di ripristino, perché i dati grezzi non sono archiviati in un formato che si possa rieseguire in modo pulito. L'assenza di un livello di schema e validazione lascia passare strutture errate e costringe i team a valle a scoprire il problema a posteriori.
L'orchestrazione è la parte che mantiene affidabili le dipendenze. Senza di essa, una sorgente può arrivare prima di un'altra e i job a valle partono con input parziali. Il monitoraggio chiude il cerchio mostrando se la pipeline è in salute, quanto velocemente si sono spostati i record e se il caricamento è rimasto entro la finestra di freschezza prevista.
Che cosa riconoscere in uno stack reale
Vedrete queste responsabilità distribuite su più strumenti anziché riunite in un unico prodotto perfetto. Un connettore potrebbe essere realizzato con Kafka Connect o Debezium, la landing zone potrebbe essere un object storage o un'area di staging del data warehouse, la validazione potrebbe vivere in SQL, Spark o in una piattaforma di data quality e l'orchestrazione potrebbe stare in Airflow, Dagster o in uno scheduler cloud. I nomi cambiano, ma le domande di controllo no.
Per i team che confrontano i software, il filtro pratico è capire se lo strumento aiuta a far rispettare le aspettative sulla sorgente prima che i dati si diffondano. Un'opzione in questa categoria è il software di data ingestion di digna, che si concentra su validazione e osservabilità dei dati in ingresso anziché limitarsi a spostare i record a valle.
Se un componente non sa rispondere a “che cosa è cambiato, dove è finito e chi deve saperlo”, non è pronto a gestire l'ingestion in produzione.
I principi di progettazione che decidono se la pipeline regge
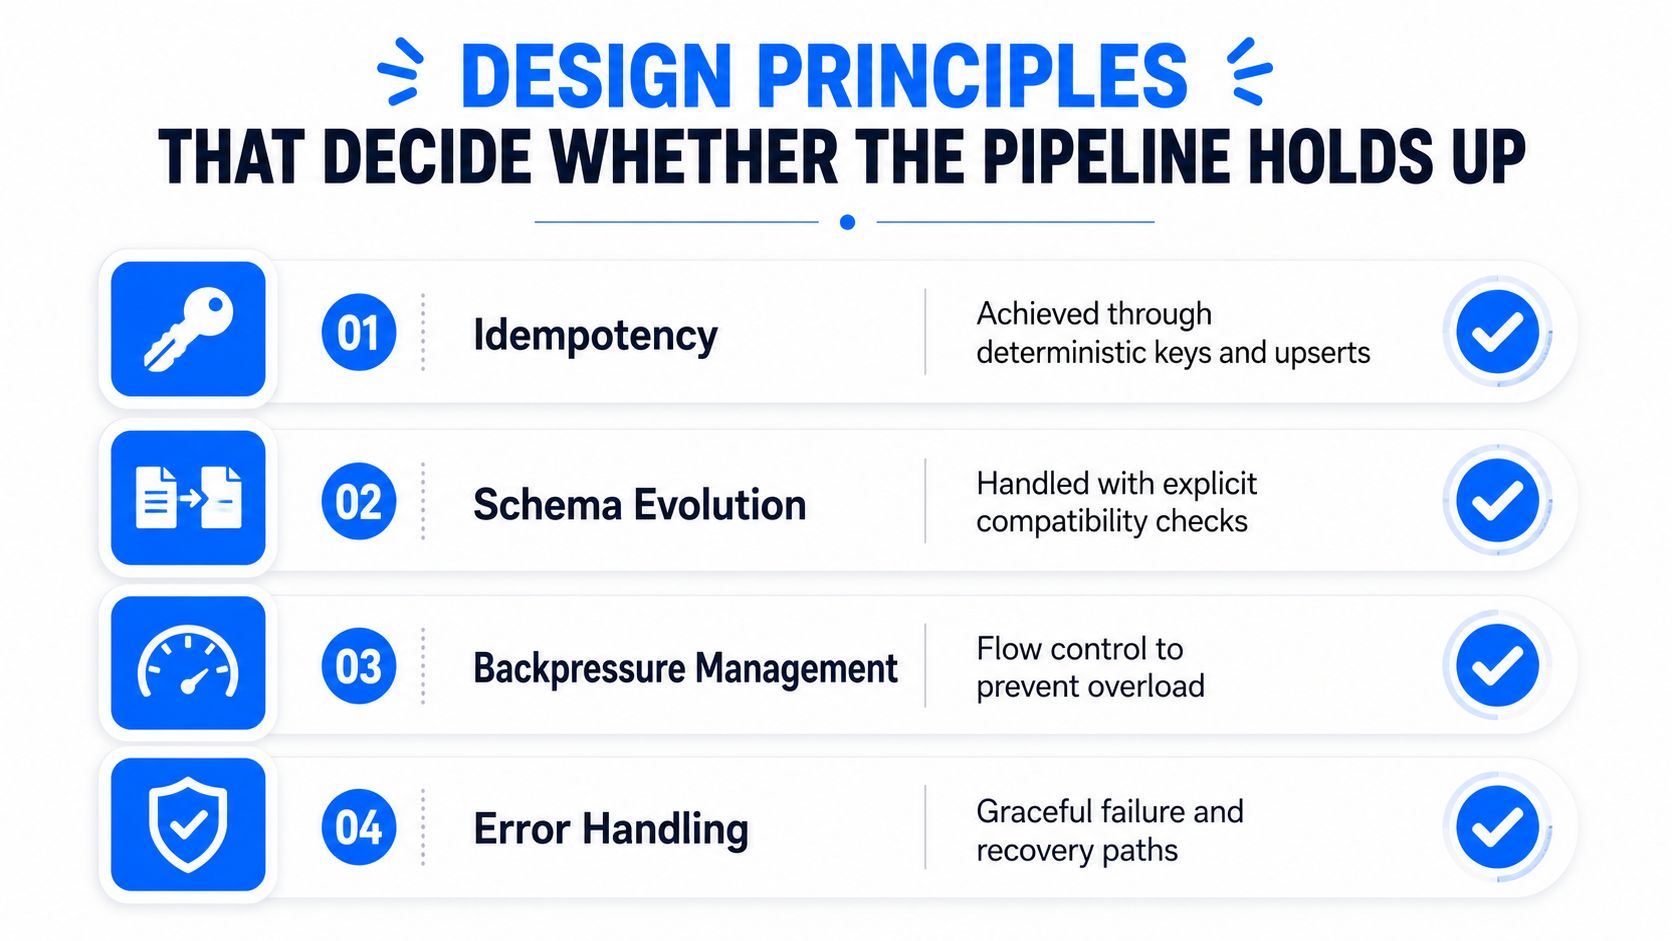
Il primo errore dei team è trattare la robustezza come una checklist da spuntare dopo che la pipeline esiste già. Lo schema più solido è integrare le regole nel flusso fin dall'inizio. Significa progettare per l'idempotenza, un'evoluzione dello schema esplicita, la backpressure e una gestione degli errori che consideri normale il successo parziale.
Progettare per i retry senza doppi conteggi
L'idempotenza non è un lusso. Se un job viene rieseguito dopo un'interruzione di rete, non volete che i record duplicati si trasformino in doppi conteggi. Chiavi deterministiche e upsert sono il modo in cui l'ingestion resta sicura quando avvengono i retry, e avverranno.
L'evoluzione dello schema merita la stessa disciplina. Un team che aggiunge una colonna nullable è una cosa, un team che rimuove un campo atteso dal codice a valle è un'altra. Se le regole di compatibilità non sono esplicite al momento dell'ingestion, la struttura rotta emerge più tardi sotto forma di un misterioso problema della dashboard o di un errore negli input di un modello.
Trattare il tempo come una feature, non come un metadato
Un'ingestion ad alte prestazioni dovrebbe registrare sia l'event time sia l'ingestion time e archiviare i timestamp in UTC, così che i confronti restino significativi tra regioni e sistemi (linee guida di progettazione). È così che i team distinguono “l'evento è avvenuto in ritardo” da “la pipeline era lenta”. In questo modo anche il comportamento degli arrivi tardivi diventa misurabile anziché aneddotico.
La backpressure rientra nello stesso discorso. Se i producer a monte possono superare la capacità del livello di landing, il sistema ha bisogno di un controllo di flusso anziché di un sovraccarico silenzioso. Una pipeline che assorbe troppo senza segnalare la tensione è di solito quella che fallisce nel modo meno utile.
I contratti vanno al confine
I data contract funzionano meglio quando vivono nell'ingestion, non dopo che il data warehouse è già stato inquinato. Definite lo schema atteso, le regole di validazione e il percorso di gestione delle modifiche prima di accettare i dati. È la mossa di governance che impedisce alla porta d'ingresso di trasformarsi in una porta girevole per record incompatibili.
Regola operativa: se una modifica allo schema sorprenderebbe un consumer a valle, deve essere intercettata prima che il caricamento sia considerato completo.
Osservabilità e validazione dei dati in pratica
Una pipeline può spostare i dati in tempo e deludere comunque il business. È la lezione che i team imparano dopo i primi incidenti. L'osservabilità deve mostrare se il flusso è in salute, se il contratto regge ancora e se ci si può fidare dei numeri che alimentano dashboard e modelli. Il throughput dice quanto si è spostato. La latenza dice quanto tempo ci è voluto. Il tasso di errore mostra dove il flusso si è interrotto. La freschezza mostra se i dati sono ancora rilevanti quando le persone li aprono. Questi segnali vanno nella dashboard dell'ingestion perché collegano le operations a ciò che percepiscono analisti e operatori.
Validare su più livelli
I controlli sullo schema al punto di ingresso intercettano le rotture evidenti, come colonne mancanti o tipi di dati modificati. Le regole a livello di record intercettano i problemi di logica di business, come date impossibili o transizioni di stato non valide. I controlli di trend intercettano la deriva comportamentale, quando la forma dei dati sembra ancora valida ma i valori si stanno allontanando dalla normalità.
Gli alert a soglia coprono solo i guasti più rumorosi. Non colgono la deriva lenta che fa sembrare sana una pipeline finché un analista non mette in dubbio il report. Baseline apprese e rilevamento delle anomalie sono più efficaci nell'individuare per tempo questi spostamenti più silenziosi, prima che si trasformino in un'emergenza sulla dashboard o in una decisione sbagliata a valle.
Portare la validazione dove i dati già risiedono
Spesso i team vogliono la validazione fuori dalla pipeline, ma questo aggiunge ritardo e ulteriori spostamenti di dati. L'esecuzione in-database è più pulita, quando la piattaforma la supporta, perché i controlli vengono eseguiti vicino ai dati e i risultati restano nell'ambiente del cliente. È la stessa idea di control plane che rende più semplice monitorare tempestività, modifiche allo schema e anomalie senza dover prima copiare i dati in un sistema separato.
Un riferimento pratico complementare è la guida di TruTec per garantire stime accurate delle pavimentazioni, utile perché tratta la validazione come una scelta di metodo anziché come un vago slogan sulla qualità. Lo stesso ragionamento vale per l'ingestion. Scegliete i controlli in base al guasto che volete fermare, che si tratti di un batch in ritardo, di un tipo di campo che deriva o di un record che non avrebbe mai dovuto oltrepassare il confine.
Per i team che costruiscono un livello di monitoraggio dedicato, la data observability di digna si inserisce nello stesso modello di control plane, con controlli su tempestività, anomalie e modifiche allo schema all'interno dell'ambiente del cliente. Questo è importante quando i dati regolamentati devono restare entro confini controllati e quando il team ha bisogno di un registro di ciò che è cambiato, non solo di un alert rosso.
Le soglie vi dicono che qualcosa si è rotto. Le baseline vi dicono che qualcosa sta derivando prima che si rompa.
Architetture di riferimento per data warehouse e data lake enterprise
Le pipeline incentrate sul warehouse e quelle incentrate sul lake risolvono lo stesso problema con compromessi diversi. Lo schema warehouse è più pulito quando l'organizzazione vuole una governance stretta sui dati modellati. Lo schema lake è migliore quando devono convivere più stili di elaborazione e i dati grezzi vanno conservati per una rielaborazione flessibile.

Ingestion incentrata sul warehouse
In un'architettura incentrata sul warehouse, i dati di solito fluiscono dalle sorgenti ai connettori, poi in una landing zone, quindi attraverso trasformazioni in stile dbt e infine in data mart curati. Questo schema funziona bene quando il business vuole un livello di modellazione definito e una forte coerenza prima di un consumo più ampio.
I punti di aggancio della governance si trovano nel contratto con la sorgente, nell'area di landing e nel livello di trasformazione. La lineage deve seguire ogni modello, così che gli analisti possano risalire a che cosa è cambiato e perché. La sicurezza deve essere presente a ogni passaggio di consegne, con crittografia in transito e a riposo, rete privata e controlli di accesso adeguati alla sensibilità dei dati.
Ingestion incentrata sul lake
Un'architettura incentrata sul lake mantiene visibile una parte maggiore della forma grezza. I dati passano dalle sorgenti ai connettori, poi in una raw zone, in una processed zone e in una curated zone. In questo modo è più semplice supportare input sia batch sia streaming senza costringere tutto in un unico stile di modellazione.
L'impostazione di governance deve essere più rigorosa ai margini, perché si conservano più dati grezzi. Il tracciamento dello schema deve avvenire vicino al confine del lake, la lineage deve attraversare tutte le zone e il controllo degli accessi va applicato a ogni livello, così che i dati grezzi non si trasformino in una proliferazione incontrollata. È lo schema che spesso si adatta agli ambienti finance, sanità, telecomunicazioni e pubblica amministrazione, quando residenza e controllo contano quanto la flessibilità.
La scelta architetturale riguarda meno l'eleganza e più ciò che l'organizzazione deve dimostrare. Se gli auditor vogliono una storia chiara su chi ha cambiato cosa, il modello incentrato sul warehouse è più facile da governare. Se gli engineer devono rieseguire eventi grezzi o supportare più stili di elaborazione, il modello incentrato sul lake di solito assorbe meglio questa complessità.
Mettere tutto insieme e che aspetto ha la maturità
Una pipeline diventa più facile da considerare affidabile quando l'ordine è quello giusto. Scegliete la cadenza in base allo SLA. Definite i contratti prima dei connettori. Trattate i timestamp come una feature. Osservate prima di generare alert. Questa sequenza riduce le rilavorazioni, perché ogni scelta restringe lo spazio per le sorprese successive.
Le pipeline di data ingestion attraversano in genere tre livelli di maturità. Prima ci sono pipeline che funzionano: i dati arrivano, ma i guasti vengono gestiti manualmente. Poi pipeline osservate, in cui i team vedono freschezza, latenza, tasso di errore e derive prima che gli utenti si lamentino. Infine pipeline governate, in cui contratti, validazione e gestione delle modifiche fanno parte del modello operativo anziché essere interventi d'emergenza.
È in quest'ultimo passaggio che l'ingestion smette di essere un'infrastruttura invisibile e inizia a giustificare il proprio budget. Non porta una funzionalità appariscente, ma previene il tipo di incidenti che minano la fiducia, consumano tempo di engineering e generano una crescita silenziosa dei costi su sorgenti e caricamenti.
Se state mappando il vostro stack, iniziate da tracciamento dello schema, rilevamento delle anomalie, monitoraggio della tempestività e governance dei costi, poi fate in modo che ciascuno risponda a una domanda operativa concreta. La migliore pratica di ingestion è quella che tiene fuori i dati errati, mantiene leggibili i costi ed evita che il business discuta su quale caricamento sia fallito.
Se siete pronti a rendere l'ingestion meno fragile, digna aiuta i team a validare i record, monitorare la tempestività, tracciare le modifiche allo schema e rilevare anomalie all'interno di ambienti private cloud o on-prem. Visitate digna per vedere come un livello di osservabilità guidato dai contratti si inserisce nella vostra pipeline e usatelo per ridurre il divario tra una modifica alla sorgente e un incidente visibile al business.
Se la vostra dashboard di ingestion ha bisogno di segnali su freschezza, schema e anomalie in un unico punto, senza copiare i dati fuori dal vostro ambiente, scoprite la data platform observability con digna.
Domande frequenti
Che cos'è una pipeline di data ingestion?
Una pipeline di data ingestion riceve dati grezzi da sorgenti come database, API, flussi di eventi, file e dispositivi IoT, li valida e li instrada verso un data warehouse, un data lake, un database o un'altra destinazione. Presidia la porta d'ingresso: l'ingestion termina quando dati affidabili sono stati depositati e controllati, non quando i byte hanno finito di essere copiati.
Meglio un'ingestion batch, micro-batch o streaming?
Lasciate decidere lo SLA di freschezza. Il batch è adatto a esigenze come una dashboard finance che deve riflettere la chiusura di ieri entro le 8 del mattino, il micro-batch si adatta agli aggiornamenti infragiornalieri e lo streaming serve quando le decisioni cambiano nell'istante in cui si verifica un evento. Lo streaming comporta la complessità più alta e richiede idempotenza, gestione della backpressure e un monitoraggio stretto.
Quali sono i componenti chiave di un'architettura di ingestion?
I componenti che contano sono cinque: connettori sorgente, landing zone, livello di schema e validazione, orchestrazione e monitoraggio. Ognuno cede in modo diverso. Un connettore fragile si rompe quando un'API cambia o una credenziale scade, una landing zone debole rende difficile la riesecuzione e l'assenza di un livello di validazione lascia passare strutture errate che i team a valle dovranno scoprire.
Come si evitano i record duplicati quando i job di ingestion vengono rieseguiti?
Progettate per l'idempotenza con chiavi deterministiche e upsert, così che un retry dopo un'interruzione di rete non trasformi i record duplicati in doppi conteggi. L'articolo considera i retry inevitabili e raccomanda anche di registrare sia l'event time sia l'ingestion time in UTC, per distinguere gli eventi in ritardo da una pipeline lenta.
Come si dovrebbero validare i dati in una pipeline di ingestion?
Validate su più livelli. I controlli sullo schema all'ingresso intercettano colonne mancanti o tipi di dati modificati, le regole a livello di record intercettano date impossibili o transizioni di stato non valide e i controlli di trend intercettano le derive. Baseline apprese e rilevamento delle anomalie colgono gli spostamenti più silenziosi che sfuggono agli alert a soglia, idealmente con esecuzione in-database, vicino ai dati.


