Monitoraggio della data quality su Databricks: guida 2026
|
8
min di lettura
Se vi è mai capitato di vedere una pipeline Delta terminare senza errori mentre una dashboard downstream mostrava ancora numeri obsoleti, sapete già che il problema non è se qualcosa è stato eseguito. Il problema è se i dati erano sicuri da usare nel momento in cui sono arrivati. Nelle configurazioni di monitoraggio della data quality su Databricks, questo divario emerge rapidamente negli ambienti regolamentati, dove un job completato può comunque contenere caricamenti incompleti, commit in ritardo o modifiche silenziose agli schemi che nessuno nota finché un utente di business non si lamenta.
Il monitoraggio nativo di Databricks offre ai team un vero punto di partenza, anche perché registra metriche storiche di profilo come count, num_nulls, avg, min/max, stddev e 1.000 quantili per ogni colonna profilata, e confronta la tabella corrente con una baseline o con finestre successive per rilevare le derive. Si estende anche alle tabelle di inferenza con metriche ML come accuracy_score, log_loss, mean_squared_error, mean_absolute_percentage_error e r2_score. È utile, ma resta solo un livello dello stack, non lo stack stesso, perché il rilevamento senza ownership, instradamento e gating dei rilasci non tiene i dati errati fuori dalla produzione. Documentazione Databricks sul monitoraggio della data quality
Indice
Quando il monitoraggio nativo di Databricks non basta più
Freshness e completezza sono necessarie, non sufficienti
Cosa deve aggiungere il resto dello stack
Architettura di uno stack di monitoraggio a più livelli
Dove si collocano i moduli
Attivare Unity Catalog Data Quality Monitoring
Cosa significano gli stati nativi
Una sequenza di rollout minima
Aggiungere validazione dei record e anomaly detection
Prima le regole deterministiche
Aggiungere l'apprendimento della baseline per le colonne di business
Colmare il divario di ownership e lineage
Cosa lascia ancora scoperto il monitoraggio nativo
Un flusso di arricchimento pratico
Alerting, dashboard e gating CI/CD
Instradare gli alert in base alla ownership, non solo alla gravità
Bloccare le promozioni prima che arrivino in produzione
Un piano di rollout in 90 giorni e una checklist di troubleshooting
Soluzioni rapide per i problemi più frequenti
Quando il monitoraggio nativo di Databricks non basta più
I team dei settori regolamentati di solito si scontrano con i limiti del monitoraggio nativo dopo un incidente sfiorato o una revisione post-incidente. Lo schema è noto. Si attiva un monitor a livello di schema, il job della dashboard si completa nei tempi previsti e la tabella sembra sana a prima vista. Poi qualcuno si accorge che l'ultima tabella Silver punta ancora al commit della sorgente del giorno prima, o che un caricamento parziale è passato perché la pipeline controllava solo che i dati fossero arrivati, non che fossero arrivati abbastanza completi da potersene fidare.
Freshness e completezza sono necessarie, non sufficienti
Il monitoraggio integrato di Databricks si concentra su freshness e completezza, ed è il primo livello giusto, perché questi segnali intercettano presto le modalità di guasto evidenti. Il servizio apprende pattern storici e stagionali, poi segnala i cambiamenti inattesi con output statistici espliciti invece che con ispezioni manuali. Può anche contrassegnare una tabella come stale quando il commit successivo arriva più tardi rispetto alla pianificazione appresa, oppure come incomplete quando il numero di righe delle ultime 24 ore scende sotto il limite inferiore atteso dal modello. Questo comportamento ha senso dal punto di vista operativo, ma lascia comunque un ampio divario tra “qualcosa non torna” e “questa specifica regola di business è fallita”.
Il problema pratico è che un interruttore a livello di schema può creare una falsa sicurezza. Una tabella può essere tecnicamente presente ed essere comunque sbagliata per la reportistica, le feature ML o gli estratti normativi. Se la pipeline controlla solo arrivo e volume, non vedrà una mancata corrispondenza di chiavi esterne, un vincolo di non nullità violato o un valore strutturalmente valido ma semanticamente errato. I team che necessitano di auditabilità devono aggiungere controlli a livello di record, un instradamento consapevole della ownership ed evidenze che vadano oltre la scansione dello schema.
Regola pratica: se un monitor sa dirvi che i dati si sono spostati, ma non se si sono spostati i record giusti, segnala i sintomi senza garantire la fiducia.
Cosa deve aggiungere il resto dello stack
Il resto del design colma quattro lacune. Primo, la validazione a livello di record intercetta le regole di business deterministiche. Secondo, le baseline di puntualità distinguono un ritardo previsto da una consegna mancata. Terzo, l'alerting consapevole del lineage evita che venga allertato il team sbagliato. Quarto, il gating CI/CD blocca le modifiche errate prima che raggiungano le tabelle di produzione.
È questa la differenza tra un monitor che riporta sintomi e uno stack di observability che sostiene la fiducia in produzione. In un deployment Databricks reale, il punto di partenza è un approccio a più livelli costruito attorno a Unity Catalog, alle expectations delle pipeline e all'analisi in-database, non un singolo interruttore nell'interfaccia. Per un esempio pratico di come i team riuniscono questi livelli in un unico modello operativo, consultate il modello di implementazione dell'observability su Databricks.
Architettura di uno stack di monitoraggio a più livelli
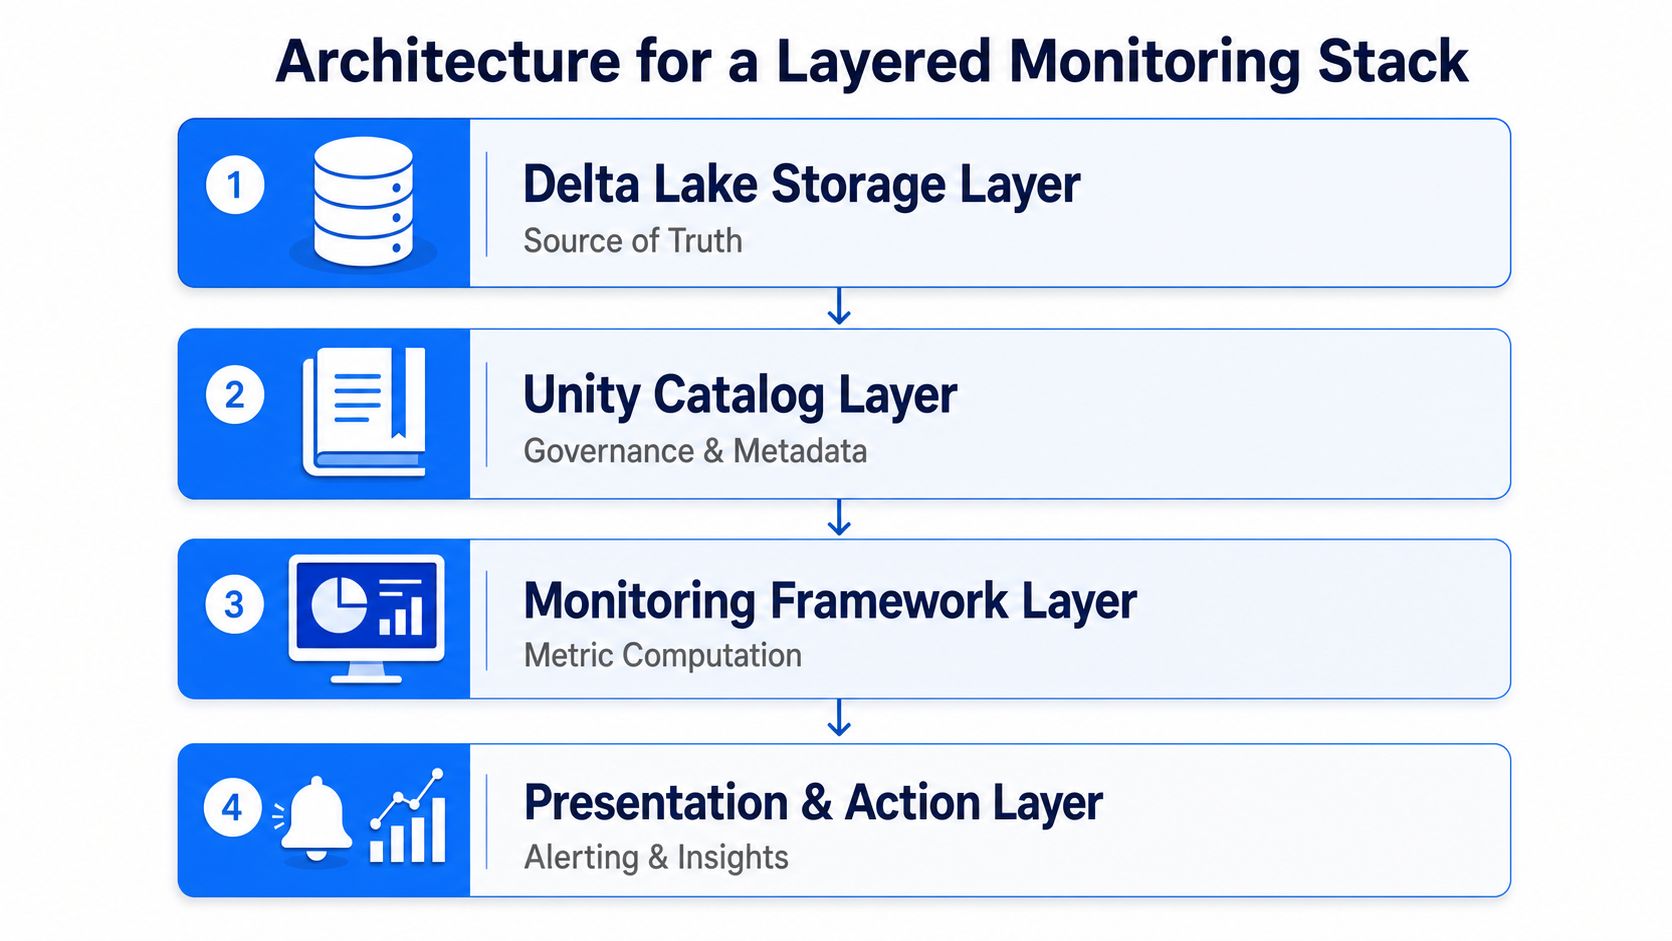
Una configurazione di monitoraggio della data quality su Databricks in produzione funziona meglio come stack a più livelli. Lo storage Delta Lake contiene la fonte di verità. Unity Catalog fornisce governance e metadati. Delta Live Tables è il punto in cui vengono eseguiti i controlli dichiarativi. Il piano di observability legge le system table e gli output delle metriche, mantenendo i dati di produzione all'interno dell'ambiente.
Un errore comune è trattare ogni segnale come lo stesso tipo di problema. Una tabella in ritardo, un caricamento ridotto, una regola di business fallita e una modifica allo schema non richiedono la stessa risposta, quindi non dovrebbero condividere un unico percorso di alert. Il monitoraggio nativo di Databricks dà il meglio sulla salute a livello di piattaforma, perché analizza le tabelle critiche di uno schema, apprende i pattern storici e archivia i risultati all'interno dell'ambiente del cliente. La documentazione Azure Databricks di Microsoft descrive inoltre i risultati del monitoraggio come una system table con conservazione gratuita a tempo indeterminato, il che la rende adatta alla revisione storica e alle attività di audit sull'intero account. System table di Azure Databricks per il monitoraggio della data quality
La suddivisione deve restare chiara. Il monitoraggio della piattaforma risponde alla domanda se la tabella è arrivata in tempo e con un volume sufficiente per potersene fidare. Le expectations della pipeline rispondono alla domanda se un record ha violato una regola. L'anomaly detection risponde alla domanda se una colonna di business si è allontanata dalla sua baseline appresa. Questa divisione mantiene gestibile il traffico di reperibilità, perché non tutti gli incidenti vengono appiattiti in un guasto generico.
Dove si collocano i moduli
La mappa dei moduli di digna si allinea a questo design. Data Anomalies copre l'apprendimento della baseline e l'anomaly detection continua. Timeliness copre le finestre di arrivo previste e i caricamenti in ritardo. Data Validation applica le regole a livello di record. Schema Tracker sorveglia le derive strutturali. Questa suddivisione si adatta all'architettura perché il piano di observability può utilizzare questi segnali senza spostare righe fuori dal warehouse o dal lake.
Mantenete il calcolo vicino ai dati. Negli ambienti regolamentati non è solo una scelta di prestazioni: è il confine che mantiene i record di produzione all'interno dell'ambiente del cliente.

Il valore del diagramma è operativo, non visivo. Mostra il flusso di controllo che funziona in produzione. La pipeline emette segnali, il piano di observability li valuta e il livello di alerting decide cosa instradare, sopprimere o portare in escalation. Questo modello scala con la crescita del patrimonio dati perché evita di concentrare ogni decisione in un unico monitor monolitico.
Attivare Unity Catalog Data Quality Monitoring
Databricks attiva il monitoraggio a livello di schema, non scrivendo a mano un controllo per ogni tabella. La procedura operativa è semplice. Attivate il monitor in Unity Catalog, lasciate eseguire il primo job pianificato, poi esaminate le system table e le viste di qualità risultanti. La cadenza predefinita è oraria, e Databricks spiega che il backtest storico integrato può simulare il monitor come se fosse stato attivato due settimane prima, il che è un modo utile per costruire una baseline prima di fidarsi dei segnali in tempo reale. Dettagli sul rollout di Unity Catalog Data Quality Monitoring
Cosa significano gli stati nativi
Stato del monitor | Condizione | Significato operativo |
|---|---|---|
Stale | Il commit successivo arriva più tardi rispetto alla pianificazione appresa | La pipeline è in ritardo, oppure la consegna upstream si è spostata |
Incomplete | Il numero di righe delle ultime 24 ore scende sotto il limite inferiore atteso dal modello | La tabella è arrivata, ma il volume sembra insufficiente |
Healthy | Freshness e completezza restano entro i limiti appresi | Per ora la tabella corrisponde al comportamento atteso |
Questo modello di stati è pratico perché offre ai team operativi qualcosa su cui agire senza costringerli a definire soglie da zero. La documentazione Azure Databricks di Microsoft spiega che il job in background monitora freshness e completezza, utilizza lo smart scanning per decidere quando eseguire le scansioni e registra i problemi di qualità in una tabella consultabile in Catalog Explorer o in Governance Hub. Flusso di monitoraggio di Azure Databricks
Una sequenza di rollout minima
Iniziate con una manciata di tabelle Bronze che alimentano processi downstream critici. Attivate il monitor dello schema, lasciate che il primo aggiornamento stabilisca una baseline e poi esaminate lo storico prima di collegare gli alert. Se attivate troppi schemi il primo giorno, ogni falso positivo diventa una riunione di governance.
Per iniziare basta spesso un semplice controllo SQL:
Questa query non intende sostituire l'interfaccia. Serve a offrire ai team di piattaforma un modo rapido per esaminare gli schemi monitorati e decidere dove effettuare il prossimo ciclo di taratura. Una volta stabilizzata la baseline, l'output del monitor diventa un segnale all'interno del più ampio ciclo di gestione degli incidenti, non l'intero piano di risposta.
Aggiungere validazione dei record e anomaly detection
Una tabella può arrivare in tempo, superare un controllo sullo schema e compromettere comunque il business. Un file di sinistri può caricarsi senza errori mentre un importo di rimborso diventa negativo, manca un codice regione obbligatorio o un record sanitario passa con un identificativo non valido. I controlli nativi di freshness e completezza intercettano il pattern di arrivo, non la regola che interessa a finance, sanità o operations. Ecco perché il livello successivo sono le expectations di Delta Live Tables, che mantengono i controlli deterministici espliciti e versionati insieme alla pipeline.
Prima le regole deterministiche
Usate le expectations di DLT per le condizioni che non dovrebbero mai dipendere da un comportamento appreso. Controlli di non nullità, controlli di intervallo e integrità referenziale sono i punti di partenza ovvi, perché falliscono subito e vi danno un motivo chiaro per fermare o mettere in quarantena i record errati.
Anche i controlli su più tabelle vanno collocati vicino ai dati. Inserite la logica in una join all'interno della pipeline oppure scrivete il risultato in una tabella di validazione downstream, poi lasciate che sia la pipeline a decidere se un record è valido. Così la regola resta nello stesso percorso di esecuzione dei dati e si evita di spostare righe in uno strumento separato solo per rispondere a una domanda sì-o-no.
Aggiungere l'apprendimento della baseline per le colonne di business
Una volta definite le regole deterministiche, usate l'anomaly detection per le colonne la cui forma cambia nel tempo. Conteggi, medie, distribuzioni e stagionalità sono spesso più utili di una soglia fissa, soprattutto per le metriche operative che variano con i cicli di business. Il livello di profiling di Databricks archivia metriche storiche come count, num_nulls, avg, min/max, stddev e 1.000 quantili, offrendovi una serie temporale del comportamento invece di un'istantanea isolata. Supporta inoltre il confronto con una baseline o con finestre successive, così il piano di observability può sorvegliare le derive senza portare i dati di produzione fuori dall'ambiente. Metriche di profiling e drift di Databricks
Un modello pratico consiste nel calcolare una baseline mobile in-database e scrivere il punteggio in una tabella Delta:
Questa tabella può alimentare il vostro livello di alerting, una dashboard o un motore di regole separato. Se desiderate un flusso dedicato alle anomalie, l'approccio di digna all'anomaly detection segue lo stesso schema: prima la baseline, poi l'alert, con il calcolo che resta in-database.
Il controllo più solido è quello che non lascia mai il warehouse. Nei workload regolamentati, questo conta quanto il segnale stesso.
La suddivisione è pratica. Le expectations di DLT impongono ciò che sapete già dover essere vero. Le baseline intercettano ciò che cambia nel tempo. Usate insieme, coprono i casi che il monitoraggio a livello di schema non sa valutare.
Colmare il divario di ownership e lineage
Il rilevamento è di solito la parte facile. L'instradamento è più difficile. Un monitor può mostrare che una tabella è obsoleta o incompleta, ma non vi dice chi ne è responsabile, quale feed upstream l'ha compromessa o se il raggio d'impatto raggiunge una dashboard dei ricavi, un report clinico o un estratto normativo. Il monitoraggio tramite system table di Databricks espone effettivamente campi sull'impatto downstream, tra cui una scala di gravità da 0 a 4 in cui 4 = molto alta, oltre a campi di esempio come num_downstream_tables = 5 e num_queries_on_affected_tables = 120 negli ultimi 30 giorni. Questo conta perché vi offre una visione concreta dell'impatto, non solo uno stato di errore.
Cosa lascia ancora scoperto il monitoraggio nativo
I pezzi mancanti sono governance, ownership e capacità di azione. I team hanno ancora bisogno di livelli di criticità, tag dei responsabili, triage basato sul lineage e regole di gating dei rilasci. La documentazione Azure Databricks di Microsoft è esplicita: il servizio nativo è incentrato sull'anomaly detection a livello di schema per freshness e completezza, con ulteriori controlli annunciati per il futuro, ed è per questo che la maggior parte delle aziende continua ad aggiungere sopra un piano di observability esterno. Ambito del monitoraggio di Azure Databricks
Un modello pratico consiste nell'arricchire l'output delle system table con i metadati di Unity Catalog. Se una tabella Bronze fallisce, l'alert deve essere instradato al responsabile del livello Bronze, non al consumatore del livello Silver. Se una tabella Gold regredisce, la chiamata deve andare al responsabile del livello di serving e includere i campi sull'impatto downstream, così chi è di turno può valutarne l'urgenza prima di procedere con l'escalation. In questo modo il monitor nativo resta nel suo ambito e il percorso di risposta ha abbastanza contesto per agire.
Un flusso di arricchimento pratico
Estraete i problemi del monitor dalla system table.
Uniteli ai tag di Unity Catalog per owner, criticità e dominio.
Integrate i metadati di lineage per identificare i consumatori downstream.
Instradate gli alert in base alla gravità e all'importanza per il business.
Questa join trasforma un evento grezzo del monitor in un record operativo. Semplifica anche le revisioni di audit, perché l'evento porta con sé un contesto, non solo uno stato.
Un modello comune negli ambienti finance e della pubblica amministrazione consiste nel trattare il monitor come rilevatore e il livello di alerting come motore delle policy. Questo confine mantiene utile la funzionalità nativa senza pretendere che possa risolvere da sola il tema della responsabilità. La stessa separazione lascia spazio anche a baseline di puntualità, validazione in-database e gating CI/CD laddove il monitoraggio a livello di schema non arriva.
Alerting, dashboard e gating CI/CD
Una volta che le metriche esistono, l'errore successivo è riversarle in un'unica dashboard e chiamarla observability. Questo nasconde più di quanto riveli. Una vista sulla salute della piattaforma dovrebbe mostrare lo stato delle scansioni, lo stato dei monitor e la salute dei job. Una vista sulla salute del business dovrebbe mostrare freshness, completezza e drift rispetto ai dati utilizzati dai consumatori. Sono pubblici diversi, e hanno bisogno di allarmi diversi.
Instradare gli alert in base alla ownership, non solo alla gravità
La logica di instradamento deve essere abbastanza semplice da poter essere spiegata durante un audit. Prima il livello di criticità, poi il tag del responsabile, infine il contesto di lineage. Se il problema riguarda il livello Gold e l'impatto downstream è elevato, procedete subito con l'escalation. Se si tratta di un feed Bronze upstream senza consumatori attivi, instradatelo al team responsabile e non fate scattare chiamate a meno che il ritardo non persista.
È anche qui che una piattaforma come le dashboard di digna per la data quality si inserisce in modo naturale. La parte utile non è l'interfaccia in sé. È la separazione tra metriche di piattaforma e metriche di business, perché è questo che evita agli operatori di inseguire il rumore delle pipeline quando il vero problema è una regola di business violata.
Bloccare le promozioni prima che arrivino in produzione
Il monitoraggio appartiene alla pipeline di rilascio, non solo al flusso di gestione degli incidenti. Se una modifica allo schema, un errore di validazione o una nuova expectation viola un controllo, la promozione deve fermarsi prima che la modifica arrivi in produzione. I Databricks Asset Bundles possono includere questo controllo accanto alla definizione del job, che è esattamente dove lo vogliono i team di governance, perché l'evidenza è versionata insieme al deployment.
Questo esempio è volutamente minimale. In un deployment reale, il task di validazione dovrebbe interrogare la tabella Delta monitorata o la vista di validazione e far fallire il bundle quando una regola viene violata. Il punto è rendere la qualità parte dell'artefatto distribuibile, non una dashboard a posteriori che qualcuno si ricorda di controllare.
Il monitoring-as-code conta negli ambienti regolamentati perché ogni modifica ha bisogno di un controllo tracciabile. Se la regola vive nella pipeline, anche la traccia di audit vive lì.
Un piano di rollout in 90 giorni e una checklist di troubleshooting
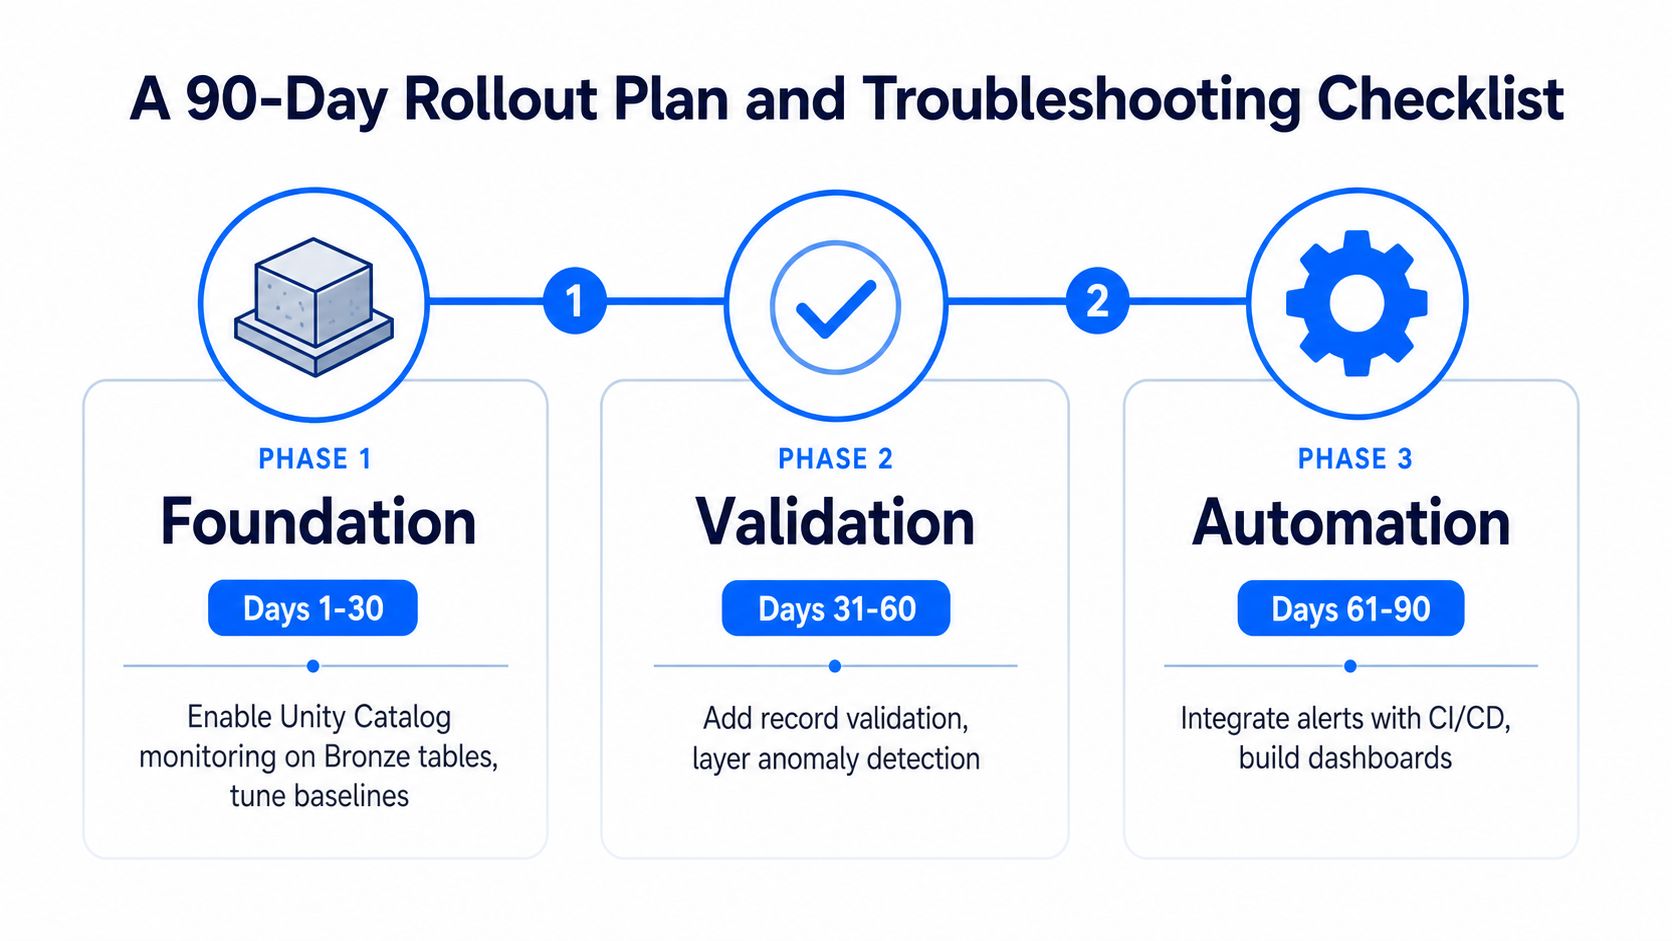
Il modo più rapido per rendere tutto questo operativo è procedere per fasi. I giorni da 1 a 30 servono ad attivare il monitoraggio di Unity Catalog su un piccolo insieme di tabelle Bronze e a tarare le baseline. I giorni da 31 a 60 servono ad aggiungere la validazione dei record e i controlli di puntualità sulle tabelle Silver. I giorni da 61 a 90 servono a collegare gli alert alla CI/CD, assegnare i livelli di criticità e instradare gli incidenti ai responsabili.
Soluzioni rapide per i problemi più frequenti
Lacune nei backfill. Rieseguite il monitor dopo il completamento del caricamento storico, poi considerate la prima finestra pulita come nuova baseline.
Falsi alert di freshness dopo l'evoluzione dello schema. Verificate se la pianificazione appresa corrisponde ancora al nuovo ritmo dei commit, poi ricalcolate la baseline del monitor.
Gravità ferme a 0. Verificate che i metadati sull'impatto downstream e il lineage siano popolati, perché senza raggio d'impatto non c'è una gravità significativa.
Tabelle di lineage senza elementi downstream. Verificate il lineage di Unity Catalog e la registrazione delle tabelle prima di fidarvi del grafo.
Alert che arrivano al team sbagliato. Rivedete i tag dei responsabili e le etichette di criticità, poi instradate a partire dal record di alert arricchito invece che dall'output grezzo del monitor.
La lezione operativa è semplice. Il monitoraggio nativo di Databricks è efficace nel rilevare la salute delle tabelle, ma la fiducia in produzione deriva da come stratificate governance, validazione e instradamento attorno a esso. Se state costruendo questo stack ora, digna può affiancare Databricks come livello di observability in-database per anomalie, puntualità, validazione e schema drift. Visitate digna per scoprire come si inserisce in un modello operativo Databricks regolamentato e confrontarlo con la vostra attuale configurazione di monitoraggio.
Scoprite come digna lo fa in pratica: data quality per Databricks.
Domande frequenti
Cosa controlla di default il monitoraggio della data quality di Databricks?
Il monitoraggio nativo si concentra su freshness e completezza. Apprende pattern storici e stagionali, contrassegna una tabella come stale quando il commit successivo arriva più tardi rispetto alla pianificazione appresa e come incomplete quando il numero di righe delle ultime 24 ore scende sotto il limite inferiore atteso. I profili registrano anche count, num_nulls, avg, min/max, stddev e 1.000 quantili.
Come si attiva Unity Catalog Data Quality Monitoring?
Si attiva a livello di schema invece di scrivere un controllo per ogni tabella. Attivate il monitor in Unity Catalog, lasciate eseguire il primo job pianificato, poi esaminate le system table. La cadenza predefinita è oraria, e un backtest storico simula il monitor come se fosse stato attivato due settimane prima per costruire una baseline.
Perché il monitoraggio nativo di Databricks non basta per i dati regolamentati?
Perché una tabella può arrivare in tempo, con abbastanza righe, ed essere comunque sbagliata. I controlli nativi non rilevano mancate corrispondenze di chiavi esterne, vincoli di non nullità violati e valori semanticamente errati. L'articolo aggiunge quattro livelli: validazione a livello di record, baseline di puntualità, alerting consapevole del lineage e gating CI/CD che blocca le modifiche errate prima che raggiungano le tabelle di produzione.
Come si scrivono regole di data quality con le expectations di Delta Live Tables?
Usate le expectations di DLT per le regole deterministiche che non dovrebbero mai dipendere da un comportamento appreso. Gli esempi dell'articolo sono CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL), valid_amount EXPECT (amount >= 0) e un controllo della regione limitato a NA, EMEA e APAC. I record non conformi possono poi essere fermati o messi in quarantena con un motivo chiaro.
Come vanno instradati gli alert di data quality di Databricks?
Instradateli in base alla ownership, non solo alla gravità. Arricchite l'output delle system table con i metadati di Unity Catalog, così che un errore nel livello Bronze allerti il responsabile Bronze invece del consumatore Silver. Includete i campi sull'impatto downstream, come la scala di gravità da 0 a 4 e il numero di query sulle tabelle interessate, così chi è di turno può valutarne l'urgenza prima dell'escalation.


