Fonti di dati eterogenee: guida pratica all'integrazione
|
7
min di lettura
Probabilmente lo avete già vissuto. Lo standup del lunedì inizia con qualcuno che dice che secondo il CRM l'ultimo trimestre è andato bene, la finanza sostiene che il quadro dei margini è diverso e il data warehouse di prodotto mostra un terzo numero completamente differente. Nessuno sta mentendo, ma nella stanza cala comunque il silenzio, perché ogni report descrive una versione leggermente diversa del business.
È questo che rende le fonti di dati eterogenee così frustranti. La rottura raramente inizia con un guasto clamoroso: inizia con piccole decisioni, un timestamp interpretato in un modo in una pipeline, una regola sui rimborsi aggiornata in un'altra, o una definizione di "cliente attivo" che si è spostata quanto basta per distorcere la dashboard. Se avete ereditato uno stack di reporting cresciuto attraverso iniziative passate, fusioni, cambi di fornitore e correzioni "temporanee" mai rimosse, sapete già quanto tutto questo sembri normale.
Indice dei contenuti
Quando i vostri report smettono di concordare
Un responsabile finance entra con un foglio di calcolo, un analista di prodotto apre la dashboard del data warehouse e il team CRM indica la propria vista dei ricavi. A prima vista tutti e tre i numeri sembrano ragionevoli, il che peggiora il disaccordo invece di migliorarlo. Il team non riceve un segnale di errore chiaro: riceve tre storie plausibili che non possono essere vere tutte contemporaneamente.
Di solito è in quel momento che si dà la colpa al data warehouse, al livello di BI o all'ultimo job ETL che qualcuno ha toccato. La causa spesso si trova a monte. Una pipeline potrebbe aver convertito i timestamp nell'ora locale, un'altra potrebbe aver applicato una nuova policy sui rimborsi e una terza potrebbe ancora contare i "clienti attivi" secondo una definizione che nessuno ha documentato dopo l'ultimo lancio.
Per questo la riconciliazione dei dati non consiste tanto nel "far quadrare i report", quanto nel ricostruire quale sistema detiene quale versione della realtà. Un buon punto di partenza è un semplice modello mentale: ogni fonte ha le proprie regole, e queste regole possono divergere senza che alcun team intenda causare problemi. Per una definizione in parole semplici di questo problema di riconciliazione, consultate la panoramica di digna sulla riconciliazione dei dati.
Regola pratica: se tre report non concordano, non iniziate riscrivendo la dashboard. Iniziate chiedendovi quale campo, regola o timestamp è cambiato per primo.
La confusione è così comune perché gli stack di dati moderni sono costruiti su una storia accumulata, non su un unico diagramma architetturale pulito. Ciò significa che lo stesso evento di business può essere rappresentato in un CRM, in un sistema finanziario, in un data warehouse e in uno strumento di assistenza, ciascuno con la propria cadenza e il proprio vocabolario. A quel punto "il numero" smette di essere un numero e diventa una negoziazione tra sistemi.
Cosa significa davvero fonti di dati eterogenee
"Eterogenee" sembra indicare un problema di formato, ma è solo il primo livello. Una fonte può arrivare in JSON, un'altra in CSV, un'altra ancora in parquet, e un'esportazione di un fornitore può essere bloccata nella propria struttura. Già a questo livello, la forma dei dati cambia il modo in cui li acquisite, li analizzate e li validate.
Il livello successivo è la cadenza. Un file batch notturno, un feed di eventi in streaming e un foglio di calcolo gestito manualmente si comportano tutti in modo diverso in una pipeline. Se li trattate allo stesso modo, la fonte più fresca può comunque essere la meno affidabile, perché arriva al momento sbagliato e con aspettative sbagliate.
Poi viene il livello che la maggior parte delle guide trascura: la semantica. Due sistemi possono avere entrambi una colonna chiamata customer_id, ma in uno può essere la chiave primaria del system of record, mentre nell'altro è un identificativo di marketing anonimizzato per il reporting delle campagne. Le etichette coincidono, il significato no, ed è lì che le join ingenue traggono in inganno.

Lo stack delle incongruenze
Un buon modo di pensare alle fonti di dati eterogenee è come a uno stack. Le differenze di formato stanno alla base, i confini tra sistemi al livello superiore e le differenze semantiche in cima, dove risiede il significato di business. Ogni livello amplifica quello sottostante, ed è per questo che una join può sembrare tecnicamente riuscita ed essere comunque sbagliata dal punto di vista analitico.
Quando i team cercano un processo di discovery migliore tra data warehouse, API e strumenti legacy, di solito hanno bisogno di un modo per far emergere presto questi livelli. Un punto di partenza pratico sono le indicazioni di digna sulla data discovery, perché l'inventario delle fonti e le verifiche di significato devono avvenire prima che le trasformazioni consolidino ipotesi sbagliate.
Un dataset può essere formattato perfettamente ed essere comunque sbagliato per la domanda che vi state ponendo.
È questo il malinteso di fondo. Spesso si pensa che l'integrazione dei dati consista soprattutto nello spostare byte da un posto all'altro. In pratica, si tratta di allineare formato, cadenza, design dei sistemi e significato di business, in modo che la vista finale non si limiti a caricarsi correttamente, ma dica la verità.
Quattro sfide pratiche che incontrerete per prime
I primi problemi di integrazione si presentano in fretta e di solito sembrano banali. Il payload di un webhook Stripe arriva come JSON annidato, mentre un ERP legacy emette ancora file notturni a larghezza fissa. L'incongruenza di forma è evidente, ma il costo sta nella continua inferenza dello schema e nel tempo che le persone impiegano a decidere quale campo sia autorevole.
Le quattro modalità di errore che emergono per prime
Sfida | Come si presenta | Sintomo tipico |
|---|---|---|
Eterogeneità dei formati | JSON annidato da una parte, esportazioni a larghezza fissa dall'altra | I job di caricamento si interrompono o deducono lo schema sbagliato |
Disallineamento delle cadenze | Ticket in tempo reale mescolati a file di sondaggi settimanali | Le dashboard invecchiano silenziosamente e confondono gli utenti |
Variabilità della qualità | Arricchimenti di terze parti accanto a clickstream di prima parte incompleti | Valori nulli, duplicati e aggregati instabili |
Conflitto semantico | "Paese" indica un codice ISO in un sistema e un testo libero in un altro | Le join riescono, ma il KPI è sbagliato |
Il disallineamento delle cadenze è quello che inganna di più i team. I ticket di assistenza possono arrivare in streaming quasi in tempo reale, mentre i sondaggi sulla soddisfazione dei clienti arrivano in un CSV settimanale: qualsiasi vista sulle "ultime 24 ore" può quindi essere incompleta senza sembrare guasta. Se l'analista non conosce il profilo di ritardo di ciascuna fonte, scambierà le differenze di freschezza per cambiamenti del business.
La variabilità della qualità è il killer silenzioso. Gli arricchimenti di terze parti possono trovarsi accanto a dati clickstream di prima parte con sessioni mancanti, identificativi duplicati o record incoerenti, e l'output unito può sembrare comunque abbastanza pulito da superare un controllo superficiale. È proprio per questo tipo di instabilità che la qualità delle fonti va trattata come parte del design, non come un lavoro di pulizia a posteriori.
Il conflitto semantico è il più difficile, perché si nasconde dietro nomi di campo familiari. Una fonte che usa country per i codici ISO, un'altra che memorizza testo libero e una terza che conserva un'abbreviazione obsoleta hanno tutte "ragione" all'interno dei propri sistemi. Nel momento in cui le confrontate, il significato di business si frantuma.
Per i team che vogliono capire come la deriva strutturale si trasformi in pipeline interrotte, le indicazioni di digna sulla schema drift aiutano a inquadrare il problema come operativo, non solo come un fastidio di modellazione.
Se il nome del campo vi sembra familiare, rallentate. I nomi familiari sono il luogo in cui si nascondono i bug semantici.
Ecco perché i progetti di integrazione si arenano così spesso. I primi problemi non sono esotici, sono ordinari e ripetuti, e costringono i team a scegliere tra velocità e fiducia prima ancora che la forma dello stack sia definita.
Strategie di integrazione tra cui vale la pena scegliere
ETL, ELT, CDC e modellazione canonica risolvono problemi diversi, ed è facile usarli male quando vengono trattati come un'ideologia. L'ETL funziona quando i consumatori hanno bisogno di dati strutturati e curati e i sistemi sorgente sono abbastanza stabili da permettere di trasformare prima del caricamento senza continue rilavorazioni. È adatto a consumatori legacy, feed di conformità e livelli di reporting che dovrebbero vedere solo strutture verificate.
L'ELT ha più senso quando il data warehouse è veloce e gli analisti vogliono prima la fedeltà dei dati grezzi e poi la trasformazione. Questo consente ai team di preservare il dettaglio delle fonti e rivedere la logica in seguito senza dover estrarre di nuovo i dati. È particolarmente utile quando le domande di business cambiano più rapidamente dei sistemi sorgente.
La CDC appartiene alla corsia operativa. Quando i sistemi a valle devono riflettere rapidamente le modifiche alla sorgente, la change data capture mantiene il ritardo abbastanza ridotto da permettere ai flussi di prodotto, assistenza o finanza di restare allineati con ciò che è appena accaduto. Il compromesso è che la CDC può propagare più velocemente anche l'incertezza, quindi ha comunque bisogno di validazione all'arrivo.
La modellazione canonica risolve un problema completamente diverso: l'accordo. Se vendite, prodotto e finanza hanno tutti bisogno della stessa definizione di cliente o di prodotto prima di qualsiasi lavoro a valle, un modello canonico offre loro un unico contratto condiviso. All'inizio è più lento, ma impedisce a ogni team di inventarsi la propria verità a valle.
Gli stack più intelligenti di solito combinano questi pattern. Un team potrebbe portare la CDC in un'area di staging, usare l'ELT all'interno del data warehouse, alimentare un modello canonico per la BI e usare comunque l'ETL per strutturare le esportazioni verso un sistema legacy. Non è incoerenza, è un'architettura adatta allo scopo.
Se state confrontando opzioni di integrazione per casi d'uso di analytics e sensibili alla privacy, una soluzione di BI privacy-first può fornire un contesto utile, perché il pattern di integrazione e il livello di consumo di solito vanno progettati insieme.
Per i progetti incentrati sul data warehouse, la pagina di digna sull'integrazione del data warehouse è un utile punto di riferimento su come i livelli di caricamento e di erogazione si collegano nella pratica.
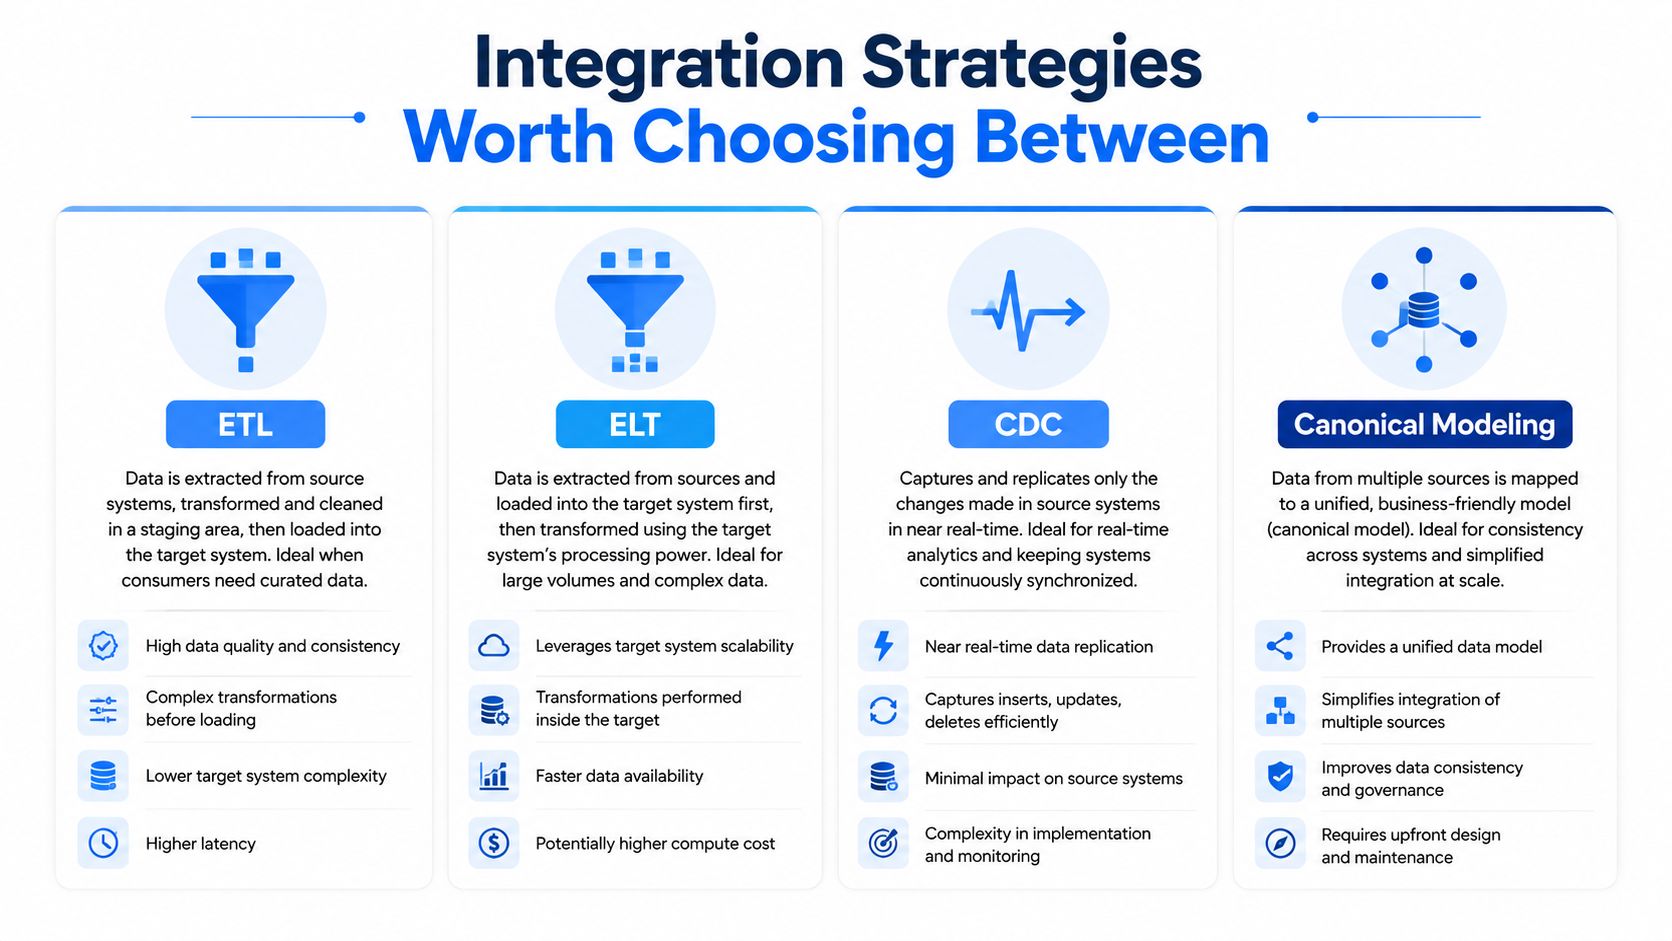
La strategia di integrazione giusta è quella che corrisponde al consumatore, al requisito di latenza e al livello di fiducia che potete garantire al confine.
Molti team perdono settimane a discutere su quale pattern sia "moderno". Questa discussione non coglie il punto. La domanda chiave è quale pattern mantenga il contratto semantico abbastanza chiaro da permettere ai team a valle di usare i dati senza doverli ricostruire a ritroso.
Armonizzazione e validazione che reggono
L'armonizzazione inizia con la deduplicazione, ma non quella semplicistica che presuppone l'esistenza di chiavi esatte. I sistemi indipendenti raramente condividono identificativi perfetti, quindi blocking key e matching probabilistico diventano spesso necessari solo per stabilire quali record si riferiscano probabilmente alla stessa entità. Questo passaggio deve avvenire prima che la logica di unione trasformi i conteggi duplicati in una falsa certezza.
Normalizzate il significato prima del numero
Una volta allineati i record, normalizzate il livello delle unità. Valute, fusi orari, sistemi di misura e calendari fiscali creano tutti incongruenze invisibili quando i team presumono che un valore significhi ovunque la stessa cosa. Un dato di ricavo nell'ora locale e uno in UTC possono essere entrambi corretti e comunque non confrontabili.
Poi viene la riconciliazione semantica. Qui contano le tabelle di mapping e le definizioni autorevoli, perché i nomi dei campi nascondono spesso differenze nelle regole di business che nessun controllo sui tipi potrà intercettare. Un nome di colonna pulito non aiuta se una fonte tratta il "cliente" come un account, un'altra come un utente e una terza come un'entità di fatturazione.
Lo stesso principio emerge nel lavoro sul "golden record", in cui i team cercano di decidere quale versione di un cliente, prodotto o sede debba essere portata avanti. Se volete un'altra impostazione pratica di questo problema, l'approccio al golden record di BatchData è un utile riferimento esterno su come un livello di record condiviso cambi la coerenza a valle.
La validazione deve poggiare sull'armonizzazione, non arrivare dopo. I controlli sullo schema vanno al confine, i controlli di integrità referenziale tra i sistemi, le regole di business come le quantità non negative nella pipeline, e la riconciliazione a livello di riga deve confrontare i totali di controllo di ciascuna fonte. Per un modo strutturato di pensare a questi controlli, la guida di digna alle regole di validazione è pertinente, perché la validazione deve viaggiare con i dati, non aspettare che sia una dashboard a lamentarsi.
Dove collocare la validazione
La validazione alla fine arriva troppo tardi. Quando la dashboard sembra sbagliata, il contesto che spiegherebbe l'errore è già scomparso.
Il pattern più solido è validare a ogni passaggio di consegne, perché ogni passaggio conserva ancora il contesto della fonte, il responsabile e l'aspettativa originale. In questo modo la correzione è più rapida e le discussioni più brevi. Inoltre impedisce ai team di considerare affidabili i dati uniti solo perché sono sopravvissuti a un job di caricamento.
Il monitoraggio come sistema di allerta precoce
Il monitoraggio serve solo se intercetta la causa prima che il report diventi un mistero. Il modo più pulito per farlo è monitorare insieme tempestività, anomalie e modifiche dello schema, non come code separate. Se una fonte arriva in ritardo, la dashboard sta già invecchiando, anche se i numeri sembrano ancora impeccabili.
Il monitoraggio della tempestività è la prima linea di difesa, perché i problemi di freschezza spesso iniziano a monte e si propagano a valle senza una rottura visibile. Se uno SLA slitta, il team deve saperlo prima che gli utenti di business inizino a prendere decisioni su dati obsoleti. Questo conta soprattutto quando una fonte in ritardo può alterare un KPI senza cambiare la forma del grafico.
Il rilevamento delle anomalie copre una classe di errori diversa. Variazioni di volume, spostamenti nelle distribuzioni e picchi nei tassi di valori nulli possono rivelare un filtro rotto, una join mancante o un deployment difettoso a monte molto prima che qualcuno noti un calo dei ricavi. È questo il valore di osservare il comportamento della fonte e non solo il risultato nella dashboard.
Il tracciamento dello schema chiude il cerchio. Aggiunte di colonne, modifiche di tipo e deriva della nullability sono i cambiamenti strutturali silenziosi che interrompono i consumatori a valle dopo che una pipeline sembra "funzionare". Per i sistemi di dati che devono reagire a requisiti di classificazione e protezione in evoluzione, il NIST osserva che il monitoraggio dovrebbe intercettare le modifiche all'asset stesso e attivare controlli aggiornati quando necessario: ecco perché il tracciamento dello schema appartiene al ciclo operativo, non solo alla documentazione.
Una vista di monitoraggio pratica è un'unica dashboard raggruppata per fonte, con riferimenti alla lineage associati a ogni alert. Questo permette a un engineer di reperibilità di risalire da un file in ritardo, un'anomalia di volume o una modifica dello schema fino al sistema di origine senza saltare da uno strumento all'altro. I team migliori smettono di chiedersi "quale report è sbagliato?" e iniziano a chiedersi "quale fonte è cambiata per prima?"
I segnali di monitoraggio e cosa intercettano
Categoria di segnale | Cosa monitora | Errore intercettato in anticipo |
|---|---|---|
Tempestività | Ritardo di arrivo, caricamenti mancanti, arrivi anticipati | Dashboard obsolete e ritardi silenziosi |
Rilevamento delle anomalie | Variazioni di volume, distribuzione e tasso di valori nulli | Filtri rotti, join mancanti, interruzioni a monte |
Tracciamento dello schema | Colonne aggiunte, modifiche di tipo, deriva della nullability | Errori della pipeline dovuti a cambiamenti strutturali |
La differenza tra monitoraggio reattivo e proattivo è una questione di tempistica. I team reattivi vengono a sapere del problema dopo le lamentele degli utenti. I team proattivi intercettano la causa quando è ancora piccola, risparmiando sia fiducia sia tempo di gestione degli incidenti.
Una checklist operativa per il vostro prossimo progetto di integrazione
Iniziate prima di scrivere la prima trasformazione. Catalogate ogni fonte, classificatene la cadenza e individuate il responsabile in grado di rispondere rapidamente a domande su schema e significato. Segnalate presto le collisioni semantiche, soprattutto per campi come cliente, ricavi, paese e prodotto.
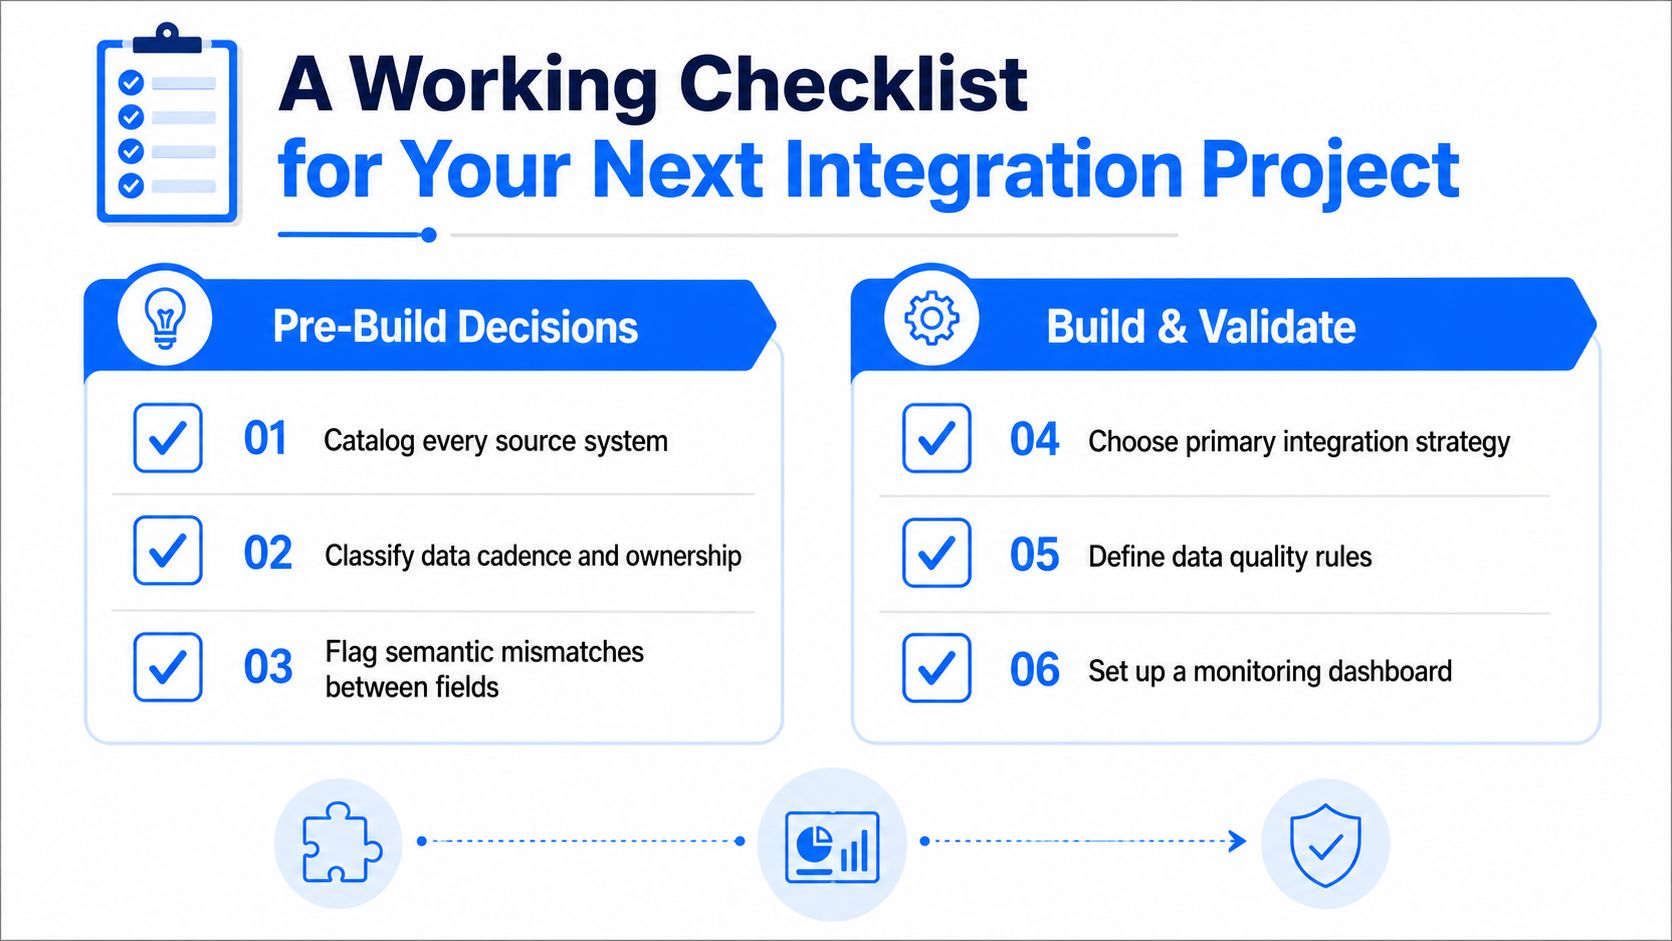
Decisioni preliminari
Catalogate ogni sistema sorgente, per non scoprire un foglio di calcolo nascosto dopo il lancio.
Classificate cadenza e responsabilità, in modo che file in ritardo e passaggi di consegne poco chiari non diventino incidenti a sorpresa.
Segnalate le incongruenze semantiche, in modo che i team non riutilizzino lo stesso nome di campo per significati di business diversi.
Costruire e validare
Scegliete il pattern di integrazione principale, ETL, ELT o CDC, in base al consumatore e al requisito di latenza.
Documentate prima il modello canonico, in modo che le trasformazioni non codifichino definizioni in conflitto.
Impostate soglie di validazione e alert di freschezza, in modo che i caricamenti difettosi falliscano subito invece di finire nella BI.
Aggiungete monitor della schema drift e controlli sul numero di righe, in modo che fonti scomparse e modifiche strutturali emergano prima che se ne accorgano gli utenti.
Se vi serve una sequenza concreta, eseguite un audit delle fonti di un giorno, abbozzate lo schema canonico su una lavagna e collegate un controllo di observability alla pipeline con il traffico più elevato. Basta questo per fermare la prima ondata di errori silenziosi senza aspettare che un comitato approvi l'architettura.
Se il vostro team deve fare i conti con report discordanti, deriva semantica o pipeline che falliscono solo quando la dashboard è già sbagliata, digna vi offre un modo per monitorare tempestività, validazione, modifiche dello schema e anomalie all'interno del vostro ambiente. Visitate digna per vedere come si inserisce in uno stack di integrazione reale e usatelo come punto di partenza per costruire dati di cui i vostri team possano fidarsi.
Domande frequenti
Cosa significa davvero "fonti eterogenee"?
Più di un problema di formato. Il formato è solo il primo livello; sotto ci sono definizioni diverse, cadenze di aggiornamento diverse e idee diverse su quale sistema detenga quale versione della realtà, ed è questo che fa sì che i report non concordino.
Da dove iniziare quando tre report non concordano?
Non dalla riscrittura della dashboard. Iniziate chiedendovi quale campo, regola o timestamp è cambiato per primo, perché la riconciliazione non consiste tanto nel far quadrare i report quanto nel ricostruire quale sistema detiene quale versione della realtà.
Perché gli stack moderni producono questo problema?
Perché sono costruiti su una storia accumulata anziché su un unico diagramma architetturale pulito. Ogni sistema è arrivato per risolvere un problema specifico in un momento specifico, e le sovrapposizioni tra loro sono state raramente progettate in modo deliberato.
A chi viene data di solito la colpa per primo?
Al data warehouse, al livello di BI o all'ultimo job ETL toccato da qualcuno. È un riflesso comprensibile e di solito sbagliato, perché il disaccordo nasce normalmente più a monte, in una definizione, e non nel livello in cui è diventato visibile.
Cosa richiede l'armonizzazione oltre al mapping?
Un accordo sulle responsabilità. Il mapping dei campi tra sistemi gestisce la parte meccanica, mentre decidere quale sistema sia autorevole per ciascun concetto è ciò che impedisce alla stessa discussione di ripresentarsi ogni trimestre.


