10 esempi di policy di data governance
|
12
min di lettura

Un documento di policy può esistere mentre i dati a cui si riferisce restano di fatto privi di governance. I dati delle indagini di settore riportano che solo il 23% delle organizzazioni utilizza framework formali di data governance o di qualità dei dati, mentre il 55% non mantiene in modo continuativo un inventario dei dati sensibili, il 70% non dispone di una strategia unificata che colleghi la visibilità sui dati e sulle identità e solo il 39% è in grado di classificare tutti i propri dati. Questi risultati mostrano perché un elenco di titoli di policy non basta. Una policy utile traduce un principio in un controllo osservabile, assegna una persona che lo gestisca, registra le evidenze e definisce cosa succede quando il controllo fallisce. Risultati delle indagini di settore sull'adozione della data governance
I dieci esempi di policy di data governance riportati di seguito sono scritti come modelli operativi anziché come definizioni statiche. Ognuno collega un obiettivo di controllo al relativo owner, trigger, evidenze, percorso di escalation e risultato misurabile. Gli esempi si applicano ai servizi finanziari, alla sanità, alle telecomunicazioni e alla pubblica amministrazione, ma la stessa logica funziona per dataset critici, reporting regolamentare, pipeline di analytics e sistemi di AI.
Una policy deve inoltre riflettere il contesto giuridico dell'organizzazione. Il Data Governance Act dell'UE è stato adottato dal Parlamento europeo il 6 aprile 2022, è entrato in vigore il 23 giugno 2022 ed è divenuto applicabile il 24 settembre 2023 dopo un periodo transitorio di 15 mesi, creando un quadro giuridico per il riutilizzo dei dati, gli intermediari e l'altruismo dei dati nei mercati dell'UE. Tempistiche e implicazioni del Data Governance Act dell'UE Questa evoluzione illustra la pressione concreta sulle imprese affinché passino dalla progettazione delle policy a controlli applicabili, in particolare quando i dati attraversano più giurisdizioni.
Indice
1. Policy sugli standard di qualità e sulla validazione dei dati
2. Policy sul rilevamento delle anomalie nei dati e sull'apprendimento della baseline
3. Policy sulla tempestività dei dati e sul monitoraggio delle consegne
4. Policy sul rilevamento delle modifiche allo schema e sulla governance strutturale
5. Policy sulla responsabilità di ownership e stewardship dei dati
6. Policy sul monitoraggio delle metriche di business e sull'affidabilità dei KPI
8. Policy sulla governance dell'accesso e della sicurezza dei dati
9. Policy sulla risposta agli incidenti sui dati e sull'escalation
10. Policy sul miglioramento continuo e sulle metriche della data governance
1. Policy sugli standard di qualità e sulla validazione dei dati
Una policy sulla qualità dei dati definisce la condizione minima che un record deve soddisfare prima che i sistemi a valle lo considerino utilizzabile. Il suo obiettivo di controllo è l'idoneità allo scopo, non una perfezione astratta. Un record di transazione potrebbe richiedere un importo valido, una controparte identificabile e i campi regolamentari obbligatori. Un record clinico potrebbe richiedere misurazioni e identificativi internamente coerenti. Un account telecom potrebbe necessitare di attributi di fatturazione e cliente coerenti prima che venga eseguito il reporting dei ricavi.
Il data owner approva il significato di business di ogni regola. Un data steward gestisce il registro delle regole, mentre i data engineer implementano i controlli nella pipeline o nel database pertinente. Il trigger è un caricamento pianificato, un evento di ingestion o un passaggio di consegne in un processo di business. Le evidenze dovrebbero includere la definizione della regola, la motivazione di business, il timestamp di esecuzione, i record interessati, i risultati superati e falliti, lo stato della remediation e lo storico delle approvazioni.
Regola pratica: una regola di validazione è governabile solo quando qualcuno è in grado di spiegare perché esiste, cosa verifica e chi interviene quando fallisce.
La validazione deterministica è diversa dal monitoraggio comportamentale. Una regola come “l'importo della transazione deve essere presente e numerico” produce un risultato ripetibile. Un monitor di anomalie, invece, valuta se il comportamento si è discostato da un pattern atteso. Entrambi rientrano in un programma di qualità, ma rispondono a domande diverse.
Come implementarla
Iniziate dai dataset che comportano il maggiore rischio di business, regolamentare od operativo. Chiedete a data engineer, analisti e stakeholder di business di definire insieme le regole, quindi documentatene la motivazione affinché chi le manterrà in futuro comprenda il controllo previsto.
Owner: un data owner di business approva soglie ed eccezioni.
Trigger: ogni caricamento rilevante o evento di elaborazione a livello di record.
Evidenze: versioni delle regole, log di esecuzione, record falliti, note di remediation e approvazione finale.
Escalation: lo steward indaga per primo, poi inoltra i problemi irrisolti all'owner e ai consumer interessati.
Risultato: i dataset critici hanno una copertura di validazione visibile e una risposta documentata ai fallimenti.
I team possono utilizzare gli standard di qualità dei dati di digna e il suo modulo di validazione a livello di record per applicare controlli di business deterministici senza dipendere da revisioni manuali. Le regole dovrebbero essere riesaminate ogni trimestre o ogni semestre, soprattutto dopo modifiche a prodotti, obblighi di reporting o sistemi sorgente. Per un ulteriore approfondimento, consultate la guida di AutoProv agli standard di qualità dei dati.
2. Policy sul rilevamento delle anomalie nei dati e sull'apprendimento della baseline
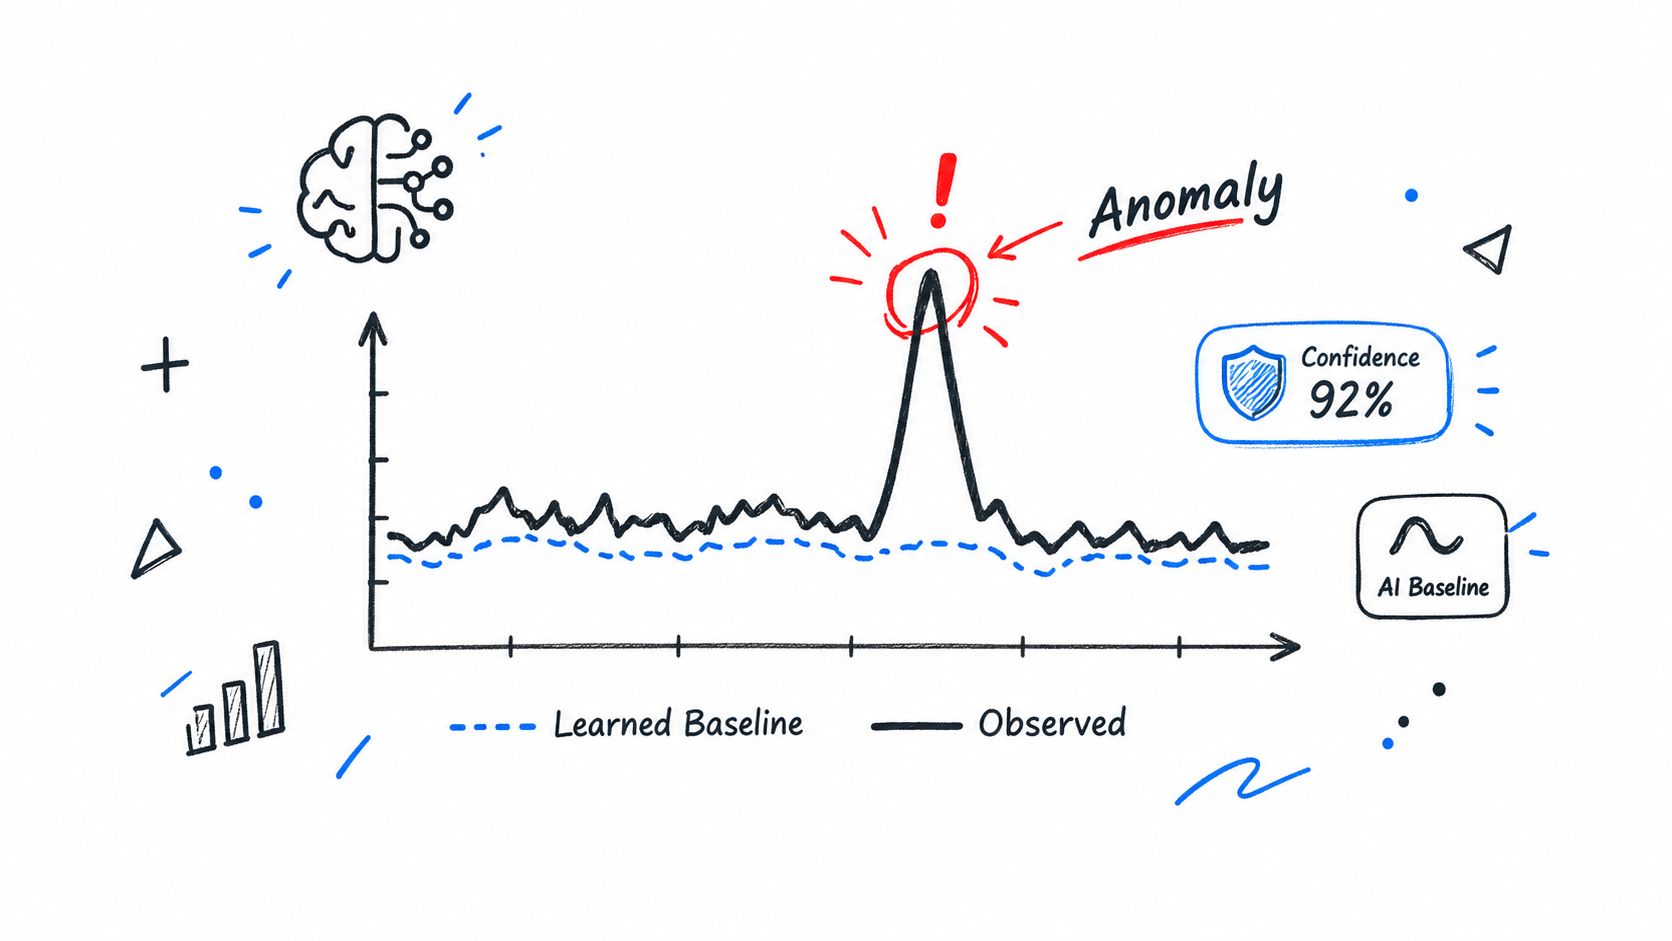
Un dataset può soddisfare tutte le regole di validazione statiche e diventare comunque inaffidabile quando il suo comportamento cambia. Una policy di rilevamento delle anomalie controlla questo divario definendo quali pattern monitorare, come viene appreso il comportamento normale, chi indaga sulle deviazioni e quali evidenze supportano la decisione finale.
Il responsabile del monitoraggio seleziona il dataset, il contesto di business e le dimensioni monitorate. Un data scientist o un platform engineer configura l'apprendimento della baseline. Il data steward registra le anomalie confermate, le cause e gli esiti. I trigger possono includere variazioni di volume, distribuzione, frequenza o di un altro comportamento definito.
Il controllo deve distinguere un segnale statistico da un incidente confermato. I team dei servizi finanziari possono indagare su volumi di trading insoliti o su pattern legati alle frodi. I team sanitari potrebbero esaminare variazioni inattese nei ricoveri o nelle distribuzioni delle misurazioni cliniche. Gli enti pubblici potrebbero analizzare distribuzioni anomale di prestazioni o dell'attività di presentazione delle pratiche. Questi casi richiedono contesto prima che un alert diventi un incidente operativo.
Il monitoraggio comportamentale individua la deviazione. La revisione umana stabilisce se la deviazione è un difetto, un evento di business legittimo o un rischio emergente.
Controlli per il monitoraggio comportamentale
Lasciate che il modello apprenda il comportamento storico prima che gli alert diventino operativi. Il disegno di implementazione prevede un periodo di apprendimento da 2 a 4 settimane, che consente ai cicli ordinari e ai pattern ricorrenti di dare forma alla baseline. Questa durata appartiene al disegno di implementazione di questa policy, non è un benchmark generale di settore.
Owner: il responsabile del monitoraggio assegna la responsabilità del triage e lo SLA di risposta.
Trigger: una deviazione definita in volume, distribuzione, frequenza o in un'altra dimensione monitorata.
Evidenze: conservate il periodo di baseline, la finestra di confronto, i dettagli dell'alert, la gravità, le note di indagine, la causa principale, l'esito e la remediation.
Ciclo di apprendimento: registrate le anomalie confermate e i falsi positivi, così da poter calibrare il modello e le soglie.
Escalation: inoltrate le anomalie ad alto impatto o irrisolte al data owner e al processo di risposta agli incidenti.
Risultato: gli analisti possono distinguere la variazione attesa dai difetti dei dati, aumentando la fiducia nel reporting e negli input dell'AI.
I team possono utilizzare il rilevamento delle anomalie nei dati di digna per i workflow Python a supporto dell'apprendimento della baseline e del monitoraggio continuo. La sua funzionalità di analytics aiuta inoltre a esaminare i pattern storici delle anomalie, invece di trattare ogni alert come un evento isolato.
L'implementazione dovrebbe procedere in sequenza: selezionare i dataset ad alto rischio, definire il comportamento monitorato, stabilire il periodo di apprendimento, testare la gravità degli alert, assegnare la responsabilità del triage e quindi riesaminare i casi confermati. La policy dovrebbe essere rivista quando cambiano i processi di business o il comportamento dei dati.
3. Policy sulla tempestività dei dati e sul monitoraggio delle consegne
Un dataset tempestivo è una dipendenza operativa, non semplicemente un attributo di qualità. Un feed può contenere valori accurati e mancare comunque la finestra decisionale per il regolamento di fine giornata, l'emissione delle fatture, le attività cliniche in giornata o il reporting regolamentare. La policy dovrebbe convertire il concetto di “abbastanza aggiornato” in un'aspettativa di consegna concordata, un trigger osservabile e una risposta definita.
Partite dall'esigenza del consumer. Gli stakeholder di finanza, operations, reporting e area clinica possono utilizzare la stessa tabella in momenti diversi della giornata, quindi il producer dei dati è responsabile dell'esecuzione della consegna, mentre il consumer definisce la finestra richiesta. Il team di piattaforma indaga sui guasti di orchestrazione, infrastruttura e dipendenze.
Registrate il consumer, il caso d'uso, la finestra di consegna accettata e le conseguenze di un ritardo. Un trigger valido può essere un arrivo mancato, un caricamento anticipato che viola le ipotesi a valle o una consegna al di fuori della finestra di servizio concordata. Il pacchetto di evidenze dovrebbe conservare gli orari di arrivo attesi ed effettivi, lo storico delle consegne, lo stato della pipeline, le informazioni sulle dipendenze, i registri degli incidenti e la decisione sull'eventuale violazione dello SLA.
Rendere osservabili le aspettative di consegna
Le pianificazioni apprese dall'AI possono individuare il comportamento normale delle consegne senza che gli ingegneri debbano mantenere fragili finestre temporali manuali. La guida di digna alle definizioni e alle metriche della tempestività dei dati spiega come monitorare arrivi mancanti, in ritardo e anticipati e come calcolare l'orario di consegna previsto.
Implementate il controllo in sequenza:
Definite la scadenza del consumer e le conseguenze di un ritardo.
Stabilite il comportamento di consegna atteso sulla base dello storico osservato.
Impostate un alert quando l'arrivo previsto trascorre senza i dati attesi o quando il comportamento di consegna cambia.
Designate il producer come primo punto di escalation.
Inoltrate le minacce alle scadenze al platform owner e al consumer di business.
Conservate l'orario atteso, l'orario effettivo, la durata del ritardo, lo stato delle dipendenze e la risposta dell'owner.
Il risultato è la chiarezza diagnostica. I team possono distinguere una sorgente in ritardo da una pipeline fallita o da un problema dell'infrastruttura a valle, invece di trattare ogni consegna mancata come lo stesso incidente.
Riesaminate mensilmente le tendenze della tempestività. Un ritardo ricorrente può indicare un problema di processo, mentre un feed affidabile potrebbe non soddisfare più le esigenze di un nuovo consumer. Queste evidenze dovrebbero aggiornare la finestra di consegna, la ownership o la regola di escalation.
4. Policy sul rilevamento delle modifiche allo schema e sulla governance strutturale
Una modifica allo schema può invalidare output affidabili prima che un controllo a livello di valore rilevi qualcosa. La rimozione di una colonna, la modifica di un tipo di dato o l'alterazione di un vincolo possono compromettere un report, un modello o una trasformazione già in fase di ingestion. Questa policy governa quindi la visibilità e l'impatto delle modifiche strutturali, con un confronto deterministico rispetto a una baseline di schema approvata.
Il controllo parte da uno schema registrato e da uno schema owner designato. Il rilevamento automatico confronta ogni versione distribuita con tale baseline e registra aggiunte, rimozioni, modifiche di tipo e modifiche ai vincoli. Il trigger è qualsiasi deviazione strutturale non approvata. Un revisore delle modifiche valuta i consumer interessati, mentre i platform engineer gestiscono deployment, notifiche e rollback.
Le evidenze devono rendere la decisione verificabile:
Schema prima e dopo la modifica e timestamp del rilevamento.
Richiesta di modifica, motivazione e livello di rischio.
Valutazione d'impatto e lineage interessata.
Approvazione, esito del deployment e decisione sul rollback.
Un istituto finanziario potrebbe rilevare la rimozione di un campo utilizzato nei calcoli regolamentari. Un'organizzazione sanitaria potrebbe intercettare una modifica di tipo in una misurazione clinica prima che raggiunga i sistemi di supporto decisionale. Un ente pubblico potrebbe dover allineare i sistemi di audit quando un dataset governativo cambia struttura. In ciascun caso, il risultato misurabile è un rilevamento più precoce e un minor numero di guasti silenziosi nel reporting, nelle analytics o nelle pipeline di AI.
Trasformare il rilevamento in una revisione proporzionata
I consumer a valle noti dovrebbero ricevere un preavviso prima che si verifichi un impatto in produzione. Questo requisito dipende da una lineage aggiornata, quindi la policy dovrebbe verificare che la mappa d'impatto sia completa prima dell'approvazione. Un comitato di revisione può approvare, respingere o rinviare una modifica, mentre i livelli di rischio evitano che le evoluzioni a basso impatto creino un collo di bottiglia manuale.
Owner: owner del dataset o del dominio.
Trigger: deviazione strutturale rispetto allo schema registrato.
Evidenze: diff dello schema, motivazione, approvazioni, mappa d'impatto e registro del deployment.
Escalation: inviate le modifiche non approvate o ad alto impatto al comitato di revisione e al processo di gestione degli incidenti.
Risultato: i consumer ricevono un preavviso utilizzabile prima che la deriva strutturale diventi un guasto silenzioso.
La spiegazione di digna sullo schema drift e sulle modifiche strutturali descrive il monitoraggio strutturale continuo per questo controllo. Il suo Schema Tracker stabilisce una baseline per aggiunte, rimozioni e modifiche dei tipi di dato, aiutando i team a bloccare o revisionare le modifiche prima che raggiungano i consumer.

5. Policy sulla responsabilità di ownership e stewardship dei dati
La ownership è un controllo operativo, non un'etichetta in un catalogo. La policy assegna la responsabilità di qualità dei dati, tempestività, aspettative di accesso, definizioni e risoluzione dei problemi per tutti i dataset critici. Deve inoltre indicare chi può decidere, chi svolge il lavoro e quali evidenze dimostrano che tale responsabilità è effettivamente esercitata.
Il data owner accetta il rischio di business e approva definizioni, aspettative di qualità ed eccezioni. Il data steward converte tali decisioni in metadati, regole, monitoraggio e gestione dei problemi. I producer restano responsabili della creazione e della consegna dei dati. I platform engineer mantengono i controlli tecnici, mentre i consumer segnalano i difetti che incidono su analytics, reporting o utilizzo dell'AI.
Un nuovo dataset critico, un cambio sostanziale di ownership o un problema di governance irrisolto avviano una revisione. L'owner conferma perimetro e rischio, lo steward registra le regole operative e i team interessati ricevono un percorso di escalation. Le controversie tra domini vengono sottoposte al decisore designato, invece di restare in una coda non assegnata.
Rendere la responsabilità verificabile
Un registro della ownership dovrebbe collegare ogni dataset critico al relativo owner, steward, producer, consumer, livello di sensibilità, diritti decisionali e percorso di escalation. Conservatelo in un luogo in cui chi indaga sugli incidenti, i team di engineering, analytics e business possano accedere allo stesso registro.
Evidenze di controllo: definizioni approvate, aspettative di qualità, regole di accesso, decisioni sulle eccezioni e cambi di ownership.
Evidenze operative: azioni degli steward, problemi assegnati, note di remediation, verbali di revisione e voci aggiornate del registro.
Evidenze di escalation: impegni di risposta non rispettati, conflitti irrisolti, accettazione del rischio e decisioni del management.
Misura del risultato: ogni dataset importante ha una persona responsabile in grado di spiegarne il significato, l'uso accettabile e la risposta da dare quando i controlli falliscono.
Questa definizione di data steward distingue la responsabilità di business dal coordinamento operativo. Riunioni di stewardship settimanali o quindicinali, ove opportuno, possono esaminare incidenti, azioni scadute e pattern di qualità ricorrenti. La riunione è utile solo quando i partecipanti lavorano su evidenze condivise e registrano decisioni, owner e scadenze. Questo registro collega l'attività di governance a reporting, analytics e output di AI più affidabili.
6. Policy sul monitoraggio delle metriche di business e sull'affidabilità dei KPI
L'affidabilità dei KPI è un controllo operativo, non una funzionalità di dashboard. Protegge la pianificazione, il reporting e le comunicazioni agli azionisti rilevando quando una metrica di business si muove in modo inatteso e verificando se la causa sia un'attività di business o un guasto dei dati.
Il metric owner, solitamente un leader di business, approva la definizione, l'interpretazione e l'uso accettabile di ciascun KPI. L'analytics engineering mantiene il calcolo e le dipendenze. Un data steward coordina l'indagine quando cambiano i dati sorgente o le regole di business. Il trigger può essere un movimento insolito di ricavi, attività dei clienti, volumi, rischio di portafoglio, churn, esiti dei trattamenti o performance operative.
Ogni registro di KPI dovrebbe includere la definizione approvata, i dati sorgente, la logica di calcolo, l'owner, il contesto di revisione e i fattori stagionali od operativi noti. I team dei servizi finanziari possono monitorare ricavi netti, costo di acquisizione e rischio di portafoglio. I team sanitari possono tenere traccia di ricoveri, esiti ed efficienza operativa. I team telecom possono osservare churn, ricavo medio per utente e disponibilità della rete.
Un alert su un KPI richiede evidenze prima dell'escalation. Una variazione significativa può derivare da un caricamento in ritardo, da una modifica allo schema, da un filtro modificato, da un aggiornamento della definizione o da un reale evento di business. Collegate il monitoraggio ai controlli di qualità, tempestività, anomalie e schema descritti altrove nel programma di governance.
Iniziate con le 3-5 metriche di business più critiche, come previsto dall'approccio di implementazione. Ampliate la copertura solo quando gli owner sono in grado di indagare e rispondere in modo coerente. La sequenza operativa è:
Verifica della definizione: confermate che la definizione e il calcolo approvati siano rimasti invariati.
Verifica dei dati: esaminate le evidenze su aggiornamento, volume, completezza e struttura.
Verifica di business: registrate un evento o una condizione operativa che spieghi il movimento.
Verifica dell'escalation: stabilite se il KPI incide su un report formale, su una decisione di business o su una comunicazione esterna.
L'owner registra l'alert, le evidenze esaminate, la conclusione, l'azione e la scadenza. I problemi irrisolti passano allo steward, al decisore di business o all'autorità di reporting in base all'impatto. Il risultato misurabile è un KPI che può essere riprodotto, spiegato e considerato affidabile da analisti, dirigenti e sistemi di AI.
La soluzione Business Monitoring di digna può esaminare variazioni insolite di ricavi, volumi, attività dei clienti e metriche operative. Le revisioni mensili con la leadership di business verificano se gli alert rappresentano ancora un rischio di business significativo e se le soglie richiedono un aggiustamento.
7. Policy sulla data lineage e sull'analisi d'impatto
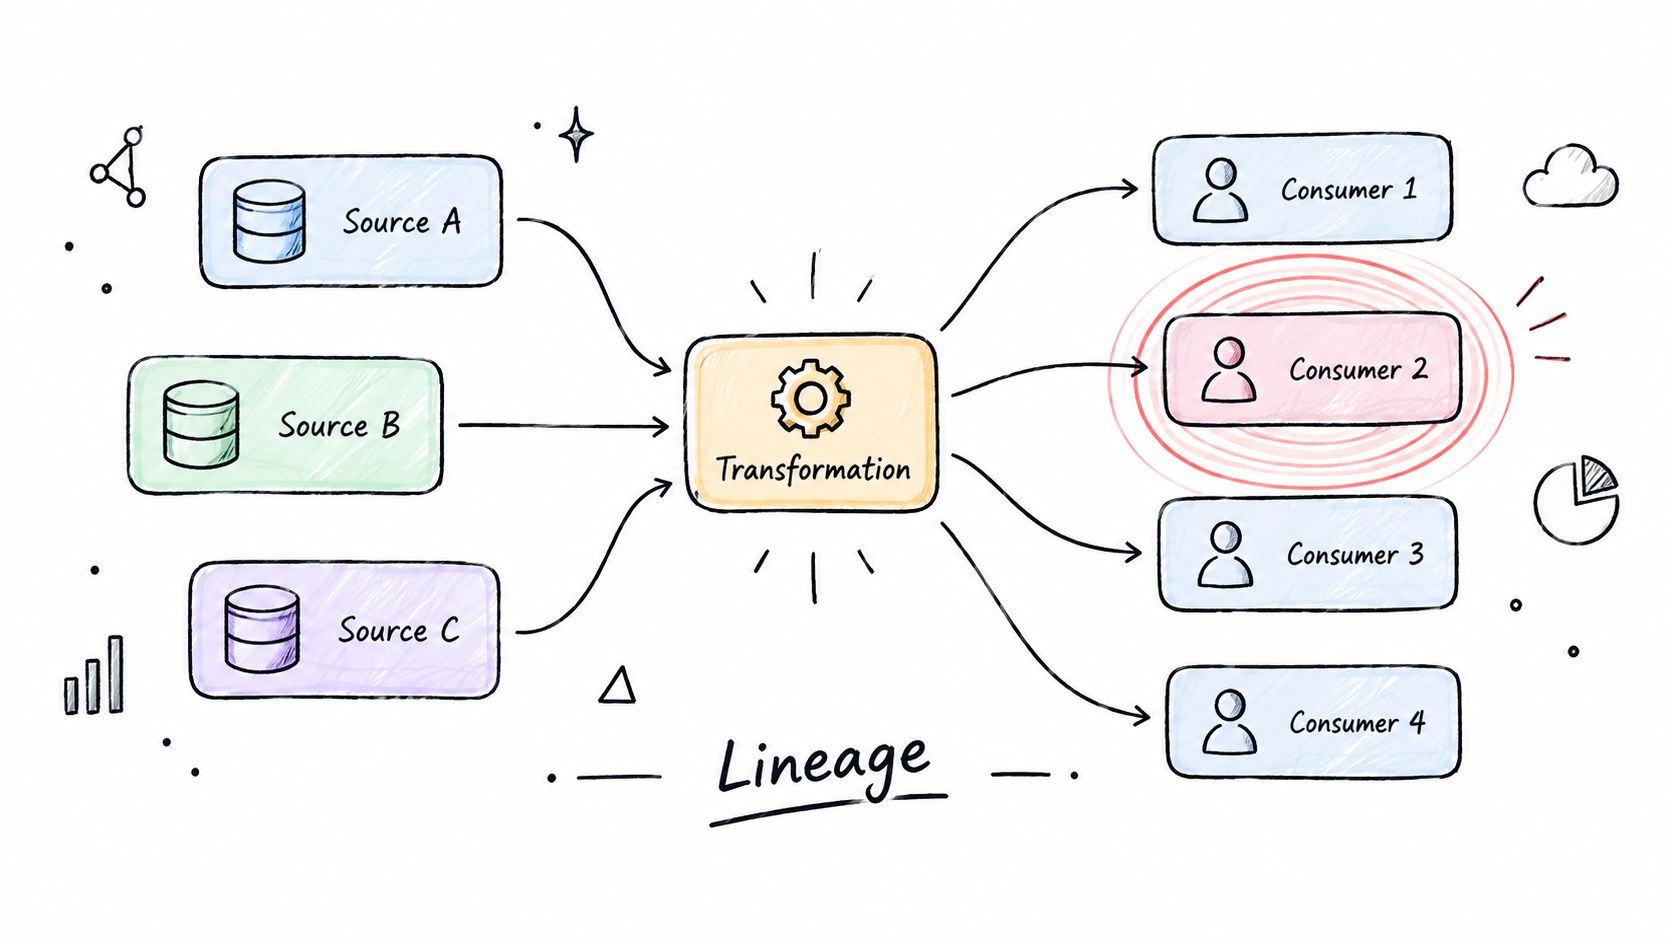
La lineage trasforma una dipendenza dei dati in un controllo operativo. Collega un numero riportato o un input di un modello alla sua sorgente, alle trasformazioni, alle destinazioni e ai consumer. L'obiettivo della policy è stabilire il perimetro interessato prima che un difetto, una modifica strutturale o un rilievo di audit avvii la remediation.
Il data owner classifica gli asset critici e ne approva l'uso di business. I data engineer acquisiscono le dipendenze di pipeline e trasformazioni, mentre gli steward verificano che le relazioni tecniche riflettano il significato di business. Un nuovo flusso critico, una modifica sostanziale alla pipeline, un incidente di qualità, il deployment di un modello o una richiesta di audit avviano il controllo.
Le evidenze dovrebbero includere gli asset di origine e di destinazione, la logica di trasformazione, le relazioni di dipendenza, una mappa di lineage versionata, la data di revisione e i consumer interessati. La sequenza operativa è:
Registrate il flusso e il relativo owner.
Acquisite le dipendenze tecniche e le versioni delle trasformazioni.
Confermate le definizioni di business e i consumer critici.
Valutate l'impatto quando cambia una sorgente, una regola o una destinazione.
Segnalate le relazioni mancanti o ambigue al data owner e al platform architect.
Una banca può utilizzare questo registro per individuare i modelli di rischio interessati da un feed interrotto. Un'organizzazione sanitaria può mappare i flussi di dati clinici a fini di audit e compliance, mentre un ente pubblico può mostrare come i dati sorgente raggiungono i sistemi di reporting. Per i sistemi di AI, la lineage fornisce le evidenze di quali input un modello ha utilizzato e di come tali input sono cambiati.
La lineage è un controllo strutturale, non un diagramma statico.
I diagrammi manuali diventano obsoleti man mano che i sistemi evolvono. L'acquisizione automatica dagli strumenti di pipeline offre una base operativa più solida, ma uno steward deve comunque verificare che le dipendenze siano complete e che i consumer ad alto impatto siano rappresentati. Il risultato misurabile è un'analisi d'impatto più rapida e basata su evidenze, con una remediation prioritizzata in base a report, modelli e decisioni interessati anziché su ricerche manuali.
digna include un data catalog che può supportare la documentazione della lineage e una comprensione condivisa. Un audit trail visivo può inoltre mostrare cosa è successo e quando, un requisito di evidenza rilevante per i software di audit trail per la compliance delle flotte nel Regno Unito.
8. Policy sulla governance dell'accesso e della sicurezza dei dati
La governance degli accessi è un controllo operativo, non un elenco di autorizzazioni. Specifica chi può visualizzare o modificare ciascun dominio di dati, quale finalità di business giustifica tale accesso, come vengono concesse o revocate le autorizzazioni e quali evidenze supportano la decisione. L'obiettivo di controllo è l'uso autorizzato dei dati sensibili e critici. Regole restrittive possono ritardare analisi legittime, mentre una revisione debole aumenta l'esposizione e rende difficile stabilire le responsabilità.
Il data owner definisce le regole di accesso al dominio e approva le eccezioni. I team di identity and access management assegnano le autorizzazioni, i team di sicurezza gestiscono autenticazione e logging e gli steward verificano che gli accessi corrispondano ancora alle responsabilità attuali. Una richiesta, un cambio di ruolo, un trasferimento, una cessazione, un'escalation di privilegi o una ricertificazione pianificata avviano il workflow.
Un registro difendibile collega la richiesta al suo approvatore, alla mappatura dei ruoli, allo stato delle autorizzazioni, ai timestamp di concessione e revoca, agli eventi di accesso, alla motivazione delle eccezioni e all'esito della revisione. I conflitti irrisolti vengono sottoposti al team di sicurezza e all'owner responsabile, con accesso sospeso o limitato ove la policy lo richieda.
Anche la limitazione della finalità influenza il controllo. Le linee guida sul GDPR dell'UE stabiliscono che i dati personali devono essere raccolti per finalità determinate, esplicite e legittime e non riutilizzati in modo incompatibile. Linee guida della Commissione europea sui principi del GDPR Un utente può quindi ricevere l'accesso per un'attività operativa definita senza l'autorizzazione a riutilizzare gli stessi dati per analisi, reporting o sviluppo di AI non correlati.
Integrare la traccia delle revisioni nell'implementazione
Utilizzate un accesso basato sui ruoli legato alle responsabilità lavorative anziché all'appartenenza informale a un team. Collegate la policy ai sistemi di identità ove possibile, quindi eseguite revisioni trimestrali degli accessi affinché gli owner possano rimuovere le autorizzazioni che non hanno più una finalità documentata.
Owner: data owner di business.
Trigger: richiesta, cambio di ruolo, uscita dall'organizzazione, modifica dei privilegi o revisione trimestrale.
Evidenze: workflow di approvazione, stato delle autorizzazioni, evento di accesso, revoca ed eccezione.
Escalation: team di sicurezza e owner responsabile per i conflitti irrisolti.
Risultato: l'accesso resta autorizzato, spiegabile, verificabile e reversibile.
L'esecuzione in-database di digna e le opzioni di deployment in private cloud oppure on-premises possono supportare i controlli mentre i dati restano all'interno dell'ambiente del cliente. La tecnologia registra e applica le decisioni, ma è l'organizzazione a dover stabilire chi necessita dell'accesso, perché è necessario e quando deve terminare.
9. Policy sulla risposta agli incidenti sui dati e sull'escalation
Gli incidenti sui dati richiedono un controllo operativo, non soltanto un ticket. La policy dovrebbe coprire fallimenti di qualità, consegne in ritardo o mancanti, modifiche allo schema, KPI inaffidabili e problemi di accesso. Il suo obiettivo è rilevare il problema, limitarne l'effetto su analytics, reporting o workflow di AI, documentare le decisioni e prevenirne il ripetersi.
L'incident owner dirige la risposta. L'owner del dataset valuta l'impatto di business e approva una remediation accettabile. I platform engineer esaminano le cause tecniche, gli steward mantengono il registro e i consumer interessati ricevono aggiornamenti. I trigger includono validazioni fallite, alert di anomalia, consegne mancate, modifiche strutturali non autorizzate o una metrica di business inspiegata.
La gravità determina il percorso di risposta. Un incidente che interessa il reporting regolamentare, le operazioni di trading o la sicurezza dei pazienti giustifica un'escalation più rapida e una comunicazione più chiara verso gli stakeholder rispetto a un problema a basso impatto su un dataset interno.
Rendere la risoluzione verificabile
Il registro dovrebbe conservare l'alert, la notifica, l'indagine, la causa principale, l'azione correttiva, l'approvazione del ripristino e la revisione post-incidente. Queste evidenze distinguono un guasto della sorgente effettivamente corretto da una soluzione temporanea.
Rilevamento: acquisite il segnale, il timestamp, il dataset interessato e il perimetro iniziale.
Notifica: contattate l'owner, lo steward, i consumer e i responsabili reperibili.
Indagine: stabilite impatto, causa, dipendenze e contenimento.
Risoluzione: correggete, eseguite il rollback, mettete in quarantena oppure comunicate la limitazione dei dati.
Prevenzione: assegnate le attività di follow-up e verificate che il controllo sia stato modificato.
L'escalation dovrebbe essere attivata dall'impatto di business, non solo dal volume degli alert.
L'owner chiude l'incidente solo dopo che le evidenze supportano il ripristino dell'utilizzo o una limitazione esplicita. Una knowledge base consultabile dovrebbe conservare cause principali, decisioni ed eccezioni. Le revisioni post-incidente mensili possono individuare debolezze ricorrenti di processo o di piattaforma che i singoli ticket nascondono.
Gli alert di digna e la sua dashboard incentrata sull'utente possono offrire a ingegneri, analisti e stakeholder una visione condivisa di incidenti e tendenze. La sequenza di implementazione prevede di definire i criteri di gravità, collegare i segnali di rilevamento, assegnare i ruoli di risposta, richiedere evidenze alla chiusura e quindi riesaminare le cause ricorrenti. Il risultato misurabile è uno storico delle risposte che supporta un reporting affidabile e un uso più sicuro dell'AI a valle.

10. Policy sul miglioramento continuo e sulle metriche della data governance
La governance ha bisogno di proprie metriche operative. Una policy di miglioramento continuo definisce come l'organizzazione misura la copertura dei controlli, riesamina le performance, assegna priorità alle lacune e modifica le policy quando cambiano le condizioni di business o regolamentari. Evita che la governance diventi un esercizio di revisione documentale scollegato dal comportamento effettivo dei dati.
Il comitato di governance stabilisce il framework di misurazione. Gli owner di dominio interpretano i risultati, gli steward coordinano la remediation e i team di piattaforma forniscono le evidenze di esecuzione. Il trigger è una revisione di governance pianificata, un incidente rilevante, un nuovo workflow regolamentato o un cambiamento significativo nel patrimonio di dati.
Tra le misure utili:
Copertura della classificazione: la quota di asset di dati a cui è assegnata una classificazione.
Copertura della ownership: la quota di dataset critici con owner designati.
Copertura della lineage: la quota di elementi di dati critici con lineage documentata.
Reattività sugli accessi: la quota di richieste di accesso approvate entro lo SLA concordato.
Completamento delle ricertificazioni: la quota di revisioni trimestrali degli accessi completate nei tempi previsti.
Queste misure provengono da una guida di implementazione che raccomanda di monitorare la copertura operativa anziché affidarsi ai soli documenti di policy. La stessa guida riporta un tempo medio di approvazione degli accessi sceso a 1,3 giorni rispetto ai 5,2 giorni precedenti alla policy, con i controlli di qualità pianificati che raggiungono il 97% di esecuzione e la conformità alla conservazione dei dati che raggiunge l'88%. Metriche di implementazione per i controlli delle policy di data governance
Usare i benchmark senza delegare il giudizio
Il lavoro di UNSC/Global Data Governance Mapping ha creato un framework di 26 indicatori distribuiti su sei attributi di governance per confrontare l'implementazione della governance tra organizzazioni e giurisdizioni. Framework Global Data Governance Mapping Un benchmark può evidenziare la mancanza di controlli su ownership, metadati, accessi, lineage o gestione dei problemi, ma non può stabilire quale rischio conti di più per una specifica azienda.
Selezionate 5-7 metriche chiave collegate al valore di business, riesaminatele ogni trimestre e pubblicate le attività di miglioramento in modo trasparente. Il modulo Data Analytics di digna può supportare l'analisi storica delle metriche di observability, mentre le risorse sugli strumenti per un deployment dell'AI sicuro e verificabile offrono una prospettiva pertinente sui requisiti di evidenza negli ambienti ad alta intensità di AI.
Confronto tra 10 policy di data governance
Policy | 🔄 Complessità di implementazione | ⚡ Risorse necessarie | 📊 Risultati attesi | Casi d'uso ideali | ⭐ Vantaggi principali |
|---|---|---|---|---|---|
Policy sugli standard di qualità e sulla validazione dei dati | Alta, ampia definizione delle regole e governance | Media–Alta, data engineer, esperti di dominio, strumenti di validazione | Idoneità dei dati costante, audit trail, meno errori a valle | Settori regolamentati, pipeline di ML, reporting aziendale | Previene i dati errati, garantisce coerenza, supporta la compliance |
Policy sul rilevamento delle anomalie nei dati e sull'apprendimento della baseline | Media, configurazione dei modelli e pipeline di monitoraggio | Media, dati storici, risorse di ML/observability | Rilevamento precoce delle variazioni dei dati, alert adattivi, monitoraggio scalabile | Rilevamento delle frodi, serie temporali ad alto volume, metriche operative | Rileva automaticamente problemi nuovi, riduce la calibrazione manuale, scala facilmente |
Policy sulla tempestività dei dati e sul monitoraggio delle consegne | Media, definizione degli SLA e apprendimento delle pianificazioni | Media, strumentazione delle pipeline, observability | Maggiore puntualità delle consegne, conformità agli SLA, meno ritardi a valle | Fatturazione, scadenze regolamentari, pipeline sensibili ai tempi | Alert proattivi sui ritardi, evidenze sugli SLA, insight sull'affidabilità delle pipeline |
Policy sul rilevamento delle modifiche allo schema e sulla governance strutturale | Media–Alta, monitoraggio strutturale continuo e analisi d'impatto | Media, mappatura della lineage, mappatura dei consumer a valle | Rilevamento rapido delle modifiche bloccanti, meno guasti a valle | Schemi in evoluzione, piattaforme dati multi-team, validazione dei contratti | Previene i guasti silenziosi, consente rollback coordinati, audit trail |
Policy sulla responsabilità di ownership e stewardship dei dati | Media, definizione dei ruoli e processi organizzativi | Media, steward designati, cadenza di governance, dashboard | Responsabilità chiare, indagini più rapide, ownership duratura | Grandi organizzazioni, ambienti regolamentati, team dati distribuiti | Accelera la risoluzione, chiarisce le responsabilità, preserva la conoscenza |
Policy sul monitoraggio delle metriche di business e sull'affidabilità dei KPI | Media, definizione delle metriche e integrazione con la BI | Media, stakeholder di business, analisti, strumenti di BI | KPI affidabili, alert precoci sull'impatto di business, fiducia nelle decisioni | Reporting per il management, metriche di prodotto/finanza, KPI per gli investitori | Previene decisioni sbagliate, collega le metriche alle cause principali, supporta la strategia |
Policy sulla data lineage e sull'analisi d'impatto | Alta, acquisizione e manutenzione della lineage end-to-end | Alta, strumenti di catalogazione, automazione, impegno di integrazione | Valutazioni rapide del raggio d'impatto, indagini più brevi, evidenze di governance | Pipeline complesse, audit, dipendenze tra più sistemi | Consente analisi d'impatto rapide, riduce i tempi di triage, supporta la compliance |
Policy sulla governance dell'accesso e della sicurezza dei dati | Media, integrazione di RBAC e IAM | Media, IAM, logging, processi di revisione degli accessi | Accesso controllato, log pronti per l'audit, minore rischio interno | Dati sensibili/regolamentati (PII, PHI, finanziari) | Protegge i dati sensibili, garantisce la verificabilità, applica il privilegio minimo |
Policy sulla risposta agli incidenti sui dati e sull'escalation | Media, playbook per gli incidenti, SLA e configurazione della reperibilità | Media–Alta, team reperibili, strumenti per gli incidenti, processi di postmortem | MTTD/MTTR ridotti, remediation documentata, apprendimento continuo | Servizi dati mission-critical, pipeline di reporting regolamentare | Risposta strutturata, risoluzione più rapida, apprendimento organizzativo |
Policy sul miglioramento continuo e sulle metriche della data governance | Media, selezione delle metriche e processi di maturità | Media, analytics, revisioni con gli stakeholder, metriche storiche | Progressi di governance misurati, roadmap di miglioramento prioritizzata | Organizzazioni che stanno maturando la governance, necessità di giustificare il ROI | Fornisce evidenze dell'impatto, favorisce l'ottimizzazione continua, allinea gli stakeholder |
Trasformare il testo delle policy in controlli operativi
I programmi di governance più solidi non iniziano scrivendo tutte le policy possibili. Iniziano da un piccolo insieme di dataset ad alto rischio e rendono visibile la responsabilità. Questo approccio affronta anche un problema centrale dell'implementazione: in molte organizzazioni la governance formale resta incompleta, quindi una documentazione ampia può creare un'apparenza di maturità senza garantire una reale copertura dei controlli.
Iniziate selezionando i dataset che supportano il reporting regolamentare, le decisioni finanziarie rilevanti, le attività cliniche, la fatturazione ai clienti o i workflow di AI e analytics. Assegnate un owner di business e uno steward operativo prima di definire controlli dettagliati. L'owner dovrebbe stabilire cosa significa “idoneo all'uso”, quali consumer contano e quale livello di rischio l'organizzazione accetta. Lo steward dovrebbe mantenere regole, evidenze, registri dei problemi e attività di escalation.
Definite poi le evidenze di qualità e di consegna. Una policy di qualità dovrebbe produrre risultati di validazione, dettagli sui record falliti e lo storico della remediation. Una policy di tempestività dovrebbe mostrare il comportamento di consegna atteso ed effettivo, non semplicemente se una pipeline è stata completata. Questi controlli funzionano insieme, perché una pipeline completata con successo può comunque consegnare dati incompleti o in ritardo, mentre un caricamento puntuale può contenere record non validi.
Aggiungete successivamente i controlli sugli accessi e quelli strutturali. La governance degli accessi dovrebbe collegare finalità, ruolo, approvazione, assegnazione, revoca ed evidenze di revisione. Il principio di minimizzazione dei dati del GDPR richiede che i dati personali siano adeguati, pertinenti e limitati a quanto necessario rispetto alla finalità del trattamento. Linee guida dell'ICO britannico sulla minimizzazione dei dati Questo principio fornisce un limite concreto alle decisioni su accesso e raccolta. Anche le policy di conservazione necessitano di una base difendibile. Il NIST SP 800-63B stabilisce che i cloud service provider devono rispettare i requisiti di conservazione dei registri applicabili e, laddove la conservazione non sia obbligatoria, adottare un processo di gestione del rischio che tenga conto dei rischi per la privacy e la sicurezza e informi l'abbonato della policy di conservazione. Linee guida del NIST SP 800-63B sulla conservazione dei registri
La governance diventa credibile quando ogni requisito importante produce evidenze che una persona designata è in grado di interpretare e su cui può agire.
Collegate gli incidenti ai percorsi di escalation invece di inviare gli alert in una coda senza responsabile. Definite gravità, responsabilità di reperibilità, destinatari delle comunicazioni, opzioni di contenimento, aspettative sull'analisi della causa principale e revisione post-incidente. L'owner dovrebbe poter approvare una risposta di business, mentre ingegneri e steward forniscono le evidenze tecniche e operative necessarie a supportarla.
Infine, riesaminate regolarmente le tendenze. Misurate la copertura di classificazione e ownership, la lineage degli elementi critici, le performance rispetto agli SLA di accesso, il completamento delle ricertificazioni, l'esecuzione dei controlli di qualità, la tempestività, i pattern di anomalia e la ricorrenza degli incidenti. L'approccio di benchmark sviluppato nell'ambito del lavoro di Global Data Governance Mapping dimostra perché gli indicatori strutturati sono più utili per il confronto rispetto alle dichiarazioni descrittive di maturità. I team di governance possono adattare questa logica senza considerare un framework esterno come un sostituto delle proprie decisioni sul rischio.
La norma ISO/IEC 38505-1 inquadra la data governance come una responsabilità dell'organo di governo, chiamato a valutare, indirizzare e monitorare la gestione e l'uso dei dati. Riconosce inoltre la responsabilità per le violazioni della privacy, per la normativa sulla tenuta dei registri e per la mancata conformità agli standard obbligatori. Responsabilità di data governance secondo la ISO/IEC 38505-1 Questa prospettiva cambia il ruolo della tecnologia di governance. Gli strumenti possono eseguire controlli, conservare evidenze e rendere visibili gli incidenti, ma la leadership resta responsabile di decisioni, interpretazione, eccezioni e accountability.
digna può supportare questo modello operativo attraverso la validazione in-database, il rilevamento delle anomalie basato sull'AI, il monitoraggio della tempestività, il tracciamento dello schema, la visibilità condivisa sugli incidenti, un data catalog e l'analisi storica. Le sue opzioni di deployment in private cloud e on-premises consentono alla piattaforma di essere eseguita all'interno dell'ambiente del cliente, mentre l'organizzazione mantiene la responsabilità della progettazione delle policy e della ownership dei controlli.
Adottate le policy in sequenza, misurate se funzionano e rivedetele quando il business cambia. Un modello è un punto di partenza. Un programma di governance funzionante è la combinazione di diritti decisionali, controlli eseguibili, evidenze, risposta umana e revisione periodica.
digna combina validazione a livello di record, rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema, business monitoring e analytics storiche in una piattaforma che viene eseguita all'interno dell'ambiente del cliente. Visitate digna per scoprire come i suoi moduli possono aiutarvi a trasformare le policy di data governance in controlli osservabili per analytics e AI.
La policy 4 descrive il controllo; il rilevamento che lo rende possibile è una funzionalità di prodotto. Schema Tracker confronta ogni schema distribuito con una baseline approvata e registra aggiunte, rimozioni, ridenominazioni e modifiche di tipo nel momento in cui avvengono.
Domande frequenti
Cosa rende una policy di data governance operativa anziché decorativa?
Ogni policy indica un obiettivo di controllo, un owner, un trigger, un pacchetto di evidenze, un percorso di escalation e un risultato misurabile. I dati delle indagini citati nell'articolo rilevano che solo il 23% delle organizzazioni utilizza framework formali di governance, quindi la sola documentazione crea spesso un'apparenza di maturità senza una reale copertura dei controlli.
Quali policy dovrebbe scrivere per prime un team?
Iniziate da un piccolo insieme di dataset ad alto rischio: reporting regolamentare, decisioni finanziarie rilevanti, attività cliniche, fatturazione ai clienti e workflow di AI o analytics. Assegnate un owner di business e uno steward operativo prima di definire controlli dettagliati, perché una documentazione ampia scritta per prima supera i controlli che dovrebbero applicarla.
In cosa differisce una policy di tempestività da una policy di qualità?
Una policy di qualità stabilisce se un record è idoneo allo scopo. Una policy di consegna converte il concetto di “abbastanza aggiornato” in una finestra concordata, un trigger osservabile e una risposta definita, con il producer responsabile dell'esecuzione e il consumer che definisce la finestra. Una pipeline può essere completata con successo e mancare comunque il regolamento di fine giornata.
Quali evidenze dovrebbe conservare una policy sulle modifiche allo schema?
Lo schema prima e dopo la modifica con il timestamp del rilevamento, la richiesta di modifica e la relativa motivazione, un livello di rischio, una valutazione d'impatto che copra la lineage interessata, oltre all'approvazione, all'esito del deployment e alla decisione sul rollback. Il rilevamento confronta ogni versione distribuita con una baseline registrata, gestita da uno schema owner designato.
Chi è responsabile di una policy di governance nel lavoro quotidiano?
La responsabilità è suddivisa tra tre ruoli. Il data owner approva il significato di business di ogni regola e accetta il rischio residuo, lo steward mantiene il registro delle regole, le evidenze e le attività di escalation, e gli ingegneri implementano i controlli nella pipeline o nel database. Registrare per prima cosa questa suddivisione è ciò che mantiene la policy verificabile.


