Data trust analytics spiegata per i team dati moderni
|
8
min di lettura

Un sondaggio del 2024 sulle priorità di pianificazione ha rilevato che il 67% delle organizzazioni non si fidava completamente dei dati usati per prendere decisioni, rispetto al 55% dell'anno precedente: un calo di fiducia di 12 punti in un solo ciclo annuale. L'analisi del sondaggio di Precisely descrive chiaramente il problema: ai team di analytics viene chiesto di muoversi più velocemente, mentre la loro base di evidenze resta difficile da verificare.
Questo divario è il terreno pratico della data trust analytics. Collega qualità dei dati, observability, rilevamento delle anomalie, lineage e contesto di business, così che i team possano rispondere a una domanda più utile di “La pipeline è stata eseguita?”. Possono chiedersi: “Questo dataset è abbastanza affidabile da supportare una decisione o un output di AI in questo momento?”
Indice
Perché la fiducia nei dati è il nuovo collo di bottiglia per analytics e AI
Perché la fiducia nel codice non è fiducia nei dati
Che cosa significa davvero data trust analytics
La fiducia è un segnale composito
I cinque pilastri che producono segnali di fiducia
La freschezza mostra se i dati sono aggiornati
La qualità verifica valori e regole di business
Il volume intercetta gli errori silenziosi di completezza
Lo schema protegge la compatibilità strutturale
Il lineage identifica chi e che cosa è interessato
Come i livelli di rilevamento combinano statistica, ML e revisione umana
Dove il machine learning aggiunge valore
Perché le persone restano parte del sistema
Metriche che rendono la fiducia qualcosa di misurabile
Leggere le metriche insieme
Aggiungere il contesto decisionale
Dall'observability alla prontezza decisionale per l'AI
Costruire scorecard attorno agli output
Gestire la fiducia entro i vincoli enterprise
Mantenere il control plane proporzionato
Assegnare l'ownership prima di aggiungere alert
Costruire un modello operativo della fiducia che regga nel tempo
Trasformare gli incidenti in conoscenza istituzionale
Rivedere la fiducia come pratica interfunzionale
Perché la fiducia nei dati è il nuovo collo di bottiglia per analytics e AI
Un responsabile finance apre una dashboard dei ricavi prima di una riunione con il management. Il grafico mostra un calo netto delle vendite regionali, quindi il team rinvia un piano di assunzioni e rivede il forecast. Più tardi un ingegnere scopre che una modifica a monte ha fatto arrivare in ritardo una parte dei dati dei clienti. La dashboard non mostrava una falsificazione intenzionale. Mostrava dati diventati incompleti senza che l'errore fosse evidente.
Questo scenario è frequente perché dashboard, modelli di machine learning e copilot di AI ereditano le condizioni dei dati sorgente. Righe mancanti possono ridurre una metrica. Una partizione obsoleta può far sembrare aggiornato un trend che non lo è. Una join interrotta può rimuovere clienti da un segmento. Una colonna rinominata può alterare una trasformazione. Senza un lineage utilizzabile, nessuno riesce a stabilire rapidamente quali report, feature o decisioni sono interessati.
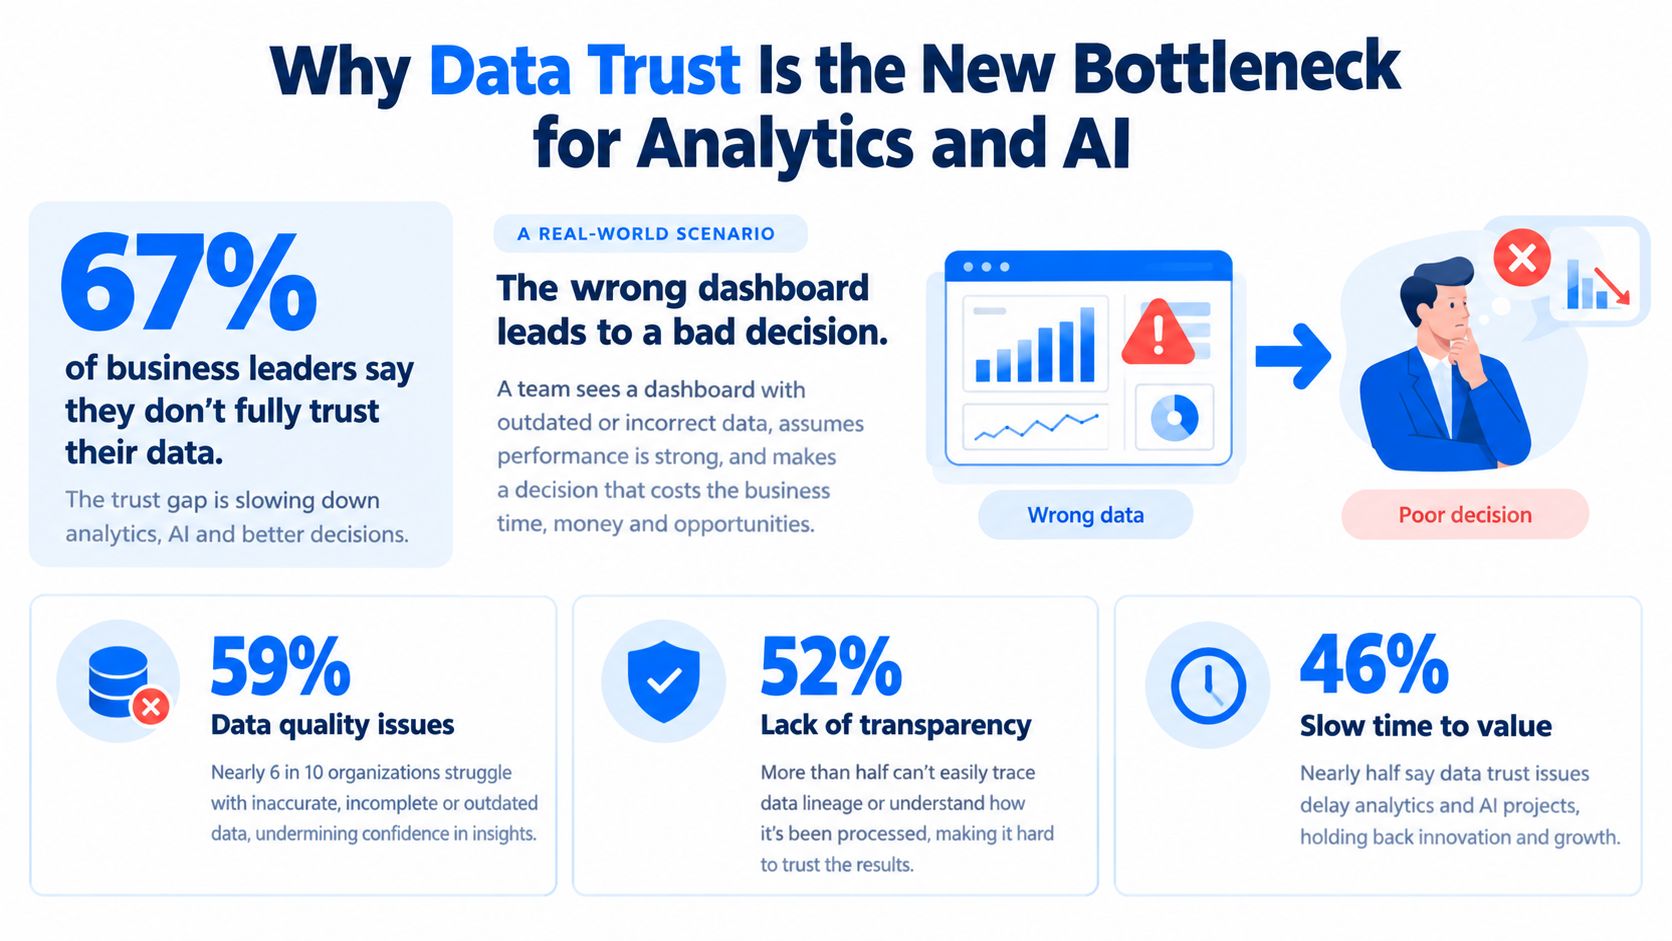
Il costo per l'azienda va oltre un singolo grafico errato. In un report di settore correlato, il 77% dei decisori IT ha dichiarato di non fidarsi completamente dei dati della propria organizzazione per decisioni accurate, tempestive e critiche per il business, mentre l'82% ha affermato che i dipendenti hanno dovuto rifare progetti di analytics già completati a causa della scarsa qualità dei dati. Lo stesso report di Precisely collega la scarsa fiducia ad attriti operativi: la qualità dei dati è il principale ostacolo per il 70% degli intervistati nelle organizzazioni con bassa fiducia nei dati decisionali.
Perché la fiducia nel codice non è fiducia nei dati
Un modello può superare i test di deployment e produrre comunque raccomandazioni inaffidabili se le sue tabelle di feature hanno subito una deriva. Una query SQL può compilare correttamente pur restituendo meno righe perché un processo a monte ha smesso di caricare una sorgente. La correttezza del software vi dice che il codice è stato eseguito come previsto. Non dimostra che gli input fossero completi, tempestivi, stabili o adatti alla decisione.
La data trust analytics fornisce questa evidenza mancante. Tratta i segnali operativi come parte della validità analitica, poi collega gli errori agli asset interessati e ai responsabili. I team che valutano l'impatto della scarsa qualità dei dati sulle decisioni di business possono usare questa distinzione per passare dalla correzione degli errori visibili nelle dashboard alla prevenzione di output inaffidabili prima che raggiungano chi decide.
Che cosa significa davvero data trust analytics
Partiamo dalla definizione ristretta. La qualità dei dati verifica se valori e record soddisfano condizioni note, ad esempio che un campo obbligatorio sia valorizzato, che una data rientri in un intervallo consentito o che un identificativo cliente sia univoco. Questi controlli sono necessari, ma coprono solo ciò che il team ha pensato di specificare.
La data trust analytics amplia la domanda. Combina le evidenze di qualità con freschezza, volume, stabilità dello schema, lineage, ownership e significato documentato. Chi consuma i dati deve sapere non solo se un valore sembra valido, ma anche se il dataset è aggiornato, compreso, tracciabile e sicuro da usare per uno scopo specifico.
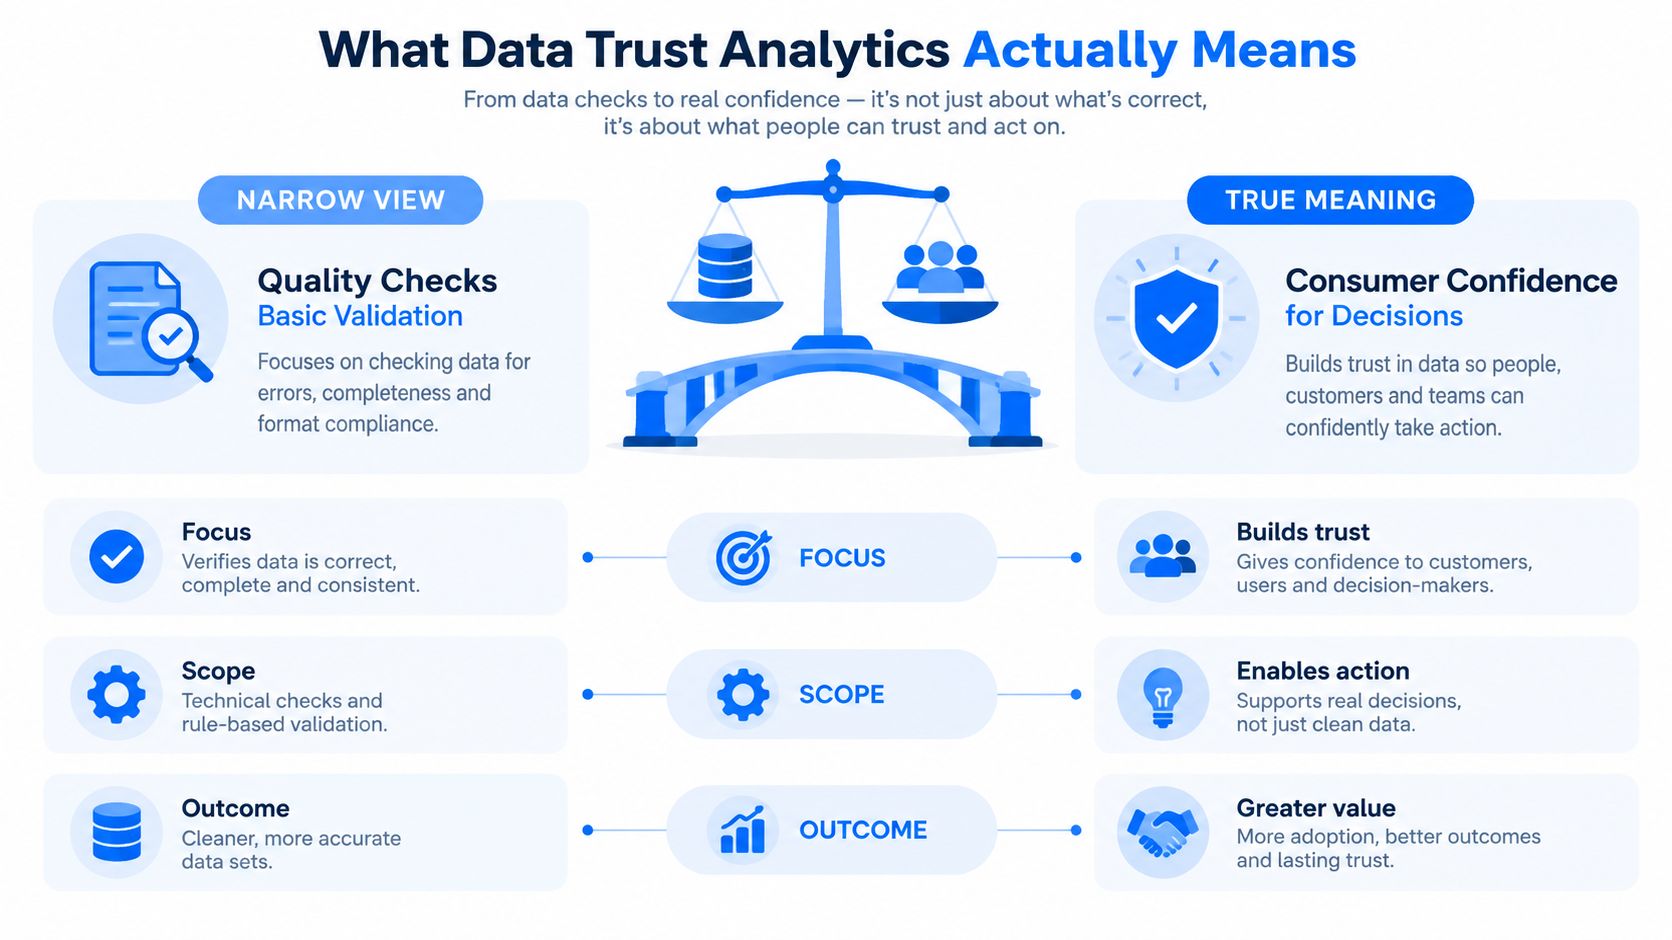
Una distinzione utile è:
La qualità dei dati chiede: “Questo valore rispetta la regola?”
La data trust analytics chiede: “Un decisore baserebbe una raccomandazione su questo dataset in questo momento?”
La seconda domanda dipende dal contesto. Un piccolo ritardo può essere accettabile per un report di pianificazione mensile ma inaccettabile per un alert operativo. Una colonna può essere tecnicamente valida e tuttavia semanticamente ambigua. Una feature di un modello può superare i controlli sui valori nulli perdendo però il collegamento con il sistema sorgente che ne spiega il significato.
La fiducia è un segnale composito
Pensate alla fiducia come a una conclusione tratta da diversi tipi di evidenze:
Evidenze operative: i dati sono arrivati quando previsto e la pipeline è stata completata?
Evidenze statistiche: conteggi, distribuzioni, medie e pattern dei valori mancanti somigliano al loro comportamento consolidato?
Evidenze strutturali: colonne, tipi di dato e relazioni sono rimasti compatibili?
Evidenze di contesto: scopo, responsabile, lineage e definizione di business del dataset sono documentati?
Un framework di data observability rende visibili questi segnali, ma la visibilità da sola non è il risultato finale. Il passaggio importante è tradurre le osservazioni in un giudizio di affidabilità per una specifica dashboard, modello, metrica o workflow di AI.
I cinque pilastri che producono segnali di fiducia
Un errore silenzioso in una pipeline raramente si annuncia con un errore rosso. Supponiamo che un processo di change data capture a monte perda righe per due giorni, mentre il job continua a segnalare un esito positivo. Le dashboard dei ricavi iniziano a sottostimare e un modello di forecasting riceve uno storico clienti incompleto. Ogni pilastro dell'observability rivela una parte diversa dell'incidente.
I cinque pilastri standard sono freschezza, qualità, volume, schema e lineage. Funzionano insieme, non come etichette intercambiabili. Le dimensioni della qualità dei dati offrono un modo utile per collegare i singoli controlli alla domanda più ampia: i dati a valle restano adatti all'uso?
La freschezza mostra se i dati sono aggiornati
La freschezza verifica se un dataset è arrivato secondo la pianificazione prevista. Un caricamento che compare ogni mattina ma manca la sua normale finestra di consegna dovrebbe ridurre la fiducia, anche se i record già presenti superano la validazione. Il monitoraggio della tempestività può distinguere un caricamento in ritardo da uno mancante e può anche individuare una consegna inaspettatamente anticipata che potrebbe indicare un problema di pianificazione o di partizionamento.
La qualità verifica valori e regole di business
I controlli di qualità esaminano tassi di valori nulli, duplicati, formati non validi, relazioni referenziali e vincoli di business. Nell'esempio delle righe perse, i record rimanenti potrebbero avere tutti ID cliente validi, quindi la sola validazione a livello di record potrebbe non cogliere l'incidente. La qualità diventa più informativa quando viene interpretata insieme al volume e al comportamento storico.
Il volume intercetta gli errori silenziosi di completezza
Il monitoraggio del volume confronta il numero di righe o altri indicatori di dimensione con i pattern attesi. Una riduzione improvvisa può rivelare un'estrazione parziale anche quando la pipeline non emette alcun errore tecnico. Il volume non spiega la causa, ma dà al team un segnale precoce che la completezza del dataset merita un'indagine.
Lo schema protegge la compatibilità strutturale
Il tracciamento dello schema rileva aggiunte, rimozioni, ridenominazioni e modifiche di tipo. Una colonna rinominata può rompere immediatamente una trasformazione a valle, oppure può essere mappata in modo errato e produrre risultati plausibili ma fuorvianti. La compatibilità strutturale fa parte della fiducia perché i consumatori dipendono sia dai valori sia dalla forma dei dati.
Il lineage identifica chi e che cosa è interessato
Il lineage collega la tabella sorgente a trasformazioni, dashboard, feature, modelli e metriche di business. Quando viene rilevata la perdita di righe, il lineage aiuta il team a identificare quali report sui ricavi e quali forecast vanno rivisti. L'ownership trasforma poi questa mappa in azione, instradando l'incidente verso le persone responsabili della sorgente e dei prodotti interessati.
Nessun pilastro da solo può certificare la prontezza decisionale. La fiducia emerge quando i segnali vengono correlati, interpretati nel contesto e consegnati a responsabili chiaramente individuati.
Come i livelli di rilevamento combinano statistica, ML e revisione umana
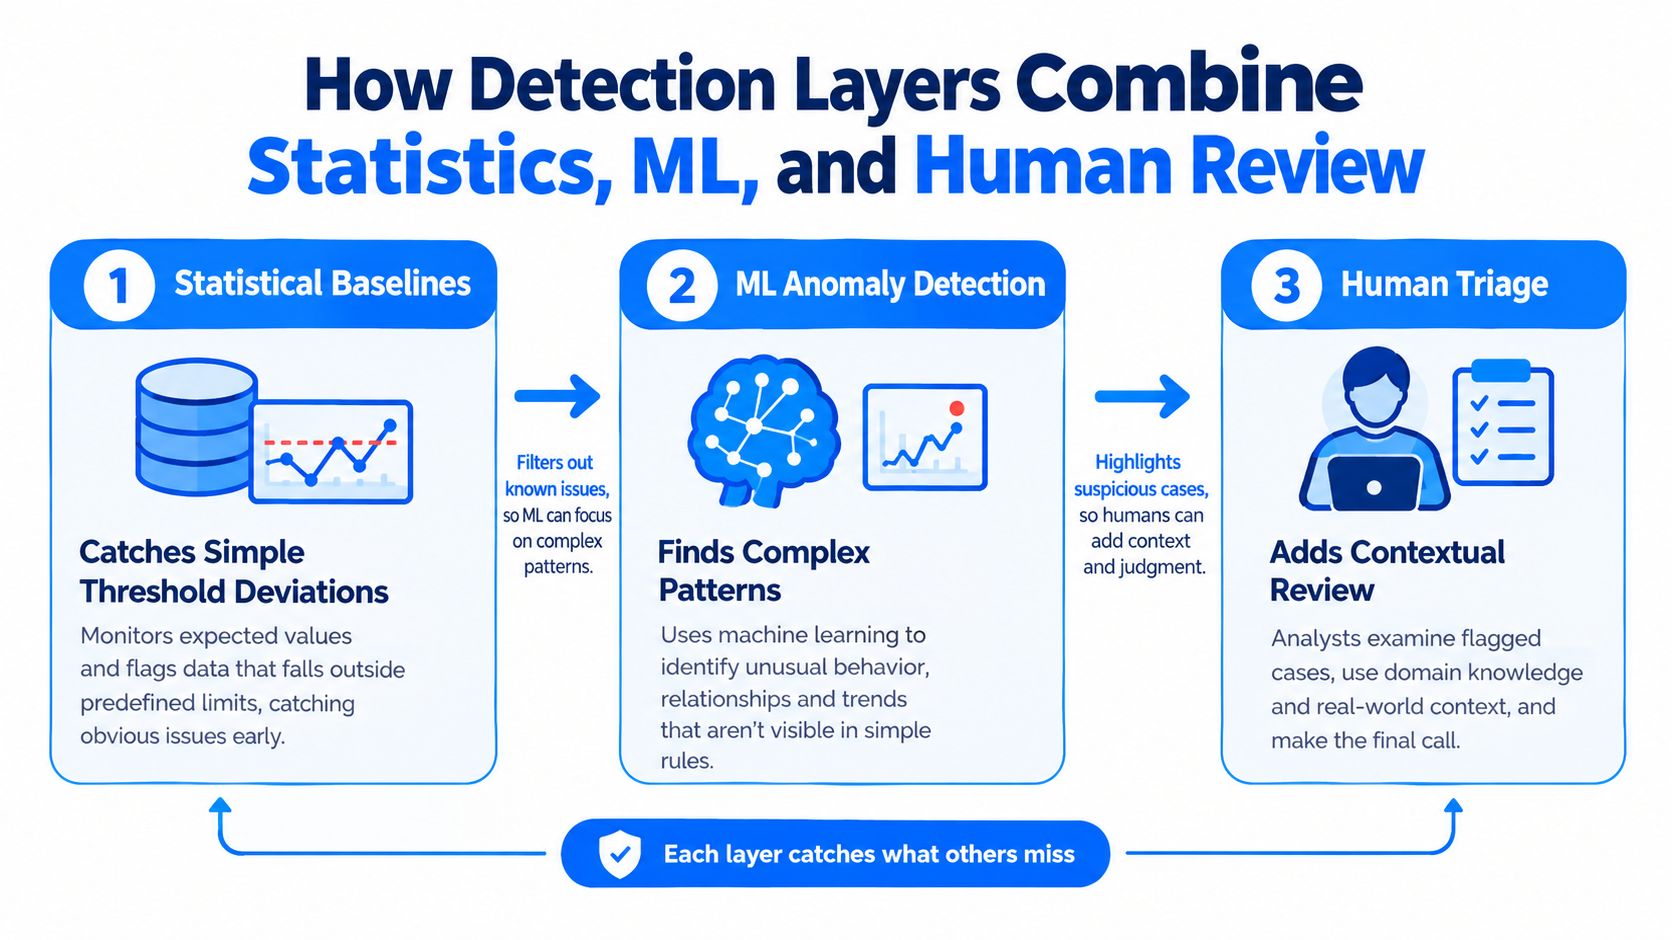
Il rilevamento funziona al meglio come sistema a livelli, perché ogni livello risponde a una domanda diversa. Le baseline statistiche intercettano gli errori evidenti in modo economico e spiegabile. Il machine learning identifica comportamenti che le regole fisse potrebbero non cogliere. La revisione umana fornisce il contesto di business necessario per decidere se un alert rappresenta un incidente, una modifica pianificata o una variazione innocua.
Iniziate con baseline per freschezza, volume, tassi di valori nulli, medie e altre misure fondamentali. Una soglia può segnalare una consegna mancante, mentre una statistica mobile può mostrare uno scostamento significativo rispetto al comportamento recente. Questi controlli sono facili da spiegare durante la revisione degli incidenti, quindi restano utili anche dopo che un team ha aggiunto un rilevamento più avanzato.
Dove il machine learning aggiunge valore
Le regole statiche diventano meno affidabili quando i dati seguono pattern stagionali, settimanali, legati ai cicli di rilascio o ai segmenti di clientela. Una distribuzione appresa o un modello stagionale può identificare un pattern insolito che resta all'interno di un'ampia soglia fissa, un approccio fondato sul riconoscimento statistico dei pattern. Una pipeline può superare la regola sul numero minimo di righe producendo però una distribuzione molto diversa dal suo profilo consolidato.
Per i dati operativi ad alto volume, una ricerca dell'Università di Amsterdam descrive un approccio non supervisionato basato sul consenso che combina più modelli, regole empiriche, tuning iterativo degli iperparametri e un esperto di dominio coinvolto nel ciclo. Il metodo dello studio sostiene un principio di design pratico: nessun singolo rilevatore dovrebbe essere responsabile di ogni tipo di anomalia.
Perché le persone restano parte del sistema
Una pipeline può superare i controlli fissi su freschezza e volume e attivare comunque un modello appreso perché una metrica chiave cala in modo insolito. Un analista consulta il calendario dei rilasci e conferma che il cambiamento è stato causato da una promozione pianificata. Contrassegnare l'evento come atteso evita che alert simili diventino rumore ricorrente e fornisce al processo di rilevamento un contesto migliore.
Un altro framework di qualità dei dati raccomanda di profilare ogni batch in arrivo, conservare i profili storici e alimentare con le serie temporali risultanti i modelli di rilevamento delle anomalie. L'approccio di profilazione citato tratta la deriva come una sequenza misurabile anziché come un'ispezione una tantum.
Regola pratica: usate le regole per le modalità di errore note, i modelli per i comportamenti che cambiano e le persone per il contesto di business.
Metriche che rendono la fiducia qualcosa di misurabile
La fiducia diventa gestibile quando i team la esprimono attraverso metriche che possono riportare, monitorare con alert e migliorare. Una dashboard che dice “i dati sembrano sani” è difficile da difendere. Una scorecard che mostra le performance di freschezza, le anomalie irrisolte, il tempo di ripristino dopo modifiche dello schema e la copertura del lineage offre a ingegneri e stakeholder un linguaggio operativo condiviso.
Le metriche seguenti sono punti di partenza, non obiettivi universali. Un dataset critico di pagamenti dovrebbe avere aspettative più rigorose di una tabella esplorativa. Definite il benchmark insieme ai responsabili e ai consumatori che comprendono le conseguenze di un errore.
Metrica | Definizione | Benchmark obiettivo | Pilastro di origine |
|---|---|---|---|
SLO di freschezza | Quota di aggiornamenti attesi consegnati entro la cadenza concordata | Definito in base all'uso decisionale del dataset e alle aspettative di consegna | Freschezza |
Tasso di anomalie | Eventi anomali rilevati rispetto all'insieme delle tabelle monitorate e al periodo di osservazione | Abbastanza basso da preservare l'attenzione, con gli incidenti confermati tracciati separatamente dagli eventi accettati | Qualità, volume, freschezza |
MTTR delle modifiche dello schema | Tempo medio da una modifica dello schema non autorizzata o incompatibile alla sua risoluzione | Abbastanza breve da proteggere la pubblicazione a valle e l'uso dei modelli | Schema |
Copertura del lineage | Quota di asset a valle collegati a una sorgente a monte con un responsabile e monitorata | Copertura completa per report, feature e modelli critici | Lineage |
Leggere le metriche insieme
Un buon risultato sulla freschezza non compensa un lineage carente. Un tasso di anomalie basso può indicare dati stabili, oppure un rilevatore troppo prudente. L'MTTR delle modifiche dello schema può sembrare sano mentre i team restano incapaci di identificare tutte le dashboard interessate.
Per questo motivo, pubblicate il contesto della metrica insieme al numero. Registrate l'insieme degli asset monitorati, l'uso decisionale, le esclusioni, le anomalie accettate e lo stato dell'ownership. Una guida alla misurazione dell'affidabilità può aiutare i team a trasformare le osservazioni operative in una conversazione sull'affidabilità comprensibile per gli stakeholder di business.
Aggiungere il contesto decisionale
Ogni scorecard dovrebbe rispondere a tre domande:
Che cosa è stato misurato? Indicate la tabella, l'insieme di feature, la metrica o l'input del modello.
Che cosa è cambiato? Mostrate il segnale attuale rispetto alla sua baseline storica e all'aspettativa concordata.
Quale azione ne consegue? Identificate il responsabile, il percorso di escalation e la decisione sulla pubblicazione o sull'inferenza.
Questa struttura impedisce ai team di trattare la fiducia come un'etichetta decorativa su una dashboard. Rende la fiducia verificabile.
Dall'observability alla prontezza decisionale per l'AI
L'observability produce evidenze, ma non dice automaticamente al responsabile di un modello se un sistema di AI debba essere eseguito oggi. Una piattaforma può mostrare un'esecuzione sana delle pipeline mentre i dati delle feature restano difficili da tracciare, distribuiti in modo insolito o interessati da anomalie irrisolte.
Il divario è misurabile nel sentiment delle aziende. Il 58% delle organizzazioni ha dichiarato di aver implementato o ottimizzato programmi di data observability, eppure il 42% non si fida ancora degli output dei propri modelli di AI o di machine learning, secondo recenti analisi sulla fiducia nell'AI in ambito enterprise. L'observability può quindi coesistere con la sfiducia quando i team monitorano l'infrastruttura senza dimostrare che gli input a valle sono pronti per le decisioni.
Costruire scorecard attorno agli output
Una scorecard di fiducia dovrebbe legare le evidenze a un consumatore specifico. Ad esempio, una tabella di feature potrebbe mostrare una freschezza accettabile ma solo il 60% di copertura del lineage e tre anomalie irrisolte. Questi valori appartengono allo scenario, non sono benchmark generali, ma dimostrano perché un generico stato verde della pipeline può essere fuorviante.
Il processo di promozione dei modelli può applicare gate espliciti:
Gate di freschezza: gli input richiesti sono arrivati entro le finestre previste.
Gate di qualità: le regole di validazione critiche sono state superate, con le eccezioni documentate.
Gate di schema: non restano modifiche strutturali incompatibili irrisolte.
Gate di lineage: il responsabile del modello può ricondurre le feature critiche a sorgenti monitorate.
Gate degli incidenti: le anomalie aperte hanno un responsabile assegnato e una decisione documentata.
Una scorecard non dovrebbe nascondere l'incertezza dietro un unico numero composito. Dovrebbe mostrare le evidenze alla base della decisione, l'approvazione del responsabile del rischio e le condizioni in cui l'output deve essere trattenuto o rivisto.
Queste evidenze possono comparire anche nella documentazione del modello. Dirigenti, autorità di regolamentazione, analisti e ingegneri hanno bisogno di più di una metrica del modello. Hanno bisogno di una spiegazione difendibile del fatto che i dati alla base dell'output fossero aggiornati, stabili, validati e tracciabili al momento dell'uso.
Gestire la fiducia entro i vincoli enterprise
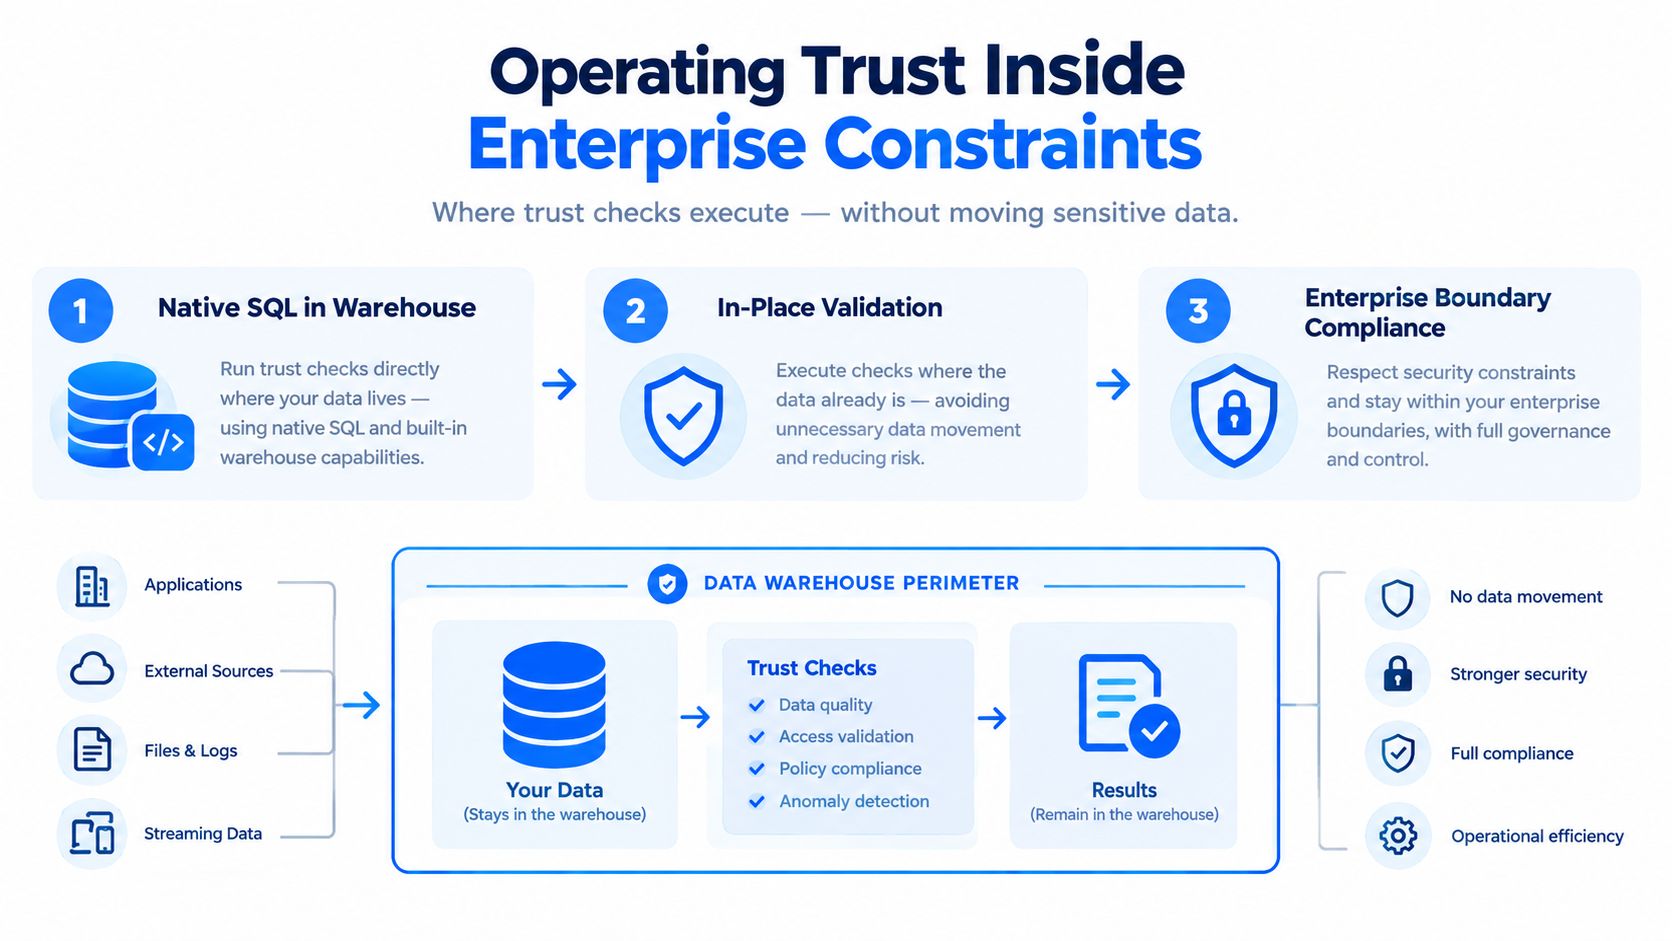
I controlli sulla fiducia devono adattarsi all'ambiente in cui i dati sensibili risiedono già. Spostare i record di produzione in un servizio di monitoraggio separato può creare problemi di privacy, residenza dei dati, controllo degli accessi, crittografia e rete. Può anche complicare il modello di ownership, separando le evidenze dal sistema che contiene i dati.
Un'architettura pratica separa spesso l'esecuzione dal coordinamento. Controlli SQL nativi o nativi del database possono calcolare numero di righe, vincoli, indicatori di freschezza e risultati delle validazioni dove risiedono i dati. Un servizio centralizzato può quindi gestire policy, alert, instradamento degli incidenti e scorecard usando i metadati necessari anziché copie dei record sottostanti.
Mantenere il control plane proporzionato
Il modello di deployment giusto dipende dai confini dell'organizzazione. Un'installazione in cloud privato o on-premises può essere adatta ai team che non possono spostare i dati di produzione fuori dal proprio ambiente. digna dichiara che la sua piattaforma viene eseguita nel cloud privato o nell'infrastruttura on-premises del cliente, con i controlli di qualità dei dati e la logica di rilevamento delle anomalie eseguiti all'interno del motore di database del cliente. La sua documentazione descrive questo modello in loco.
Il design operativo dovrebbe anche tenere conto degli attriti nell'adozione. Dati di indagine recenti hanno rilevato che il 61% dei team si affidava ancora a controlli manuali o a validazioni basate su SQL, il 27% usava una piattaforma di observability dedicata e solo il 14% applicava accordi sul livello di servizio a livello di intera organizzazione, mentre il 39% li monitorava. Il report di Integrate.io mostra perché l'implementazione deve rispettare i workflow esistenti, invece di presumere che ogni team possa sostituire tutte insieme le proprie pratiche di validazione.
Assegnare l'ownership prima di aggiungere alert
Lo stesso report ha rilevato che la responsabilità della qualità dei dati era condivisa tra più team per il 44% degli intervistati, e che la visibilità limitata sullo stato di salute delle pipeline era la sfida principale per il 31%. La responsabilità condivisa può funzionare, ma solo quando qualcuno è titolare della decisione di indagare, pubblicare, sopprimere o ripristinare un output.
Date priorità ai controlli in base a:
Impatto decisionale: monitorate per primi gli asset che influenzano decisioni finanziarie, regolamentari, cliniche, operative o relative ai clienti.
Sensibilità dei dati: riducete al minimo i metadati conservati e mantenete gli accessi allineati ai permessi esistenti.
Costo dell'errore: instradate gli alert con conseguenze rilevanti attraverso i canali consolidati di gestione degli incidenti.
Aderenza operativa: testate i controlli in caso di ingestion in ritardo, dipendenze degradate e modifiche dello schema.
Non acquistate una promessa valida per l'intera piattaforma prima di aver dimostrato il workflow su un dominio critico. L'adozione modulare permette ai team di validare qualità dei segnali, ownership degli alert e costo operativo prima di estendere la copertura.
Costruire un modello operativo della fiducia che regga nel tempo
Un programma di fiducia duraturo è un sistema operativo a ciclo chiuso, non una raccolta di alert di monitoraggio. I team definiscono obiettivi sul livello di servizio per freschezza, completezza, validità, compatibilità dello schema e copertura del lineage, poi collegano questi obiettivi a responsabili nominativi, percorsi di escalation e soglie di impatto sul business.
La policy di risposta conta quanto il rilevamento. Un controllo fallito potrebbe bloccare la pubblicazione a valle o l'inferenza di AI, ma solo quando controlli documentati giustificano l'interruzione. In altri casi, l'organizzazione può conservare l'ultimo risultato affidabile noto, etichettare l'output come obsoleto e concedere al responsabile una finestra definita per risolvere il problema.
Trasformare gli incidenti in conoscenza istituzionale
Per ogni incidente rilevante, registrate:
Causa: che cosa è cambiato nella sorgente, nella trasformazione, nella pianificazione, nello schema o nel percorso di accesso?
Impatto: quali tabelle, metriche, dashboard, feature, modelli e decisioni sono stati interessati?
Risposta: chi ha indagato, quale azione è stata intrapresa e quanto rapidamente è stato ripristinato il servizio?
Evidenze: quali risultati di validazione e monitoraggio hanno confermato che i dati erano di nuovo sicuri da usare?
Dopo il ripristino, riportate questi risultati nelle regole di validazione, nella configurazione delle baseline, nelle mappe di ownership, nelle policy di accesso e nei backlog di engineering. Un errore di tempestività ricorrente può richiedere una riprogettazione della pianificazione. Un problema di schema ripetuto può richiedere contratti di compatibilità. Un'ambiguità ricorrente su una metrica può richiedere una definizione semantica più solida.
Rivedere la fiducia come pratica interfunzionale
Data engineering, analytics, governance, sicurezza e stakeholder di business dovrebbero esaminare insieme le scorecard. Ogni gruppo vede una diversa modalità di errore. Gli ingegneri comprendono il comportamento delle pipeline, gli analisti l'interpretazione, la sicurezza l'esposizione, la governance l'accountability e i responsabili di business le conseguenze delle decisioni.
Questa disciplina sostiene gli sforzi più ampi per sbloccare valore di business con i dati, perché i dati affidabili diventano una capacità operativa anziché un sottoprodotto non esaminato. L'obiettivo non è eliminare ogni anomalia. È creare evidenze ripetute che l'organizzazione conosce i propri dati, sa chi ne è responsabile, sa quali decisioni ne dipendono ed è in grado di riprendersi quando le condizioni cambiano.
La fiducia si guadagna quando le stesse evidenze supportano la stessa decisione sia nei giorni ordinari sia nei giorni di incidente.
digna offre funzionalità di qualità dei dati e observability eseguite nel vostro ambiente per monitorare anomalie, tempestività, validazione, modifiche dello schema e comportamento storico dei dati, senza spostare i dati di produzione fuori dall'ambiente del cliente. Visitate digna per vedere come il suo approccio modulare può collegare i segnali operativi alla prontezza decisionale per analytics e AI.
Domande frequenti
Che cos'è la data trust analytics?
Collega qualità dei dati, observability, rilevamento delle anomalie, lineage e contesto di business, così che un team possa rispondere a una domanda più utile di “La pipeline è stata eseguita?”. La domanda diventa se un dataset è abbastanza affidabile da supportare una decisione o un output di AI in questo momento.
Quali segnali producono fiducia?
Cinque pilastri: freschezza, qualità, volume, schema e lineage. La freschezza confronta l'arrivo dei dati con la pianificazione, il volume intercetta gli errori silenziosi di completezza, lo schema protegge la compatibilità strutturale e il lineage identifica chi è interessato. Nessun pilastro da solo può certificare la prontezza decisionale.
Come si misura la fiducia nei dati?
Quattro metriche la rendono riportabile: SLO di freschezza, tasso di anomalie, MTTR delle modifiche dello schema e copertura del lineage. Leggetele insieme anziché separatamente, perché un buon risultato sulla freschezza non compensa un lineage carente, e pubblicate il contesto della metrica insieme al numero.
La data observability garantisce un'AI affidabile?
No. In analisi recenti il 58% delle organizzazioni ha dichiarato di aver implementato o ottimizzato programmi di data observability, eppure il 42% non si fida ancora degli output della propria AI o del machine learning. Colmare questo divario significa legare le evidenze a un consumatore specifico tramite gate espliciti di promozione dei modelli.
Chi dovrebbe essere responsabile della fiducia nei dati?
Assegnate l'ownership prima di aggiungere alert. Un'indagine ha rilevato che la responsabilità della qualità dei dati era condivisa tra più team per il 44% degli intervistati, e che la visibilità limitata sullo stato di salute delle pipeline era la sfida principale per il 31%. Date priorità ai controlli in base a impatto decisionale, sensibilità e costo dell'errore.


