Data observability per data engineer: una guida pratica
|
7
min di lettura

Una pipeline batch può terminare in verde mentre la dashboard che alimenta è già sbagliata. Il caricamento può contenere solo una parte dei dati attesi, un sistema a monte può aver aggiunto una colonna che modifica una trasformazione, oppure l'ultima partizione può essere in ritardo di ore. Il monitoraggio dell'infrastruttura segnala un'esecuzione riuscita, mentre analisti e sistemi di machine learning consumano output obsoleti o corrotti.
È in questo divario che la data observability per i data engineer dimostra il proprio valore. Esamina il comportamento dei dati che attraversano data warehouse, data lake, stream e trasformazioni, poi collega le anomalie a ownership, impatto e risposta. La sfida pratica non è raccogliere ogni segnale possibile, ma costruire una copertura sufficiente a intercettare i guasti rilevanti senza spostare dati sensibili fuori dal vostro ambiente e senza sommergere gli ingegneri di alert.
Indice
Perché i data engineer hanno bisogno di observability oltre il monitoraggio delle pipeline
Monitorare i sistemi e monitorare i dati
I cinque pilastri e il loro valore pratico
Strumentare i quattro SLI fondamentali di ogni pipeline
1. Tasso di successo dei job
2. Latenza di freshness
3. Completezza e volume
4. Conformità dello schema
Risolvere l'alert fatigue che compromette l'observability
Progettare gli alert attorno alle decisioni
Misurare la qualità del rilevamento, non il volume delle notifiche
Implementare l'observability in ambienti regolamentati e on-premises
Una sequenza di deployment che supera la revisione di sicurezza
Gli ambienti eterogenei hanno bisogno di un contratto comune
Scegliere la strategia di alerting giusta per il vostro data stack
Quando vincono le regole semplici
Quando aiutano i metodi adattivi
Integrare l'observability nell'architettura di pipeline esistente
Posizionare i controlli dove rispondono a una domanda
Partire in piccolo e scalare l'implementazione dell'observability
Perché i data engineer hanno bisogno di observability oltre il monitoraggio delle pipeline
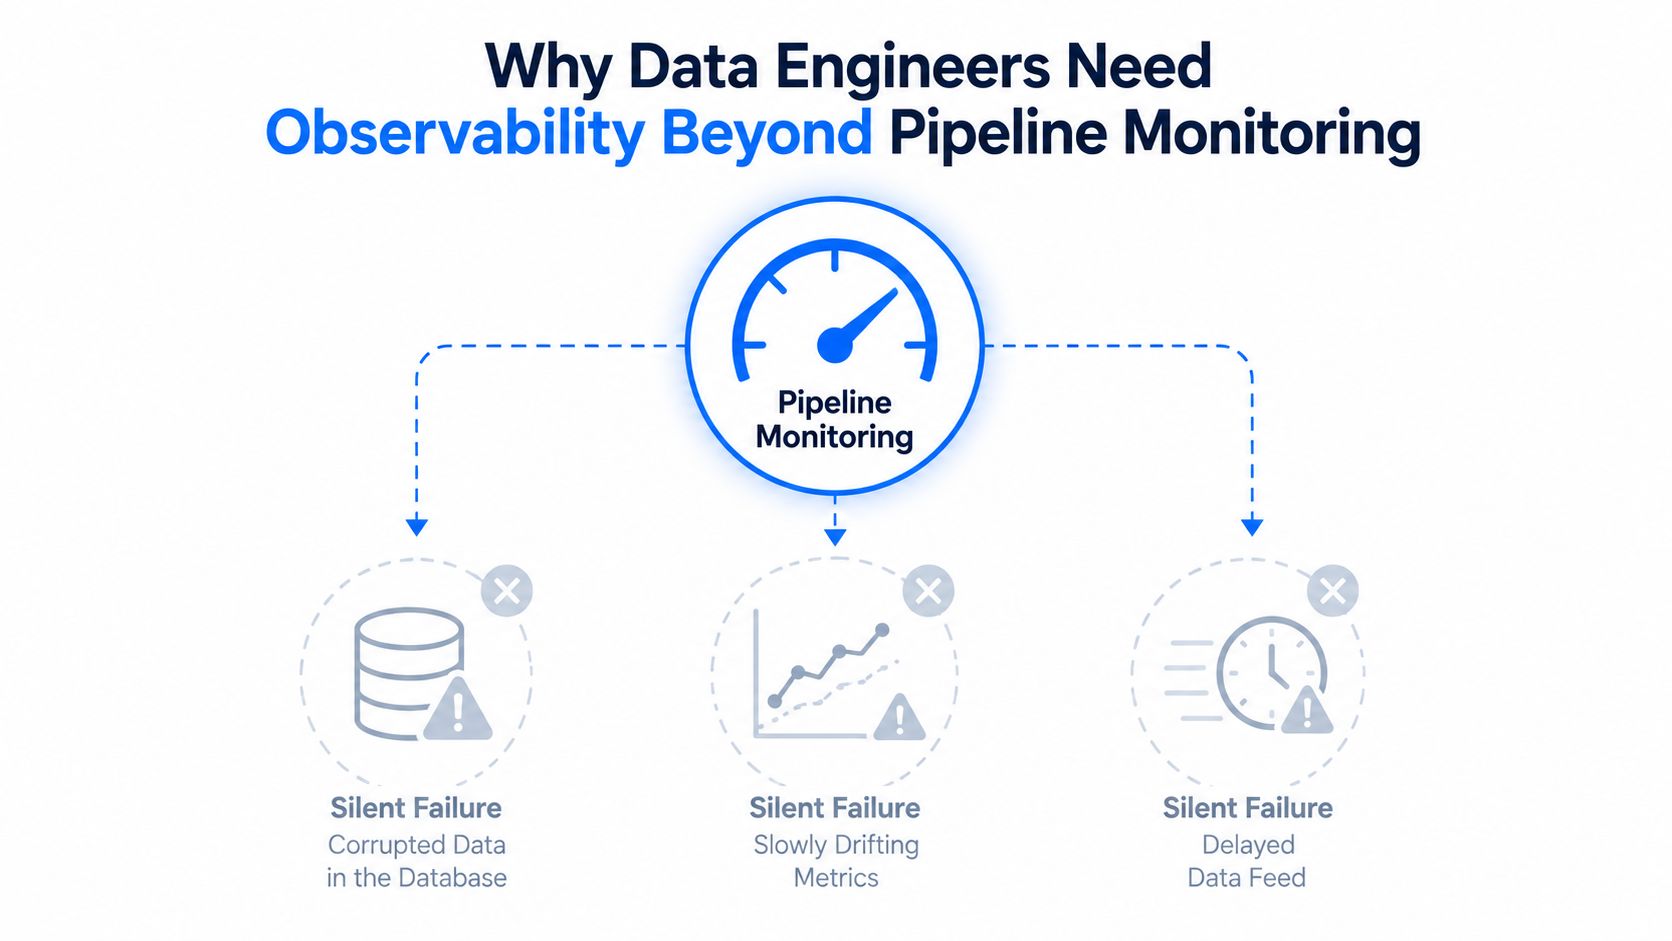
Alle 9:00 una dashboard di orchestrazione mostra un job notturno completato con successo. Il task del warehouse è terminato, i retry sono rimasti a zero e il cluster di calcolo è in salute. In tarda mattinata, il reparto finance si accorge che in una dashboard dei ricavi mancano le transazioni recenti. Anche un modello addestrato sulla stessa tabella ha iniziato a produrre risultati instabili.
La pipeline non è fallita nel senso convenzionale. Ha consegnato una partizione parziale e ha segnato il lavoro come completato. Una join a valle ha escluso dei record e la tabella risultante sembrava strutturalmente abbastanza valida da far caricare le dashboard. Il monitoraggio tradizionale ha visto un sistema disponibile. Non ha visto dati inaffidabili.
Monitorare i sistemi e monitorare i dati
Il monitoraggio delle pipeline resta importante. Tasso di successo dei job, comportamento dei retry, durata dei task, salute degli executor e capacità dell'infrastruttura aiutano gli ingegneri a individuare i guasti operativi. Ma questi segnali dicono se un processo è stato eseguito, non se l'output è completo, tempestivo, strutturalmente coerente o se si comporta normalmente.
La data observability aggiunge l'ispezione dei dati stessi. Combina segnali tecnici con contesto come lineage, owner, dipendenze a valle e criticità per il business. La distinzione è simile alla differenza tra verificare che un camion delle consegne abbia lasciato il magazzino e verificare che il pacco contenga gli articoli giusti e sia arrivato prima che il cliente ne avesse bisogno.
Un buon punto di partenza è il confronto di digna tra data observability e qualità dei dati, perché regole di qualità e observability risolvono problemi correlati ma diversi. I test deterministici fanno rispettare aspettative note. L'observability aiuta a far emergere cambiamenti inattesi che nessuno aveva pensato di codificare in un test.
I cinque pilastri e il loro valore pratico
La maggior parte dei modelli di data observability si basa su cinque pilastri, freshness, distribuzione, schema, lineage e volume, come descritto nella panoramica di Databricks sulla data observability.
La freshness indica se i dati sono arrivati entro la pianificazione prevista. Conta soprattutto per le dashboard operative, il reporting regolamentare e i processi che dipendono da record aggiornati.
Il volume confronta la quantità di dati con il comportamento normale. Può far emergere caricamenti incompleti, ingestion duplicate, filtri non funzionanti e interruzioni a monte.
Lo schema traccia colonne, tipi di dato e modifiche strutturali. Diventa critico quando i sistemi sorgente evolvono indipendentemente dai consumatori del warehouse.
La distribuzione osserva il comportamento dei valori, inclusi pattern di null, intervalli, unicità e altre caratteristiche del dataset. Può intercettare un feed semanticamente rotto che ha comunque le colonne e il numero di righe corretti.
La lineage collega un incidente agli asset e ai team coinvolti. Senza di essa, gli ingegneri passano il tempo di risposta a cercare owner e dipendenze a valle.
Un warehouse regolamentato può dare priorità a schema e lineage, perché una modifica strutturale non controllata può compromettere le evidenze del reporting. Una piattaforma di streaming può puntare su freshness e distribuzione, perché eventi in ritardo o anomali possono distorcere rapidamente le decisioni operative. L'implementazione giusta non tratta tutti i pilastri allo stesso modo. Offre una copertura più profonda ai data product il cui guasto ha un impatto maggiore sul business o sulla compliance.
Per un contesto di settore più ampio, il tag observability sull'ecommerce è utile per vedere come i problemi di affidabilità emergono al di fuori del platform engineering vero e proprio. La lezione per la produzione è semplice: mantenete il monitoraggio dell'infrastruttura, poi aggiungete segnali a livello di dati dove uno stato verde della pipeline può ancora nascondere un risultato sbagliato.
Strumentare i quattro SLI fondamentali di ogni pipeline
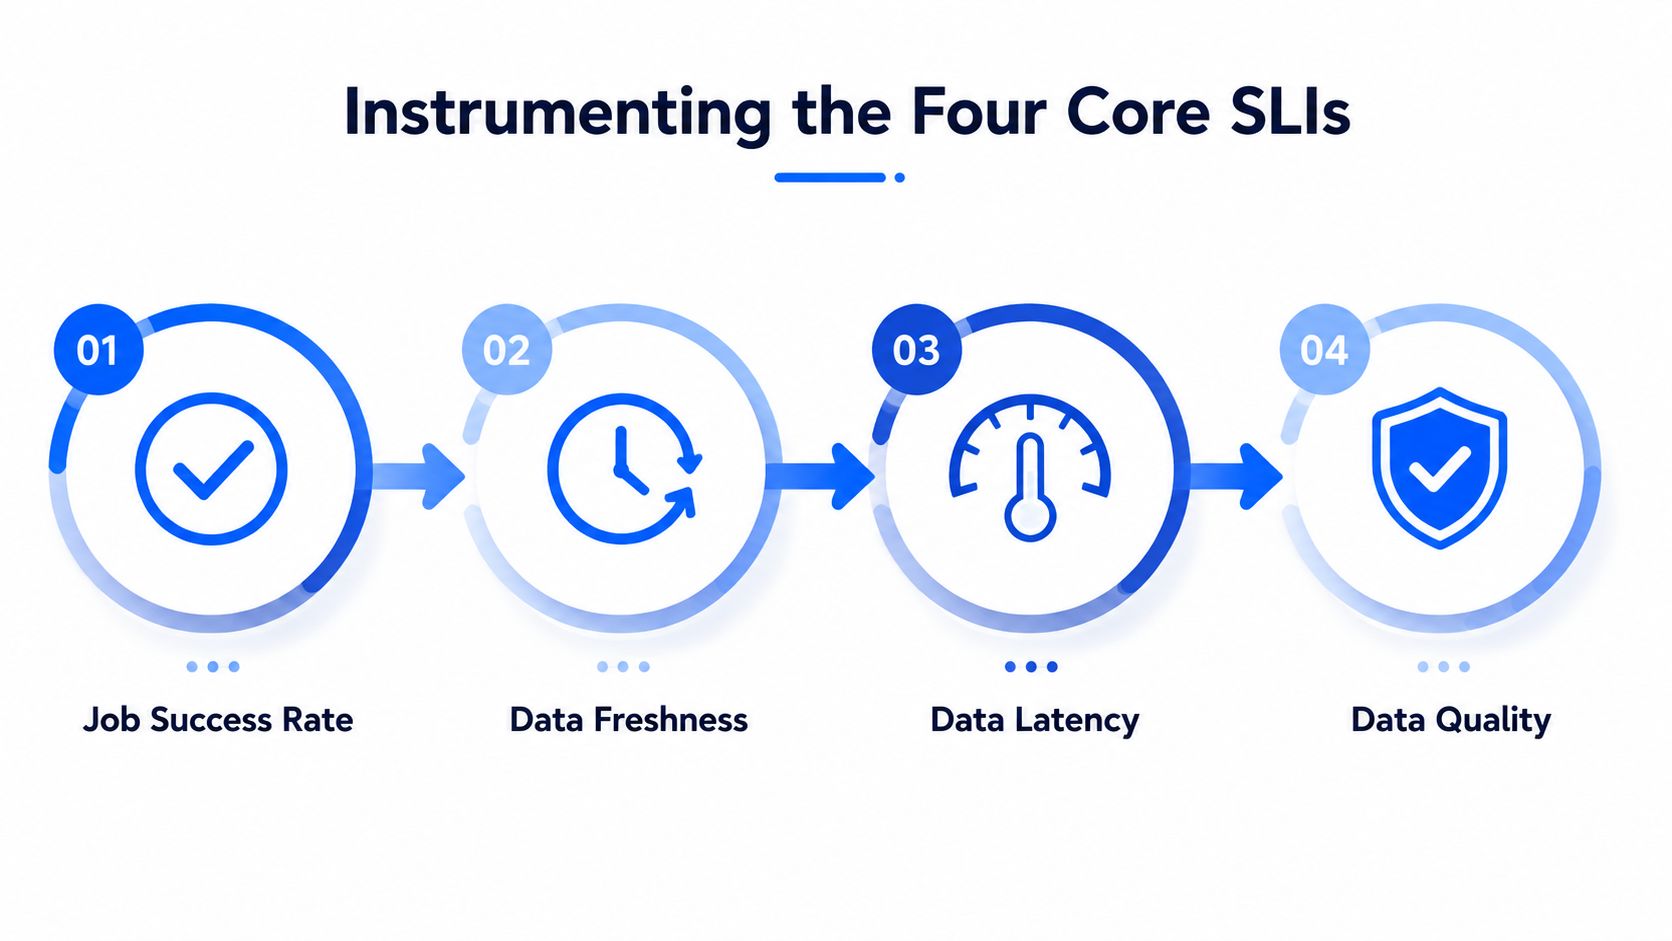
Un rollout pratico dell'observability può iniziare con quattro service level indicator, o SLI, su ogni pipeline critica: tasso di successo dei job, latenza di freshness, completezza o volume e conformità dello schema. Questi segnali coprono esecuzione, tempi, quantità e struttura senza richiedere un programma di monitoraggio elaborato fin dal primo giorno.
1. Tasso di successo dei job
Tracciate le esecuzioni completate, fallite, ripetute, saltate e andate in timeout. Un semplice rapporto di successo è utile, ma non fermatevi a uno stato binario. Registrate il percorso di esecuzione, la durata, lo stato delle dipendenze e se il job ha prodotto l'output atteso.
Per i sistemi batch, emettete un evento di completamento solo dopo che la partizione di destinazione è stata confermata e validata. Per i sistemi di streaming, distinguete l'attività del processo dal progresso effettivo. Un consumer può restare connesso mentre il lag cresce o si accumulano record malformati.
2. Latenza di freshness
La freshness misura il tempo trascorso dall'ultimo aggiornamento riuscito, o il ritardo tra la consegna prevista e quella effettiva. Per i dataset critici, i team esprimono spesso la metrica come latenza p95 o p99, che impedisce a un piccolo numero di record veloci di mascherare una lunga coda di arrivi in ritardo. Anche le indicazioni di settore sul monitoraggio della freshness inquadrano il controllo rispetto alla cadenza di ingestion prevista.
Le pipeline batch dovrebbero registrare l'orario pianificato, l'orario di arrivo e l'orario di effettiva disponibilità. I sistemi di streaming dovrebbero tracciare separatamente il lag sull'event time e il lag sull'ingestion time, poiché un consumer attivo può comunque elaborare eventi in ritardo.
Usate il comportamento storico come contesto invece di applicare un'unica soglia universale. Una baseline pratica confronta la stessa ora del giorno nelle 2–4 settimane precedenti, come illustrato nelle indicazioni di Streamkap sull'observability dello streaming. Per un alert critico, il punto di partenza statistico consigliato è 3 deviazioni standard dalla baseline, mentre per un avviso si possono usare 2 deviazioni standard. Questi valori vanno inseriti in una policy che tenga conto anche degli impegni di consegna e delle conseguenze a valle.
3. Completezza e volume
Confrontate il numero di record, partizioni, file o finestre di eventi attesi con quelli effettivi. Un batch giornaliero può richiedere una partizione attesa e un intervallo minimo di record. Uno stream può dover mantenere il throughput degli eventi ed evitare lacune inspiegate nelle finestre temporali.
I conteggi da soli non bastano. Abbinateli a controlli sui duplicati, monitoraggio del tasso di null e copertura delle partizioni, così che un caricamento duplicato non sembri completo. Le anomalie di volume spesso arrivano prima che una dashboard si rompa in modo visibile, il che le rende preziosi indicatori precoci e non semplici strumenti diagnostici post-incidente.
4. Conformità dello schema
Misurate la percentuale di righe che superano la validazione strutturale, poi tracciate le modifiche a nomi di colonna, tipi, nullabilità e annidamento. Lo schema drift comprende colonne aggiunte, colonne rimosse e modifiche del tipo di dato, come documentato nella spiegazione di Ataccama sul tracciamento dello schema.
Posizionate il controllo vicino al confine con la sorgente e di nuovo prima dei livelli di consumo di maggior valore. Questa collocazione aiuta a distinguere una modifica del contratto a monte da un difetto di trasformazione. Memorizzate la versione dello schema osservata a ogni esecuzione, così chi interviene può confrontare il primo output errato con la modifica che lo ha preceduto.
Regola pratica: prima la baseline, poi l'alert. Una soglia senza contesto storico o non vede il drift graduale o crea rumore durante i normali cicli operativi.
Per i team che vogliono definire con precisione le metriche di consegna, questa guida a definizioni e metriche di monitoraggio della tempestività dei dati offre un vocabolario utile per distinguere i ritardi di arrivo, elaborazione e disponibilità.
Risolvere l'alert fatigue che compromette l'observability
Più controlli possono peggiorare l'affidabilità quando nessuno si fida delle notifiche. Un report enterprise sull'observability del 2025 ha rilevato che veniva utilizzato solo il 13% dei dati di telemetria, il che significa che il problema centrale non è sempre la mancanza di visibilità. Può essere un eccesso di segnali che non diventano mai decisioni operative, come riportato in una recente copertura sull'observability enterprise.
L'errore è trattare ogni deviazione come un incidente. Una piccola variazione di distribuzione su una tabella esplorativa non dovrebbe allertare lo stesso team, né seguire lo stesso percorso di escalation, di dati obsoleti che alimentano il reporting regolamentare. Gli ingegneri hanno bisogno di un modo per classificare i segnali in base a impatto, affidabilità e ownership.
Progettare gli alert attorno alle decisioni
Ogni alert dovrebbe rispondere a quattro domande:
Cosa è cambiato? Identificate il dataset, il campo, la partizione o la pipeline.
Quanto è insolito? Mostrate la baseline, il valore osservato e il livello di confidenza.
Chi è responsabile della risposta? Instradate la notifica a un team o a un service owner nominato.
Cosa potrebbe essere coinvolto? Includete la lineage e il processo di business che dipende dall'asset.
Un alert utile potrebbe indicare che una tabella critica è arrivata al di fuori del suo normale schema di consegna, identificare la partizione mancante, mostrare la dipendenza del reporting a valle e indicare il job di ingestion responsabile. “Rilevata anomalia di volume” non è un workflow di gestione degli incidenti. È un invito ad avviare un'indagine manuale.
Le soglie statistiche aiutano a ridurre le chiamate arbitrarie. Usate 3 deviazioni standard per gli alert critici e 2 per gli avvisi quando il comportamento storico è stabile, poi sopprimete le notifiche duplicate finché un incidente resta aperto. Per dati stagionali, sparsi o in rapido cambiamento, una baseline appresa può funzionare meglio di una regola fissa, ma ha comunque bisogno di un owner e di una policy di severità consapevole del business.
Misurare la qualità del rilevamento, non il volume delle notifiche
Il mean-time-to-detect è spesso la misura di affidabilità più rivelatrice, perché i team possono risolvere un problema solo dopo averne scoperto l'esistenza. Uno studio di settore del 2026 ha riportato che i team dati gestivano in media 67 incidenti al mese, con il 68% che richiedeva più di 4 ore per rilevare i problemi e una media di 15 ore per risolverli, secondo la copertura del sondaggio di Integrate.io. L'implicazione operativa è chiara: ridurre il ritardo di rilevamento può creare più valore che aggiungere un'altra dashboard.
Tracciate gli alert rumorosi che non hanno richiesto alcuna azione, gli alert senza owner assegnato, gli alert ripetuti per un'unica causa principale e gli incidenti scoperti per primi dagli utenti di business. Poi affinate le soglie, consolidate i segnali correlati ed eliminate i controlli che non cambiano alcuna decisione.
Una dashboard della qualità dei dati mirata dovrebbe aiutare chi interviene a vedere trend e incidenti irrisolti, non limitarsi a mostrare un lungo inventario di controlli. Il programma di observability più solido non è quello con più alert. È quello a cui gli ingegneri credono abbastanza da agire.
Implementare l'observability in ambienti regolamentati e on-premises
Un design SaaS-first spesso presume che metadati e campioni possano spostarsi liberamente verso un servizio esterno. Questa ipotesi crolla nei servizi finanziari, nella sanità, nelle telecomunicazioni e nel settore pubblico, dove residenza dei dati, auditabilità, controllo degli accessi e revisione di sicurezza condizionano ogni decisione architetturale.
Lo schema di implementazione di cui mi fido in questi ambienti mantiene i dati di produzione all'interno del perimetro del cliente. L'esecuzione in-database calcola le metriche dove i dati già risiedono, mentre il livello di observability riceve metadati autorizzati, risultati delle metriche e contesto degli incidenti invece di record di produzione senza restrizioni.
Una sequenza di deployment che supera la revisione di sicurezza
Partite dal diagramma dei flussi di dati. Documentate dove vengono eseguiti i controlli, cosa esce dal database, quale service account li esegue e dove vengono archiviati i risultati. I team di sicurezza possono esaminare un flusso specifico in modo molto più efficace di una promessa che un prodotto è “sicuro”.
Separate il calcolo delle metriche dai dati di indagine. Conteggi delle righe, timestamp di freshness, impronte dello schema e metriche di qualità aggregate possono essere sufficienti per il rilevamento. I campioni a livello di record dovrebbero essere opzionali, mascherati o vietati dove la policy lo richiede.
Usate perimetri di deployment privati. Un'installazione in private cloud o on-premises può essere eseguita all'interno della VPC, dell'account cloud o del data center del cliente. Mantenete connettori, scheduler, metadata store e interfacce utente all'interno di zone di rete approvate.
Rendete le evidenze di audit parte del design. Archiviate definizioni dei controlli, orari di esecuzione, risultati osservati, presa in carico, cambi di ownership e cronologia della remediation. Gli auditor di solito devono stabilire cosa è stato controllato, quando è stato eseguito, cosa è successo e chi ha risposto.
I team dovrebbero anche documentare esplicitamente le decisioni sulla residenza dei dati. La guida ai requisiti di residenza dei dati è un riferimento utile per decidere quali metadati possono attraversare confini regionali o organizzativi.
Gli ambienti eterogenei hanno bisogno di un contratto comune
Database legacy, piattaforme di warehouse, storage dei data lake, topic Kafka e strumenti di trasformazione raramente espongono metadati identici. Standardizzate l'output dell'observability invece di forzare ogni sorgente nello stesso metodo di strumentazione. Ogni integrazione dovrebbe pubblicare identità dell'asset, orario di aggiornamento, risultato di volume o completezza, stato dello schema, stato del controllo, owner e riferimenti di lineage.
Service account con privilegi minimi, accesso in sola lettura dove possibile, identificatori mascherati e credenziali separate per ogni ambiente riducono il raggio d'impatto del sistema di monitoraggio stesso. Testate il deployment in scenari di backup, failover e rete disconnessa prima del rollout in produzione.
Il compromesso è reale. I controlli in-database possono consumare risorse del warehouse, mentre la scansione esterna può semplificare l'onboarding ma creare attriti di governance. Misurate il costo delle query, pianificate la profilazione più onerosa lontano dai picchi di carico e usate in modo continuo controlli leggeri sui metadati, riservando una validazione più approfondita agli asset critici.
Scegliere la strategia di alerting giusta per il vostro data stack
La strategia di alerting dovrebbe seguire il comportamento dei dati, non le mode degli strumenti. Le soglie statiche sono facili da spiegare e da sottoporre ad audit. Le baseline statistiche si adattano alla variazione normale. Il machine learning può ridurre la creazione manuale di regole, ma introduce un comportamento del modello che i team di compliance e di piattaforma potrebbero voler ispezionare. La validazione deterministica resta essenziale ovunque una regola di business debba essere applicata in modo esatto.
Strategia | Ideale per | Limiti | Complessità di implementazione |
|---|---|---|---|
Soglie statiche | Conteggi prevedibili, limiti rigidi, finestre di consegna contrattuali | Cedono con stagionalità, crescita e drift graduale | Bassa |
Baseline statistiche | Comportamento di volume, freshness e distribuzione specifico del dataset | Richiedono un contesto storico sufficiente e un tuning accurato | Media |
Rilevamento delle anomalie con machine learning | Pattern complessi, comportamenti che cambiano e copertura ampia | Richiede spiegabilità, governance e revisione dei falsi positivi | Da media ad alta |
Validazione deterministica dei record | Controlli regolamentari, regole di business e requisiti esatti a livello di riga | Non può identificare pattern sconosciuti senza regole definite | Media |
Quando vincono le regole semplici
Usate una regola statica quando la condizione di errore è inequivocabile. Una partizione obbligatoria non arrivata, un tipo di dato vietato o un campo che deve soddisfare un vincolo di business definito dovrebbero produrre un risultato deterministico. Questi controlli sono più facili da testare, da spiegare agli auditor e da riprodurre durante la revisione di un incidente.
Le soglie statiche funzionano bene anche per feed stabili ad alto volume con limiti operativi chiari. Diventano fragili quando il comportamento normale cambia in base all'ora, alla stagione, al segmento di clientela o al ciclo di vita del prodotto. Una singola soglia globale spesso genera falsi positivi durante i picchi legittimi e non rileva il degrado lento.
Quando aiutano i metodi adattivi
Le baseline statistiche sono utili quando ogni dataset ha il proprio ritmo. Confrontate elementi omogenei, come la stessa ora o la stessa finestra di consegna, e conservate il contesto storico che ha portato all'alert. Il machine learning può estendere questo approccio a molti asset, ma gli ingegneri dovrebbero comunque pretendere un codice motivazione, una visualizzazione della baseline e un processo di override.
Il design più difendibile combina i metodi. Usate il rilevamento delle anomalie per una copertura ampia di freshness, volume e distribuzioni. Aggiungete controlli deterministici per i campi regolamentari, i requisiti contrattuali e la logica dei record critica per il business. Instradate entrambi nello stesso workflow di gestione degli incidenti, così chi interviene non deve riconciliare sistemi di alert separati.
Un livello di monitoraggio e reporting dovrebbe mostrare non solo se un controllo è fallito, ma anche il suo trend, l'owner, la severità e la rilevanza a valle. Le capacità di monitoraggio e reporting di digna sono un esempio di questo modello operativo combinato, accanto a strumenti costruiti attorno a test dbt, asserzioni nel warehouse o controlli di orchestrazione personalizzati.
Integrare l'observability nell'architettura di pipeline esistente
L'observability non dovrebbe richiedere una ricostruzione. Lo schema più sicuro aggiunge misurazioni ai confini già esistenti, poi invia i risultati a un workflow condiviso di incidenti e metadati senza bloccare ogni task su ogni controllo.

In Airflow, emettete metadati di esecuzione e completamento dai task dei DAG, poi eseguite controlli di freshness e completezza dopo la conferma della partizione di destinazione. In dbt, conservate i risultati dei test e i tempi dei modelli come eventi di observability a tutti gli effetti. I job Spark possono pubblicare conteggi di input e output, conteggi dei record scartati, impronte dello schema e dettagli delle partizioni. I consumer Kafka dovrebbero esporre lag, ritardo sull'event time, tassi di record malformati e comportamento del volume a livello di topic.
Posizionare i controlli dove rispondono a una domanda
Usate controlli sincroni quando proseguire creerebbe un rischio inaccettabile a valle. Un controllo di conformità dello schema prima di pubblicare un contratto condiviso o un controllo di completezza prima di rilasciare un dataset regolamentare possono ragionevolmente bloccare la fase successiva.
Usate controlli asincroni per la profilazione più ampia e l'analisi dei trend. Metriche di distribuzione, statistiche di colonna e confronti storici possono essere eseguiti accanto al percorso critico, purché l'alert risultante abbia un processo di contenimento chiaro. In questo modo si evita che ogni controllo analitico diventi un collo di bottiglia della pipeline.
La gestione dello schema merita una policy esplicita. Classificate colonne aggiunte, colonne rimosse e modifiche del tipo di dato come compatibili, da revisionare o bloccanti. Non fate fallire automaticamente ogni modifica additiva, ma non accettate una modifica del tipo di dato senza revisione, perché può cambiare il modo in cui i consumatori a valle interpretano i valori.
La lineage dovrebbe essere acquisita ai confini delle trasformazioni, non ricostruita durante un incidente. Memorizzate le relazioni sorgente-destinazione per task Airflow, modelli dbt, trasformazioni Spark e topic di streaming, poi associate i controlli agli asset che descrivono.
Principio di progettazione: l'observability dovrebbe rendere la pipeline più facile da gestire, non diventare un'ulteriore dipendenza che può bloccarla inutilmente.
Infine, usate i risultati dell'observability per migliorare l'architettura. Ritardi di freshness ripetuti possono rivelare una finestra di estrazione sovraccarica. Anomalie di volume persistenti possono indicare contratti deboli con le sorgenti. Una serie di incidenti di schema può giustificare interfacce versionate invece di ulteriori alert.
Partire in piccolo e scalare l'implementazione dell'observability
Monitorare tutto fin dal primo giorno crea un catalogo di controlli prima che il team sappia quali segnali contano. Iniziate con una sola pipeline critica, preferibilmente un asset che alimenta il reporting per il management, le operazioni con i clienti, le attività regolamentari o un modello in produzione. Classificate i candidati in base a impatto sul business, storico degli incidenti, profondità delle dipendenze e difficoltà di rilevare i guasti manualmente.
Un rollout per fasi è più facile da difendere, perché ogni fase produce evidenze operative.
Giorni 1–30: mappate la pipeline selezionata, identificate owner e consumatori a valle, definite gli SLI di freshness, successo dei job, completezza e schema e registrate la baseline.
Giorni 31–60: aggiungete validazione della distribuzione o a livello di record dove la prima fase rivela dei rischi. Affinate le soglie di avviso e critiche, instradate gli alert ai team responsabili e documentate il workflow di risposta.
Giorni 61–90: esaminate incidenti e quasi-incidenti, eliminate i controlli rumorosi, aggiungete il contesto di lineage, misurate il mean-time-to-detect e scegliete la pipeline successiva in base al rischio dimostrato, non all'entusiasmo.
Misurate i risultati che cambiano le decisioni di engineering. Il mean-time-to-detect mostra se il team viene a conoscenza dei guasti prima. Il volume degli incidenti e le cause principali ricorrenti rivelano se il monitoraggio sta riducendo il carico operativo. I guasti a valle evitati dimostrano il valore ad analisti, stakeholder della compliance e business owner.
L'adozione dipende anche dall'ownership. Assegnate a ogni dataset critico un owner tecnico, definite chi può prendere in carico o sopprimere un alert e richiedete una motivazione quando un controllo viene disattivato. Esaminate i falsi positivi dopo gli incidenti, non solo durante una revisione annuale degli strumenti.
digna può supportare questo modello per fasi con esecuzione in-database, deployment in private cloud o on-premises, rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema. Se il vostro ambiente non può spostare i dati di produzione su una piattaforma SaaS, valutate se l'architettura preserva quel confine offrendo comunque agli ingegneri un contesto degli incidenti utilizzabile.
Usate i primi 90 giorni per strumentare una pipeline critica per il business, stabilire baseline affidabili e misurare la qualità del rilevamento prima di estendere la copertura. Per valutare un approccio all'interno del vostro ambiente per warehouse, data lake e flussi di dati regolamentati, visitate digna e approfondite come la sua piattaforma modulare di observability può integrarsi nella vostra architettura esistente.
Domande frequenti
Cosa aggiunge l'observability al monitoraggio delle pipeline?
L'ispezione dei dati stessi. Il monitoraggio delle pipeline resta importante, perché indica se i job sono stati eseguiti e se l'infrastruttura ha retto, ma non può segnalare che un batch è terminato in verde mentre la dashboard che alimenta è già sbagliata.
Quali sono i cinque pilastri?
Freshness, distribuzione, schema, lineage e volume. La freshness indica se i dati sono arrivati entro la pianificazione prevista, il volume confronta la quantità con il comportamento normale, lo schema traccia colonne e tipi, la distribuzione osserva pattern di null, intervalli e unicità, e la lineage collega un incidente agli asset e ai team coinvolti.
In cosa differisce l'observability dalle regole di qualità dei dati?
Risolvono problemi correlati ma diversi. Le regole codificano condizioni che qualcuno sapeva già di dover mettere per iscritto; l'observability descrive comportamenti che nessuno ha specificato in anticipo. Per questo un team che dispone solo di uno dei due continua a essere sorpreso in una direzione prevedibile.
Che aspetto ha una pipeline guasta che non è fallita?
Una dashboard di orchestrazione che alle 9:00 mostra un job notturno completato con successo mentre i dati prodotti sono sbagliati. La pipeline non è fallita nel senso convenzionale, ed è proprio per questo che il monitoraggio dello stato dei job ha segnalato un successo.
Da dove dovrebbe iniziare un ingegnere?
Dai dataset il cui comportamento sarebbe più difficile da ricostruire a posteriori. Strumentarli per primi fornisce la lineage e lo storico che trasformano il prossimo incidente in una breve indagine invece che in uno scavo archeologico.


