Data governance e qualità dei dati: una guida pratica
|
8
min di lettura

Nel 2024, il 62% delle organizzazioni ha indicato la mancanza di data governance come la principale sfida legata ai dati che frena le iniziative di AI, mentre il 51% ha citato la data governance tra le maggiori sfide di integrità dei dati, subito dopo la qualità dei dati, secondo la ricerca globale pubblicata da Precisely. Questo dato cambia il punto di partenza: un'AI e un'analisi affidabili non dipendono dal lavoro sulla qualità dei dati o da quello sulla governance presi isolatamente. Dipendono da un sistema di controllo che assegna le responsabilità, definisce l'idoneità all'uso, misura i difetti, rileva i cambiamenti e indirizza i problemi alle persone in grado di risolverli.
Questa guida tratta data governance e qualità dei dati come una disciplina operativa, non come un esercizio di policy. Vedrete come distinguere le due, trasformare le dimensioni della qualità in KPI, combinare regole deterministiche e observability, costruire un modello operativo basato sulla responsabilità ed estendere questi controlli ai carichi di lavoro di AI. La domanda pratica, dall'inizio alla fine, è semplice: chi decide, che cosa si misura, che cosa succede quando i dati falliscono e come fa il business a sapere che il programma funziona?
Indice
Perché data governance e qualità dei dati oggi sono collegate
Le dimensioni fondamentali della qualità dei dati che potete davvero misurare
Dalle regole all'observability: che cosa intercetta che cosa
Rendere i vostri dati pronti per l'AI con la governance come spina dorsale
Dimostrare il valore della governance oltre le checklist di compliance
Un piano di 90 giorni per allineare la governance al vostro programma di qualità
Perché data governance e qualità dei dati oggi sono collegate
Le organizzazioni non possono scalare l'AI aggiungendo documenti di governance a dataset inaffidabili. La ricerca 2024 di Precisely collega una governance debole a una preparazione all'AI che si arena e a problemi più ampi di integrità dei dati, mostrando che governance e qualità operano come condizioni collegate e non come filoni di lavoro separati. La governance stabilisce chi è responsabile di un dataset critico, che cosa significa “valido” e come vengono gestite le eccezioni. La misurazione della qualità mostra se quelle decisioni funzionano in produzione.
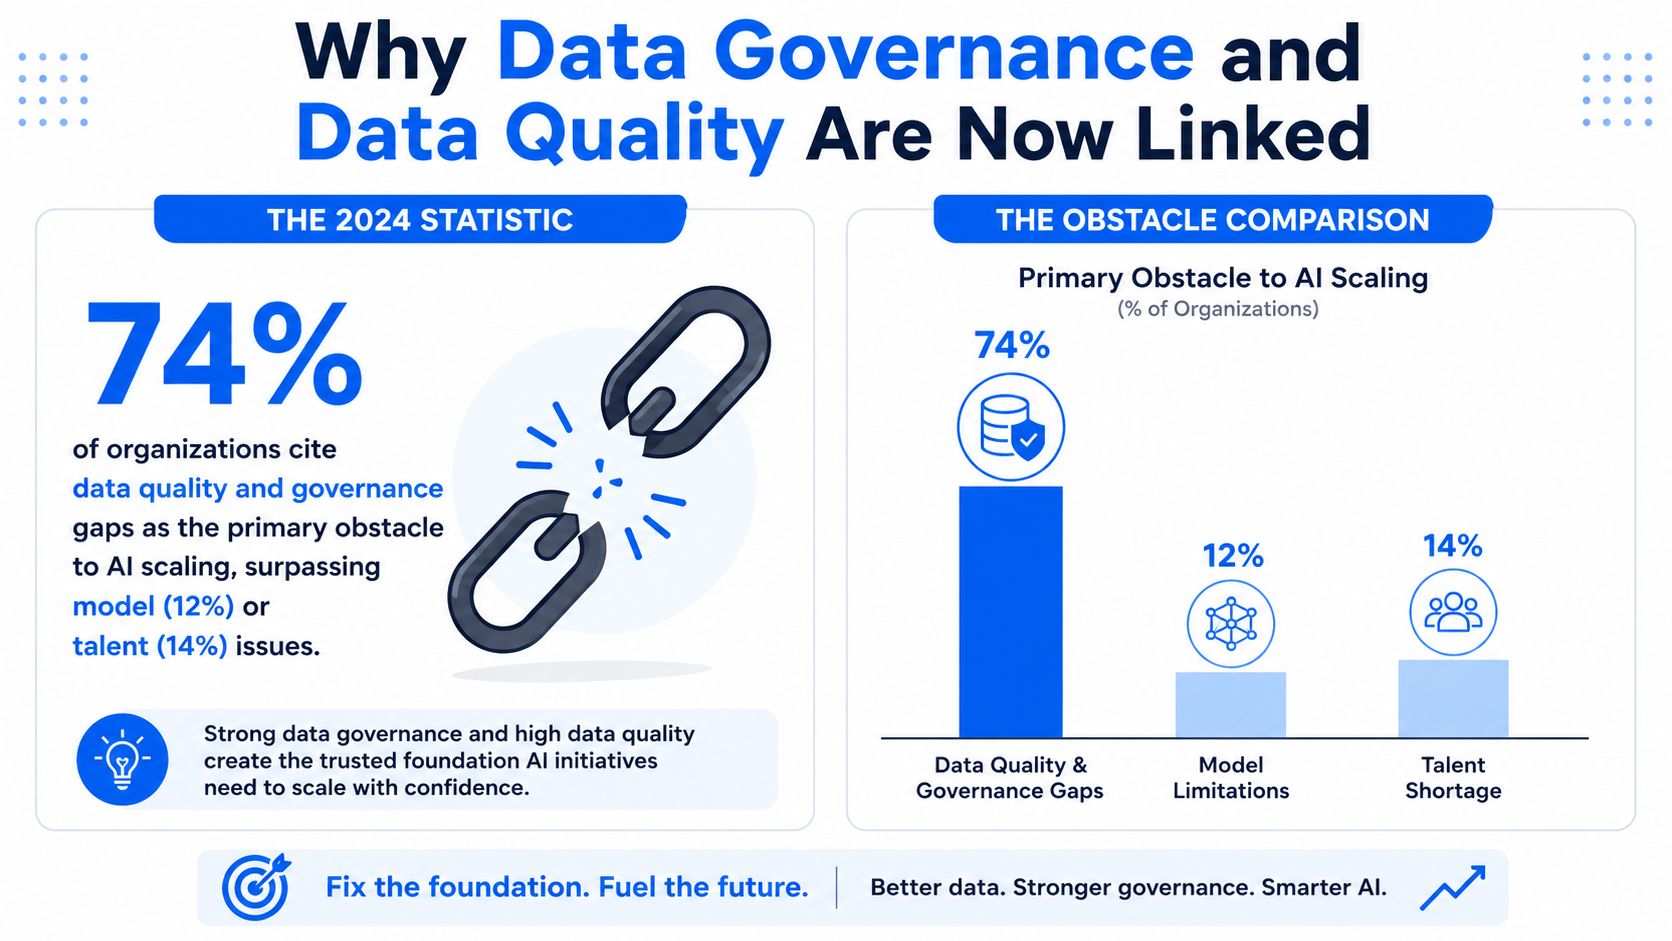
Il dato del 74% riportato nell'infografica e il confronto con i problemi di modelli e competenze non sono supportati dai dati verificati disponibili, quindi non vanno usati come prova. Il risultato verificato è comunque abbastanza forte da riformulare il problema. Un team di modellazione può ottimizzare gli algoritmi e un team di ingegneria può aumentare la capacità delle pipeline, ma nessuno dei due può risolvere responsabilità ambigue, definizioni in conflitto, lineage mancante o dati che arrivano troppo tardi per la decisione che dovrebbero supportare.
I programmi di governance più datati misuravano spesso il successo con la pubblicazione di policy, comitati e workflow di approvazione. Questi elementi contano ancora, ma non dimostrano che un record cliente sia completo, che un evento finanziario sia arrivato in tempo o che una dashboard utilizzi la fonte prevista. La descrizione della data governance del Government Accountability Office statunitense la presenta come un insieme di strutture organizzative e strumenti di supporto pensati per migliorare la qualità e la disponibilità dei dati. Questa impostazione indica la governance come infrastruttura di gestione, non come burocrazia.
Partite dal ciclo di controllo
Un ciclo di controllo pratico ha quattro parti:
Definire il requisito. Indicate che cosa devono contenere i dati, quanto devono essere aggiornati e quale caso d'uso supportano.
Assegnare la responsabilità. Nominate l'owner che può approvare la regola e lo steward che gestisce le eccezioni quotidiane.
Misurare e osservare. Usate controlli di qualità, segnali di freshness, lineage e alert operativi.
Correggere e imparare. Correggete la fonte, aggiornate la regola o modificate il requisito quando cambia l'uso di business.
Questo approccio che parte dal modello operativo aiuta i team a valutare la propria maturità in modo accurato. Un programma con un catalogo ma senza owner è incompleto. Una dashboard piena di punteggi di qualità ma senza un percorso di correzione è solo decorativa. Una policy senza un controllo misurabile è un'intenzione, non governance.
Per una spiegazione più ampia del perché la governance supporta compliance, adozione dell'AI e fiducia del business, leggete perché la data governance è essenziale per compliance, AI e fiducia del business. Il passo successivo utile non è scegliere subito una piattaforma. Prima individuate gli elementi di dati critici che influenzano le decisioni, poi collegate ciascuno di essi a una definizione, un owner, una soglia e una risposta.
Le due discipline e come si rafforzano a vicenda
Un punteggio di qualità ha senso solo quando qualcuno ha definito l'uso previsto e il risultato accettabile. La data governance fornisce questo sistema di controllo: stabilisce diritti decisionali, responsabilità, policy, standard e percorsi di escalation. La qualità dei dati fornisce le prove: se un asset di dati soddisfa il requisito nell'uso reale.
La relazione si vede meglio con un esempio semplice. Un indirizzo cliente può essere adeguato per segmentare una campagna regionale ma inadatto alle spedizioni. Un timestamp di transazione può supportare il reporting giornaliero e arrivare comunque troppo tardi per un processo di controllo antifrode. Per questo la ISO 8000 considera la qualità dipendente dal contesto e non assoluta, come spiegato nella guida su come la data governance si allinea alla gestione della qualità dei dati.
La governance definisce le condizioni di misurazione. Il monitoraggio della qualità mostra se quelle condizioni sono rispettate.
Dimensione | Data governance | Qualità dei dati |
|---|---|---|
Domanda principale | Chi decide come vengono gestiti i dati? | I dati sono idonei all'uso previsto? |
Meccanismo principale | Ruoli, policy, standard, workflow e responsabilità | Misurazioni, validazione, profiling, monitoraggio e correzione |
Output tipico | Definizioni approvate, registri di ownership, regole di accesso e percorsi di escalation | Punteggi di qualità, controlli falliti, incidenti, trend e azioni correttive |
Condizione di successo | Le persone applicano le decisioni in modo coerente lungo tutto il ciclo di vita dei dati | I dati critici soddisfano i requisiti concordati per uno scopo di business |
Il ciclo di feedback conta più delle etichette. Valori null ripetuti possono riflettere un processo di origine debole, una definizione di business poco chiara, uno steward poco efficace o un controllo che viene eseguito dopo che gli utenti a valle hanno già consumato i dati. Il risultato di qualità individua il sintomo. La governance stabilisce chi indaga, quale decisione si applica e come il problema viene corretto.
Tre confini mantengono chiaro il modello operativo:
La governance non è sicurezza. La sicurezza protegge riservatezza, integrità e disponibilità attraverso controlli come la gestione degli accessi. La governance stabilisce il quadro più ampio di responsabilità e decisioni in cui quei controlli operano.
Qualità non significa pulizia. I valori possono sembrare disordinati ed essere comunque idonei a uno scopo definito. Un dataset curato può restare errato, obsoleto o incoerente rispetto a una fonte autorevole.
Un catalogo non è governance. Un catalogo registra asset e metadati. La governance aggiunge diritti decisionali, owner, standard, workflow e conseguenze quando i requisiti non vengono rispettati.
La chiarezza dei ruoli evita che l'ufficio centrale di governance diventi un collo di bottiglia. Gli owner approvano definizioni e requisiti, gli steward gestiscono il significato operativo e le eccezioni, i custodian supportano i controlli tecnici e i consumer utilizzano i dati entro le condizioni concordate. Questa guida pratica ai ruoli della data governance può aiutare i team a distinguere queste responsabilità. Con questa separazione, i risultati di qualità diventano segnali di controllo osservabili e non avvisi isolati su una dashboard, e l'organizzazione può valutare se i propri dati sono pronti per analisi o AI affidabili.
Le dimensioni fondamentali della qualità dei dati che potete davvero misurare
Una dimensione della qualità diventa utile solo quando è legata a un uso di business, un ruolo responsabile, una soglia, una frequenza di misurazione e un percorso di correzione. Senza questi elementi, una dashboard può mostrare punteggi gradevoli mentre gli utenti continuano a ricevere dati inaffidabili.
Le sei dimensioni seguenti sono ampiamente pratiche perché corrispondono direttamente a schemi di errore osservabili.
Trasformate le dimensioni in controlli operativi
L'accuratezza verifica se un valore rappresenta la realtà. Un processo di validazione potrebbe confrontare lo stato del cliente con una fonte operativa autorevole, con il data owner che approva la regola di confronto.
La completezza verifica se i valori obbligatori sono presenti. Per i dati personali (PII) dei clienti, il requisito potrebbe essere una soglia di completezza definita e misurata ogni giorno, con un data steward responsabile delle eccezioni e del coordinamento della correzione alla fonte.
La coerenza controlla se lo stesso concetto segue la stessa definizione in tutti i sistemi. Se “cliente attivo” è diverso tra vendite e finanza, è l'owner del dominio a dover risolvere la definizione, invece di chiedere agli analisti di riconciliarla ogni volta.
La tempestività misura se i dati arrivano quando la decisione ne ha bisogno. Un programma di governance può usare la formula Conformità allo SLA di tempestività = consegne di dati disponibili in tempo divise per il totale delle consegne attese, moltiplicate per 100, come descritto nella guida di digna sui KPI di data governance. Di solito il team di ingegneria della fonte è responsabile dei mancati arrivi, mentre l'owner di business conferma se lo SLA supporta il caso d'uso.
L'unicità impedisce rappresentazioni duplicate della stessa entità. Gli identificativi delle controparti possono essere controllati in fase di ingestion, con la governance che approva le regole di matching e l'owner del dominio che accetta le eccezioni residue.
La validità verifica se i valori sono conformi a un formato, un intervallo, un elenco o una regola di business accettati. Uno steward può gestire le eccezioni, ma di solito è il custodian a implementare il controllo tecnico nel punto in cui i record non validi entrano nella piattaforma.
Dimensione | Esempio di KPI / SLA | Errore tipico | Ruolo responsabile |
|---|---|---|---|
Accuratezza | Corrispondenza con una fonte autorevole approvata | Stato, importo o identificativo errato | Data owner |
Completezza | I campi obbligatori raggiungono la soglia concordata | Attributi critici null o mancanti | Data steward |
Coerenza | Una definizione condivisa produce valori allineati tra i sistemi | Stati di clienti o prodotti in conflitto | Owner del dominio |
Tempestività | La consegna rispetta la finestra di arrivo concordata | Caricamento in ritardo, mancante o anticipato | Team di ingegneria della fonte |
Unicità | Il tasso di collisione degli identificativi o di duplicati resta entro la tolleranza | Più record per una stessa controparte | Data owner e steward |
Validità | I valori sono conformi a regole o valori di riferimento approvati | Formato, intervallo o codice non valido | Data custodian |
I team di qualità possono avere bisogno anche di segnali operativi al di fuori delle sei dimensioni fondamentali. Per esempio, un team che valuta le funzionalità di monitoraggio in tempo reale delle SERP API dovrebbe comunque ricondurre l'output del monitoraggio a un data owner nominato e a un requisito di business documentato. Lo strumento può far emergere i comportamenti, ma è la governance a decidere quali scostamenti contano e quale risposta è richiesta.
Una utile panoramica sulle dimensioni della qualità dei dati aiuta i team a costruire un vocabolario comune. Il lavoro più difficile è selezionare solo i controlli che influenzano le decisioni e poi rendere qualcuno responsabile di ogni eccezione.
Dalle regole all'observability: che cosa intercetta che cosa
Le regole di qualità tradizionali sono precise e preziose. Intercettano i difetti che il team conosce già, come valori null in campi obbligatori, valori fuori da un intervallo approvato, codici di riferimento non validi, relazioni interrotte o uno schema che non corrisponde più a un contratto. Questi controlli sono deterministici, spiegabili e spesso necessari come evidenza per i regolatori.
L'observability risponde a una domanda diversa: che cosa è cambiato nel sistema di dati che potrebbe rendere inaffidabile un output considerato attendibile? Sorveglia caricamenti in ritardo o mancanti, volumi insoliti, variazioni nelle distribuzioni, cambiamenti strutturali ed esposizione a valle. La spiegazione della data observability di Databricks descrive il ruolo dei controlli su freshness, distribuzione, schema e lineage. Ciascuno intercetta una diversa modalità di errore.
Usate entrambi i livelli in modo consapevole
Metodo di rilevamento | Errore intercettato | Strumenti tipici | Caso d'uso ideale |
|---|---|---|---|
Regola di validazione | Valore non valido, campo mancante o condizione di business non soddisfatta | Motore di qualità dei dati o controllo SQL | Controlli contrattuali e normativi |
Controllo dello schema | Rimozione o aggiunta di colonne, cambio di tipo | Schema registry o schema tracker | Compatibilità delle pipeline |
Riconciliazione | Discrepanza tra totali o chiavi di origine e destinazione | Workflow di confronto batch | Trasferimenti finanziari e operativi |
Monitoraggio della freshness | Consegna dei dati in ritardo o assente | Piattaforma di observability o scheduler | Reporting sensibile ai tempi |
Monitoraggio delle distribuzioni | Drift nei tassi di null, negli intervalli o negli schemi dei valori | Profiling e anomaly detection | Dataset che si degradano lentamente |
Alert basato sul lineage | Dashboard o modelli a valle a rischio | Catalogo e grafo del lineage | Analisi d'impatto e prioritizzazione |
Le regole danno il meglio quando il requisito è noto e stabile. Se un campo obbligatorio non deve mai essere vuoto, codificate questa aspettativa. Se un codice prodotto valido deve provenire da un insieme di riferimento approvato, applicatelo al confine. Non sostituite un controllo esplicito con un punteggio di anomalia non spiegato.
L'observability dà il meglio quando l'errore è indiretto o sconosciuto. Un fornitore può modificare il proprio output senza violare alcuna regola documentata sui campi. Una pipeline può continuare a girare consegnando partizioni obsolete. Una feature può mantenere lo stesso schema mentre la sua distribuzione cambia abbastanza da influenzare un modello.
Regola pratica: usate l'observability per scoprire gli schemi di errore ricorrenti, poi trasformate quelli importanti in regole esplicite con owner e tempi di risposta.
Un programma maturo combina gli approcci a più livelli. Partite dall'observability per trovare le modalità di errore sconosciute, aggiungete regole deterministiche per i requisiti noti e collegate entrambe al lineage, così che i team possano dare priorità agli output colpiti. La distinzione tra data observability e qualità dei dati è utile in questo contesto: i controlli di qualità valutano aspettative definite, mentre l'observability offre una visibilità più ampia sul comportamento mutevole del sistema.
Costruire il modello operativo dietro le policy
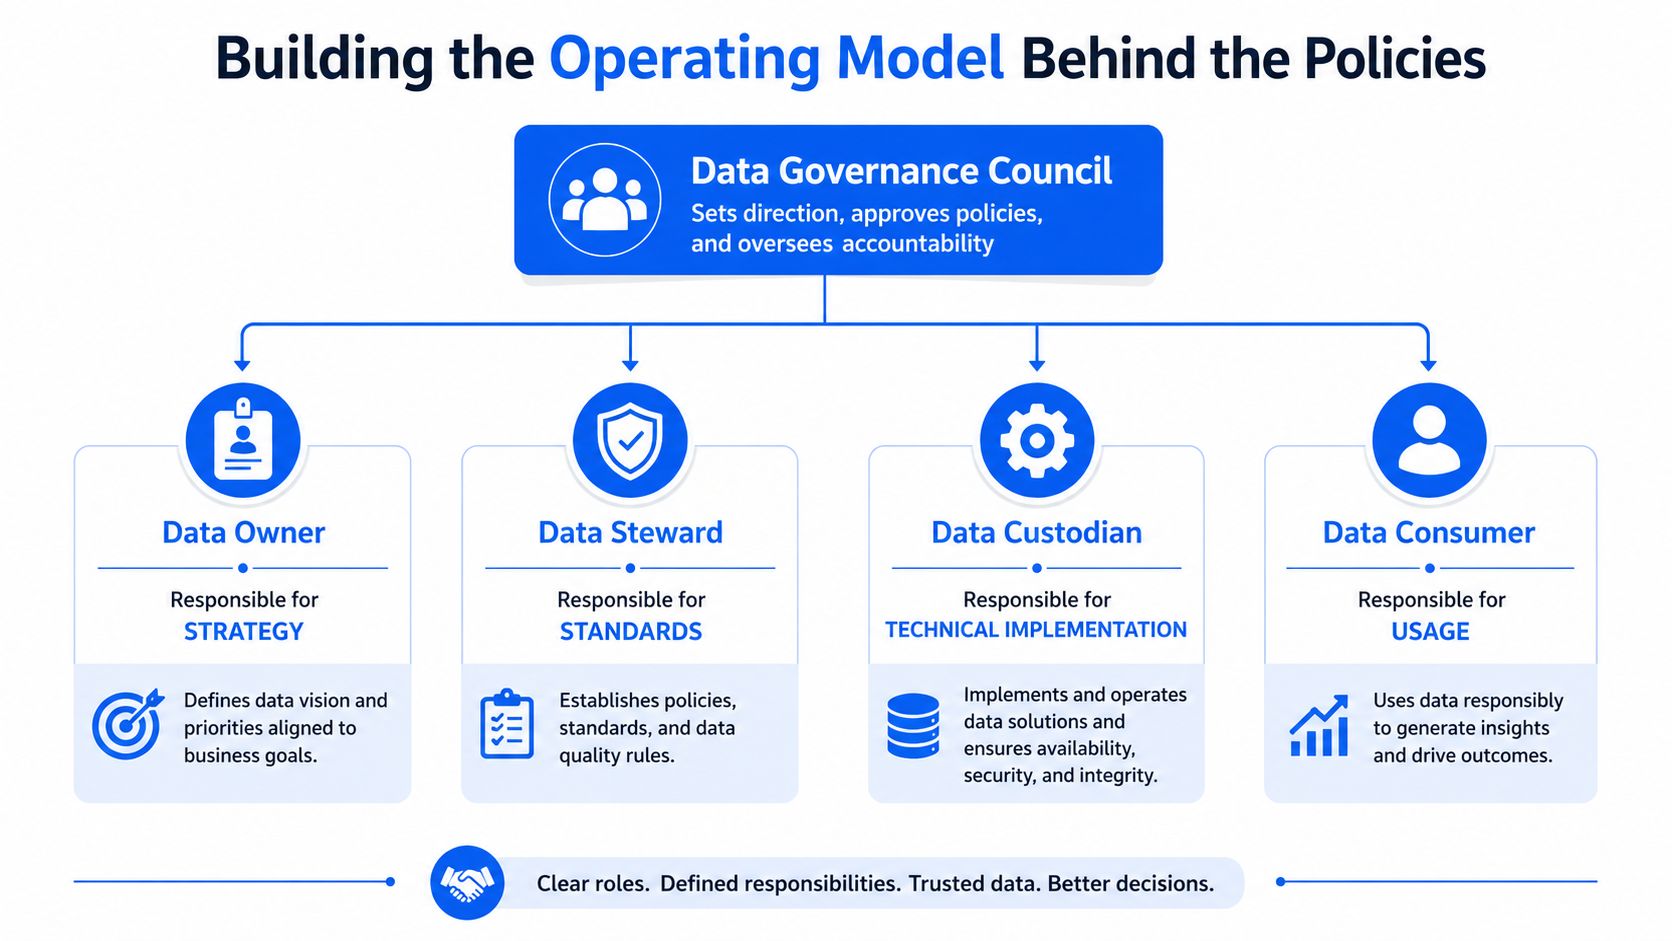
Una policy diventa operativa solo quando una persona sa rispondere senza esitazioni a tre domande: chi è responsabile di questi dati, quale standard si applica e chi corregge un errore? Se nessuno sa rispondere, l'organizzazione ha documentazione ma non controllo.
Partite da quattro ruoli:
Data owner: prende le decisioni di business sull'asset, approva definizioni, soglie, aspettative di accesso e trattamento del rischio.
Data steward: gestisce le definizioni, monitora i problemi di qualità, coordina le correzioni e mantiene il contesto di business.
Data custodian: implementa storage tecnico, accessi, pipeline, validazione, monitoraggio e controlli delle modifiche.
Data consumer: utilizza i dati per operazioni, reporting, analisi o modelli e segnala quando non rispondono allo scopo previsto.
Date al consiglio veri diritti decisionali
Un consiglio di stewardship non dovrebbe esistere solo per esaminare presentazioni. Ha bisogno dell'autorità per approvare definizioni condivise, dare priorità agli elementi di dati critici, risolvere i conflitti tra domini, accettare rischi ed escalare i problemi che superano i confini organizzativi. Il consiglio può indicare la direzione, ma sono gli steward integrati nei team a dover gestire il lavoro quotidiano, vicino alla fonte e al processo di business.
La ownership può essere organizzata per dominio, per asset o per dataset. La ownership per dominio funziona bene quando i dati di clienti, finanza, prodotti o supply chain hanno una leadership di business coerente. La ownership per asset è più precisa per tabelle o report ad alto rischio. La ownership a livello di dataset è utile quando una singola pipeline ha uno scopo circoscritto ma importante.
Scegliete la struttura e collegate gli strumenti
Un modello centralizzato offre standard coerenti ed escalation più semplici, ma può allontanarsi dal contesto operativo. Un modello federato dà ai domini più controllo e conoscenza locale, ma richiede standard condivisi per evitare la frammentazione. Un modello hub-and-spoke combina una funzione centrale di governance con steward di dominio che eseguono i controlli dove i dati vengono creati e utilizzati.
Catalogo, glossario, sistema di lineage, motore di qualità e strumenti di gestione degli accessi dovrebbero rafforzarsi a vicenda. Il glossario definisce che cos'è un “evento di ricavo”. Il catalogo ne identifica gli asset. Il lineage mostra dove viaggia il valore. Il monitoraggio della qualità verifica il requisito. I controlli di accesso stabiliscono chi può usarlo. Un workflow di gestione degli incidenti registra la decisione e la correzione.
Assegnate gli SLA agli elementi di dati critici, non a tutte le colonne allo stesso modo. Un timestamp di ricavo, un identificativo paziente o una classificazione normativa possono richiedere controlli espliciti. Gli attributi a minor rischio possono avere un monitoraggio più leggero. Questa prioritizzazione mantiene la governance concreta ed evita che il programma diventi un esercizio di inventario ingestibile.
Rendere i vostri dati pronti per l'AI con la governance come spina dorsale
La preparazione all'AI dipende dalla capacità dei team di osservare e controllare i dati alla base di un modello. Una tabella pulita e una voce di catalogo non mostrano da dove provengono gli esempi di training, quali trasformazioni li hanno modificati, che cosa significano le etichette o se i dati sono approvati per l'uso previsto. I team devono anche confrontare la feature di produzione con quella di training prima che un modello entri in esercizio.
Lineage e provenienza forniscono questo sistema di controllo. Per ogni dataset di AI, registrate la fonte, la cronologia delle trasformazioni, l'owner, le condizioni di accesso, la base di consenso o di licenza pertinente e il caso d'uso approvato. Collegate il record al modello, al set di valutazione, alla pipeline delle feature, al contesto dei prompt e al processo di monitoraggio. Questa catena rende la qualità osservabile, perché un controllo fallito può essere ricondotto a una fonte, a una trasformazione o al responsabile di una decisione.
I controlli giusti dipendono dal carico di lavoro. Un modello antifrode può richiedere controlli più stringenti su freshness ed etichette rispetto a una dashboard periodica sul churn. Un sistema di raccomandazione può dipendere dall'ordine degli eventi e da feature coerenti. Un'applicazione di AI generativa può basarsi sul contesto di retrieval, sulla provenienza dei documenti, sui controlli dei duplicati e sulla protezione da materiale di origine obsoleto. Per una spiegazione pratica del perché l'AI generativa dipende da dati di origine affidabili, leggete qualità dei dati e AI generativa.
Usate controlli specifici per il carico di lavoro:
Coerenza delle feature: verificate che le pipeline di training e di serving utilizzino definizioni e trasformazioni compatibili.
Qualità delle etichette: tracciate le etichette ambigue, mancanti o contraddittorie e indirizzate le contestazioni agli steward di dominio.
Dati di valutazione: proteggete i dataset di valutazione rappresentativi da contaminazioni accidentali e documentatene l'ambito previsto.
Monitoraggio dei bias: verificate se la copertura e gli schemi di etichettatura producono prestazioni disomogenee tra i gruppi rilevanti.
Instradamento del feedback: inviate gli errori del modello sia al data steward responsabile sia al team del modello.
Analisi recenti collegano la compliance dell'AI alla data governance e riportano che la qualità dei dati resta la sfida principale in sette domande su otto relative all'integrità dei dati. Riportano inoltre che il 48% delle organizzazioni non aveva implementato programmi per governare i dati utilizzati per l'AI, secondo l'analisi di DataVersity sui framework di governance e sulla compliance dell'AI. L'implicazione operativa è chiara: un programma di AI che non può tracciare e misurare i propri input ha un punto cieco strutturale.
La governance, quindi, certifica l'idoneità a uno specifico carico di lavoro di AI. Non etichetta un dataset come universalmente “pronto per l'AI”. I team possono esprimere questo giudizio solo definendo l'uso previsto, misurando le dimensioni di qualità pertinenti e osservando queste misure lungo l'intero ciclo di vita dei dati e del modello.
Dimostrare il valore della governance oltre le checklist di compliance
Un programma di governance dimostra il proprio valore quando mostra che cosa è cambiato nel business, non solo quali policy sono state completate. Le evidenze di compliance contano ancora, ma i leader hanno bisogno anche di un collegamento chiaro tra un errore nei dati, il controllo applicato e il risultato operativo.
La sintesi di Board del report State of Enterprise Data Governance riporta che il 39% dei data leader fatica a dimostrare l'impatto della governance al vertice aziendale. La stessa sintesi descrive team che si affidano soprattutto a misure operative anziché a risultati di business. Aggiungere riquadri alle dashboard non colmerà questo divario. Le misure devono collegarsi a decisioni che i dirigenti già comprendono.
Partite dalla decisione, poi risalite ai dati e al controllo che la sostengono. Per esempio, una decisione di pianificazione rimandata può dipendere da input obsoleti, da un owner poco chiaro o da un'eccezione di qualità rimasta irrisolta. Questa catena di evidenze rende la governance osservabile. Offre inoltre ai team un modo pratico per verificare se un controllo protegge davvero un processo di business.
Tra le misure utili:
Riduzione degli incidenti: registrate gli incidenti sui dati, la loro gravità, le rilavorazioni che generano e il tempo impiegato per diagnosticarli e correggerli.
Affidabilità delle decisioni: collegate freshness, accuratezza o completezza dei dati critici alle decisioni su campagne, sottoscrizione dei rischi, previsioni o pianificazione operativa.
Risposta al rischio: misurate il tempo necessario per individuare gli asset coinvolti, raccogliere le evidenze e spiegare una modifica dei dati tramite il lineage e i registri di ownership.
Adozione e risoluzione: verificate se gli steward risolvono i problemi assegnati e se i consumer usano asset affidabili invece di mantenere estrazioni private.
Attività di governance | KPI di business | Fonte della misurazione | Cadenza di reporting |
|---|---|---|---|
Monitorare gli elementi di dati critici | Carico di rilavorazioni o incidenti | Workflow dei problemi e registri di servizio | Mensile |
Applicare controlli di tempestività | Decisioni rimandate a causa di dati obsoleti | Monitor delle consegne e log dei processi di business | Settimanale o mensile |
Mantenere il lineage | Tempo necessario per l'analisi d'impatto | Lineage e registri di audit | Trimestrale |
Risolvere le eccezioni di qualità | Tempo dal rilevamento alla correzione | Workflow di stewardship | Mensile |
Standardizzare le definizioni chiave | Report o riconciliazioni in conflitto | Glossario e revisione del reporting | Trimestrale |
Queste cadenze sono raccomandazioni operative, non requisiti universali. Stabilite una baseline del processo attuale prima di dichiarare miglioramenti, registrate la fonte di ogni KPI e spiegate i risultati nel linguaggio del business. “La completezza è migliorata” pesa meno di “il team di pianificazione ha smesso di ricostruire lo stesso report perché i suoi input erano disponibili e definiti in modo coerente”.
Una singola percentuale di completezza può anche nascondere errori prioritari. Pochi valori mancanti possono incidere su una decisione ad alto impatto, mentre molti campi di scarso valore restano completi. Per le organizzazioni che gestiscono un'esposizione complessa verso i fornitori, ridurre il rischio di governance nelle supply chain offre un modo utile per collegare i controlli sui dati alle discussioni sul rischio operativo e di terze parti.
Un piano di 90 giorni per allineare la governance al vostro programma di qualità
Un lavoro di allineamento mirato dovrebbe produrre controlli funzionanti, non un grande archivio di policy. Organizzate le attività in sequenza in modo che il team impari da dati reali, owner reali e incidenti reali.
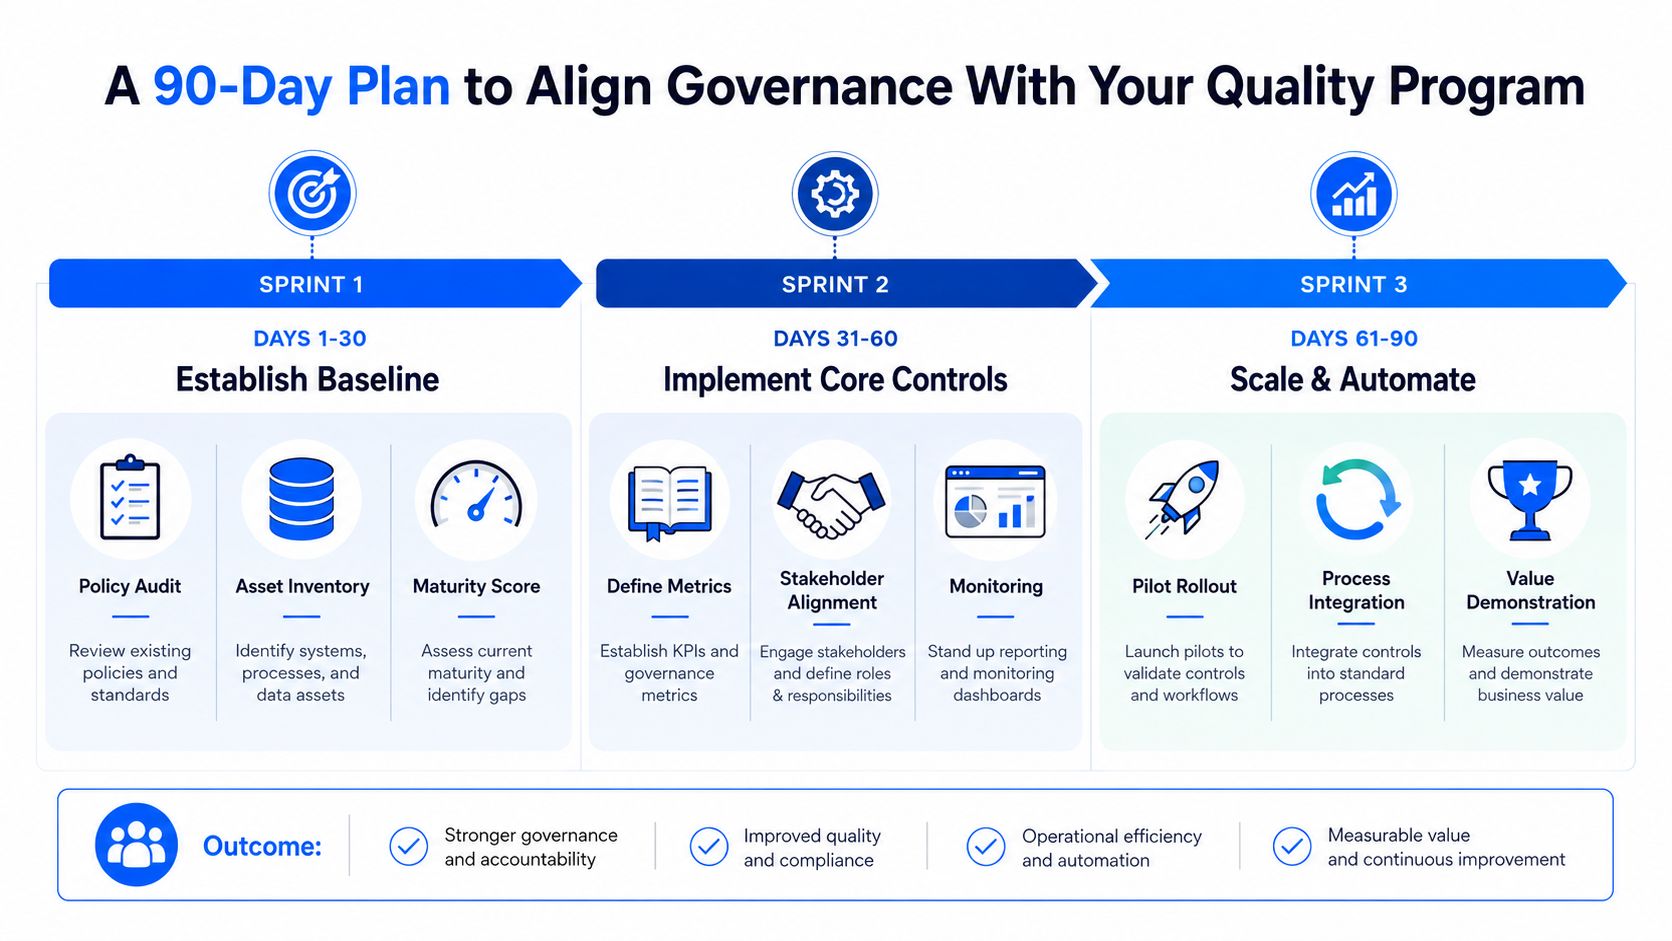
Giorni 1-30: stabilire la baseline
Esaminate le policy esistenti e individuate le contraddizioni. Fate l'inventario degli asset di dati che supportano report importanti, processi operativi e carichi di lavoro di AI. Per ogni asset, registrate owner, steward, fonte, utenti, difetti noti e uso previsto. Scegliete uno sponsor esecutivo e confermate quali steward possono prendere decisioni o escalarle.
Non aspettate l'acquisto di una piattaforma. Un foglio di calcolo strutturato, un registro dei problemi, query sul data warehouse e un glossario condiviso possono stabilire la prima baseline. L'obiettivo è far emergere le lacune di ownership e di misurazione, non creare un catalogo perfetto.
Giorni 31-60: allineare la strumentazione
Definite SLA a livello di dominio per gli elementi di dati critici individuati nel primo sprint. Collegate i segnali di freshness, schema, validazione e anomalie al workflow di governance. Avviate un catalogo leggero con metadati di ownership, definizioni, riferimenti al lineage e link ai risultati di qualità.
In questa fase, separate gli alert dagli incidenti. Uno schema insolito può richiedere un'indagine, mentre una regola normativa violata può richiedere un'escalation immediata. Rendete esplicito il percorso di risposta.
Giorni 61-90: dimostrare e iterare
Pubblicate la prima scorecard rivolta al business. Eseguite uno sprint di correzione sui tre problemi principali selezionati in base all'impatto sul business, non alla comodità tecnica. Formalizzate la cadenza del consiglio di stewardship, il registro delle decisioni, il percorso di escalation e la revisione delle eccezioni irrisolte.
FAQ in breve
Come possiamo iniziare senza acquistare uno strumento? Partite da un inventario degli asset critici, un glossario, controlli SQL, registri delle consegne e un workflow dei problemi. Dimostrate che gli owner rispondono ai difetti misurati prima di ampliare la tecnologia.
E se gli steward non hanno autorità? Date al consiglio diritti decisionali documentati, nominate uno sponsor esecutivo e definite scadenze di escalation. Un titolo senza autorità non risolverà i conflitti tra domini.
Come manteniamo lo slancio dopo la prima spinta? Legate le riunioni di revisione ai KPI di business, spostate l'attenzione a rotazione sugli asset a più alto impatto e dismettete i controlli che non servono più a un caso d'uso reale. La governance dovrebbe diventare parte della delivery e della gestione degli incidenti, non un esercizio annuale separato.
digna offre una piattaforma enterprise di qualità dei dati e observability che gira all'interno dell'ambiente del cliente, con moduli per anomaly detection, tempestività, validazione, tracciamento dello schema e monitoraggio in-database. Se il vostro team ha bisogno di collegare controlli di qualità misurabili ai workflow di governance su data warehouse, data lake o pipeline, visitate digna per scoprire la piattaforma e le sue opzioni di deployment.
Domande frequenti
Che relazione c'è tra data governance e qualità dei dati?
Sono condizioni collegate, non filoni di lavoro separati. La governance definisce le condizioni di misurazione, decidendo chi è responsabile dei dati e che cosa significa idoneità all'uso; la qualità misura poi se i dati le soddisfano. Un punteggio di qualità ha senso solo quando qualcuno ha già definito l'uso previsto e il risultato accettabile.
Com'è fatto il ciclo di controllo?
Quattro parti che si ripetono: definire il requisito, assegnare la responsabilità, misurare e osservare, poi correggere e imparare. Trattare la governance come un modello operativo anziché come un insieme di documenti è ciò che permette a un team di valutare con precisione la propria maturità, invece di contare le policy pubblicate.
Una governance debole blocca davvero l'AI?
La ricerca 2024 di Precisely stabilisce un collegamento diretto: il 62% delle organizzazioni ha indicato la mancanza di data governance come la principale sfida legata ai dati che frena le iniziative di AI, e il 51% ha citato la governance tra le maggiori sfide di integrità dei dati, subito dopo la qualità dei dati stessa.
Che cosa distingue in pratica le due discipline?
La loro domanda principale. La governance si chiede chi decide come vengono gestiti i dati e produce definizioni approvate, registri di ownership, regole di accesso e percorsi di escalation. La qualità si chiede se i dati sono idonei all'uso previsto e produce punteggi, controlli falliti, incidenti, trend e azioni correttive.
La qualità dei dati è una proprietà assoluta?
No. La ISO 8000 considera la qualità dipendente dal contesto e non assoluta, ed è proprio per questo che la governance deve venire prima. Lo stesso dataset può essere del tutto idoneo per una decisione e inutilizzabile per un'altra, e solo l'uso previsto, una volta definito, stabilisce quale verdetto si applica.


