Che cos'è la data observability? Guida per i data team moderni
|
7
min di lettura

Probabilmente state affrontando una qualche variante dello stesso problema che hanno quasi tutti i data team moderni. Una dashboard che ieri sembrava a posto oggi è improvvisamente obsoleta. Un KPI settimanale crolla a zero perché una tabella a monte ha smesso di aggiornarsi. Un modello inizia a produrre output discutibili, ma nessuna pipeline è tecnicamente “fallita”, quindi non scatta alcun alert finché non se ne accorge uno stakeholder. La parte difficile non è solo risolvere il problema. È capire dove è iniziato, chi ne è responsabile e quanti asset a valle sono già stati colpiti.
Ecco perché la data observability è passata dall'essere un'idea utile ma accessoria a un requisito operativo. Offre ai team un modo per comprendere lo stato di salute dei dati lungo ingestione, trasformazione, archiviazione e consumo, invece di affidarsi a controlli sullo stato dei job e a test sparsi che non colgono i guasti silenziosi.
Indice
Observability, monitoraggio e qualità: una distinzione chiara
Progettare per l'observability: in-database o nella pipeline
Valutare le piattaforme di data observability: una checklist
Oltre le dashboard rotte: l'ascesa della data observability
I team non iniziano a cercare la data observability perché amano le nuove categorie di prodotto. Iniziano perché lo stack attuale lascia dei punti ciechi. Airflow dice che un job è andato a buon fine. I test dbt passano. Il warehouse è operativo. Eppure una dashboard è ancora sbagliata, un estratto per la finanza arriva in ritardo o un workflow di AI consuma dati di input alterati senza alcun errore evidente.
Questo divario conta perché oggi i sistemi di dati si guastano in modi più silenziosi. Una partizione mancante, un feed sorgente in ritardo, un cambio di tipo in una colonna a monte o un graduale spostamento della distribuzione possono danneggiare le decisioni a valle senza far accendere nessuna spia rossa.
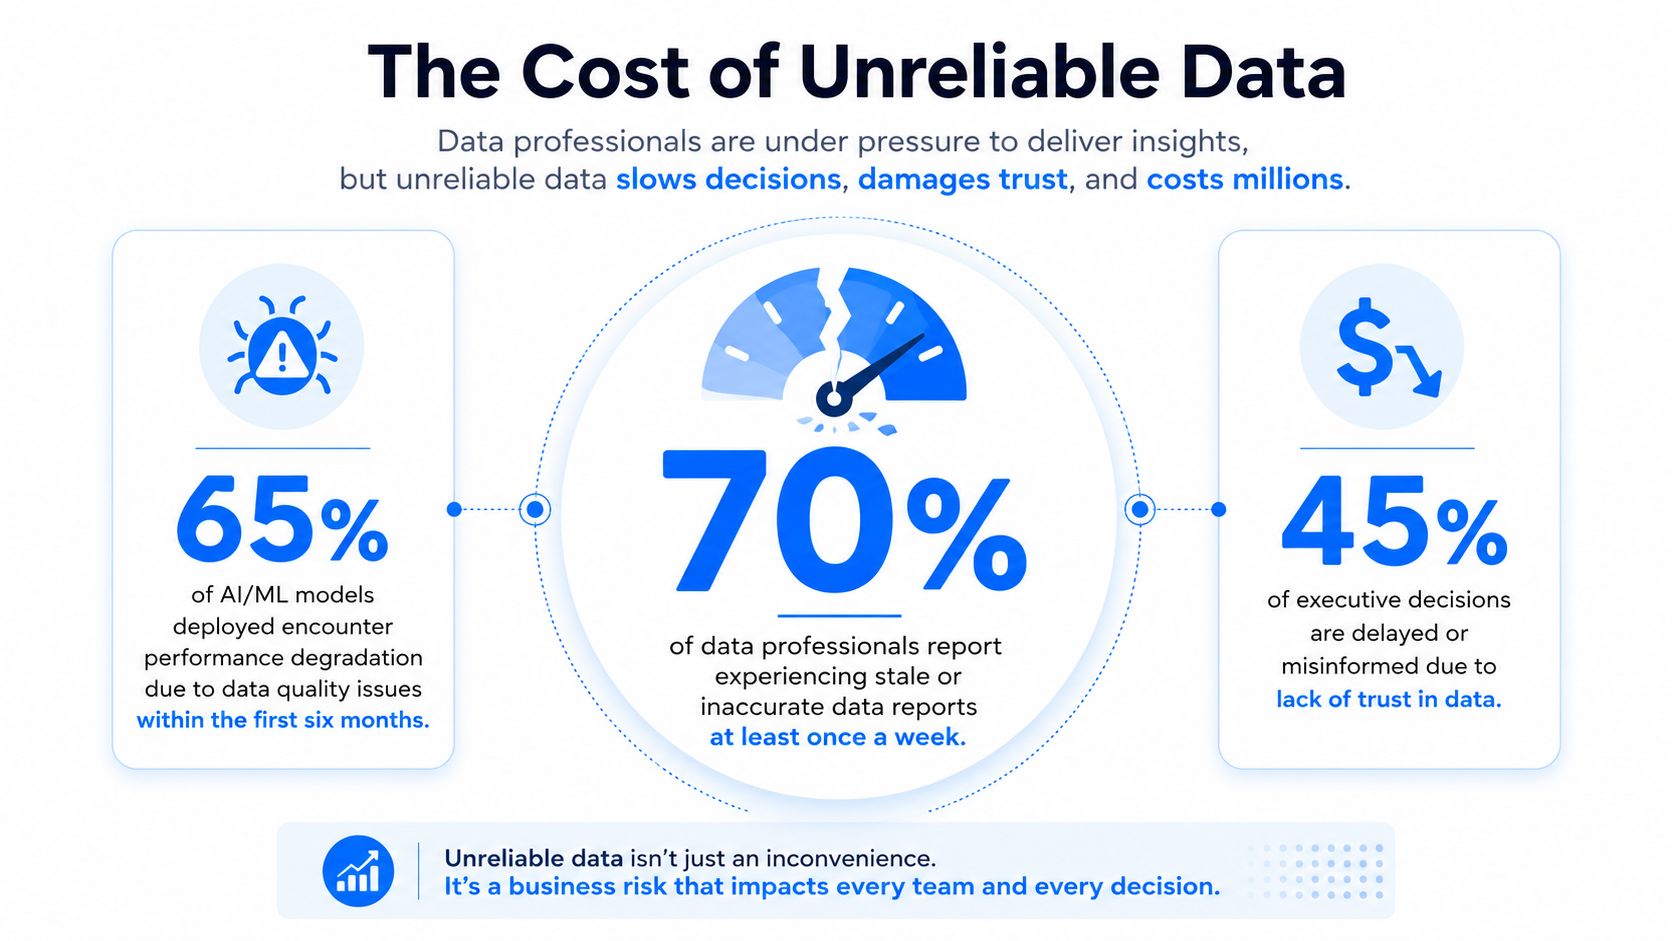
Perché il monitoraggio tradizionale non copre più il vero problema
Il monitoraggio tradizionale risponde a domande operative come “Il job è stato eseguito?” o “Il servizio è attivo?”. I data team hanno però bisogno di risposte anche a un'altra categoria di domande:
I dati sono arrivati in tempo: anche se la pipeline è stata completata, l'ultima partizione è arrivata quando gli utenti se l'aspettavano?
Il contenuto è cambiato in modo inatteso: i tassi di null, le distribuzioni o i campi di business chiave stanno derivando?
La struttura è cambiata: una colonna è stata rinominata, rimossa o convertita a un altro tipo a monte?
Chi è coinvolto: quali dashboard, modelli e team dipendono da questo asset?
Questo è il territorio della data observability. Si concentra sulla salute dei dati stessi e sul percorso che compiono attraverso lo stack.
Le dashboard rotte sono di solito il sintomo finale, non il primo guasto.
Perché è diventato un cambiamento strategico
La categoria cresce perché le aziende hanno superato i semplici controlli di stato. La proiezione di Mordor Intelligence sul mercato della data observability valuta il mercato globale a 3,51 miliardi di USD nel 2026 e prevede che raggiunga 6,03 miliardi di USD entro il 2031, con un CAGR dell'11,42%. Questa crescita riflette un passaggio più ampio dal monitoraggio di base verso una visibilità end-to-end.
In pratica, il cambiamento è facile da capire. I team hanno più servizi cloud, più domini, più trasformazioni, più consumatori e più pressione per supportare analytics e AI senza che gli incidenti sui dati diventino un'emergenza quotidiana. Se il vostro stack comprende strumenti di ingestione, orchestrazione, trasformazioni nel warehouse, semantic layer e pipeline di modelli, i controlli di salute su singoli strumenti isolati non vi diranno se il data product finale è affidabile.
La data observability è il modello operativo che colma questo divario. Offre a ingegneri e analisti una visibilità condivisa su freshness, contenuto, struttura e dipendenze, così che i problemi emergano prima che uno stakeholder li segnali.
I cinque pilastri della data observability
Il modo più semplice per rendere concreta la data observability è scomporla nei segnali che i team monitorano. La panoramica di Flexera sui cinque pilastri li definisce come freshness, qualità, volume, schema e lineage, che insieme aiutano le organizzazioni a rilevare la deriva silenziosa dei dati.
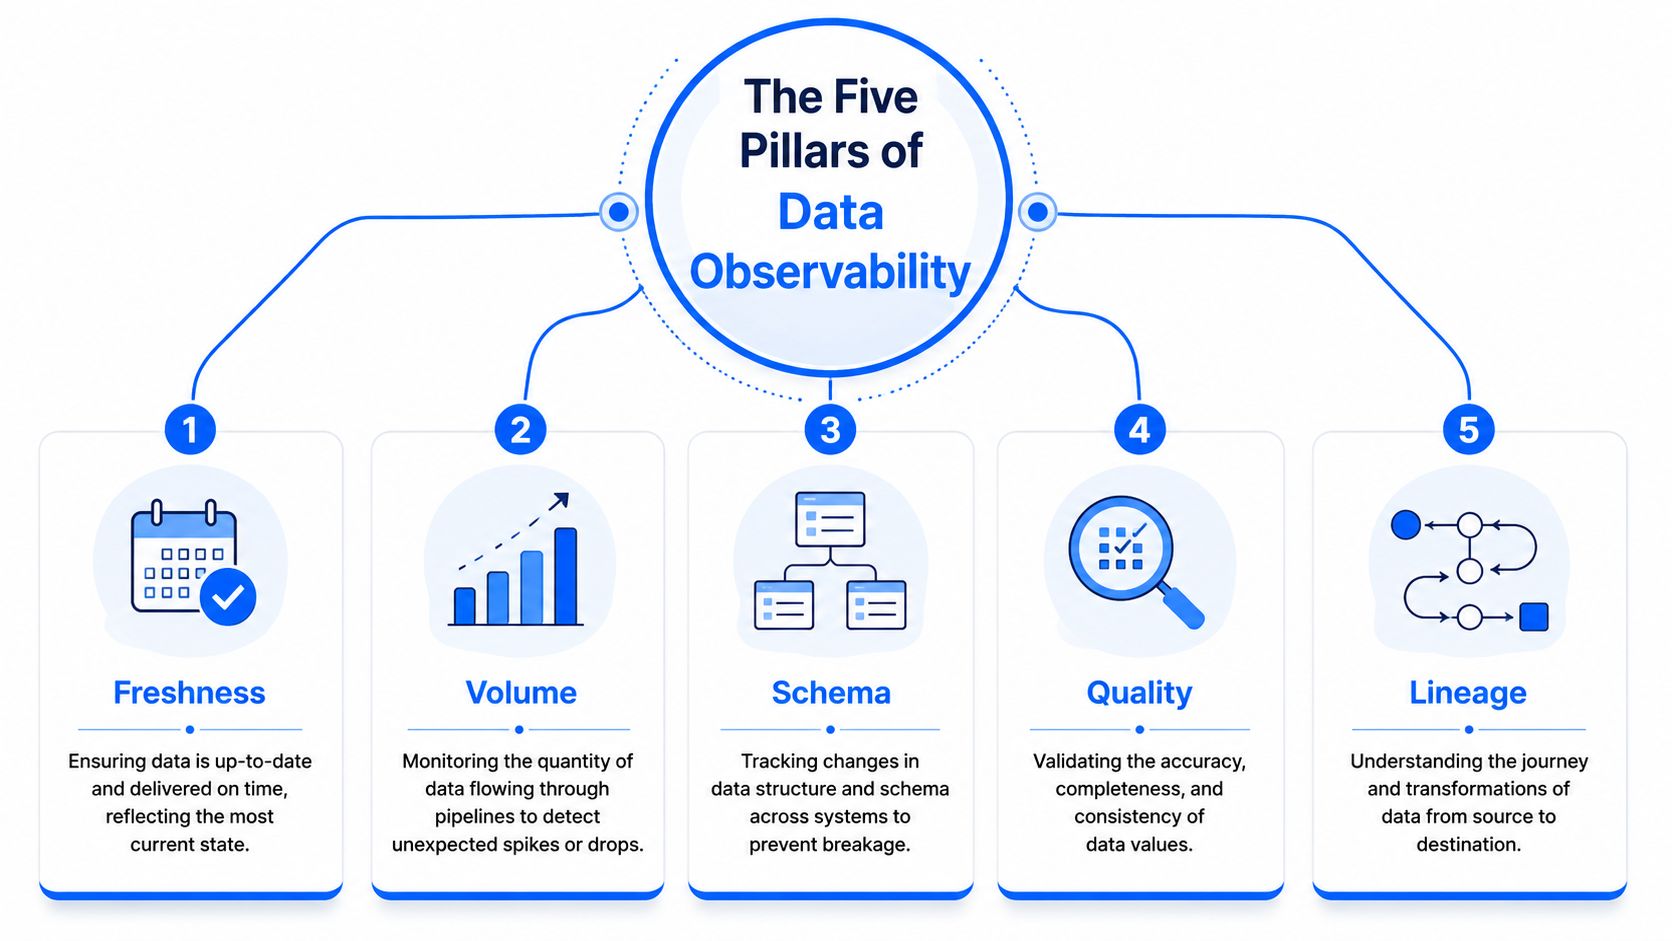
La freshness indica se i dati sono arrivati quando previsto
La freshness è il pilastro della tempestività. Risponde a una domanda operativa di base: questo dataset è abbastanza aggiornato per l'uso a cui è destinato?
Una tabella può essere perfettamente valida e comunque inutile se arriva in ritardo. Report di chiusura contabile, dashboard dell'assistenza clienti e workflow antifrode dipendono tutti da orari di arrivo attesi. Un buon monitoraggio della freshness non si limita a confrontare con un timestamp statico. Apprende i normali schemi di consegna, le pianificazioni attese e la differenza tra “in ritardo ma ancora accettabile” e “abbastanza in ritardo da creare un rischio di business”.
Un modello mentale utile è l'orario dei treni. Non basta che il treno esista. Deve arrivare quando i passeggeri ne hanno bisogno.
La qualità verifica se i valori sono adatti all'uso
La qualità riguarda il contenuto in sé. I valori sono abbastanza accurati, completi e coerenti da potersene fidare?
Questo pilastro intercetta problemi come picchi insoliti di null, enumerazioni non valide, codici errati, valori impossibili o campi di business che all'improvviso smettono di comportarsi come al solito. È anche il punto in cui i team spesso si rendono conto che job di trasformazione andati a buon fine non garantiscono output utilizzabili.
Regola pratica: se un dataset può essere tecnicamente disponibile e produrre comunque una decisione di business sbagliata, vi servono segnali di qualità, non solo segnali di pipeline.
Il volume evidenzia variazioni inattese nel flusso di dati
Il volume verifica se la quantità di dati che attraversa un sistema appare ancora normale. A volte il segnale più chiaro di una sorgente guasta non è un job fallito. È una tabella che riceve molte meno righe del solito, o molte di più.
I controlli sul volume sono particolarmente utili per pipeline di ingestione, flussi di eventi e caricamenti batch ricorrenti. Un calo improvviso può indicare record sorgente mancanti. Un picco può indicare duplicazioni, riprocessamenti o una modifica involontaria nella logica di estrazione.
Lo schema traccia i cambiamenti strutturali prima che danneggino i consumatori
L'observability dello schema monitora i cambiamenti strutturali, come colonne aggiunte o rimosse, campi rinominati o tipi di dato modificati. Spesso gli ingegneri scoprono i problemi di schema solo dopo che un modello di BI si rompe o un parser a valle inizia a fallire.
Pensate allo schema come alla superficie contrattuale tra produttori e consumatori. Se quel contratto cambia senza che nessuno se ne accorga, la rottura di solito compare a valle e in ritardo.
Un buon schema tracker non deve mostrare solo che una struttura è cambiata, ma anche dove ha avuto origine quel cambiamento e quali asset dipendenti sono esposti.
La lineage mostra il raggio d'impatto e la responsabilità
La lineage mappa da dove provengono i dati, cosa li ha trasformati e cosa dipende da essi. È la differenza tra cercare un filo rotto dentro un muro e vedere lo schema elettrico completo.
Quando si verifica un incidente, la lineage risponde alle domande che contano sotto pressione:
Dove è iniziato il problema
Quali tabelle, dashboard o modelli si trovano a valle
Chi è responsabile degli asset coinvolti
Cosa è cambiato subito prima dell'incidente
Senza lineage, i team perdono tempo a tirare a indovinare. Con la lineage, la root cause analysis diventa un'indagine mirata invece di una caccia al tesoro su Slack.
Observability, monitoraggio e qualità: una distinzione chiara
I team usano spesso questi termini come se significassero la stessa cosa. Non è così. La sovrapposizione esiste, ma ciascuna disciplina svolge un compito diverso.
Un confronto diretto
Dimensione | Monitoraggio dei dati | Qualità dei dati | Data observability |
|---|---|---|---|
Focus principale | Attività di pipeline e sistemi | Correttezza di valori e record | Salute complessiva dei dati tra pipeline, contenuto, struttura e dipendenze |
Approccio tipico | Reattivo o basato su soglie | Controllo e validazione basati su regole | Rilevamento e diagnosi proattivi |
Domanda principale | Il processo è stato eseguito e ha emesso i segnali attesi? | I dati rispettano gli standard definiti? | I dati sono affidabili e, se no, cosa è cambiato e cosa è coinvolto? |
Input comuni | Stato dei job, log, tempi di esecuzione, task falliti | Regole di validazione, profiling, vincoli di business | Metadati, pattern storici, anomalie, lineage, schema, freshness, segnali di qualità |
Ideale per intercettare | Job falliti, pianificazioni saltate, problemi infrastrutturali | Violazioni note della logica di business | Deriva silenziosa, pattern insoliti, modifiche nascoste a monte, impatto a valle |
Punto debole | Non coglie molti scenari “verdi ma sbagliati” | Dipende dalle regole che si sa già di dover scrivere | Richiede una strumentazione e una copertura dei metadati più ampie |
Chi lo usa | Data engineer e team di piattaforma | Qualità dei dati, governance, analisti, auditor | Engineering, analytics, governance e stakeholder operativi insieme |
Perché i team li confondono
Nella maggior parte degli stack il monitoraggio è arrivato per primo, quindi molte organizzazioni cercano di estenderlo oltre ciò per cui è stato pensato. Uno strumento di orchestrazione può dirvi se un task è fallito. Di solito non può dirvi che il task è andato a buon fine caricando record cliente incompleti. Un framework di validazione può applicare regole su campi noti. Di solito non può dirvi che una distribuzione finora stabile si è spostata in un modo che nessuna regola aveva previsto.
Ecco perché l'observability va considerata la capacità più ampia. Incorpora i segnali del monitoraggio e integra i controlli di qualità dei dati, ma non è riducibile né all'uno né agli altri.
Per i team che stanno costruendo controlli più solidi a livello di record, questa guida su come semplificare i dati con la validazione è utile perché spiega dove le regole di validazione esplicite contano ancora. L'importante è non fermarsi lì. La validazione gestisce i requisiti noti. L'observability gestisce le condizioni che cambiano e le modalità di guasto sconosciute.
Un modo semplice per inquadrare la relazione è questo:
Il monitoraggio osserva il comportamento dei sistemi.
La qualità garantisce la correttezza dei dati.
L'observability collega comportamento, correttezza, cambiamento e impatto.
Questa distinzione conta soprattutto negli ambienti regolamentati. I team di audit di solito si interessano sia alla salute operativa sia alla conformità alle regole di business. Se questi controlli vivono in silos separati, la risposta agli incidenti rallenta e la raccolta delle evidenze diventa caotica. Una visione combinata è più pratica. Qui è utile anche un confronto più approfondito tra data observability e qualità dei dati, soprattutto quando i team devono decidere se serve un altro strumento di test o un livello operativo più ampio.
Progettare per l'observability: in-database o nella pipeline
La maggior parte dei dibattiti sull'implementazione si riduce a una scelta progettuale. Osservate i dati principalmente in transito nella pipeline o eseguite l'observability là dove i dati risiedono già?
Questa decisione architetturale incide su costi, privacy, latenza, complessità operativa e su quanto la soluzione sia realistica per gli ambienti regolamentati.
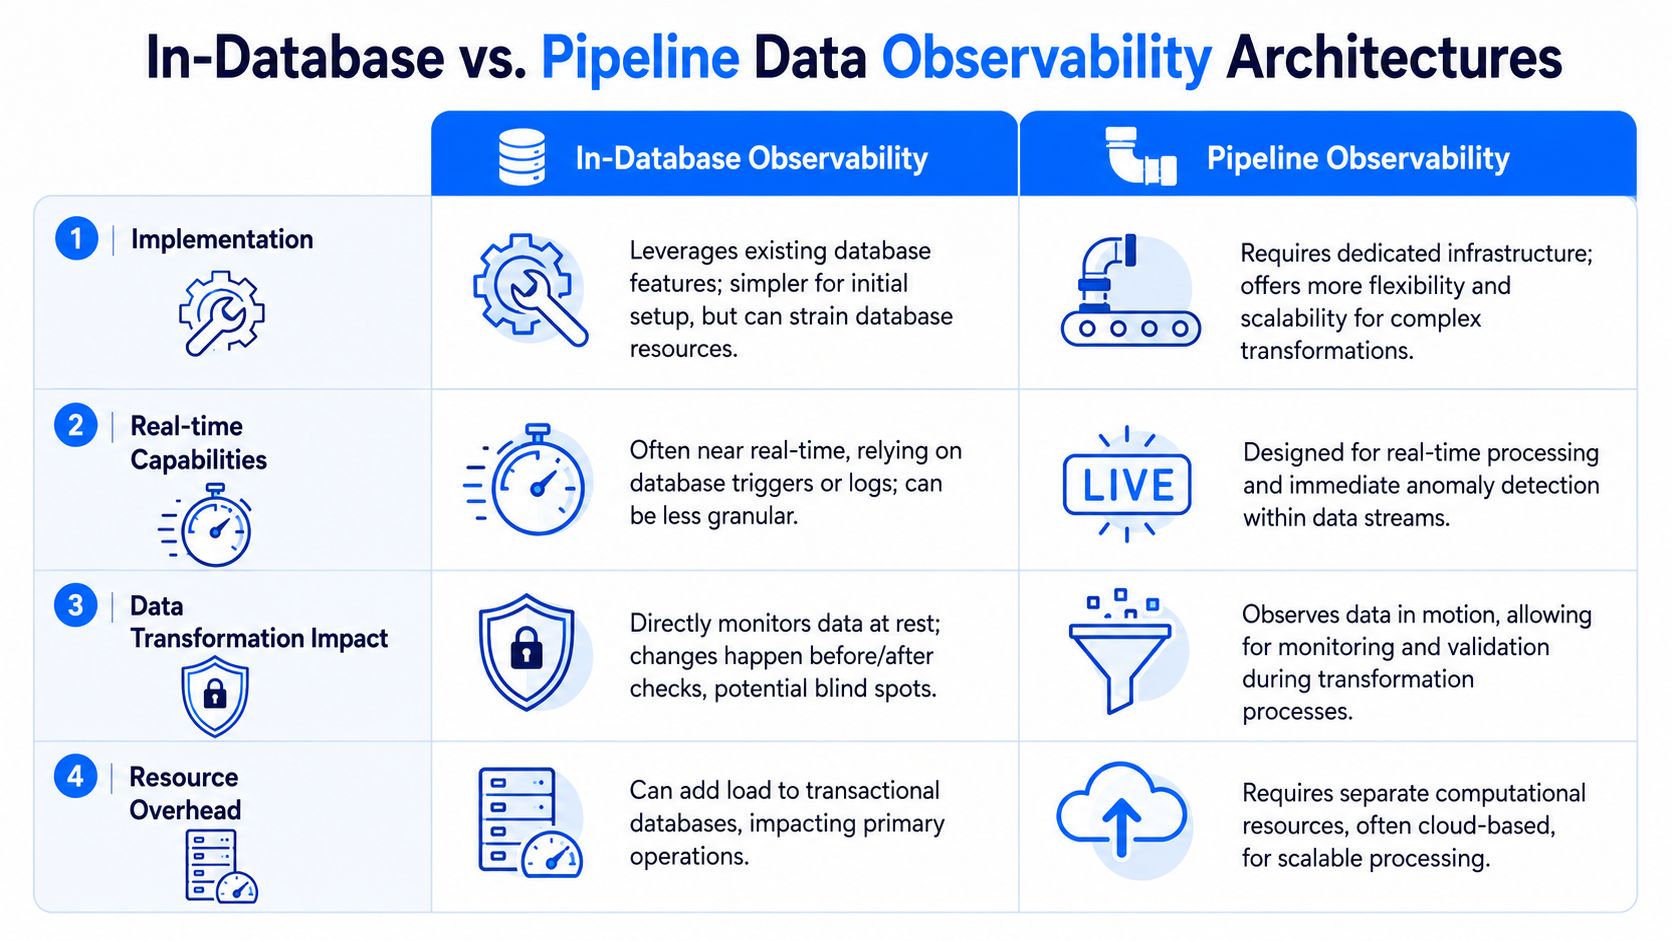
La strumentazione della pipeline funziona, ma si frammenta in fretta
L'observability incentrata sulla pipeline monitora i dati in movimento. Può essere utile quando i team hanno bisogno di visibilità durante le fasi di trasformazione, lo stream processing o i passaggi di orchestrazione. Potete esaminare il comportamento in più checkpoint e collegare gli alert vicino agli eventi di esecuzione.
Il rovescio della medaglia è la frammentazione. Quando lo stack comprende strumenti ETL, sistemi di streaming, trasformazioni nel warehouse, notebook e processi di aggiornamento della BI, la logica di monitoraggio si distribuisce su troppe superfici. La responsabilità diventa confusa. La logica degli alert deriva. Gli ingegneri finiscono per correlare manualmente le evidenze tra log, scheduler e metadati del warehouse.
Gli approcci fortemente basati sulla pipeline creano anche la pressione a spostare o duplicare i metadati, e talvolta i dati stessi, in sistemi esterni per l'analisi. In una startup cloud-native può essere accettabile. Nella finanza, nella sanità o nella pubblica amministrazione spesso è fuori discussione.
L'esecuzione in-database si adatta meglio agli ambienti regolamentati
Per gli ambienti private cloud e on-premises, l'observability in-database è di solito l'architettura più pulita. La logica viene eseguita dove i dati si trovano già, il che riduce gli spostamenti e mantiene i dataset sensibili all'interno dell'ambiente controllato dal cliente.
Questo conta perché una delle maggiori lacune del mercato è la mancanza di indicazioni pratiche per un'observability basata sull'AI senza esfiltrazione di dati. Nei contesti regolamentati i team hanno comunque bisogno di rilevamento non supervisionato dei pattern, apprendimento delle baseline e anomaly detection, ma non possono semplicemente inviare i dati di produzione a un backend SaaS e sperare che l'ufficio legale approvi in seguito.
L'analisi di Acceldata sulle architetture di observability su scala enterprise sottolinea la progettazione guidata dai metadati e osserva che ridurre al minimo lo spostamento dei dati è un parametro di riferimento critico per i warehouse ad alto volume. Questo principio diventa ancora più importante on-premises, dove egress, replica e storage duplicato generano un sovraccarico sia operativo sia di compliance.
Un framework decisionale pratico è il seguente:
Scegliete una copertura incentrata sulla pipeline quando avete bisogno di visibilità dettagliata durante le fasi di streaming o trasformazione e disponete già di un team di piattaforma maturo che gestisce più strumenti.
Scegliete l'esecuzione in-database quando privacy, residenza dei dati, scala del warehouse e spostamento minimo dei dati sensibili sono requisiti imprescindibili.
Usate i metadati come control plane quando vi serve ampiezza di copertura tra i domini senza configurare a mano i controlli per ogni asset.
L'observability basata sull'AI on-premises funziona su larga scala solo se l'apprendimento delle baseline e l'anomaly detection possono avvenire all'interno dell'ambiente del cliente.
L'altro compromesso riguarda la collocazione delle risorse. Gli approcci in-database possono aggiungere carico se implementati con poca attenzione, soprattutto sui sistemi transazionali. La soluzione non è evitare questo modello. È limitare l'esecuzione agli store analitici, usare i metadati in modo intelligente ed evitare costose scansioni a forza bruta su ogni oggetto in ogni momento.
Tra le piattaforme progettate per questo modello, digna è un esempio che esegue le analisi all'interno dei database del cliente e supporta deployment private cloud o on-premises, combinando anomaly detection, monitoraggio della tempestività, schema tracking e validazione a livello di record. Questa architettura è spesso più adatta quando i team di sicurezza non consentono al fornitore di accedere ai dati di produzione.
Valutare le piattaforme di data observability: una checklist
Molti strumenti dichiarano di fare observability perché hanno alert, dashboard o qualche controllo sulle anomalie. Non basta. Una valutazione seria deve verificare come si comporta la piattaforma in condizioni operative reali, soprattutto se gestite un'infrastruttura privata o siete sotto pressione per la compliance.
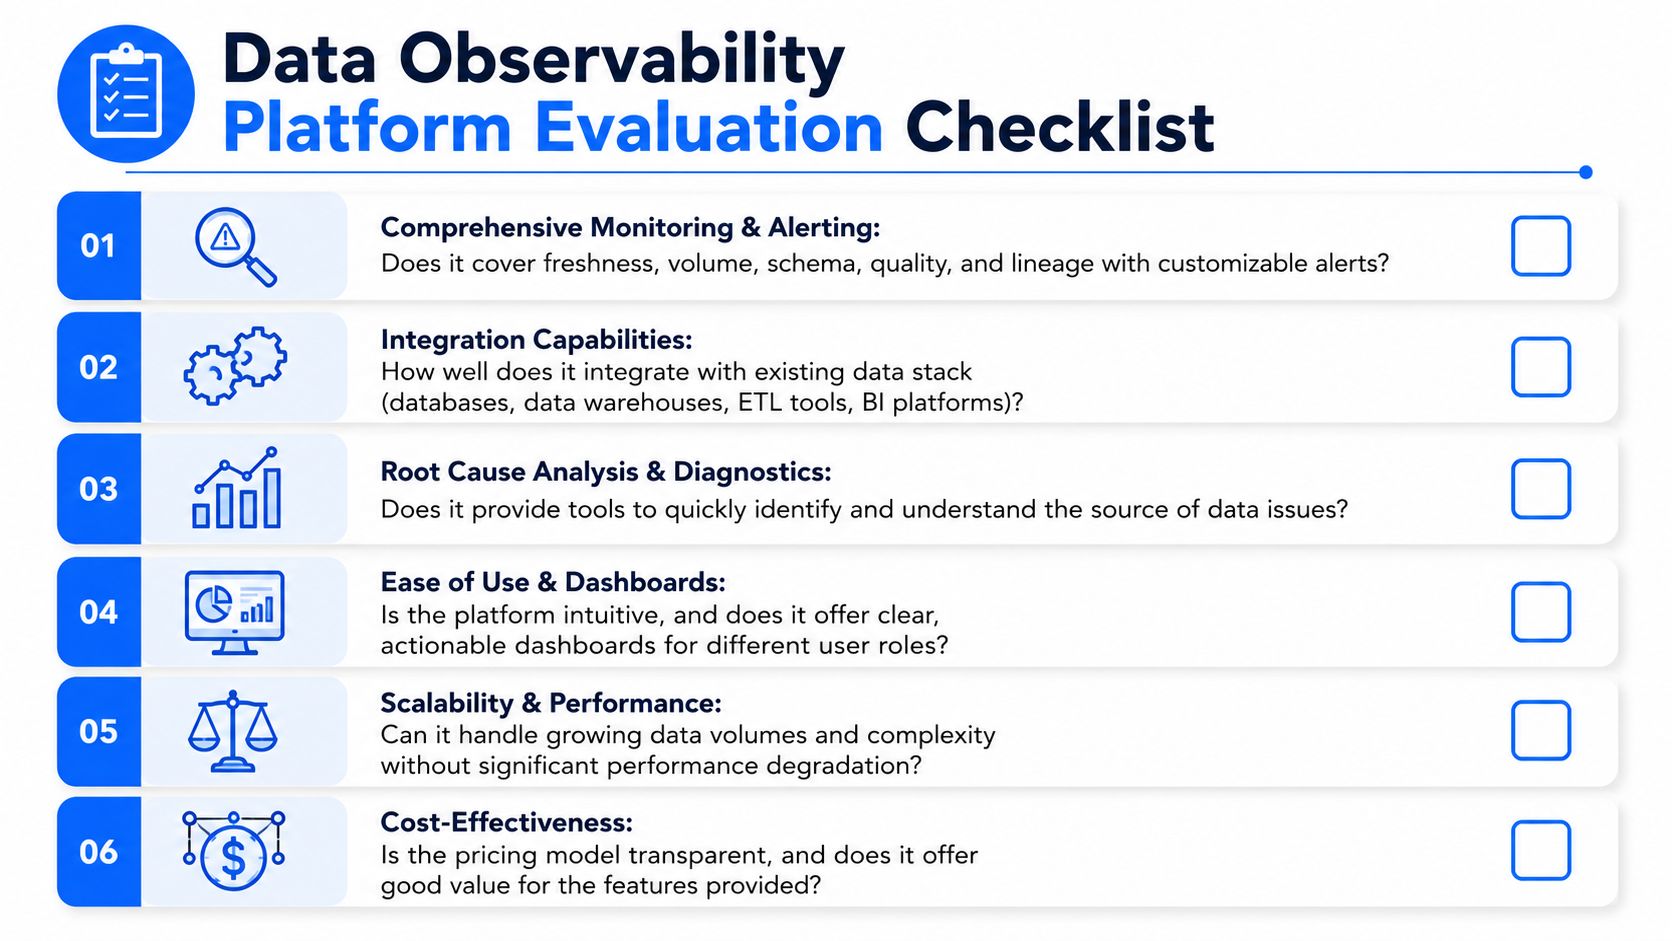
Su cosa insistere prima di un proof of concept
Innanzitutto, cercate una copertura dell'intera superficie operativa, non di un solo segnale. Una piattaforma deve gestire freshness, qualità, volume, schema e lineage in modo unificato, non come pezzi assemblati alla meglio.
In secondo luogo, prestate molta attenzione a come funziona l'anomaly detection. L'analisi di Secoda sui trend della data observability osserva che l'anomaly detection basata sull'AI è l'applicazione dell'AI più citata nel campo dell'observability, soprattutto perché apprende le baseline normali senza richiedere la manutenzione manuale delle regole. Questa distinzione conta. Se il vostro team deve regolare a mano le soglie per ogni dataset, non avete risolto il carico operativo. L'avete solo spostato.
In terzo luogo, verificate la realtà del deployment, non il linguaggio del marketing. “Privato” può significare molte cose. Chiedete se la piattaforma può essere eseguita nel vostro ambiente, se l'apprendimento delle baseline avviene lì e se il fornitore accede mai a dataset di produzione o a payload di telemetria che espongono contenuti regolamentati.
Una shortlist utile dovrebbe includere:
Flessibilità di deployment: le opzioni cloud, private cloud e on-premises devono essere reali, non promesse di roadmap.
Apprendimento nell'ambiente: baseline e anomaly detection devono essere eseguite dove risiedono i vostri dati soggetti a governance.
Observability e validazione unificate: vi servono il rilevamento statistico per i problemi sconosciuti e la validazione basata su regole per la logica critica ai fini dell'audit.
Lineage e diagnostica utilizzabili: la root cause analysis deve ridurre i tempi di indagine, non aggiungere un'altra dashboard.
Viste specifiche per ruolo: ingegneri, analisti e stakeholder della governance hanno bisogno di interfacce e percorsi di alerting diversi.
Domande che smascherano rapidamente le piattaforme deboli
Durante la valutazione, le domande più rivelatrici sono di solito quelle operative:
Domanda | Perché è importante |
|---|---|
Quanta configurazione manuale delle soglie è necessaria? | Un impegno di configurazione elevato di solito si traduce in alert fatigue e monitor abbandonati. |
Può rilevare problemi quando nessuna regola statica viene violata? | La deriva silenziosa e i pattern insoliti raramente si manifestano attraverso test predefiniti. |
Cosa rimane all'interno del nostro ambiente? | Questo determina se lo strumento è anche solo installabile in contesti regolamentati. |
Può combinare regole a livello di record con l'anomaly detection? | I team pronti per gli audit hanno bisogno di entrambe. Prodotti separati aggiungono attrito. |
Come mostra il raggio d'impatto? | Il rilevamento senza analisi d'impatto lascia comunque chi interviene a tirare a indovinare. |
Un ulteriore filtro aiuta. Chiedete al fornitore di illustrare uno scenario in cui una tabella arriva in ritardo, uno schema a valle cambia e una regola di business fallisce su un campo regolamentato. Se la storia richiede tre prodotti e un passaggio manuale, è questa l'architettura che erediterete.
Per i team che confrontano capacità più ampie, questa spiegazione di cosa dovrebbe includere una piattaforma di observability è un utile punto di riferimento mentre si costruisce una checklist di valutazione.
Casi d'uso e ROI della data observability
Il valore della data observability diventa evidente quando collegate ogni segnale a un guasto di business che i team conoscono già. I casi d'uso più forti non sono astratti. Sono gli incidenti che le persone sono stanche di dover sistemare.
Mantenere affidabile il reporting direzionale
Un tipico schema di guasto è un report che si aggiorna puntualmente ma include dati obsoleti o parziali. Il livello di BI sembra in salute. La vista di business sottostante no.
Il monitoraggio della freshness intercetta gli arrivi in ritardo prima che se ne accorga chi consulta la dashboard. I controlli sul volume aggiungono una seconda protezione individuando caricamenti incompleti che producono comunque tabelle tecnicamente valide. Il risultato per il business è semplice: i manager smettono di prendere decisioni su numeri aggiornati a metà e gli analisti smettono di passare le mattinate a dimostrare se ci si può fidare di un KPI.
Proteggere gli input di ML e AI dalla deriva silenziosa
I sistemi di AI e ML spesso si degradano perché gli input sono cambiati in modo sottile, non perché un endpoint di serving è andato giù. La distribuzione di un campo si sposta. Un valore categorico scompare. Una modifica allo schema cambia la logica delle feature senza un guasto evidente.
Le piattaforme moderne usano il machine learning non supervisionato per apprendere i pattern normali su segnali come freshness, volume, schema e distribuzioni dei valori, il che consente di segnalare anomalie anche quando nessuna regola statica viene violata, come descritto nella voce del glossario di Grid Dynamics sulle piattaforme di data observability. È esattamente il tipo di protezione di cui hanno bisogno i team di modelli e di analytics, perché molte modifiche dannose si collocano al di fuori dell'insieme di regole che qualcuno ha pensato di scrivere.
Ridurre i tempi di indagine sugli incidenti
Il ritorno operativo diretto deriva spesso da un triage più rapido. Quando emerge un problema, chi interviene deve sapere se è nato nell'ingestione, nella trasformazione, nell'estrazione dalla sorgente o nella modellazione a valle. Deve anche sapere chi è responsabile degli asset coinvolti.
Un buon workflow di observability elimina tre abitudini costose:
Ricerca manuale nei log: gli ingegneri smettono di ricomporre indizi sparsi tra strumenti separati.
Richieste a pioggia agli stakeholder: i team smettono di chiedere a cinque responsabili se hanno toccato i dati.
Rollback alla cieca: chi interviene può isolare la modifica prima di annullare lavoro non correlato.
L'incidente più rapido da risolvere è quello in cui responsabilità, lineage e primo segnale anomalo sono visibili nello stesso posto.
Combinare observability e validazione per essere pronti agli audit
Questo è il caso d'uso che la maggior parte degli articoli sottovaluta. I team regolamentati non hanno bisogno solo di anomaly detection. Hanno anche bisogno di dimostrare che la logica di business critica per l'audit viene applicata in modo coerente.
Ciò significa combinare segnali di observability come freshness, schema e volume con regole di validazione a livello di record. Ad esempio, un workflow in ambito sanitario o finanziario può richiedere entrambi i tipi di protezione contemporaneamente:
Livello di observability: rileva che il caricamento giornaliero è in ritardo o che uno schema è cambiato a monte.
Livello di validazione: verifica che campi obbligatori, set di codici o vincoli di business siano ancora rispettati a livello di record.
Livello operativo: instrada l'incidente con un contesto sufficiente per l'indagine e la raccolta delle evidenze.
Questa lacuna conta perché molti team usano ancora strumenti separati per l'anomaly detection e la validazione di business, il che complica le attività di compliance. L'analisi di Datagaps sugli strumenti di observability allineati a Gartner evidenzia questa lacuna nell'integrazione della validazione della qualità dei dati con l'observability ai fini dell'audit. In pratica, riunire entrambe in un unico workflow riduce i passaggi di consegne e offre agli auditor una traccia più chiara di cosa è stato rilevato, quale regola è stata applicata e come è stato risolto il problema.
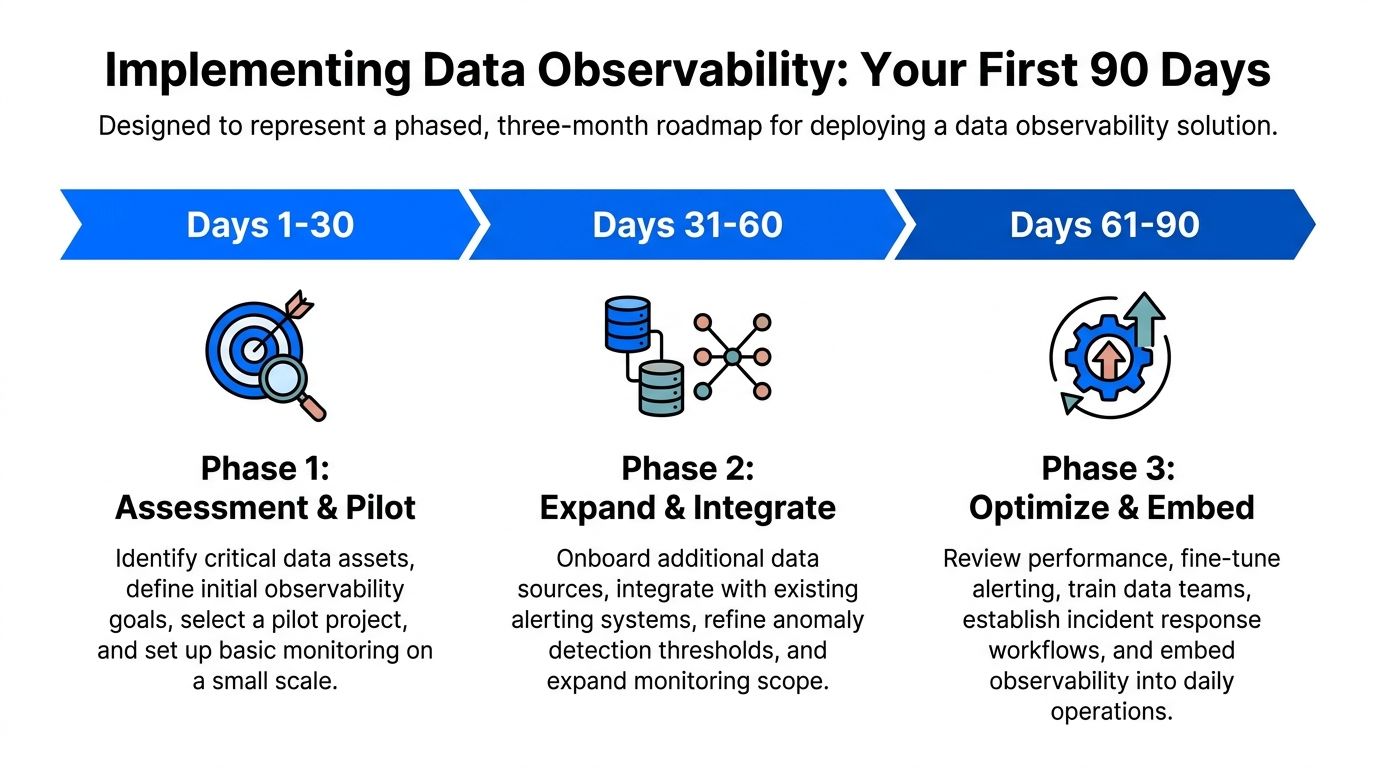
Implementare la data observability: i primi 90 giorni
Il fallimento di un rollout spesso rispecchia il fallimento del monitoraggio. Succede perché il perimetro iniziale è troppo ampio. I primi novanta giorni devono servire a dimostrare il valore operativo su una porzione critica del patrimonio di dati, per poi espandersi con disciplina.
Il trend di adozione previsto da Gartner, citato da Atlan, indica che il 50% delle aziende con architetture di dati distribuite adotterà strumenti di data observability entro il 2026, rispetto a circa il 20% nel 2024. La lezione non è che ogni team debba affrettarsi ad acquistare. È che i team hanno bisogno di una strategia di implementazione prima che sia la complessità a imporla.
Giorni 1-30: scegliete un flusso critico
Scegliete un dataset o una pipeline con tre caratteristiche: un impatto di business visibile, incidenti ricorrenti e responsabili identificabili. Buoni candidati sono i feed di reporting finanziario, le tabelle delle metriche cliente, le pipeline degli eventi del prodotto principale o i dataset di input dei modelli.
In questa fase:
Definite la criticità per il business: mettete per iscritto chi usa i dati, quando li usa e che aspetto ha un guasto.
Selezionate i segnali iniziali: iniziate con freshness, schema e un segnale di qualità che rifletta un rischio reale.
Mappate le dipendenze: stabilite una lineage sufficiente a identificare la sorgente immediatamente a monte e i consumatori a valle.
Concordate la gestione degli incidenti: decidete dove vanno gli alert e chi si occupa per primo del triage.
Non partite da tutte le tabelle del warehouse. Partite da un flusso che tutti concordano essere importante.
Giorni 31-60: collegate gli alert all'operatività reale
Il secondo mese è quello in cui molti progetti pilota si arenano. Il rilevamento esiste, ma nessuno lo ha integrato nel modello operativo quotidiano.
In questa fase, concentratevi sul workflow:
Ambito di lavoro | Come si presenta un buon risultato |
|---|---|
Instradamento degli alert | Gli alert arrivano negli stessi canali che i team usano già per gli incidenti |
Responsabilità | Ogni asset monitorato ha un responsabile principale chiaro |
Tuning | Il rumore evidente viene eliminato, ma le anomalie significative restano visibili |
Validazione | Le regole critiche per l'audit vengono aggiunte dove la logica di business deve essere esplicita |
Cadenza di revisione | I team rivedono incidenti e falsi positivi a intervalli fissi |
È anche il momento in cui emergono le carenze di personale. Se state costruendo una funzione dati e dovete definire il mix di competenze di analytics, ML e piattaforma necessarie per una gestione a lungo termine, questa guida all'assunzione di data scientist nelle startup è un riferimento pratico per delineare le aspettative sui ruoli nei team in fase iniziale.
Giorni 61-90: dimostrate il valore e standardizzate
Entro il terzo mese, l'obiettivo non è “più dashboard”. È la prova che il progetto pilota ha cambiato il comportamento del team.
Documentate un breve insieme di risultati:
Quali incidenti sono stati intercettati prima rispetto al passato
Quali alert erano rumorosi e come sono stati regolati
Quali asset di business hanno ottenuto una responsabilità più chiara
Quali regole rilevanti per la compliance ora hanno visibilità operativa
Quali domini aggiuntivi dovrebbero essere integrati in seguito
Iniziate da una pipeline problematica, non dall'intera piattaforma. I team si fidano dell'observability dopo il primo incidente evitato, non dopo il primo diagramma architetturale.
Da lì, create uno schema di onboarding ripetibile. Definite quali metadati richiedete, come vengono assegnati i responsabili, quali segnali di base sono sempre attivi e quando vengono aggiunte regole di validazione personalizzate. È così che la data observability smette di essere un progetto pilota e diventa parte della normale pratica di engineering.
Se il vostro team ha bisogno di una data observability che funzioni in ambienti private cloud o on-premises, digna è progettata per questo modello. Esegue le analisi all'interno dei database controllati dal cliente, combina l'anomaly detection basata sull'AI con controlli di tempestività, schema tracking, analytics storiche e validazione a livello di record, e mantiene i dati di produzione all'interno dell'ambiente del cliente.
Per capire come si combinano i segnali di freshness, volume, schema e qualità quando l'analisi deve restare all'interno dei vostri database, leggete la data platform observability con digna.
Domande frequenti
Che cos'è la data observability?
La data observability è la capacità di comprendere lo stato di salute dei dati lungo ingestione, trasformazione, archiviazione e consumo, invece di affidarsi ai controlli sullo stato dei job. Risponde a domande come: i dati sono arrivati in tempo, il contenuto o la struttura sono cambiati in modo inatteso e quali dashboard, modelli e team sono coinvolti quando qualcosa va storto.
Quali sono i cinque pilastri della data observability?
Freshness, qualità, volume, schema e lineage. La freshness verifica l'arrivo tempestivo, la qualità verifica se i valori sono adatti all'uso, il volume segnala variazioni inattese nel numero di righe, lo schema traccia i cambiamenti strutturali come le colonne rinominate e la lineage mostra raggio d'impatto e responsabilità, così che la root cause analysis diventi un'indagine mirata.
Qual è la differenza tra data observability e monitoraggio dei dati?
Il monitoraggio verifica se un processo è stato eseguito e ha emesso i segnali attesi, usando stato dei job, log e tempi di esecuzione. L'observability verifica se i dati sono affidabili e, se non lo sono, cosa è cambiato e cosa è coinvolto. Il monitoraggio non coglie molti scenari “verdi ma sbagliati”, come un task che va a buon fine pur caricando record cliente incompleti.
La data observability deve essere eseguita in-database o nella pipeline?
Dipende dai vostri vincoli. La strumentazione della pipeline è adatta a una visibilità dettagliata durante le fasi di streaming o trasformazione, ma si frammenta rapidamente tra gli strumenti. L'esecuzione in-database è più indicata quando privacy, residenza dei dati, scala del warehouse e spostamento minimo dei dati sensibili sono requisiti imprescindibili, perché baseline e anomaly detection vengono eseguite all'interno dell'ambiente del cliente.
Come si implementa la data observability nei primi 90 giorni?
Nei giorni 1-30, scegliete un flusso critico e iniziate con freshness, schema e un segnale di qualità. Nei giorni 31-60, instradate gli alert nei canali per gli incidenti già esistenti, assegnate i responsabili e riducete il rumore. Nei giorni 61-90, documentate gli incidenti intercettati prima e standardizzate uno schema di onboarding ripetibile.


