Compliance sulla qualità dei dati: guida all'audit 2026
|
7
min di lettura

La scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di USD all'anno secondo il benchmark citato in una ricerca di mercato, e questo prima ancora di arrivare al rilievo di audit, al ticket di remediation o al report di cui nessuno si fida. Negli ambienti regolamentati, questo costo smette di essere un problema di efficienza e diventa un problema di controllo, perché gli stessi record deboli che rallentano gli analisti indeboliscono anche le evidenze regolamentari, finanziarie e di audit.
Ho visto questo schema ripetersi in data warehouse e pipeline che in superficie sembravano a posto. I report corrispondevano ai numeri del mese precedente, gli alert erano rumorosi ma familiari, e poi una verifica di compliance ha fatto emergere il problema di fondo: nessuno era in grado di dimostrare come i dati fossero stati validati, tracciati o difesi. È questo il divario su cui si concentra questa guida: trasformare i controlli continui sulla qualità dei dati in evidenze di audit che reggano a un esame approfondito.
Indice
Perché la compliance sulla qualità dei dati è una questione da consiglio di amministrazione
Come la scarsa qualità dei dati provoca violazioni di compliance
Mappare le dimensioni della qualità dei dati sugli standard normativi
Perché la validazione basata su regole non basta per la compliance moderna
Costruire evidenze pronte per l'audit con il monitoraggio continuo
Caso di studio: sostituire 9000 regole manuali con l'observability basata sull'AI
Rendere operativa la compliance sulla qualità dei dati tra i team
Perché la compliance sulla qualità dei dati è una questione da consiglio di amministrazione
Uno stack di controlli sui dati debole crea un rischio a livello di consiglio di amministrazione molto prima di diventare un rilievo di audit. Un benchmark ampiamente citato stima il costo medio della scarsa qualità dei dati in 12,9 milioni di USD all'anno, e la stessa ricerca stima perdite fino a 3,1 trilioni di USD all'anno per l'economia statunitense sintesi della ricerca di mercato. Questi numeri contano perché mostrano quanto rapidamente le lacune nella validazione diventino un'esposizione finanziaria, e non solo un lavoro di pulizia per il team dati.
Il costo operativo si manifesta prima di tutto nella sala di controllo. Quando i report sui ricavi dipendono da dataset incoerenti, quando i record di audit sono incompleti o quando i team non sanno spiegare come è stato prodotto un dato, il problema smette di essere tecnologico e diventa un problema di ownership. Lo stesso corpus di ricerche collega la scarsa qualità dei dati a un impatto negativo sul 31% dei ricavi aziendali e afferma che i team dati possono dedicare fino all'80% del loro tempo a pulire e preparare i dati invece di analizzarli sintesi della ricerca di mercato. È un colpo diretto sia alla supervisione sia all'esecuzione.
Regola pratica: se un dataset non può essere validato, tracciato e difeso, la dashboard è solo cosmetica.
La misurazione è la successiva linea di frattura. Un sondaggio di settore ha rilevato che il 59% delle organizzazioni non misura affatto la qualità dei dati sintesi della ricerca di mercato. In settori regolamentati come i servizi finanziari, la sanità, le telecomunicazioni e la pubblica amministrazione, questa lacuna crea attriti negli audit, perché i dati non misurati non possono essere difesi in modo coerente quando qualcuno chiede evidenze.
Per i team che definiscono la baseline, cosa significa in pratica la data compliance offre un utile punto di partenza. Anche i responsabili legali e operativi dipendono dalle procedure di governance e compliance, perché il vero fallimento di solito non è un singolo campo errato. È l'assenza di un sistema di controllo in grado di dimostrare come i dati sono stati verificati, corretti e conservati.
Come la scarsa qualità dei dati provoca violazioni di compliance
Le violazioni di compliance raramente si presentano come un'interruzione netta del sistema. Di solito emergono come report incoerenti, una scadenza di segnalazione mancata o un audit trail che non riesce a dimostrare che i numeri sono stati verificati. Ecco perché sono difficili da individuare per tempo. Spesso i team si accorgono del problema solo quando qualcuno chiede come è stato prodotto un dato, molto tempo dopo l'inizio del drift nella pipeline.
La pressione normativa è già reale. La panoramica sulla regolamentazione digitale osserva che il Data Governance Act dell'UE si applica dal 24 settembre 2023 e che le imprese che già fornivano servizi di intermediazione dei dati al 23 giugno 2022 avevano tempo fino al 24 settembre 2025 per conformarsi alle relative disposizioni sull'intermediazione. La governance non è più una preferenza interna. Viene scritta nella legge, e i controlli deboli sui dati diventano un'esposizione legale.
Dove nascono di solito i fallimenti
Il punto di rottura è spesso operativo, non tecnico. Un controllo si rompe nel passaggio tra sistemi sorgente, un team usa definizioni incoerenti oppure la validazione manuale viene considerata sufficiente perché la revisione mensile di solito va a buon fine. Nella stessa panoramica normativa, un sondaggio ha riportato che il 58% delle organizzazioni afferma che la scarsa qualità dei dati ha causato significativi problemi di compliance, mentre il 45% segnala framework di data governance carenti o incoerenti.
La qualità dei dati diventa un problema di compliance quando nessuno è in grado di dimostrare che il controllo ha operato al momento giusto, sui dati giusti, con il risultato giusto.
L'impatto sul business segue lo stesso schema. L'impatto della scarsa qualità dei dati sul business mostra come i dati deboli vadano oltre l'analytics e arrivino alle decisioni operative, dove gli errori sono più difficili da difendere e da correggere. Un altro studio di mercato citato nella stessa panoramica normativa afferma che il 78% delle grandi imprese ha riscontrato significativi problemi di qualità dei dati negli ultimi 12 mesi, e il 54% ha dichiarato che tali problemi hanno inciso direttamente su ricavi, conformità normativa o efficienza operativa. Se i dati in ingresso sono instabili, anche le evidenze di compliance lo sono.
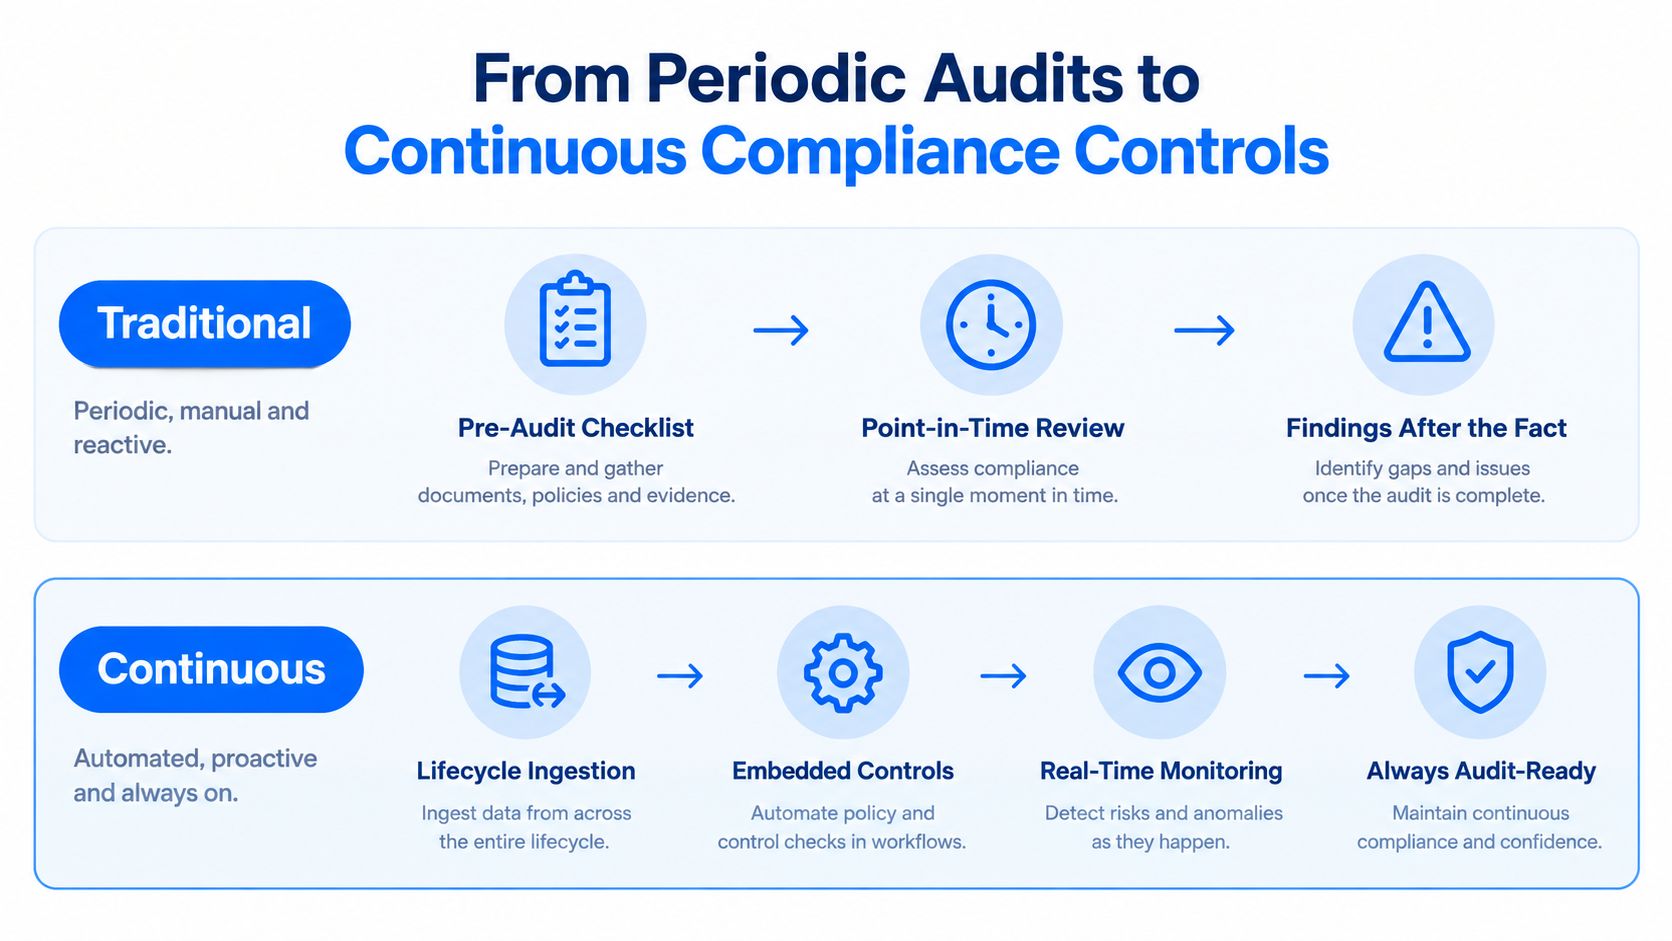
Dagli audit periodici ai controlli di compliance continui
Gli audit periodici contano ancora, ma sono troppo lenti per essere l'unica linea di difesa. Quando un audit scopre un controllo non funzionante, i dati errati sono già passati attraverso ingestione, trasformazione e reporting. Ecco perché la moderna compliance sulla qualità dei dati dipende da controlli continui integrati nel ciclo di vita, non da una revisione trimestrale.

Il cambiamento sembra astratto finché non lo si collega al lavoro che il vostro team già svolge. Il monitoraggio continuo osserva freschezza, completezza e cambiamenti strutturali mentre i dati si muovono. La validazione automatizzata applica ogni volta la stessa logica, il che è importante perché agli auditor interessa meno se una regola esiste e più se è stata applicata in modo coerente. La documentazione della lineage chiude il cerchio mostrando da dove provengono i dati, come sono cambiati e quali controlli li hanno interessati.
Cosa cambia a livello operativo
In un modello periodico, la governance è qualcosa a cui ci si prepara. In un modello continuo, la governance è qualcosa che la piattaforma produce ogni giorno. Questa differenza riduce il divario tra progettazione e funzionamento dei controlli, perché le evidenze vengono generate durante la normale elaborazione invece di essere ricostruite a posteriori.
Regola pratica: se un controllo esiste solo durante la preparazione dell'audit, non è un controllo, è un promemoria.
L'aspetto migliore di questo modello è che si adatta al comportamento delle pipeline regolamentate. I dati arrivano in ritardo, gli schemi cambiano e i sistemi sorgente si modificano senza troppo preavviso. Quando i controlli sono integrati nel workflow, il team vede questi guasti abbastanza presto da correggerli prima che diventino difetti nei report.
Uno schema di implementazione utile consiste nell'instradare automaticamente questi controlli nel reporting di compliance, ed è qui che l'automazione del reporting di compliance diventa rilevante dal punto di vista operativo. Elimina il lavoro manuale di confezionamento che di solito rallenta la risposta agli audit.
Mappare le dimensioni della qualità dei dati sugli standard normativi
I framework di compliance e i team di data engineering usano spesso vocabolari diversi per lo stesso problema. Un regolatore chiede se il record è idoneo all'uso, mentre un ingegnere chiede se la colonna ha superato la validazione. Il divario si colma quando si mappano le dimensioni della qualità su standard riconosciuti, invece di trattarle come conversazioni separate.
La Data Quality Guidance del governo canadese definisce nove dimensioni: accesso, accuratezza, coesione, completezza, coerenza, interpretabilità, pertinenza, affidabilità e tempestività linee guida del governo canadese. Gli Archivi Nazionali australiani indicano la ISO 8000-110:2021 come standard globale per la qualità dei dati e i master data aziendali, ed elencano dimensioni comuni come accuratezza, completezza, coerenza, integrità, tempestività, unicità/deduplicazione e validità linee guida degli Archivi Nazionali australiani.
Con cosa possono lavorare davvero gli auditor
Questi framework sono importanti perché offrono ai team un linguaggio che si traduce direttamente in controlli. Se una policy stabilisce che i dati dei clienti devono essere accurati e tempestivi, il team tecnico può tradurlo in regole di validazione, controlli di latenza e logica di riconciliazione. Se la policy stabilisce che i dati devono essere affidabili, le evidenze dovrebbero mostrare come e quando sono stati testati.
Il Data Governance Primer della U.S. Administration for Community Living afferma che i dati aziendali dovrebbero essere testati periodicamente rispetto a standard di qualità definiti e indica accesso ai dati, definizione dei dati, policy sulla privacy, standard di sicurezza e standard di qualità dei dati come temi di governance primer dell'ACL. Il governo del Nuovo Galles del Sud aggiunge un dettaglio operativo utile: la gestione della qualità dei dati è un processo continuo lungo l'intero ciclo di vita dei dati, e le agenzie dovrebbero definire requisiti legati alle esigenze di business, inclusi standard di disponibilità, metriche e obiettivi modulo NSW sulla qualità dei dati.
Questa combinazione è il modello pratico. Gli standard definiscono le dimensioni, la governance definisce le responsabilità e le operations definiscono come vengono prodotte le evidenze.
Per i team che trasformano queste categorie in una mappa dei controlli funzionante, le dimensioni della qualità dei dati sono un utile punto di riferimento. È più facile sottoporre ad audit ciò che si sa nominare con chiarezza.
Perché la validazione basata su regole non basta per la compliance moderna
La validazione basata su regole ha ancora il suo spazio, ma crolla rapidamente quando le pipeline diventano più grandi, più veloci e più interdipendenti. I controlli hard-coded funzionano quando il modello dei dati è stabile e le eccezioni sono rare. Non funzionano bene quando lo schema cambia, i sistemi sorgente evolvono o la stessa regola deve essere mantenuta in una mezza dozzina di punti.
Il vero problema è la manutenzione
Una regola può dirvi che qualcosa è fallito. Non può dirvi se il fallimento è rilevante nel contesto, se i dati hanno cambiato forma o se lo stesso comportamento è normale per una fonte e sospetto per un'altra. Ecco perché i team finiscono con l'alert fatigue, script SQL fragili e controlli che si allontanano dalla realtà. Il costo operativo non è solo l'overhead di esecuzione, è la perdita di conoscenza quando un ingegnere se ne va e la logica delle regole se ne va con lui.
Il divario di compliance è più ampio di accuratezza, completezza e tempestività. I recenti cambiamenti normativi richiedono evidenze, non solo regole. Ciò significa lineage dimostrabile, tracciabilità, fonti dei dati di training documentate e metriche di qualità misurabili. I requisiti per i sistemi ad alto rischio dell'AI Act dell'UE sottolineano la documentazione delle fonti dei dati di training, delle trasformazioni e dell'utilizzo, mentre il framework ETSI del 2026 formalizza 18 metriche di qualità dei dati, tra cui usabilità, lineage, tracciabilità e tempestività panoramica su normative e standard.
Un insieme statico di regole può dimostrare che una condizione è stata verificata. Non può dimostrare che l'ambiente di controllo nel suo complesso sia rimasto affidabile.
È qui che l'observability fa la differenza. Il monitoraggio continuo intercetta il drift, osserva i cambiamenti di contesto e conserva il registro operativo di cui gli auditor hanno bisogno. Aiuta inoltre i team a evitare la trappola comune di trattare la compliance come una checklist anziché come un sistema di controllo vivo.
Per i data warehouse che si affidano ancora a validazioni costruite a mano, un confronto diretto è disponibile nell'articolo sulle regole tecniche di qualità dei dati definite manualmente. In pratica, la domanda non è se le regole debbano esistere. È se da sole siano sufficienti. Di solito non lo sono.
Costruire evidenze pronte per l'audit con il monitoraggio continuo
La differenza tra superare un audit e non superarlo si riduce spesso alle prove. Se un controllo di validazione è stato eseguito, ma non esiste un registro duraturo del dataset, delle impostazioni della regola, del timestamp e dell'esito, il controllo è difficile da difendere. Ecco perché considero le evidenze pronte per l'audit un obiettivo di progettazione primario, non un effetto collaterale.
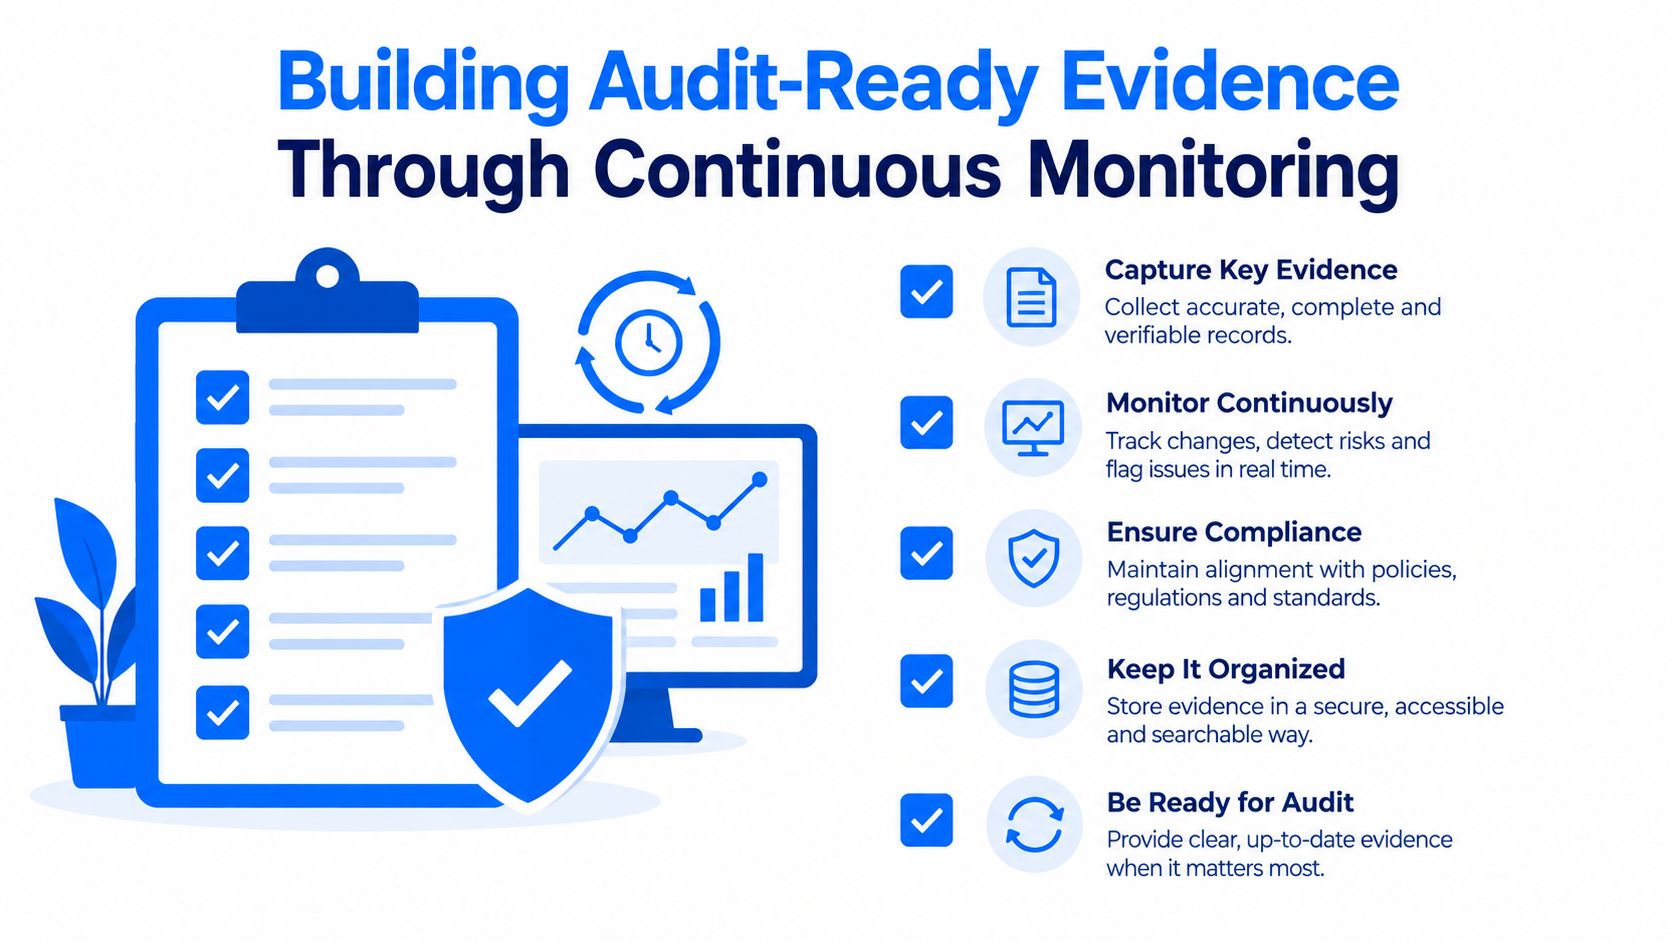
Lo schema pratico è semplice. Registrate ogni evento di validazione in modo immutabile, e rendete il log abbastanza granulare da rispondere alle domande che gli auditor pongono davvero. Ciò significa identità del dataset, identità della colonna, parametri della regola, timestamp, esito superato/fallito, numero di errori e storico delle risoluzioni linee guida sull'audit trail. Una volta che questo esiste, i team possono ricostruire cosa è stato verificato, quando è stato eseguito e come si è comportato il controllo prima e dopo le modifiche alle regole.
Cosa vi garantiscono queste evidenze
Accorciano le indagini quando lo schema drift o i dati in ritardo incidono sul reporting a valle. Conservano inoltre le soglie storiche, il che è importante quando una regola cambia ma il team di audit deve comunque sapere cosa è successo con l'impostazione precedente. Nelle pipeline regolamentate, è la differenza tra “pensiamo che andasse bene” e “ecco lo stato esatto del controllo in quel momento”.
Il vantaggio tecnico è altrettanto importante. Quando i risultati della validazione vengono registrati in modo coerente, i team possono quantificare la qualità al momento della validazione invece che dopo che i dati si sono già spostati. Questo rende l'analisi delle cause profonde molto più rapida, perché le evidenze riconducono allo specifico evento di controllo anziché a un vago sintomo della pipeline.
Il workflow di supporto non deve necessariamente rallentare la consegna. Se fatto bene, viene eseguito all'interno della pipeline, archivia il registro del controllo insieme all'evento e lo esporta su richiesta quando la compliance ne ha bisogno. È il modello di cui mi fido, perché regge sia alla pressione operativa sia alla revisione degli audit.
È disponibile anche un video dimostrativo pratico per i team che vogliono vedere come funziona nella realtà.
Caso di studio: sostituire 9000 regole manuali con l'observability basata sull'AI
ITSV, la spina dorsale IT della previdenza sociale austriaca, è un esempio utile perché la scala ha imposto una decisione concreta. Il team gestiva la qualità dei dati con 9000 regole scritte a mano nel proprio data warehouse, e quel modello non era più adeguato né ai volumi né all'onere di manutenzione. L'ambiente elaborava 50 GB al giorno da oltre 30 fonti in oltre 500 strutture, il che rendeva insostenibile la continua messa a punto delle regole dettagli del caso di studio.
La vecchia configurazione presentava i sintomi tipici. La conoscenza si perdeva quando le persone se ne andavano, la documentazione restava indietro rispetto alle regole e nessun team era davvero responsabile del framework dall'inizio alla fine. Oltre 140 alert giornalieri riempivano le caselle di posta, la maggior parte ignorati perché il loro significato non era chiaro, e solo il 25% dei casi rilevanti di qualità dei dati era coperto dettagli del caso di studio.
Cosa è cambiato con il passaggio dei controlli
Già a partire da settembre 2021, ITSV ha iniziato a sostituire il framework basato su regole con digna Data Anomalies e digna Data Timeliness. L'analisi è rimasta all'interno dell'infrastruttura di ITSV, in linea con le sue esigenze di privacy, e il team non ha dovuto regolare soglie né mantenere regole manualmente. Data Timeliness ha appreso i pattern di arrivo e segnalato i dati in ritardo o mancanti, mentre Data Anomalies ha appreso il comportamento normale in tutto il data warehouse e segnalato le deviazioni dettagli del caso di studio.
Questo è importante perché il caso non riguarda davvero la sostituzione di uno strumento. Riguarda la sostituzione di un fragile lavoro di manutenzione con un'observability che produce evidenze. I controlli sono diventati più facili da difendere perché erano al tempo stesso continui e tracciabili, e il team ha recuperato il tempo prima speso a smistare il rumore.
Ho visto migrazioni simili funzionare per un motivo preciso: spostano l'ownership dalla memoria umana al comportamento del sistema. I controlli non dipendono più dal fatto che qualcuno si ricordi quale regola andava aggiornata nel trimestre precedente. Vengono eseguiti, registrati e inoltrati in escalation in autonomia.
Rendere operativa la compliance sulla qualità dei dati tra i team
Nemmeno un'observability solida può colmare una lacuna di governance. La parte più difficile della compliance sulla qualità dei dati è spesso l'ownership, perché i fallimenti si collocano di solito tra i team anziché all'interno di un unico sistema. Dati di sondaggi recenti mostrano che il 44% degli intervistati afferma che l'ownership è condivisa tra più team, il 61% si affida ancora a controlli manuali o a validazioni basate su SQL e solo il 14% applica gli SLA a livello di intera organizzazione, sebbene il 39% monitori gli SLA per le pipeline chiave report del sondaggio.
Questo indica dove sta il lavoro. Il problema non è che i team non tengano alla qualità. È che hanno distribuito le responsabilità senza distribuire l'applicazione dei controlli. Se nessuno è responsabile del controllo dall'inizio alla fine, gli alert vengono smistati in modo informale, gli incidenti vengono instradati per abitudine e le evidenze di audit vengono raccolte troppo tardi.
Un modello operativo pratico
Iniziate con un responsabile designato per ogni dataset critico, poi definite cosa viene misurato, con quale frequenza viene verificato e dove finiscono gli incidenti quando il controllo fallisce. Rendete il logging immutabile, mantenete la lineage collegata al record e assicuratevi che il percorso di escalation sia esplicito. Se il fallimento di un controllo non può essere indirizzato a una persona, non è ancora operativo.
Un secondo requisito è la coerenza tra i team. Engineering, analytics e governance devono usare le stesse definizioni di freschezza, completezza e modifica dello schema. Se un gruppo produce report su una metrica mentre un altro valida un'interpretazione diversa dello stesso campo, l'audit trail sembrerà coerente solo finché qualcuno non inizierà a fare domande.
Regola pratica: la compliance diventa continua solo quando ownership, monitoraggio ed escalation sono abbastanza automatizzati da sopravvivere a una settimana intensa.
Un'opzione per i team che costruiscono questo modello operativo è digna, che monitora il comportamento dei dati all'interno dell'ambiente del cliente e supporta validazione, monitoraggio della tempestività, tracciamento dello schema ed evidenze pronte per l'audit. Se il vostro obiettivo è rendere i controlli più facili da difendere senza trasformare il vostro team in una fabbrica di regole manuali, vale la pena valutare come la piattaforma si integra nel vostro data warehouse e nel vostro stack di pipeline.
Se volete vedere come funziona l'approccio basato su baseline apprese del caso ITSV senza scrivere né regolare soglie, digna Data Anomalies mostra come modella il comportamento normale di ogni tabella e segnala automaticamente le deviazioni.
Domande frequenti
Che cos'è la compliance sulla qualità dei dati?
La compliance sulla qualità dei dati significa essere in grado di dimostrare che i dati regolamentati sono stati validati, tracciati e difesi, non solo verificati. L'articolo sostiene che un controllo conta solo se le evidenze mostrano che ha operato al momento giusto, sui dati giusti, con il risultato giusto, anziché essere ricostruito durante la preparazione dell'audit.
Perché i controlli di qualità dei dati basati su regole non bastano per la compliance?
Le regole hard-coded dimostrano che una condizione è stata verificata, ma non possono mostrare che l'ambiente di controllo nel suo complesso sia rimasto affidabile. Si rompono quando gli schemi cambiano e le fonti si modificano, generano alert fatigue e perdono conoscenza quando gli ingegneri se ne vanno. Normative come l'AI Act dell'UE e le 18 metriche di qualità dei dati dell'ETSI ora richiedono anche lineage e tracciabilità.
Cosa dovrebbe includere un audit trail per la validazione dei dati?
Ogni evento di validazione dovrebbe essere registrato in modo immutabile con identità del dataset, identità della colonna, parametri della regola, timestamp, esito superato o fallito, numero di errori e storico delle risoluzioni. Con questo registro, i team possono ricostruire esattamente cosa è stato eseguito e come si è comportato un controllo prima e dopo la modifica di una soglia o di una regola.
Quali dimensioni della qualità dei dati corrispondono agli standard normativi?
La Data Quality Guidance del Canada indica nove dimensioni, tra cui accuratezza, completezza, coesione, affidabilità e tempestività. La ISO 8000-110:2021, citata dagli Archivi Nazionali australiani, aggiunge integrità, unicità e validità. Mapparle su regole di validazione, controlli di latenza e logica di riconciliazione offre ad auditor e ingegneri un vocabolario condiviso.
Come ha fatto ITSV a sostituire 9000 regole manuali di qualità dei dati?
A partire da settembre 2021, ITSV ha sostituito il proprio framework di regole scritte a mano con digna Data Anomalies e Data Timeliness, eseguiti all'interno della propria infrastruttura. Il data warehouse acquisisce 50 GB al giorno da oltre 30 fonti, e la vecchia configurazione produceva oltre 140 alert giornalieri coprendo solo il 25% dei casi rilevanti.


