Integrazione del data warehouse: guida per i team dati moderni
|
4
min di lettura
Un progetto di integrazione del warehouse di solito nasce da un reclamo del business, non da un diagramma architetturale.
Un responsabile finance apre la dashboard mensile dei ricavi e vede totali che non corrispondono al CRM. Le operations segnalano che i dati di magazzino arrivano con diverse ore di ritardo. Il team dati controlla i log delle pipeline e trova ogni job contrassegnato come riuscito. Nulla sembra rotto, eppure nessuno si fida dei numeri. È questo il problema centrale che l'integrazione del data warehouse deve risolvere. Non si tratta solo di spostare dati da un sistema all'altro, ma di creare una base analitica affidabile che le persone possano usare senza mettere in dubbio ogni grafico.
La maggior parte dei team enterprise alla prima esperienza si concentra su connettori, pianificazioni dei caricamenti e codice di trasformazione. Sono aspetti importanti. Ma i progetti che reggono nel tempo sono quelli che trattano l'integrazione come una disciplina di affidabilità. Servono schema mapping, trasformazioni controllate, lineage, governance e un monitoraggio post-caricamento che intercetti i guasti più sottili prima che si propaghino a dashboard, previsioni e feature di machine learning.
Indice
Le architetture fondamentali di integrazione del data warehouse
Checklist per il successo dell'integrazione e piano di validazione
Il vero costo dei dati scollegati
Lo schema di fallimento classico è questo. Le vendite riportano un totale clienti dal CRM, la finanza ne riporta un altro dall'ERP e l'assistenza ha una terza versione nella sua piattaforma di ticketing. Ogni team ha i suoi dati. Nessuno è d'accordo.
Questa discrepanza fa più danni di un'interruzione visibile. Gli analisti costruiscono soluzioni alternative nei fogli di calcolo. I dirigenti smettono di fidarsi della BI. Gli ingegneri passano le mattinate a dimostrare se il problema dipende dalla fonte, dal mapping o da un caricamento non aggiornato. Una sola metrica errata può minare la fiducia nell'intero warehouse.
L'integrazione del data warehouse è ciò che trasforma questo caos in un sistema. Offre un unico percorso governato dalle applicazioni sorgente a un modello analitico condiviso. Invece di lasciare che ogni team interpreti in modo diverso gli export grezzi, il warehouse standardizza le definizioni, allinea la granularità e conserva lo storico in una forma che strumenti di reporting e modelli possono usare in modo coerente.
Non è un problema esclusivo del software o della finanza. I settori con sistemi operativi frammentati incontrano la stessa difficoltà. Se vi serve un esempio semplice di come sistemi aziendali scollegati creino attriti nel reporting, questa guida alle integrazioni per le imprese edili mostra il lato operativo dello stesso schema. Applicazioni diverse possono servire bene team diversi, ma generano caos analitico quando nessuno è responsabile del livello di integrazione.
La perdita di fiducia di solito costa più di un job fallito. I team si riprendono da un'interruzione visibile più in fretta che da settimane di numeri silenziosamente sbagliati.
Se state cercando di rendere visibile l'impatto sul business, un calcolatore del costo del data downtime può aiutarvi a inquadrare in termini concreti il costo operativo di dati inaffidabili. Questa conversazione è importante, perché l'integrazione del warehouse viene spesso finanziata come semplice “idraulica”, quando andrebbe trattata come infrastruttura decisionale.
Le architetture fondamentali di integrazione del data warehouse
I team discutono spesso di ETL contro ELT come se uno dei due pattern avesse vinto. Non è così. Una buona architettura nasce dall'abbinare il pattern al carico di lavoro.
Il modo più semplice per spiegare i compromessi è il modello della cucina. Gli ingredienti crudi sono i dati sorgente. La preparazione è la trasformazione. L'impiattamento è il modello finale del warehouse. La domanda non è quale cucina sia la migliore in teoria, ma dove si fa la preparazione, quanto velocemente il piatto deve uscire e quanto volume la cucina riesce a gestire.
La direzione del mercato spiega perché questi pattern contano. Il mercato complessivo dell'integrazione dei dati è stimato in 15,18 miliardi di USD nel 2026 e 30,27 miliardi di USD entro il 2030, con una crescita legata all'elaborazione in tempo reale tramite sistemi di streaming come Apache Kafka per casi d'uso quali il rilevamento delle frodi e la gestione dell'inventario in tempo reale, secondo l'analisi di Integrate.io sui tassi di crescita dell'integrazione dei dati in tempo reale.
In cosa differiscono i pattern principali
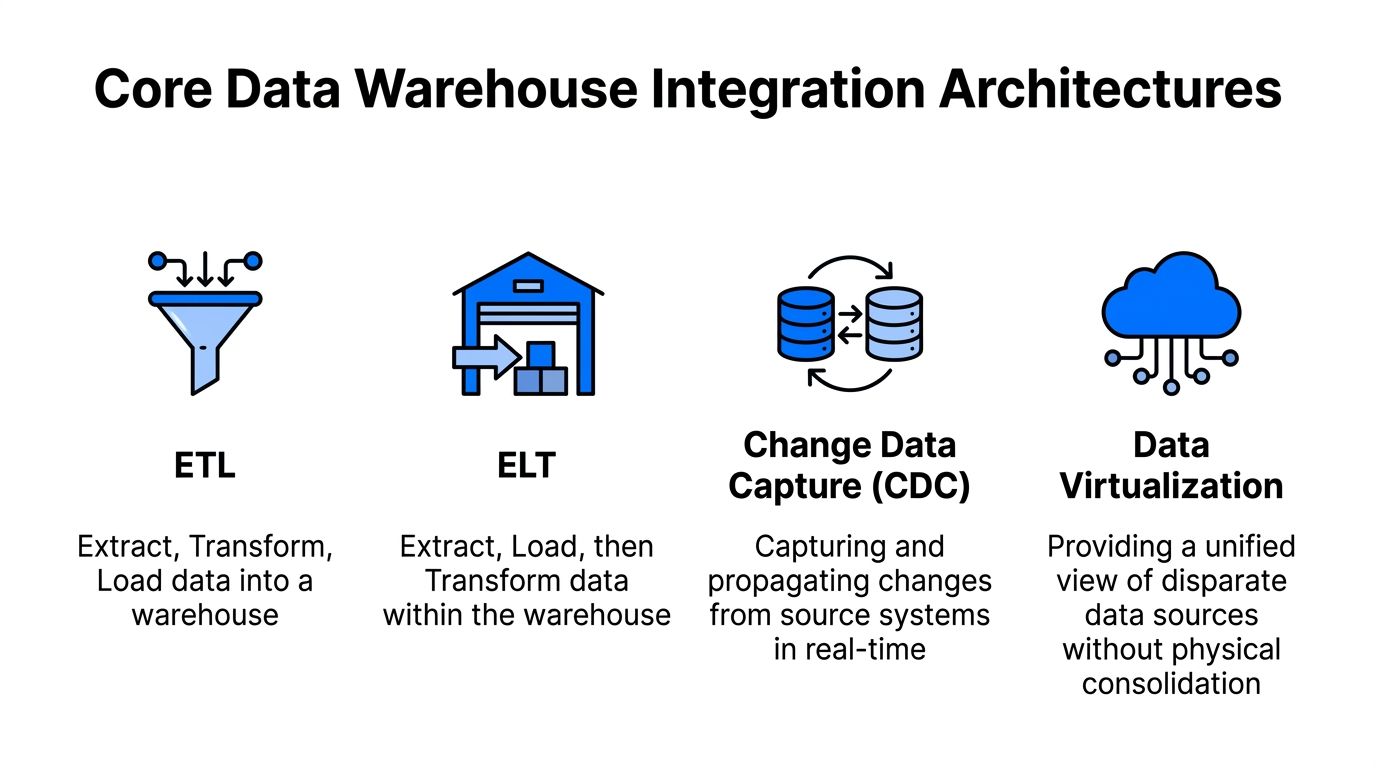
ETL è la cucina di preparazione. Si estraggono i dati dai sistemi sorgente, li si trasforma prima che raggiungano il warehouse, poi si carica un risultato pulito e conforme. Funziona bene quando i controlli di qualità devono avvenire prima che i dati siano esposti agli analisti. Le riconciliazioni notturne e il reporting regolamentato rientrano spesso in questo caso.
ELT carica prima e trasforma all'interno del warehouse. È l'approccio del cuoco di linea per le moderne piattaforme cloud. Si caricano rapidamente dati grezzi o leggermente standardizzati, poi si usa la potenza di calcolo del warehouse per le trasformazioni pesanti. Di solito è la scelta migliore quando i volumi sono elevati e non si vuole che sistemi di trasformazione esterni diventino il collo di bottiglia.
CDC, o Change Data Capture, osserva inserimenti, aggiornamenti ed eliminazioni alla fonte e propaga solo ciò che è cambiato. Riduce gli spostamenti non necessari e mantiene aggiornate le tabelle analitiche senza ricaricamenti completi. È uno dei modi più pratici per supportare un reporting quasi in tempo reale, proteggendo al tempo stesso i sistemi sorgente da continue estrazioni complete.
Lo streaming invia gli eventi nel momento in cui si verificano. Invece di attendere il batch pianificato successivo, la pipeline elabora i dati in modo continuo. È la soluzione a cui ricorrere quando il warehouse alimenta analytics operativi, alerting o feature di ML che perdono rapidamente valore se arrivano in ritardo.
Regola pratica: se il business tollera i ritardi e richiede controlli rigorosi prima del caricamento, ETL è di solito più semplice. Se il business ha bisogno di dati freschi e il warehouse dispone di una buona potenza di calcolo, ELT e CDC di solito invecchiano meglio.
Confronto tra architetture di integrazione dei dati
Pattern | Punto di trasformazione | Latenza | Ideale per |
|---|---|---|---|
ETL | Prima del caricamento nel warehouse | Batch, spesso pianificato | Riconciliazioni notturne, validazione rigorosa prima del caricamento |
ELT | All'interno del warehouse dopo il caricamento | Da batch a quasi tempo reale | Grandi volumi, warehouse cloud-native, trasformazioni flessibili |
CDC | Trasformazione minima durante la propagazione delle modifiche, poi gestione a valle | Quasi tempo reale | Mantenere aggiornate le tabelle del warehouse dai sistemi transazionali |
Streaming | Elaborazione degli eventi in linea e trasformazioni a valle | Tempo reale | Rilevamento delle frodi, inventario in tempo reale, analisi delle minacce |
Ciò che non funziona è scegliere un unico pattern per tutte le fonti. Estrazioni dall'ERP, API del CRM, log di eventi e flussi IoT non si comportano allo stesso modo. Le piattaforme mature combinano questi approcci. Possono usare ETL per i processi di chiusura contabile, ELT per la replica delle applicazioni SaaS, CDC per i database operativi e streaming per i dati di eventi.
Attenzione anche alla trappola comune nel linguaggio dell'infografica. La data virtualization può essere utile per un accesso unificato, ma non equivale all'integrazione del warehouse. La virtualizzazione aiuta ad astrarre l'accesso. Un warehouse ha comunque bisogno di modellazione fisica, trasformazioni governate e uno storico duraturo se volete analytics affidabili.
Un piano pratico per integrare le fonti dati
La maggior parte dei programmi di integrazione falliti parte troppo a valle. I team si affrettano a costruire pipeline prima di aver profilato le fonti, allineato le definizioni di business o concordato come gestire i conflitti. Poi passano mesi a riscrivere logiche che avrebbero dovuto essere definite nella prima settimana.
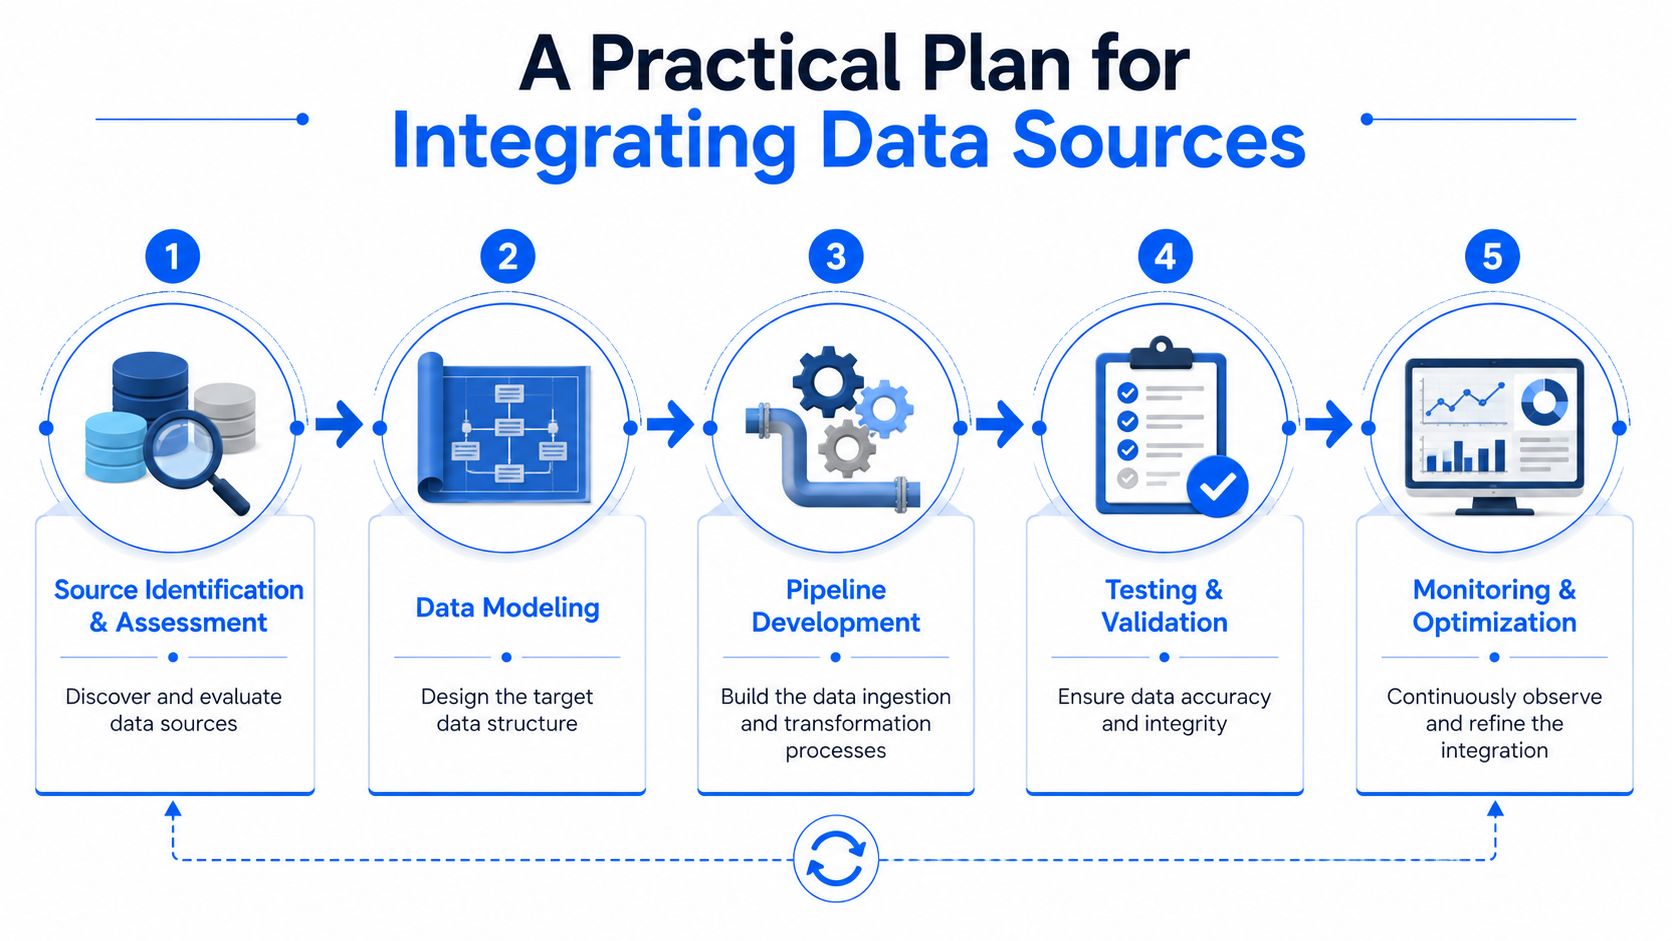
Un'integrazione efficace del warehouse dipende dalla mappatura di schemi eterogenei provenienti da sistemi come ERP e CRM in un modello unificato. La scelta tra ETL ed ELT deriva direttamente dai requisiti del progetto. L'ETL batch è adatto ai job notturni con controlli di qualità prima del caricamento, mentre l'ELT è adatto a casi d'uso ad alto volume basati su streaming o API perché sfrutta la potenza di calcolo del warehouse per la trasformazione, come illustrato nella guida di Exasol all'integrazione del data warehouse.
Partire dalla realtà delle fonti, non dalle ambizioni del target
Iniziate facendo l'inventario dei sistemi sorgente e profilando i dati stessi. Non fidatevi dei nomi dei campi. Una colonna chiamata customer_id in un sistema può contenere un identificativo a livello di account, mentre un'altra fonte la usa per un singolo contatto. Il primo deliverable pratico non è una pipeline, ma un contratto sulla fonte.
Concentratevi su quattro domande iniziali:
Qual è la granularità di business di ciascun dataset. Ordine, riga d'ordine, account, sessione, polizza, sinistro.
Quali campi sono autorevoli in ciascuna fonte. Non lasciate che due sistemi “possiedano” entrambi lo stesso fatto di business senza una regola esplicita.
Come sono rappresentati tempo e stato. Timestamp, fusi orari locali, soft delete e codici di stato generano più difetti di quanto previsto inizialmente.
Quale storico va conservato. Molte applicazioni sorgente sovrascrivono i valori correnti. Le analisi spesso hanno bisogno dello stato precedente.
È anche il momento in cui conta la risoluzione dei conflitti di schema. Convenzioni di denominazione, tipi di dati, formati di valuta e unità di misura devono essere normalizzati prima di raggiungere i livelli di reporting di business. Se il CRM memorizza i ricavi come decimali e l'ERP memorizza i valori monetari presupponendo la valuta locale, serve un modello canonico chiaro prima che qualcuno scriva la logica dei KPI.
Costruire la pipeline a livelli
Uno stack di integrazione duraturo ha di solito almeno tre livelli.
Livello di landing
Acquisite i dati sorgente con interferenze minime. Conservate la forma grezza, i timestamp di caricamento e i metadati di estrazione. Questo livello aiuta con replay, audit e root cause analysis.Livello di standardizzazione Normalizzate chiavi, timestamp, conversioni di tipo, valori di stato e incoerenze strutturali. Molti conflitti tra sistemi vengono risolti in questo livello.
Livello di business Pubblicate modelli orientati ai soggetti per le analisi. Vendite, clienti, sinistri, prodotti, assistenza. In questo livello i team dovrebbero consumare i dati, non nelle tabelle di ingestione grezze.
Alcune scelte funzionano bene in modo costante:
Usate caricamenti idempotenti: le pipeline devono poter essere rieseguite in sicurezza senza duplicare record o corrompere lo storico.
Separate l'ingestione dalla logica di business: non mescolate il codice di estrazione con la logica delle metriche. Rende doloroso il change management.
Tracciate il lineage fin da subito: registrate tabella sorgente, momento dell'estrazione e dipendenze di trasformazione dalla prima esecuzione in produzione.
Gestite le eliminazioni in modo esplicito: soft delete, hard delete e disattivazioni basate sullo stato richiedono ciascuna una gestione diversa.
Il modo più rapido per produrre dashboard errate è rimandare i controlli di integrità referenziale a quando gli stakeholder hanno già iniziato a costruire report.
Anche l'orchestrazione merita più attenzione di quanta ne riceva di solito. Una pipeline può avere un SQL perfetto e fallire comunque a livello operativo se le dipendenze sono poco chiare. Definite ordine di caricamento, comportamento dei retry, aspettative di freschezza ed escalation dei guasti prima del lancio. L'affidabilità dell'integrazione dipende dal flusso di controllo tanto quanto dal codice di trasformazione.
Combattere i guasti silenziosi con la data observability
Una dashboard delle pipeline tutta verde non significa che il vostro warehouse sia in salute.
I problemi più costosi nell'integrazione del warehouse si verificano spesso dopo l'arrivo dei dati. Un team sorgente aggiunge una colonna, cambia un tipo di dato, sposta la tempistica degli eventi o modifica il comportamento di un processo di business. La pipeline termina comunque. Le tabelle si popolano comunque. Le dashboard si caricano comunque. Ma le misure chiave iniziano a deviare perché il significato, la forma o la tempestività dei dati sono cambiati senza un errore esplicito.
È il punto cieco che la maggior parte delle guide all'implementazione tralascia. Un sondaggio TDWI ha rilevato che il 72% dei team dati segnala dashboard errate a causa di modifiche di schema non monitorate e derive di latenza, come evidenziato nella discussione di TDWI sulle lacune dell'integrazione moderna dei dati. Il problema chiave non è solo l'ETL fallito, ma la deriva silenziosa che sfugge ai test tradizionali.
Perché caricamenti riusciti producono comunque analisi errate
La validazione tradizionale di solito verifica se il job è stato eseguito, se il numero di righe sembra plausibile e se i campi obbligatori non sono nulli. Questi controlli sono importanti, ma non colgono un'ampia classe di guasti a valle.
Ecco alcuni esempi comuni:
Schema drift: una fonte cambia
status_codeda intero a stringa. La conversione nel warehouse riesce, ma la logica di business che si basa sulla mappatura numerica ora si comporta in modo diverso.Deriva di latenza: i dati che di solito arrivano al mattino presto iniziano ad arrivare ore dopo. Le dashboard si aggiornano secondo la pianificazione e mostrano un'attività di business parziale come se fosse completa.
Deriva della distribuzione: un processo sorgente cambia a monte e la proporzione dei valori tra le categorie si sposta bruscamente. Tecnicamente nulla fallisce, ma le previsioni e le metriche sensibili alle anomalie diventano inaffidabili.
Deriva della granularità: record che prima rappresentavano un evento per cliente ora rappresentano un evento per riga d'ordine. Gli aggregati si gonfiano senza alcun errore del loader.
Non sono problemi teorici. Si presentano di continuo nei programmi di warehouse di prima generazione, perché i team trattano l'integrazione come un trasporto anziché come un sistema di produzione monitorato.
Il caricamento nel warehouse è solo l'inizio dell'integrazione. La vera prova è se i dati mantengono lo stesso significato, la stessa freschezza e la stessa struttura quando intorno a loro iniziano a verificarsi cambiamenti in produzione.
La differenza tra monitoraggio di base e osservabilità è il contesto. Il monitoraggio vi dice se la pipeline è stata eseguita. L'osservabilità vi aiuta a rilevare se l'output si comporta ancora come previsto.
Cosa monitorare dopo l'arrivo dei dati
I controlli post-caricamento dovrebbero stare vicino al warehouse, non solo nel livello di orchestrazione. I controlli di maggior valore includono di solito:
Monitoraggio della freschezza: apprendete le finestre di arrivo previste per tabella e fonte. Generate alert su caricamenti in ritardo, mancanti o parziali prima che gli utenti di business vedano dashboard non aggiornate.
Tracciamento dello schema: rilevate automaticamente colonne aggiunte o rimosse, modifiche dei tipi di dati e variazioni inattese della nullabilità.
Rilevamento delle anomalie sulle metriche: osservate numero di righe, somme, rapporti, cardinalità e spostamenti della distribuzione. Spesso è il primo segnale che un processo sorgente è cambiato.
Validazione a livello di record: applicate le regole di business lato warehouse, soprattutto dove valgono requisiti di reporting regolamentato o di audit.
Analisi dei trend: confrontate il comportamento attuale con i pattern di riferimento nel tempo, così i team possono distinguere un vero incidente dalla normale stagionalità.
I team chiedono spesso se gli unit test nel codice di trasformazione possano gestire tutto questo. Ne gestiscono una parte, ma non abbastanza. I test statici sono bravi a validare la logica attesa. Sono più deboli nel rilevare le incognite sconosciute, soprattutto quando la fonte è cambiata in un modo che nessuno aveva modellato.
Uno stack di osservabilità pratico dovrebbe rispondere ogni giorno a domande come queste:
Controllo | Cosa intercetta | Perché è importante |
|---|---|---|
Freschezza | Arrivi in ritardo o mancanti | Previene reporting parziale e decisioni basate su dati non aggiornati |
Modifica di schema | Colonne aggiunte, rimosse o modificate | Protegge le trasformazioni e i modelli semantici a valle |
Anomalia di volume | Picchi o cali inattesi | Segnala problemi di estrazione alla fonte o modifiche di processo |
Anomalia di distribuzione | Pattern di valori insoliti | Intercetta derive silenziose nei processi di business o nel mapping |
Violazione di una regola di validazione | Errori della logica di business a livello di record | Supporta fiducia, conformità e preparazione agli audit |
Per i team che vogliono approfondire perché questo livello è importante, questa guida sul perché la data observability è cruciale per la gestione moderna dei dati è una lettura complementare utile.
Una breve panoramica è utile se i vostri stakeholder pensano ancora che “job riuscito” sia sufficiente:
Deployment e sicurezza dell'integrazione enterprise
L'integrazione enterprise del warehouse raramente è limitata dall'SQL. È limitata dalle revisioni di sicurezza, dai requisiti di governance e dalla complessità operativa di movimentare dati su larga scala.
L'adozione di warehouse cloud-native è uno dei motivi per cui questo lavoro continua ad accelerare. Si prevede che il mercato globale del DWaaS cresca da 8,13 miliardi di USD nel 2025 a 43,16 miliardi di USD entro il 2035, trainato dalle aziende di settori come finanza e sanità che adottano architetture cloud-native con integrazione in tempo reale e automazione basata sull'AI, secondo Precedence Research sul mercato del data warehouse as a service.
Le scelte architetturali determinano il rischio
Il design di integrazione più sicuro di solito riduce al minimo gli spostamenti di dati non necessari. Se potete trasformare e validare all'interno del warehouse o in ambienti strettamente controllati, riducete il numero di sistemi che contengono copie di dati sensibili. Questo conta per i settori regolamentati e conta per l'audit interno.
Alcuni pattern di solito reggono bene:
Preferite landing zone controllate: non disperdete le estrazioni grezze in posizioni di storage improvvisate.
Usate l'accesso basato sui ruoli: gli ingegneri non hanno sempre bisogno di accedere direttamente ai campi di business sensibili, e gli analisti raramente hanno bisogno di dati grezzi senza restrizioni.
Separate gli account di servizio per funzione: estrazione, trasformazione e consumo dovrebbero avere permessi distinti.
Registrate le azioni delle pipeline: accessi, modifiche di schema, caricamenti falliti e retry dovrebbero lasciare una traccia operativa.
La governance va integrata fin dall'inizio
La governance non è documentazione da aggiungere dopo il deployment. Inizia quando si definiscono ownership delle fonti, data contract, regole di conservazione e aspettative di lineage. Se i team aspettano la produzione per chiarire chi è responsabile di customer_status o quale sistema è autorevole per le rettifiche dei ricavi, finiscono per governare gli incidenti invece di governare i dati.
I programmi enterprise più solidi allineano anche le aree tematiche ai confini delle policy. Modelli finanziari, dataset sanitari e dati dell'assistenza clienti hanno spesso regole di accesso, esigenze di conservazione e standard di validazione diversi. Il warehouse può essere centralizzato, ma la governance raramente lo è.
I problemi di sicurezza nell'integrazione nascono di solito da decisioni di comodo. Le estrazioni temporanee diventano permanenti. Le credenziali condivise restano in circolazione. Le tabelle di debug sopravvivono all'incidente per cui erano state create.
Anche la scalabilità conta. Un vero deployment enterprise significa che l'architettura deve assorbire nuove fonti, schemi che cambiano e requisiti di conformità più stringenti senza una riprogettazione ogni trimestre. Ecco perché modellazione orientata ai soggetti, acquisizione dei metadati e un controllo degli accessi disciplinato non sono un costo aggiuntivo: sono ciò che mantiene la piattaforma gestibile man mano che l'adozione cresce.
Checklist per il successo dell'integrazione e piano di validazione
Un primo programma di integrazione enterprise non ha bisogno di un'architettura perfetta. Ha bisogno di un modello operativo ripetibile. I team migliori rendono esplicita la propria checklist, la applicano a ogni nuova fonte e trattano la validazione come un'attività continua anziché formale.
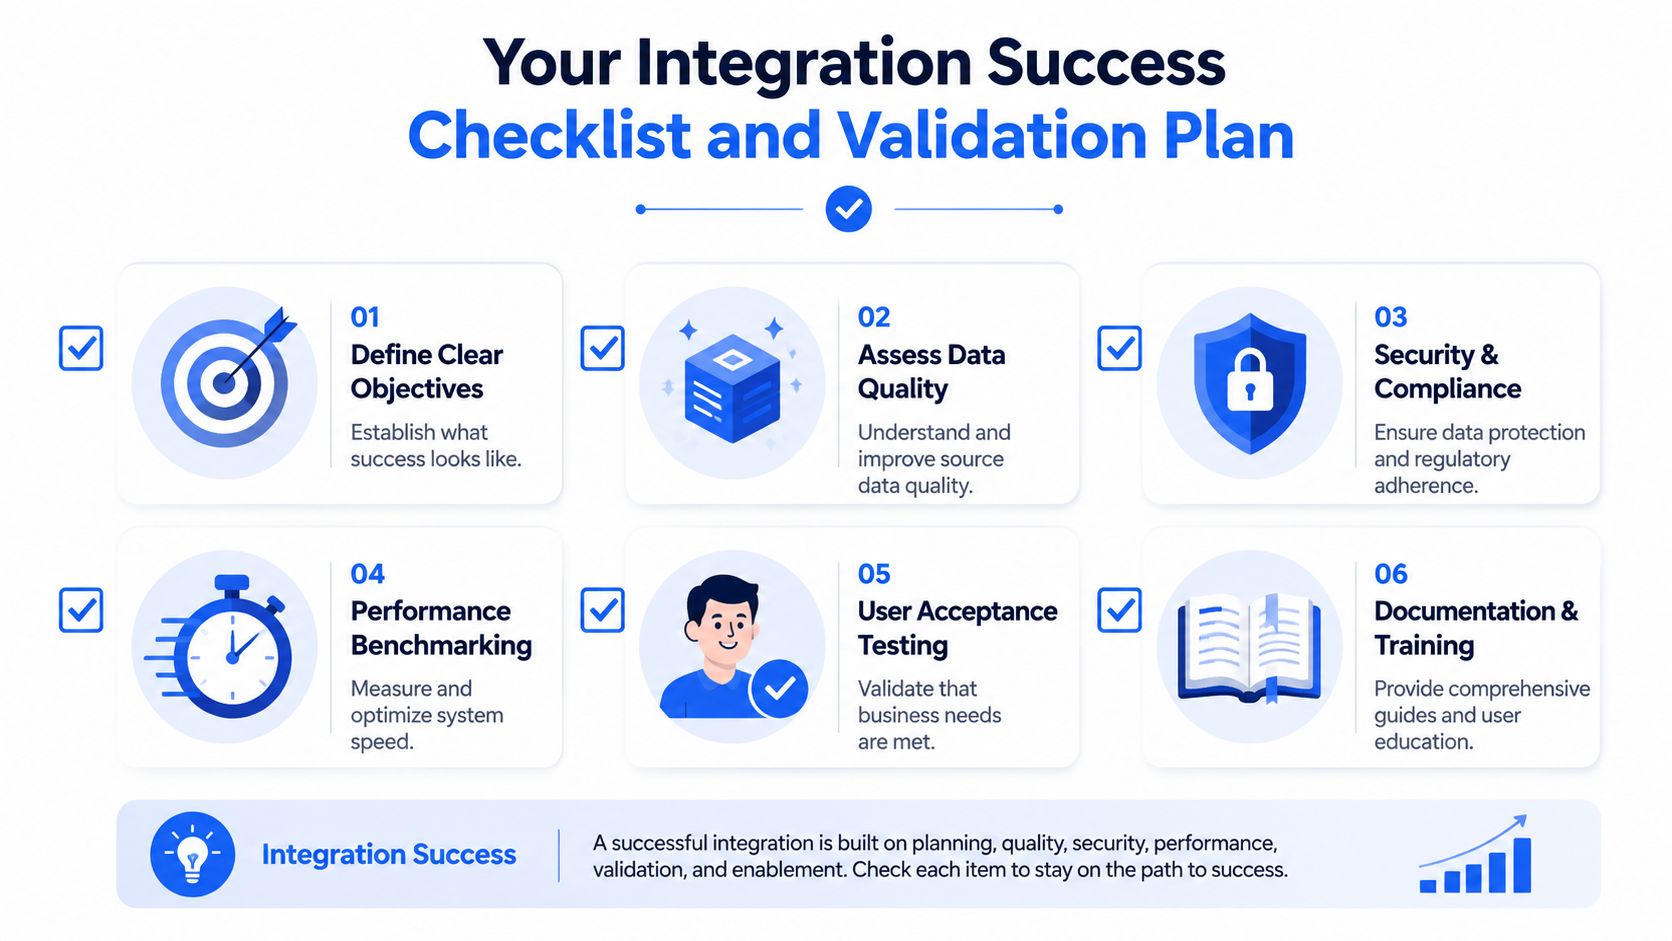
Checklist pre-deployment
Usatela prima di promuovere qualsiasi pipeline in produzione.
Definite l'obiettivo di business: indicate le decisioni che questa integrazione supporta. “Caricare i dati del CRM” non è un obiettivo. “Fornire un reporting affidabile su clienti e pipeline commerciale” lo è.
Fissate l'ownership delle fonti: ogni campo critico ha bisogno di un responsabile di business o di sistema. Se l'ownership è vaga, i difetti rimbalzeranno tra i team.
Documentate la granularità del target: specificate se il modello rappresenta account, ordine, sinistro, evento o un'altra entità di business. Molti errori di reporting nascono da ipotesi implicite sulla granularità.
Profilate presto le anomalie delle fonti: pattern di valori nulli, chiavi duplicate, timestamp mancanti e incoerenze di tipo dovrebbero essere noti prima dell'inizio della modellazione.
Scegliete il pattern di integrazione in modo consapevole: ETL batch, ELT, CDC o streaming devono riflettere esigenze di freschezza, volume e controllo.
Progettate per il replay: conservate metadati e storico di landing sufficienti per rieseguire in sicurezza dopo un caricamento fallito o parziale.
Stabilite le aspettative di freschezza: gli utenti di business devono sapere quando i dati sono attesi e cosa significa “completo” per ciascun dominio.
Definite le regole di accesso e mascheramento: i controlli di sicurezza devono essere rilasciati insieme al modello, non dopo che arrivano i reclami.
Preparate l'ownership operativa: qualcuno deve essere responsabile di incidenti, retry, coordinamento con le fonti e comunicazione a valle.
Validazione e test moderni
La vecchia pratica di validazione consisteva nel campionare qualche record, confrontare i totali e sperare che la pipeline si comportasse bene la settimana successiva. Non regge più quando i sistemi sorgente evolvono.
Un piano di validazione più solido combina test fissi con controlli continui lato warehouse:
Validazione pre-caricamento
Verificate completezza dell'estrazione, campi obbligatori e disponibilità della consegna dalla fonte.Validazione delle trasformazioni
Testate join, unicità delle chiavi, conversioni di tipo e integrità referenziale all'interno dei livelli modellati.Validazione delle regole di business
Verificate la logica di dominio, come transizioni di stato valide, ordine delle date e combinazioni obbligatorie di attributi.Osservabilità post-caricamento
Osservate freschezza, modifiche di schema, variazioni di volume e anomalie delle metriche quando i dati sono già disponibili per i consumatori.Validazione lato consumatori
Verificate che modelli BI, dashboard e tabelle di feature ML siano ancora allineati agli output attesi del warehouse.
Per affrontare queste sfide, molti team hanno bisogno di strumenti che vadano oltre i log di orchestrazione e le asserzioni SQL. Un approccio moderno alla validazione dovrebbe monitorare continuamente il comportamento del warehouse, confrontare i caricamenti attuali con baseline apprese, rilevare gli arrivi in ritardo e far emergere lo schema drift prima che gli utenti di business lo scoprano in una dashboard. Se state formalizzando questo processo, questa guida alla validazione dei dati durante le migrazioni e alle best practice è un riferimento pratico.
Una checklist di revisione finale per il go-live dovrebbe rispondere sì a queste domande:
Area di validazione | Domanda per il go-live |
|---|---|
Prontezza delle fonti | Sappiamo di cosa è responsabile ciascuna fonte e con quale frequenza cambia? |
Modellazione | La granularità del warehouse è esplicita e documentata? |
Affidabilità delle pipeline | I job possono essere rieseguiti in sicurezza e riprendersi da un errore parziale? |
Qualità dei dati | Le regole di business chiave vengono applicate automaticamente? |
Freschezza | Sappiamo quando deve arrivare ciascuna tabella e come segnalare i ritardi? |
Protezione dalle derive | Siamo in grado di rilevare modifiche di schema e di distribuzione dopo il caricamento? |
Sicurezza | Controlli di accesso e percorsi di audit sono in atto? |
Consumo | Dashboard e modelli a valle sono stati validati rispetto all'output finale del warehouse? |
Se il vostro team non sa rispondere chiaramente a queste domande, probabilmente l'integrazione non è finita. Sta solo caricando dati.
Un'integrazione affidabile del warehouse non si ferma a ETL o ELT. Dipende dalla capacità di intercettare dati in ritardo, schema drift e anomalie sottili dopo il caricamento, quando spesso il successo viene dichiarato troppo presto. digna aiuta i team dati a monitorare la freschezza, validare i record, tracciare le modifiche di schema e rilevare le derive silenziose dei dati all'interno del proprio ambiente, così le analisi restano affidabili in produzione.
Se lo schema drift è il guasto post-caricamento che più volete intercettare, digna Schema Tracker rileva colonne aggiunte, rimosse e con tipo modificato prima che emergano nelle dashboard.
Domande frequenti
Che cos'è l'integrazione del data warehouse?
L'integrazione del data warehouse crea un unico percorso governato dalle applicazioni sorgente, come CRM ed ERP, a un modello analitico condiviso. Oltre a spostare i dati, standardizza le definizioni, allinea la granularità e conserva lo storico, così finanza, vendite e assistenza smettono di riportare tre diversi totali clienti da tre sistemi diversi.
Qual è la differenza tra ETL, ELT e CDC per un data warehouse?
L'ETL trasforma i dati prima del caricamento ed è adatto alle riconciliazioni notturne con controlli rigorosi prima del caricamento. L'ELT carica prima e usa la potenza di calcolo del warehouse per le trasformazioni pesanti su grandi volumi. Il CDC propaga dalla fonte solo inserimenti, aggiornamenti ed eliminazioni, mantenendo le tabelle aggiornate quasi in tempo reale senza ricaricamenti completi.
Quali livelli dovrebbe avere una pipeline di integrazione del data warehouse?
Uno stack duraturo ha almeno tre livelli. Il livello di landing conserva la forma grezza, i timestamp di caricamento e i metadati di estrazione per replay e audit. Il livello di standardizzazione normalizza chiavi, timestamp, tipi e valori di stato. Il livello di business pubblica modelli orientati ai soggetti, come vendite, clienti o sinistri, per le analisi.
Perché caricamenti riusciti nel warehouse producono comunque dashboard errate?
I job possono riuscire mentre schema, latenza, distribuzione o granularità derivano silenziosamente. Un sondaggio TDWI citato nell'articolo ha rilevato che il 72% dei team dati segnala dashboard errate a causa di modifiche di schema non monitorate e derive di latenza, ad esempio quando status_code passa da intero a stringa e la conversione nel warehouse riesce comunque.
Cosa bisogna monitorare dopo l'arrivo dei dati nel warehouse?
I controlli post-caricamento dovrebbero stare vicino al warehouse e coprire la freschezza rispetto alle finestre di arrivo previste, le modifiche di schema come colonne aggiunte o rimosse, le anomalie di volume e di distribuzione, le regole di validazione a livello di record e l'analisi dei trend rispetto alle baseline. Insieme aiutano a distinguere gli incidenti reali dalla normale stagionalità.


