Che cos'è la distribuzione dei dati: guida 2026
|
7
min di lettura

La vostra dashboard si accende prima che il caffè si raffreddi. Durante la notte, una metrica di fatturato che di solito resta in un intervallo familiare inizia a comportarsi diversamente, e l'alert non riguarda affatto la media, riguarda la forma dei dati. È il momento in cui molti team si rendono conto di aver osservato la cosa sbagliata, perché una media stabile può nascondere una distribuzione che si è spostata, è diventata asimmetrica o ha accumulato outlier.
Capire che cos'è la distribuzione dei dati significa capire come i valori si distribuiscono, dove si concentrano e come cambiano nel tempo. Per i data engineer non si tratta di teoria astratta, ma della differenza tra un modello che continua a funzionare e una pipeline che si degrada gradualmente. In pratica, la forma della distribuzione vi aiuta a decidere se trasformare una metrica, usare uno stimatore robusto, restringere le soglie di anomalia o indagare su una sorgente guasta.
Indice
Introduzione alla distribuzione dei dati
Una distribuzione è lo schema che sta dietro ai vostri valori, non solo il mucchio di righe in una tabella. Per i dati numerici, gli statistici descrivono di solito questo schema attraverso centro, dispersione, modalità, forma e outlier. Per i dati categoriali, la domanda chiave è più semplice: con quale frequenza compare ciascuna categoria rispetto alle altre? La panoramica di ScienceDirect sulla distribuzione dei dati la tratta come un passaggio di sintesi di base, e questo è importante perché le decisioni a valle dipendono da essa.
Perché dovrebbe interessare ai team che gestiscono pipeline
Un istogramma è spesso il primo posto in cui un data engineer dovrebbe guardare quando una metrica cambia. Mostra se i valori sono concentrati vicino a un centro, sbilanciati da un lato, divisi in più cluster o contaminati da outlier. Questi schemi influenzano le scelte di trasformazione, la stima e le soglie di anomalia, quindi un controllo visivo può far emergere un problema prima che una singola media dia un'impressione sbagliata.
Una pipeline può sembrare sana in una dashboard e intanto deviare sotto la superficie. Una sorgente può iniziare a inviare record in ritardo, una fase di ingestione può duplicare eventi o un segmento di clienti può cambiare in modo tale da modificare la forma della metrica. Ecco perché la comprensione della distribuzione dei dati torna continuamente nel lavoro in produzione.
Un semplice esempio aiuta. Se la latenza delle richieste mantiene la stessa media ma la coda si allunga, il carico di lavoro si sta comportando diversamente anche se il numero di sintesi sembra stabile. Lo stesso tipo di cambiamento può presentarsi nei valori degli ordini, negli input delle feature o nei conteggi degli errori, e spesso indica un cambiamento operativo piuttosto che rumore casuale.
Regola pratica: se la media sembra a posto ma l'istogramma appare diverso, trattatelo come un incidente reale finché non viene dimostrato il contrario.
Questa abitudine diventa più facile da mantenere quando i controlli sulla distribuzione restano vicini ai dati. Strumenti come digna aiutano i team a esaminare questi schemi direttamente nel database, accorciando il percorso da una forma anomala a una probabile causa principale.
Comprendere le forme delle distribuzioni
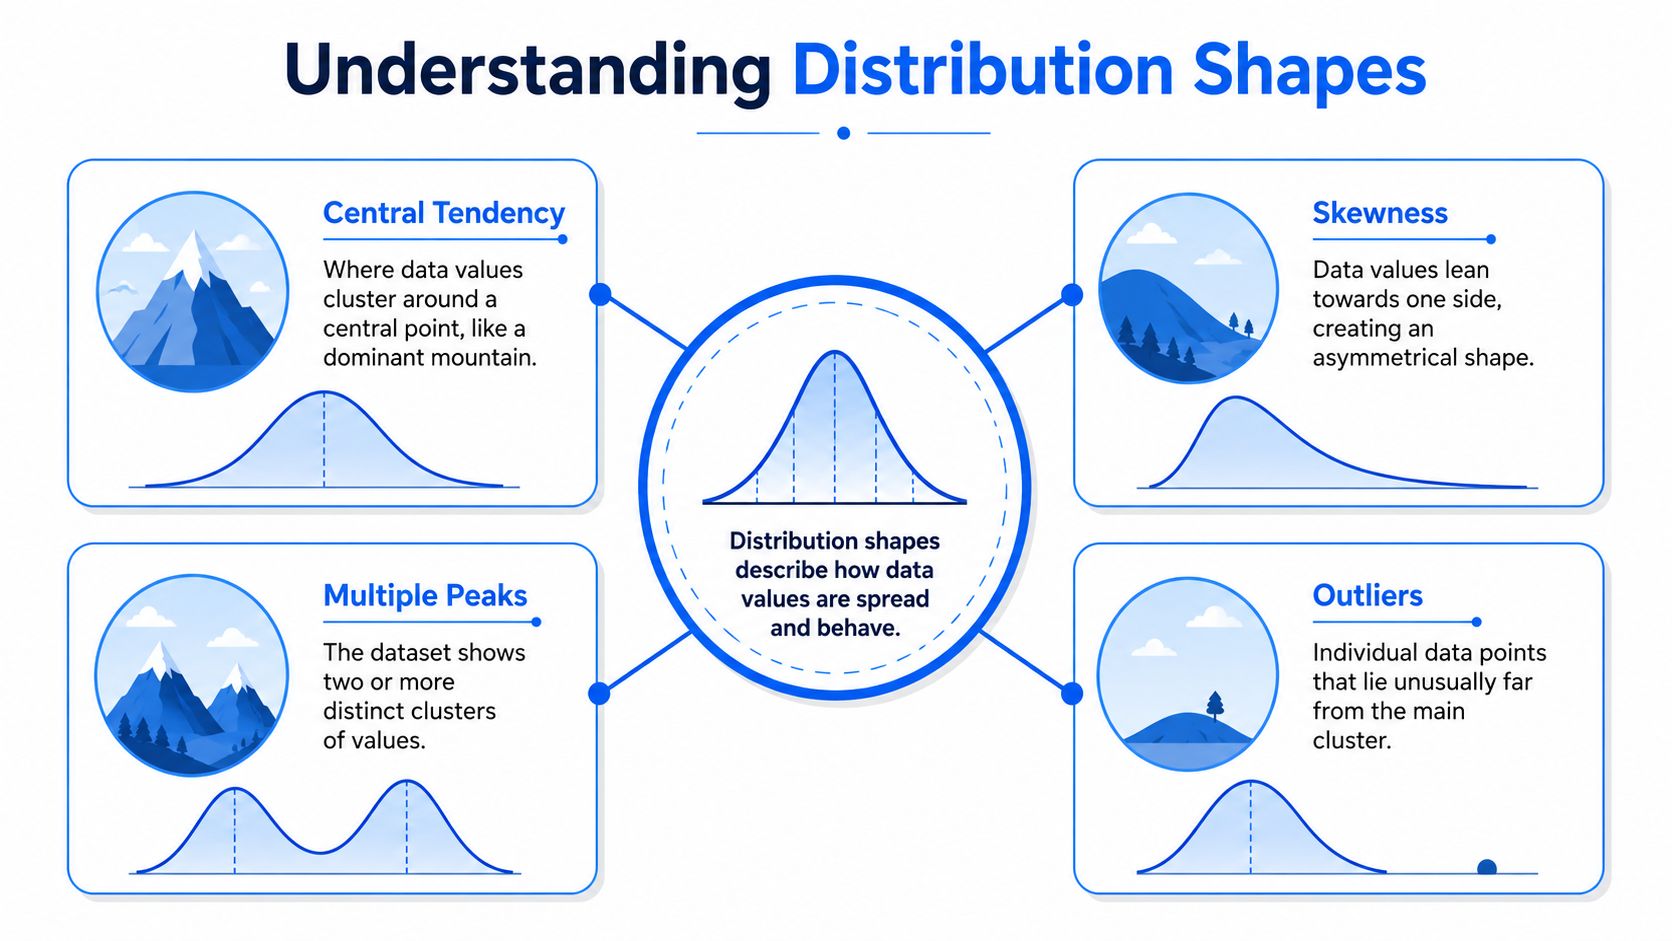
La forma di una distribuzione mostra come sono disposti i valori, non solo dove cadono. Immaginate il dataset come una mappa del terreno. Uno schema unimodale si innalza in una collina principale, i dati bimodali si dividono in due picchi, i dati uniformi restano relativamente piatti e i dati asimmetrici pendono da un lato con una coda allungata. L'infografica sulle forme delle distribuzioni è un utile promemoria visivo del fatto che tendenza centrale, asimmetria, picchi multipli e outlier cambiano tutti il modo in cui la stessa metrica va letta.
Un singolo grafico può rivelare molto su una pipeline. Una metrica di latenza che appare centrata attorno a un unico cluster si comporta in modo molto diverso da una che si divide in due gruppi dopo un deployment, anche se le medie sembrano simili. Questa differenza indica spesso traffico misto, un nuovo percorso di codice o una join a monte che ha cambiato la popolazione misurata.
Le forme principali che incontrerete
Unimodale significa un unico cluster principale. La latenza delle richieste appare spesso così quando la maggior parte del traffico segue un unico schema operativo, anche se alcune richieste più lente allungano la coda. Bimodale significa due cluster distinti, cosa che spesso si verifica quando due gruppi sono mescolati, come il traffico mobile e desktop all'interno di un'unica metrica. Uniforme significa che i valori sono distribuiti in modo abbastanza omogeneo, quindi nessuna regione domina il grafico.
L'asimmetria cambia il modo in cui leggete il centro. In una distribuzione con asimmetria positiva, pochi valori elevati spingono la coda verso destra. In una distribuzione con asimmetria negativa, la coda si allunga verso sinistra. Una media può sembrare ancora accettabile mentre la forma si è spostata abbastanza da cambiare il modo in cui la metrica dovrebbe essere modellata o monitorata.
Perché gli outlier cambiano la storia
Gli outlier non sono solo “punti sbagliati”. Possono riflettere un processo raro ma valido, oppure mostrare che un sistema sorgente sta inviando record rumorosi. In entrambi i casi possono distorcere le soglie e nascondere ciò che sta facendo il resto della distribuzione. Se una colonna di importi di pagamento contiene improvvisamente una manciata di valori estremi, una semplice media può spostarsi abbastanza da far sembrare sospetta una tabella sana.
Quando una metrica cambia forma, non chiedetevi solo se il volume totale è cambiato. Chiedetevi se i dati ora provengono da un processo diverso.
Un esempio di produzione lo rende più evidente. Supponiamo che una tabella di eventi sia sempre apparsa unimodale e inizi a sembrare bimodale dopo un deployment. Ciò può significare che un nuovo percorso di codice sta producendo una seconda popolazione di valori, oppure che una join a monte sta duplicando un segmento del traffico. In quel caso l'istogramma diventa uno strumento di debugging, non solo un grafico, e un'analisi attenta con la guida di digna ai metodi statistici può aiutare i team a collegare il cambiamento di forma al passo successivo dell'indagine.
Cosa ricordare quando esaminate la forma
Il centro vi dice dove si trova il cluster principale.
La dispersione vi dice quanto è ampio quel cluster.
La modalità vi dice quanti cluster possono essere nascosti nei dati.
La forma vi dice se la simmetria regge.
Gli outlier vi dicono se i punti rari meritano un'indagine.
Questi cinque indizi bastano di solito a trasformare un grafico in un'ipotesi di lavoro. Leggeteli insieme e individuerete problemi che una tabella di sintesi può non cogliere.
Esplorare le rappresentazioni statistiche
Grafici diversi rispondono a domande diverse sulla distribuzione. Un istogramma mostra la frequenza per intervalli (bin). Una funzione di densità di probabilità offre una visione continua di dove è probabile che compaiano i valori. Una funzione di distribuzione cumulativa mostra quanta massa cade al di sotto di un punto. Una stima kernel della densità leviga osservazioni rumorose in una curva continua. La scelta giusta dipende dal fatto che vogliate la forma, i quantili o un confronto levigato tra gruppi.
Partite dal grafico adatto alla vostra domanda
Se dovete sapere se i tempi di risposta si raggruppano attorno a pochi valori o si distribuiscono su diversi cluster, partite da un istogramma. Se dovete confrontare due versioni di un servizio e stimare dove una supera una soglia di latenza, una CDF è spesso più chiara perché rende facile leggere i quantili. Se il campione è scarso e l'istogramma appare frastagliato, una KDE può rendere la struttura più visibile, anche se un'eccessiva levigatura può nascondere picchi significativi.
Il compromesso chiave è sempre tra interpretabilità e sensibilità al rumore. Gli istogrammi sono facili da spiegare nelle revisioni e nelle riunioni sugli incidenti, ma dipendono dall'ampiezza dei bin. Le KDE riducono il rumore visivo, ma possono cancellare casi limite importanti nei dati operativi. Le CDF sono eccellenti per ragionare in termini di percentili, soprattutto quando contano confronti di tipo SLO o la separazione tra coorti.
La panoramica tecnica sui metodi statistici per l'analisi dei dati nella guida di digna ai metodi statistici è utile se volete collegare questi grafici alle metriche che li sottendono.
Un modo rapido per scegliere tra i quattro
Istogramma: usatelo per primo quando volete uno sguardo grezzo su concentrazione, asimmetria o multimodalità.
PDF: usatela quando volete una visione concettuale della probabilità relativa tra i valori.
CDF: usatela quando contano quantili, soglie e “quale percentuale si trova sotto questo valore”.
KDE: usatela quando dati scarsi richiedono una levigatura, ma verificate di non nascondere strutture rare ma importanti.
I log dei tempi di risposta sono un buon esempio. Se la maggior parte delle richieste è veloce e alcune sono lente, l'istogramma potrebbe mostrare una coda lunga. Una CDF vi dirà con quale rapidità si accumula la regione veloce, il che aiuta quando definite un limite di latenza. Una KDE offre una lettura più levigata della stessa storia, utile nelle revisioni con gli stakeholder, dove le irregolarità distolgono l'attenzione dal trend.
Usare statistiche descrittive e stima
Una tabella dei tempi di risposta o uno snapshot di un feature store possono sembrare gestibili una volta ridotti a pochi numeri di sintesi, ma quei numeri aiutano solo se sapete cosa nascondono. La media si sposta quando compaiono valori estremi, la mediana resta più stabile, la moda può far emergere il valore più comune e la varianza o altre misure di dispersione mostrano quanto i valori si allontanano dal centro. Nei sistemi di produzione i quantili sono spesso più utili della media, perché mostrano dove le code iniziano a contare.
Usate le statistiche descrittive come insieme diagnostico, non come risposta unica
Un dataset simmetrico e a campana si comporta diversamente da uno asimmetrico, e questa differenza cambia il modo in cui leggete le statistiche descrittive. Molte procedure inferenziali presuppongono una normalità approssimativa, quindi gli analisti devono verificare che questa ipotesi sia adatta ai dati prima di considerare la media rappresentativa. Quando la forma non corrisponde a tale ipotesi, gli statistici esaminano spesso un istogramma e passano poi a metodi non parametrici, trasformazioni o modelli specifici per la distribuzione, come osservato nella rassegna di statistica clinica. Nel lavoro applicato, i grafici di probabilità e i controlli sui quartili aiutano a verificare se i dati osservati corrispondono a una distribuzione attesa prima di confrontare coorti, impostare limiti di controllo o monitorare il drift.
La stima deve adattarsi ai dati, non il contrario
L'adattamento parametrico funziona bene quando la distribuzione segue una famiglia nota in modo sufficientemente fedele da giustificare l'ipotesi. È utile nelle pipeline stabili in cui volete soglie compatte e limiti facili da spiegare nelle revisioni degli incidenti. Gli approcci non parametrici sono più sicuri quando i dati sono irregolari, quando la coda conta più del centro o quando non vi fidate abbastanza della forma per affidarvi a una formula.
Il bootstrapping aiuta quando vi serve l'incertezza attorno a una statistica di sintesi senza presupporre che il campione provenga da una curva teorica perfetta. In pratica, vi permette di stimare una mediana o una banda di quantili anche quando la distribuzione sottostante è disordinata. Se usate SQL o Python, stabilite le regole per valori mancanti e outlier prima di calcolare la sintesi, perché queste scelte influenzano ogni soglia a valle.
Regola pratica: calcolate la mediana e alcuni quantili prima di fidarvi della media. Nei dati asimmetrici, la media può far sembrare anomala una tabella sana o far sembrare innocuo un cambiamento reale.
Per il monitoraggio delle pipeline, l'insieme di statistiche di sintesi deve essere operativo, non decorativo. Un limite di controllo basato su un percentile può essere più utile di una singola media se il vostro compito è intercettare presto i valori estremi. Una mediana con i quartili può dirvi se si è spostato il centro o se si sono spostate le code. Questa differenza aiuta gli analisti a distinguere un normale cambiamento stagionale da un cambiamento di forma che indica un problema a monte, e mantiene gli alert significativi invece che rumorosi.
Confrontare le distribuzioni nella pratica
Confrontare due distribuzioni è il punto in cui la teoria diventa una decisione. Vi state chiedendo se un nuovo campione somiglia ancora alla baseline, se due coorti si comportano in modo diverso o se un mix categoriale è cambiato abbastanza da contare. Non esiste un unico test universale, perché confronti diversi si concentrano su parti diverse della distribuzione.
Scegliete la metrica adatta alla modalità di guasto
Il test di Kolmogorov–Smirnov è un modo non parametrico per verificare se due campioni continui potrebbero provenire dalla stessa distribuzione. È utile quando vi interessa la forma complessiva, non solo la media. La divergenza di Kullback–Leibler misura quanto una distribuzione di probabilità differisce da una distribuzione di riferimento, quindi è adatta ai confronti tra baseline e situazione attuale in cui conta l'asimmetria. La distanza di Wasserstein misura il costo di trasformare una distribuzione in un'altra, il che la rende intuitiva quando volete capire, in termini pratici, di quanto si sono spostati i valori.
Per i confronti categoriali, il test del chi quadrato è l'opzione familiare quando volete sapere se due variabili sono associate. Il population stability index, o PSI, viene spesso usato per valutare se la distribuzione di una popolazione è stabile tra periodi di tempo o segmenti. Questo lo rende particolarmente rilevante per i controlli sul drift, soprattutto quando volete un punteggio compatto per le dashboard di monitoraggio.
Attenzione a code, codifica e dimensione del campione
Ogni metrica ha i suoi punti ciechi. Il test KS può essere sensibile agli spostamenti nella parte centrale, ma meno interpretabile quando serve una spiegazione di business. Le misure di divergenza dipendono da come vengono stimate le probabilità, il che significa che code scarse possono renderle instabili. I test categoriali possono essere distorti dal modo in cui le etichette sono codificate o raggruppate, quindi lo schema di input conta quanto il test stesso.
Una buona regola in produzione è scegliere la metrica in base alla domanda a cui volete rispondere, non quella che sembra più complessa. Se confrontate una baseline e un flusso live per rilevare il drift, un metodo sensibile alla forma è un primo passo migliore di un semplice confronto tra medie. Se verificate la presenza di bias in un campo categoriale, un test basato sulle frequenze è più appropriato di una distanza continua.

Best practice di visualizzazione ed errori comuni
Un grafico di distribuzione è utile solo se il grafico stesso è onesto. Ampiezza dei bin, scala degli assi, contrasto dei colori e annotazioni influenzano tutti ciò che le persone credono di vedere. L'obiettivo non è far sembrare il grafico curato, ma rendere la forma leggibile senza distorcere lo schema sottostante.
Costruite il grafico in modo che la forma resti visibile
Usate ampiezze dei bin che rivelino la struttura senza levigare eccessivamente i dati. Troppi bin fanno sembrare una storia la variazione casuale. Troppo pochi appiattiscono cluster reali in qualcosa di insignificante. Se la vostra metrica ha una coda lunga, un asse che parte da zero può essere appropriato in un grafico e fuorviante in un altro, quindi la linea di base deve corrispondere alla domanda posta.
Il colore deve separare chiaramente i gruppi, non decorare il grafico. Se confrontate coorti, usate tonalità che restino leggibili in una dashboard e accessibili in una revisione di team. Gli outlier meritano un'annotazione, ma non un trattamento drammatico. Etichettateli con il contesto, così chi esegue la revisione sa se sono rari ma validi o record corrotti.
Vale la pena tenere a portata di mano la guida interna sui metodi di identificazione degli outlier quando un punto sembra strano ma non siete ancora pronti a definirlo un errore.
Attenzione alle trappole che nascondono reali problemi di copertura
Un grafico dall'aspetto uniforme può comunque essere fuorviante se la raccolta dei dati è disomogenea. L'articolo di Frontiers sulla sanità pubblica dedicato alla copertura incompleta e ai campi mancanti ricorda con forza che i gruppi meno serviti possono sparire dal quadro quando i dati sorgente sono incompleti, e che un dataset può apparire bilanciato nel complesso pur essendo distorto ai margini articolo di Frontiers sulla sanità pubblica. Questa idea conta anche al di fuori della sanità, perché i dati mancanti e gli schemi di raccolta possono plasmare ogni distribuzione che esaminate.
Un grafico piatto non è una prova di equità. Può anche essere il segnale che i margini non sono mai stati osservati abbastanza bene da comparire.
Nel lavoro pratico sulle dashboard, suddividete per sottogruppo quando potete e aggiungete indicatori di dati mancanti quando non potete. Questo vi permette di distinguere una distribuzione ampia da una distorta. Se una metrica appare stabile solo dopo l'aggregazione, probabilmente dovete esaminarne le parti prima di fidarvi del totale.
Una breve checklist per chi esegue la revisione
Controllate con attenzione i bin: la scelta dei bin deve far emergere la forma, non fabbricarla.
Esaminate gli assi: la scala deve corrispondere alla storia che volete raccontare.
Annotate le eccezioni: gli outlier richiedono una spiegazione, non il silenzio.
Suddividete per sottogruppo: l'aggregazione può nascondere differenze importanti.
Segnalate i dati mancanti: dati incompleti possono imitare una distribuzione sana.
La migliore abitudine nella visualizzazione è lo scetticismo. Se un grafico sembra troppo pulito, chiedetevi cosa è stato eliminato con la media, cosa è stato omesso e quale sottogruppo non è mai finito nel grafico.
Monitorare i cambiamenti di distribuzione in produzione con digna
La ragione pratica per studiare le distribuzioni è intercettare il drift prima che diventi un problema visibile ai clienti. Una metrica di fatturato potrebbe mantenere la stessa media mentre la forma cambia sotto la superficie, ed è esattamente il tipo di problema che sfugge quando i team guardano solo i totali. Il tutorial di Utrecht sulla distribuzione dei dati lo spiega bene: quando la distribuzione di una metrica cambia improvvisamente, ciò può segnalare un problema di qualità dei dati anche se la media sembra stabile Utrecht distribution tutorial.
Perché il monitoraggio basato sulla forma batte quello basato solo sulla media
Se una pipeline inizia a inviare più record verso la fascia alta di una metrica, la media può muoversi lentamente, o per niente, mentre la coda continua ad allargarsi. Questo crea una falsa sicurezza. Il monitoraggio basato sulla forma cerca il cambiamento nello schema completo, che è esattamente ciò di cui hanno bisogno i sistemi di produzione quando il problema potrebbe essere una modifica a una tabella sorgente, una discrepanza di schema o un bug tardivo nella trasformazione.
È qui che conta l'osservabilità in-database. digna esegue il calcolo delle metriche all'interno dell'ambiente del cliente, così i team possono monitorare il comportamento dei dati dove i dati risiedono già. Il suo modulo Data Anomalies apprende le baseline e segnala i comportamenti insoliti, mentre Schema Tracker sorveglia le modifiche strutturali e Timeliness monitora gli arrivi in ritardo, mancanti o anticipati. Poiché i controlli avvengono nel database, i team dedicano meno tempo a spostare dati e più tempo a interpretare il segnale.
Un percorso concreto di gestione di un incidente
Supponiamo che una tabella del fatturato inizi a deviare dopo un deployment. La dashboard mostra che la media sembra ancora normale, ma la distribuzione è diventata visibilmente asimmetrica e la coda si è allargata. Un alert di digna può segnalare questo cambiamento, e il team può quindi tracciarlo attraverso la tabella sorgente, il livello di trasformazione e la metrica a valle senza uscire dal workflow di osservabilità.
Questo percorso verso la causa principale è importante perché i cambiamenti di forma raramente arrivano da soli. Spesso viaggiano insieme a schema drift, duplicazione dei record o un feed a monte in ritardo. Quando lo stack di monitoraggio mantiene in un unico posto l'anomalia, la tempistica e la modifica dello schema, gli ingegneri possono triangolare il problema molto più rapidamente che partendo da un singolo grafico in uno strumento di BI.
Come mantenere utili gli alert
Gli aggiornamenti della baseline devono essere deliberati, non automatici dopo ogni minima oscillazione. Le soglie devono riflettere la volatilità naturale della metrica invece di imporre un'unica regola a ogni dataset. Gli alert devono arrivare dove il team lavora già, che si tratti di una dashboard condivisa o di un canale per gli incidenti, così il cambiamento di distribuzione diventa un'azione da svolgere invece di un segnale silenzioso.
Se state costruendo ora il monitoraggio in produzione, l'abitudine principale da adottare è semplice: osservate la forma, non solo il livello. Una volta fatto questo, strumenti come il workflow di rilevamento del drift di digna possono supportare controlli continui sulla metrica stessa, invece di aspettare che siano i reclami a valle a rivelare il problema.
Conclusione e prossimi passi
La risposta breve a che cos'è la distribuzione dei dati è che si tratta dello schema con cui i valori si distribuiscono, si raggruppano e cambiano. La risposta utile è che la forma della distribuzione guida decisioni reali. Vi dice quando trasformare, quando usare stime robuste, quando confrontare le coorti in modo diverso e quando un alert in produzione sta probabilmente segnalando un problema più profondo di un semplice spostamento della media.
L'abitudine più preziosa è trattare la forma della distribuzione come un segnale di monitoraggio. Partite dagli istogrammi, aggiungete la rappresentazione statistica adatta alla domanda, confrontate le baseline con una metrica adatta alla modalità di guasto e mantenete onesta la visualizzazione. Da lì, il monitoraggio continuo diventa molto più affidabile.
Se volete rendere tutto questo concreto, iniziate da una tabella critica della vostra pipeline. Esaminatene l'istogramma, controllate alcuni quantili, confrontate la distribuzione attuale con una baseline e configurate alert sia per i cambiamenti di forma sia per quelli di volume. Poi estendete la stessa disciplina al resto del flusso di dati.
Se siete pronti a monitorare i cambiamenti di distribuzione prima che si trasformino in report errati o errori dei modelli, visitate digna e scoprite come le sue funzionalità di osservabilità in-database possono riunire forma, drift, tempestività e modifiche di schema nello stesso workflow. È un modo pratico per passare dal debugging reattivo al controllo continuo dei dati.
Domande frequenti
Che cos'è la distribuzione dei dati?
È lo schema che sta dietro ai vostri valori, non solo il mucchio di righe in una tabella. Capire una distribuzione significa capire come i valori si distribuiscono, dove si concentrano e come quella forma cambia nel tempo.
Perché i team che gestiscono pipeline dovrebbero interessarsi alle distribuzioni?
Perché una pipeline può sembrare sana in una dashboard e intanto deviare sotto la superficie. Un istogramma è spesso il primo posto in cui un data engineer dovrebbe guardare quando una metrica cambia, dato che la forma si sposta prima del totale.
Che cosa rivela una distribuzione che una media nasconde?
Dove si trovano effettivamente i valori. Una media invariata può nascondere una popolazione che si divide in due cluster, un campo normalmente popolato che si va svuotando o una categoria legittima che diventa silenziosamente dominante.
Come si confrontano due distribuzioni?
Con un test di confronto anziché a occhio. Il confronto statistico vi dice se la forma di oggi differisce dalla baseline più della normale variazione, che è la domanda a cui un controllo visivo può solo suggerire una risposta.
Quando il monitoraggio della distribuzione batte una regola a soglia?
Quando il guasto non ha un limite fisso da superare. Una soglia intercetta un valore che esce dall'intervallo, mentre il monitoraggio della distribuzione intercetta gli stessi valori che si riorganizzano in una forma che non descrive più il business.



