Come eseguire l'audit della data quality nelle pipeline enterprise
|
8
min di lettura

La vostra dashboard del rischio sembra normale finché qualcuno non nota che gli ultimi dati non cambiano da venerdì. La pipeline è verde, le query sul warehouse funzionano ancora e non è scattato alcun alert. In un altro team, un'applicazione sorgente aggiunge una colonna, la logica a valle accetta la struttura modificata e una metrica sul volume dei pazienti diventa incompleta. L'errore non è clamoroso. Si presenta come un numero plausibile che nessuno ha messo in discussione.
È questa la realtà operativa dell'audit della data quality nelle pipeline enterprise. Le checklist statiche possono confermare che la documentazione esiste, ma spesso non colgono caricamenti in ritardo, schema drift, stati di business non validi e cambiamenti graduali dei dati che degradano analytics o modelli di AI. Un audit utile deve collegare dimensioni di qualità misurabili al modo in cui i dati si muovono, cambiano e vengono consumati.
Indice
Perché gli audit della data quality falliscono nelle pipeline moderne
Gli audit tradizionali partono spesso da uno snapshot del warehouse. Il team verifica che i campi obbligatori siano valorizzati, riconcilia alcuni totali selezionati e confronta un campione di record con un documento di policy. Questo approccio può funzionare per una tabella di reporting stabile. Non regge quando la pipeline sottostante cambia ogni ora, quando più consumatori interpretano lo stesso campo in modo diverso o quando un sistema a monte consegna i dati di ieri senza dichiarare alcun errore.
Un team finanziario può scoprire che la sua dashboard del rischio è ferma da diversi giorni perché il job di ingestion è stato completato con successo senza nuovi record. Un team di analytics sanitarie può accorgersi che una modifica nel sistema sorgente ha cambiato il tipo di un campo, lasciando le trasformazioni a valle tecnicamente eseguibili ma semanticamente errate. In entrambi i casi, i record possono sembrare validi se presi singolarmente. Il difetto risiede in tempestività, struttura, lineage o significato di business.
Le lacune lasciate dalle checklist statiche
I controlli di completezza di alto livello non vi diranno se un caricamento critico è arrivato in ritardo, se una nuova colonna ha aggirato la governance o se una transazione viola una regola pur rispettando il data type atteso. Le linee guida indipendenti in materia di audit sottolineano la necessità di verificare i dati riportati, valutare i sistemi che li producono e preservare una tracciabilità basata sulle evidenze, così che i team possano individuare caricamenti mancanti, schema drift ed errori logici prima che incidano sul reporting o sulle evidenze di compliance (linee guida indipendenti sulla verifica dei dati e sulla tracciabilità degli audit).
Questa tracciabilità conta perché la scarsa qualità dei dati ha un costo operativo concreto. Monte Carlo cita un costo medio di 12,9 milioni di dollari all'anno per la scarsa qualità dei dati, insieme a incidenti ricorrenti, un tempo medio di rilevamento riportato di 4 ore, un tempo di risoluzione di 9 ore e oltre 793 ore di data downtime al mese in media (linee guida di Monte Carlo sull'audit della data quality). Queste cifre fanno della velocità di rilevamento e delle prestazioni di ripristino una questione di audit, non una semplice preferenza ingegneristica.
Regola pratica: se il vostro audit non è in grado di mostrare quando un dataset è cambiato, quando era atteso, chi lo ha consumato e che cosa è successo dopo un'eccezione, state documentando uno snapshot, non sottoponendo a audit una pipeline.
Un workflow ripetibile colma questa lacuna. IBM descrive una sequenza che parte da perimetro e obiettivi, profila i dati, definisce regole esplicite, testa i record, analizza i pattern dei problemi, stabilisce le priorità di correzione e prosegue con monitoraggio e reporting (workflow di valutazione della data quality di IBM). I team devono anche capire perché le iniziative di qualità falliscono a livello strutturale, non solo registrare i singoli difetti. Le correzioni strutturali per i progetti di data quality falliti offrono un contesto utile quando un audit continua a trovare sintomi senza cambiare la pipeline che li genera.
Per le organizzazioni che devono bilanciare controlli tecnici e obblighi di governance più ampi, una risorsa su audit e compliance in Australia 2026 può aiutare a inquadrare il contesto normativo. Il test ingegneristico resta lo stesso: l'organizzazione è in grado di dimostrare che i dati importanti sono stati consegnati, trasformati, validati e utilizzati come previsto?
Definire perimetro e obiettivi dell'audit
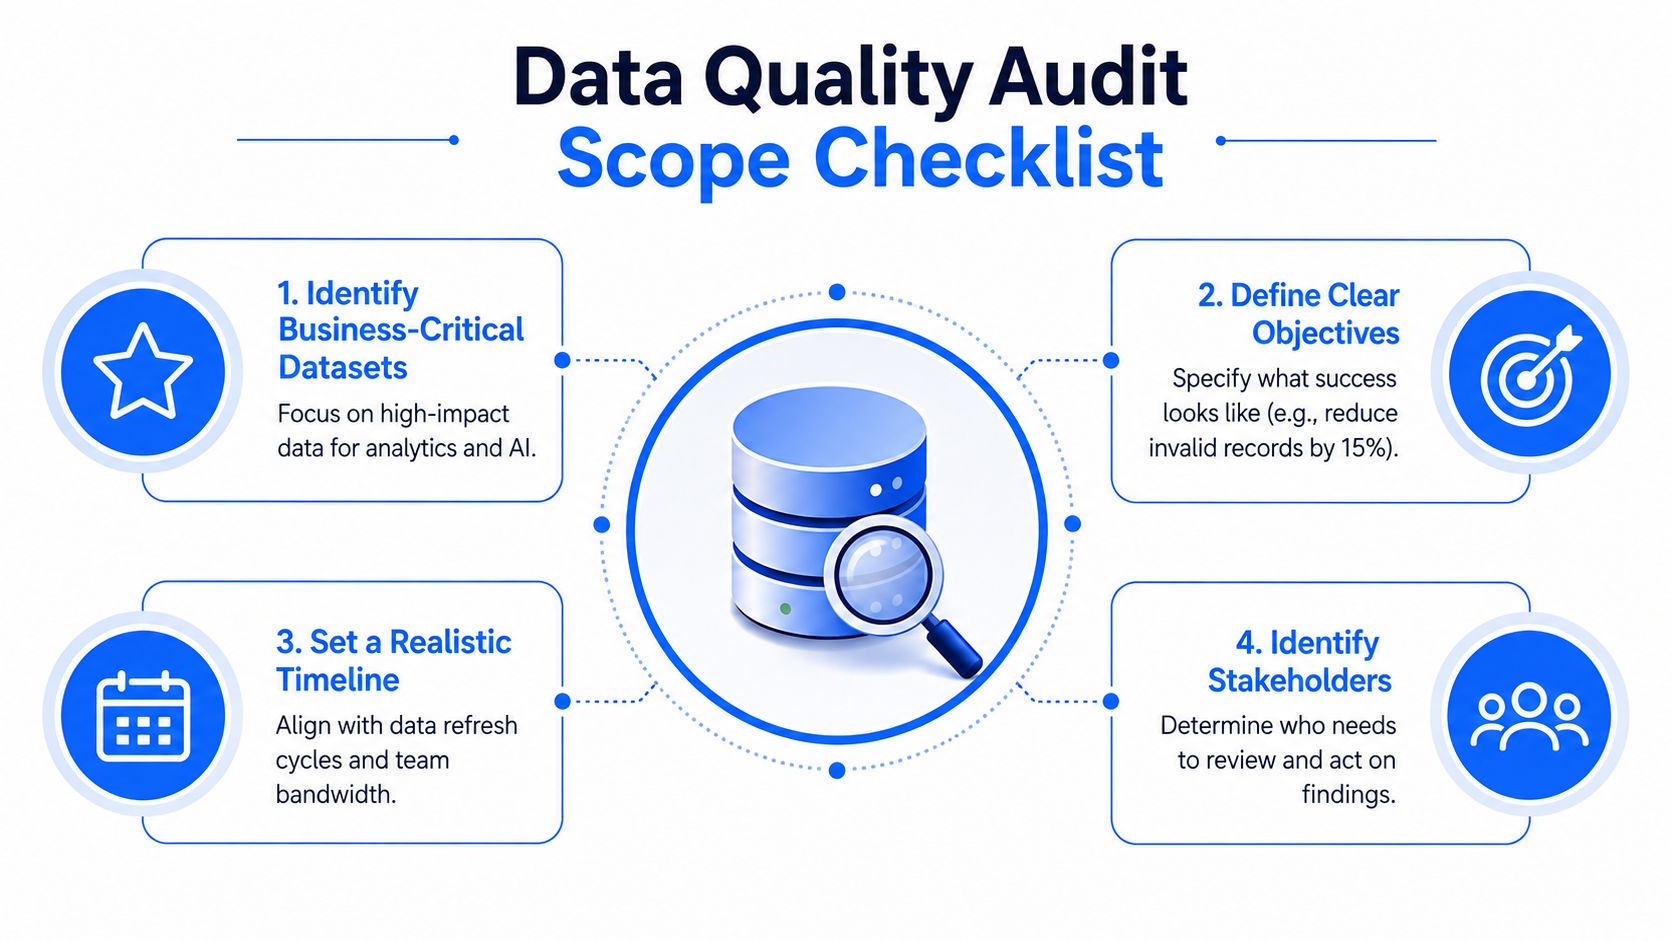
Un audit della data quality che include ogni tabella produce di solito un lungo elenco di problemi e poca responsabilizzazione. Partite dall'impatto sul business, poi risalite lungo la supply chain dei dati.
Selezionate i dati che possono causare danni reali
Elencate i report, le segnalazioni regolamentari, le decisioni operative e i workflow di AI che dipendono dai dati aziendali. Per ciascun output, individuate tabelle, pipeline, trasformazioni e sistemi sorgente coinvolti. Una tabella clienti che supporta i controlli di identità merita un livello di attenzione diverso da un dataset esplorativo usato da un solo analista.
Usate un semplice punteggio di priorità basato su categorie qualitative:
Criticità per il business: un errore inciderebbe su ricavi, decisioni di rischio, operazioni sui pazienti, erogazione dei servizi o reporting direzionale?
Dipendenza regolamentare: il dataset contribuisce a evidenze, reporting obbligatorio o processi controllati?
Numero di consumatori: molte dashboard, molti modelli e applicazioni dipendono dalla stessa tabella?
Rilevabilità dell'errore: un caricamento non riuscito sarebbe evidente, o potrebbe produrre un output plausibile ma non aggiornato?
Frequenza dei cambiamenti: lo schema della sorgente o la logica di business cambiano regolarmente?
Il vostro inventario dovrebbe identificare i critical data element, i loro responsabili, le definizioni, i valori ammessi e i consumatori a valle. Un riferimento pratico per organizzare questi elementi sono le indicazioni di digna sui critical data element.
Trasformate le preoccupazioni di business in obiettivi verificabili
“Migliorare la data quality” non è un obiettivo di audit. “Confermare che i campi del reporting regolamentare siano completi e validi al momento dell'invio” lo è. Altri obiettivi utili includono verificare l'integrità dei dati di addestramento dei modelli, prevenire interruzioni delle dashboard, confermare che i flussi di transazioni rispettino le aspettative di consegna o dimostrare che una modifica di schema non può arrivare in produzione senza revisione.
Scrivete ogni obiettivo in quattro parti:
Asset: il dataset, la pipeline, il report o l'input del modello.
Rischio: l'errore che conta.
Evidenza: i controlli e la lineage necessari per dimostrare il controllo.
Decisione: l'azione intrapresa quando il controllo fallisce.
Questa struttura evita che i team raccolgano metriche che nessuno usa. Facilita inoltre la revisione da parte degli stakeholder, perché i responsabili di business possono vedere come un'eccezione tecnica si traduce in una conseguenza operativa.
Scegliete tra copertura di base e approfondimento mirato
Un audit di base profila un dominio ampio e individua le lacune più grandi. È utile quando le responsabilità non sono chiare o l'organizzazione non dispone di un inventario condiviso. Un audit mirato approfondisce un singolo flusso ad alto rischio, come pagamenti, episodi clinici, anagrafiche di identità o feature dei modelli. Permette di agire più rapidamente, ma può non cogliere problemi sistemici altrove.
Eseguite un audit di base quando vi serve una mappa. Eseguite un approfondimento quando un errore noto minaccia una decisione o un controllo. In entrambi i casi, assegnate un data owner, un responsabile tecnico e un revisore di business prima dell'inizio dei test. Per le questioni di indipendenza, perimetro e responsabilità di revisione, una guida all'outsourcing dell'internal audit per i responsabili finanziari offre utili considerazioni di governance.
Le dimensioni fondamentali della data quality da misurare
Un audit difendibile misura la qualità attraverso dimensioni esplicite anziché con un giudizio generico secondo cui i dati “sembrano corretti”. Una revisione del 2014 dei metodi di valutazione della qualità dei dati sanitari pubblici ha rilevato che completezza, accuratezza e tempestività erano i tre attributi più utilizzati tra i 49 attributi di data quality complessivi studiati (revisione su audit di data governance e data quality). La stessa prassi usa statistiche descrittive e reporting in percentuale, il che rende i risultati confrontabili e verificabili.

Misurate il record e il suo significato
La completezza verifica se i dati richiesti sono presenti. Misurate tassi di null, chiavi mancanti, file assenti e combinazioni di campi incomplete. Un'email cliente non nulla può comunque essere incompleta se manca lo stato del consenso associato, quindi le regole di completezza dovrebbero riflettere lo scopo del record.
L'accuratezza verifica se un valore rappresenta l'entità o l'evento reale. Un indirizzo valorizzato può comunque essere inesatto, e l'importo di una transazione può essere sintatticamente valido pur non concordando con una fonte attendibile. I test di accuratezza richiedono spesso il confronto con record sorgente, dati di riferimento, totali di riconciliazione o processi di business controllati.
La coerenza verifica se la stessa entità, definizione o misura concorda tra i sistemi. Identificativi cliente in conflitto, convenzioni valutarie diverse o logiche di calcolo delle metriche non allineate generano output incoerenti anche quando ogni singola tabella supera un controllo locale sui null.
La validità verifica se i valori sono conformi ai formati e alle regole di business definiti. Ciò include valori di stato ammessi, relazioni tra date, intervalli numerici, integrità referenziale e requisiti condizionali. Un record può essere completo ma non valido se contiene un valore al di fuori del dominio consentito.
Trattate tempestività e struttura come controlli operativi
La tempestività non è solo una preferenza per dati freschi. Le linee guida consolidate la definiscono come disponibilità entro un intervallo di tempo specificato o un livello di servizio atteso, inclusi latenza di consegna, arrivi in ritardo, caricamenti mancanti e rispetto della finestra SLA concordata (linee guida su data governance e gestione della data quality). Registrate separatamente il pattern di arrivo atteso, l'orario di arrivo effettivo, la completezza del caricamento e la disponibilità a valle. Un dataset può essere accurato e completo ma inutilizzabile perché è arrivato dopo la finestra decisionale.
La validazione dello schema costituisce il livello strutturale sotto queste dimensioni. Validate in fase di ingestion colonne obbligatorie, data type, nullability, convenzioni di denominazione e modifiche strutturali consentite. Le linee guida sui controlli di data quality indicano l'applicazione di schema e data type come controlli che intercettano aggiunte, eliminazioni e modifiche di tipo non autorizzate prima che i sistemi a valle vadano in errore (linee guida sulla validazione di schema e data type).
Nei workflow ricchi di documenti, la qualità delle immagini a monte può incidere sull'accuratezza dell'estrazione prima ancora che inizino i controlli sul warehouse. I team che lavorano con documenti finanziari scansionati possono consultare le indicazioni sulla qualità delle immagini per l'estrazione dei dati. Per un framework più ampio sulle dimensioni, il riferimento di digna sulle dimensioni della data quality collega queste misure al monitoraggio operativo.
Strategie di campionamento e metodi di test
Le scansioni complete delle tabelle sono appropriate quando il dataset è abbastanza piccolo, il controllo è critico per la sicurezza o la regola è poco costosa da valutare. Sono spesso la scelta giusta per i controlli su schema, unicità della chiave primaria, presenza delle colonne obbligatorie e consegna, perché questi controlli esaminano la struttura o i metadati anziché ogni valore di business.
Le grandi tabelle dei fatti richiedono più discernimento. Campionate per periodi di tempo, sistemi sorgente, segmenti geografici o di prodotto, pattern di null e finestre di cambiamento note. Un campione casuale può stimare il comportamento generale, ma può non cogliere errori concentrati. Il campionamento stratificato garantisce una rappresentanza a ogni segmento importante, mentre il campionamento mirato si concentra sui record creati durante deployment, migrazioni, caricamenti in ritardo o modifiche ai sistemi sorgente.
Adattate il test al tipo di errore
Usate la validazione a livello di record per la logica di business. Verificate che le date rispettino le relazioni consentite, che gli stati corrispondano alle transizioni ammesse, che gli importi rientrino in intervalli sensati e che i valori di riferimento esistano. Gli aggregati di alto livello possono confermare che un totale si è spostato in modo inatteso, ma solo le evidenze a livello di record possono mostrare quali righe hanno violato la regola e perché.
Usate il rilevamento delle anomalie quando il pattern atteso è complesso o cambia nel tempo. Una soglia fissa può intercettare un conteggio impossibile, ma può non cogliere un drift graduale nelle distribuzioni, combinazioni insolite di categorie o un cambiamento improvviso in una feature di un modello. Combinate segnali statistici e regole deterministiche invece di considerare gli uni sostitutivi delle altre.
Le tecniche di data profiling di digna offrono un utile punto di partenza per comprendere distribuzioni, dati mancanti, unicità e pattern strutturali prima di fissare le soglie.
Metodi di test dell'audit per dimensione di qualità
Dimensione | Metodo di test | Scansione completa o campione |
|---|---|---|
Completezza | Controlli su null, chiavi mancanti, arrivo dei file e combinazioni obbligatorie | Scansione completa per i campi critici, campione stratificato per l'esplorazione ampia |
Accuratezza | Riconciliazione con fonti attendibili, controlli sui dati di riferimento e revisione di dominio | Campione mirato, con riconciliazione completa dove il rischio di controllo è elevato |
Coerenza | Confronti tra sistemi, rilevamento dei duplicati e controlli sulle definizioni | Scansione completa per chiavi e aggregati, campione per la revisione semantica |
Validità | Validazione di formato, intervalli, liste di riferimento e regole di business condizionali | Scansione completa per le regole poco costose, campione per la logica complessa |
Tempestività | Controlli su timestamp di arrivo, latenza, caricamenti mancanti e SLA | Monitoraggio completo degli eventi di consegna |
Schema | Validazione di colonne, data type, nullability e modifiche strutturali | Scansione completa dei metadati in fase di ingestion |
Per il punteggio, calcolate il tasso di problemi come (numero di problemi sui dati individuati ÷ totale dei dati esaminati) × 100, una formula descritta dal framework di audit della data quality di KPI Depot (formula del tasso di problemi nell'audit della data quality). Questa fonte classifica 90%+ come eccellente, 80%–89% come buono, 70%–79% come discreto e sotto il 70% come scarso. Trattate queste fasce come un modello di benchmarking, non come un limite di controllo universale. Un basso tasso di problemi in una tabella a basso impatto può contare meno di un singolo record non valido in un campo regolamentare critico.
Documentare i rilievi e stabilire le priorità di correzione
Un report di audit dovrebbe consentire a un ingegnere di riprodurre il rilievo e a un responsabile di business di comprenderne la conseguenza senza leggere SQL. Ogni problema ha bisogno di evidenze, di un responsabile, di una gravità e di una decisione.
Registrate i rilievi in modo che un altro team possa verificarli
Registrate dataset e colonna, regola testata, orario di esecuzione, versione della sorgente, record interessati o definizione del campione, risultato osservato, risultato atteso, lineage e query o artefatto di supporto. Indicate se il problema è nuovo, ricorrente o collegato a un deployment noto. In questo modo si crea una traccia di evidenze invece di uno screenshot che perde il contesto non appena la pipeline viene rieseguita.
Un formato utile per i rilievi è:
Rilievo: descrivete il difetto in una frase.
Evidenza: indicate la regola, la popolazione, il contesto di esecuzione e i record rappresentativi.
Impatto: spiegate quale report, controllo, modello o processo potrebbe essere interessato.
Responsabile: nominate la persona o il team responsabile della correzione.
Esito: registrate la correzione, il rischio accettato, la scadenza dell'eccezione o il percorso di escalation.
Classificate il rischio prima dell'impegno ingegneristico
La gravità dovrebbe riflettere l'impatto sul business, non quanto il difetto sia tecnicamente interessante. Un caricamento mancante che alimenta un report di rischio può avere la precedenza su un insieme più ampio di problemi estetici di formattazione. Una modifica di schema che interessa diversi modelli a valle merita un rapido contenimento anche se il numero iniziale di record sembra piccolo.
Usate una coda di correzione con percorsi separati:
Contenimento: bloccate la pubblicazione, mettete in quarantena i record non validi o avvisate i consumatori.
Correzione: riparate i dati interessati e rieseguite le trasformazioni dipendenti.
Correzione strutturale: modificate ingestion, contratti, responsabilità o validazione in modo che il difetto non si ripresenti.
Verifica: rieseguite il test fallito e confermate gli output a valle.

Un report pratico per gli stakeholder non tecnici può usare questo schema di frase: “Il feed del rischio clienti è arrivato fuori dalla finestra di consegna concordata, quindi la dashboard potrebbe rappresentare una situazione operativa precedente. Il team della data platform è responsabile della pianificazione della sorgente, il team rischi della decisione di utilizzo, ed entrambi i team devono confermare la successiva consegna andata a buon fine prima della pubblicazione.”
Un rilievo senza responsabile è un'osservazione. Un rilievo con responsabile, scadenza, evidenze e test di verifica diventa un controllo.
Le sintesi di alto livello hanno ancora un loro spazio, ma non dovrebbero essere l'unica evidenza. La validazione a livello di record mostra il difetto effettivo, mentre il monitoraggio strutturale spiega se la pipeline è cambiata. Conservate entrambi nel registro dell'audit, poi collegate il ticket di correzione al risultato del test che ne dimostra la chiusura.
Passare dagli audit periodici al monitoraggio continuo
Gli audit periodici sono utili per stabilire una baseline, rivedere i controlli e mettere in discussione le ipotesi. Sono poco adatti agli errori che si verificano tra una revisione e l'altra. Una pipeline può consegnare in ritardo, cambiare forma o iniziare a produrre distribuzioni insolite subito dopo la conclusione di un audit.
Il monitoraggio continuo trasforma il workflow di audit in un controllo operativo. Tracciate la latenza di consegna rispetto alle pianificazioni attese, generate alert sui caricamenti mancanti, validate i record critici al loro arrivo e registrate aggiunte, rimozioni e modifiche di data type nello schema. Sistemi di sorveglianza automatici dovrebbero avvisare il team responsabile quando le metriche escono dalle soglie accettabili, mentre i controlli in fase di ingestion dovrebbero impedire che modifiche strutturali dannose raggiungano i consumatori a valle (framework di monitoraggio continuo della data quality).
Il design del monitoraggio dovrebbe separare i tipi di segnale. I segnali di tempestività indicano se i dati sono arrivati quando previsto. I segnali di validazione individuano i record che violano regole esplicite. I segnali di anomalia fanno emergere cambiamenti inattesi nelle distribuzioni o nei comportamenti. I segnali di schema intercettano il drift strutturale. Combinarli offre agli ingegneri contesto sufficiente per distinguere una sorgente in ritardo da un difetto di trasformazione o da un evento di business legittimo.
Il monitoraggio ha bisogno anche di evidenze di livello adeguato all'audit. Conservate la regola o la baseline, l'orario di esecuzione, il dataset interessato, il valore osservato, la soglia, il destinatario dell'alert, la presa in carico e la risoluzione. Questo registro supporta la risposta agli incidenti e la successiva revisione dei controlli senza spostare i dati di produzione in un ambiente di ispezione separato.
La funzionalità di monitoraggio della data quality di digna è un'opzione per questo modello operativo. La sua piattaforma funziona all'interno dell'ambiente del cliente e supporta validazione a livello di record, tracciamento della tempestività, rilevamento delle anomalie, analisi storica della qualità e monitoraggio delle modifiche di schema, con esecuzione in-database in modo che i dati restino dove si trovano. L'approccio modulare consente ai team di partire da un'esigenza di monitoraggio specifica ed estendersi a tabelle, pipeline e processi di business critici.
Un programma maturo non elimina gli audit periodici. Li usa per verificare se i controlli continui restano appropriati, se le responsabilità corrispondono ancora al business e se il portafoglio di monitoraggio copre i nuovi consumatori e i nuovi rischi.
digna aiuta i team enterprise a monitorare il comportamento dei dati, validare i record, tracciare la tempestività delle consegne, rilevare le modifiche di schema e conservare evidenze pronte per l'audit all'interno della propria infrastruttura. Visitate digna per scoprire come la sua piattaforma modulare di Data Quality e Data Observability può supportare analytics e AI affidabili lungo le vostre pipeline critiche.
Domande frequenti
Perché gli audit tradizionali della data quality falliscono?
Perché partono da uno snapshot del warehouse. I controlli di completezza di alto livello non vi diranno se un caricamento critico è arrivato in ritardo, se una nuova colonna ha aggirato la governance o se una transazione viola una regola pur rispettando il data type atteso.
Che cosa distingue un audit da uno snapshot?
La tracciabilità nel tempo. Se il vostro audit non è in grado di mostrare quando un dataset è cambiato, quando era atteso, chi lo ha consumato e che cosa è successo dopo un'eccezione, state documentando uno snapshot, non sottoponendo a audit una pipeline.
Come si definisce il perimetro di un audit della data quality?
Escludendo la maggior parte delle tabelle. Un audit che copre tutto produce un lungo elenco di problemi e poca responsabilizzazione. Assegnate un punteggio ai candidati in base a criticità per il business, dipendenza regolamentare, numero di consumatori, rilevabilità dell'errore e frequenza dei cambiamenti, poi inventariate i critical data element con responsabili, definizioni, valori ammessi e consumatori a valle.
Come dovrebbero essere scritti gli obiettivi dell'audit?
In quattro parti, perché “migliorare la data quality” non è un obiettivo. Indicate l'asset, il rischio che conta, le evidenze necessarie per dimostrare il controllo, inclusi controlli e lineage, e la decisione da prendere quando il controllo fallisce.
Quanto costa la scarsa qualità dei dati a livello operativo?
Monte Carlo cita una media di 12,9 milioni di dollari all'anno, insieme a un tempo medio di rilevamento di 4 ore, un tempo di risoluzione di 9 ore e oltre 793 ore di data downtime al mese in media. Il tempo di rilevamento è la parte che un audit può davvero cambiare.


