Architettura delle pipeline di dati: guida completa per il 2026
|
12
min di lettura

Alle 8:00 il report sembrava a posto. Alle 9:15 il reparto finance lo aveva già usato in una riunione. All'ora di pranzo qualcuno si è accorto che i totali non tornavano, non perché l'SQL fosse sbagliato, ma perché una tabella a monte aveva smesso di ricevere una parte dei record durante la notte. Nessun alert è scattato. La pipeline tecnicamente “era stata eseguita”. La dashboard offriva una fiducia ormai scaduta.
È questa la modalità di guasto con cui molte organizzazioni fanno i conti oggi. Non interruzioni clamorose, ma una corruzione silenziosa. Un file mancante, una modifica dello schema, una trasformazione che continua a girare ma ora mappa il campo sbagliato, un feed in ritardo che trasforma un KPI aggiornato nella risposta di ieri. Quando succede, la fiducia crolla più in fretta di quanto qualsiasi metrica di sistema possa segnalare.
Una solida architettura delle pipeline di dati non si limita a spostare i dati dalla sorgente alla destinazione. Determina se la vostra piattaforma dati è qualcosa di cui gli operatori si fidano sotto pressione, se gli analisti possono spiegare i numeri senza tirare a indovinare e se gli input dei modelli restano stabili mentre i sistemi sorgente evolvono. La parte più difficile non è disegnare dei riquadri. È progettare la pipeline in modo che qualità, tempestività e visibilità esistano fin dal primo diagramma, non dopo la prima escalation al management.
I team che lavorano con input eterogenei affrontano il problema in modo ancora più acuto quando nel flusso entrano documenti semi-strutturati. Se la vostra pipeline include l'estrazione di documenti per casi d'uso di AI, vale la pena consultare questa guida pratica alla conversione dei PDF per gli LLM, perché gli errori nella struttura dei documenti spesso nascono molto prima della modellazione. Come riferimento visivo su come questi sistemi si integrano, un semplice diagramma dell'architettura dei dati aiuta ad allineare la discussione prima di toccare gli strumenti.
Indice
Guida all'architettura moderna delle pipeline di dati
Una definizione utile di architettura delle pipeline di dati è semplice: è il progetto operativo che stabilisce come i dati vengono raccolti, modificati, archiviati e consegnati senza perdere significato lungo il percorso. Sembra banale finché non si eredita un sistema in cui ingestion, trasformazioni, schedulazioni, storage e dashboard sono stati costruiti in momenti diversi da team diversi.
In pratica, l'architettura si manifesta nei pattern di guasto. Un design fragile fa sì che i team abbiano paura di cambiare qualsiasi cosa. Un passaggio debole tra ingestion e trasformazione lascia scorrere a valle record malformati. Un livello di reporting senza aspettative di freschezza abitua il business a scoprire i problemi manualmente. Niente di tutto questo si risolve aggiungendo un altro orchestratore o un'altra dashboard.
L'architettura deve anche riflettere il modo in cui le persone lavorano davvero. Gli analisti vogliono tabelle stabili. I team di piattaforma vogliono deployment ripetibili. Gli ML engineer vogliono input che non subiscano drift senza che nessuno se ne accorga. I team di sicurezza vogliono che i dati restino all'interno di ambienti controllati. Un progetto moderno deve soddisfare tutti senza trasformarsi in un labirinto.
Le pipeline affidabili non sono quelle che non falliscono mai. Sono quelle che falliscono in modi che gli operatori possono vedere, isolare e correggere rapidamente.
Ecco perché i design migliori trattano la pipeline meno come un impianto idraulico e più come un sistema di produzione. Ogni fase ha un responsabile. Ogni dipendenza è visibile. Ogni percorso di consegna ha un'aspettativa di tempestività e correttezza. Se costruite partendo da questi presupposti, tutte le altre decisioni diventano molto più chiare.
I quattro pilastri di una pipeline di dati
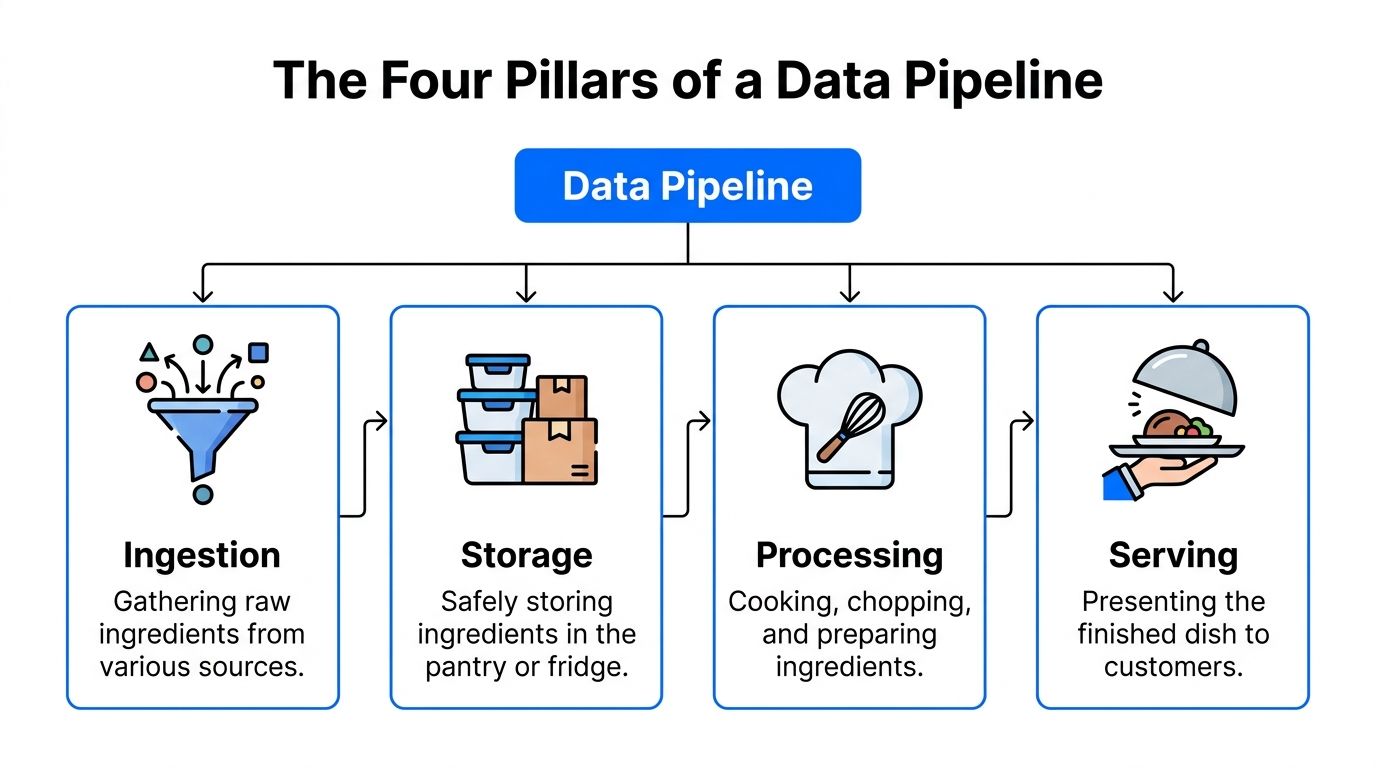
Il modo più semplice per spiegare la progettazione di una pipeline è prendere in prestito un'analogia dalla cucina. Gli ingredienti arrivano dai fornitori, vengono conservati in modo sicuro, preparati dai cuochi e infine serviti ai clienti. Se un passaggio va storto, al cliente non interessa quale postazione abbia sbagliato. Sa solo che il piatto è in ritardo o non è quello giusto.
Ragionare come una linea operativa
La versione tecnica ha quattro pilastri pratici:
L'ingestion preleva i dati dai sistemi sorgente. Può trattarsi di API, database transazionali, strumenti SaaS, flussi di eventi o depositi di file.
Lo storage conserva i dati grezzi o di staging in un luogo durevole, spesso su piattaforme come Amazon S3, Snowflake o Databricks.
L'elaborazione trasforma i dati in qualcosa di utilizzabile. Comprende pulizia, deduplicazione, filtraggio, formattazione e join.
Il serving espone il risultato a dashboard, strumenti di reverse ETL, modelli, applicazioni o consumatori a valle.
Una delle sintesi moderne più chiare è la spiegazione di Striim sui componenti delle pipeline di dati moderne, che individua il nucleo in ingestion, trasformazione e storage e osserva che i guasti nella trasformazione portano direttamente a report obsoleti e dashboard non funzionanti quando dati malformati raggiungono il livello di consumo. Io continuo a considerare il serving un tema architetturale a sé, perché molti team costruiscono la pipeline ma progettano in modo insufficiente il passaggio verso le persone e i sistemi che la utilizzano.
Dove i team di solito sbagliano
Gli errori raramente si trovano agli estremi. Avvengono nelle transizioni.
Alcuni esempi si presentano di continuo:
I dati grezzi arrivano senza controlli contrattuali. La pipeline accetta i record, ma nessuno verifica se mancano campi chiave o se hanno il tipo sbagliato.
Lo storage diventa una discarica. I team conservano ogni versione di tutto, ma non distinguono tra zone di atterraggio, curate e pronte per i consumatori.
Le trasformazioni diventano un monolite. Un unico job enorme gestisce tutta la logica, quindi fare il debug di una sola metrica significa leggere l'intero patrimonio.
Il serving viene trattato come “semplice BI”. In realtà, coerenza semantica, aspettative di freschezza e modalità di accesso appartengono proprio a questo livello.
Regola pratica: se un consumatore non sa dire da dove viene un numero, il vostro livello di serving non è finito.
Una buona architettura mantiene ogni pilastro abbastanza distinto da operare in modo indipendente, ma abbastanza collegato da impedire che i guasti si nascondano tra l'uno e l'altro. È questa separazione a rendere gestibili, anziché caotiche, le decisioni successive su pattern, resilienza e observability.
I principali pattern architetturali delle pipeline di dati
I pattern architetturali sono il punto in cui i team commettono errori costosi, perché ogni opzione funziona bene per qualcosa. La scelta sbagliata di solito non è una “cattiva tecnologia”. È un disallineamento tra esigenze di latenza, complessità operativa e tipo di analisi di cui il business ha bisogno.
ETL ed ELT risolvono problemi diversi
L'ETL è adatto agli ambienti in cui la trasformazione deve avvenire prima che i dati arrivino a destinazione. È frequente quando la pulizia alla sorgente è rigorosa, la capacità di calcolo della destinazione è limitata o i requisiti normativi impongono controlli prima del caricamento.
L'ELT funziona meglio quando la piattaforma di destinazione è pensata per elaborazioni pesanti e i team vogliono flessibilità dopo il caricamento. Warehouse e lakehouse hanno reso questo pattern molto più praticabile, perché si possono caricare rapidamente i dati e dar loro forma in un secondo momento con trasformazioni basate su SQL.
Nessuno dei due pattern è superiore in assoluto. L'ETL offre un controllo più stretto prima dell'ingestion. L'ELT offre maggiore agilità ai team di analytics. Se state valutando gli strumenti per la parte iniziale della pipeline, questa panoramica sui software di data ingestion è un buon punto di partenza per confrontare come le decisioni sull'acquisizione dalle sorgenti influenzano il resto dello stack.
Batch, streaming, Lambda e Kappa
Batch e streaming rappresentano un bivio con conseguenze ancora maggiori.
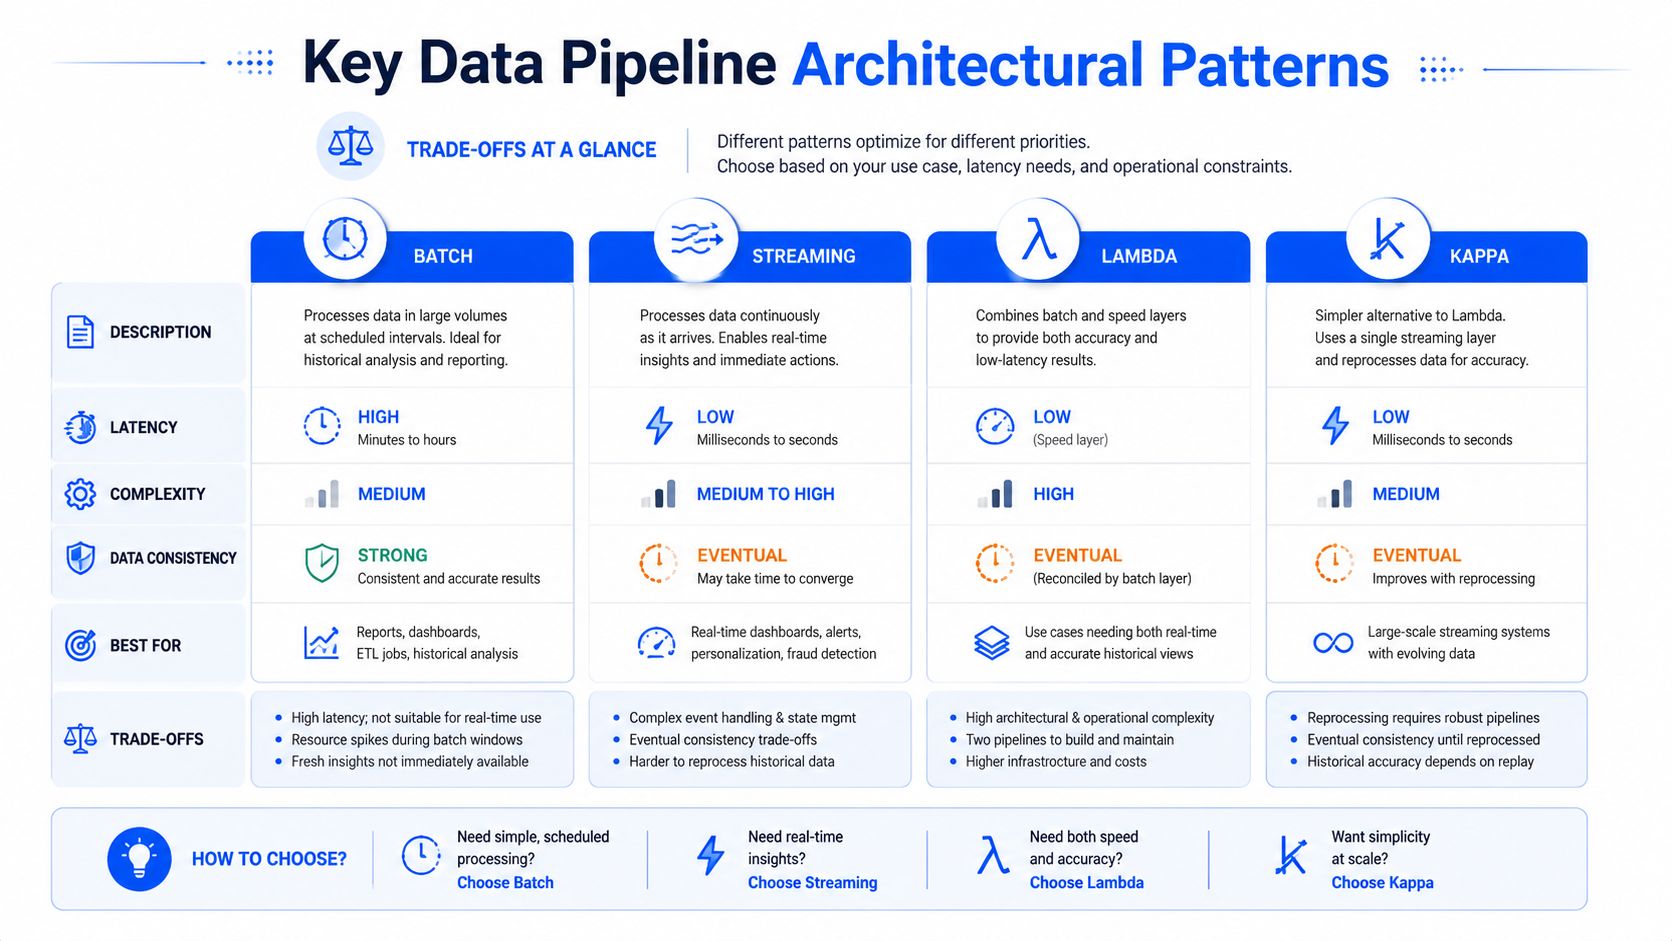
Il batch è la scelta migliore quando il business può tollerare consegne programmate e la pipeline deve elaborare in modo coerente grandi insiemi storici. Il reporting finanziario di fine giornata è un caso classico. Lo streaming è pensato per le situazioni in cui il ritardo indebolisce il caso d'uso stesso, come il monitoraggio operativo, gli alert o i workflow guidati dagli eventi.
Le forme ibride contano quando servono entrambi. L'articolo di Striim sui pattern architetturali Lambda e Kappa coglie bene la distinzione. L'architettura Lambda bilancia la velocità del tempo reale con l'affidabilità del batch eseguendo flussi di dati paralleli. Un hot path gestisce lo streaming in tempo reale, un cold path gestisce l'elaborazione storica e un livello di serving unisce i risultati. L'architettura Kappa elimina il livello batch separato e gestisce sia l'elaborazione in tempo reale sia quella storica attraverso un'unica pipeline di streaming, semplificando le operazioni grazie all'eliminazione dei sistemi doppi.
Questa semplificazione è allettante, ma Kappa comporta un compromesso reale. Rielaborare la storia dello stream attraverso un'unica pipeline è elegante solo se strumenti, strategia di retention e disciplina operativa sono abbastanza solidi da supportare il replay in sicurezza.
Pattern delle pipeline di dati a confronto
Pattern | Caso d'uso principale | Vantaggi | Svantaggi |
|---|---|---|---|
Batch | Analytics programmate e report ricorrenti | Prevedibile, adatto a grandi job storici, più facile da comprendere | Latenza più alta, meno adatto alla risposta operativa |
Streaming | Casi d'uso guidati dagli eventi e visibilità quasi in tempo reale | Bassa latenza, ottimo per alert e operazioni live | Gestione degli errori, replay e gestione dello stato più complessi |
Lambda | Team che hanno bisogno sia di profondità storica sia di insight immediati | Copre insieme l'affidabilità del batch e la velocità del tempo reale | Due percorsi da costruire, testare e mantenere |
Kappa | Ambienti streaming-first che vogliono un unico modello di elaborazione | Modello operativo più semplice rispetto ai sistemi a doppio percorso | Strategia di replay e disciplina dello stream diventano critiche |
Una banca potrebbe usare il batch per il reporting regolamentare, lo streaming per i segnali di frode e un pattern ibrido quando l'attività dei clienti richiede una reazione immediata ma anche una riconciliazione storica. È proprio questo il punto. Scegliete il pattern che corrisponde alla finestra decisionale, non quello che sembra più moderno su una slide.
Costruire pipeline che non si rompono
Le pipeline che causano più problemi sono di solito quelle che “funzionavano benissimo” finché il business non è cambiato. Arriva una nuova sorgente. Un campo viene rinominato. Un team aggiunge logica per una dashboard, un altro aggiunge feature di ML e all'improvviso un singolo guasto manda in tilt tre output non correlati, perché tutto vive all'interno della stessa catena fragile.
La modularità è una questione di sopravvivenza
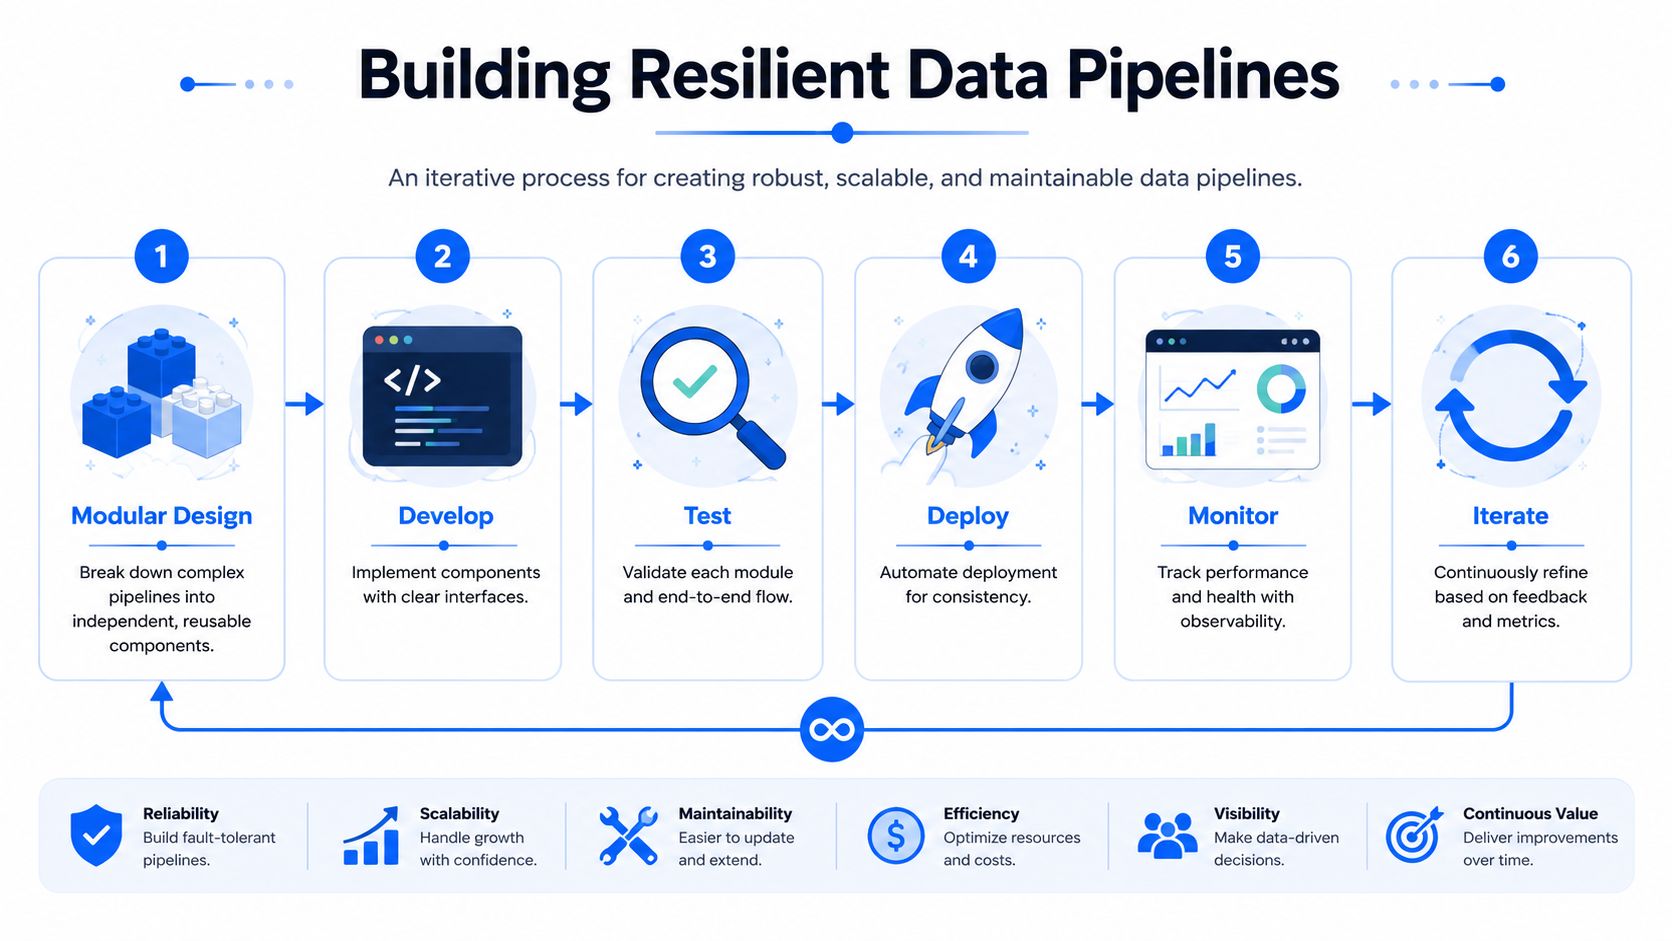
Il design modulare non è una questione di stile. È ciò che impedisce a un cambiamento di trasformarsi in un'interruzione.
L'analisi di Monte Carlo sull'architettura delle pipeline modulare e automatizzata centra il punto in modo diretto: le pipeline affidabili devono essere modulari e automatizzate, e i design non modulari generano breaking change che paralizzano i team al punto da non volerle più modificare. Una descrizione dolorosamente accurata. Quando le persone hanno paura di modificare una pipeline, la qualità comincia a degradarsi, perché i problemi noti restano lì più a lungo del dovuto.
Una struttura modulare pratica di solito comprende:
Unità di ingestion allineate alle sorgenti, che possono fallire o essere rieseguite in modo indipendente.
Livelli di trasformazione con contratti chiari, così che logica di staging, logica di conformità e logica di business non collassino in un unico passaggio.
Controlli di qualità riutilizzabili, che si spostano insieme al modulo invece di vivere in un foglio di calcolo separato.
Automazione del deployment, così che i rilasci siano ripetibili e il rollback non richieda atti di eroismo.
Lineage, test ed esecuzione parallela
Il punto di guasto successivo è la cecità sulle dipendenze. I team pensano di sapere chi utilizza una tabella finché non deprecano una colonna e rompono una metrica di cui nessuno ricordava l'esistenza.
La lineage automatizzata risolve questo problema. Il tracciamento manuale non sopravvive alla complessità, soprattutto quando entrano in gioco più strumenti di orchestrazione, warehouse e livelli di serving. Quando una pipeline va in ritardo o uno schema cambia, la lineage trasforma l'analisi della causa radice da un tentativo alla cieca in una ricerca circoscritta.
Ecco la sequenza operativa che consiglio prima di dichiarare una pipeline pronta per la produzione:
Isolare i componenti, in modo che una singola modifica non richieda un refactoring completo.
Scrivere le aspettative di interfaccia per ogni passaggio, inclusi schema e tempestività.
Testare sia i moduli sia i percorsi completi, perché un unit test pulito non coglie i presupposti errati tra una fase e l'altra.
Qui sotto trovate un utile approfondimento sulle pratiche per pipeline resilienti.
E c'è un altro punto che viene spesso trascurato: l'esecuzione parallela non è un'ottimizzazione da aggiungere in seguito. Per i carichi di lavoro moderni fa parte del design. Quando task indipendenti possono essere eseguiti in parallelo, si riducono i colli di bottiglia e si preservano le finestre di consegna man mano che il volume dei dati cresce. Se non lo pianificate fin dall'inizio, ogni aumento dell'attività delle sorgenti diventa un problema di schedulazione.
Costruite la pipeline in modo che un team possa modificare un componente senza chiedere il permesso ad altri cinque team.
Proteggere le pipeline di dati nel vostro ambiente
L'architettura di sicurezza parte da una domanda diretta: dove risiedono i dati mentre la pipeline è in esecuzione? Molti team si concentrano su crittografia e controllo degli accessi, ma ignorano lo spostamento dei dati. È un errore, soprattutto nei settori finanziario, sanitario, delle telecomunicazioni e della pubblica amministrazione, dove la residenza e i percorsi di esposizione contano quanto la logica di trasformazione.
La residenza dei dati cambia la progettazione
I deployment on-premises e in private cloud impongono una disciplina architetturale migliore, perché non permettono di restare vaghi su dove finiscono i dati sensibili. Se una pipeline copia dati di produzione in zone di staging non gestite, amplia gli accessi durante la trasformazione o invia payload a servizi esterni per i controlli di qualità, avete ampliato la superficie di attacco ancora prima che i dati raggiungano le analytics.
Mantenere l'esecuzione all'interno dell'ambiente controllato dal cliente cambia questa situazione. Riduce gli spostamenti non necessari, restringe la cerchia di chi può accedere ai dati di produzione e rende molto più semplici le discussioni con gli auditor. Questo conta soprattutto quando i dati regolamentati devono restare in un ambiente specifico o quando le policy interne vietano ai fornitori l'accesso ai dataset in produzione.
I controlli di sicurezza che devono far parte del progetto
Un'architettura sicura delle pipeline di dati presenta di solito alcune caratteristiche comuni:
Crittografia in transito e a riposo, affinché estrazione, trasferimento e archiviazione non creino punti di esposizione in chiaro.
Accesso basato sui ruoli, che separa operatori della pipeline, sviluppatori, analisti e utenti business.
Segmentazione degli ambienti, affinché sviluppo, test e produzione non si confondano.
Percorsi di validazione verificabili per le regole di business con implicazioni di compliance.
Design a copie minime, affinché l'architettura eviti di creare dataset sensibili duplicati solo per monitorarli.
La sicurezza si interseca anche con le aspettative di consegna. Se la vostra architettura include SLA per la tempestività e il rilevamento dei ritardi, gli operatori possono analizzare i ritardi anomali sia come un problema di affidabilità sia come un potenziale segnale di sicurezza. Un feed che si interrompe all'improvviso può essere un problema della sorgente. Ma può anche essere un problema di credenziali, di policy o di connettività che merita attenzione immediata.
I design più solidi trattano la compliance come una proprietà architetturale, non come un esercizio di documentazione. Se avete bisogno di data quality, rilevamento delle anomalie e tracciamento degli schemi, progettate questi controlli in modo che vengano eseguiti dove i dati risiedono già. Di solito è più sicuro, più facile da governare e più facile da difendere durante una revisione.
Integrare data quality e observability fin dalla progettazione
Molte organizzazioni credono di avere observability quando in realtà hanno solo un monitoraggio della destinazione. Sanno se la tabella del warehouse esiste. Sanno se il job di BI è terminato. Non sanno se i dati sono entrati nella pipeline in buono stato, se hanno cambiato forma in modo pericoloso o se sono arrivati con un ritardo tale da rendere il report fuorviante.

L'observability inizia dall'ingestion
Questo divario è esattamente il motivo per cui l'observability deve far parte dell'architettura stessa. L'analisi di Alation sui pattern architetturali delle pipeline di dati e l'observability introduce una distinzione importante: la validazione della qualità va collocata nel punto di ingresso, non solo dopo l'elaborazione. Se si aspetta fino ai controlli sulla destinazione, drift silenzioso, modifiche dello schema e valori mancanti si sono già propagati lungo il flusso.
Qui la pressione del mercato e la realtà operativa si incontrano. Il mercato degli strumenti per pipeline di dati è valutato 14,76 miliardi di dollari con un CAGR del 26,8%, e la stessa fonte osserva che le pipeline moderne possono elaborare oltre 800 milioni di record al giorno. A questa scala, un livello di observability con metriche come i record elaborati al secondo e i tassi di errore per fase non è un lusso. È il controllo operativo di base.
Perché il rilevamento basato sull'apprendimento batte le regole fragili
I controlli basati su regole restano importanti, soprattutto per vincoli di business espliciti. Ma non reggono quando il problema è comportamentale anziché binario.
Il rilevamento delle anomalie è più adatto a questo compito, perché può apprendere i pattern attesi e segnalare gli outlier senza una continua manutenzione manuale delle soglie. FirstEigen descrive il rilevamento delle anomalie basato sull'AI nei flussi di dati come un processo che stabilisce baseline per dati di alta qualità e poi fa emergere le deviazioni sospette da esaminare. La panoramica di Oracle sui metodi statistici e neurali per il rilevamento delle anomalie aggiunge un'utile profondità. Clustering, metodi basati sulla densità come LOF e autoencoder aiutano a rilevare anomalie locali e sottili che i test più semplici non vedono.
Per i team che gestiscono pipeline ricche di documenti, lo stesso principio vale a livello di campo. Questa guida alla validazione dei dati per fatture e ordini di acquisto ricorda che la validazione non riguarda solo gli schemi. Significa anche applicare regole a livello di record prima che i valori errati si diffondano nella logica a valle.
Dati errati intercettati all'ingestion sono un incidente evitato. Dati errati intercettati in una dashboard sono un problema di fiducia.
Cosa strumentare fin dal primo giorno
Un design di observability nativa dovrebbe tenere sotto controllo almeno quattro dimensioni:
La tempestività verifica quando i dati sono attesi e se i pattern di arrivo cambiano.
Il volume rileva cali improvvisi, picchi o variazioni insolite della distribuzione.
Lo schema segnala colonne aggiunte, colonne rimosse e cambi di tipo prima che le trasformazioni si rompano senza che nessuno se ne accorga.
La validazione applica regole di business a livello di record laddove la correttezza deve essere esplicita.
Se la pipeline gestisce dati sequenziali o guidati dagli eventi, i pattern temporali meritano un'attenzione particolare. La spiegazione di Nile Secure sul preprocessing dei dati e il rilevamento delle anomalie basato sul tempo evidenzia il ruolo del preprocessing, del feature engineering e dei modelli adatti ai comportamenti sequenziali, come le LSTM. È importante perché molti “guasti delle pipeline” sono in realtà problemi di tempestività: i dati arrivano, ma non quando il business ne ha bisogno.
Un modello mentale utile è questo: il monitoraggio vi dice che un job è stato eseguito. L'observability vi dice se i dati sono rimasti affidabili durante l'esecuzione. Per un confronto concreto tra queste responsabilità, vale la pena tenere a portata di mano questa analisi su data observability e data quality a confronto quando progettate il livello di controllo.
Una checklist pratica per la vostra prossima pipeline
Il modo più rapido per migliorare la revisione di una pipeline è smettere di chiedersi se il sistema funziona e iniziare a chiedersi in quali condizioni smette di essere affidabile.
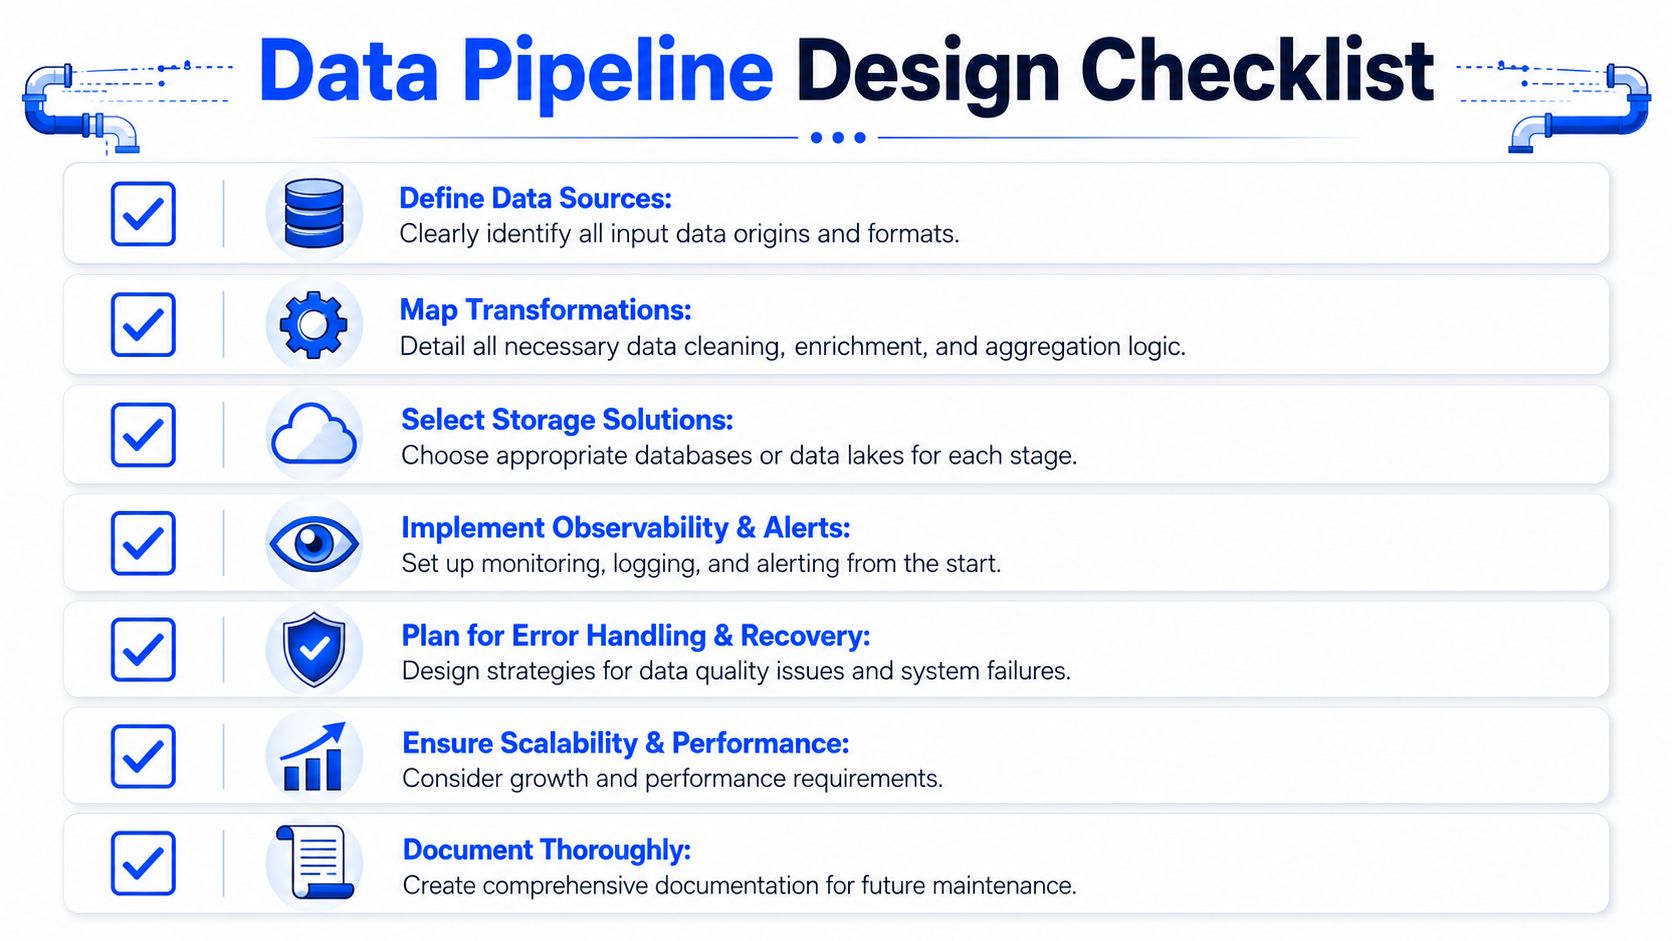
Usate questa checklist prima di approvare un nuovo design o di sottoporre a audit uno esistente:
Definite presto i contratti con le sorgenti. Conoscete struttura, ownership, modalità di aggiornamento e modalità di guasto di ogni sorgente?
Scegliete il pattern in base alla finestra decisionale. Questo caso d'uso è batch, streaming o ibrido in base alla rapidità con cui qualcuno deve agire sui dati?
Separate i livelli grezzo, trasformato e di serving. Potete rieseguire l'ingestion senza ricostruire da zero la logica di business?
Progettate moduli, non mostri. Un team può modificare un componente senza mettere a rischio consumatori non correlati?
Mappate la lineage in modo automatico. Se oggi cambia uno schema, riuscite a identificare rapidamente tabelle, dashboard e modelli impattati?
Pianificate l'esecuzione parallela. Il throughput reggerà ancora quando le sorgenti cresceranno o le finestre di aggiornamento si sovrapporranno?
Fissate le aspettative di tempestività. Esiste uno SLA chiaro o un'aspettativa operativa su quando i dati devono arrivare e quando un ritardo diventa un incidente?
Integrate validazione e observability fin dal primo rilascio. Freschezza, volume, schema e controlli a livello di record fanno parte dell'architettura anziché essere un'aggiunta?
Mantenete i dati sensibili dove risiedono, quando possibile. Il vostro design riduce al minimo le copie e limita gli accessi durante monitoraggio e trasformazione?
Documentate i passaggi. Un nuovo team lead riesce a capire cosa entra, cosa cambia, cosa viene archiviato e chi lo utilizza?
Una buona pipeline non è quella più complicata. È quella che il vostro team può modificare in sicurezza, monitorare con chiarezza e di cui può fidarsi sotto pressione.
Se il vostro team vuole questi controlli senza spostare i dati di produzione fuori dal proprio ambiente, vale la pena dare un'occhiata da vicino a digna. Combina data quality e observability in un'unica piattaforma, viene eseguito all'interno di ambienti private cloud o on-premises controllati dal cliente e aiuta i team a intercettare anomalie, modifiche dello schema, problemi di tempestività ed errori di validazione a livello di record prima che si trasformino in report obsoleti o sistemi a valle non funzionanti.
Poiché molti guasti delle pipeline sono in realtà dati arrivati in ritardo, vedete come digna Timeliness confronta la consegna effettiva con i pattern di arrivo attesi e segnala i ritardi prima che report obsoleti raggiungano il business.
Domande frequenti
Che cos'è l'architettura delle pipeline di dati?
L'architettura delle pipeline di dati è il progetto operativo che stabilisce come i dati vengono raccolti, modificati, archiviati e consegnati senza perdere significato lungo il percorso. L'articolo la suddivide in quattro pilastri: ingestion, storage, elaborazione e serving. I buoni design non evitano ogni guasto; falliscono in modi che gli operatori possono vedere, isolare e correggere.
Qual è la differenza tra ETL ed ELT?
L'ETL trasforma i dati prima che arrivino a destinazione, il che è adatto quando la pulizia alla sorgente è rigorosa, la capacità di calcolo della destinazione è limitata o servono controlli normativi prima del caricamento. L'ELT carica prima e dà forma ai dati in seguito con SQL all'interno di warehouse o lakehouse, offrendo più agilità ai team di analytics. Nessuno dei due è superiore in assoluto: l'ETL offre un controllo più stretto, l'ELT più flessibilità.
Qual è la differenza tra architettura Lambda e Kappa?
Lambda esegue due flussi paralleli: un hot path per lo streaming in tempo reale, un cold path per l'elaborazione batch storica e un livello di serving che unisce i risultati. Kappa elimina il livello batch e gestisce entrambi tramite un'unica pipeline di streaming. È più semplice da gestire, ma dipende da una strategia di replay sicura.
Come si costruisce una pipeline di dati che non si rompe?
Rendetela modulare: unità di ingestion allineate alle sorgenti che possono fallire o essere rieseguite in modo indipendente, livelli di trasformazione con contratti chiari, controlli di qualità riutilizzabili e automazione del deployment. Poi aggiungete la lineage automatizzata, scrivete le aspettative di interfaccia per ogni passaggio, inclusi schema e tempestività, e prevedete l'esecuzione parallela nel design invece di aggiungerla in seguito.
Cosa bisogna monitorare in una pipeline di dati fin dal primo giorno?
Strumentate almeno quattro dimensioni: tempestività, volume, schema e validazione a livello di record. I controlli di qualità vanno collocati nel punto di ingresso dell'ingestion, non solo sulla destinazione, altrimenti drift e valori mancanti si propagano lungo il flusso. Molti cosiddetti guasti delle pipeline sono in realtà problemi di tempestività, in cui i dati arrivano, ma troppo tardi.


