Architettura dei sistemi di dati: guida per i data team moderni
|
11
min di lettura

Conoscete già lo schema. Una dashboard tace, un analista scopre che i numeri non tornano e, quando il problema alla sorgente viene finalmente individuato, tre team a valle hanno già preso decisioni sulla base di dati errati. Il sistema non ha fallito in modo eclatante. Si è semplicemente allontanato dalla realtà abbastanza da far iniziare a erodere la fiducia. È questo il problema di fondo che l'architettura dei sistemi di dati deve risolvere, non disegnando diagrammi più belli, ma rendendo il flusso dei dati prevedibile, governabile e abbastanza resiliente da sopravvivere alla crescita.
Indice
Che cos'è l'architettura dei sistemi di dati
Molti team chiamano architettura il proprio stack quando in realtà si tratta solo di un accumulo di strumenti. Funziona per un po', finché non arriva il primo cambiamento serio: lo schema di una sorgente si sposta, compare un nuovo carico di lavoro o la governance diventa più severa. A quel punto la fragilità emerge sotto forma di report interrotti, pipeline fragili e output dei modelli di cui nessuno si fida del tutto.
L'architettura dei sistemi di dati è il framework deliberato che governa il modo in cui i dati si muovono, vengono trasformati e vengono consumati all'interno di un'organizzazione. Il SEI della Carnegie Mellon descrive questo compito in modo chiaro: stabilisce linee guida comuni per le operazioni sui dati, così che le organizzazioni possano prevedere, modellare, misurare e controllare il flusso dei dati in un sistema (guida del SEI). È la parte che molti team trascurano. L'architettura non riguarda solo la collocazione di storage e compute, ma è la disciplina operativa che rende il movimento dei dati comprensibile e gestibile su larga scala.
L'architettura riguarda il controllo, non la decorazione
Quando esamino una piattaforma dati, cerco i confini. Chi è responsabile dell'ingestione? Dove vengono rilevate le modifiche allo schema? Quale livello è responsabile della qualità e quale livello consuma dati affidabili? Se queste risposte sono vaghe, prima o poi la piattaforma diventerà un problema di coordinamento piuttosto che tecnico.
Lo scopo dell'architettura è ridurre le sorprese. Vi dà una struttura in grado di assorbire nuove sorgenti, regole di business che cambiano e volumi in crescita senza trasformare ogni rilascio in un'emergenza. Ecco perché il lavoro di architettura enterprise parte dal comportamento del sistema di fronte al cambiamento, non dalla forma del diagramma di un data warehouse.
L'altro inquadramento utile è la distinzione tra la vista concettuale rivolta agli utenti e l'implementazione tecnica. In pratica, una buona architettura mantiene questi livelli coordinati ma separati, così gli utenti possono ragionare sui dati senza essere costretti a comprendere ogni decisione di storage sottostante.
indicazioni sull'architettura dei dati enterprise
Regola pratica: se non sapete spiegare come un dataset passa dalla sorgente al consumo, non avete ancora un'architettura, avete un'infrastruttura.
I componenti fondamentali di un sistema di dati
Un sistema di dati sembra semplice solo quando le sue parti svolgono il proprio compito in modo indipendente. In realtà, la piattaforma si comporta come la rete idrica di una città. Le sorgenti sono i bacini, l'ingestione è la rete di pompaggio, lo storage è l'infrastruttura di trattamento e accumulo, l'elaborazione è la filtrazione e l'instradamento, e la distribuzione sono i rubinetti che le persone usano.
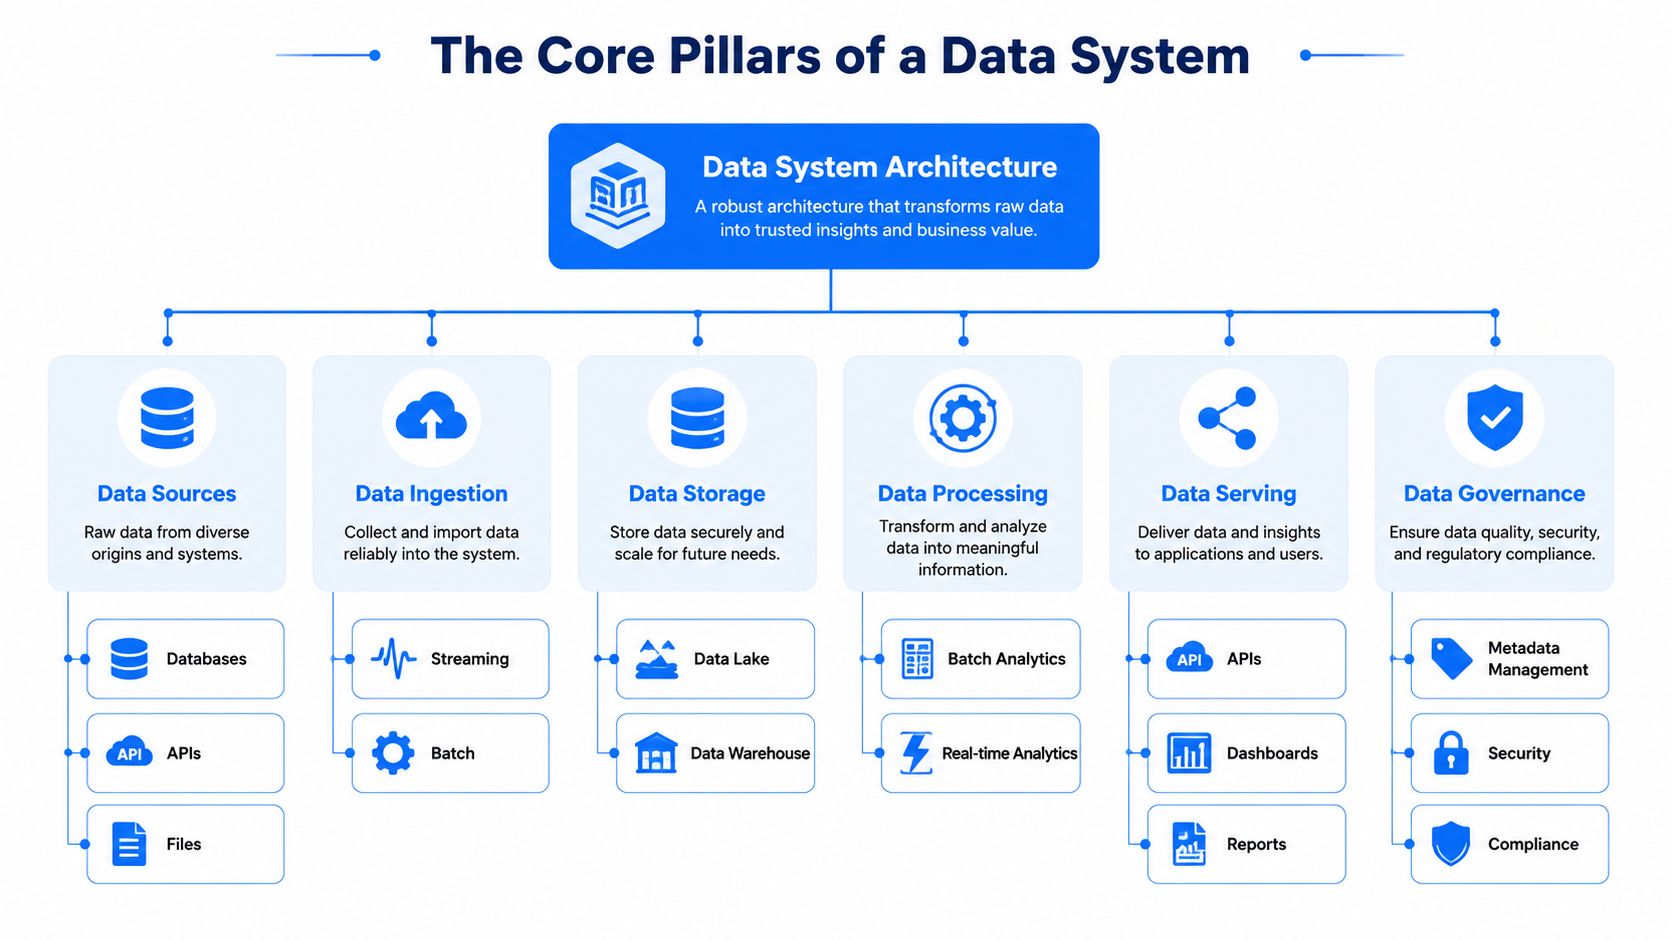
Il confine tecnico più chiaro nel sistema è la separazione tra schemi interni ed esterni. Il materiale di Purdue descrive lo schema interno come le strutture fisiche di memorizzazione, come gli indici, mentre gli schemi esterni definiscono le diverse viste utente esposte ai consumatori (capitolo di Purdue). Questa separazione è importante perché permette al livello di storage di evolvere senza costringere ogni consumatore a valle a cambiare nello stesso momento.
Ingestione e storage hanno responsabilità diverse
L'ingestione è la porta d'ingresso. Decide come i dati entrano nel sistema, che si tratti di streaming, caricamenti batch, API o depositi di file. Se l'ingestione è approssimativa, i livelli a valle ereditano ambiguità. Se è disciplinata, le fasi successive possono fare ipotesi più solide su completezza, ordinamento e freschezza.
Lo storage non è solo un posto in cui scaricare record. È lì che decidete se il sistema ha bisogno di un data lake, di un data warehouse o di entrambi, e quanta struttura debba esserci nei dati a riposo rispetto a quelli in movimento. Le indicazioni di IBM sull'architettura dei dati collegano questo alla sequenza pratica di modelli concettuali, logici e fisici, seguiti da ingestione, API, gestione dei metadati ed endpoint di consumo (architettura dei dati secondo IBM). Questa sequenza funziona perché costringe le scelte di progettazione ad allinearsi al modo in cui le persone useranno i dati.
Elaborazione e distribuzione sono il punto in cui l'architettura diventa visibile al business. L'elaborazione trasforma gli input grezzi in strutture utilizzabili, mentre la distribuzione pubblica gli output per dashboard, API, report e applicazioni a valle. Se la distribuzione è strettamente accoppiata all'ingestione, ogni problema alla sorgente diventa un problema per il cliente. Se è troppo distaccata, il business finisce per guardare risultati obsoleti o incoerenti.
I metadati sono la memoria del sistema
La gestione dei metadati è il livello in cui i team investono troppo poco, per poi pentirsene. È al tempo stesso il ricettario, l'inventario e il registro del lineage. Senza di essa i dati possono ancora muoversi, ma nessuno è in grado di dire con certezza cosa è cambiato, chi ne dipende o se un campo ha lo stesso significato in sistemi diversi.
Lezione operativa: l'architettura diventa duratura quando ogni livello ha un compito circoscritto e i metadati mantengono allineati i compiti.
Pattern comuni di architettura dei sistemi di dati
Il pattern giusto dipende dal problema che state risolvendo, non dal diagramma più di tendenza in circolazione. Un lakehouse aiuta quando analytics e storage basato su file devono convergere. Il data mesh aiuta quando un unico team centrale non riesce a tenere il passo con la complessità organizzativa. La progettazione event-driven si adatta ai sistemi in cui il cambiamento stesso è il segnale principale. I pattern Lambda e Kappa affrontano la tensione tra correttezza del batch e risposta a bassa latenza.
indicazioni pratiche sull'architettura delle pipeline di dati
Quattro pattern per quattro diversi tipi di pressione
Un Data Lakehouse cerca di ridurre la separazione tra analytics in stile data warehouse e storage in stile data lake. Il vantaggio è la semplicità operativa: un unico ambiente logico per casi d'uso analitici più ampi. Il rischio è che i team presumano che un'unica piattaforma elimini automaticamente la necessità di governance, cosa che non avviene. Servono comunque ownership chiara, controlli di qualità e data contract.
Il Data Mesh viene spesso frainteso come un pattern di storage. In realtà è una risposta organizzativa alla scala. Se i team di dominio sono responsabili dei propri data product, i colli di bottiglia centrali si riducono, ma solo se l'azienda accetta standard condivisi per interoperabilità, individuabilità e governance.
L'architettura event-driven funziona quando al business interessano i cambiamenti di stato nel momento in cui avvengono. È molto adatta ai sistemi operativi, ma può diventare rumorosa se i team usano gli eventi per tutto, comprese le domande a cui rispondono meglio modelli analitici curati.
Lambda e Kappa sono risposte diverse allo stesso problema di latenza. Lambda mantiene affiancati il percorso batch e quello veloce, il che può essere pratico ma pesante dal punto di vista operativo. Kappa semplifica partendo dallo streaming, soluzione più pulita quando l'organizzazione è in grado di supportare quel modello end-to-end.
Pattern | Caso d'uso principale | Complessità | Latenza dei dati | Modello di governance |
|---|---|---|---|---|
Data Lakehouse | Analytics unificate su carichi di lavoro in stile data lake e data warehouse | Da media ad alta | Da batch a quasi tempo reale, a seconda dell'implementazione | Centralizzato con standard condivisi |
Data Mesh | Scalare l'ownership dei dati tra i domini | Alta | Variabile in base al dominio | Governance federata |
Architettura event-driven | Workflow operativi e propagazione dei cambiamenti | Media | Bassa latenza | Contratti sugli eventi e ownership dei servizi |
Architettura Lambda | Accuratezza del batch più viste operative rapide | Alta | Mista | Suddiviso per percorso |
Architettura Kappa | Elaborazione stream-first con operazioni più semplici | Media | Bassa latenza | Governance incentrata sullo stream |
Scegliete in base agli attriti, non alle mode
Un pattern che sembra elegante in una presentazione può rivelarsi costoso nella pratica. Il data mesh fallisce quando i team di dominio non vogliono farsi carico dell'onere della product ownership. I sistemi event-driven falliscono quando i team trattano ogni integrazione come un problema di streaming. Lambda fallisce quando l'organizzazione non riesce a mantenere sincronizzati due percorsi.
La domanda utile è semplice. Quale parte del business è sotto la pressione maggiore: scala, latenza o coordinamento? La risposta di solito indica il pattern che reggerà meglio.
Non partite dall'etichetta dell'architettura. Partite dalla modalità di guasto che dovete eliminare.
Progettare per la fiducia e l'affidabilità
La fiducia si rompe più in fretta del throughput. Una pipeline può essere veloce ed essere comunque inutile se consegna dati obsoleti, incompleti o strutturalmente modificati. Ecco perché qualità e osservabilità devono essere progettate all'interno del sistema, non aggiunte dopo il primo incidente.

Le indicazioni moderne sono esplicite: l'architettura ha bisogno di meccanismi integrati per il rilevamento dei cambiamenti e il feedback operativo. Deve tenere conto di schema drift, tempestività e comportamento della piattaforma come aspetti progettuali continui, non come un'aggiunta di monitoraggio (best practice di Streamkap). Questo corrisponde al modo in cui falliscono i sistemi reali. Non si limitano a fermarsi, iniziano lentamente a funzionare male.
L'affidabilità parte dalla forma del ciclo di controllo
Un sistema affidabile definisce le aspettative prima di scrivere codice. Che aspetto hanno i dati corretti? Quale freschezza è accettabile? Quali modifiche allo schema sono sicure e quali dovrebbero bloccare l'utilizzo a valle? Non sono domande di reporting, sono requisiti architetturali.
I sistemi più solidi tengono conto anche della località dei dati. Se validazione e rilevamento delle anomalie avvengono vicino ai dati, riducete gli spostamenti non necessari e preservate il contesto originale del record. Questo è importante negli ambienti enterprise, dove le copie creano oneri di sicurezza, governance e prestazioni.
Perché l'osservabilità va prevista in fase di progettazione
L'osservabilità non dovrebbe attendere il consolidamento successivo al lancio. Se monitorate solo lo stato di salute dell'infrastruttura, vi sfuggiranno i problemi dei dati che contano di più per analisti e utenti di business. Una piattaforma può sembrare sana pur servendo partizioni corrotte, feed in ritardo o tabelle strutturalmente modificate.
Uno stack di affidabilità pratico comprende alcuni meccanismi distinti:
Validazione in fase di ingestione: rifiutate o segnalate i record che violano le regole di business prima che si propaghino.
Rilevamento delle anomalie sulle baseline: apprendete la forma normale dei dati e generate alert in caso di movimenti inattesi.
Tracciamento dello schema: rilevate campi aggiunti, rimossi o modificati prima che i consumatori si interrompano.
Controlli di tempestività: verificate che i dati arrivino quando dovrebbero, non solo che prima o poi arrivino.
digna è un'opzione in questo ambito, perché esegue i controlli di qualità all'interno dell'ambiente del cliente, traccia le modifiche allo schema e monitora tempestività e anomalie senza spostare i dati dalla loro sede. Questa scelta progettuale conta più del nome del marchio. Il principio architetturale è lo stesso: mantenere il rilevamento vicino al sistema di riferimento.
Deployment e sicurezza negli ambienti enterprise
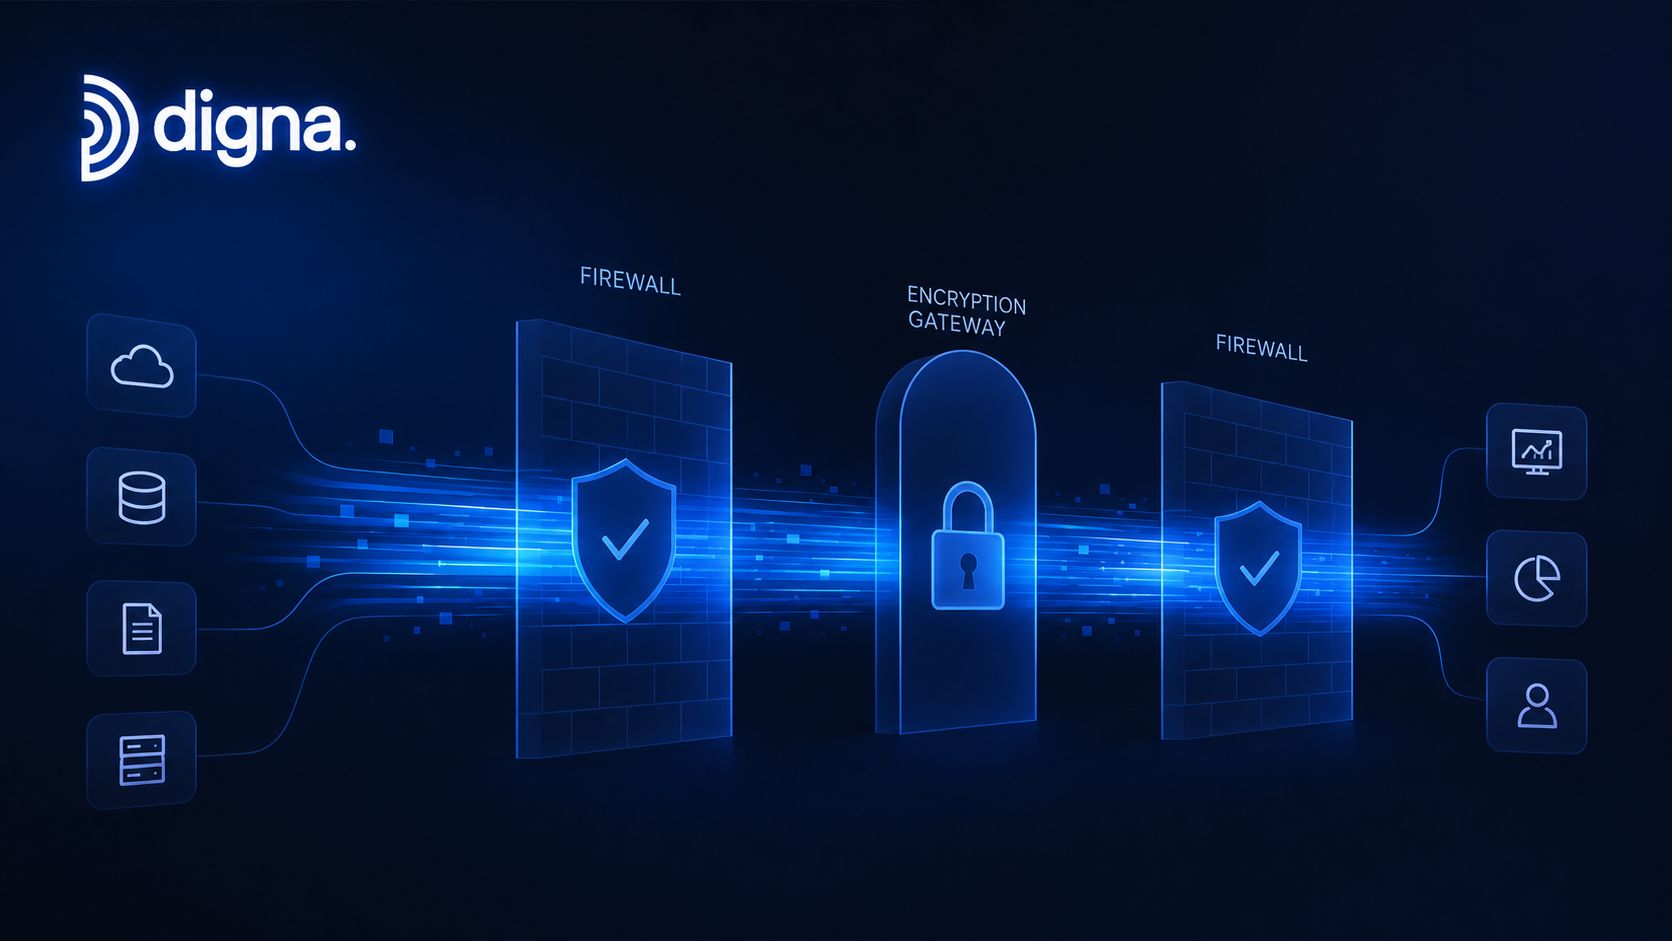
Il deployment enterprise cambia i presupposti della progettazione. Quando entrano in gioco dati regolamentati, controlli interni e requisiti di audit, l'architettura deve dimostrare dove risiedono i dati, chi può accedervi e come ogni modifica sia tracciabile. I deployment in private cloud e on-premises restano rilevanti perché la sicurezza non riguarda solo la crittografia. Riguarda anche la località, i confini di accesso e il controllo operativo.
AWS descrive l'architettura dei dati enterprise come un sistema vivo che deve essere monitorato e riottimizzato continuamente man mano che i volumi di dati crescono, i casi d'uso evolvono e le normative cambiano, con governance e monitoraggio integrati nel ciclo di vita (architettura dei dati secondo AWS). Questo inquadramento è utile perché tratta la compliance come parte delle operazioni continue, non come un esercizio di certificazione al momento del lancio.
La sicurezza è una proprietà architetturale
Se i dati finiscono nell'ambiente sbagliato, nessuna rifinitura delle dashboard eliminerà il rischio di fondo. Le architetture solide definiscono zone di fiducia chiare, isolano i carichi di lavoro sensibili e controllano gli spostamenti tra i sistemi. Inoltre rendono l'auditabilità un requisito di primo piano, così che log di accesso, trasformazioni ed eccezioni possano essere esaminati senza un lavoro manuale di archeologia.
Il modello di deployment svolge un ruolo cruciale. Negli ambienti gestiti dal cliente, il team che controlla i dati controlla anche il perimetro delle policy. Questo semplifica le discussioni su sovranità, accesso ai dati ed esposizione verso i fornitori, soprattutto nei settori finanziario, sanitario e della pubblica amministrazione.
I controlli devono scalare con la piattaforma
Un controllo degli accessi che funziona per una manciata di tabelle spesso fallisce in un grande patrimonio di produzione. I team hanno bisogno di schemi per autorizzazioni basate sui ruoli, accessi tra servizi e supervisione amministrativa che non dipendano da conoscenze tribali. Lo stesso vale per lineage e audit trail: se non sono integrati nell'architettura, verranno ricostruiti male dopo un incidente.
indicazioni sulla protezione dei dati dei clienti
L'obiettivo finale non è solo tenere fuori gli attaccanti. È progettare una piattaforma in grado di rispondere rapidamente alle domande di governance quando i team legali, di compliance o di sicurezza le pongono. Se l'architettura non ne è capace, non è pronta per l'uso enterprise.
Fare la scelta architetturale giusta
Le buone scelte architetturali riguardano di solito meno l'eleganza e più i compromessi. ThoughtWorks descrive l'architettura dei dati moderna come un insieme di compromessi tra sicurezza, compliance, individuabilità, riproducibilità e idoneità misurabile, non come un diagramma statico, ed è questa la lente giusta per la valutazione (indicazioni di ThoughtWorks sull'architettura). La progettazione migliore è quella che si adatta alla realtà operativa del vostro team.
Partite dai vincoli
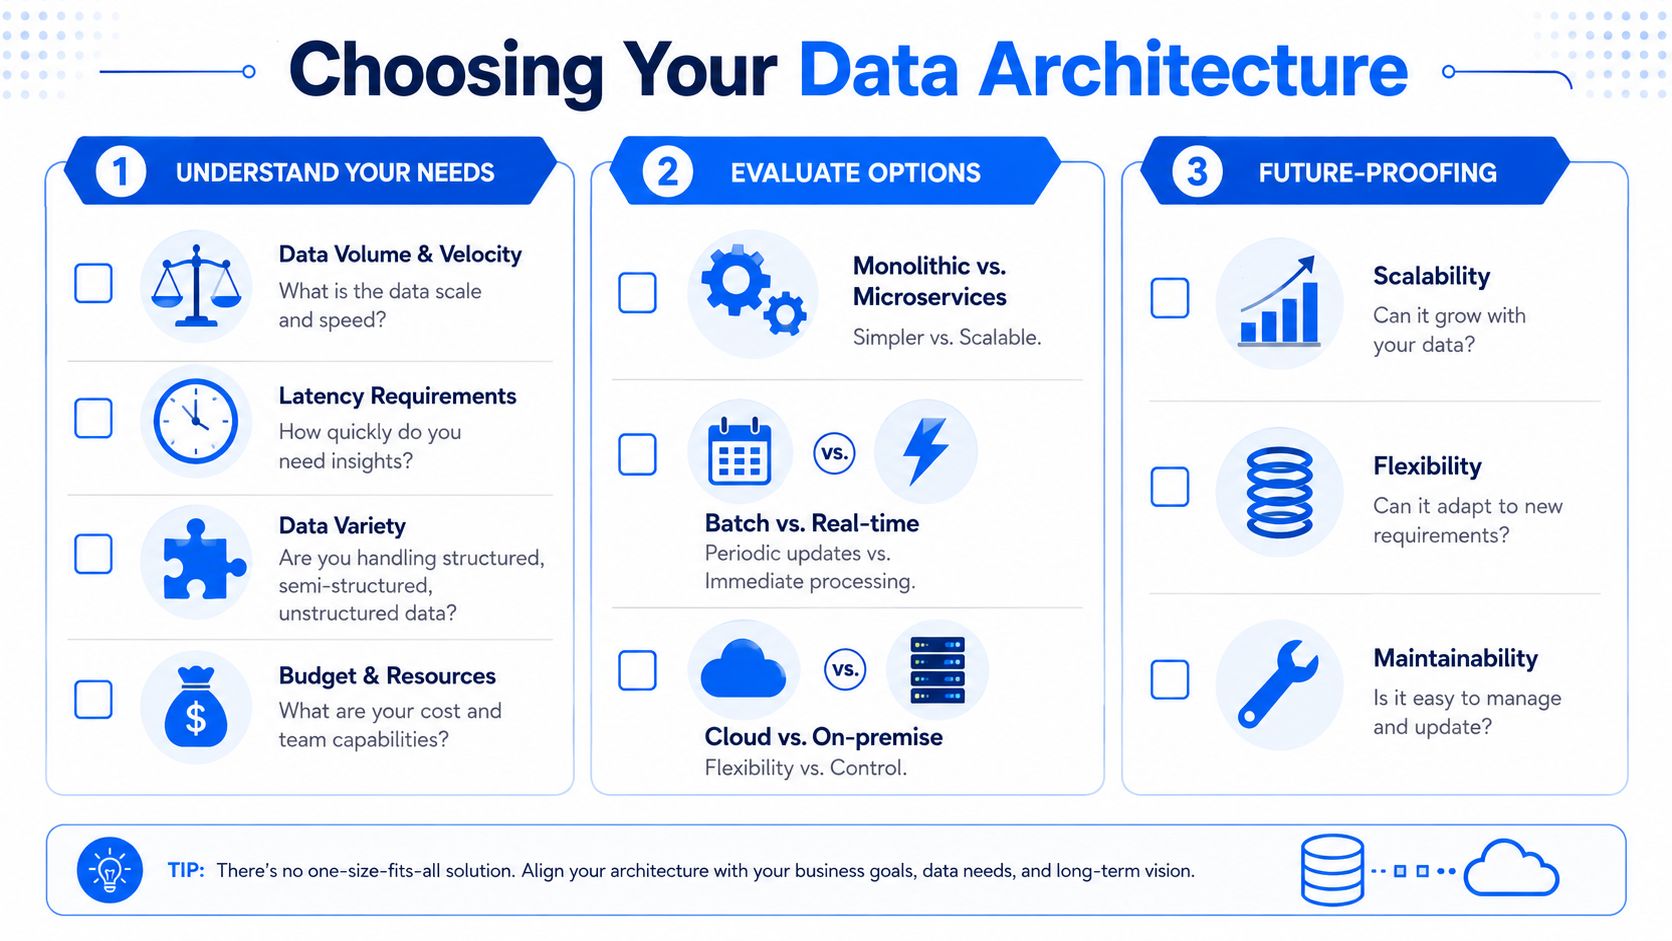
Prestazioni e costi tirano sempre in direzioni opposte. Lo stesso vale per scalabilità e semplicità operativa. L'elaborazione batch è più facile da governare, ma l'elaborazione in tempo reale può essere indispensabile quando il business ha bisogno di agire immediatamente. La scelta sbagliata è di solito quella che ottimizza per un carico di lavoro futuro di cui nessuno si è ancora impegnato ad assumersi la responsabilità.
Usate con gli stakeholder una breve checklist decisionale:
Volume e velocità dei dati: quanti dati si muovono e con quale rapidità arrivano?
Requisiti di latenza: il business ha bisogno di risultati immediati o bastano aggiornamenti pianificati?
Varietà dei dati: avete a che fare con record strutturati, feed semi-strutturati o contenuti non strutturati?
Budget e capacità del team: il team è in grado di gestire la soluzione che sceglie?
Onere di governance: chi è responsabile di accessi, conservazione e auditabilità?
Valutate il sistema che siete in grado di sostenere
Una progettazione vale quanto la capacità del team di gestirla in una giornata difficile. Se l'architettura dipende da competenze specialistiche che nessuno nel team di piattaforma possiede, il rischio operativo aumenta. Se richiede un coordinamento fragile tra più livelli, aumenta anche la probabilità di guasti silenziosi.
Rendere un sistema a prova di futuro significa meno prevedere la prossima parola d'ordine e più mantenere aperte le vie d'uscita. La piattaforma può assorbire una nuova sorgente senza una riprogettazione importante? Può supportare una regola di governance più rigorosa? Può evolvere senza costringere ogni consumatore a reimparare il modello?
Un'architettura solida vi dà spazio per crescere mantenendo comprensibili le parti in movimento. Una debole sembra efficiente sulla carta e si rivela costosa nella pratica.
Conclusione: il progetto di un sistema vivo
L'architettura dei sistemi di dati non è un progetto da definire una volta per tutte. È la struttura viva che consente ai dati di muoversi in modo affidabile attraverso ingestione, storage, elaborazione, distribuzione e governance mentre l'organizzazione cambia intorno a essa. I sistemi che durano sono quelli che trattano affidabilità, osservabilità e controllo come principi di progettazione, non come lavoro di pulizia.
Il passaggio storico dalle rigide strutture a file ai modelli relazionali, e poi dal data warehousing centralizzato agli approcci distribuiti e cloud-native, porta alla stessa lezione: l'architettura evolve quando evolvono le esigenze di dati del business. La differenza tra uno stack fragile e una piattaforma duratura dipende di solito dal fatto che il team abbia progettato per il cambiamento prima che il cambiamento arrivasse.
I sistemi migliori sono adattabili senza essere vaghi, osservabili senza essere rumorosi e governati senza diventare inutilizzabili. È questo lo standard a cui vale la pena puntare.
Se il vostro team sta cercando di rendere qualità dei dati, osservabilità e governance parte dell'architettura anziché un ripensamento, visitate digna. Gira all'interno del vostro ambiente ed è pensata per monitorare il comportamento dei dati dove i dati risiedono già. Se state pianificando una piattaforma che deve restare affidabile mentre cresce, è il tipo di disciplina progettuale che vale la pena introdurre fin dall'inizio.
Domande frequenti
Che cos'è l'architettura dei sistemi di dati?
È il framework deliberato che governa il modo in cui i dati si muovono, vengono trasformati e vengono consumati all'interno di un'organizzazione. Molti team chiamano architettura il proprio stack quando in realtà si tratta di un accumulo di strumenti.
Che cosa distingue un'architettura da un accumulo di strumenti?
I confini. Esaminare una piattaforma dati significa cercare i punti in cui la responsabilità passa di mano, e uno stack privo di tali confini ha dei componenti ma nessuna architettura degna di questo nome.
A che cosa serve davvero l'architettura?
A ridurre le sorprese. Riguarda il controllo più che la decorazione, ed è per questo che la prova di una progettazione non è come appare nel diagramma, ma quanto si comporta in modo prevedibile quando una sua parte cambia.
Come si capisce se se ne ha una?
Chiedendosi che cosa succede a ogni confine quando qualcosa va storto. Se la risposta cambia a seconda di chi la dà, i confini esistono nel diagramma anziché nel sistema.
Dove si colloca l'osservabilità nell'architettura?
Ai confini. Strumentare i passaggi di consegna è ciò che trasforma un diagramma in qualcosa su cui si può ragionare durante un incidente, perché è lì che le ipotesi di un componente incontrano l'output di un altro.


