Affidabilità della qualità dei dati: come la misurano davvero i team
|
8
min di lettura

Il lunedì mattina inizia con un successo familiare. La dashboard dei ricavi si carica, i totali quadrano con la finanza e ogni grafico è verde prima della riunione del management. Nessuno vede che le transazioni mobile in ritardo sono ancora in fase di backfill, che un job di sessionizzazione ha perso alcune partizioni e che un campo rinominato produce molti più NULL rispetto alla sua baseline. La dashboard sembra affidabile perché l'output visibile è stato generato, non perché la catena di consegna sia rimasta affidabile.
Questa distinzione è importante, perché analytics, operations e sistemi di AI consumano le stesse pipeline. L'affidabilità della qualità dei dati non è una checklist applicata a una tabella a posteriori. È una proprietà operativa dell'intera catena, che comprende aggiornamento, completezza, comportamento dello schema, validità, lineage e governance. Questa guida tratta l'affidabilità come una questione di produzione e mostra come misurarla senza trasformare ogni rilascio in un collo di bottiglia di test manuali.
Indice
Il guasto nascosto dietro dashboard all'apparenza affidabili
Perché qualità e affidabilità non sono la stessa cosa
L'errore di investimento
Le metriche che misurano davvero l'affidabilità
Controlli basati su regole, controlli statistici e rilevamento delle anomalie con l'AI
Disponeteli a livelli in base alla certezza
Osservabilità, controlli in-database e validazione che lavorano insieme
Salvaguardie operative che impediscono ai programmi di affidabilità di arenarsi
Indirizzate gli alert al data product
Separate i livelli di servizio
Mantenete i controlli nel percorso di consegna
Che cosa richiede davvero l'affidabilità dei dati per l'AI
Seguite l'intera catena degli input dell'AI
Mettere tutto insieme e i prossimi passi
Il guasto nascosto dietro dashboard all'apparenza affidabili
Il primo problema compare nel flusso di eventi. Un rilascio dell'app mobile cambia il modo in cui vengono emesse le transazioni, per cui alcuni record arrivano in ritardo anziché nella finestra di elaborazione prevista. Il job di ingestione va a buon fine perché ha ricevuto dati, ma i dati non sono completi nel momento in cui i consumatori a valle li leggono.
Poi la sessionizzazione elabora le partizioni disponibili. Ne mancano tre, eppure la trasformazione produce comunque una tabella. Il numero giornaliero di righe resta entro un ampio intervallo storico perché il traffico desktop maschera il buco del mobile. L'aggiornamento della dashboard si completa e i totali possono ancora quadrare con la finanza, se la finanza riceve un backfill successivo o usa un orario di cut-off diverso.
Il terzo guasto è strutturale. Un campo a monte viene rinominato e la trasformazione mantiene la colonna tramite un percorso di compatibilità. Il tasso di NULL del campo aumenta, ma nessun alert confronta la variazione con una baseline nota. Le feature di attribuzione contengono ora meno informazioni utilizzabili, mentre il modello di churn continua ad addestrarsi come se la feature avesse mantenuto il suo significato precedente.
Una dashboard verde dimostra che una query è stata eseguita e ha restituito un risultato. Non dimostra che siano arrivati i dati giusti, che ogni trasformazione si sia comportata correttamente o che i consumatori li abbiano ricevuti entro la finestra richiesta.
Ecco perché i team possono fidarsi della superficie visiva e prendere comunque decisioni inaffidabili. Un report può essere numericamente coerente con un sistema di riferimento ed essere al tempo stesso incompleto, obsoleto o semanticamente compromesso per un altro caso d'uso. Un modello può anche assorbire il degrado molto prima che qualcuno noti un errore visibile nel reporting.
La risposta pratica è monitorare la catena di consegna, non solo la tabella finale. Una dashboard ha bisogno di evidenze sull'aggiornamento, completezza delle partizioni, storico dello schema, contesto di lineage e un responsabile per ogni asset critico a monte. I team che si concentrano solo sui sintomi visibili nelle dashboard possono approfondire le dashboard sulla qualità dei dati, ma la soluzione più profonda è individuare quale controllo è fallito prima che la dashboard diventasse fuorviante.
Perché qualità e affidabilità non sono la stessa cosa
La qualità dei dati descrive se i dati sono conformi alle condizioni attese. Un valore può essere valido, non NULL, del tipo corretto, entro un intervallo consentito e collegato a un record di riferimento esistente. Questi controlli esaminano il contenuto e la struttura dei record.
L'affidabilità dei dati si chiede se i consumatori possano contare sui dati nel tempo e lungo l'intero processo di consegna. Comprende la qualità, ma si chiede anche se i dati attesi siano arrivati, se la pipeline li abbia resi disponibili entro la sua finestra di servizio, se la loro lineage sia nota e se le modifiche siano state comunicate e controllate.
L'analogia del mattone rende concreta la differenza. La qualità si chiede se ogni mattone sia solido e della forma giusta. L'affidabilità si chiede se il muro arrivi nei tempi previsti, contenga tutti i corsi di mattoni, abbia un'origine nota e continui a reggersi al variare delle condizioni.
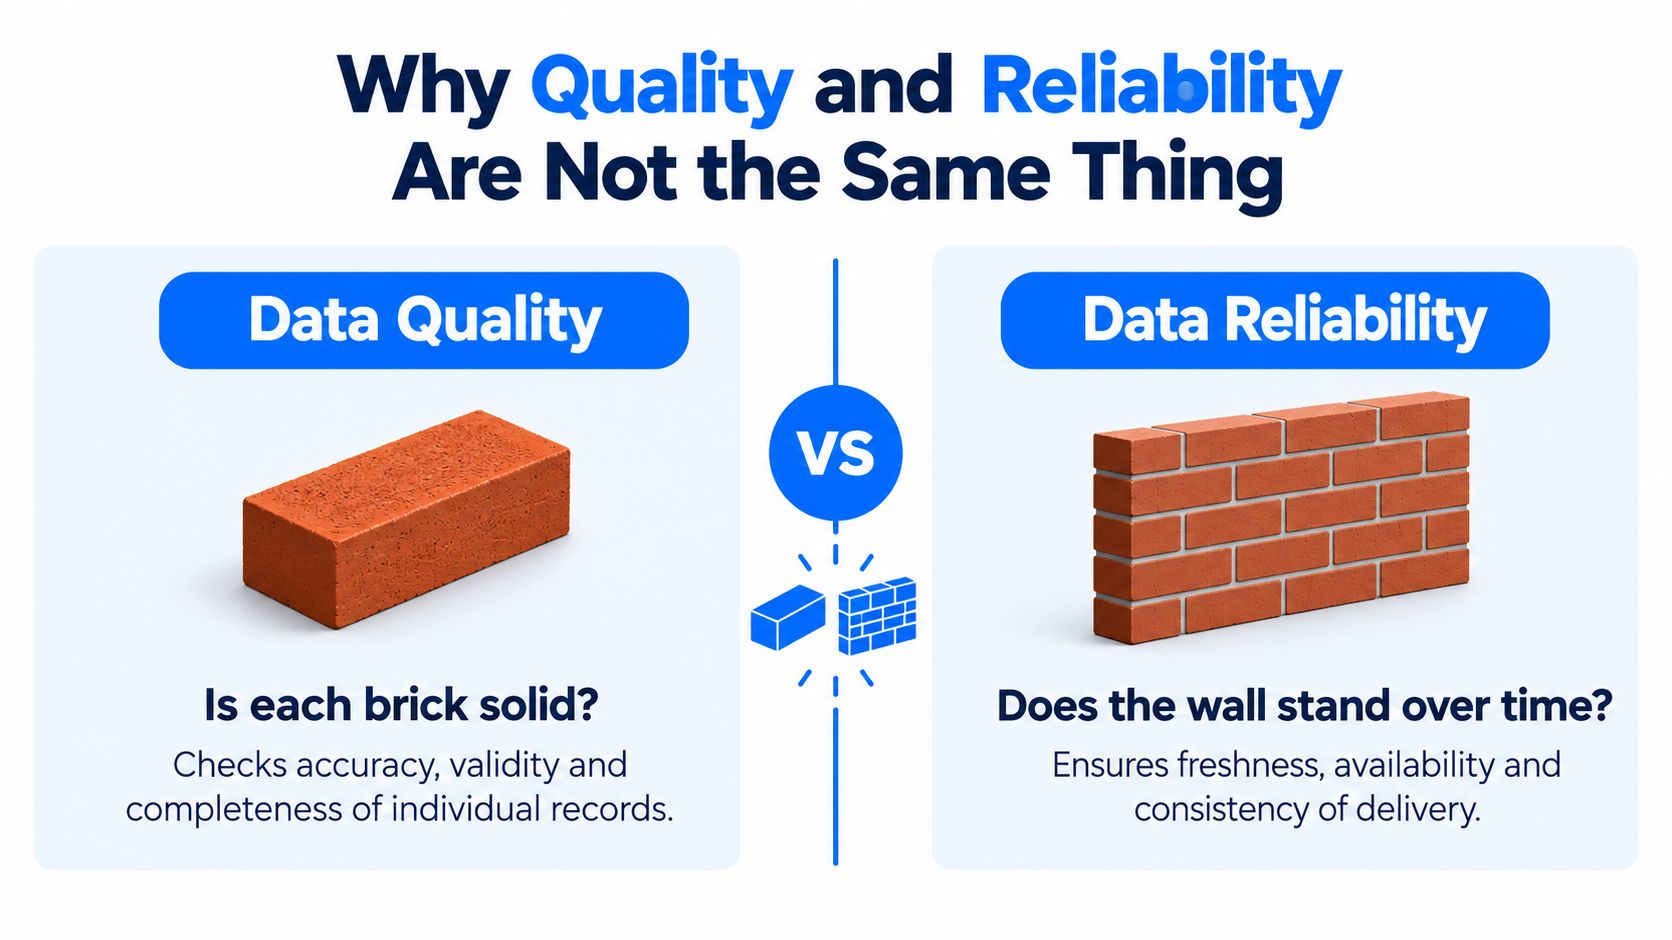
Una tabella può superare la validazione a livello di riga e fallire come prodotto affidabile. Ogni record arrivato può avere un identificativo cliente valido, eppure può mancare un'intera partizione. Un validatore dello schema può confermare che una colonna esiste, mentre la lineage è interrotta e nessuno sa quale fonte l'abbia prodotta. Un dataset può essere accurato a riposo ed essere comunque troppo obsoleto per una decisione operativa.
L'errore di investimento
Quando i team trattano qualità e affidabilità come sinonimi, spesso acquistano o costruiscono i controlli sbagliati. Aggiungono altri controlli sui NULL, asserzioni sui tipi e regole di dominio, lasciando però indefinite le aspettative di aggiornamento. Ispezionano i valori all'interno del warehouse ma non monitorano partizioni in ritardo, durata delle esecuzioni, dipendenze a monte o impatto a valle.
Ne risulta un sistema di controllo squilibrato. I controlli deterministici proteggono il mattone, mentre nessuno verifica se il muro sia completo o se sia arrivato quando il consumatore ne aveva bisogno. Il risultato è una grande raccolta di test superati, associata a un prodotto inaffidabile.
L'affidabilità richiede quindi definizioni di servizio end-to-end. Produttore e consumatore dovrebbero concordare che cosa deve arrivare, entro quando, in quale forma, con quali vincoli di business e con quali evidenze di lineage. La qualità a livello di riga resta essenziale, ma diventa una parte di un contratto di consegna anziché l'intera definizione di fiducia.
Le metriche che misurano davvero l'affidabilità
L'affidabilità in produzione diventa gestibile quando i team traducono le aspettative in segnali osservabili. Cinque metriche coprono le principali modalità di guasto: aggiornamento, completezza, stabilità dello schema, validità e deriva della distribuzione. Non vanno trattate come valori universali di superato/non superato. Ogni soglia appartiene a un contratto che riflette la tolleranza del consumatore e il ruolo dell'asset.
L'aggiornamento (freshness) misura il divario tra la disponibilità attesa di un evento e il suo arrivo effettivo. Un'implementazione utile confronta i timestamp di high-watermark con una finestra di livello di servizio, poi genera un alert quando una partizione è in ritardo o manca. Le linee guida tecniche sul monitoraggio della freshness descrivono questo approccio basato sugli SLA, anziché considerare un timestamp come evidenza sufficiente di buona salute.
La completezza confronta ciò che sarebbe dovuto arrivare con ciò che è arrivato. Il controllo dovrebbe operare a livello di partizione o di unità di consegna, perché un insieme completo di righe all'interno di una giornata incompleta può comunque produrre un risultato fuorviante. Un alert potrebbe scattare quando manca una partizione attesa o quando il conteggio consegnato esce dalla fascia operativa concordata.
La stabilità dello schema traccia aggiunte, rimozioni, rinomine e cambi di tipo rispetto a una baseline o a un contratto esplicito. Queste modifiche possono rompere le trasformazioni, alterare il significato o aumentare i tassi di NULL senza causare un guasto immediato della pipeline. Azure Databricks espone campi di drift come count_delta, avg_delta, percent_null_delta, percent_zeros_delta, percent_distinct_delta e non_null_columns_delta, a dimostrazione di come i team possano quantificare le variazioni strutturali e di distribuzione in una tabella di confronto. La documentazione di Azure Databricks sulle metriche di drift spiega questo modello di output.
I controlli di validità verificano i valori rispetto a vincoli e regole di dominio. Coprono nullabilità, intervalli, categorie consentite, formati, requisiti di unicità e integrità referenziale. Una condizione di alert pratica potrebbe essere qualsiasi violazione di un vincolo chiave, mentre le regole meno rigide possono generare un alert quando il tasso di errore supera la tolleranza concordata con il consumatore.
La deriva della distribuzione misura i movimenti nel comportamento dei valori numerici, categorici e NULL. Intercetta cambiamenti che superano le regole statiche, come una categoria legittima che diventa insolitamente dominante o un campo normalmente valorizzato che diventa sparso. Gli incidenti di schema drift che riguardano oltre il 5% dei campi sono stati associati a un aumento del 30% dei problemi di qualità dei dati segnalati dagli utenti finali, secondo l'analisi di Integrate.io sugli incidenti di schema drift. Usate questo dato come segnale di rischio, non come soglia universale di produzione.
Metrica | Che cosa misura | Soglia tipica | Modalità di guasto intercettata |
|---|---|---|---|
Aggiornamento | Latenza di arrivo attesa rispetto a quella effettiva | Una finestra SLA definita, spesso con un avviso prima della violazione vera e propria | Caricamenti in ritardo, dashboard obsolete, feature in ritardo |
Completezza | Record o partizioni attesi rispetto a quelli consegnati | Partizioni richieste presenti e volume consegnato entro una fascia concordata | Porzioni mancanti, caricamenti parziali, eventi persi |
Stabilità dello schema | Variazione strutturale rispetto a una baseline o a un contratto | Nessuna modifica distruttiva non approvata, con revisione delle modifiche additive | Rinomine, rimozioni, cambi di tipo, rotture a valle |
Validità | Conformità a vincoli e regole di business | Le regole critiche devono essere superate, con tassi tollerati per quelle non critiche | Chiavi non valide, valori impossibili, riferimenti errati |
Deriva della distribuzione | Movimento statistico nel tempo | Alert quando il movimento supera una baseline calibrata | Spostamenti della popolazione, picchi di NULL, cambi di categoria |
Queste metriche costituiscono un contratto tra produttori e consumatori. La domanda utile non è se un dataset abbia una “buona qualità”, ma se la catena di consegna abbia soddisfatto le condizioni richieste da una specifica decisione, da un modello o da un report. I team possono usare un framework pratico per misurare l'affidabilità per collegare queste condizioni al monitoraggio a livello di asset.
Controlli basati su regole, controlli statistici e rilevamento delle anomalie con l'AI
Nessun singolo metodo di rilevamento può vedere ogni guasto. I controlli basati su regole danno il meglio quando il comportamento atteso è esplicito. Una chiave non NULL, un valore di stato approvato, un riferimento valido o un pattern obbligatorio possono essere espressi chiaramente e valutati a basso costo ai confini di ingestione o trasformazione.
I controlli statistici risolvono un problema diverso. Stabiliscono una baseline per comportamenti che non si possono ridurre a una singola regola deterministica, come volume di righe, valore medio, varianza, cardinalità, proporzione di NULL o tempistica di arrivo. Una regola può stabilire che una colonna non può essere NULL, mentre un controllo statistico può notare che i NULL sono improvvisamente diventati frequenti anche se tecnicamente la colonna resta valorizzata.
Il rilevamento delle anomalie appreso dall'AI aggiunge un terzo livello. I modelli possono combinare più segnali e individuare comportamenti correlati che l'autore di una regola non aveva previsto. Uno spostamento simultaneo di volume, aggiornamento, distribuzione e consumo a valle può indicare un problema legato a un rilascio anche quando nessun singolo segnale supera un limite scelto manualmente.
Approccio | Ideale per | Limiti | Livello |
|---|---|---|---|
Validazione basata su regole | Garanzie contrattuali e vincoli di business | Onere di manutenzione quando la logica cambia, copertura limitata dei comportamenti sconosciuti | Confini di ingestione e trasformazione |
Controlli statistici | Derive, stagionalità, volumi, latenza e variazioni di distribuzione | Richiedono una baseline utile e un'attenta calibrazione dei falsi positivi | Monitoraggio di dataset e pipeline |
Rilevamento delle anomalie con l'AI | Rischi correlati ed emergenti su più segnali | Meno immediatamente spiegabile e dipendente da uno storico rappresentativo | Osservabilità trasversale ai segnali e definizione delle priorità |
Disponeteli a livelli in base alla certezza
Partite dalle regole per le condizioni che non devono mai essere violate. Questi controlli devono fallire in modo evidente quando una chiave rotta o un riferimento non valido renderebbero l'output non sicuro. Applicate il monitoraggio statistico alle metriche che variano naturalmente, poi calibrate la sensibilità sulla base dello storico degli incidenti anziché scegliere un limite arbitrario.
Il rilevamento con l'AI si guadagna il suo posto quando l'ambiente offre abbastanza contesto comportamentale da cui apprendere. Deve far emergere candidati da indagare, non bloccare automaticamente ogni pipeline. La revisione umana resta necessaria quando l'anomalia ha un impatto di business rilevante, la baseline sta cambiando o il sistema non è in grado di spiegare quale consumatore sarà coinvolto.
Il giusto approccio di rilevamento delle anomalie per i dati in serie temporale dipende dal comportamento del segnale e dall'azione associata a un alert. Un avviso rumoroso senza un responsabile non è osservabilità. È solo un'altra coda che gli ingegneri finiranno per ignorare.
Osservabilità, controlli in-database e validazione che lavorano insieme
Considerate una pipeline che acquisisce eventi da Kafka, li trasforma con dbt e serve tabelle curate da Snowflake. L'affidabilità migliora quando il team tratta osservabilità, controlli in-database e validazione di business come un unico livello di controllo distribuito lungo questa sequenza temporale.
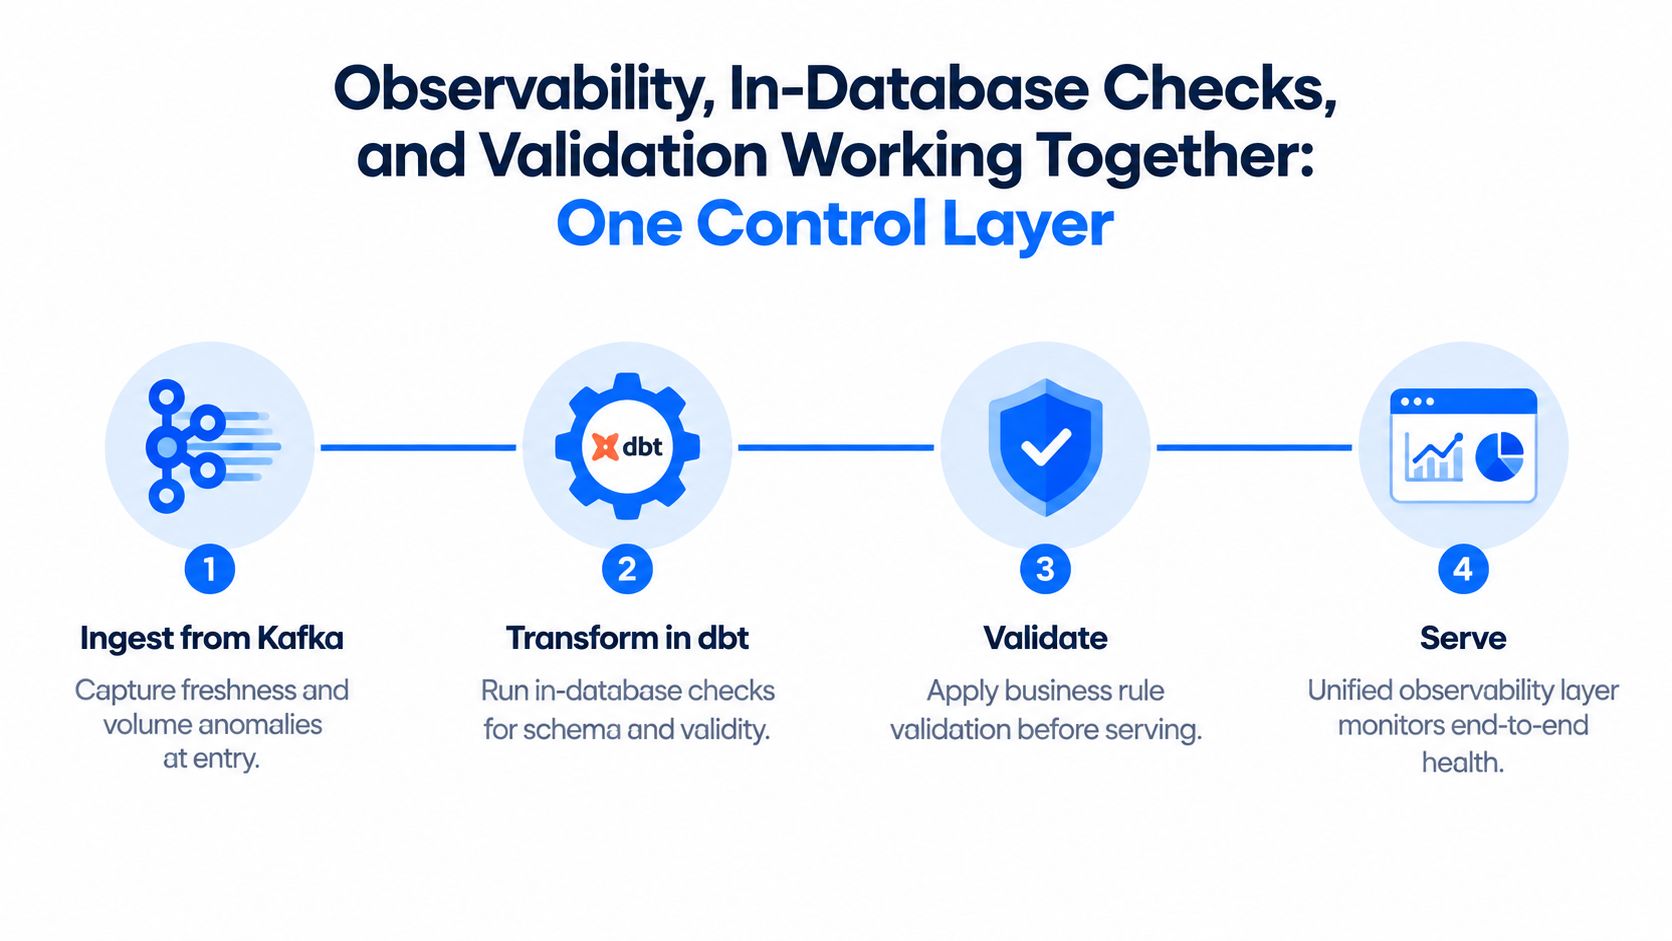
In fase di ingestione, controlli leggeri confrontano tempistiche di arrivo e volumi con il pattern atteso. I vincoli nativi del warehouse e le query pianificate possono intercettare campi mancanti, tipi inattesi o conteggi anomali vicino al punto in cui i dati sono archiviati. Questi controlli non spiegheranno ogni sintomo a valle, ma possono impedire che un problema strutturale evidente si propaghi.
Durante la trasformazione, i test dbt fanno rispettare i contratti sulle colonne e le ipotesi di business. Nel frattempo, un livello di osservabilità controlla durata delle esecuzioni, numero di righe, stato delle partizioni, lineage e comportamento delle dipendenze. Se un modello termina con successo ma produce una relazione inaspettatamente piccola, la telemetria della pipeline aggiunge un contesto che una semplice asserzione sulla colonna non può fornire.
Dopo la distribuzione, il team confronta il consumo a valle con le aspettative a monte. Una dashboard può eseguire correttamente la query pur ricevendo una partizione obsoleta, quindi la cronologia dell'incidente deve collegare l'arrivo in ritardo da Kafka, l'esecuzione dbt, lo stato della tabella in Snowflake e la dashboard coinvolta.
I controlli in-database vedono le violazioni dove risiedono i dati. La validazione vede se i dati rispettano il significato di business. L'osservabilità vede come si è comportato il sistema circostante.
Il punto di integrazione è un insieme condiviso di indicatori di livello di servizio e un registro comune degli incidenti. Ogni alert dovrebbe identificare l'asset, il produttore, il consumatore, la condizione violata, il momento della prima osservazione e la lineage nota. Le indicazioni su regole di validazione dei dati e qualità continua dei dati aiutano i team a definire il livello delle regole, ma il valore operativo emerge quando questo livello condivide il contesto con il monitoraggio delle pipeline.
Senza un contesto condiviso, i team si scambiano screenshot tra strumenti diversi e discutono se il guasto sia da attribuire a Kafka, dbt, Snowflake o alla dashboard. Con un'unica cronologia possono separare la causa scatenante dal sintomo e assegnare la correzione al team che controlla il contratto pertinente.
Salvaguardie operative che impediscono ai programmi di affidabilità di arenarsi
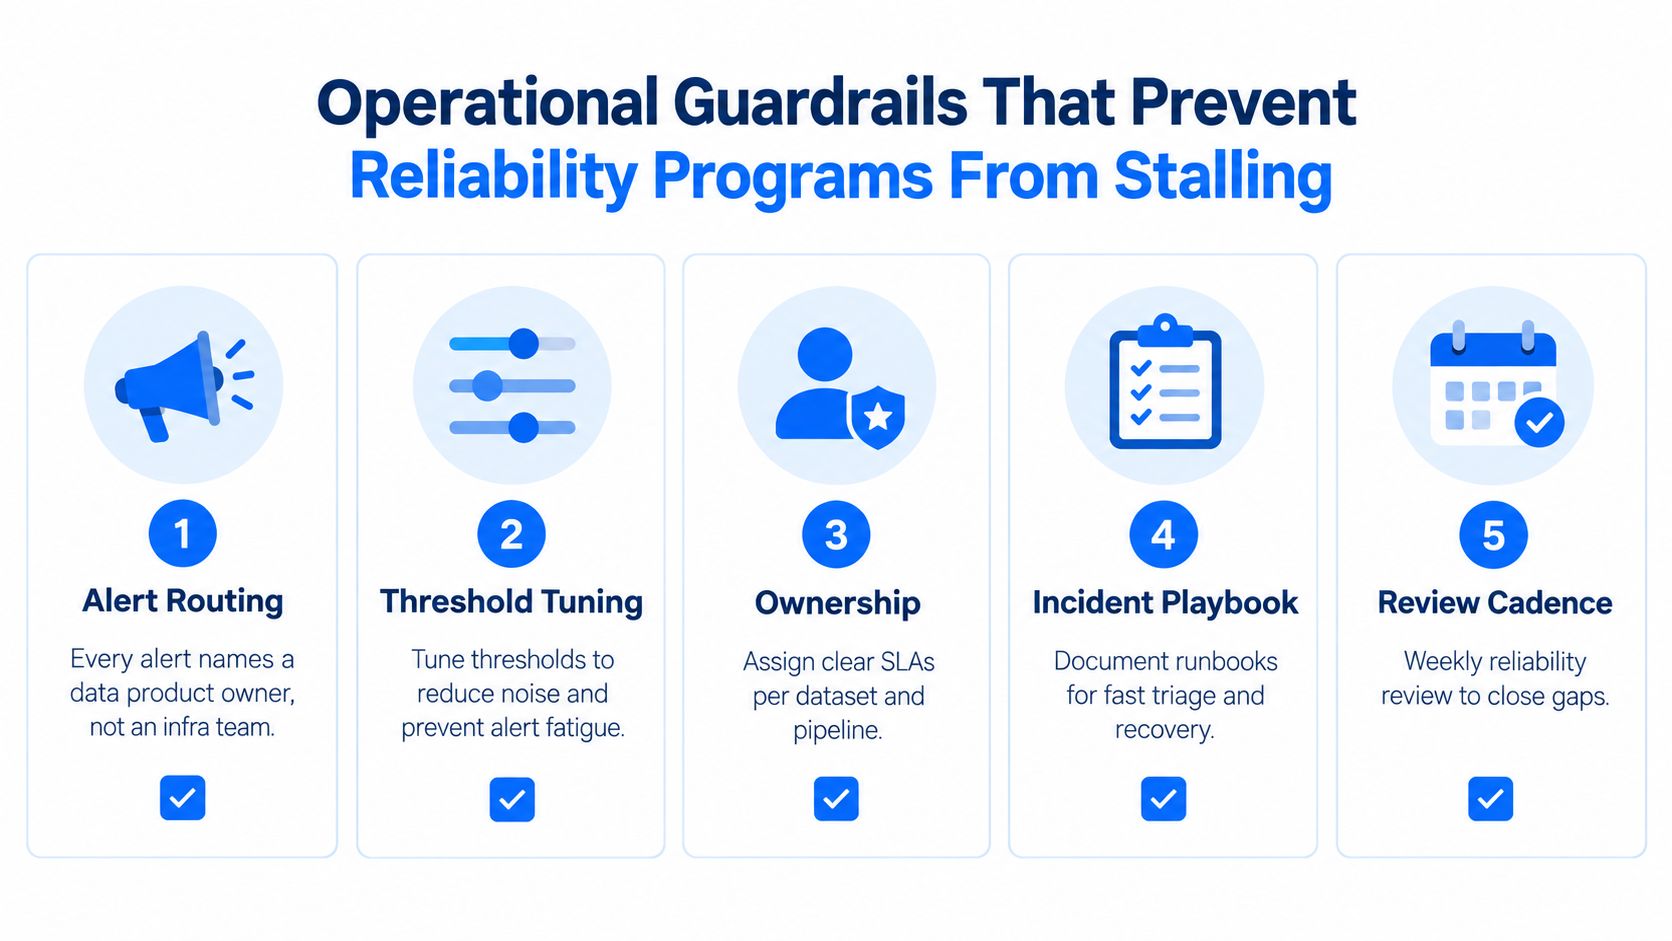
I programmi di affidabilità di solito si arenano per motivi organizzativi prima ancora di fallire sul piano tecnico. Gli alert finiscono in una coda dell'infrastruttura, i responsabili dei dataset non sono designati e ogni team definisce “sano” in modo diverso. Le salvaguardie rendono esplicito il modello operativo.
Indirizzate gli alert al data product
Un alert deve indicare il data product coinvolto, il suo responsabile e il suo consumatore a valle. I team di infrastruttura possono essere responsabili delle capacità condivise di esecuzione e monitoraggio, mentre i team di analytics o di dominio sono responsabili dei dataset di cui controllano il significato. Una responsabilità condivisa senza un referente principale di solito significa che nessuno interviene rapidamente.
Separate i livelli di servizio
Non riducete ogni condizione a un unico punteggio o a un unico “SLA sulla qualità dei dati”. Definite aspettative separate per:
Aggiornamento: il ritardo di ingestione consentito, con una finestra di avviso prima della violazione vera e propria.
Correttezza: la quota richiesta di record che superano le regole di validazione critiche.
Disponibilità: il completamento atteso delle esecuzioni pianificate delle pipeline.
Impatto: i consumatori e i processi di business coinvolti quando si verifica una violazione.
Questa separazione aiuta i team a scegliere la risposta giusta. Una tabella in ritardo ma per il resto corretta può richiedere un backfill, mentre una tabella apparentemente valida ma con l'integrità referenziale compromessa può richiedere la quarantena.
Mantenete i controlli nel percorso di consegna
I controlli nativi del warehouse, i test dbt, i gate sulle modifiche dello schema e i test di contratto impediscono che l'affidabilità diventi una fase separata di QA manuale. Il workflow di monitoraggio documentato di AWS SageMaker separa acquisizione dei dati, creazione della baseline e job di monitoraggio pianificati, e la sua baseline usa Deequ per calcolare vincoli di schema e statistiche. La documentazione AWS sul monitoraggio della qualità dei dati dei modelli offre un esempio concreto di come trasformare le aspettative in controlli di produzione pianificati.
Fate attenzione a tre anti-pattern:
Dashboard senza responsabile: una pagina di stato visiva senza un referente crea consapevolezza ma non azione.
Erosione delle soglie: i team allargano gradualmente le soglie finché gli alert smettono di scattare, invece di correggere la baseline o la fonte.
Affidabilità di facciata: le caselle spuntate soddisfano un audit mentre dati in ritardo, lineage interrotta e modifiche dello schema non revisionate continuano a colpire i consumatori.
Rivedete la qualità degli alert dopo ogni incidente. Se un alert non ha portato a una decisione, modificatene l'instradamento, il contesto, la soglia o l'azione associata. L'obiettivo non è la massima copertura del monitoraggio, ma un rilevamento affidabile collegato al ripristino.
Che cosa richiede davvero l'affidabilità dei dati per l'AI
La preparazione all'AI non inizia quando un modello viene messo in produzione. Inizia con l'evidenza che input, feature, contesto di retrieval e output restano affidabili nelle condizioni di produzione.
Report recenti inquadrano chiaramente il divario. Il 71% dei professionisti dei dati indica tra le principali preoccupazioni output errati o allucinati che raggiungono gli stakeholder, mentre PwC ha rilevato che solo il 51% degli intervistati costruisce una base di dati pulita e strutturata prima di scalare le iniziative digitali, come sintetizzato in questo report su accelerazione dell'AI e fiducia. Queste cifre indicano un problema operativo, non soltanto un problema di valutazione dei modelli.
Seguite l'intera catena degli input dell'AI
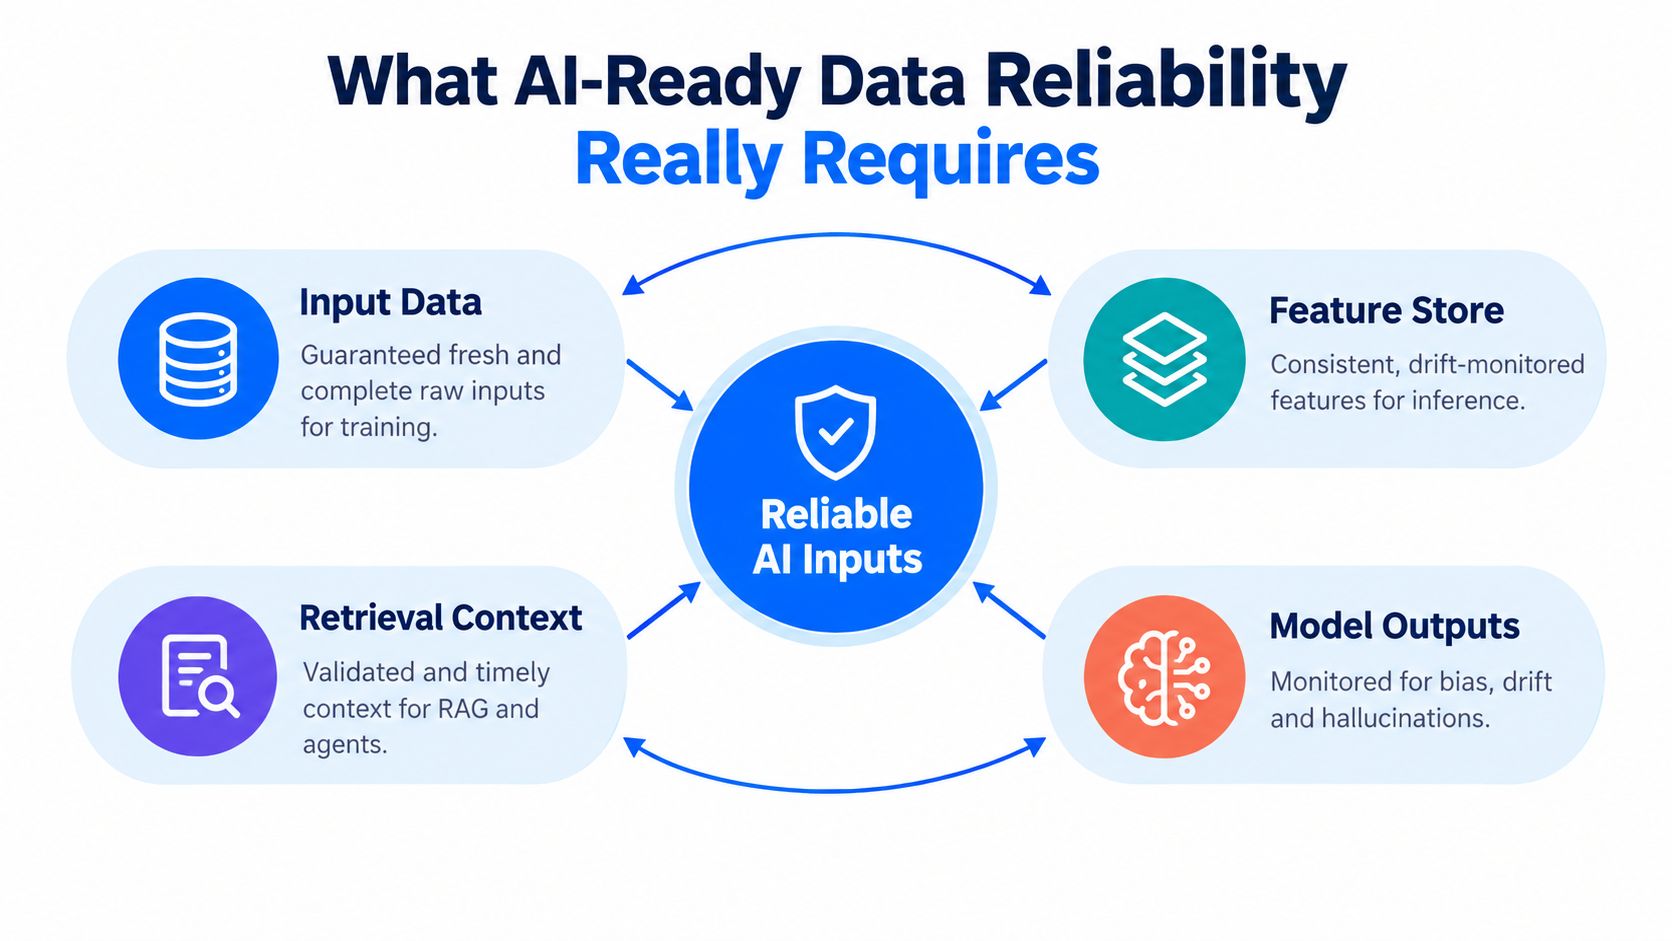
Gli input grezzi hanno bisogno di garanzie di aggiornamento e completezza. I feature store hanno bisogno di definizioni coerenti e di un monitoraggio delle derive allineato alle finestre di inferenza. I sistemi retrieval-augmented e gli agenti hanno bisogno di un contesto validato e tempestivo, comprese le evidenze che i documenti non siano stati eliminati, modificati o prelevati da una posizione non monitorata.
La lineage deve ricollegare feature e contenuti di retrieval alle loro fonti e trasformazioni. Senza questa tracciabilità, una regressione della qualità del modello può trasformarsi in un'indagine senza fine. Gli ingegneri devono sapere se la modifica proviene dai dati sorgente, dalla logica delle feature, dall'indicizzazione, dal retrieval o dal modello stesso.
Gli output del modello hanno bisogno di un proprio ciclo di feedback. Monitorate bias, derive e segnali di allucinazione dove possono essere valutati, poi collegate i problemi alle condizioni dei dati a monte. I gate di promozione dovrebbero bloccare o sospendere un rilascio quando gli SLA sugli input critici non vengono rispettati, anziché lasciare che un modello consumi feature notoriamente obsolete.
Il framework dell'ETSI riflette questa visione più ampia definendo 18 metriche misurabili di qualità dei dati, tra cui affidabilità, copertura, lineage, tracciabilità e tempestività, secondo il report citato. La preparazione all'AI deriva quindi dal programma di affidabilità che già protegge analytics e operations. Non è un esercizio di compliance separato né una casella finale sull'accuratezza da spuntare. Il principio alla base del rapporto tra modelli di AI e qualità dei dati è operativo: input inaffidabili producono comportamenti inaffidabili a valle, anche quando il modello in sé non è cambiato.
Mettere tutto insieme e i prossimi passi
Un primo sprint sull'affidabilità dovrebbe essere abbastanza circoscritto da poter essere completato e abbastanza importante da fare la differenza. Scegliete un dataset critico per i ricavi, mappatene le dipendenze a monte e a valle e definite le condizioni che lo rendono sicuro per il suo consumatore principale.
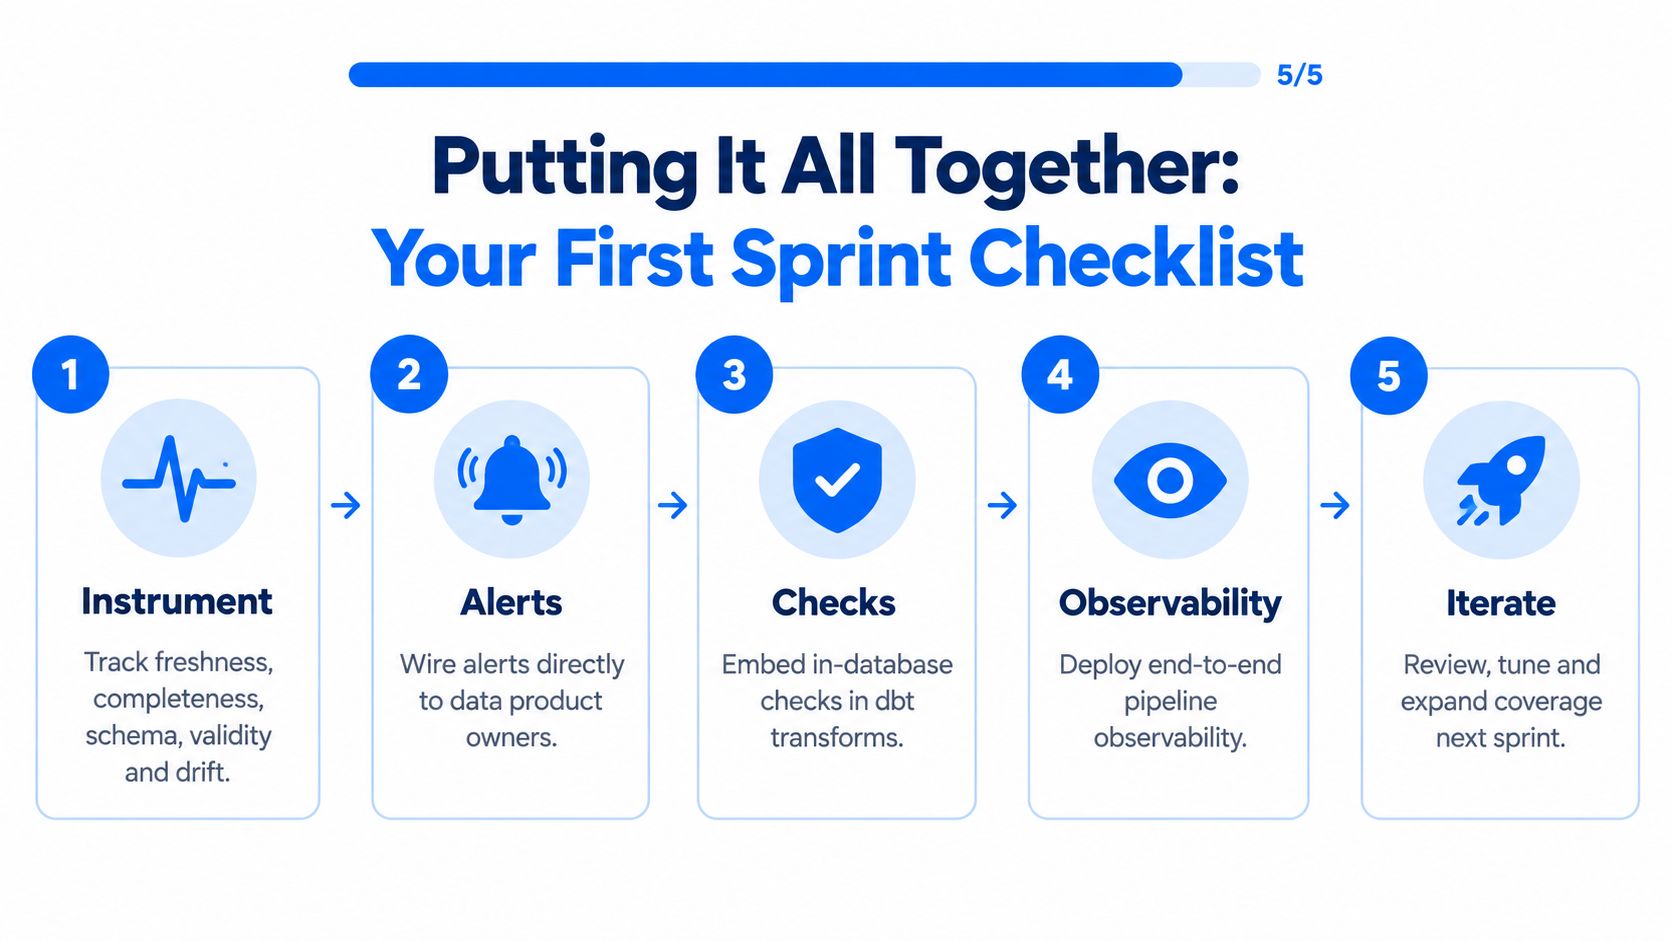
Seguite questa sequenza:
Strumentate la catena: tracciate aggiornamento, completezza, stabilità dello schema, validità e deriva della distribuzione.
Assegnate la risposta: indirizzate ogni alert a un responsabile del data product designato e identificate il consumatore coinvolto.
Formalizzate il contratto: documentate le aspettative di aggiornamento, correttezza e disponibilità per l'asset.
Posizionate i controlli in modo mirato: usate regole deterministiche per le garanzie rigide, controlli statistici per le derive e rilevamento appreso per le anomalie correlate.
Estendete la protezione agli input dell'AI: applicate gli stessi controlli ai dati delle feature, al contesto di retrieval e ai dataset destinati ai modelli.
Il mercato si sta orientando verso garanzie quantificate anziché un vago linguaggio sulla fiducia. La sfida operativa è rendere queste misurazioni utilizzabili da team, pipeline, warehouse e metriche di business. Scorecard di affidabilità condivise e SLO trasversali ai team sono più utili delle dashboard dei singoli strumenti, perché collegano la salute tecnica alle decisioni che ne dipendono.
I team devono ancora fare i conti con il collo di bottiglia dei test manuali. I sondaggi riportano che il 61% si affida a controlli manuali o a validazioni basate su SQL, mentre solo il 27% usa una piattaforma di osservabilità dedicata e il 14% applica gli SLA a livello di intera organizzazione, secondo il report 2025 di Integrate.io sui trend di qualità e osservabilità dei dati. La risposta pratica non è testare tutto a mano. È automatizzare le evidenze al momento della consegna, assegnare un responsabile a ogni controllo e trattare una violazione su un asset critico come un incidente di produzione.
Scegliete quel dataset questa settimana. Definite tre metriche di affidabilità, assegnate un responsabile e analizzate la prima violazione come un incidente, con una cronologia e un piano di correzione, non come un normale ticket sui dati.
digna offre una piattaforma enterprise per la qualità e l'osservabilità dei dati che gira all'interno del vostro ambiente, combinando validazione in-database, monitoraggio della tempestività, tracciamento dello schema e rilevamento delle anomalie su warehouse, lake e pipeline. Per collegare questi controlli in un programma di affidabilità concreto per analytics e AI, visitate digna e scoprite la piattaforma.
Per gli stessi controlli organizzati in base al guasto che ciascuno previene, anziché in base alla metrica che lo misura, consultate gli otto casi d'uso della data observability con il responsabile e il percorso di risposta associati a ciascuno.
Domande frequenti
Qual è la differenza tra qualità dei dati e affidabilità dei dati?
La qualità si chiede se ogni record sia conforme: valido, non NULL, del tipo corretto, entro l'intervallo previsto. L'affidabilità si chiede se i consumatori possano contare sul dataset nel tempo, compreso il fatto che le partizioni attese siano arrivate entro la finestra di servizio con una lineage nota. Il mattone può essere solido mentre al muro mancano dei corsi.
Quali metriche misurano davvero l'affidabilità dei dati?
Cinque metriche coprono le principali modalità di guasto: aggiornamento, completezza, stabilità dello schema, validità e deriva della distribuzione. Nessuna dovrebbe essere un valore universale di superato/non superato. Ogni soglia appartiene a un contratto che riflette la tolleranza del consumatore, e la completezza in particolare va verificata per partizione anziché per riga.
Quando conviene usare il rilevamento delle anomalie anziché i controlli basati su regole?
Le regole sono adatte alle condizioni che non devono mai essere violate, come una chiave non NULL o un riferimento valido. I controlli statistici gestiscono i segnali che variano naturalmente, tra cui volume, cardinalità, proporzione di NULL e tempistiche di arrivo. Il rilevamento con l'AI si guadagna il suo posto sugli spostamenti correlati di più segnali che nessun autore di regole aveva previsto.
Perché i programmi di affidabilità dei dati si arenano?
Di solito per motivi organizzativi prima ancora che tecnici. Gli alert finiscono in una coda dell'infrastruttura senza un referente designato, ogni team definisce “sano” in modo diverso e le soglie si allargano finché non scatta più nulla. Fate attenzione alle dashboard senza responsabile, all'erosione delle soglie e alle caselle spuntate che soddisfano un audit mentre i consumatori continuano a ricevere dati in ritardo.
Che cosa richiede l'affidabilità dei dati per l'AI?
Evidenze lungo l'intera catena degli input anziché un controllo finale sull'accuratezza. Gli input grezzi hanno bisogno di garanzie di aggiornamento e completezza, i feature store di un monitoraggio delle derive allineato alle finestre di inferenza, e la lineage deve ricollegare le feature alle loro fonti, così che una regressione del modello non diventi un'indagine senza fine.


