Simulation de Monte-Carlo : un guide pratique pour les équipes de données
|
8
minute de lecture

À 2 heures du matin, un tableau de bord des revenus mensuels fait un bond brutal. L'ingénieur de données d'astreinte est alerté, vérifie le dernier lancement du pipeline et ne trouve aucune erreur évidente. Ce chiffre pourrait représenter un véritable changement d'activité, un chargement partiel en amont ou un changement de schéma silencieux qui a altéré la métrique. La réponse dépend de l'instinct car l'équipe n'a pas de vision quantifiée de la probabilité de chaque explication.
La simulation de Monte Carlo remplace cette conjecture unique par une distribution de résultats plausibles. En échantillonnant de manière répétée des entrées incertaines, une équipe peut estimer la probabilité qu'un pipeline échoue, qu'un KPI dérive ou qu'un SLA de Timeliness soit enfreint. La méthode a des racines profondes dans les probabilités et l'informatique, mais sa valeur pratique pour les équipes de données est directe : elle transforme l'incertitude en un signal opérationnel.
Table des matières
Le moment où vous regrettez de ne pas avoir lancé de Monte Carlo
Monte Carlo pour les pipelines, les KPI et les SLA de Timeliness
Passer à l'échelle Monte Carlo au sein de la base de données
Transformer les résultats de simulation en surveillance opérationnelle
Le moment où vous regrettez de ne pas avoir lancé de Monte Carlo
L'ingénieur compare le pic de revenus avec le tableau de bord d'hier, vérifie le nombre de lignes, examine les notes de déploiement récentes et demande au propriétaire amont si quelque chose a changé. Ces vérifications sont utiles, mais elles répondent uniquement à la question de savoir si l'équipe a trouvé des preuves d'un problème. Elles ne répondent pas à la question la plus importante : quelle est la probabilité que le revenu déclaré soit erroné ?
Un contrôle déterministe peut indiquer que la table est arrivée à temps et contient les colonnes attendues. Un modèle de Monte Carlo peut aller plus loin en représentant l'incertitude dans la livraison amont, le comportement des valeurs nulles, l'arrivée des événements et les résultats des transformations. Chaque exécution simulée devient une version plausible du traitement de la nuit, et le résultat obtenu montre à quelle fréquence la métrique de revenus se situe à l'intérieur ou à l'extérieur d'une plage acceptable.
Règle pratique : Traitez une valeur de tableau de bord comme une observation entachée d'incertitude, et non comme une vérité absolue.
Cette distinction change la réponse à l'incident. Si la plupart des résultats simulés corroborent la hausse observée et que les entrées du pipeline semblent normales, l'ingénieur peut enquêter sur un véritable événement commercial avec une plus grande confiance. Si de nombreuses exécutions plausibles produisent une valeur matériellement différente dans les mêmes conditions amont, l'équipe dispose d'éléments probants pour prioriser la Data Validation avant que les dirigeants n'agissent sur la base du tableau de bord.
De l'intuition à la probabilité
La méthode n'est pas réservée à l'analyse de crise. Une simulation nocturne peut estimer la probabilité qu'un pipeline à plusieurs étapes se termine avant son objectif de livraison. Un modèle de surveillance de l'activité peut estimer si l'évolution d'un KPI est cohérente avec des valeurs nulles partielles et des enregistrements arrivant tardivement. Un modèle de ponctualité peut estimer à quelle fréquence un ralentissement en aval pousse les données au-delà de leur engagement de service.
Le changement de perspective est minime mais important. Au lieu de vous demander « Ce pipeline va-t-il échouer ? », demandez-vous « Sur l'ensemble des versions plausibles de cette nuit, à quelle fréquence échoue-t-il et quelles hypothèses conduisent à ce résultat ? » Cette question fournit aux ingénieurs de données une base mesurable pour les alertes, l'escalade et la priorisation.
La simulation de Monte Carlo a été formalisée pendant le projet Manhattan dans les années 1940, lorsque Stanislaw Ulam et John von Neumann ont appliqué des essais aléatoires répétés à des problèmes tels que la diffusion des neutrons, qui étaient impraticables à résoudre directement. Le nom a été adopté en 1949 par Nicolas Metropolis, associant la méthode au hasard et au casino de Monaco, comme décrit dans ce récit historique des méthodes de Monte Carlo.
Qu'est-ce que la simulation de Monte Carlo
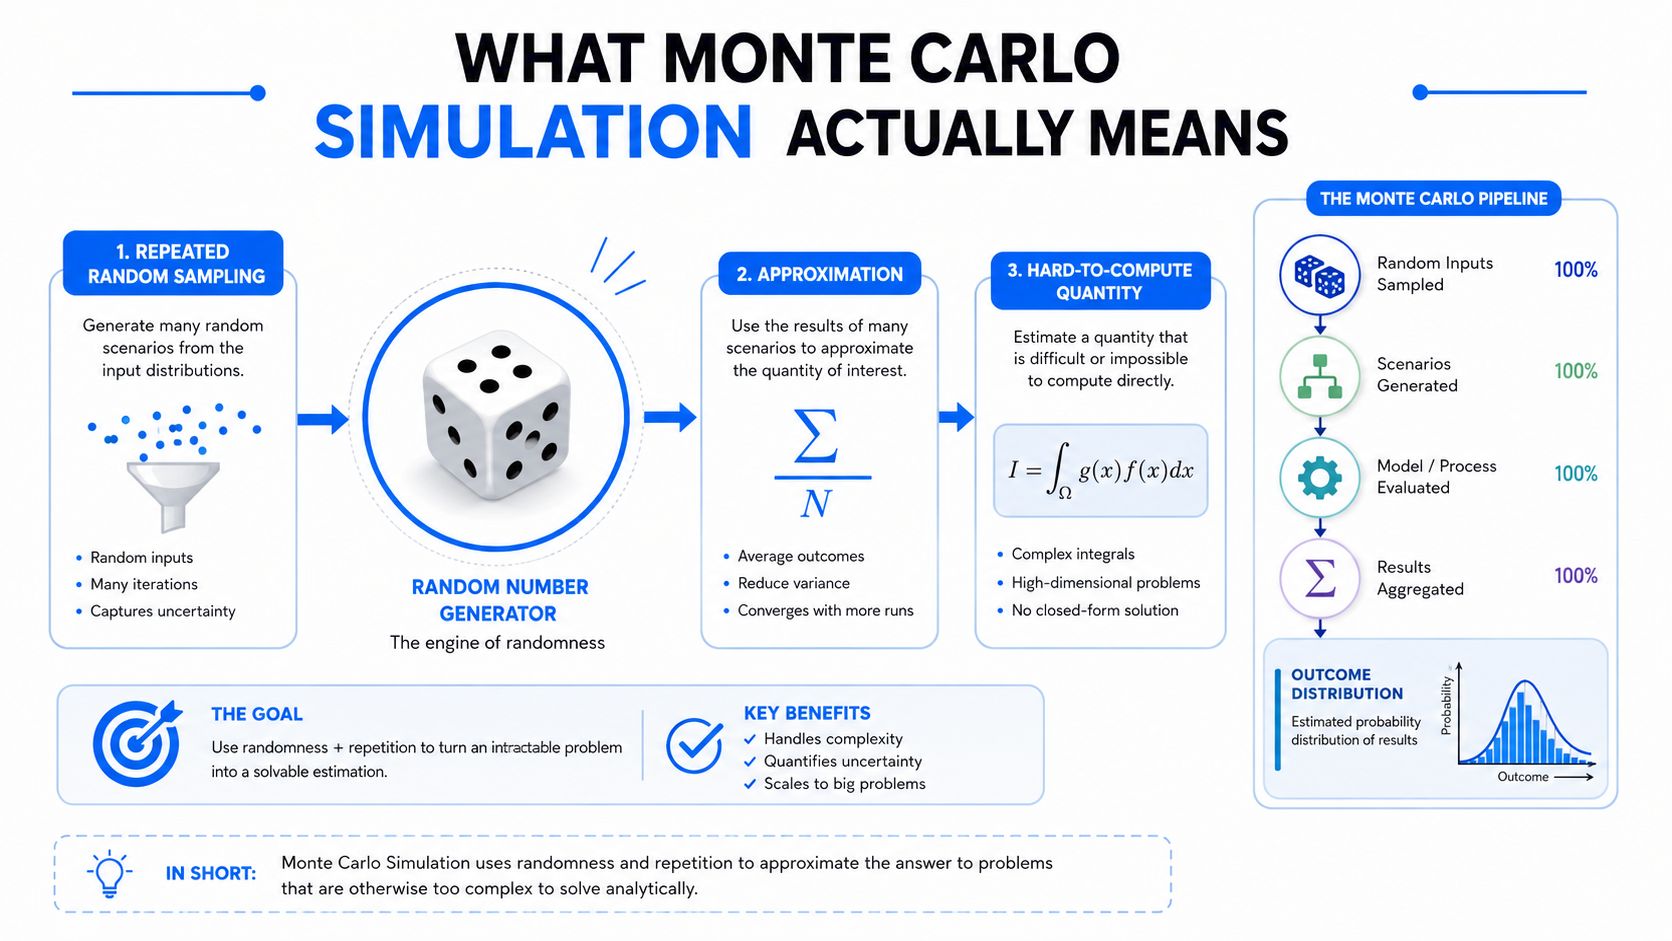
La simulation de Monte Carlo est un échantillonnage aléatoire répété utilisé pour approximer une quantité difficile à calculer de manière analytique. L'algorithme échantillonne des états plausibles, évalue le modèle pour chacun d'eux et synthétise les résultats.
Considérez un pipeline comprenant cinq étapes en amont. Chaque étape peut échouer, prendre du retard ou fournir des données incomplètes. Le calcul mental peut suggérer le risque d'une seule étape, mais les dépendances et l'évolution des conditions rendent le résultat combiné difficile à calculer directement. La simulation représente l'incertitude de chaque étape, crée une version plausible d'une exécution de pipeline, enregistre si elle a atteint son objectif et répète ce processus à travers de nombreuses exécutions simulées.
Trois blocs de construction définissent le modèle mental :
Un modèle de système : Les étapes, les dépendances, les transformations et les critères de réussite.
Des entrées incertaines : Le comportement en cas de défaillance, le temps de traitement, les taux de valeurs nulles, les retards d'événements ou d'autres variables représentées par des distributions de probabilité.
Un agrégateur de résultats : Une fonction qui enregistre le résultat de chaque exécution, tel que le statut d'achèvement, la valeur du KPI ou le non-respect du SLA.
Le résultat est une distribution de réponses, et non une valeur unique prétendument parfaite. Les analystes peuvent examiner la probabilité de défaillance, la plage des valeurs plausibles du KPI ou le percentile du délai de livraison attendu. Cela est important en Observability car la santé d'un pipeline s'inscrit rarement dans une limite binaire nette. Une table peut arriver à temps tout en contenant des valeurs anormales, ou passer la validation tout en augmentant le risque en aval.
Pourquoi l'échantillonnage répété fonctionne
L'intuition influente de Stanislaw Ulam a été de remplacer le calcul exhaustif par de nombreux essais aléatoires. Le récit de Britannica utilise le solitaire comme analogie : des parties répétées permettent d'estimer les chances de gagner sans calculer chaque séquence possible. La même approche s'applique à l'intégration numérique, à l'optimisation, aux statistiques bayésiennes et aux simulations de systèmes physiques, biologiques et sociaux, comme le résument ces notes de cours sur Monte Carlo.
Pour un ingénieur de données, la métaphore du casino est moins utile que la séparation entre la structure du modèle et les entrées échantillonnées. La logique du pipeline reste fixe tandis que les valeurs incertaines changent d'une exécution à l'autre. La distribution qui en résulte expose le risque masqué par une prévision ponctuelle et offre à une plateforme d'Observability telle que digna un moyen de connecter les défaillances simulées, la dérive des KPI et le risque de Timeliness avec la surveillance opérationnelle.
Fonctionnement de la méthode étape par étape
Commencez par définir précisément le résultat du pipeline. Par exemple, une exécution est réussie lorsque chaque étape requise se termine avant l'objectif de livraison et produit des données qui passent les contrôles de qualité pertinents. Un manquement se produit lorsqu'une condition requise n'est pas remplie.
L'algorithme suit ensuite cinq étapes pratiques :
Modéliser les étapes. Listez chaque dépendance amont et la manière dont son état affecte le résultat final.
Attribuer des distributions. Représentez le comportement incertain des défaillances et le temps de traitement à l'aide de distributions basées sur l'historique disponible ou sur le jugement d'experts.
Tirer un échantillon par étape. Chaque exécution crée une version plausible de la nuit.
Agrégations du résultat. Enregistrez si le pipeline s'est terminé, a enfreint son SLA ou a produit un KPI inacceptable.
Répéter et inspecter la stabilité. Continuez l'échantillonnage jusqu'à ce que les estimations des principaux résultats deviennent suffisamment stables pour la prise de décision.
L'exemple suivant utilise NumPy pour l'échantillonnage aléatoire et pandas pour la synthèse. Il simule mille nuits de pipeline, puis calcule la part observée des exécutions ayant enfreint le SLA.
Les probabilités de cet extrait sont des espaces réservés pour les entrées du modèle, et non des faits de production. Une implémentation digne de confiance les estimerait à partir de l'historique observé du pipeline, examinerait les dépendances entre les étapes et inclurait le comportement du temps de traitement plutôt que de traiter chaque défaillance comme identique.
Étape | Objectif | Structure du code |
|---|---|---|
Modéliser les étapes | Représenter le système testé |
|
Échantillonner l'incertitude | Générer des états d'étape plausibles |
|
Agrégations du résultat | Décider si le pipeline a échoué |
|
Répéter les exécutions | Construire une distribution de sortie |
|
Résumer le risque | Convertir les résultats en une estimation de probabilité |
|
Pour une vue complémentaire de la manière dont les signaux statistiques peuvent appuyer la surveillance des données, voir la reconnaissance de formes statistiques. Le défi suivant consiste à rendre un script opérationnel suffisamment fiable pour les décisions opérationnelles. Cela nécessite un échantillonnage délibéré, des vérifications de convergence et une réduction de la variance.
Échantillonnage, convergence et réduction de la variance
L'échantillonnage aléatoire simple est l'option par défaut car il est facile à mettre en œuvre et largement applicable. Son erreur diminue avec la racine carrée du nombre d'échantillons, de sorte que les exécutions supplémentaires améliorent la précision de manière progressive plutôt que d'éliminer magiquement l'incertitude. Ce comportement découle de la loi des grands nombres, dont les formes forte et faible sous-tendent la convergence de Monte Carlo, comme l'explique cette référence sur la convergence de Monte Carlo.
Cette relation est importante lorsqu'une équipe interprète une probabilité de violation. Une légère variation entre deux exécutions peut refléter un bruit d'échantillonnage plutôt qu'un changement significatif dans le pipeline sous-jacent. Suivez la moyenne mobile, inspectez l'erreur type de Monte Carlo et comparez les estimations entre différents nœuds de calcul ou chaînes indépendants. Un test R-hat de Gelman-Rubin peut aider à identifier si des chaînes parallèles se sont mélangées, bien qu'il ne corrige pas un modèle mal spécifié.
Choisir la bonne stratégie d'échantillonnage
L'échantillonnage stratifié divise le domaine d'entrée en strates disjointes et échantillonne au sein de chacune d'elles. En éliminant la composante de variance entre les strates, il peut réduire considérablement la variance, en particulier lorsqu'un pipeline présente des régimes de fonctionnement distincts tels que les jours de semaine, les charges de fin de mois ou des fenêtres de Release connues. Le mécanisme sous-jacent est décrit dans cette référence technique sur l'échantillonnage stratifié.
L'échantillonnage préférentiel adopte une approche différente. Il effectue davantage de tirages dans les régions où la fonction cible est plus grande, ce qui peut accélérer la convergence lorsque l'événement d'intérêt est rare ou fortement concentré, comme décrit dans ce guide d'amélioration de l'intégration de Monte Carlo.
Technique | Fonctionnement | Idéal pour la Data Observability | Points de vigilance |
|---|---|---|---|
Échantillonnage aléatoire simple | Tirages indépendants à partir des distributions définies | Modèles généraux de pipelines et de KPI | Gains de précision lents pour les violations rares |
Échantillonnage stratifié | Échantillons au sein de régions d'entrée distinctes | Différentes fenêtres de charge ou régimes de pipeline | Des strates mal définies peuvent ajouter de la complexité sans couverture utile |
Échantillonnage préférentiel | Concentre les tirages sur les régions à fort impact | Défaillances rares et événements extrêmes de SLA | Une pondération incorrecte peut biaiser l'estimateur |
Variables antitthétiques | Associe des tirages aléatoires complémentaires | Estimations de KPI avec un comportement de réponse fluide | Moins utile lorsque le modèle est discontinu |
Variables de contrôle | Utilise une valeur de référence connue et corrélée | Métriques avec une base opérationnelle stable | Nécessite une relation de contrôle fiable |
La famille plus large de réduction de la variance comprend également les nombres aléatoires communs, le conditionnement, les variables antithétiques, les variables de contrôle, l'échantillonnage stratifié et l'échantillonnage préférentiel, comme documenté dans cette présentation des méthodes de réduction de la variance de Monte Carlo. Pour des conseils de mise en œuvre concernant l'analyse statistique dans les flux d'observabilité, voir les méthodes statistiques pour l'analyse des données.
Monte Carlo pour les pipelines, les KPI et les SLA de Timeliness
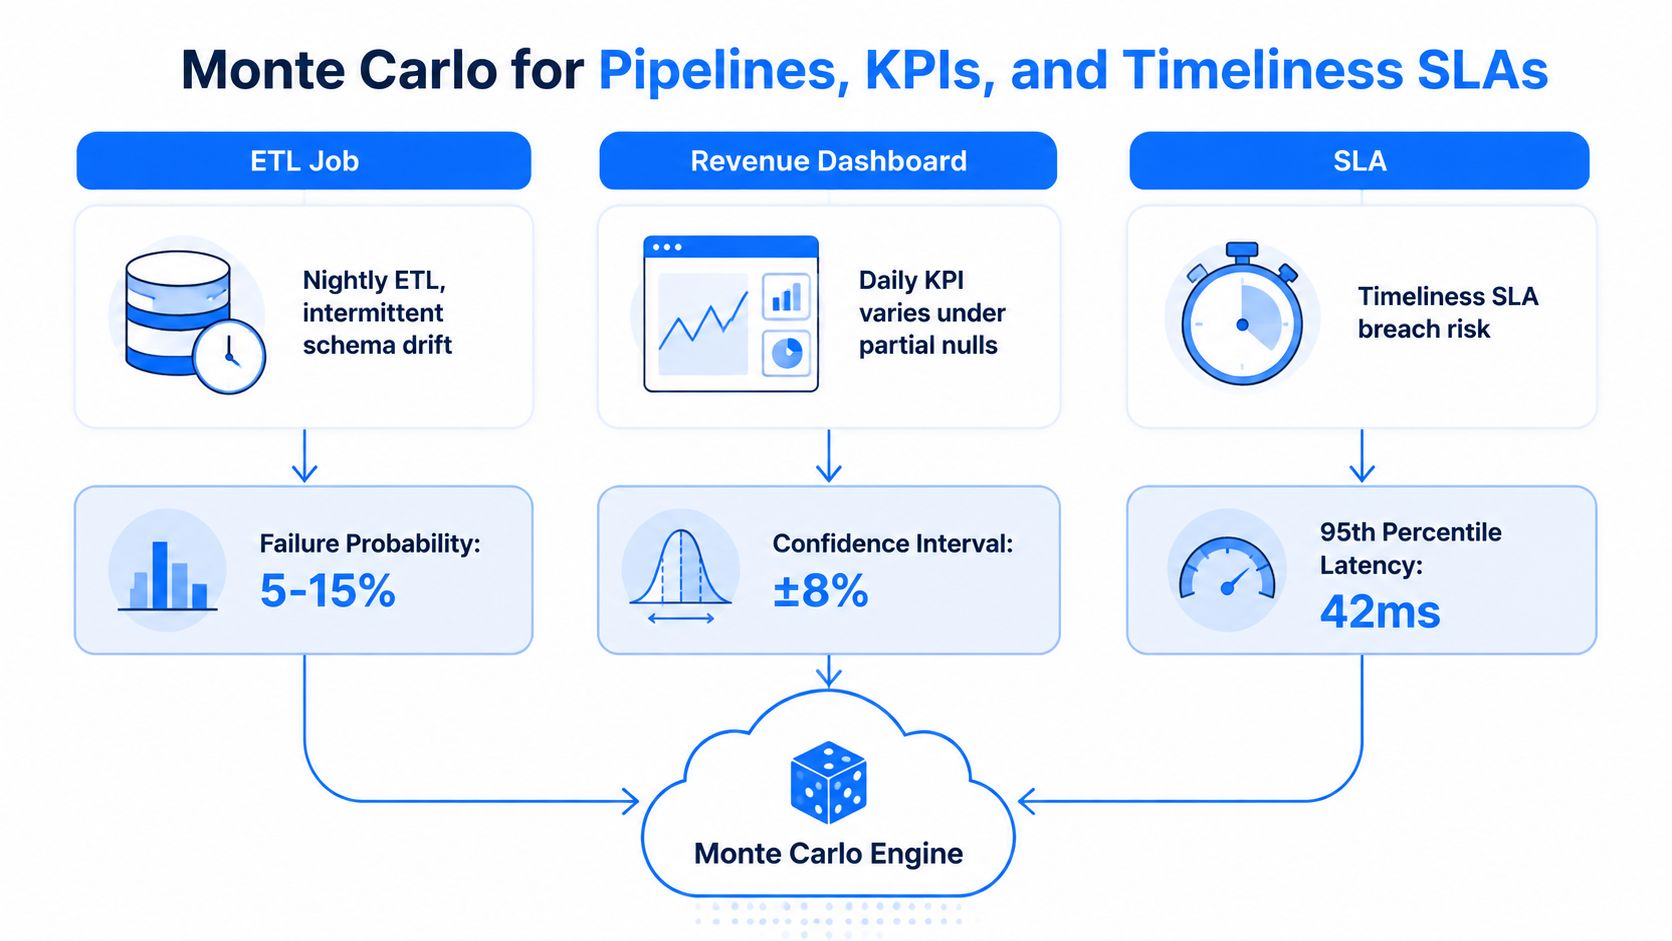
Un ETL nocturne peut réussir la plupart du temps tandis qu'une dérive de schéma intermittente brise occasionnellement une transformation en aval. Un tableau de bord des revenus peut afficher un mouvement brusque parce que certains enregistrements sont arrivés en retard ou qu'un sous-ensemble de valeurs est devenu nul. Un SLA de fraîcheur peut rester techniquement conforme tandis que la latence de traitement se rapproche régulièrement de sa limite.
Ce sont des problèmes opérationnels différents, mais ils partagent la même forme. Les entrées sont incertaines, le modèle relie ces entrées à un résultat, et le résultat utile est une distribution de probabilité plutôt qu'un statut binaire.
Trois histoires d'observabilité
Dans le cas de l'ETL, le modèle échantillonne la disponibilité des étapes, la compatibilité des schémas et la durée du traitement. Chaque exécution permet de savoir si l'ensemble du flux de travail se termine avant le point de livraison prévu. Le résultat de la surveillance peut devenir un score de risque de défaillance, avec un lignage associé aux tables et transformations amont qui contribuent le plus au risque simulé.
Pour le tableau de bord des revenus, le modèle échantillonne le comportement partiel des valeurs nulles, les événements tardifs et l'effet de ces conditions sur le calcul du KPI. Au lieu de déclarer chaque mouvement comme anormal, l'équipe peut comparer la valeur observée avec une bande simulée et enquêter lorsque l'observation sort de la distribution attendue.
La surveillance de la ponctualité suit le même schéma. Le modèle échantillonne le comportement d'arrivée et de traitement, puis évalue si le délai de livraison qui en résulte franchit le seuil du SLA. Une probabilité de violation peut déclencher une alerte avant que la livraison réelle ne manque son objectif, à condition que les entrées et les dépendances soient calibrées par rapport à l'historique opérationnel.
Des distributions aux alertes
Une plateforme d'Observability peut utiliser le résultat de la simulation de plusieurs manières :
Risque de défaillance : Alerter lorsque la probabilité de défaillance d'un pipeline franchit un seuil défini par l'équipe.
Incertitude des KPI : Afficher la métrique observée à côté de sa plage simulée, puis orienter l'enquête lorsque la valeur s'écarte de cette plage.
Risque de SLA : Escalader lorsque la probabilité de violation prédite augmente, même si la charge actuelle n'a pas encore échoué.
Contexte de lignage : Associer le résultat aux ensembles de données et aux transformations amont qui influencent le résultat simulé.
L'alerte ne doit pas seulement indiquer qu'un chiffre est inhabituel. Elle doit expliquer si ce résultat inhabituel est cohérent avec le comportement connu des entrées, quelles hypothèses génèrent le risque et quels actifs en aval peuvent être affectés. Les équipes qui mettent en place des contrôles de ponctualité peuvent utiliser ce guide des métriques de fraîcheur des données pour aligner les résultats de simulation avec les définitions existantes de la fraîcheur.
Passer à l'échelle Monte Carlo au sein de la base de données
Un notebook est un endroit utile pour valider un modèle, mais il devient une mauvaise limite d'exécution lorsque les données sources contiennent des millions de lignes et que la simulation a besoin de manière répétée du même historique résidant dans l'entrepôt. L'extraction d'échantillons à travers le réseau ajoute des mouvements de données, crée un autre environnement à sécuriser et sépare le calcul du système qui possède les données opérationnelles.
L'exécution en base de données inverse cette limite. Les fonctions SQL définies par l'utilisateur, les opérations sur les tableaux et le code Python vectorisé exécuté sur le moteur de données permettent de maintenir l'échantillonnage au plus près de la source. L'entrepôt peut allouer de la puissance de calcul selon son modèle d'exécution, tandis que le découpage des partitions limite les lectures à l'historique pertinent.

Un guide pratique de mise à l'échelle
Commencez par la localité des données. Stockez les entrées historiques, les paramètres de distribution, les valeurs échantillonnées et les synthèses de résultats là où la surveillance en aval s'exécute déjà. Évitez les appels de fonctions aléatoires par ligne lorsqu'une opération aléatoire vectorisée ou native de l'entrepôt peut générer des lots plus efficacement.
Ensuite, optimisez le plan d'exécution :
Lot par worker : Choisissez une taille de lot qui maintient les workers actifs sans épuiser la mémoire.
Élagage des partitions : Ne lisez que les fenêtres de temps et les actifs nécessaires à la calibration.
Vectorisation des calculs : Opérez sur des tableaux ou des ensembles plutôt que d'invoquer le modèle ligne par ligne.
Persistance des résumés : Stockez les percentiles et les probabilités de violation au lieu de conserver chaque tirage intermédiaire lorsque les exigences d'audit le permettent.
Séparation de la calibration et du scoring : Réajustez les distributions selon un calendrier contrôlé, puis exécutez des tâches de scoring légères plus fréquemment.
Un test d'architecture utile compare deux flux de travail : exécuter 100 000 itérations au sein de la base de données versus exporter des échantillons vers un notebook. L'option en base de données évite le transfert réseau et peut réutiliser la capacité de l'entrepôt, tandis que l'option notebook peut nécessiter une sérialisation supplémentaire, de la mémoire locale et des mouvements de données. Le coût et la latence réels dépendent du moteur, de la complexité du modèle, de la disposition des partitions et de l'allocation des workers, de sorte qu'il convient de tester les deux voies avec des données représentatives plutôt que de supposer que l'une est universellement plus économique.
Pour une explication plus large sur la façon de maintenir le calcul de qualité à proximité des données de l'entrepôt, voir l'exécution de la qualité des données en base de données. Le principe de conception est simple : déplacez la logique de simulation vers les données chaque fois que des transferts répétés deviendraient le goulot d'étranglement.
Pièges, validation et limites des hypothèses
Multiplier les exécutions ne sauve pas un modèle structurellement irréaliste. Cela peut donner l'illusion de stabilité à une estimation biaisée, car la simulation échantillonne de manière répétée à partir des mêmes hypothèses incorrectes.
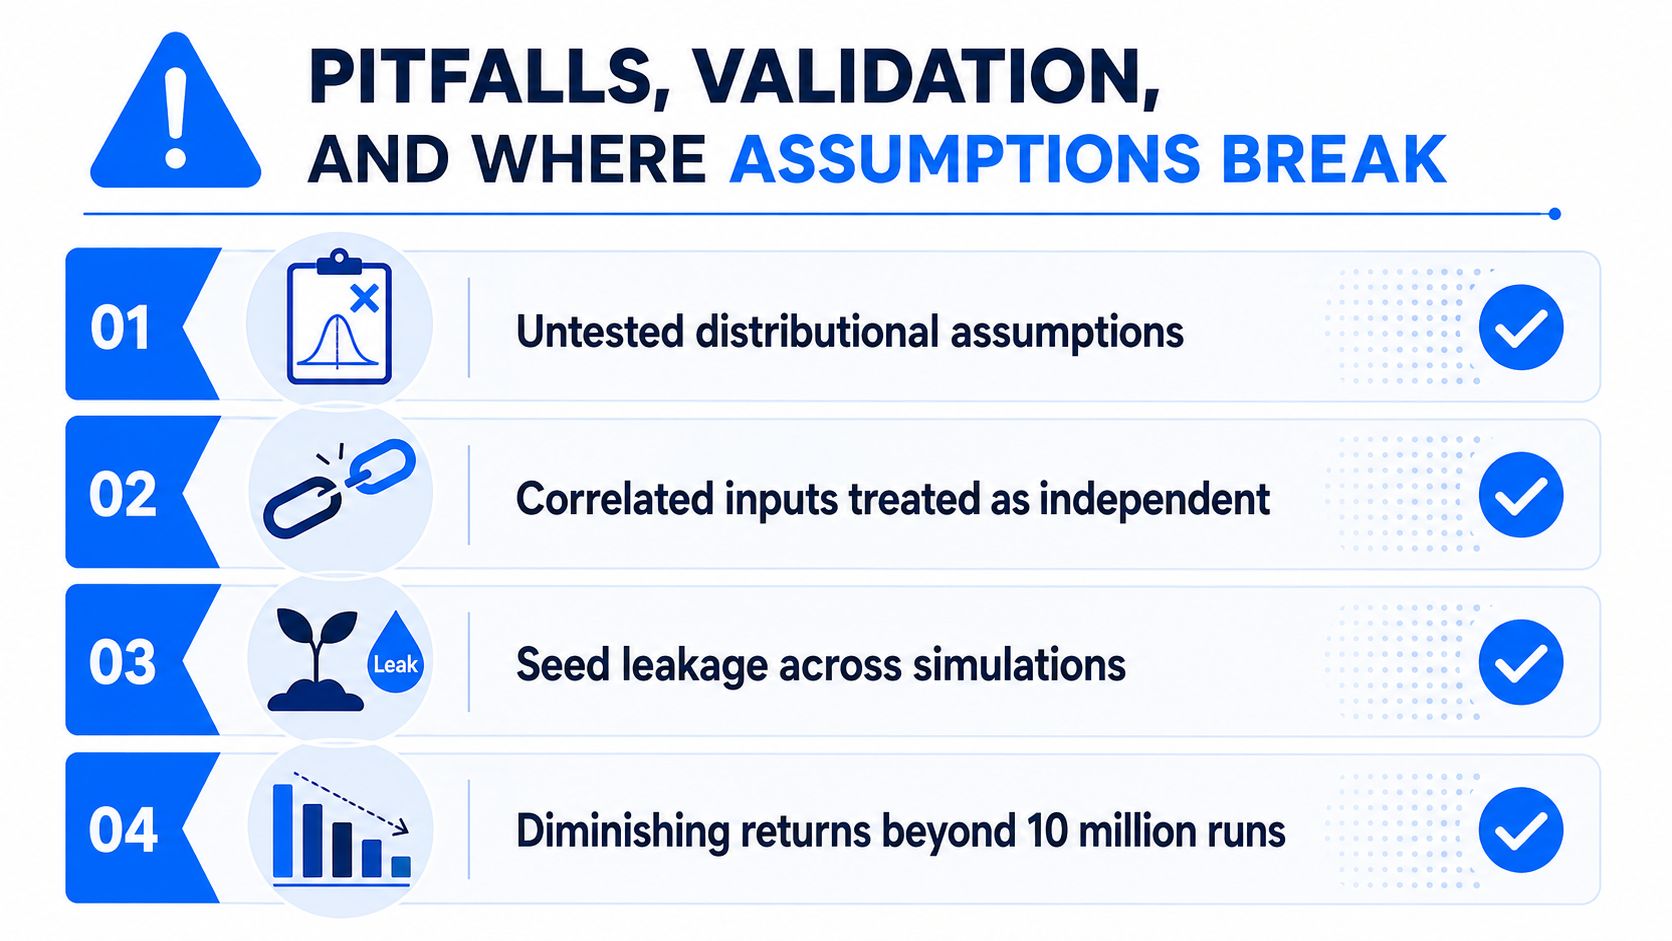
Les problèmes les plus graves surviennent généralement avant l'exécution :
Distributions non testées : Une distribution normale ou statique peut ne pas représenter l'asymétrie, les changements de régime ou les comportements extrêmes opérationnels.
Fausse indépendance : Des entrées corrélées, telles que le retard en amont et le temps d'attente en aval, peuvent être échantillonnées comme si elles n'avaient aucun lien.
Fuite de graine (seed) : Des graines aléatoires partagées ou mal gérées peuvent créer une dépendance involontaire entre les exécutions.
Dérive de population : Des modifications de schéma silencieuses ou l'évolution de la composition du trafic peuvent invalider la population historique utilisée pour la calibration.
Convergence sur un régime étroit : Une estimation en cours peut sembler stable tout en excluant un régime de fonctionnement important.
La littérature récente sur la modélisation des risques met en évidence des préoccupations structurelles similaires, notamment des distributions statiques, des matrices de corrélation fixes, une faible cohérence macroéconomique et une forte demande de calcul. La leçon principale est que le réalisme structurel importe tout autant que l'échantillonnage aléatoire, en particulier dans les environnements financiers et de gestion des risques réglementés, comme en témoigne cette analyse des limites de la génération de scénarios de Monte Carlo.
Actions de validation pour détecter les biais
Comparez les taux de défaillance simulés aux logs d'incidents des 90 derniers jours, en utilisant la fenêtre historique comme référence de validation plutôt que comme preuve que l'avenir se comportera à l'identique. Vérifiez l'ajustement de chaque distribution d'entrée marginale, inspectez la dépendance entre les variables importantes et effectuez des analyses de sensibilité sur les 20 % de paramètres qui génèrent 80 % de la variance lorsque ceux-ci sont établis par votre analyse, et non supposés à l'avance.
La reproductibilité nécessite également plus d'une graine fixe. Réexécutez le modèle avec une nouvelle graine et comparez les percentiles importants, les probabilités de violation et les classifications d'alertes. Des changements importants peuvent indiquer un échantillonnage insuffisant, des queues de distribution instables ou un modèle excessivement sensible.
Une liste de contrôle de diagnostic post-modification
Après chaque modification de modèle, vérifiez que :
La population d'entrée correspond toujours aux actifs surveillés.
Les distributions marginales et les dépendances restent plausibles.
Des graines indépendantes produisent des résultats de décision comparables.
Les diagnostics de convergence couvrent les métriques utilisées pour l'alerte.
Le backtesting ne révèle pas une sous-estimation systématique des défaillances.
Les hypothèses et la version du modèle sont enregistrées avec chaque résultat.
Une simulation doit gagner la confiance opérationnelle par sa validation, et non par le volume de son nombre d'itérations.
Transformer les résultats de simulation en surveillance opérationnelle
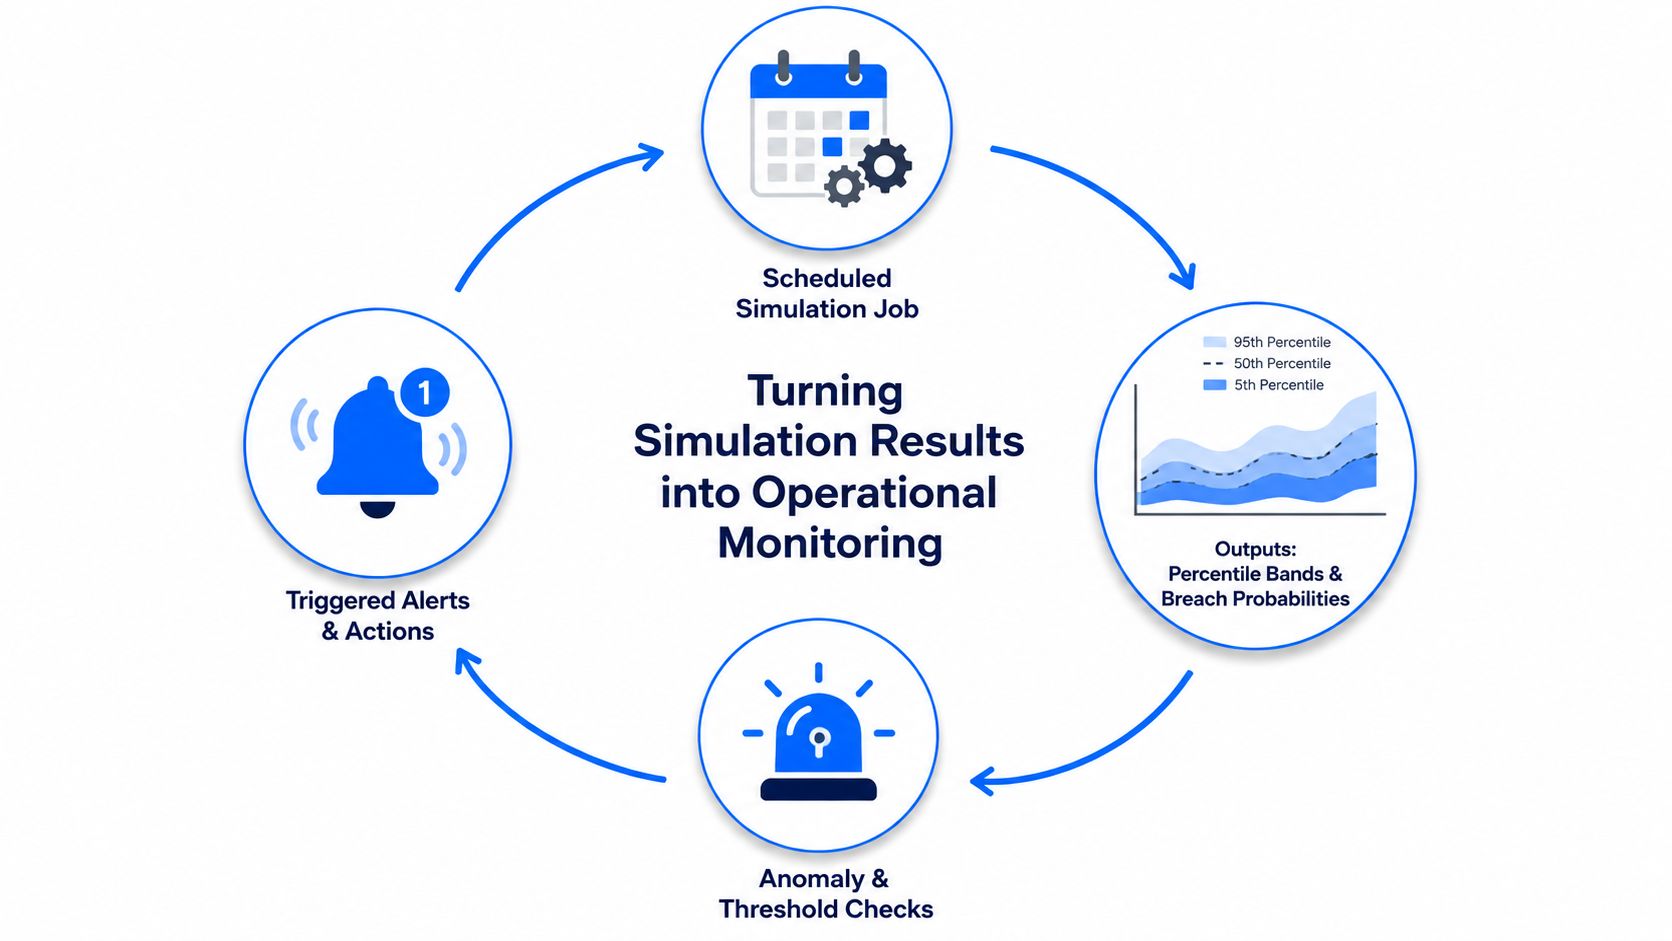
Un flux de travail Monte Carlo en production est une boucle, pas un notebook. Une tâche planifiée calibre ou charge les distributions d'entrées actuelles, exécute le modèle, écrit les bandes de percentiles et les probabilités de violation, et transmet ces résultats aux mêmes vérifications d'anomalies et de seuils qui gèrent les autres signaux d'Observability.
La table quotidienne la plus utile rassemble les valeurs prédites et observées. Pour un KPI, stockez la mesure observée, la plage simulée correspondante, la probabilité associée au mouvement observé, la version du modèle et l'horodatage de l'exécution. Pour un pipeline, stockez le risque de défaillance prédit, le résultat réel et les actifs amont utilisés pour produire l'estimation.
Une liste de contrôle d'intégration
Planifier le modèle : Exécutez la calibration et le scoring à des fréquences adaptées au comportement surveillé.
Conserver les preuves : Stockez les distributions, les graines ou politiques de graines, les versions de modèle et les résumés de résultats.
Connecter le signal : Intégrez les probabilités de violation et les écarts de percentiles dans la logique d'anomalie et de seuil.
Orienter l'action : Envoyez les alertes vers les canaux d'incidents existants avec le lignage et le contexte d'enquête suggéré.
Examiner les résultats : Comparez les prévisions avec les défaillances observées et mettez à jour les hypothèses lorsque le comportement change.
Cette approche s'intègre dans une architecture d'Observability en base de données, où les simulations s'exécutent près des données et les résultats atterrissent aux côtés des métriques de validation, de schéma, d'anomalie et de ponctualité. Une couche de reporting telle que la surveillance et le reporting des données peut alors présenter la métrique observée et sa distribution prédite dans la même vue opérationnelle.
digna fournit une plateforme d'entreprise qui effectue des analyses de qualité des données et d'Observability au sein de l'environnement du client, y compris la détection d'anomalies, la surveillance de la ponctualité, la validation, le suivi des schémas et les métriques métier ou de plateforme. Visitez digna pour évaluer comment son approche en base de données peut connecter les signaux de risque de Monte Carlo avec les flux de surveillance que votre équipe de données utilise déjà.


