Comment évaluer la qualité des données : guide pratique pour les équipes
|
6
minute de lecture

On sent la qualité des données se dégrader bien avant que quelqu'un ouvre un ticket. Le dashboard s'est actualisé, le pipeline a signalé un succès, et pourtant les chiffres ne correspondent ni à la finance, ni aux ventes, ni à ce que le métier s'attendait à voir. C'est généralement à ce moment que les équipes comprennent que la question n'est pas de savoir si les données sont arrivées, mais si l'on peut s'y fier.
La plupart des équipes commencent par des contrôles de fraîcheur et des taux de valeurs nulles, parce qu'ils sont faciles à automatiser. Ces contrôles comptent, mais ils ne disent pas si une colonne a changé de signification du jour au lendemain, si une source s'est mise à dupliquer des enregistrements, ou si un jeu de données d'apparence propre reste faux pour la décision qu'il sert. C'est pourquoi évaluer la qualité des données doit être traité comme un workflow de diagnostic, et non comme un voyant d'état, et pourquoi un rapport erroné peut provenir d'un chargement « réussi ».
Table des matières
Pourquoi la plupart des contrôles de qualité des données passent à côté du vrai problème
Définir les jeux de données critiques et les dimensions de qualité
Pourquoi la plupart des contrôles de qualité des données passent à côté du vrai problème
Une matinée typique commence par un pipeline au vert et un fil Slack au rouge. Le chargement est terminé, les tables du warehouse sont alimentées et le dashboard du chiffre d'affaires semble correct au premier coup d'œil, jusqu'à ce que quelqu'un remarque que le total est faux parce qu'une source a modifié le type d'une colonne ou qu'une règle métier ne correspond plus au nouveau format. Le pipeline n'a pas échoué, mais la couche de décision, si.
C'est précisément cet écart qui fait que le succès d'un pipeline et la qualité des données ne sont pas la même chose. Un job terminé prouve seulement que des octets ont été déplacés, pas que les enregistrements signifient toujours la même chose qu'hier. Si vos contrôles s'arrêtent à la fraîcheur et au comptage des nulls, vous passerez à côté des problèmes d'exactitude, des contradictions entre tables et des dérives de schéma qui cassent le reporting en aval sans prévenir.
Règle pratique : si un indicateur peut être faux tout en ayant l'air présent, il lui faut un contrôle de qualité qui va au-delà de sa simple existence.
Les équipes se brûlent les doigts lorsqu'elles confondent observabilité et évaluation de la qualité. L'observabilité vous dit que quelque chose a changé dans le flux, tandis que l'évaluation demande si les données restent adaptées à leur usage. La différence compte dans les environnements réglementés et dans les workflows d'IA, où des données techniquement propres peuvent rester dangereuses sur le plan opérationnel.
Le meilleur modèle mental interne est simple : des données présentes ne sont pas des données fiables. C'est la ligne que vos alertes doivent défendre. Si vous cartographiez l'écart entre des dashboards bruyants et des contrôles actionnables, cette approche riche en données, pauvre en information est un complément utile, car elle décrit exactement le mode de défaillance avec lequel de nombreuses équipes vivent au quotidien.
Définir les jeux de données critiques et les dimensions de qualité
Commencez par décider de ce qui compte avant d'écrire le moindre contrôle. Toutes les tables ne méritent pas le même examen, et tous les champs ne portent pas le même risque. Le bon périmètre se situe à l'intersection de l'impact métier et de la dépendance en aval, si bien que la première question est toujours : « Qu'est-ce qui casse si cette valeur est fausse ? »
Dans un environnement réglementé, je délimiterais d'abord le jeu de données autour des workflows critiques, puis j'identifierais les attributs qui pilotent réellement ces workflows. Il s'agit généralement des identifiants, horodatages, clés étrangères, champs de statut, codes réglementaires et de toute valeur qui alimente un KPI, un rapport ou un modèle. Une fois ces éléments nommés, définissez les six dimensions comme des exigences mesurables, et non comme des idéaux abstraits.
Dimension | Ce qu'elle mesure | Type de seuil habituel | Exemple de défaillance |
|---|---|---|---|
Complétude | Les valeurs obligatoires sont présentes | Strict sur les champs obligatoires, plus souple sur le texte facultatif | Un identifiant client obligatoire est manquant |
Unicité | Les enregistrements ne sont pas dupliqués | Généralement tolérance zéro sur les champs clés | La même transaction arrive deux fois |
Cohérence | Les valeurs ne se contredisent pas d'un système ou d'une table à l'autre | Contrôles de rapprochement entre sources | Le statut de commande diffère entre le warehouse et la facturation |
Validité | Les valeurs respectent les formats, plages ou règles autorisés | Réussite ou échec strict selon des modèles définis | Un identifiant fiscal a un format incorrect |
Exactitude | Les valeurs correspondent à des données de référence fiables ou à la réalité | Rapprochement avec des sources faisant autorité | Un code produit existe, mais pointe vers le mauvais article |
Actualité | Les données sont suffisamment fraîches pour l'usage prévu | Fenêtres de fraîcheur ou engagements de livraison | Un fichier quotidien arrive après la date limite du reporting |
Le piège consiste à réduire tout cela à un score unique. Un jeu de données peut être presque complet et pourtant inutilisable si les valeurs valides sont fausses ou périmées. C'est pourquoi les seuils doivent être pondérés par le risque, avec une tolérance zéro pour un identifiant réglementaire invalide, par exemple, et une certaine souplesse pour un champ descriptif non essentiel.
Un bon document de périmètre tient sur une page. S'il ne peut pas dire quelles tables comptent, quels champs sont critiques et pourquoi chaque dimension est contrôlée, le programme dérivera vers un simple théâtre de cases cochées.
Si vous avez besoin d'une méthode pratique pour identifier les champs critiques et les rattacher à des responsables, les éléments de données critiques sont le bon point de départ. Pour les équipes qui définissent le périmètre conjointement entre gouvernance et ingénierie, cet alignement évite bien des débats en aval.
Appliquer la méthodologie d'évaluation par étapes
La façon la plus propre d'évaluer la qualité des données est de séquencer le travail plutôt que de l'improviser. L'ordre compte, car chaque étape alimente la suivante, et en sauter une transforme tout le processus en conjectures. Commencez par le profilage, puis définissez les règles, fixez les seuils, exécutez les requêtes et examinez les résultats.

Profiler avant de prescrire
Profilez d'abord le jeu de données. Examinez les taux de nulls, les taux de doublons, les plages de valeurs, les formats et les relations référentielles, car ces schémas vous indiquent où se trouvent les vrais défauts. Sans cette base de référence, vous finirez par écrire des règles fondées sur des hypothèses plutôt que sur des faits.
Traduisez ensuite les exigences en tests propres à la dimension que vous mesurez. Un champ de date a besoin d'une règle de format et d'une règle de plage. Une clé étrangère a besoin d'un contrôle référentiel. Un code réglementaire peut nécessiter un modèle strict ainsi qu'un rapprochement avec la source de vérité.
Fixer des seuils qui reflètent le risque
Les seuils d'avertissement et d'échec ne devraient pas être identiques. Un champ qui alimente un dashboard peut tolérer un faible taux de défauts, alors qu'un champ qui pilote le reporting de conformité ne le devrait généralement pas. C'est sur cette distinction qu'échouent trop de programmes, parce qu'ils traitent tous les défauts de la même façon.
Calculez les résultats au niveau de l'enregistrement, du champ, de la table et du domaine, puis suivez leur évolution dans le temps. Un passage unique ne dit presque rien. Un taux de défauts qui se dégrade vous indique qu'une source a changé, qu'un contrat a été rompu ou qu'une équipe en amont a modifié son comportement. C'est là que la méthodologie devient opérationnelle plutôt que décorative.
L'objectif est de repérer tôt le cas sournois, celui où un jeu de données est complet à 99 % mais reste substantiellement faux. Si vous avez besoin d'une référence sur la terminologie de cette approche, la définition de l'évaluation de la qualité des données est un complément utile.
Échantillonnage, validation et reporting honnête
Un résultat sans contexte est un risque. Si vous avez échantillonné 100 enregistrements, vous ne devriez jamais présenter l'indicateur comme s'il provenait d'une analyse complète de la population, car l'incertitude fait partie du constat. Conservez le numérateur, le dénominateur, la fenêtre d'observation, la définition de la population et la méthode d'échantillonnage pour chaque indicateur, puis indiquez des intervalles de confiance lorsque le résultat est estimé à partir d'un échantillon, comme le souligne le guide de mesure du NIST dans son traitement de l'incertitude (NIST SP 800-55).

Présenter la distribution, pas seulement le score
Une estimation de complétude fondée sur 100 enregistrements échantillonnés n'est pas la même chose que le même pourcentage calculé sur 100 000 enregistrements. La première peut être utile, mais elle est beaucoup moins stable et bien plus facile à mal interpréter. Suivez la moyenne, l'écart type, les quantiles et les valeurs manquantes par segment afin de voir où le problème se concentre.
Cette segmentation compte, car les scores agrégés masquent les défaillances locales. Une table peut sembler correcte dans l'ensemble alors qu'un pays, un système source ou un segment de clientèle s'effondre. Si vous ne conservez pas la ventilation, vous passerez à côté de la cause racine opérationnelle et perdrez du temps à débattre du chiffre global.
Ne pas confondre les modes de défaillance courants
La validité n'est pas l'exactitude. Une valeur peut avoir le bon format et rester fausse. Des données en retard ne sont pas non plus des données manquantes, et l'imputation automatique peut améliorer l'apparence de la complétude tout en nuisant à la traçabilité.
C'est pourquoi le rapport doit exposer l'incertitude, et non la cacher. Un bon résultat de qualité vous dit ce qui a été contrôlé, comment, quel degré de confiance vous pouvez avoir et quelles parties de la population demandent de l'attention.
Pour les équipes qui construisent la partie saisie de ce workflow, parcourir les blocs de saisie de données est une référence utile pour réfléchir à la discipline et à la structure des entrées, surtout lorsque les systèmes sources sont désordonnés. Le problème opérationnel n'est généralement pas le calcul, mais l'obtention d'entrées fiables dès le départ.
Vous pouvez aussi rattacher les contrôles à des règles explicites et à une logique de revue grâce aux règles de validation des données, contrôles et qualité des données en continu, là où le reporting cesse d'être abstrait et commence à soutenir une véritable remédiation.
Choisir le bon mélange d'outils et d'automatisation
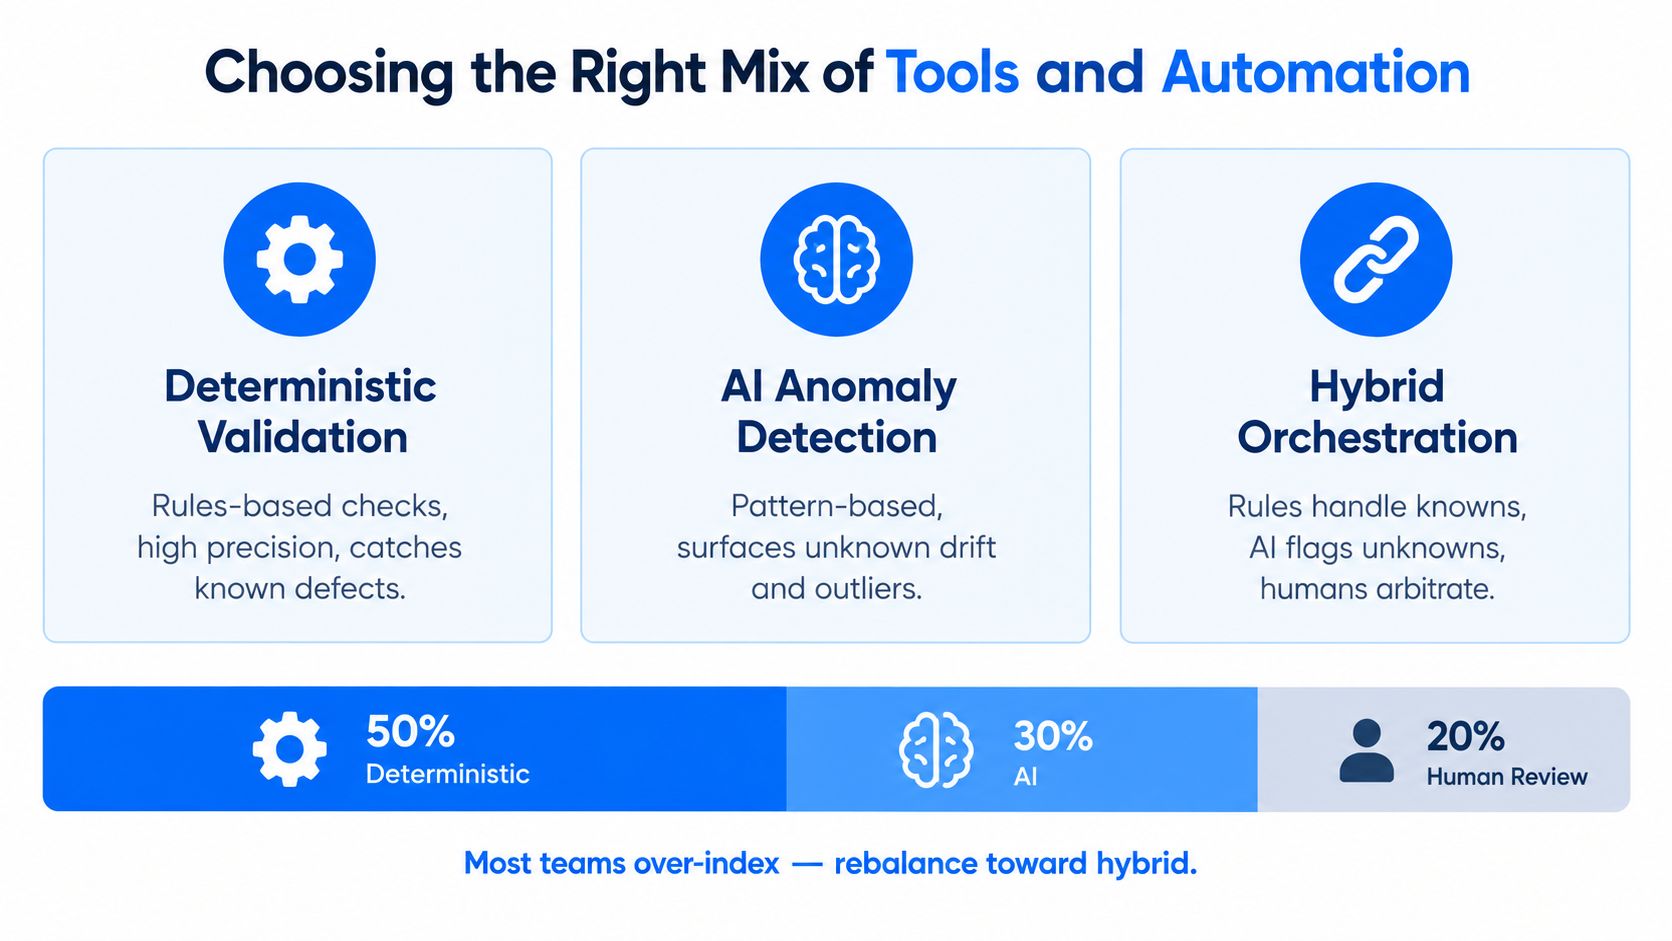
Les bons programmes ne misent pas tout sur un seul type de signal. La validation déterministe détecte les défauts connus, la détection d'anomalies par IA repère les schémas inhabituels, et les contrôles de schéma et de fraîcheur interceptent les défaillances silencieuses avant qu'elles ne se propagent. Utilisez les trois, mais attribuez à chacun le problème qu'il traite le mieux.
Adapter le signal au mode de défaillance
La validation par règles est le bon outil lorsque l'exigence est explicite et auditable. Si un code fiscal doit suivre un format ou si une clé étrangère doit exister, écrivez la règle et rendez le résultat reproductible. C'est la preuve qu'attendent les auditeurs, et le moyen le plus rapide d'empêcher des défauts connus d'entrer dans votre patrimoine de données.
La détection d'anomalies statistique ou par IA a sa place là où le problème est une dérive comportementale. Un changement de schéma dans le volume, la distribution ou le timing peut ne violer aucune règle stricte, tout en signalant un changement de source, un problème dans un processus en amont ou une hypothèse invalidée. Les baselines apprises surpassent les contrôles statiques dans ces cas, car un ensemble de règles ne peut pas anticiper chaque nouveau mode de défaillance.
Ne pas négliger la surveillance de la structure et des livraisons
Les changements de schéma et les contrôles de fraîcheur méritent leur propre place dans le stack. Un changement de type de colonne, un champ ajouté ou une livraison en retard peuvent casser les consommateurs en aval avant qu'une règle au niveau des lignes ne se déclenche. Ces contrôles sont basiques, mais ils évitent bien des douleurs en production.
Le compromis porte sur la gouvernance et l'emplacement. L'exécution dans la base de données réduit les déplacements de données et maintient le contrôle au plus près des données, ce qui compte dans les environnements réglementés. L'adoption modulaire aide aussi, car les équipes doivent commencer par un chemin critique et l'étendre, plutôt que d'acheter une plateforme géante qu'elles n'exploitent jamais pleinement.
Vous n'avez pas besoin d'un outil miracle unique. Il vous faut un stack adapté au profil de risque des données, à la charge de conformité de l'équipe et au type de défaillances que rencontre votre entreprise. Si vous comparez des fournisseurs ou élaborez un standard interne, les outils de qualité des données constituent un point d'ancrage pratique pour cette évaluation.
Quand des données propres ne sont pas des données sûres
Un jeu de données peut réussir tous les contrôles classiques et rester dangereux pour la décision qu'il alimente. Cela devient vite évident dans les projets d'IA, car la question n'est pas seulement de savoir si les données sont propres, mais si elles sont pertinentes, représentatives et adaptées au groupe concerné. L'article 10 du règlement européen sur l'IA exige que les données d'entraînement, de validation et de test à haut risque soient pertinentes, suffisamment représentatives, aussi complètes et exemptes d'erreurs que possible, et statistiquement adaptées aux groupes et contextes concernés (AI Act de l'UE, article 10).
La propreté technique ne prouve pas l'aptitude à l'usage
Le modèle standard à six dimensions atteint ici ses limites. Vous pouvez avoir des données complètes, valides et uniques qui sous-représentent pourtant un groupe minoritaire, omettent une zone géographique pertinente ou reflètent un contexte opérationnel dépassé. Ce jeu de données peut sembler techniquement solide et rester dangereux sur le plan opérationnel.
La solution pratique consiste à ajouter au dossier d'évaluation la couverture des sous-groupes, le décalage de distribution et la documentation de l'usage prévu. Dans la santé, la finance, les télécommunications et les services publics, ce n'est pas une préoccupation théorique. Les scores de qualité agrégés peuvent sembler acceptables alors que la couverture ou les taux d'erreur de certains groupes restent inacceptables.
Traiter la représentativité comme une exigence opérationnelle
La représentativité doit devenir mesurable, sinon elle reste un vœu pieux. Les équipes ont besoin de seuils explicites de couverture des sous-groupes, de règles claires indiquant quand une dérive est un changement légitime de la population, et d'une trace expliquant pourquoi le jeu de données convient à une décision donnée. C'est la seule façon de distinguer une population qui évolue réellement d'un biais d'échantillonnage préjudiciable.
C'est aussi là que la responsabilité compte. Quelqu'un doit trancher sur la question de savoir si les données correspondent toujours au cas d'usage, et pas seulement si les contrôles sont passés. Si le jeu de données est propre mais inadapté, la bonne réponse est d'arrêter le workflow, pas de célébrer le dashboard.
Présenter les résultats et opérationnaliser le workflow
Le rapport doit indiquer aux parties prenantes ce qui a été contrôlé, ce qui a échoué, le degré de confiance de l'équipe dans le résultat et qui est responsable de l'action suivante. Incluez le périmètre, les dimensions testées, les seuils, les ventilations par segment, les résultats avec leur incertitude, l'état de la remédiation et un responsable clair pour chaque problème non résolu. Si vous avez besoin d'une référence pratique en matière de documentation opérationnelle, les guides pratiques de Trupeer Inc. sont un modèle utile pour rendre les étapes d'un processus lisibles sans les compliquer.
Garder le workflow reproductible
Les programmes les plus fiables font de l'évaluation un calendrier, et non un projet ponctuel. Planifiez des évaluations récurrentes, versionnez les règles et les seuils, déclenchez des alertes en cas de dégradation et passez en revue les résultats avec les parties prenantes à un rythme régulier. Cela rejoint le modèle de gouvernance de l'ISO 8000, dans lequel les normes sont révisées tous les cinq ans et le contrôle qualité fait partie de la gestion courante, et non d'un événement de certification unique (ISO 8000-1:2022).
Checklist pour le runbook : délimiter les jeux de données critiques, profiler les données, définir les règles, fixer les seuils d'avertissement et d'échec, exécuter les requêtes, suivre l'évolution des résultats, indiquer l'incertitude et réévaluer selon un calendrier.
Évitez les dashboards de vanité. Évitez les avalanches d'alertes. Les deux produisent le même résultat : les gens cessent de faire confiance au programme. Un workflow qualité ne fonctionne que si les signaux sont suffisamment précis pour agir et suffisamment stables pour soutenir à la fois l'audit, l'ingénierie et l'analytique.
Si vous cherchez une plateforme qui s'exécute dans votre propre environnement et combine validation au niveau des enregistrements, surveillance de la fraîcheur, suivi des schémas et détection d'anomalies, digna est une option à évaluer pour ce modèle opérationnel. Rendez-vous sur digna pour voir comment son approche de la qualité des données et de l'observabilité s'adapte aux jeux de données critiques, aux environnements réglementés et aux workflows prêts pour l'IA.
Pour la partie de ce stack fondée sur des baselines apprises, découvrez comment le module digna Data Anomalies détecte des variations de volume, de distribution et de timing qu'aucune règle écrite à la main n'avait anticipées.
Questions fréquentes
Comment évaluer la qualité des données étape par étape ?
Évaluez la qualité des données selon une séquence fixe : délimiter les jeux de données critiques, profiler les données, définir des règles par dimension, fixer des seuils d'avertissement et d'échec, exécuter les requêtes et suivre l'évolution des résultats. Le profilage vient en premier, car les taux de nulls, les doublons et les plages de valeurs montrent où se trouvent réellement les défauts.
Quelles sont les six dimensions utilisées pour mesurer la qualité des données ?
Les six dimensions sont la complétude, l'unicité, la cohérence, la validité, l'exactitude et l'actualité. Chacune doit être une exigence mesurable avec son propre type de seuil, par exemple une tolérance zéro pour les champs clés dupliqués ou une fenêtre de fraîcheur pour un fichier quotidien qui doit arriver avant la date limite du reporting.
Pourquoi un pipeline réussi peut-il quand même livrer de mauvaises données ?
Un job terminé prouve seulement que des octets ont été déplacés, pas que les enregistrements signifient toujours la même chose qu'hier. Une source peut changer le type d'une colonne ou dupliquer des enregistrements alors que le chargement reste au vert, donc des contrôles limités à la fraîcheur et aux nulls manquent les problèmes d'exactitude, les contradictions entre tables et les dérives de schéma.
Comment présenter les résultats de qualité obtenus par échantillonnage ?
Les résultats issus d'un échantillon doivent toujours indiquer leur incertitude. Conservez le numérateur, le dénominateur, la fenêtre d'observation, la définition de la population et la méthode d'échantillonnage pour chaque indicateur, et indiquez des intervalles de confiance, car une estimation de complétude sur 100 enregistrements est bien moins stable que le même pourcentage sur 100 000 enregistrements.
Des données propres sont-elles toujours sûres pour l'IA ?
Non, des données propres peuvent rester dangereuses si elles sous-représentent un groupe, omettent une zone géographique ou reflètent un contexte dépassé. L'article 10 de l'AI Act de l'UE exige que les données d'entraînement à haut risque soient pertinentes et suffisamment représentatives, d'où l'intérêt d'ajouter couverture des sous-groupes, décalage de distribution et documentation de l'usage prévu.


