Convertir un timestamp en datetime : le guide complet
|
6
minute de lecture

1700000000 n'est pas un datetime, c'est un timestamp machine. Pour le convertir en toute sécurité, identifiez d'abord l'unité, normalisez en UTC, puis affichez le résultat avec un contexte de fuseau horaire explicite, sinon vous corromprez l'enregistrement.
Un dashboard cassé à 8 h 05 n'a généralement pas l'air cassé du tout. Le graphique se charge, le batch se termine et l'export de facturation arrive à l'heure, mais une équipe lit des secondes comme des millisecondes, une autre suppose l'heure locale et une troisième formate un instant sans conserver la valeur d'origine. C'est dans cet écart entre les timestamps machine et les datetimes lisibles par l'humain que se cachent la plupart des problèmes de production.
Table des matières
Pourquoi les conversions de timestamps échouent en production
La gestion des fuseaux horaires au-delà de la conversion de base
Précision, détection des unités et perte silencieuse de données
Pourquoi les conversions de timestamps échouent en production
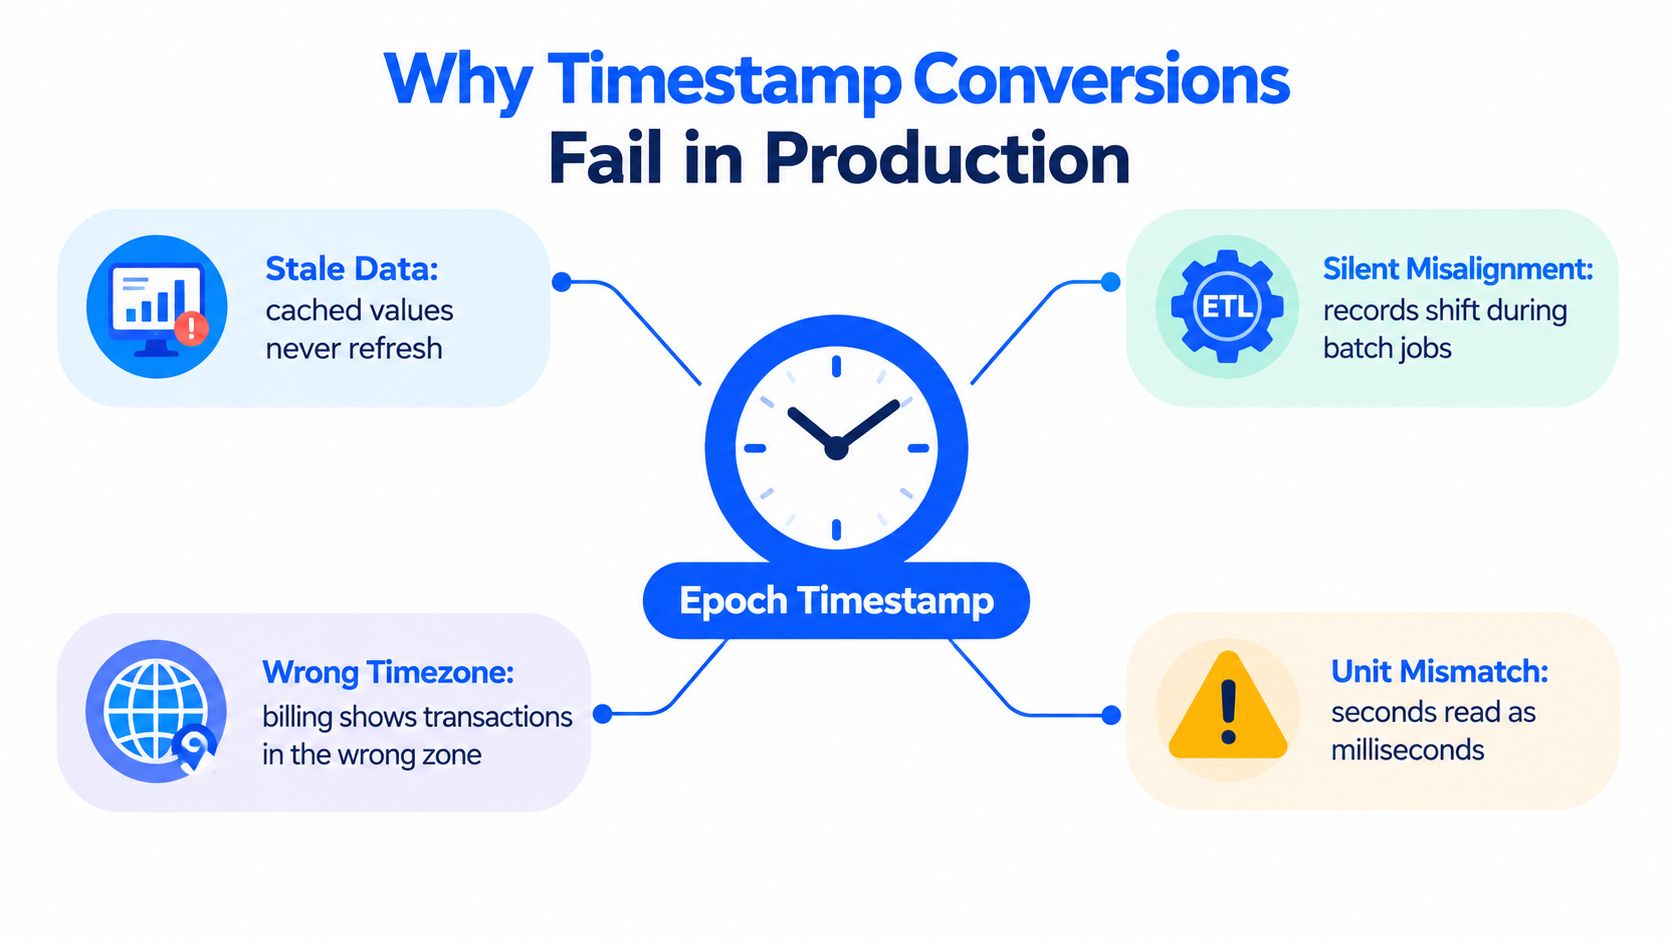
Un dashboard qui affiche les chiffres de la veille, une exécution ETL qui décale des enregistrements d'un jour ou un extrait de facturation qui atterrit dans la mauvaise région renvoient généralement à une même cause : la signification ambiguë du timestamp. Un timestamp Unix identifie un instant par rapport à l'epoch Unix, soit 00:00:00 UTC le 1er janvier 1970, mais le nombre lui-même n'indique pas comment l'afficher. Les mêmes chiffres peuvent désigner le mauvais moment si un système lit des secondes et un autre des millisecondes, ou si le fuseau horaire local d'un serveur s'immisce dans l'étape de conversion. La convention Unix traite en outre chaque jour civil comme exactement 86 400 secondes logiques, ce qui garde l'arithmétique simple, mais les secondes intercalaires et les règles de fuseau horaire comptent toujours lorsque le résultat est présenté à des personnes. (Référence de la NASA sur les secondes intercalaires)
Ce qui casse en premier
La première défaillance est généralement une confusion d'unités. Une valeur qui devrait être lue en secondes est interprétée comme des millisecondes, et le datetime obtenu tombe près de 1970 ou loin de la plage attendue. La deuxième défaillance est la dérive de fuseau horaire : le timestamp est correctement décodé, mais affiché dans le mauvais contexte local.
Règle pratique : traitez la valeur numérique brute comme la source de vérité et le datetime formaté comme une couche de présentation.
La troisième défaillance se cache dans les échanges entre systèmes. Un service écrit en UTC, un autre lit une valeur naïve comme une heure locale, et le pipeline « fonctionne » quand même, parce que le résultat paraît assez plausible pour passer un rapide coup d'œil. La quatrième défaillance tient à la politique des secondes intercalaires, car le temps POSIX ordinaire ignore les secondes UTC insérées et ne peut pas représenter 23:59:60 de manière unique. Le risque ne se limite pas aux jolis affichages. Il apparaît dans les clôtures de facturation, les chronologies d'incidents et tout jeu de données où l'ordre compte. Pourquoi les premières défaillances d'un pipeline passent souvent inaperçues propose une façon utile d'aborder ces erreurs silencieuses dans des flux de données voisins.
À quoi ressemble un modèle mental correct
La bonne séquence est simple, mais chaque étape compte. D'abord, identifiez l'unité et le contrat sémantique. Ensuite, normalisez vers un instant absolu. Enfin, affichez cet instant en UTC ou dans un fuseau civil nommé, uniquement lorsque la sortie est nécessaire. Si vous sautez l'une de ces étapes, vous ne convertissez plus un timestamp en datetime, vous devinez.
Convertir des timestamps dans les systèmes courants
Les conversions les plus sûres sont celles qui rendent l'unité et le fuseau horaire évidents dans le code. Python, JavaScript et SQL ont chacun leurs valeurs par défaut, et c'est précisément là que commencent les bugs de production. Si vous standardisez une conversion explicite et consciente du fuseau horaire, la même valeur brute reste reproductible d'un serveur, d'un job et d'un notebook à l'autre.
Python
La bibliothèque standard de Python offre un modèle propre : datetime.fromtimestamp(value, tz=timezone.utc) pour une conversion consciente de l'UTC, puis astimezone(target_zone) uniquement lorsqu'un fuseau local nommé est requis. Si vous omettez tz, Python utilise l'heure locale de la plateforme et renvoie un datetime naïf, et c'est ainsi que le même code se met à se comporter différemment d'un hôte à l'autre. C'est pourquoi l'étape UTC explicite est le choix par défaut le plus sûr. La documentation officielle de datetime décrit aussi la distinction entre naïf et aware ainsi que l'usage recommandé de timezone.utc. (Documentation datetime de Python)
JavaScript
L'objet Date de JavaScript stocke des millisecondes depuis l'epoch Unix : les secondes Unix doivent donc être multipliées par 1 000 avant la conversion. L'opération inverse exige une division par 1 000, et il faut conserver la précision fractionnaire lorsqu'elle compte. L'autre piège est le choix de l'accesseur, car un stockage basé sur l'UTC n'empêche pas les accesseurs locaux de lire à travers le fuseau horaire de la machine hôte. La référence MDN de Date (en anglais) rappelle utilement de garder cette distinction explicite.
SQL et moteurs d'entrepôt de données
Les moteurs SQL varient : le réflexe le plus sûr consiste donc à vérifier le type cible et le comportement du fuseau horaire plutôt que de supposer qu'un moteur se comporte comme un autre. PostgreSQL distingue la précision des timestamps et prend en charge une résolution fractionnaire, tandis que ClickHouse propose des fonctions distinctes pour les secondes, les millisecondes et les microsecondes. En pratique, l'essentiel n'est pas de mémoriser chaque nom de fonction, mais de s'assurer que le type stocké correspond à l'unité source et que le fuseau d'affichage est choisi délibérément. La documentation PostgreSQL sur les dates et heures est particulièrement utile pour raisonner sur la précision et les fractions de seconde. (Types date et heure de PostgreSQL)
Pour les équipes qui jonglent entre formats de fichiers et ingestion dans l'entrepôt, les formats de fichier Parquet comptent, car les champs de timestamp traversent souvent des systèmes aux attentes de précision différentes. Un datetime correct dans un moteur peut perdre son sens lorsqu'un parser en aval suppose une autre unité ou tronque les fractions de seconde.
La gestion des fuseaux horaires au-delà de la conversion de base
Le décodage de l'epoch et la conversion de fuseau horaire résolvent des problèmes différents. Le décodage indique quel instant l'enregistrement représente. La conversion indique comment cet instant doit apparaître dans un lieu et un contexte historique donnés. Les systèmes qui confondent ces étapes produisent des dates locales correctes dans un environnement et fausses dans un autre. La base de données des fuseaux horaires de l'IANA existe parce que l'histoire des fuseaux horaires varie selon les lieux et au fil du temps. Elle enregistre les règles d'heure locale et les met à jour lorsque les gouvernements modifient les décalages et les politiques d'heure d'été.
Pourquoi les décalages fixes échouent
Un décalage fixe capture un moment, mais pas les règles qui se cachent derrière ce moment. America/New_York n'est pas équivalent à UTC-5, car le fuseau nommé inclut le passage à l'heure d'été et les changements historiques, ce que le décalage ne fait pas. Si vous ne stockez que le décalage, vous perdez l'identité du lieu ainsi que les changements de règles qui lui sont associés.
Python gère cela correctement avec tzinfo, qui conserve ensemble le décalage et le comportement du fuseau. Le modèle le plus sûr consiste à décoder d'abord en UTC, puis à convertir vers un fuseau nommé à la frontière de l'affichage. Attacher une étiquette de fuseau horaire à un datetime naïf est une réinterprétation, pas une conversion.
Une heure locale peut se répéter lors du passage à l'heure d'hiver et disparaître lors du passage à l'heure d'été.
Pourquoi JavaScript demande plus de vigilance
L'objet Date de JavaScript repose en interne sur l'UTC, mais ses accesseurs de composants ordinaires utilisent le fuseau horaire local de la machine hôte. Un notebook de débogage sur un ordinateur portable et un conteneur de production dans une autre région peuvent afficher des champs locaux différents pour le même instant. Le timestamp reste correct. C'est le chemin d'affichage qui change, et cela suffit à créer des bugs déroutants. Pour des pipelines déterministes, utilisez les accesseurs UTC ou une bibliothèque consciente des fuseaux horaires, et ne vous fiez pas aux réglages par défaut de la machine.
La traçabilité fait partie de la gestion des fuseaux horaires
Gérer les fuseaux horaires ne se résume pas au formatage. Les systèmes de la finance, de la santé ou du reporting transfrontalier doivent conserver ensemble l'instant d'origine, le fuseau choisi et le statut de conversion, sous forme de champs de métadonnées qui voyagent avec l'enregistrement, et non à côté, dans une note de notebook ou un commentaire de ticket.
Cette séparation est décisive en production. Sans l'instant d'origine, vous ne pouvez pas prouver ce qui a été reçu. Sans le statut de conversion, vous ne pouvez pas savoir si une valeur a été normalisée, affichée ou réinterprétée plus tard.
Précision, détection des unités et perte silencieuse de données
Une conversion de timestamp en datetime peut modifier bien plus que l'affichage. Elle peut détruire la précision, écraser l'ordre des événements et masquer la différence entre deux enregistrements survenus dans la même seconde affichée, mais pas au même instant. C'est pourquoi la détection des unités doit être traitée comme un contrat de schéma, et non comme une estimation fondée sur le nombre de chiffres. Les pratiques d'exactitude en qualité des données sont particulièrement pertinentes ici, car un mauvais choix de précision paraît toujours « valide » aux systèmes en aval.
Pourquoi compter les chiffres est un piège
Un entier long ne vous dit pas si la source est en secondes, millisecondes, microsecondes ou nanosecondes. Une valeur à 13 chiffres peut représenter des millisecondes dans un flux, alors qu'un autre système utilise une tout autre échelle. Si vous divisez par 1 000 parce que le nombre « ressemble » à des millisecondes, vous pouvez obtenir un datetime plausible mais subtilement faux.
PostgreSQL prend en charge une précision de timestamp de zéro à six chiffres fractionnaires, ce qui suffit à montrer l'enjeu. Si votre source contient des microsecondes et que votre cible ne stocke que des valeurs à la seconde, vous perdez des informations d'ordre alors même que le résultat s'affiche proprement. Cette perte peut affecter la déduplication, la mesure de latence, la corrélation d'incidents et les pistes d'audit.
Ce qu'il faut conserver
Stockez la valeur numérique d'origine. Stockez l'unité source. Stockez la précision cible. N'affichez ensuite le datetime lisible qu'une fois ces valeurs rendues explicites. Si la source utilise des fractions de seconde, conservez-les sous une forme qui n'arrondit pas via la virgule flottante, à moins que votre système ne puisse tolérer cette perte.
Une sortie lisible est utile aux humains, mais elle peut masquer la réalité opérationnelle : deux événements étaient bien distincts.
Les timestamps de type POSIX méritent eux aussi une formulation prudente. Ils sont pratiques pour l'arithmétique, car chaque jour est traité comme 86 400 secondes, mais ils ne constituent pas une horloge physique parfaite et ne comptent pas séparément les secondes intercalaires. Cette distinction compte dans les systèmes d'observabilité, où le pipeline peut devoir distinguer « la même seconde affichée » du « même événement sous-jacent ».
Construire un pipeline de timestamps pour la production
Un pipeline de production doit toujours suivre le même ordre. Parser d'abord la valeur brute et confirmer l'unité source. Valider l'ordre de grandeur, la précision et la nullabilité par rapport au contrat. Normaliser en UTC. Convertir vers un fuseau local nommé uniquement pour la présentation. Émettre un format explicite, comme ISO 8601 avec Z ou un décalage. Cette séquence empêche un même enregistrement de changer de sens lorsqu'il traverse les services.

Le workflow qui tient en production
Commencez par le contrat avant de toucher au formateur. Un champ de timestamp doit déclarer s'il est exprimé en secondes, en millisecondes ou dans une autre unité, et s'il représente l'UTC ou une heure civile locale. Inscrivez cette déclaration dans la documentation du schéma, les checks du pipeline et les fixtures de test, afin que le parser et le relecteur jugent la même chose.
Normalisez l'instant avant tout formatage d'affichage. JavaScript exige une multiplication ou une division explicite autour du stockage en millisecondes de Date. Python doit d'abord créer des datetimes UTC aware. SQL doit utiliser des types conscients du fuseau horaire et éviter les casts silencieux qui dépendent des paramètres de session. Ce n'est qu'ensuite qu'il faut convertir vers le fuseau métier, et seulement si un consommateur en aval a besoin d'un affichage local.
Les équipes qui comparent des briques d'orchestration et d'entreposage peuvent s'appuyer sur les composants d'un pipeline de données moderne comme référence. La règle pratique est plus simple : chaque étape doit transporter la valeur brute, l'unité source, le fuseau de présentation et le résultat de validation. Le dépannage reste ainsi possible sans rejouer tout le pipeline.
Le timestamp numérique d'origine ne doit jamais disparaître simplement parce qu'un datetime a été affiché dans un rapport. Conservez les deux. L'un est le champ d'audit, l'autre la couche d'affichage. Les contrôles qualité des pipelines de données sont les plus solides lorsque les deux survivent à chaque étape.
Valider les conversions par des tests de cas limites
Les bugs de timestamps apparaissent aux marges. Des valeurs qui semblent correctes lors d'une démo rapide échouent souvent en production : la suite de tests doit donc viser délibérément les cas gênants. Incluez zéro, les valeurs négatives antérieures à l'epoch, les fractions de seconde, les valeurs nulles, les chaînes non numériques et les timestamps proches des changements d'heure. La même suite doit aussi couvrir les dates maximales prises en charge près des limites du système et vérifier que les accesseurs UTC de JavaScript restent cohérents avec les accesseurs locaux d'un environnement à l'autre. Les pratiques de test de la qualité des données sont les plus solides lorsqu'elles sondent les cas difficiles, pas seulement le chemin nominal.
Ce qu'il faut tester en premier
Zéro et valeurs antérieures à l'epoch : vérifiez que le pipeline traite
0et les timestamps négatifs de manière cohérente, ou les rejette avec un motif clair.Précision fractionnaire : vérifiez que les microsecondes ou millisecondes survivent à la conversion lorsque le contrat source l'exige.
Moments de changement d'heure : testez les heures locales répétées et sautées afin que la couche d'affichage n'étiquette pas mal l'instant.
Entrées nulles et non numériques : vérifiez que le pipeline rejette les enregistrements invalides sans deviner.
Timestamps en limite haute : vérifiez la plus grande plage de datetimes que votre base de données, votre runtime ou votre format de sérialisation peut contenir.
Ce qu'il faut journaliser
Journalisez l'unité source, les métadonnées de fuseau horaire de la source, l'instant UTC normalisé, le statut de validation et l'éventuel motif d'erreur. Ces métadonnées rendent l'analyse des incidents reproductible, surtout lorsqu'un environnement met à jour ses données de fuseaux horaires pendant qu'un autre accuse du retard. La base de l'IANA évolue avec le temps : la reproductibilité dépend donc autant de la connaissance des versions que de la justesse du code.
Une conversion qui ne peut pas être reproduite à partir des logs n'a pas été validée.
Un dernier contrôle doit comparer la valeur d'origine au datetime affiché après un aller-retour, lorsque c'est possible. Si l'instant renvoyé change, le chemin de conversion perd encore de l'information. Conserver le timestamp brut à côté du datetime facilite grandement l'audit, car un champ préserve la valeur machine et l'autre montre la forme lisible.
Si vous souhaitez que ces contrats de timestamp - unité, plage plausible, précision et nullabilité - soient appliqués à chaque chargement et pas seulement dans les suites de tests, digna Data Validation les exécute sous forme de règles directement dans votre base de données.
Questions fréquentes
Comment convertir un timestamp Unix en datetime en Python ?
Utilisez datetime.fromtimestamp(value, tz=timezone.utc) pour obtenir un datetime conscient de l'UTC, puis appelez astimezone() avec un fuseau ZoneInfo comme America/New_York uniquement si vous avez besoin d'un affichage local. Sans tz, Python utilise l'heure locale de l'hôte et renvoie un datetime naïf, si bien que les résultats varient d'un serveur à l'autre.
Pourquoi mon timestamp converti affiche-t-il une date en 1970 ?
Une date proche de 1970 signale presque toujours une confusion d'unités : une valeur en secondes a été lue comme des millisecondes, et l'instant tombe juste après l'epoch Unix, le 1er janvier 1970 à 00:00:00 UTC. Confirmez l'unité source à partir du contrat de schéma au lieu de la deviner d'après le nombre de chiffres.
America/New_York est-il équivalent à UTC-5 ?
Non. UTC-5 est un décalage fixe qui décrit un seul moment, alors qu'America/New_York est un fuseau IANA nommé qui intègre les règles d'heure d'été et les changements historiques. Si vous ne stockez que le décalage, vous perdez l'identité du lieu et chaque changement de règle associé, et les heures locales dérivent.
Que doit stocker un pipeline de timestamps en plus du datetime formaté ?
Conservez la valeur numérique d'origine, l'unité source, la précision cible, le fuseau horaire utilisé pour l'affichage et le résultat de validation. La valeur brute sert de champ d'audit et le datetime n'est que la couche de présentation : les deux doivent accompagner l'enregistrement à chaque étape du pipeline.
Quels cas limites les tests de conversion de timestamps doivent-ils couvrir ?
Commencez par zéro et les valeurs négatives antérieures à l'epoch, les fractions de seconde, les valeurs nulles et les chaînes non numériques, ainsi que les moments de changement d'heure où des heures locales se répètent ou disparaissent. Ajoutez des dates proches des limites de votre base ou de votre runtime et vérifiez qu'un aller-retour renvoie le même instant.


