Qu'est-ce qu'un fichier Parquet et pourquoi il porte l'analytique
|
8
minute de lecture

Apache Parquet est un format de fichier open source et orienté colonnes pour les données analytiques. Sa structure commence par un nombre magique de 4 octets PAR1 et se termine par un pied de page qui stocke le schéma, l'emplacement des row groups et des statistiques. Les données sont rangées par colonne dans des row groups, des column chunks et des data pages, ce qui permet aux moteurs de requête d'écarter des colonnes et d'ignorer les row groups non pertinents avant toute lecture lourde.
Sur la question qu'est-ce qu'un fichier Parquet, vous vivez probablement l'une de ces deux frustrations. Soit vos requêtes d'entrepôt analysent bien plus de données que nécessaire, soit votre lac est devenu un mélange désordonné de CSV, de JSON et d'exports à moitié documentés auxquels personne ne se fie vraiment. Dans les deux cas, le format de fichier n'est pas un détail d'implémentation mineur. Il détermine le coût, la vitesse et la sécurité avec laquelle les équipes en aval peuvent bâtir dessus.
Pensez à un flux analytique courant. Une développeuse BI a besoin du chiffre d'affaires par région et par mois. Le jeu de données brut comporte des dizaines de champs supplémentaires, des attributs imbriqués et des partitions historiques. Si ces données résident dans des fichiers texte orientés lignes, le moteur doit souvent tout parcourir simplement pour répondre à une question étroite. Parquet a changé ce modèle opérationnel en devenant un format d'échange pratique pour les systèmes analytiques, surtout dans les lacs de données et les entrepôts modernes, car il a été conçu autour de lectures sélectives plutôt que d'analyses de fichiers complets.
Cela dépasse la performance. Les décisions de format influent aussi sur la fiabilité. Si des changements de schéma arrivent, si les dossiers de partitions s'écartent des attentes ou si les statistiques n'aident plus le moteur à ignorer les plages obsolètes, les équipes le ressentent sous forme de tableaux de bord cassés, de traitements coûteux et d'incidents difficiles à déboguer. C'est pourquoi les équipes plateforme traitent souvent Parquet à la fois comme un format de stockage et comme un standard opérationnel.
Sommaire
Comment fonctionne le stockage en colonnes et pourquoi cela compte
À l'intérieur d'un fichier Parquet : des row groups aux pages
Encodage, compression et métadonnées, moteurs de la performance
Travailler avec Parquet dans Spark, Presto, Pandas et les lacs partitionnés
Fiabiliser les données Parquet par l'observabilité et les contrôles qualité
Introduction : ce qu'est vraiment un fichier Parquet
Un fichier Parquet est un format de stockage conçu pour le travail analytique, en particulier lorsque les équipes interrogent de grands jeux de données mais n'ont besoin que de quelques champs à chaque fois.
Partons d'un problème d'entrepôt familier. Une développeuse BI ouvre une requête de tableau de bord pour le chiffre d'affaires par canal et par mois. Les données source contiennent des paramètres de campagne, des détails d'appareil, des traits utilisateur, des charges utiles d'événements et plusieurs colonnes dont personne n'a besoin pour cette question. Si ces enregistrements sont en CSV ou en JSON, le moteur doit souvent lire tout ce matériel malgré tout, car chaque ligne garde tous les champs regroupés.
Parquet change ce modèle opérationnel. Il stocke les données par colonne, si bien que les moteurs de requête peuvent se concentrer sur les champs référencés par la requête au lieu de traîner chaque attribut dans le chemin de lecture. La documentation Apache Parquet le décrit comme un format open source orienté colonnes pour données analytiques, et sa structure de fichier inclut le nombre magique PAR1 ainsi que des métadonnées de pied de page telles que les informations de schéma et l'emplacement des row groups (documentation du format de fichier Apache Parquet).
Ce choix de disposition ne joue pas que sur la vitesse.
Dans un vrai lac de données, les décisions de format se voient sur la facture mensuelle, dans la latence des tableaux de bord et dans la gestion des incidents. Un format qui autorise les lectures sélectives aide à réduire les coûts d'analyse. Un format dont le schéma et les métadonnées sont intégrés au fichier donne aux plateformes davantage de matière à valider, surveiller et diagnostiquer. Si un producteur ajoute des colonnes, change des types ou écrit les partitions de façon incohérente, ces problèmes se détectent plus facilement quand le format porte une information structurelle plus riche que du texte brut.
C'est pour cette raison que Parquet est devenu un standard dans les lacs et les entrepôts. Il offre à Spark, Trino, Hive, Pandas, DuckDB et aux moteurs d'entrepôt cloud un format commun adapté aux schémas d'accès analytiques. Pour les ingénieurs analytics, cela signifie moins de compromis entre interopérabilité et performance. Pour les équipes plateforme, cela signifie que Parquet n'est pas qu'une extension de fichier. C'est un choix opérationnel portant sur la maîtrise des coûts, l'élagage des requêtes, la stabilité du schéma et la confiance que les équipes en aval peuvent accorder à ce qu'elles lisent.
Comment fonctionne le stockage en colonnes et pourquoi cela compte
La plupart des confusions autour de Parquet commencent ici. On entend orienté colonnes et on suppose que cela veut seulement dire « mieux compressé ». La compression fait partie de l'histoire, mais l'idée plus large tient à la disposition physique des données.
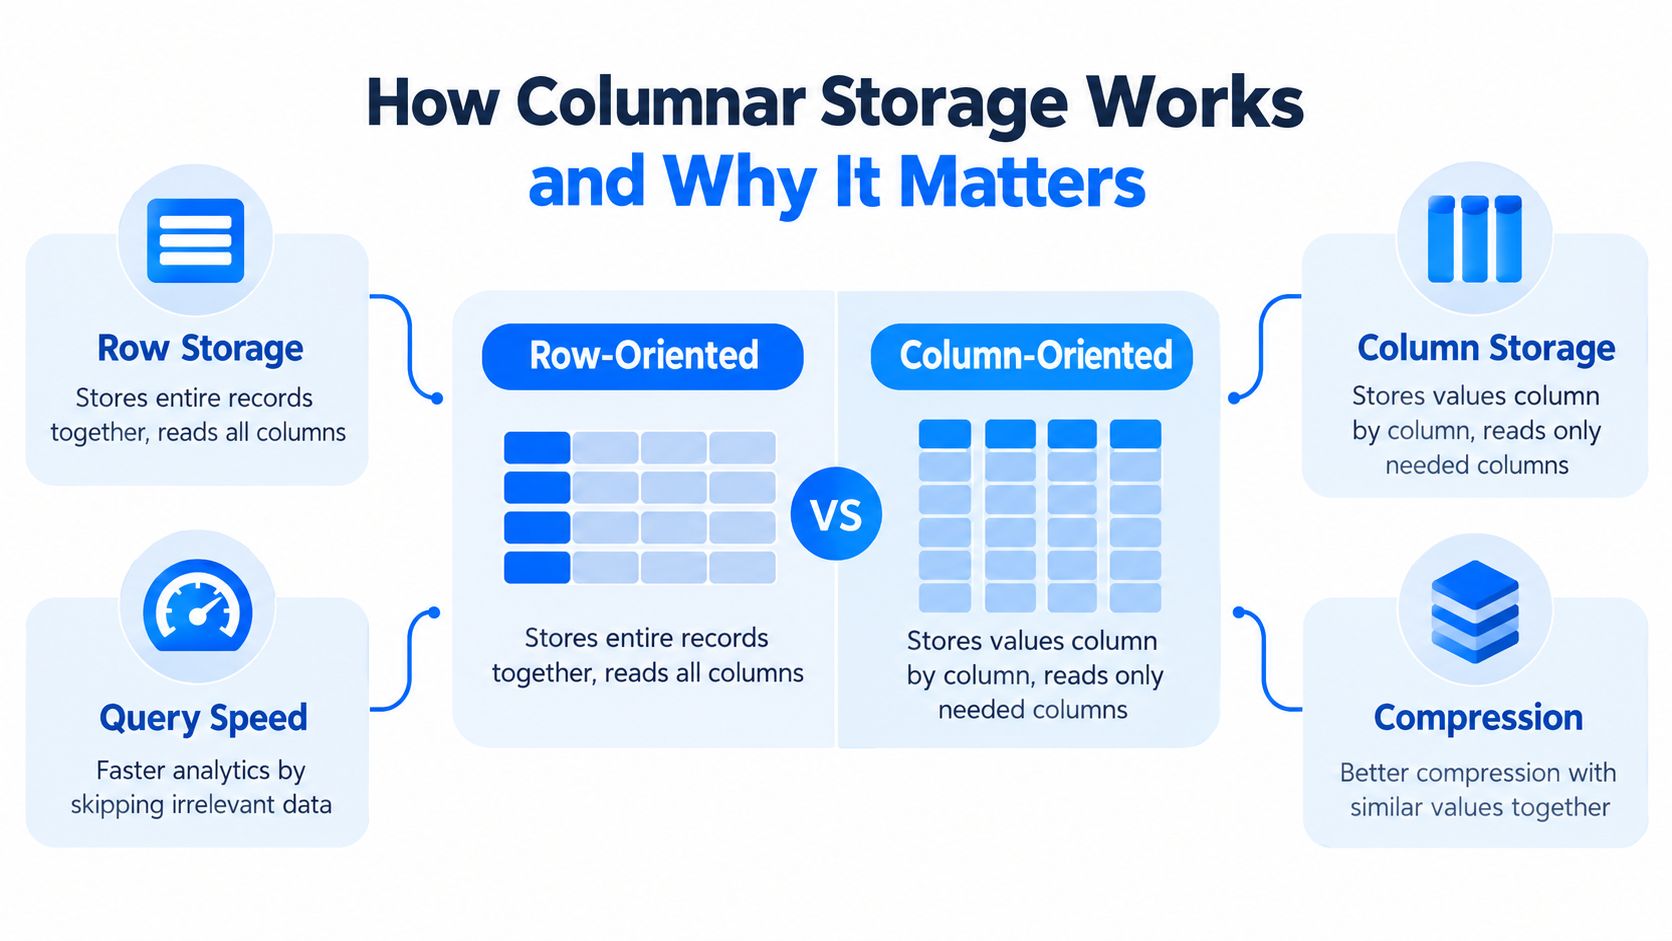
Les lignes servent aux enregistrements, les colonnes aux questions
Imaginez un tableur avec les colonnes order_id, country, order_date et amount.
Dans un format orienté lignes, le stockage ressemble à des enregistrements compactés :
commande 1 : tous les champs ensemble
commande 2 : tous les champs ensemble
commande 3 : tous les champs ensemble
Dans un format orienté colonnes, le stockage regroupe les valeurs par champ :
toutes les valeurs
order_idensembletoutes les valeurs
countryensembletoutes les valeurs
order_dateensembletoutes les valeurs
amountensemble
Cela paraît abstrait jusqu'à ce qu'on applique une requête. Si votre outil BI demande le montant total par pays, il n'a pas besoin de chaque champ de chaque enregistrement. Avec un stockage en colonnes, le moteur peut se limiter aux colonnes pertinentes.
Pourquoi les moteurs analytiques en profitent
Les requêtes analytiques parcourent souvent beaucoup de lignes mais référencent relativement peu de colonnes. C'est exactement le schéma d'accès que Parquet favorise.
Un modèle mental pratique :
Le planificateur de requêtes examine les colonnes demandées.
Le moteur ne lit que ces segments de colonne.
Les champs non pertinents restent sur le disque ou dans le stockage objet.
Cette lecture sélective explique pourquoi les équipes consacrent tôt du temps aux décisions d'architecture des systèmes de données. La disposition du stockage et le moteur de requête doivent coopérer, sinon vous payez des analyses que vous n'avez jamais voulu lancer.
Quand on dit que Parquet est rapide, on veut généralement dire que le moteur évite du travail avant de lire l'essentiel du fichier.
Pourquoi les valeurs similaires aident aussi la compression
Le stockage en colonnes regroupe également les types de données similaires et les valeurs répétées. Une colonne country comportant de nombreux codes répétés se compresse différemment d'une ligne mixte où s'entremêlent horodatages, décimaux, booléens et chaînes.
C'est important car les systèmes analytiques ne se soucient pas seulement de la taille sur disque. Des segments de colonne plus petits et plus homogènes peuvent réduire les E/S et rendre les analyses plus faciles à traiter pour les moteurs. L'avantage n'est donc pas unique. Il naît de la combinaison de lectures sélectives et de données naturellement plus favorables à l'optimisation du stockage.
Retenez cette règle empirique :
Choisissez des formats orientés lignes lorsque vous devez lire ou écrire fréquemment des enregistrements entiers.
Choisissez des formats en colonnes lorsque vous agrégez, filtrez et parcourez quelques champs sur de nombreux enregistrements.
C'est pourquoi Parquet apparaît si souvent dans les data marts, les couches curées du lac et les pipelines proches de l'entrepôt.
À l'intérieur d'un fichier Parquet : des row groups aux pages
Beaucoup savent que Parquet est orienté colonnes mais n'arrivent pas à se représenter le contenu du fichier. C'est là que l'optimisation des performances devient floue. Sans comprendre la hiérarchie, difficile d'expliquer pourquoi un jeu de données s'élague bien et un autre analyse trop.
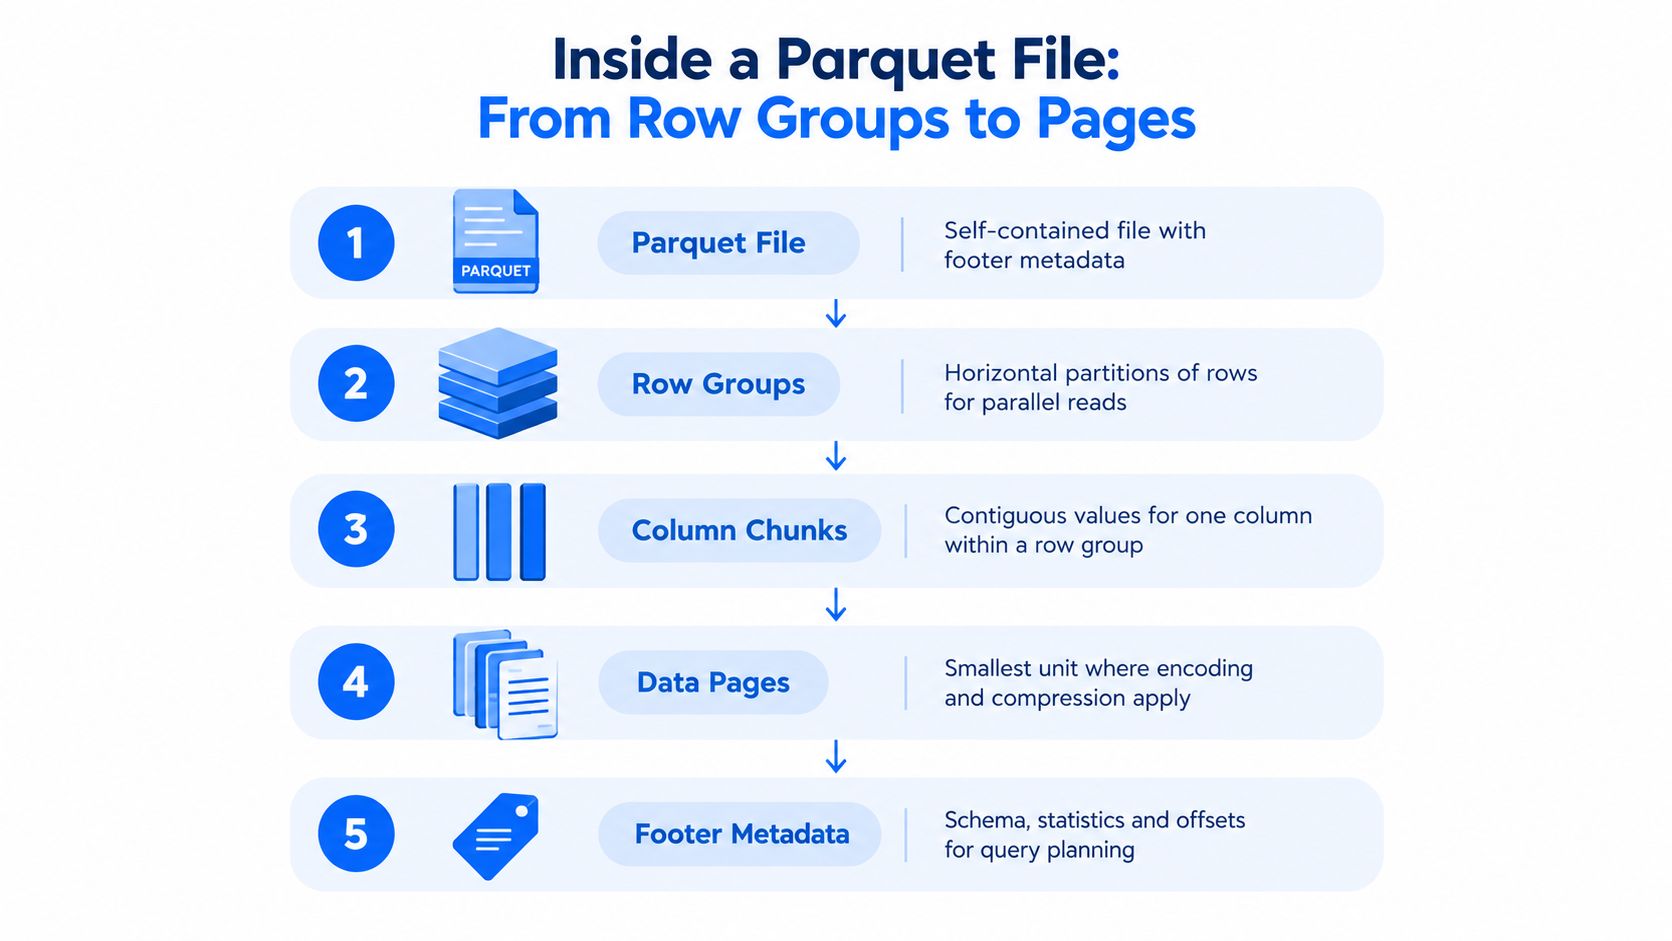
Commencer au niveau du fichier
Un fichier Parquet est autonome. Le projet Apache précise que le format est ouvert et que la spécification du format de fichier et la définition Thrift doivent être lues ensemble pour comprendre le fonctionnement de la structure (documentation Apache Parquet).
À haut niveau, le fichier contient :
Des sections de données qui contiennent les valeurs réelles des colonnes
Un pied de page qui décrit ce qui se trouve à l'intérieur
Des décalages et des métadonnées qui aident les lecteurs à trouver rapidement les bons éléments
Ce pied de page est le centre de contrôle. Il indique au moteur le schéma, l'emplacement des row groups et les statistiques disponibles pour planifier la lecture.
La hiérarchie interne
La structure de Parquet est organisée en couches très précises :
Row groups
Ce sont des partitions horizontales de lignes au sein du fichier. Un row group contient la même plage de lignes pour toutes les colonnes.Column chunks
Dans chaque row group, chaque colonne reçoit son propre bloc de données contigu.Data pages
Dans chaque column chunk, les valeurs sont stockées en unités plus petites appelées pages.
Dans les environnements de lac riches en métadonnées, cette hiérarchie est étroitement liée à la gestion des métadonnées. Plus les équipes suivent clairement les schémas, les partitions et la structure des fichiers, plus il est simple de diagnostiquer le comportement d'analyse et les ruptures liées au schéma.
Pourquoi les row groups comptent en exploitation
Les row groups sont plus qu'un détail de stockage. Ils déterminent la quantité de données qu'un moteur peut ignorer et la façon dont le travail se parallélise.
Supposons qu'une requête filtre sur une plage de dates étroite. Si les statistiques de row group montrent que certains groupes ne contiennent que des dates anciennes, le moteur peut les ignorer au lieu de les parcourir. C'est la valeur pratique des métadonnées intégrées : elles raccourcissent les lectures avant même le décodage.
Un jeu de données Parquet sain n'est pas seulement valide. Il est organisé pour que les moteurs puissent dire « non » rapidement aux lectures inutiles.
Ce que le pied de page indique au moteur
Le pied de page stocke des métadonnées telles que :
Les informations de schéma
L'emplacement des row groups
Des statistiques, dont min/max et le nombre de valeurs nulles
Ces statistiques comptent en exploitation car elles permettent aux moteurs d'écarter les données non pertinentes avant de les parcourir, une des raisons pour lesquelles Parquet est devenu un format d'échange de fait pour l'analytique, comme le décrit la documentation du format de fichier Apache Parquet citée plus haut.
Si vous vous êtes déjà demandé pourquoi une table paraît « vive » dans Trino ou Spark et une autre non, la réponse se cache souvent ici. Les deux fichiers peuvent être du Parquet, mais la disposition interne, les frontières des row groups et la qualité des métadonnées peuvent produire des comportements d'exécution très différents.
Encodage, compression et métadonnées, moteurs de la performance
Un fichier Parquet fait économiser de l'argent et accélère les requêtes pour trois raisons distinctes. Il stocke les valeurs efficacement grâce à l'encodage, réduit les octets encodés par la compression et fournit aux moteurs des métadonnées qui leur évitent de lire d'emblée des données non pertinentes.
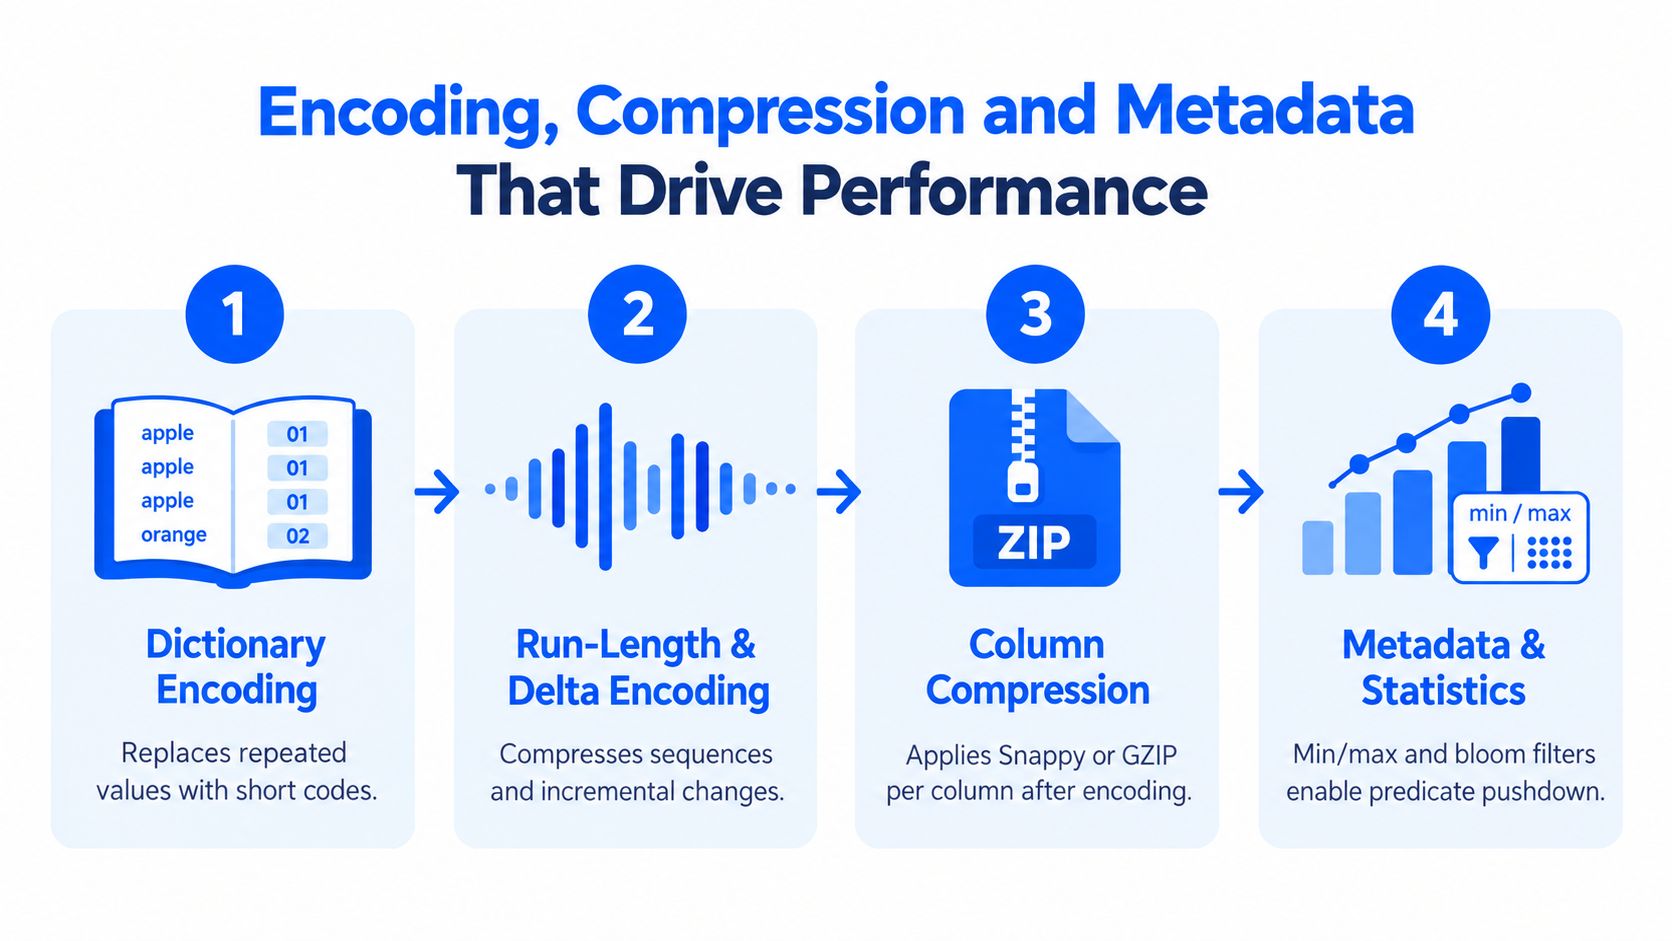
L'encodage vient en premier
L'encodage modifie la représentation des valeurs avant l'exécution de tout codec de compression. La documentation du format Parquet répertorie des encodages tels que dictionnaire, run-length et delta comme faisant partie de la conception du fichier (spécification d'encodage Parquet).
En clair :
L'encodage par dictionnaire stocke les valeurs répétées sous forme de références courtes au lieu de répéter la valeur complète à chaque fois.
L'encodage run-length stocke de façon compacte les longues séries d'une même valeur.
L'encodage delta stocke les écarts entre valeurs voisines, ce qui fonctionne bien pour des séquences qui montent ou descendent progressivement.
Une développeuse BI ressent cette différence sans voir les octets directement. Une colonne pays avec beaucoup de valeurs répétées ou une colonne d'horodatage aux incréments prévisibles offre à Parquet des motifs qu'il stocke bien plus efficacement que du texte brut.
La compression réduit les octets encodés
Une fois les valeurs encodées, Parquet peut compresser séparément les données de chaque colonne. C'est important car une colonne contient généralement un seul type de données et un seul type de motif. Une colonne de statut se comporte autrement qu'une colonne de prix, et Parquet laisse chacune se compresser selon ses propres règles.
C'est pourquoi « Parquet est compressé » ne dit qu'une partie de l'histoire. La compression réduit le stockage et les E/S réseau, mais c'est souvent l'encodage qui crée la répétition que la compression peut exploiter. Dans les plateformes cloud, cela se traduit par un coût de stockage plus faible et moins d'octets lus pendant les analyses.
Les métadonnées guident les plus grandes décisions de performance
C'est avec les métadonnées que Parquet passe du statut de format de stockage à celui de choix opérationnel.
Si un analyste filtre sur order_date >= '2026-01-01', le moteur peut ignorer de larges portions du fichier avant de décoder la moindre valeur. Il le peut parce que Parquet stocke des statistiques et des détails structurels qui l'aident à écarter les row groups et les pages incapables de satisfaire le filtre. Moins lire signifie des tableaux de bord plus rapides, des dépenses de requête plus faibles et des performances plus prévisibles sous charge partagée.
Ces mêmes métadonnées jouent aussi sur la fiabilité. Si les détails de schéma dérivent, si des statistiques manquent ou si les valeurs de partition ne correspondent pas au contenu des fichiers, les équipes perdent à la fois en vitesse et en confiance. L'élagage des requêtes s'affaiblit. Le diagnostic ralentit. Les contrats de données deviennent plus difficiles à faire respecter.
Voilà pourquoi le travail sur les métadonnées relève des discussions sur la qualité des données, et pas seulement sur le stockage. Les équipes qui investissent dans des pratiques de métadonnées améliorant la qualité et l'efficacité des données obtiennent généralement deux bénéfices à la fois : un meilleur comportement d'analyse et une détection plus précoce des problèmes de schéma ou de partition.
Dans les lacs d'entreprise, des fichiers Parquet bien écrits font plus que reposer à bas coût dans le stockage objet. Ils aident les moteurs à éviter du travail, les équipes à repérer les dérives et les responsables plateforme à empêcher la dégradation des performances et de la fiabilité au fil du temps.
Parquet face à CSV, JSON et ORC : les arbitrages expliqués
Parquet est populaire, mais il n'est pas la réponse à toutes les questions de stockage. Les équipes choisissent mieux quand elles comparent les formats par charge de travail au lieu de supposer qu'un format doit gagner partout.
Commencer par la distinction simple
CSV et JSON sont souvent plus simples aux frontières d'ingestion. Ils sont lisibles, portables et familiers à presque tout le monde. Mais cette commodité peut coûter cher lorsque les mêmes fichiers servent à des requêtes analytiques répétées.
Parquet est plus fort quand les lecteurs ont besoin d'un accès sélectif, d'un schéma typé et d'analyses efficaces. ORC est également orienté colonnes et entre souvent dans la conversation dans les environnements très tournés vers l'entrepôt. Le choix pratique dépend de vos outils, de vos habitudes d'écriture et de qui doit inspecter les données directement.
Choisir entre formats en lignes et en colonnes
Format | Idéal pour | Efficacité de stockage | Schéma de requête |
|---|---|---|---|
CSV | Exports simples, inspection manuelle, échange léger | Plus faible pour les charges analytiques | Les lectures portent généralement sur le contenu complet de la ligne |
JSON | Échange semi-structuré flexible et charges utiles d'API | Souvent plus faible pour l'analytique car la structure se répète dans le fichier | Bon pour l'échange entre applications, moins efficace pour des analyses répétées |
Parquet | Jeux de données analytiques, couches curées du lac, stockage adapté à la BI | Élevée pour les données analytiques car les colonnes sont stockées séparément et optimisées individuellement | Optimal quand les requêtes lisent un sous-ensemble de colonnes sur de nombreuses lignes |
ORC | Analytique en colonnes dans les écosystèmes déjà standardisés dessus | Élevée pour les charges analytiques | Bonne adéquation aux lectures analytiques, surtout là où la prise en charge d'ORC est déjà établie |
Comment décider en pratique
Utilisez Parquet lorsque ces conditions sont réunies :
Vos requêtes sont sélectives : les analystes demandent régulièrement quelques colonnes sur de larges plages de dates.
Vous avez besoin d'un comportement de schéma plus robuste : le stockage typé aide quand les modèles et tableaux de bord en aval dépendent de champs cohérents.
Le coût de stockage compte : des empreintes analytiques plus petites peuvent réduire la surcharge d'analyse.
Restez sur CSV ou JSON lorsque ces conditions dominent :
Des humains doivent inspecter les fichiers directement : pour un coup d'œil rapide, le texte reste gagnant.
Les systèmes amont émettent d'abord des enregistrements bruts : les zones d'atterrissage restent souvent orientées lignes avant curation.
La simplicité d'écriture prime sur l'optimisation de lecture : certaines pipelines veulent le format d'export le plus simple possible en périphérie.
ORC entre en jeu quand votre stack penche déjà dans cette direction. Si vos moteurs, vos standards de gouvernance ou vos conventions de plateforme favorisent ORC, ce peut être le meilleur choix organisationnel. Le propos n'est pas que Parquet batte tout. C'est que Parquet l'emporte souvent quand les équipes analytiques optimisent pour des lectures répétées, une gestion prévisible du schéma et une large compatibilité d'écosystème.
Travailler avec Parquet dans Spark, Presto, Pandas et les lacs partitionnés
Un format devient utile quand il s'accorde aux outils déjà en place. C'est le cas de Parquet. L'écosystème Apache Parquet et la Library of Congress le décrivent comme largement pris en charge par de nombreux langages et outils analytiques, et le projet tient un historique formel des versions dans le dépôt parquet-format (dépôt Apache parquet-format).
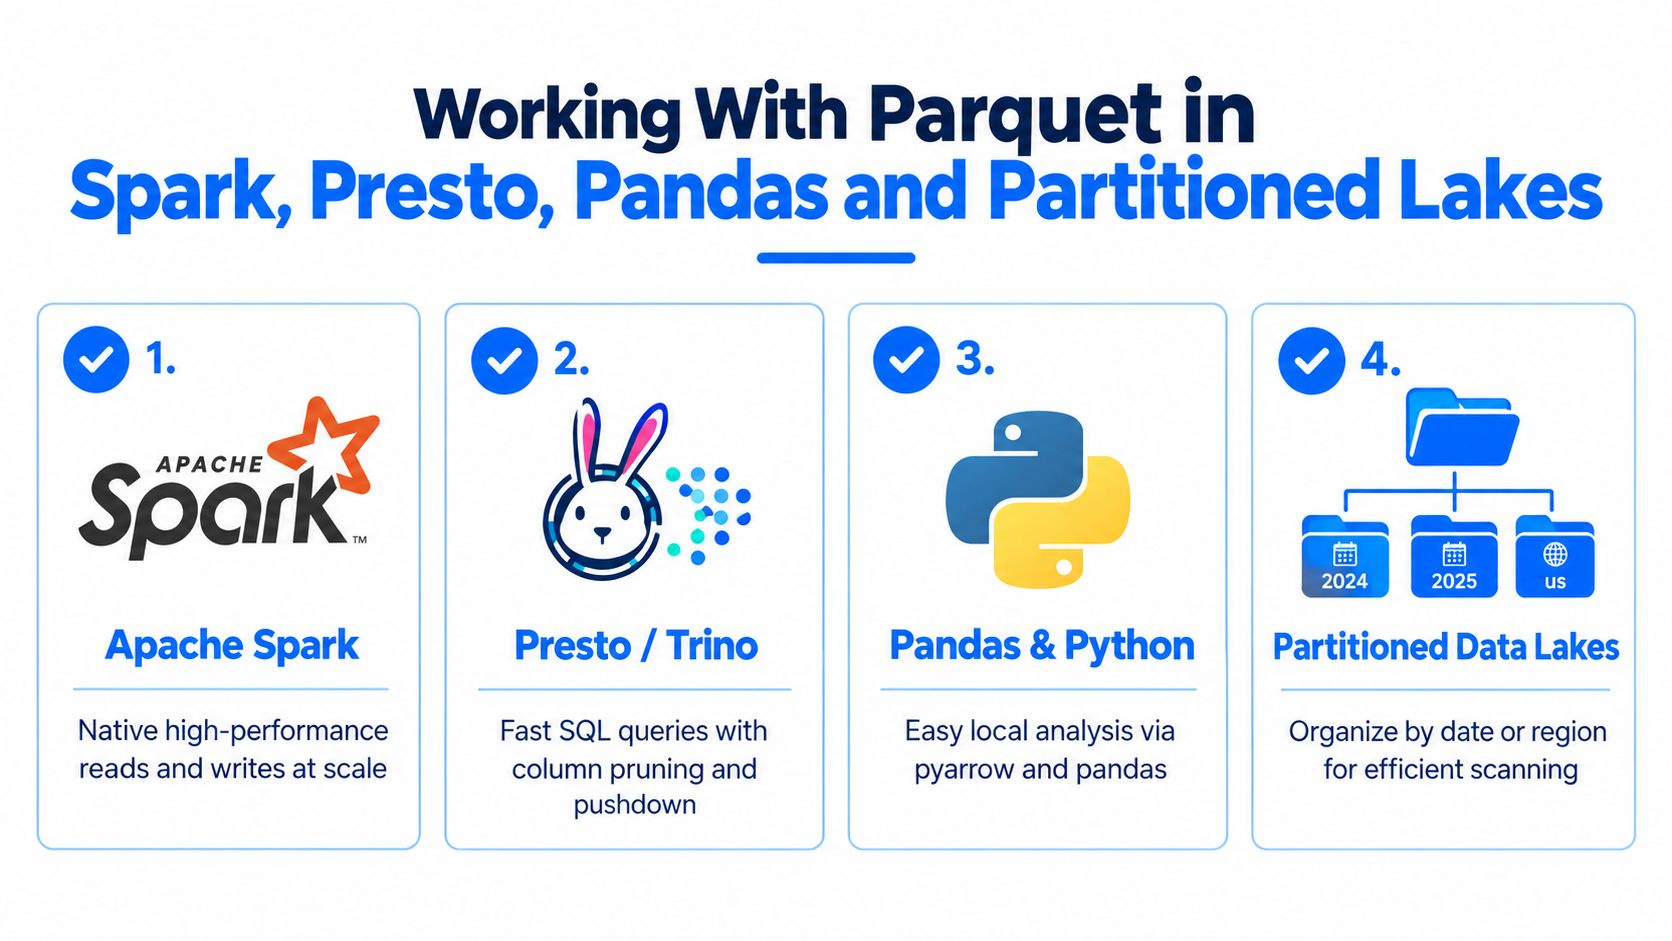
À quoi cela ressemble dans de vraies pipelines
Dans Spark, Parquet convient naturellement aux lectures et écritures distribuées de grande taille. Dans Presto ou Trino, l'élagage de colonnes et le predicate pushdown sont centraux pour un SQL rapide sur les données du lac. Dans Pandas, les équipes lisent souvent Parquet via des outils fondés sur Arrow pour l'analyse locale et les flux de développement.
Cette large prise en charge explique en partie pourquoi Parquet est devenu le choix par défaut pour les jeux de données partagés. Les outils n'ont pas besoin d'adaptateurs spécifiques pour participer.
Pour les équipes exploitant des pipelines de type lakehouse sur Databricks, l'observabilité de plateforme de données pour les environnements Databricks devient pertinente dès que le nombre de jeux de données et le volume de traitements augmentent. Les problèmes de disposition des fichiers, les partitions tardives et les incohérences de schéma se manifestent d'abord comme du bruit opérationnel, pas comme des erreurs de format évidentes.
La liste de contrôle pratique
Parquet fonctionne au mieux quand les équipes gèrent le jeu de données, et pas seulement le fichier individuel.
Partitionnez avec retenue : organisez les données selon des champs alignés sur les filtres courants, comme la date ou la région, sans faire exploser l'arborescence en fragments minuscules.
Évitez les petits fichiers : trop de fichiers Parquet minuscules peuvent annuler les bénéfices d'un bon format, car les moteurs passent du temps à ouvrir et planifier de nombreux objets.
Traitez l'évolution du schéma avec soin : ajouter des colonnes reste souvent gérable. Les changements de type incompatibles sont le point où pipelines et tableaux de bord commencent à casser.
Standardisez les habitudes d'écriture : des conventions mélangées entre producteurs créent des frictions évitables pour les lecteurs en aval.
Le format de fichier peut être correct alors que le jeu de données reste difficile à exploiter. L'essentiel des difficultés avec Parquet vient d'erreurs de disposition, de partitionnement ou de gestion du schéma.
Une habitude opérationnelle qui paie
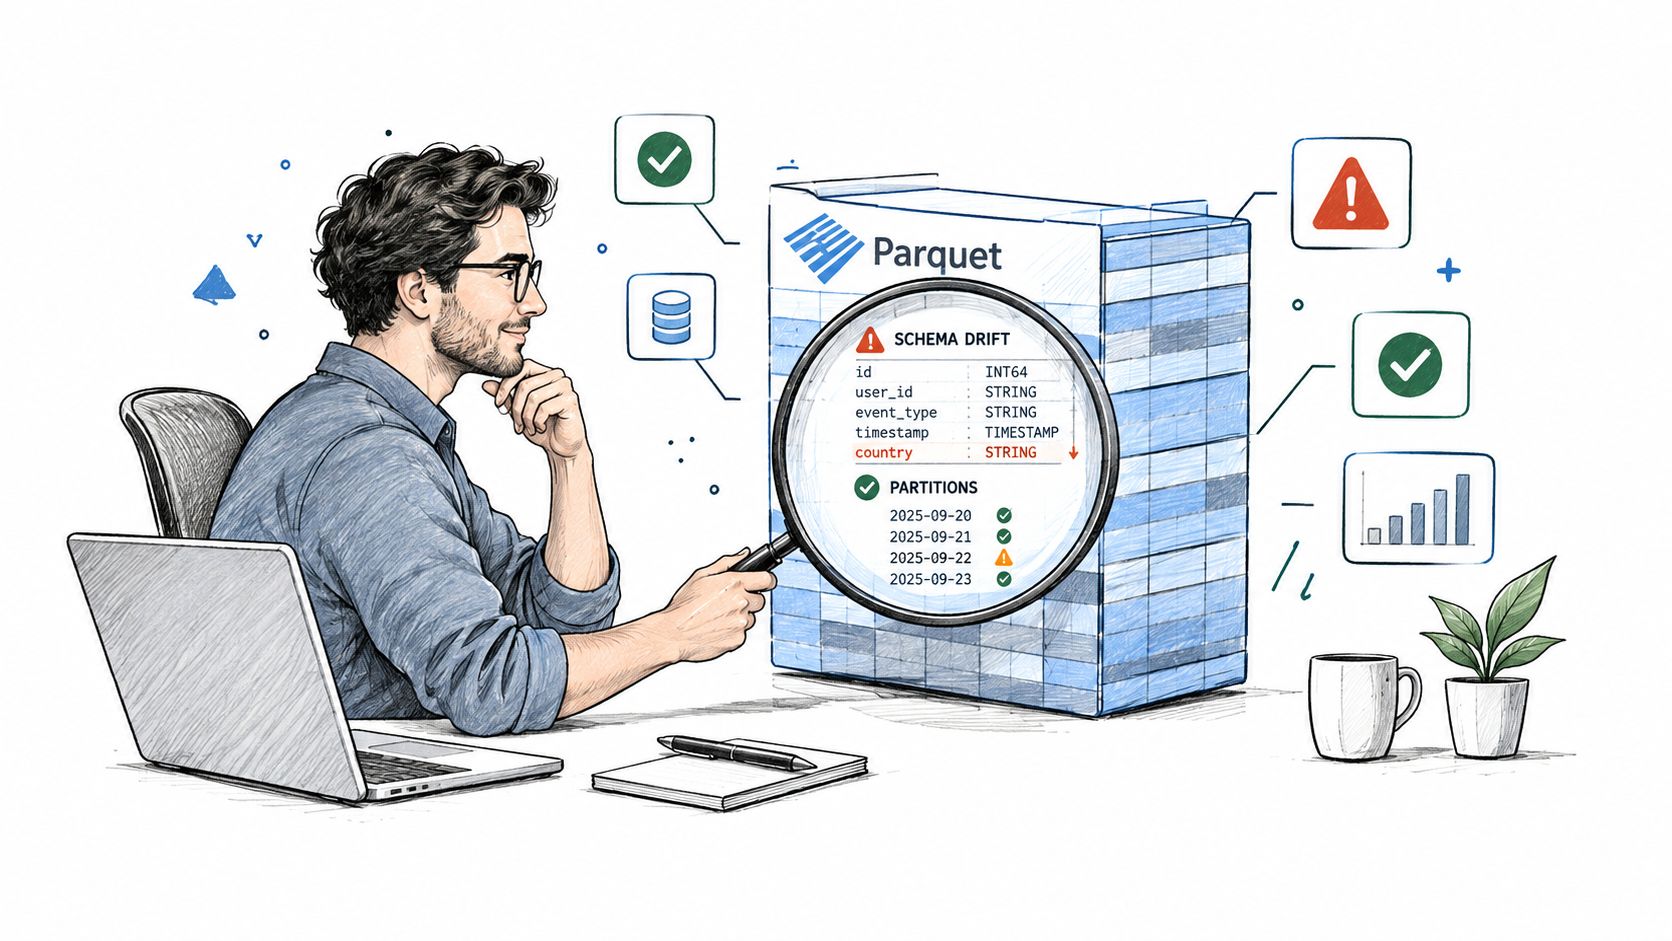
Suivez délibérément la dérive de schéma. Si un producteur écrit customer_id en chaîne et un autre différemment, le problème ne se manifeste pas toujours par une écriture en échec. Il apparaît parfois plus tard sous forme de valeurs nulles déroutantes, de partitions ignorées ou d'un modèle BI qui ne compile plus.
C'est là que l'observabilité rejoint la maîtrise du format. Une option utilisée par les équipes est digna, qui s'exécute dans l'environnement du client et peut surveiller les changements de schéma, la Timeliness, les anomalies et les contrôles de validation sur les jeux de données de lac et d'entrepôt. Dans les plateformes riches en Parquet, ces contrôles aident à repérer les cas où les fichiers restent techniquement lisibles mais dangereux en exploitation.
Fiabiliser les données Parquet par l'observabilité et les contrôles qualité
Un fichier Parquet peut être parfaitement valide et provoquer malgré tout un tableau de bord cassé le lundi matin. C'est la partie que beaucoup d'équipes apprennent à leurs dépens.
Où les problèmes de fiabilité apparaissent réellement
Les modes de défaillance courants n'ont rien d'exotique :
Un producteur ajoute ou supprime des colonnes et les transformations en aval ne s'adaptent pas proprement.
Une partition arrive en retard, si bien que le tableau de bord d'hier paraît complet sans l'être.
Les valeurs des données se décalent alors que la structure du fichier semble toujours correcte.
Le nombre de fichiers explose et les moteurs passent plus de temps à gérer des objets qu'à lire des données utiles.
Aucun de ces problèmes ne se règle en disant « nous utilisons Parquet ». Le format apporte un stockage efficace et des métadonnées utiles. Il ne garantit pas que les producteurs écrivent des schémas cohérents ni que les traitements livrent les données à l'heure.
Que surveiller autour des jeux de données Parquet
Une exploitation fiable de Parquet comprend généralement des contrôles dans quelques catégories :
Suivi de schéma : détectez les champs ajoutés, supprimés ou modifiés avant que les lecteurs en aval échouent.
Contrôles de Timeliness : vérifiez que les partitions ou chargements attendus arrivent quand ils le doivent.
Validation des données : confirmez que les règles métier tiennent toujours après transformations et réécritures.
Détection d'anomalies : repérez les variations inhabituelles du nombre de lignes, des motifs de valeurs nulles ou des indicateurs métier.
Les équipes qui mettent en place des pratiques d'observabilité des données autour des jeux du lac détectent ces problèmes plus tôt, surtout lorsque les contrôles s'exécutent près des données plutôt qu'après la rupture des rapports.
Un format de fichier valide n'équivaut pas à un jeu de données fiable. La fiabilité vient de la surveillance du comportement, de la structure et de la livraison dans la durée.
Si vous expliquez à d'autres ce qu'est un fichier Parquet, voilà la réponse mûre à leur laisser. Parquet est un format en colonnes puissant pour l'analytique. Ses row groups, column chunks, pages et métadonnées rendent possibles les lectures sélectives. Mais à l'échelle de l'entreprise, le critère de succès n'est pas seulement la rapidité des requêtes. C'est la confiance que les équipes peuvent accorder aux données qu'elles renvoient.
digna donne aux équipes un moyen de surveiller, dans leur propre environnement, le comportement autour des jeux de données Parquet, y compris les changements de schéma, la Timeliness, les anomalies et les contrôles de validation sur les lacs, les entrepôts et les pipelines. Si vous vous standardisez sur Parquet et voulez l'efficacité du format sans angles morts sur la fiabilité, rendez-vous sur digna.
Exécuter ces contrôles en continu, plutôt que par sondage une fois le tableau de bord cassé, c'est précisément à quoi sert l'observabilité de plateforme de données.
Questions fréquentes
Qu'est-ce qu'un fichier Parquet ?
Apache Parquet est un format de fichier open source orienté colonnes conçu pour les charges analytiques. Chaque fichier commence par un nombre magique PAR1 de 4 octets et se termine par un pied de page contenant le schéma, l'emplacement des row groups et les statistiques de colonnes, ce qui permet aux moteurs de requête d'ignorer les données qu'ils n'ont jamais besoin de lire.
En quoi un fichier Parquet diffère-t-il d'un fichier CSV ?
CSV stocke les valeurs ligne par ligne : le moteur analyse donc chaque champ de chaque ligne même si la requête ne touche que trois colonnes. Parquet regroupe les valeurs de chaque colonne, si bien que les moteurs ne lisent que ce qui est demandé. CSV reste plus simple aux frontières d'ingestion ; Parquet paie sur des requêtes analytiques répétées.
Que sont les row groups, column chunks et pages dans Parquet ?
Ce sont trois couches imbriquées à l'intérieur du fichier. Un row group est une tranche horizontale de la table ; à l'intérieur, les valeurs de chaque colonne résident dans un column chunk ; chaque chunk se divise en pages, les unités que Parquet encode et compresse réellement. La taille du row group détermine ce qu'une requête peut ignorer.
L'avantage de vitesse de Parquet tient-il seulement à la compression ?
La compression n'est qu'une des trois raisons. L'encodage — dictionnaire, run-length, delta — restructure les valeurs avant tout codec, la compression réduit ensuite ces octets encodés colonne par colonne, et les métadonnées du pied de page évitent au moteur d'ouvrir les row groups non pertinents. Les métadonnées font généralement gagner plus de temps que les octets économisés sur disque.
Quels outils peuvent lire les fichiers Parquet ?
Parquet est pris en charge par Spark, Presto et Trino, par Pandas via des outils fondés sur Arrow, et par la plupart des moteurs proches de l'entrepôt. Spark convient aux lectures et écritures distribuées de grande taille, Presto et Trino s'appuient sur l'élagage de colonnes et le predicate pushdown, et Pandas sert à l'analyse locale. Suivez la dérive de schéma entre producteurs, car les types divergents ressurgissent plus tard sous forme de valeurs nulles déroutantes.



