Patron de conception de données : guide pour les équipes modernes
|
8
minute de lecture

Votre équipe dispose d'un data warehouse, d'un pipeline de streaming et de dashboards qui ne s'accordent pas sur le même indicateur client. Un analyste fait confiance à la table finance, un autre à un data mart départemental, et un troisième a ajouté un filtre pour que le rapport d'hier concorde. Le problème ne vient pas forcément de la technologie de base de données. Il vient du fait que personne ne s'est mis d'accord sur le patron de conception de données, c'est-à-dire les règles qui déterminent comment l'information est structurée, gouvernée et contrôlée une fois en production.
Un bon patron ne se limite pas à produire un joli schéma d'architecture. Il donne aux ingénieurs une méthode reproductible pour capturer les données, relier les faits associés, servir différentes charges de travail et révéler les défaillances avant que les utilisateurs ne prennent des décisions sur la base d'informations erronées. Les patrons les plus solides rendent aussi la responsabilité explicite, définissent les changements acceptables et conservent la preuve de ce que le système savait à un instant donné.
Table des matières
Ce qu'est vraiment un patron de conception de données
Les équipes se tournent généralement vers un patron après le premier désaccord douloureux. Un pipeline fonctionne pour un service, puis une autre équipe a besoin des mêmes données avec une définition, un calendrier de livraison ou un historique différents. Les ingénieurs commencent à ajouter des exceptions. Les analystes créent des transformations en double. Au bout du compte, l'organisation dispose de plusieurs réponses à une question qui ne devrait en avoir qu'une.
Considérez un patron de conception de données comme une recette de cuisine. La recette n'impose ni la marque du four ni la couleur des assiettes. Elle précise les ingrédients, l'ordre de préparation, les relations entre les composants et les vérifications qui indiquent au cuisinier si le plat peut être servi sans risque. Un patron de données fait de même pour les systèmes d'information.

La structure n'est que la première couche
Un patron est une réponse réutilisable à un problème de conception récurrent. Il peut organiser des faits et des dimensions analytiques, conserver chaque événement métier, centraliser des définitions partagées ou permettre aux domaines de publier des data products selon des standards communs. Le patron fournit à l'équipe un vocabulaire pour prendre des décisions avant que les détails d'implémentation ne prennent le dessus.
Un schéma d'architecture montre des composants et des connexions. Un patron va plus loin en expliquant pourquoi ces composants existent et comment ils se comportent face au changement. Deux schémas peuvent se ressembler tout en produisant des résultats très différents si l'un définit la responsabilité, l'historique et la validation, et que l'autre laisse ces questions sans réponse.
Un patron pratique répond à trois questions :
Comment les données sont-elles structurées ? Identifier les entités, les événements, les relations, le grain, les clés, l'historique et les modèles de mise à disposition.
Comment les données sont-elles gouvernées ? Définir la responsabilité, le nommage, la signification métier, l'accès, le lignage et les règles de compatibilité.
Comment les défaillances deviennent-elles visibles ? Préciser les attentes de fraîcheur, les contrôles de validation, la surveillance des schémas, les seuils d'anomalie et l'escalade.
Règle pratique : si un patron n'explique pas ce qui se passe lorsqu'un chargement est en retard ou qu'un champ change de type, c'est une ébauche structurelle, pas une conception opérationnelle.
Cette distinction compte avant même de choisir un data warehouse, un lakehouse, un message broker ou un outil d'orchestration. La technologie peut implémenter un patron, mais elle ne peut pas décider si l'historique des adresses d'un client doit figurer dans un flux d'événements immuable, dans une table d'état courant, ou dans les deux. L'équipe doit d'abord prendre cette décision, puis l'appliquer de manière cohérente.
Comment l'entrepôt de données d'entreprise a donné naissance aux premiers patrons
À la fin des années 1980, les entreprises cherchaient à transformer des informations dispersées dans leurs systèmes opérationnels en un outil d'analyse exploitable par les dirigeants. Un article de l'IBM Systems Journal publié en 1988 employait l'expression « business data warehouse », une étape importante dans la formalisation de l'idée d'intégrer les informations de plusieurs systèmes opérationnels pour l'analyse métier. William Inmon a ensuite développé le patron d'entrepôt orienté entreprise et publié Building the Data Warehouse en 1992.
Prenons un établissement de santé qui cherche à répondre à une question simple : combien chaque service a-t-il dépensé pour un épisode de soins d'un patient ? Les systèmes sources peuvent enregistrer séparément les rendez-vous, les demandes de remboursement, les paiements et les informations sur les praticiens. Selon l'approche d'Inmon, l'organisation commence par rassembler des données détaillées, historisées et intégrées dans un entrepôt d'entreprise central. La couche d'intégration réduit les définitions incohérentes avant que les équipes en aval ne reçoivent des sous-ensembles thématiques. Le patron d'Inmon utilise généralement des structures relationnelles normalisées, qui favorisent la traçabilité et réduisent la redondance au niveau de la couche partagée.
Cette approche considère l'entrepôt comme le registre de sens, soigneusement tenu, de l'organisation. Une équipe finance et une équipe des opérations cliniques peuvent toujours recevoir des vues différentes, mais toutes deux héritent des mêmes fondations gouvernées.
L'approche dimensionnelle de Ralph Kimball part d'une autre question : quel processus métier les utilisateurs doivent-ils analyser ? Sa méthode, formalisée dans The Data Warehouse Toolkit, publié pour la première fois en 1996, a popularisé les tables de faits, les tables de dimensions, les schémas en étoile et les dimensions conformes. L'équipe santé pourrait construire une table de faits des demandes de remboursement reliée aux dimensions patient, praticien, service, payeur et temps. Les analystes peuvent interroger directement le processus métier sans naviguer dans un modèle d'entreprise fortement normalisé.
La plupart des organisations combinent les deux philosophies. Elles conservent une couche canonique ou intégrée pour le sens partagé, le lignage et la gouvernance, puis publient des data marts dimensionnels pour le reporting et l'analyse des KPI. Cette approche hybride reste visible dans les architectures modernes d'entrepôt de données d'entreprise, même lorsque l'infrastructure sous-jacente est un data warehouse cloud ou un lakehouse.
La leçon durable est simple. L'endroit où réside la vérité et la manière dont elle est consommée sont des décisions liées, mais ce ne sont pas les mêmes décisions.
La modélisation dimensionnelle en pratique
Une équipe commerciale demande rarement : « Puis-je explorer votre modèle relationnel normalisé ? » Elle demande : « Combien avons-nous vendu, à qui, dans quel magasin et sur quelle période ? » La modélisation dimensionnelle fonctionne bien parce qu'elle organise les données autour de ces questions métier.
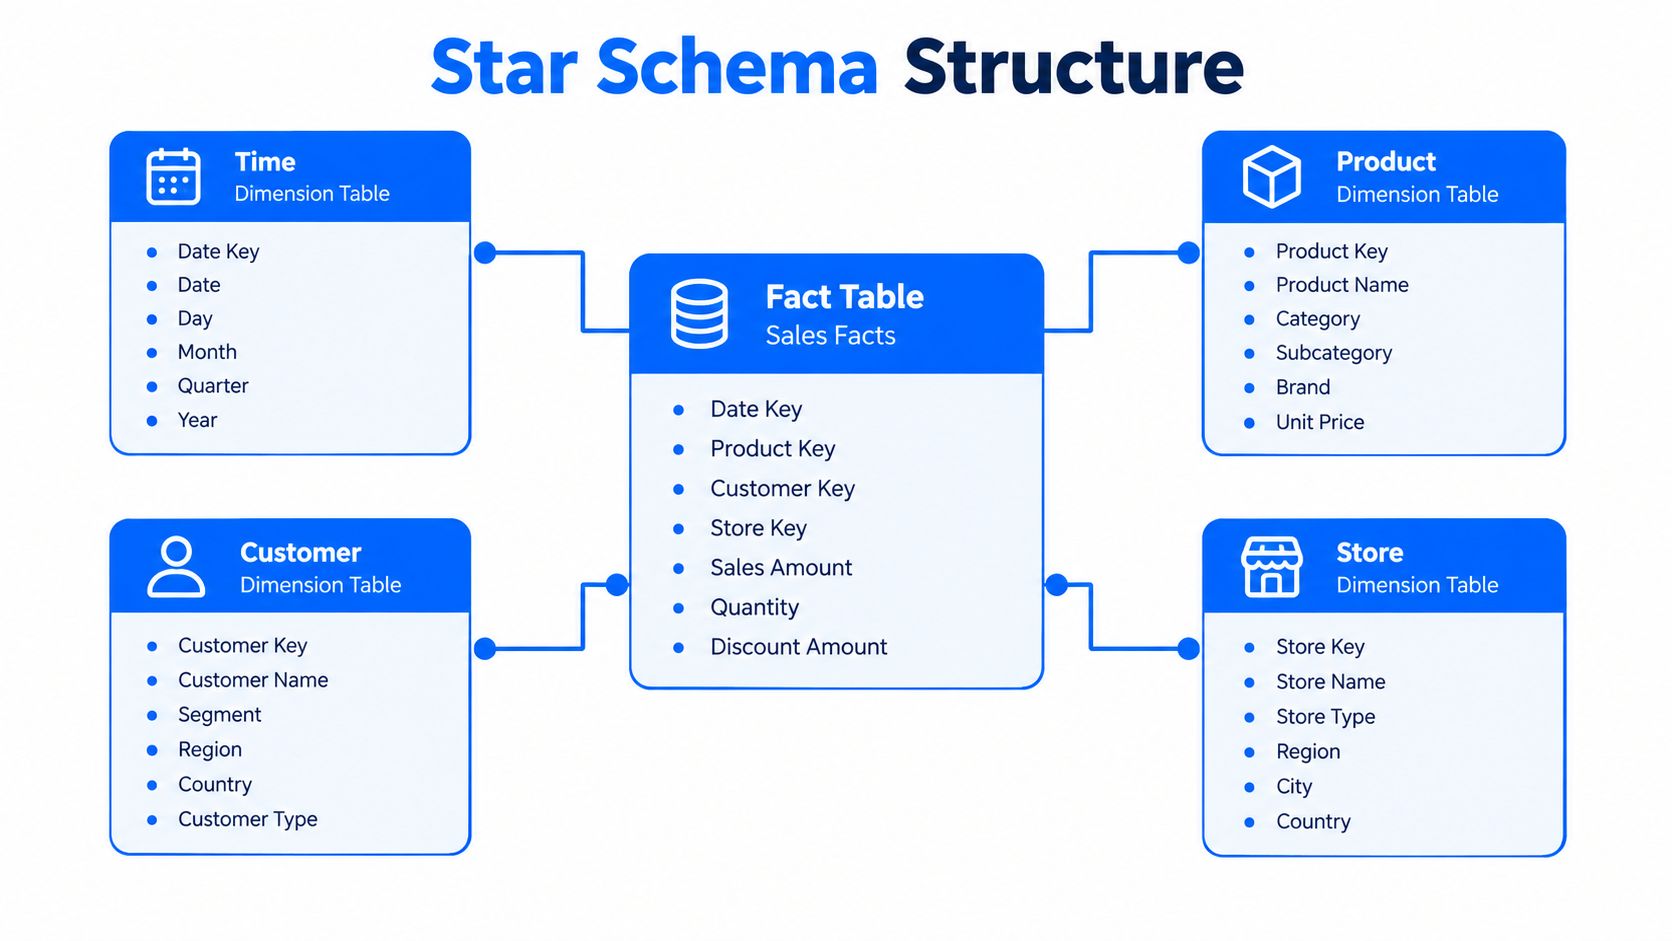
Partez d'un événement mesurable, comme une ligne de commande. La table de faits stocke les détails numériques et opérationnels de l'événement, notamment la quantité, le chiffre d'affaires, la remise, l'horodatage de la commande, la clé produit, la clé client et la clé magasin. Les tables de dimensions fournissent le contexte descriptif qui rend chaque ligne utile. La dimension produit décrit l'article, la dimension client décrit l'acheteur, la dimension magasin décrit le lieu, et la dimension temps fournit les attributs calendaires et de reporting.
Le grain avant les colonnes
Avant d'ajouter des champs, énoncez le grain en une phrase : « Une ligne représente un produit dans une commande. » Cette phrase évite une erreur courante : mélanger des valeurs au niveau de la commande et au niveau de la ligne dans la même table de faits. Si le chiffre d'affaires est répété sur plusieurs lignes produit, une simple somme peut surestimer les ventes.
Une dimension conforme utilise la même définition métier dans tous les data marts. Si la dimension client signifie « client facturé » en finance mais « utilisateur final » dans l'analytique produit, le nom partagé crée une fausse cohérence. Les équipes doivent définir la signification, les clés, l'historique et les relations valides, puis mettre ces règles à la disposition de chaque consommateur. Les recommandations sur les tables de faits et de dimensions peuvent aider les équipes à établir ce vocabulaire avant de construire leurs rapports.
L'exactitude historique impose un autre choix de conception. Supposons qu'un client passe du segment petite entreprise au segment grand compte. Une dimension d'état courant affichera le dernier segment, mais un rapport de ventes historique peut avoir besoin du segment en vigueur au moment de chaque commande. Les techniques de dimensions à évolution lente (slowly changing dimensions) conservent l'historique approprié, selon que l'entreprise souhaite garder les valeurs précédentes, les écraser ou enregistrer des périodes de validité.
Là où le patron trouve toute sa place
La modélisation dimensionnelle est rentable lorsque les questions dominantes portent sur combien, à quelle fréquence, où, quand ou par qui. Les schémas en étoile sont accessibles aux analystes, permettent des jointures prévisibles et facilitent le partage de la logique des KPI. Un contrat stable entre faits et dimensions offre aussi aux équipes qualité des points de contrôle clairs pour l'intégrité référentielle, les taux de valeurs nulles, les clés en double et les mesures inattendues.
Le patron montre ses limites lorsque la charge de travail repose sur des documents irréguliers, des événements non structurés à fort volume ou la reconstruction, avec une exigence d'audit, de chaque changement d'état. Il peut représenter ces entrées, mais forcer chaque problème dans un schéma en étoile masque souvent l'historique des événements d'origine. C'est pourquoi de nombreuses plateformes matures conservent des enregistrements bruts ou canoniques et exposent des data marts dimensionnels comme couche de mise à disposition.
Event sourcing et logique append-only
Un solde bancaire ressemble à une valeur d'état courant, mais le rapprochement dépend de l'historique qui le sous-tend. Si un solde est modifié à tort et que le système ne stocke que le dernier chiffre, les enquêteurs n'ont aucun moyen fiable de reconstituer la façon dont il a été obtenu.
L'event sourcing adopte l'approche inverse. Au lieu de mettre à jour une ligne de solde sur place, le système enregistre des événements tels qu'un dépôt, un retrait, un virement ou une correction. Le solde courant devient une projection calculée à partir de cet historique ordonné.

Des événements à un état exploitable
Le patron comporte trois éléments pratiques :
Event store append-only : chaque changement métier est enregistré comme un nouvel événement. Les événements existants ne sont jamais écrasés.
Projection : un consommateur lit les événements et construit une représentation interrogeable, comme le solde courant du compte.
Rejeu et correction : si la logique de projection change ou si l'état est corrompu, l'équipe peut le reconstruire à partir de l'historique des événements.
Une correction n'efface pas la transaction d'origine. Elle ajoute un événement compensatoire qui préserve la chronologie. Le système devient ainsi utile pour l'audit, le débogage, l'analyse historique et la reproduction d'incidents.
Le modèle de lecture peut ne pas se mettre à jour exactement au même moment que le journal d'événements. Les équipes doivent donc accepter et communiquer une cohérence à terme (eventual consistency) là où elle convient au processus métier. Elles ont aussi besoin d'un versionnage des événements, de consommateurs idempotents, de règles d'ordonnancement, de décisions de rétention et d'une stratégie de snapshots lorsque le rejeu d'un long historique devient coûteux.
Le choisir pour la traçabilité, pas par effet de mode
L'event sourcing est une base solide lorsque l'entreprise doit répondre à la question : « Que s'est-il passé, dans quel ordre, et pourquoi l'état actuel est-il ainsi ? » Les grands livres financiers, les historiques de workflows, les mouvements de stock et les événements de domaine distribués sont des candidats naturels.
Ce n'est pas un bon choix par défaut pour toutes les applications CRUD. Les lectures deviennent plus complexes, car les utilisateurs ont souvent besoin d'une projection plutôt que du journal source. Les équipes doivent maintenir le code de projection et gérer une convergence différée. Une table d'état courant classique peut être plus claire lorsque l'entreprise n'a besoin que de la dernière valeur et n'exige pas d'historique reconstituable.
Les équipes lakehouse peuvent combiner une ingestion orientée événements avec un format de table ouvert et des modèles de mise à disposition matérialisés. La présentation des formats de table ouverts apporte un contexte utile pour séparer l'historique durable des données des modèles que les consommateurs interrogent.
Le journal d'événements est la preuve. La projection en est l'interprétation pratique.
Modèles canoniques contre responsabilité par domaine
Un modèle canonique stipule que l'organisation doit s'accorder sur des définitions partagées au niveau d'une couche d'intégration. Un modèle porté par les domaines stipule que l'équipe la plus proche d'une capacité métier doit publier un data product exploitable et assumer la responsabilité de sa qualité.
Aucune de ces positions ne résout tous les problèmes. Un modèle central peut éviter les définitions contradictoires, mais une équipe centrale peut devenir une file d'attente pour chaque changement. Un modèle par domaine peut rapprocher les décisions de la source, mais des équipes distinctes peuvent publier des significations incompatibles pour « client », « compte actif » ou « commande finalisée ».
Dimension | Modèle canonique | Data Mesh |
|---|---|---|
Responsabilité | Une équipe centrale data ou d'intégration assure la gestion des définitions partagées | Les équipes de domaine sont propriétaires des data products issus de leurs capacités métier |
Gouvernance | Des règles d'entreprise cohérentes sont plus faciles à appliquer de manière centralisée | Des standards fédérés coordonnent les équipes sans retirer la responsabilité aux domaines |
Rapidité de livraison | Les changements transverses aux domaines peuvent nécessiter une revue et un alignement centralisés | Les domaines peuvent itérer plus rapidement dans le cadre de règles d'interopérabilité partagées |
Risque | L'équipe centrale peut devenir un goulet d'étranglement ou s'éloigner du contexte des sources | Les définitions, la qualité et les interfaces peuvent diverger en l'absence de contrats solides |
Les arguments en faveur du modèle canonique
Les modèles canoniques conviennent aux organisations qui ont besoin d'un vocabulaire réglementaire commun, de contrôles financiers partagés ou d'une traçabilité entre services. La couche d'intégration joue le rôle d'un dictionnaire. Elle résout les différences entre systèmes sources avant que les analystes et les applications ne consomment les données.
Le coût, c'est la coordination. Une équipe centrale doit comprendre de nombreux domaines, gérer les demandes de changement et maintenir la pertinence du modèle à mesure que l'activité évolue. Si elle devient le seul groupe autorisé à publier des données utiles, la livraison ralentit et les experts métier perdent leur responsabilité.
Les arguments en faveur des domaines
Le data mesh attribue la responsabilité à des domaines tels que la facturation, la logistique ou le support client. Chaque domaine publie ses données comme un produit, avec une documentation, des attentes de qualité, des contrôles d'accès et un engagement de service. Une couche de gouvernance fédérée définit toujours des règles partagées en matière d'interopérabilité, de sécurité et de découvrabilité.
Cela ne fonctionne que si les équipes de domaine disposent des compétences et de la capacité nécessaires pour exploiter des data products. L'organisation doit fournir un outillage commun et faire respecter les contrats, sans quoi la décentralisation se traduit par des pipelines dupliqués reposant sur des hypothèses différentes. Les équipes qui travaillent sur les frontières entre domaines peuvent aussi tirer profit de ce guide sur la modélisation des agrégats pour le SaaS, en particulier lorsque la responsabilité métier et les frontières des systèmes doivent être alignées.
Un compromis pragmatique consiste à conserver une couche canonique pour les concepts partagés à haut risque et à laisser les domaines publier des produits spécialisés autour d'elle. La gouvernance fédérée des données peut soutenir cet équilibre en définissant ce qui doit être cohérent partout et ce que les domaines peuvent adapter localement.
Comparaison des trois patrons fondamentaux
Les trois patrons résolvent des problèmes principaux différents. La modélisation dimensionnelle optimise la navigation analytique. L'event sourcing préserve une séquence de changements. La modélisation canonique établit un sens partagé entre les systèmes et les équipes.
Leurs différences apparaissent plus clairement lorsqu'on les évalue au regard de la charge de travail plutôt que des préférences personnelles.
Critère | Modélisation dimensionnelle | Event sourcing | Modèle canonique |
|---|---|---|---|
Performance des requêtes | Excellente pour les requêtes BI et les agrégations répétées | Nécessite souvent des projections ou des snapshots pour des lectures pratiques | Dépend de la couche de mise à disposition, les structures normalisées peuvent nécessiter des modèles en aval |
Adéquation à la gouvernance | Contrats clairs sur les métriques et les dimensions | Historique et traçabilité solides, avec une discipline accrue de gestion des événements | Idéal pour les définitions centrales, le lignage et les données partagées réglementées |
Préparation à l'IA | Utile pour des features sélectionnées et des métriques métier labellisées | Précieux pour le rejeu, les features temporelles et les historiques comportementaux | Utile pour des features cohérentes et une sémantique partagée entre domaines |
Coût opérationnel | Modéré, avec la maintenance de la modélisation et des dimensions historiques | Plus élevé, car les journaux, projections, versionnages et rejeux doivent être exploités | Coût de coordination plus élevé, surtout lorsque de nombreux domaines dépendent de changements centraux |
Meilleure question de départ | « Que doivent agréger et comparer les utilisateurs ? » | « Quelle séquence a produit cet état ? » | « Quelle définition chaque système doit-il partager ? » |
Le tableau ne désigne pas de vainqueur universel, car une plateforme réelle a souvent besoin des trois. Une couche canonique peut établir des définitions partagées pour les clients, les produits et les données financières. Des data marts dimensionnels peuvent transformer ces définitions en modèles de reporting accessibles. Des journaux d'événements peuvent conserver les preuves nécessaires pour rejouer ou auditer les changements importants.
Diagnostiquer la charge de travail dominante
Demandez à l'équipe quelle défaillance ferait le plus de dégâts :
Un rapport lent ou confus : commencez par la modélisation dimensionnelle et définissez le grain de chaque table de faits.
Un changement d'état impossible à tracer : conservez les événements et construisez des projections à partir de l'historique append-only.
Des définitions d'entreprise contradictoires : établissez des concepts canoniques, une responsabilité claire et un contrôle des changements.
Des entrées d'IA qui dérivent sans prévenir : ajoutez une surveillance comportementale et une responsabilité claire au patron structurel que vous choisissez, quel qu'il soit.
La préparation à l'IA n'est pas qu'une question de stockage. Les embeddings, les distributions de features, les résultats de recherche (retrieval) et la ponctualité des entrées de modèle peuvent changer alors que le schéma de table reste valide. Un patron qui ne gouverne que les colonnes peut passer à côté d'une défaillance sémantique.
Pourquoi un schéma propre ne suffit pas
Un tableau blanc peut montrer un flux soigné allant des systèmes sources vers un data warehouse, un data mart, un dashboard et un modèle. Il ne peut pas montrer qui reçoit l'alerte lorsque le fichier d'hier arrive en retard, quelle règle valide le montant d'une demande de remboursement, ni comment un auditeur prouve qu'un rapport a utilisé les bonnes données à un instant donné du passé.
Cet écart transforme l'architecture en risque opérationnel. Un patron fiable définit le comportement de livraison attendu, l'emplacement des validations, la responsabilité, la politique de compatibilité et les preuves conservées après chaque chargement important.
Placer les contrôles de confiance au plus près des flux de données
Une équipe qui choisit un patron doit préciser des contrôles à trois niveaux :
Ingestion : vérifier l'arrivée, le volume, la structure de base, les doublons et les champs obligatoires.
Transformation : valider les règles métier, les relations, les valeurs acceptées et la logique de rapprochement.
Consommation : surveiller le comportement des KPI, la fraîcheur visible par les utilisateurs, les défaillances en aval et l'adéquation des entrées de modèle.
L'évolution des schémas mérite le même traitement. L'ajout de champs nullables peut rester compatible avec les consommateurs existants, alors qu'une restriction de type ou un renommage sémantique peut les casser. Les partitionnements physiques doivent rester, autant que possible, un détail d'implémentation, afin que les consommateurs interrogent des tables logiques plutôt que des chemins de répertoires codés en dur. L'évolution pilotée par les métadonnées, telle que documentée dans les recommandations de conception d'Apache Iceberg, permet de modifier l'organisation physique tandis que les fichiers historiques conservent leurs spécifications d'origine.
Les preuves changent la norme
Plus de 56 % des répondants à une enquête sur l'analytics engineering ont cité la qualité des données comme le défi le plus fréquemment rencontré, tandis que 38 % prévoyaient d'augmenter leurs investissements dans la qualité des données ou l'observabilité au cours de l'année suivante, selon le State of Analytics Engineering 2025 de dbt. Ces chiffres étayent une conclusion pratique : la gouvernance et l'observabilité ont leur place dans le patron, pas dans un backlog d'exploitation ultérieur.
Une conception digne de confiance rend les mauvaises données plus faciles à trouver, à expliquer, à contenir et à corriger.
Pour chaque jeu de données critique, consignez le responsable, le comportement de livraison attendu, la version du schéma, les résultats de validation, le lignage et l'historique des incidents. Définissez ensuite ce qui se passe lorsqu'un contrôle échoue. Le pipeline s'arrête-t-il, met-il des enregistrements en quarantaine, publie-t-il un avertissement ou continue-t-il avec un statut dégradé explicite ? La bonne réponse dépend de l'impact métier, mais ne pas la préciser garantit des réactions incohérentes.
Choisir et rendre opérationnel votre patron
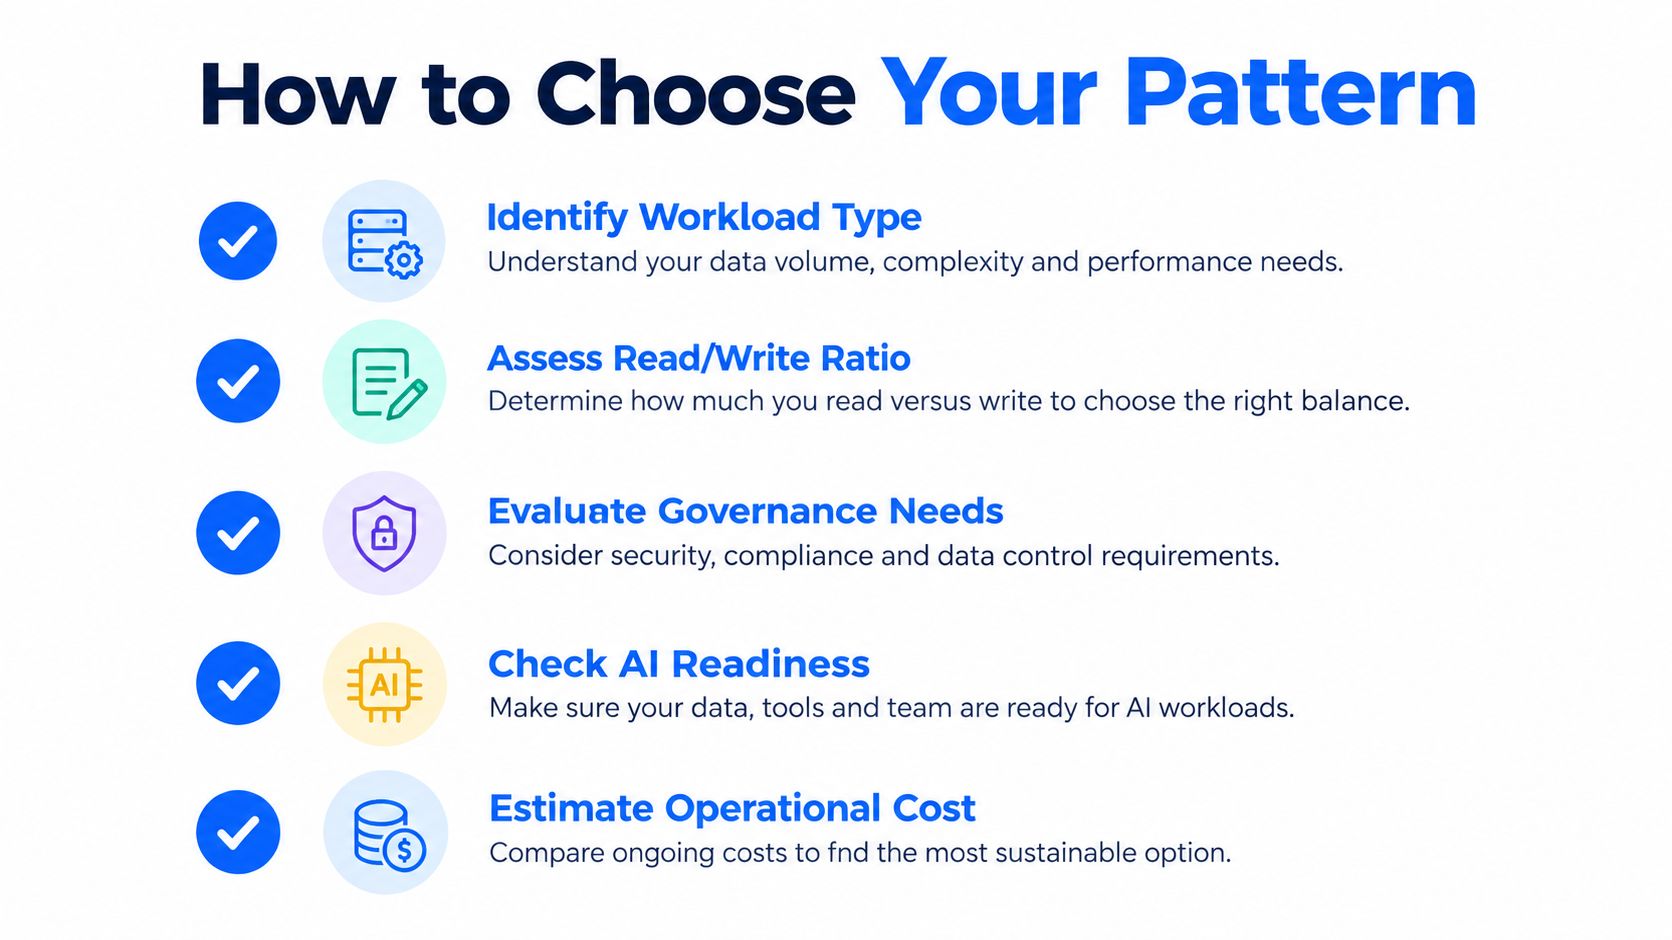
Organisez une courte revue de conception et consignez cinq décisions :
Identifiez la charge de travail dominante. Le reporting, l'audit, la mise à disposition opérationnelle, la réaction en temps réel et la génération de features pour l'IA nécessitent des structures différentes.
Choisissez le patron principal. Sélectionnez le modèle qui résout le problème le plus important, puis ajoutez délibérément des couches complémentaires.
Définissez des contrats. Précisez le grain, les clés, les significations, les attentes de fraîcheur, la compatibilité des schémas et la responsabilité.
Associez des contrôles. Ajoutez la surveillance des arrivées, la validation des enregistrements, la détection d'anomalies, les alertes de dérive de schéma, le lignage et les preuves historiques.
Testez le comportement en cas de défaillance. Simulez des données en retard, des valeurs inattendues, des changements structurels, des événements en double et des reconstructions de projections.
Pour les charges de travail d'IA, étendez la checklist au-delà des colonnes. Décidez comment l'équipe détectera la dérive des embeddings, l'évolution des distributions de features, la dégradation des résultats de recherche (retrieval) et les entrées de modèle obsolètes. Une table techniquement valide peut tout de même produire un modèle peu fiable si son comportement change sans qu'un responsable n'en réponde.
Une plateforme comme celle décrite dans l'approche de digna en matière de gestion des data products peut s'intégrer à cette couche opérationnelle en combinant validation in-database, surveillance de la ponctualité, détection d'anomalies et suivi des changements de schéma au sein même de l'environnement du client. La décision importante ne porte pas uniquement sur l'outil. Elle consiste à savoir si le patron donne à des personnes identifiées suffisamment de preuves pour agir lorsque les données cessent de se comporter comme prévu.
digna aide les équipes à surveiller le comportement de leurs données au sein de leur propre environnement grâce à la validation in-database, à la surveillance de la ponctualité, à la détection d'anomalies et au suivi des changements de schéma. Si vous transformez un schéma d'architecture statique en contrat de confiance opérationnel, rendez-vous sur digna pour découvrir comment la plateforme peut vous accompagner dans cette démarche.
Comme une restriction de type ou un renommage sémantique peut casser les consommateurs alors que tous les pipelines continuent de tourner, le Schema Tracker de digna enregistre les changements structurels des tables surveillées, afin que la politique de compatibilité de votre patron soit adossée à une alerte.
Questions fréquentes
Qu'est-ce qu'un patron de conception de données ?
Un patron de conception de données est une réponse réutilisable à un problème de données récurrent, qui couvre trois aspects : la façon dont les données sont structurées, la façon dont elles sont gouvernées et la façon dont les défaillances deviennent visibles. Comme une recette, il définit les ingrédients, l'ordre et les vérifications, pas la marque du four, et guide ainsi les décisions avant le choix de tout data warehouse ou outil.
Quelle est la différence entre les approches d'Inmon et de Kimball ?
Inmon part d'un entrepôt d'entreprise central et normalisé qui intègre un historique détaillé avant que les équipes ne reçoivent des sous-ensembles thématiques. Kimball part du processus métier et construit des tables de faits, des tables de dimensions et des schémas en étoile pour une analyse directe. La plupart des organisations combinent les deux, en conservant une couche intégrée pour le sens partagé et en publiant des data marts dimensionnels pour le reporting.
Pourquoi faut-il définir d'abord le grain d'une table de faits ?
Énoncer le grain, par exemple une ligne par produit dans une commande, évite de mélanger des valeurs au niveau de la commande et au niveau de la ligne dans la même table. Sans cela, un chiffre d'affaires répété sur plusieurs lignes produit est additionné plusieurs fois et surestime les ventes. La phrase définissant le grain doit être rédigée avant l'ajout de toute colonne.
Quand utiliser l'event sourcing plutôt qu'une table d'état courant ?
Utilisez l'event sourcing lorsque l'entreprise doit expliquer ce qui s'est passé, dans quel ordre, et pourquoi l'état actuel est tel qu'il est. Les grands livres financiers, les historiques de workflows et les mouvements de stock s'y prêtent bien. Pour les applications CRUD qui n'ont besoin que de la dernière valeur, une simple table est plus claire, car les projections et la cohérence à terme ajoutent un réel coût d'exploitation.
Une plateforme de données doit-elle utiliser un modèle canonique ou un data mesh ?
Souvent les deux. Un compromis pragmatique consiste à conserver une couche canonique pour les concepts partagés à haut risque, comme les définitions client, produit et financières, tandis que les équipes de domaine publient des data products spécialisés autour d'elle. La gouvernance fédérée décide alors de ce qui doit être cohérent partout et de ce que les domaines peuvent adapter localement, ce qui évite à la fois un goulet d'étranglement central et des définitions divergentes.


