Analyse des dangers opérationnels pour les équipes data
|
6
minute de lecture

Beaucoup d'équipes traitent encore l'analyse des dangers opérationnels comme un simple exercice de validation. Elles rédigent la checklist, approuvent la mise en production et supposent que le tableau des risques restera stable jusqu'à la prochaine revue. Cette habitude ne tient plus dans les opérations modernes de données et d'IA, où les défaillances les plus importantes apparaissent généralement après le déploiement, et non avant.
Les revues statiques passent à côté des signaux qui changent les résultats : dérive de schéma, chargements tardifs, chemins de validation défaillants, autorité d'automatisation qui évolue et contournements humains qui n'apparaissent jamais dans un document préalable au lancement. L'approche la plus sûre est une analyse des dangers continue et fondée sur les données, où les métriques d'observability servent de preuves en temps réel et où chaque changement de l'environnement opérationnel peut rouvrir la question du risque.
Table des matières
Repenser l'analyse des dangers opérationnels pour les opérations de données
Cartographier les limites du système et les chaînes causales
Concevoir des contrôles testables pour la supervision humaine
Repenser l'analyse des dangers opérationnels pour les opérations de données
L'analyse des dangers opérationnels ne fonctionne que si elle suit le système, et non le calendrier. Une revue ponctuelle peut repérer des défauts de conception évidents, mais elle ne peut pas suivre le rythme d'un pipeline dont les données sources, la logique d'orchestration ou l'usage en aval changent d'une semaine à l'autre. Cet écart compte, car le danger réside rarement dans un seul symptôme. Il se manifeste généralement sous la forme d'une chaîne de petites défaillances qui s'alignent au mauvais moment.
Pourquoi les revues ponctuelles échouent
Un pipeline peut réussir une checklist de lancement et devenir risqué plus tard. Une équipe en amont modifie un schéma, une transformation continue de tourner, une table de reporting se remplit de valeurs nulles, et l'entreprise continue d'agir sur des données obsolètes parce que personne n'a relié ces événements entre eux. C'est précisément là que la réflexion sur le cycle de vie prend toute son importance : le danger n'est pas le seul changement de schéma, c'est le chemin causal qui mène du changement à la décision erronée.
Règle pratique : si l'environnement peut changer sans mise en production formelle, l'analyse des dangers doit évoluer sans attendre une revue trimestrielle.
La data observability devient, dans ce contexte, bien plus qu'une commodité d'ingénierie. Lorsque les retards, les échecs de validation, les discontinuités du nombre de lignes ou la dérive de schéma sont capturés comme preuves opérationnelles, ils deviennent la matière première de l'analyse des dangers, et non un simple bruit de dashboard. Une équipe qui traite ces signaux comme des données d'entrée de sécurité peut réagir avant que le problème ne se transforme en perte de reporting, en dégradation de modèle ou en défaillance de contrôle.
La data observability fonctionne au mieux lorsqu'elle est intégrée à la même logique de contrôle que celle des programmes de sécurité dans les secteurs réglementés. La question utile n'est pas de savoir si un pipeline a « réussi ». Il s'agit de savoir si le système se comporte toujours comme l'analyse des dangers l'avait supposé.
Des checklists qualitatives aux modèles quantitatifs

La discipline moderne n'a pas commencé avec les dashboards. Elle est née lorsque les ingénieurs de sécurité ont cessé de considérer les checklists générales comme suffisantes et ont commencé à modéliser la manière dont les défaillances se combinent. L'analyse par arbre de défaillances (Fault Tree Analysis, FTA) est apparue au début des années 1960 comme une méthode déductive qui part d'un événement indésirable au niveau du système et remonte jusqu'aux défaillances de composants, aux actions humaines et aux conditions externes susceptibles de le provoquer. Bell Laboratories l'a développée vers 1961-1962 pour le système de contrôle de lancement du missile Minuteman, et Boeing l'a adoptée en 1963 pour l'analyse de sécurité des avions commerciaux, ce qui a orienté l'analyse des dangers vers des modèles logiques explicites et des calculs de probabilité. La revue de la FTA publiée par la NASA retrace cette évolution dans des secteurs critiques pour la sécurité comme le nucléaire, la chimie et l'industrie pharmaceutique. Présentation de la FTA par la NASA
Pourquoi l'ancienne logique reste pertinente
La leçon fondamentale de la FTA est structurelle : les dangers se comprennent mieux comme des combinaisons de conditions observables que comme des incidents isolés. Dans les opérations de données, un fichier source en retard, une validation en échec et un changement de schéma passé inaperçu constituent un modèle de risque plus utile que « le pipeline a échoué ». La première formulation favorise l'investigation et la prévention. La seconde sert surtout à désigner un coupable.
Un bon modèle de danger nomme les conditions qui peuvent être mesurées, et pas seulement le résultat que tout le monde remarque une fois le mal fait.
Cette logique aide aussi les équipes à identifier les points de défaillance uniques et les coupes minimales, ce qui compte lorsqu'une seule dépendance fragile peut rompre toute une chaîne de reporting. L'objectif n'est pas de transformer les plateformes de données en systèmes aérospatiaux. L'objectif est d'appliquer la même rigueur qui a rendu l'ingénierie à haut risque plus fiable.
Pour les équipes qui souhaitent traduire ces idées dans la pratique analytique moderne, la simulation de Monte Carlo est un complément utile lorsque l'espace des entrées est incertain. Elle ne remplace pas l'analyse causale, mais elle permet de tester sous charge le comportement de combinaisons d'erreurs de timing, de volume et de transformation.
Cartographier les limites du système et les chaînes causales

Une analyse des dangers est faible si les limites du système sont floues. Les directives de gestion de la sécurité de la FAA exigent que les analystes définissent le système et son contexte opérationnel, identifient les dangers avec suffisamment de détails pour déterminer le risque, analysent la gravité et la probabilité, comparent le risque aux objectifs de performance et réévaluent les contrôles à l'aide des données opérationnelles. Cette vision fondée sur le cycle de vie convient bien aux plateformes de données, car le système couvre généralement l'ingestion, la transformation, le stockage, l'orchestration, la revue humaine et les consommateurs en aval. Directives de gestion de la sécurité de la FAA
Une cartographie pratique des limites
Commencez par l'ensemble du chemin des données, et pas seulement par la table de l'entrepôt que tout le monde interroge chaque matin. Incluez les flux amont, les fenêtres de traitement par lots, les processeurs de flux, les modèles dbt, les étapes d'approbation, les interventions manuelles et les équipes qui consomment les données pour le reporting ou l'automatisation. Si un risque peut entrer par un système amont et se manifester trois couches plus loin, il fait partie de la même analyse.
Décrivez ensuite les dangers sous forme de chaînes causales. Une modification de schéma peut casser une transformation, ce qui peut produire un reporting réglementaire incomplet, ce qui peut entraîner une défaillance de contrôle dans le processus de revue métier. C'est une fiche plus solide que « dérive de schéma », car elle identifie la condition initiatrice, la conséquence et le contexte opérationnel dans lequel la perte devient visible.
L'architecture du système de données joue ici un rôle clé, car c'est elle qui détermine où les preuves sont disponibles et où les contrôles peuvent être placés. Si une équipe ne peut pas indiquer l'étape exacte où les retards, les pics de valeurs nulles ou les enregistrements invalides sont détectés, l'analyse reste abstraite.
La sécurité des agents IA dans la finance est une référence utile si vous souhaitez voir comment l'analyse des risques évolue lorsque la prise de décision automatisée entre en jeu. Le fil conducteur est simple : dès qu'un logiciel peut agir, les limites du système doivent inclure à la fois l'action et les conditions qui la rendent dangereuse.
Ce que doit contenir chaque fiche de danger
Une fiche utile consigne le mode opératoire, la condition initiatrice, la conséquence, la gravité, la probabilité, les protections existantes, le responsable du contrôle, le signal de détection et l'autorité d'acceptation. Le danger passe ainsi d'un simple souvenir à un objet géré. Cela facilite aussi la réévaluation lorsque le système change, car l'équipe sait exactement quelle hypothèse a été violée.
Évaluer le risque avec des métriques de données observables
Les scores de risque les plus solides proviennent de la combinaison de la conséquence et de la probabilité, et non du simple décompte des symptômes. La politique de la FAA définit le risque de sécurité comme la combinaison de la gravité et de la probabilité, et la pratique fondée sur la norme MIL-STD-882 évalue les dangers à travers le matériel, le logiciel, les interfaces humaines et les environnements opérationnels. C'est important dans les opérations de données, car une même anomalie technique peut présenter un risque faible dans un processus métier et un risque sérieux dans un autre. FAA Order 8040.4B
Transformer l'observability en signal de risque
Un chargement tardif n'est pas qu'un désagrément d'ingénierie. Si le cas d'usage en aval dépend de données à jour, le retard accroît l'exposition en retardant une décision ou en alimentant un modèle avec un score obsolète. Une hausse anormale du taux de valeurs nulles peut révéler une capture incomplète à la source, une jointure en échec ou une transformation défaillante, et chacune de ces causes affecte différemment la crédibilité du résultat.
Composante du risque | Définition abstraite | Métrique de données observable |
|---|---|---|
Probabilité | Fréquence à laquelle le danger peut survenir | Retards de chargement, taux d'échec de validation |
Gravité | Ampleur possible des conséquences | Impact sur les KPI métier, exhaustivité du reporting réglementaire |
Détection | Rapidité avec laquelle l'équipe peut voir le problème | Latence des alertes, discontinuités du nombre de lignes |
Robustesse des contrôles | Capacité des protections à bloquer ou à faire remonter le problème | Détection des changements de schéma, couverture de validation |
Ce tableau est le plus utile lorsque les équipes cessent de le traiter comme un artefact de reporting et commencent à s'en servir pour prioriser le travail. Un flux régulièrement en retard avec une détection faible mérite un plan de contrôle différent d'un problème de formatage isolé repéré avant publication. C'est toute la différence entre un journal bien tenu et un véritable modèle de risque.
Règle opérationnelle : classez la conséquence crédible du scénario causal, puis révisez le score une fois les contrôles appliqués.
Ce qui rend le score défendable
Un score défendable est traçable. Si un jeu de données de sinistres arrive en retard, l'équipe doit pouvoir indiquer la fréquence des retards, le chemin de détection, l'exposition métier et le contrôle qui a réduit le risque résiduel. C'est la seule façon pour que l'acceptation du risque résiduel cesse d'être une affirmation vague et devienne une décision documentée.
Pour une vue plus approfondie de la couche de métriques, les métriques de data observability constituent le pont concret entre le comportement de la plateforme et l'évaluation des risques. Elles donnent à l'analyse une surface mesurable plutôt qu'une vague déclaration rassurante.
Concevoir des contrôles testables pour la supervision humaine
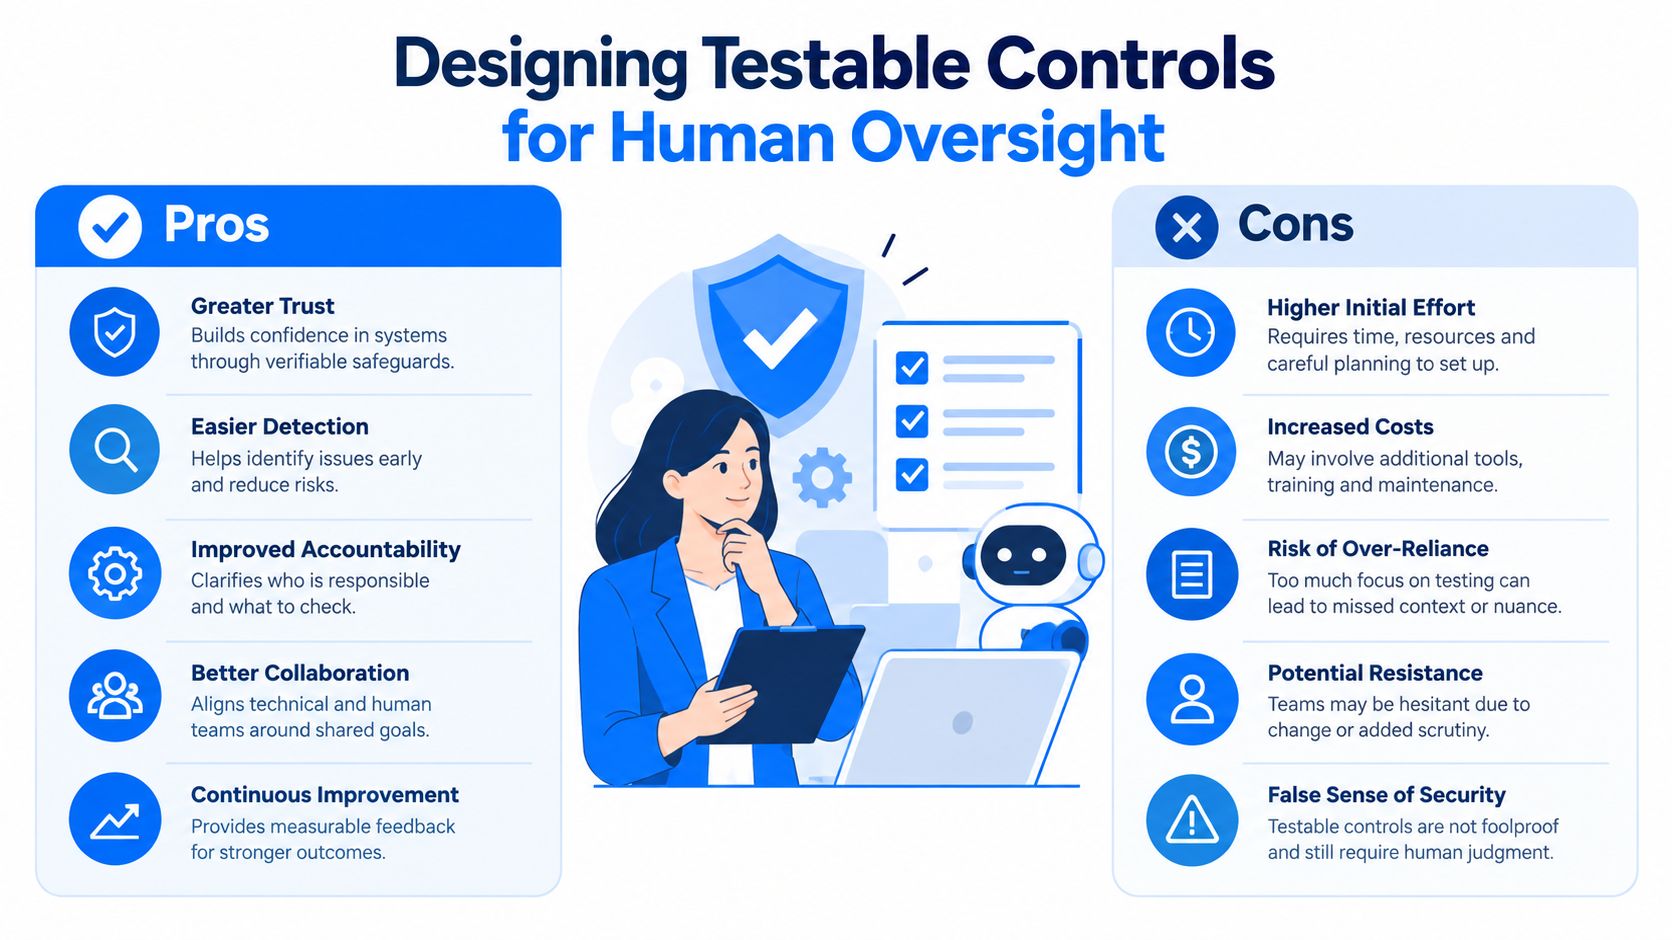
La revue humaine est ajoutée à de nombreux plans de contrôle parce qu'elle paraît sûre. En pratique, elle peut échouer de manière subtile. Les régulateurs et les organismes de sécurité ne cessent de rappeler que la responsabilité humaine ne disparaît pas lorsque l'IA intervient, et ils recommandent de tester la charge de travail, l'attention, la prise de décision, la clarté des rôles, le comportement d'escalade et les réactions face à des recommandations incorrectes ou absentes. Directives sur les facteurs humains
L'humain dans la boucle n'est pas un contrôle en soi
Un relecteur qui reçoit trop d'alertes commencera à trier au lieu de valider. Un relecteur confronté à des explications peu claires acceptera le résultat du système, car le contester prend trop de temps. Un relecteur qui ne sait pas à qui revient l'escalade peut remarquer le problème et le laisser passer malgré tout.
C'est pourquoi la supervision humaine doit être testable. Simulez des données dégradées, des entrées retardées, des changements de schéma, des signaux contradictoires, des pannes d'automatisation et une forte charge de travail, puis mesurez le temps de détection, la qualité des interventions, l'aboutissement des escalades, le temps de rétablissement et la récurrence. Ces résultats vous indiquent si l'humain dispose du temps, des informations, de l'autorité et des compétences nécessaires pour intervenir.
Ajouter un relecteur peut accroître le risque si celui-ci est submergé, insuffisamment formé ou empêché d'agir.
C'est l'élément que de nombreuses équipes négligent. Une couche humaine n'est pas automatiquement un contrôle préventif. Dans certains environnements, elle devient un goulet d'étranglement qui ajoute du délai sans ajouter de sécurité, en particulier lorsque le flux d'alertes est bruyant ou que l'explication fournie par le système est faible.
Comment rendre la supervision mesurable
Enregistrez le moment où l'opérateur a vu le problème, s'il l'a remis en question, quelle action il a entreprise et si le système s'est rétabli proprement. Conservez ces preuves à côté de la télémétrie technique, car un workflow nominalement réussi peut encore masquer un comportement humain dangereux. Si l'opérateur doit deviner, différer ou contourner le processus, le contrôle n'est pas encore mature.
La surveillance continue dans les secteurs réglementés
Une équipe des services financiers peut tout faire correctement sur le papier et passer quand même à côté du danger en pratique. Un flux transactionnel qui arrive habituellement à l'heure commence à dériver plus tard que d'ordinaire, mais la variation de volume est si faible qu'un seuil statique ne se déclenche jamais. Le rapport est toujours généré, le dashboard est toujours mis à jour, et les données obsolètes alimentent sans qu'on le remarque un processus de décision qui suppose leur fraîcheur.
La surveillance continue change ce mode de défaillance. Dans un environnement réglementé, les KPI métier, la dérive de schéma, la ponctualité, la validation et l'état de la plateforme doivent être surveillés ensemble. Le cas d'usage qualité des données et compliance de digna s'inscrit dans ce modèle, car la plateforme reste dans l'environnement du client tout en surveillant le comportement des données sur place, ce qui maintient les preuves opérationnelles au plus près du système qu'elles protègent.
Pourquoi les seuils rigides échouent dans les environnements réglementés
Une règle rigide ne voit que ce pour quoi elle a été écrite. Elle manque un chargement présent mais tardif, ou un changement de schéma qui passe encore les contrôles syntaxiques tout en cassant une hypothèse en aval. Elle prend aussi du retard lorsque le contexte métier évolue plus vite que l'ensemble des règles.
La surveillance continue fonctionne mieux, car elle peut détecter des combinaisons inhabituelles de comportements, et pas seulement des dépassements de seuil isolés. C'est essentiel dans la santé, la finance, les télécommunications et le secteur public, où un léger changement de volume ou de structure peut se transformer en problème de reporting ou de service avant même que quelqu'un n'ouvre un ticket d'incident.
Les meilleures alertes sont précoces, précises et liées à une conséquence métier que le responsable comprend déjà.
La plateforme de données et le système de contrôle se rejoignent ici. Si la couche d'observability peut valider les règles métier critiques, suivre les changements structurels et faire remonter des schémas anormaux sans déplacer les données de production hors de l'environnement, les preuves de risque restent exploitables à la fois pour les opérations et pour l'audit. Pour les opérations de données réglementées, ces mêmes preuves soutiennent également une piste de compliance claire, comme le montre le cas d'usage qualité des données et compliance de digna.
Ce dont une bonne surveillance opérationnelle a besoin
Une bonne surveillance fait trois choses à la fois. Elle détecte le comportement des pipelines, valide le sens métier et conserve la preuve que le contrôle a fonctionné. Lorsqu'un seul de ces éléments manque, l'équipe obtient du bruit au lieu d'une assurance.
Déclencher une réévaluation quand les systèmes changent

L'analyse des dangers opérationnels pour les opérations s'appuyant sur l'IA est encore trop souvent traitée comme un exercice ponctuel préalable au déploiement, alors que les risques les plus importants apparaissent généralement après celui-ci. Les directives de sécurité récentes mettent l'accent sur la mise en œuvre progressive, la surveillance continue, la gestion des changements, la validation locale et une responsabilité explicite, au lieu de supposer qu'un modèle ou un système automatisé reste sûr après son approbation. Directives de sécurité de la FAA sur les opérations s'appuyant sur l'IA
Ce qui doit déclencher une nouvelle revue
Une réévaluation doit commencer lorsque le système change d'une manière susceptible de modifier le risque. Cela inclut les changements de version de modèle ou de logiciel, l'évolution des distributions des données d'entrée, une nouvelle autorité d'automatisation, des schémas d'intervention manuelle anormaux, des changements d'effectifs, des incidents et des quasi-accidents. Cela inclut aussi les changements de processus qui modifient qui voit une alerte, qui peut approuver une décision ou la rapidité avec laquelle le rétablissement peut avoir lieu.
Pour les équipes qui traitent des données réglementées ou du contenu automatisé, une référence connexe utile concerne les règles applicables aux vidéos générées par l'IA. La raison est simple : si un système automatisé modifie ce que les gens voient, ce à quoi ils font confiance ou ce qu'ils approuvent, l'analyse des risques doit couvrir à la fois le résultat et la réaction humaine.
Comment garder la piste de preuves exploitable
Consignez l'incertitude, la réaction des utilisateurs, l'action en aval, la gravité, le sous-groupe concerné, l'action corrective et la récurrence. Cela donne à la revue suivante suffisamment de contexte pour déterminer si le danger a été entièrement résolu ou simplement masqué. Cela évite aussi l'échec courant où un modèle paraît précis dans l'ensemble mais cause tout de même un préjudice opérationnel, parce que les gens lui font trop confiance, l'ignorent ou ne peuvent pas agir assez vite sur ses résultats.
Le processus le plus solide repose sur des déclencheurs, et non sur un calendrier. Lorsque les données, le workflow ou le modèle d'autorité changent, l'analyse des dangers doit se rouvrir automatiquement et les preuves de contrôle doivent être mises à jour en conséquence.
digna aide les équipes à transformer les métriques de pipeline, la dérive de schéma, les résultats de validation et les signaux de ponctualité en indicateurs de danger continus au sein de leur propre environnement. Si vous remplacez des checklists statiques par des preuves opérationnelles en temps réel, rendez-vous sur digna et découvrez comment la data observability peut contribuer à des opérations de données plus sûres et plus responsables.
Les chargements tardifs comptent parmi les conditions initiatrices les plus fréquentes dans ces chaînes causales, de sorte que le score de probabilité dépend de leur détection précoce. Le module Timeliness de digna apprend le schéma d'arrivée normal de chaque table et signale les données qui arrivent en retard ou pas du tout, ce qui fournit à la fiche de danger un signal de détection mesurable.
Questions fréquentes
Qu'est-ce que l'analyse des dangers opérationnels dans les opérations de données ?
L'analyse des dangers opérationnels consiste à identifier comment des défaillances dans un système en production peuvent se combiner pour causer un préjudice, puis à les maîtriser. Dans les opérations de données, elle suit l'ensemble du chemin des données, des flux amont et modèles dbt jusqu'aux interventions manuelles et aux consommateurs en aval, et elle est rouverte à chaque évolution du système.
Pourquoi les revues ponctuelles des dangers échouent-elles pour les pipelines de données ?
Parce que la plupart des défaillances dommageables apparaissent après le déploiement. Un pipeline peut réussir sa checklist de lancement, puis un changement de schéma en amont remplit une table de reporting de valeurs nulles alors que la transformation continue de tourner, et l'entreprise agit sur des données obsolètes. Une revue trimestrielle ne peut pas détecter une chaîne causale qui se forme entre deux revues.
Comment utiliser les métriques d'observability pour évaluer le risque d'un danger ?
Associez chaque composante du risque à un signal mesurable. La probabilité peut provenir des retards de chargement et des taux d'échec de validation, la gravité de l'impact sur les KPI métier ou de l'exhaustivité du reporting réglementaire, la détection de la latence des alertes et des discontinuités du nombre de lignes, et la robustesse des contrôles de la détection des changements de schéma et de la couverture de validation. Réévaluez le score une fois les contrôles appliqués.
Que doit contenir une fiche de danger ?
Une fiche de danger utile comprend le mode opératoire, la condition initiatrice, la conséquence, la gravité, la probabilité, les protections existantes, le responsable du contrôle, le signal de détection et l'autorité d'acceptation. Décrire les dangers sous forme de chaînes causales, par exemple un changement de schéma menant à une transformation défaillante puis à un reporting réglementaire incomplet, montre précisément quelle hypothèse a été violée lorsque le système évolue.
Quand faut-il réévaluer une analyse des dangers opérationnels ?
Réévaluez-la dès qu'un changement peut modifier le risque, et non selon un calendrier fixe. Les déclencheurs incluent les changements de version de modèle ou de logiciel, l'évolution des distributions des données d'entrée, une nouvelle autorité d'automatisation, des schémas d'intervention manuelle anormaux, des changements d'effectifs, des incidents et des quasi-accidents, ainsi que les changements de processus qui modifient qui voit une alerte ou qui peut approuver une décision.


