Erreur de Data Validation : Causes, Exemples et Solutions
|
9
minute de lecture
Vous l'avez probablement déjà constaté : l'actualisation du tableau de bord se termine, les chiffres semblent plausibles, puis quelqu'un demande pourquoi le taux d'attrition a soudainement changé. L'analyste vérifie le visuel, le SQL et la tâche planifiée. Des heures plus tard, on découvre que le problème provient d'une seule valeur malformée qui est entrée tôt dans le pipeline et a modifié la façon dont un système en aval a interprété l'enregistrement.
Une erreur de Data Validation est bien plus qu'une cellule de feuille de calcul rejetée. Il peut s'agir d'un champ manquant, d'une date invalide, d'un code en dehors du domaine autorisé ou d'une relation inexistante. Le défi pratique consiste à trouver l'endroit où le contrat a échoué, à décider si la ligne peut être réparée en toute sécurité et à empêcher que le même défaut ne se reproduise.
Table des matières
Quand une seule mauvaise ligne brise tout le tableau de bord
Ce que signifie réellement une erreur de Data Validation
La vérification superficielle
La vérification approfondie
Les principaux modèles derrière les échecs de validation
Valeurs manquantes
Erreurs de format
Violations de plage
Erreurs de codage et de domaine
Ruptures de cohérence
Exemples au niveau de l'enregistrement à repérer dans vos propres données
Exportations de feuilles de calcul
Ingestion d'API
Enregistrements d'entrepôt de données
Pourquoi la plupart des erreurs de validation commencent en amont
Réparer le contrat, pas seulement le résultat
Un flux de travail pratique pour détecter et corriger les erreurs
Capture
Ingestion
Entrepôt de données
Consommation
Points clés à retenir pour des opérations de données fiables
Quand une seule mauvaise ligne brise tout le tableau de bord
Une équipe financière reçoit un fichier CSV nocturne en provenance d'un portail fournisseur. Les enregistrements semblent normaux jusqu'à ce qu'un champ d'annulation contienne une date malformée. Le chargeur de l'entrepôt de données ne parvient pas à le convertir en date et écrit donc un NULL plutôt que d'arrêter le chargement.
Le modèle d'attrition traite une date d'annulation manquante comme sa propre condition. Cette simple conversion modifie l'attribution de cohorte du client, et le tableau de bord de la direction affiche une augmentation inattendue. Le pipeline indique que l'exécution a réussi, le graphique s'affiche, et pourtant le résultat reste incorrect.
L'analyste commence par le tableau de bord et retrace le résultat à travers trois rapports, deux vues SQL et une tâche Airflow. La ligne source malformée finit par apparaître dans le journal des valeurs rejetées. Le tableau de bord n'était que le premier symptôme visible.
Règle pratique : Une exécution réussie du pipeline prouve que le traitement est terminé. Elle ne prouve pas que chaque enregistrement respecte les règles sur lesquelles repose l'entreprise.
La validation doit donc s'effectuer au niveau de l'enregistrement. Une seule valeur invalide peut altérer les agrégats, les caractéristiques d'apprentissage automatique, les rapports financiers ou les flux opérationnels sans provoquer d'interruption. L'indicateur largement cité de Gartner estime que la mauvaise qualité des données coûte aux organisations en moyenne 12,9 millions de dollars par an (Gartner benchmark), tandis que les recherches d'IBM pour 2025 ont révélé que plus d'un quart des organisations estiment leurs pertes annuelles à plus de 5 millions de dollars, 7 % signalant des pertes supérieures à 25 millions de dollars (IBM research). Le livre blanc de DCI sur le coût caché des mauvaises données propose une analyse plus approfondie du coût opérationnel d'une mauvaise qualité des données.
L'investigation nécessite également du contexte. Une anomalie de données (Data Anomalies) peut représenter un comportement client authentique, tandis qu'un échec de validation signifie qu'une valeur viole une structure ou une règle attendue. Une feuille de calcul peut signaler une valeur via une liste déroulante, une importation d'entreprise peut la rejeter par rapport à un schéma gouverné, et un pipeline d'entrepôt de données peut la contraindre en un NULL trompeur. Des échecs répétés à travers ces couches indiquent généralement un défaut de mappage source, de transformation ou de contrat plutôt qu'une série de lignes malchanceuses. Pour en savoir plus sur la distinction entre valeurs inhabituelles et échecs de règles, consultez le guide de digna sur les anomalies de données (Data Anomalies).
Pour les équipes qui publient des tableaux de bord via Power BI, le guide du connecteur Power BI de Tutorial AI peut clarifier la couche de reporting. La configuration du connecteur ne permet pas de réparer une valeur source invalide. La correction fiable commence là où l'enregistrement rompt son contrat pour la première fois.
Ce que signifie réellement une erreur de Data Validation
Une erreur de Data Validation se produit lorsqu'une valeur observée ne respecte pas une règle, un schéma, une relation ou une attente métier. La règle peut être simple, comme « ce champ doit contenir une date », ou relationnelle, comme « cette commande doit faire référence à un client existant ».
Considérez la validation comme un contrat d'entrée dans un club. Un videur peut d'abord vérifier si votre pièce d'identité a le bon format. Une vérification plus approfondie confirme que le nom figure sur la liste des invités, que l'événement est valable pour ce billet et que la réservation correspond à la personne qui la présente. Les systèmes de données fonctionnent de la même manière.
La vérification superficielle
Une vérification de format permet de savoir si une valeur peut être interprétée correctement :
2025-04-18semble être une représentation de date valide.jdoe@ressemble à un champ d'e-mail mais ne respecte pas un modèle d'e-mail complet.42peut être une valeur numérique valide.Closed Wonpeut tout de même échouer si le code autorisé estclosed_won.
Ces vérifications évitent les erreurs d'analyse, mais elles ne permettent pas d'établir que l'enregistrement a du sens dans son contexte.
La vérification approfondie
La validation au niveau de l'enregistrement examine les relations et les règles métier :
Le
customer_ididentifie-t-il un client dans la dimension client ?La remise est-elle autorisée pour ce segment de clientèle ?
Le total de la commande est-il égal à la somme de ses lignes d'articles ?
La date de l'événement est-elle postérieure à la création du compte ?
Le statut appartient-il au domaine approuvé pour ce flux de travail ?
Une liste déroulante de feuille de calcul, une réponse d'API telle que HTTP 422, une violation de contrainte d'entrepôt de données et une suite de tests Great Expectations mettent tous en œuvre la même idée sous-jacente à différentes couches. Chacun compare les données avec un contrat convenu.
La Banque mondiale décrit la validation à travers des techniques telles que les contrôles de plage, les contrôles de cohérence interne et la détection des valeurs aberrantes, et insiste sur la documentation de la validation dans les métadonnées. Ces conseils figurent dans sa conférence sur la validation des données. Une erreur de validation n'est donc pas simplement un message agaçant. C'est la preuve qu'un enregistrement, un fichier ou un ensemble de données ne correspond plus aux hypothèses formulées par le système suivant.
Vous obtiendrez de meilleurs résultats en posant deux questions distinctes :
Quelle règle a échoué ?
Quelle couche a permis à la valeur invalide d'arriver jusqu'ici ?
La première question permet de réparer l'enregistrement. La seconde empêche la récurrence.
Pour une explication plus large de la validité, des dimensions et de la mesure, comparez cette définition avec l'explication de digna sur la validité des données.
Les principaux modèles derrière les échecs de validation
La plupart des incidents de validation relèvent d'un petit ensemble de modèles structurels. Classifier d'abord l'échec vous aide à choisir le bon correctif au lieu de traiter chaque ligne rejetée comme un mystère sans rapport.
La Banque mondiale identifie les valeurs manquantes, les problèmes de format, les problèmes de codage, les contrôles de plage, les contrôles de cohérence et la détection des valeurs aberrantes comme des éléments importants de la pratique de validation. Des recherches antérieures de la Society of Actuaries ont également révélé que les erreurs de validité sont plus courantes et plus répandues que les erreurs d'exactitude, les valeurs manquantes, les erreurs de format de données et les erreurs de codage figurant parmi les principaux problèmes de validité. Ces conseils sont résumés dans la recherche sur la qualité des données de la Society of Actuaries.
Modèle | Exemple de mauvaise valeur | Règle violée |
|---|---|---|
Valeur manquante |
| L'identifiant requis doit être présent |
Erreur de format |
| La valeur doit utiliser un format de date analysable |
Violation de plage |
| L'âge doit rester dans la plage autorisée |
Erreur de codage ou de domaine |
| La valeur doit correspondre à un domaine approuvé |
Rupture de cohérence |
| Le total de l'en-tête doit être égal au total du détail |
Valeurs manquantes
A missing value becomes an error when the field is required for processing or interpretation. A blank phone extension may be acceptable, while a missing customer identifier can make the record impossible to join. These failures commonly surface in ingestion logs, NOT NULL checks, or reports with unexpectedly incomplete populations.
Erreurs de format
Les erreurs de format se produisent lorsque le système ne peut pas analyser la valeur selon le type déclaré. Une date stockée sous forme de texte libre, un montant numérique contenant un symbole inattendu ou un e-mail auquel il manque son domaine peuvent passer à travers une exportation mal contrôlée et échouer à l'intérieur d'une API ou d'une conversion d'entrepôt de données.
Violations de plage
Les contrôles de plage détectent les valeurs qui sont structurellement numériques mais logiquement impossibles ou interdites. Un âge négatif, une date de naissance future ou un pourcentage supérieur à son maximum autorisé peuvent être des nombres syntaxiquement valides. La référence de validation des données de la Banque mondiale explique comment les contrôles de plage et de cohérence interne aident à localiser les erreurs avant l'analyse ou l'utilisation en production.
Erreurs de codage et de domaine
Un domaine est l'ensemble des valeurs acceptées pour un champ. Les champs de pays, de statut, de type de produit et de catégorie de risque échouent souvent parce que différents systèmes utilisent des orthographes, des majuscules, des abréviations ou des codes hérités différents. Ces erreurs ne déclenchent pas nécessairement un échec de l'analyseur, mais elles fragmentent les décomptes et brisent les filtres.
Ruptures de cohérence
Les règles de cohérence comparent les champs d'un même enregistrement ou de différents enregistrements liés. Un pays d'expédition en contradiction avec la région attribuée, une facture dont les lignes de détail ne correspondent pas au total de l'en-tête ou une transaction liée à un client inconnu relèvent de cette catégorie. Les utilisateurs professionnels remarquent souvent ces erreurs en premier car le résultat contredit ce qu'ils savent du processus.
Habitude de diagnostic : Ne commencez pas par modifier la valeur. Commencez par nommer le modèle violé. Le modèle indique généralement la couche responsable.
Exemples au niveau de l'enregistrement à repérer dans vos propres données
Le même défaut se présente différemment selon l'endroit où vous le rencontrez. Une feuille de calcul peut afficher une chaîne suspecte, une API peut renvoyer un rejet structuré et un test d'entrepôt de données peut signaler une relation défaillante. Le problème sous-jacent peut pourtant être identique.
Exportations de feuilles de calcul
Un export de CRM contient cette ligne :
customer_email | phone | stage |
|---|---|---|
|
|
|
L'e-mail échoue à un contrôle structurel de base car il lui manque un domaine complet. Le numéro de téléphone peut être utilisable pour un processus mais incompatible avec un autre processus qui attend un format normalisé tel que (555) 123-4567. Les valeurs d'étape closed-won, Closed Won et CLOSED_WON peuvent représenter le même état commercial pour une personne tout en apparaissant comme trois catégories distinctes pour un tableau croisé dynamique.
Une liste déroulante pourrait bloquer les nouvelles variations, mais elle ne normalisera pas les valeurs historiques déjà exportées. Elle n'expliquera pas non plus si le CRM source, le modèle d'exportation ou une modification manuelle a introduit la différence.
Ingestion d'API
Une API reçoit cette charge utile :
Ici, customer_id viole une règle de champ obligatoire. order_total est une chaîne de caractères alors même que le contrat de réception attend un nombre. created_at n'est pas une date valide car la combinaison du mois et du jour ne peut pas être interprétée comme une date réelle du calendrier.
Une réponse HTTP 422 est utile lorsqu'elle identifie le champ exact et la règle qui ont échoué. S'il est simplement indiqué « entité non traitable », inspectez le corps de la requête, le corps de la réponse, le type de contenu et la spécification de l'API. Le guide de Postman sur les erreurs HTTP 422 fournit un contexte de débogage pratique pour ces cas.
Enregistrements d'entrepôt de données
Une table de faits d'entrepôt de données contient une ligne présentant trois problèmes distincts :
order_datese produit avantcustomer_signup_date.customer_idne pointe vers aucune ligne dansdim_customer.discount_percent = 150, en dehors de la plage autorisée.
Le premier est un échec de cohérence temporelle. Le second est un échec d'intégrité référentielle. Le troisième est une violation de plage. Aucun n'est un simple problème de formatage, et corriger le format d'affichage ne rendra pas l'enregistrement digne de confiance.
Environnement | Exemple de champ | Mauvaise valeur d'enregistrement | Classe de défaut |
|---|---|---|---|
Feuille de calcul |
|
| Format |
Charge utile d'API |
|
| Champ obligatoire |
Charge utile d'API |
|
| Incompatibilité de type |
Table de faits d'entrepôt |
| Clé de dimension inconnue | Référentiel |
Table de faits d'entrepôt |
| Avant la date d'inscription | Temporel |
Table de faits d'entrepôt |
|
| Plage |
Ces exemples sont plus faciles à analyser lorsque vous séparez la validité de la plausibilité. Une valeur peut correspondre à un type de données et tout de même sembler invraisemblable dans son contexte. Le guide de digna sur la plausibilité des données explore cette distinction.
Pourquoi la plupart des erreurs de validation commencent en amont
Corriger les mauvaises cellules une par une donne l'impression d'être productif car le nombre d'erreurs diminue immédiatement. Cela traite souvent le symptôme tout en laissant le producteur, le contrat ou le schéma inchangés.
Une liste déroulante de feuille de calcul ne régit que ce qu'un utilisateur peut saisir via cette interface. Elle ne contrôle pas les valeurs générées par une intégration CRM, un export en masse, un client d'API, une migration de base de données ou un travail de transformation. La validation la plus forte se situe près du point de création et d'échange des données.
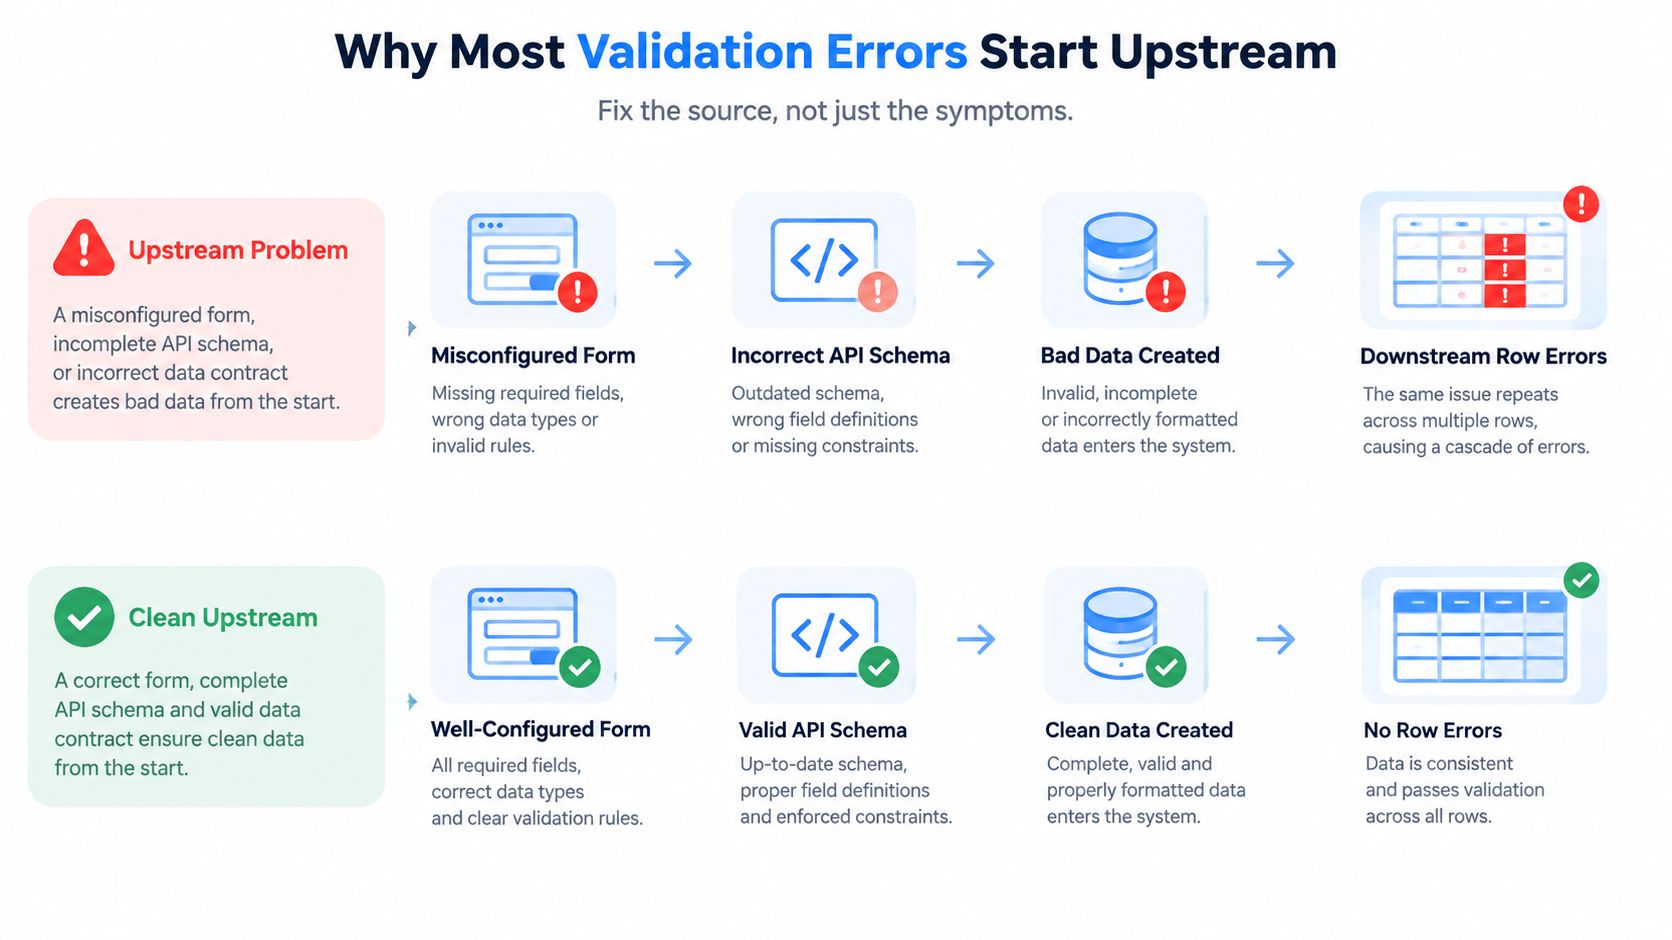
Envisagez un champ d'API qui passe de customer_id à account_id sans contrat versionné. La transformation de réception peut alimenter customer_id avec un NULL pour chaque enregistrement entrant. L'entrepôt signale alors des identifiants manquants, les jointures de tableaux de bord perdent des lignes et les analystes commencent à corriger manuellement les résultats. L'échec répété n'est pas la preuve d'une saisie de données négligente. C'est la preuve que deux systèmes ne s'entendent pas sur le schéma.
Le même modèle se produit lorsqu'un modèle d'exportation CRM change, qu'une contrainte de base de données est assouplie ou qu'une migration supprime une règle de champ obligatoire. Un changement à la source peut créer des milliers d'échecs en aval qui ressemblent à des lignes défectueuses individuelles.
Réparer le contrat, pas seulement le résultat
Utilisez le modèle d'échec pour choisir l'intervention :
Nom de champ modifié : Versionnez la charge utile et mettez à jour le consommateur de manière délibérée.
Champ optionnel qui doit exister : Rendez le champ obligatoire dans le contrat source et rejetez les requêtes incomplètes.
Valeur numérique invalide : Ajoutez une contrainte
CHECKau niveau de la source ou une validation équivalente.Statut non reconnu : Maintenez un domaine partagé ou une énumération au lieu de vous appuyer sur du texte libre.
Mauvaise relation : Validez les identifiants référencés avant de charger l'enregistrement dépendant.
Le guide de digna sur l'ingestion de données fournit un contexte utile pour traiter l'ingestion comme un mouvement contrôlé de données plutôt que comme une simple étape de transfert de fichiers.
Test de cause racine : Si le même échec de validation apparaît sur de nombreuses lignes après un changement à la source, examinez le contrat avant de nettoyer les enregistrements.
Rejeter les données invalides lors de l'ingestion est généralement plus sûr que de les laisser arriver sous forme de NULL, de chaîne vide ou de valeur par défaut forcée. Si le rejet n'est pas possible, mettez la ligne en quarantaine avec son identifiant source, l'échec de règle et l'horodatage d'ingestion afin que les consommateurs en aval ne confondent pas une valeur endommagée avec une vraie.
Un flux de travail pratique pour détecter et corriger les erreurs
Un flux de travail fiable place des contrôles là où ils fournissent le signal le plus clair et le moins de retravail. Commencez par la capture, puis passez par l'ingestion, les vérifications d'entrepôt et la consommation.
Capture
Validez les types, les champs requis, les valeurs autorisées et les plages dans les formulaires, les API et les bases de données sources. Les masques de saisie peuvent guider les utilisateurs, tandis que les contraintes de schéma empêchent les producteurs d'envoyer des valeurs que les systèmes en aval ne peuvent pas interpréter.
Une base de données source doit appliquer les règles qui comptent, quel que soit l'auteur de l'enregistrement. Une API doit renvoyer des erreurs au niveau du champ qui indiquent au client ce qu'il doit corriger. Un formulaire doit empêcher une valeur invalide avant la soumission plutôt que de s'en remettre à un analyste pour la trouver plus tard.
Ingestion
Traitez chaque fichier ou charge utile entrant comme un contrat. Validez chaque enregistrement par rapport au schéma attendu, mettez les échecs en quarantaine et émettez des événements d'erreur structurés contenant le fichier source, l'identifiant de l'enregistrement, le champ, la valeur observée et la règle violée.
Ne remplacez pas la valeur d'origine lors du nettoyage. Conservez-la aux côtés de la valeur normalisée afin que l'équipe puisse auditer ce qui est arrivé et quelle transformation a eu lieu.
Entrepôt de données
Exécutez des vérifications continues pour les valeurs nulles, l'unicité, l'intégrité référentielle, la fraîcheur, les changements de distribution et la logique croisée des champs. Un test d'entrepôt doit distinguer une seule ligne rejetée d'un échec de schéma global, et il doit conserver suffisamment de contexte pour que le propriétaire puisse reproduire le problème.
Les conseils de la Banque mondiale sur la saisie et la validation des données mettent l'accent sur des contrôles tels que la restriction des options de réponse et l'utilisation de vérifications basées sur les décomptes pour réduire les éléments ignorés ou invalides. Ces principes s'appliquent au-delà des enquêtes. Appliquez les contraintes tôt, puis vérifiez l'ensemble de données résultant de manière indépendante.
Consommation
Les tableaux de bord et les modèles ont besoin de leurs propres assertions. Comparez les décomptes de lignes attendus, détectez les partitions manquantes, vérifiez la couverture des jointures et signalez les indicateurs qui changent soudainement sans explication correspondante liée à la qualité des données.
Lorsque des formules sont modifiées dans des feuilles de calcul, la validation peut se comporter de manière inattendue. Microsoft Q&A note que des erreurs de formule telles que #REF! ou #DIV/0! peuvent entraîner l'annulation de la validation, tandis que les opérations de copie et de remplissage peuvent contourner ou modifier le comportement attendu. Consultez la discussion de Microsoft sur les erreurs de validation liées aux formules lorsqu'une liste déroulante semble correcte mais que les cellules transformées échouent toujours.
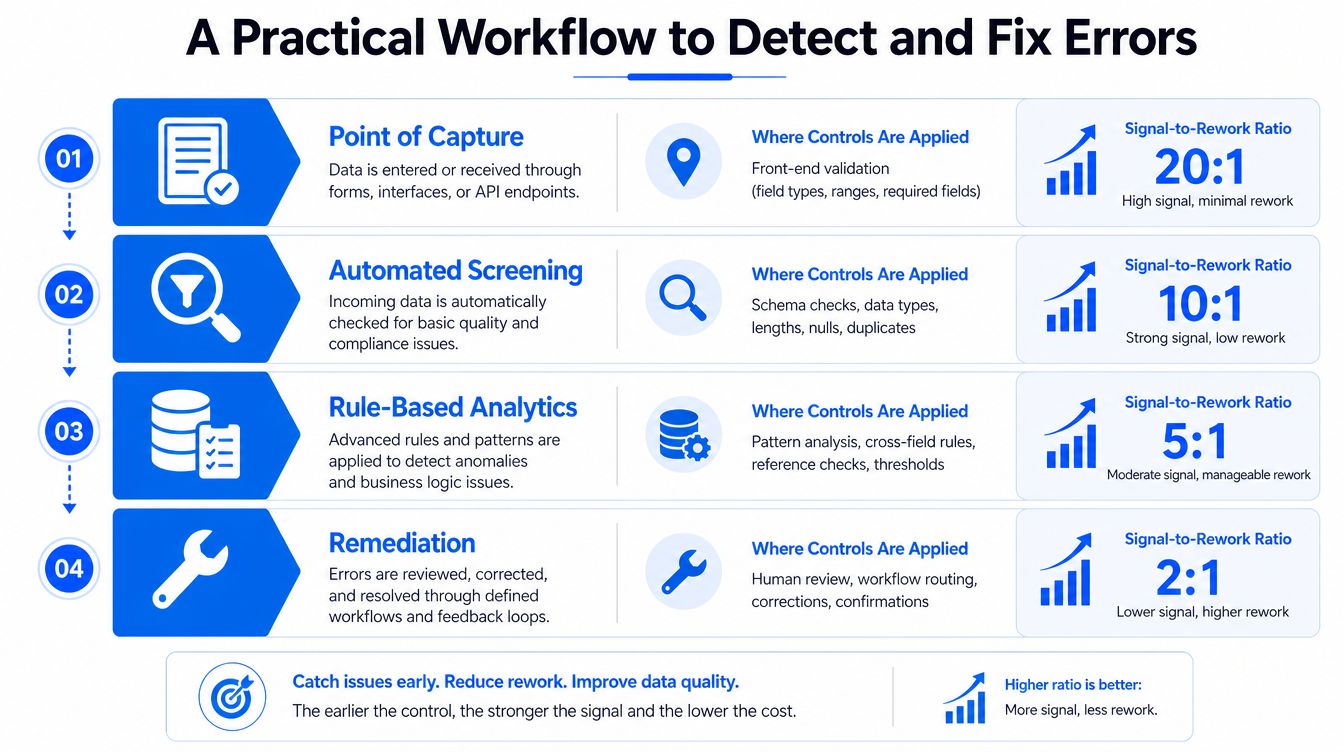
Utilisez cet ordre de remédiation :
Corrigez d'abord les contrats en amont. Corrigez la règle source, le schéma, le mappage ou le comportement du producteur.
Corrigez l'entrepôt en second lieu. Isolez, rechargez ou normalisez les enregistrements lorsque la source ne peut pas être modifiée immédiatement.
Ne nettoyez dans l'analytique que si nécessaire. Rendez la transformation visible, documentée et réversible.
Pour des contrôles continus combinant des règles au niveau de l'enregistrement et une Observability plus large, consultez les conseils de digna sur la validation des données et la qualité continue des données. La plateforme s'exécute au sein de l'environnement du client, effectue le calcul des indicateurs dans ses bases de données et peut surveiller la validation, la Timeliness, les anomalies (Data Anomalies) et les changements de schéma sans déplacer les données de production hors de cet environnement.
Points clés à retenir pour des opérations de données fiables
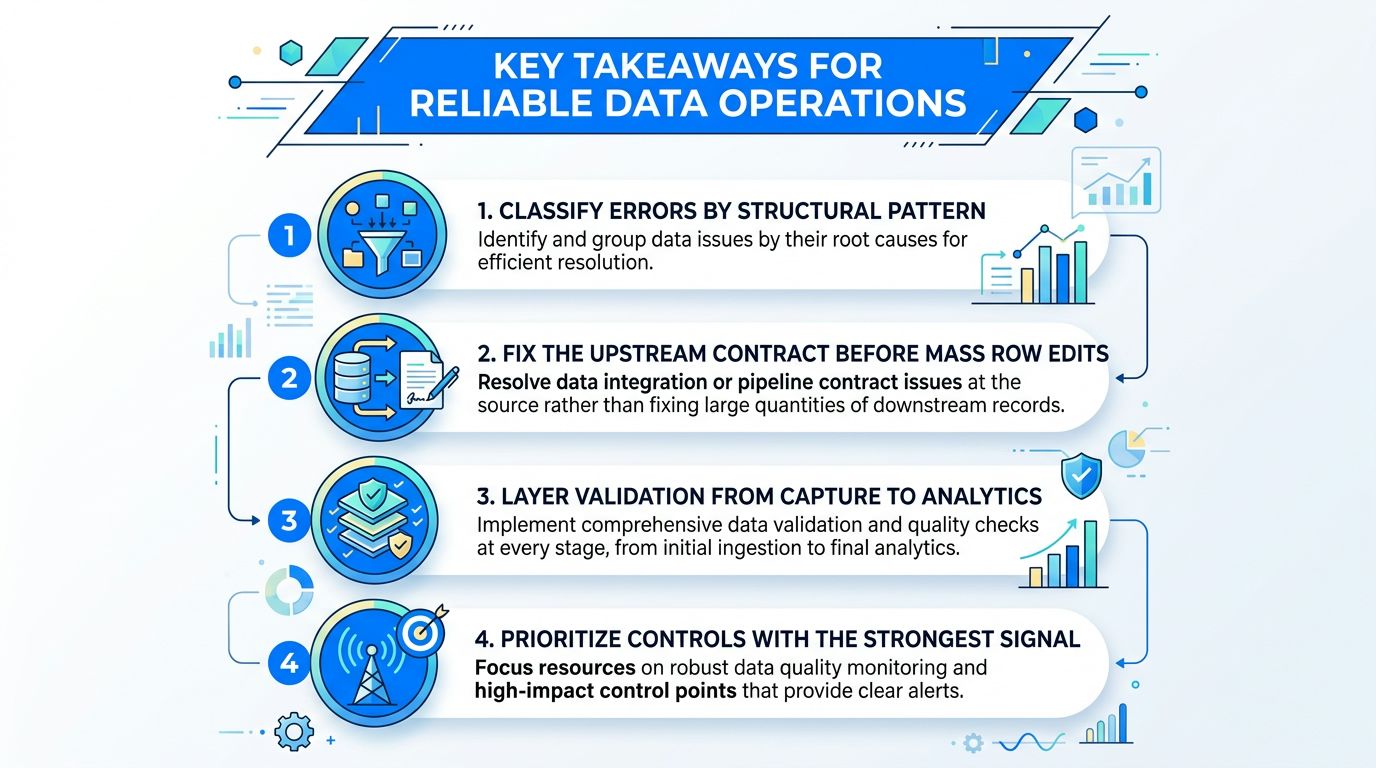
Des opérations de données fiables dépendent moins d'un exercice de nettoyage parfait que d'une réponse répétable aux échecs récurrents. Utilisez cette liste de contrôle lorsqu'une alerte de validation apparaît :
Classifiez le défaut. Déterminez s'il s'agit d'une valeur manquante, malformée, hors plage, hors domaine, incohérente, temporellement impossible ou référentiellement invalide.
Retracez le premier point de défaillance. Identifiez le producteur, l'export, le mappage d'API, la migration ou la transformation qui a introduit l'écart.
Réparez le contrat en amont. Modifiez le schéma, la règle de champ obligatoire, la contrainte, le mappage ou la charge utile versionnée avant de modifier un grand nombre de lignes en aval.
Superposez les contrôles. Validez lors de la capture, de l'ingestion, dans l'entrepôt et lors de la consommation afin qu'une conversion silencieuse ne puisse pas passer inaperçue.
Suivez la récurrence. Enregistrez le champ, la règle, la source, le pipeline et la tendance des échecs. Les échecs répétés méritent un travail d'ingénierie, pas un nettoyage manuel répété.
Conservez les preuves. Préservez les enregistrements rejetés, les résultats des règles, les horodatages et les décisions de remédiation pour investigation et auditabilité.
La leçon centrale est simple : les erreurs de validation récurrentes indiquent généralement un processus défectueux, et non un utilisateur négligent. Une seule ligne peut être l'échec visible, mais des lignes répétées révèlent une faiblesse de contrat, de schéma, de mappage ou de surveillance en amont.
La validation doit donc être observable. Les équipes ont besoin de savoir quelles règles échouent, où elles échouent, si les échecs sont isolés ou systémiques, et quels actifs en aval dépendent des données affectées. Cette visibilité transforme un écart déroutant sur un tableau de bord en un incident technique exploitable.
digna aide les équipes de données à définir des règles de validation au niveau de l'enregistrement, à surveiller les changements de schéma, à suivre la Timeliness et à détecter les comportements inhabituels dans les entrepôts et les pipelines tout en conservant les données dans l'environnement du client. Visitez digna pour découvrir comment remplacer le nettoyage récurrent ligne par ligne par des contrôles de qualité des données et d'Observability traçables.
Questions fréquentes
Qu'est-ce qu'une erreur de validation de données ?
Elle survient quand une valeur observée enfreint une règle, un schéma, une relation ou une attente métier. C'est plus qu'une cellule de tableur rejetée : une exécution réussie du pipeline prouve que le traitement s'est terminé, pas que chaque enregistrement respectait les règles dont l'activité dépend.
Quelle différence entre un contrôle de format et une validation au niveau enregistrement ?
La profondeur. Le contrôle de format demande si une valeur est interprétable, si bien que 2025-04-18 passe pour une date tandis que jdoe@ échoue à un motif d'e-mail. La validation au niveau enregistrement examine les relations : customer_id désigne-t-il un client réel, le total de commande égale-t-il ses lignes ?
Quels sont les motifs d'échec de validation les plus courants ?
Un petit ensemble revient : valeurs manquantes, problèmes de format, erreurs de codage, contrôles de plage en échec, violations de cohérence et valeurs aberrantes. La Banque mondiale identifie ces mêmes catégories et insiste pour documenter la validation dans les métadonnées, afin que la règle survive à son auteur.
Combien coûte réellement une erreur de validation ?
Le repère largement cité de Gartner situe la mauvaise qualité des données à 12,9 millions USD en moyenne par organisation et par an. Les travaux d'IBM de 2025 montrent que plus d'un quart des organisations estiment leurs pertes annuelles au-dessus de 5 millions USD, et 7 % au-dessus de 25 millions.
Comment enquêter sur une erreur de validation ?
Posez deux questions séparément. Quelle règle a échoué, ce qui répare l'enregistrement, et quelle couche a laissé la valeur invalide aller si loin, ce qui répare le pipeline. Ne répondre qu'à la première laisse le même défaut revenir demain.


