Métriques de Data Observability : le catalogue de référence
|
7
minute de lecture

Vous observez un tableau de bord qui semble normal, mais une table en amont a renommé une colonne hier après-midi et personne ne s'en est rendu compte jusqu'à ce que le rapport sur les revenus reste bloqué sur le chiffre de lundi. Le pipeline n'a pas bronché, les graphiques ne se sont pas cassés, et le modèle a continué à générer des valeurs NULL. C'est exactement le genre de défaillance que les métriques de Data Observability sont censées détecter, mais seulement si votre équipe est capable d'identifier le signal, de le calculer de la même manière et de s'accorder sur ce qui se passe lorsqu'il franchit une limite.
Les équipes ont déjà des fragments de réponse. Elles disposent de vérifications de fraîcheur dans un outil, d'alertes sur le nombre de lignes dans un autre, de journaux de schéma dans un troisième et de quelques règles tacites consignées dans les notes d'astreinte. Ce qui leur manque généralement, c'est un catalogue de référence prêt pour la navigation, une carte partagée des métriques elles-mêmes, de la manière dont chacune est calculée et du seuil qui justifie de réveiller quelqu'un. Un catalogue clair transforme une surveillance désordonnée en un outil exploitable lors d'un incident, et non pas seulement en un objet d'admiration lors d'une démonstration. Pour un point de départ pratique, digna's data observability overview est un exemple utile de la manière dont les équipes appréhendent le problème en production.
Table des matières
Pourquoi les métriques de Data Observability ont besoin d'un catalogue partagé
Le vocabulaire partagé prévient la dérive des incidents
Qu'est-ce que les métriques de Data Observability ?
Les métriques sont continues, les vérifications sont ponctuelles
Les cinq catégories clés en un coup d'œil
Fraîcheur, volume, schéma, distribution, lignage (lineage)
Métriques de fraîcheur et de Timeliness en détail
Quatre métriques pour rendre la fraîcheur actionnable
Définir la fenêtre par classe d'actifs
Scores d'anomalies et mesures de dérive (drift) ou de volatilité
Trois façons de détecter un comportement inhabituel
Comptage des modifications de schéma et signaux de dérive structurelle
Quatre métriques pour rendre la structure visible
Les moniteurs de KPI d'entreprise comme couche de niveau décisionnel
Construire le KPI à partir des actifs sous-jacents
Matrice de référence rapide pour le catalogue
Références croisées entre les catégories de métriques
Fraîcheur-vers-volume, schéma-vers-distribution, lignage-vers-dérive
Choisir l'ensemble de métriques le plus restreint mais le plus pertinent
h2 id="33">Pourquoi les métriques de Data Observability ont besoin d'un catalogue partagé
Le pire dans une dérive de schéma silencieuse n'est pas la dérive elle-même. C'est la demi-journée que votre équipe perd à débattre de la façon de l'appeler. Un ingénieur dit que la table était obsolète, un autre que l'extraction a échoué, et un troisième souligne que le résultat du modèle était erroné parce qu'une colonne d'entrée avait été renommée. Le tableau de bord s'affichait toujours, de sorte que la défaillance semblait inoffensive jusqu'à ce que quelqu'un l'utilise pour prendre une décision.
Un catalogue change cette conversation. Au lieu d'un amas informe de vérifications, vous obtenez des métriques d'observabilité nommées, chacune avec une formule connue, un propriétaire clair et une politique d'alerte qui peut être révisée après coup. C'est important car une même anomalie peut être décrite de trois manières différentes si personne ne s'est mis d'accord sur le fait qu'il s'agit d'un retard de fraîcheur, d'une conformité de schéma ou d'une perte de volume en aval.
Le vocabulaire partagé prévient la dérive des incidents
Lorsqu'un responsable des données, un analyste et un ingénieur s'entendent tous sur la même définition de « données tardives », ils cessent de perdre du temps en traduction. Un catalogue de métriques leur donne une définition unique pour chaque signal, un seul chemin de calcul et une règle d'escalade unique. C'est particulièrement utile lorsqu'une table se comporte différemment pendant les heures de bureau et pendant la nuit, car un même mot peut décrire des modes de défaillance très différents.
Un catalogue réduit également la multiplication anarchique des seuils. Sans lui, chaque ingénieur d'astreinte invente une nouvelle limite pour chaque actif, ce qui se traduit par des alertes incohérentes, des gravités variables et une confiance dégradée. Grâce au catalogue, l'équipe peut déterminer si un signal relève du niveau d'avertissement, du niveau d'alerte urgente ou du niveau « à surveiller mais ne réveiller personne ».
Règle pratique : si deux personnes peuvent être en désaccord sur le fait de savoir si le problème relève de la fraîcheur, du volume ou du schéma, c'est que votre catalogue n'est pas encore assez précis.
La valeur ajoutée devient plus évidente lors d'un incident réel. Un tableau de bord peut indiquer des revenus stables à 9 heures, mais la métrique de fraîcheur peut révéler que la table des commandes a cessé de se mettre à jour à 2 h 14. C'est le premier maillon brisé, et c'est ce qu'il faut corriger avant que quiconque ne commence à débattre des rapports en aval. Pour un point de départ pratique, digna's data observability overview montre comment les équipes abordent le problème en production.
Qu'est-ce que les métriques de Data Observability ?
Les métriques de Data Observability sont des mesures de séries temporelles effectuées sur les actifs de données et les pipelines qui les déplacent. Elles comprennent le nombre de lignes, les taux de valeurs nulles, les empreintes de schéma, les résumés de distribution, les écarts de lignage (lineage) et des indicateurs dérivés tels que les scores d'anomalies ou les scores de dérive (drift). En pratique, ce sont les signaux dont vous suivez la tendance au fil du temps pour savoir quand une table cesse de se comporter comme elle le devrait.
Un catalogue utile rend ces signaux lisibles en un coup d'œil. Une métrique nommée null_rate_email_hourly en dit bien plus à un analyste que check_7, car son nom indique déjà le sujet, la mesure et la fréquence. Les conventions de nommage structurées, comme le modèle de data tags for ai content creation, fonctionnent de la même manière : les étiquettes doivent aider à reconnaître ce que l'on regarde avant même d'ouvrir la définition.
Les métriques sont continues, les vérifications sont ponctuelles
Une vérification basique de la qualité des données répond généralement par oui ou par non. Cette colonne est-elle nulle ? Cet identifiant est-il unique ? La valeur se situe-t-elle dans la plage attendue ? Ces vérifications sont utiles, mais elles ne font que valider une règle connue à un instant précis.
Les métriques d'observabilité fonctionnent différemment. Elles sont mesurées en continu, comparées à une référence historique pour cet actif spécifique, et déclenchent des alertes en cas de déviation plutôt que de simple non-respect d'une règle. Une vérification du taux de valeurs nulles sur un champ d'e-mail est un test de qualité statique. Une série temporelle de taux de valeurs nulles horaire avec une moyenne mobile de référence est une métrique d'observabilité, car elle peut révéler un problème d'extraction lent en amont bien avant que quelqu'un ne remarque des campagnes défaillantes.
Cette distinction est essentielle pour la façon dont les équipes documentent le catalogue. Chaque entrée doit répondre à trois questions, de manière cohérente et sans approximation.
Définition : ce que signifie la métrique en langage clair.
Méthode de calcul : la formule ou l'agrégation sous-jacente.
Politique d'alerte : si elle avertit, déclenche une alerte urgente ou alimente uniquement l'analyse.
Distinction utile : si l'équipe ne lance la vérification que lorsque quelqu'un soupçonne un problème, il s'agit d'un test. Si la métrique fait l'objet d'un suivi de tendance, d'une référence de base et d'un système d'alerte, il s'agit d'Observability.
La façon la plus claire de concevoir le catalogue est de le voir comme une couche intermédiaire entre la télémétrie brute et l'action humaine. Les comptages bruts et les horodatages deviennent des métriques. Les métriques deviennent des seuils. Les seuils se traduisent par des décisions opérationnelles (runbooks).
Les cinq catégories clés en un coup d'œil
Le domaine s'organise généralement autour de cinq grands axes de mesure, et chaque axe permet de détecter une classe de défaillance différente. Il ne s'agit pas de taxonomies concurrentes, mais de visions complémentaires d'un même actif. Un catalogue sain répertorie ces cinq catégories afin que les équipes ne se focalisent pas uniquement sur le seul signal qu'elles savent déjà collecter.
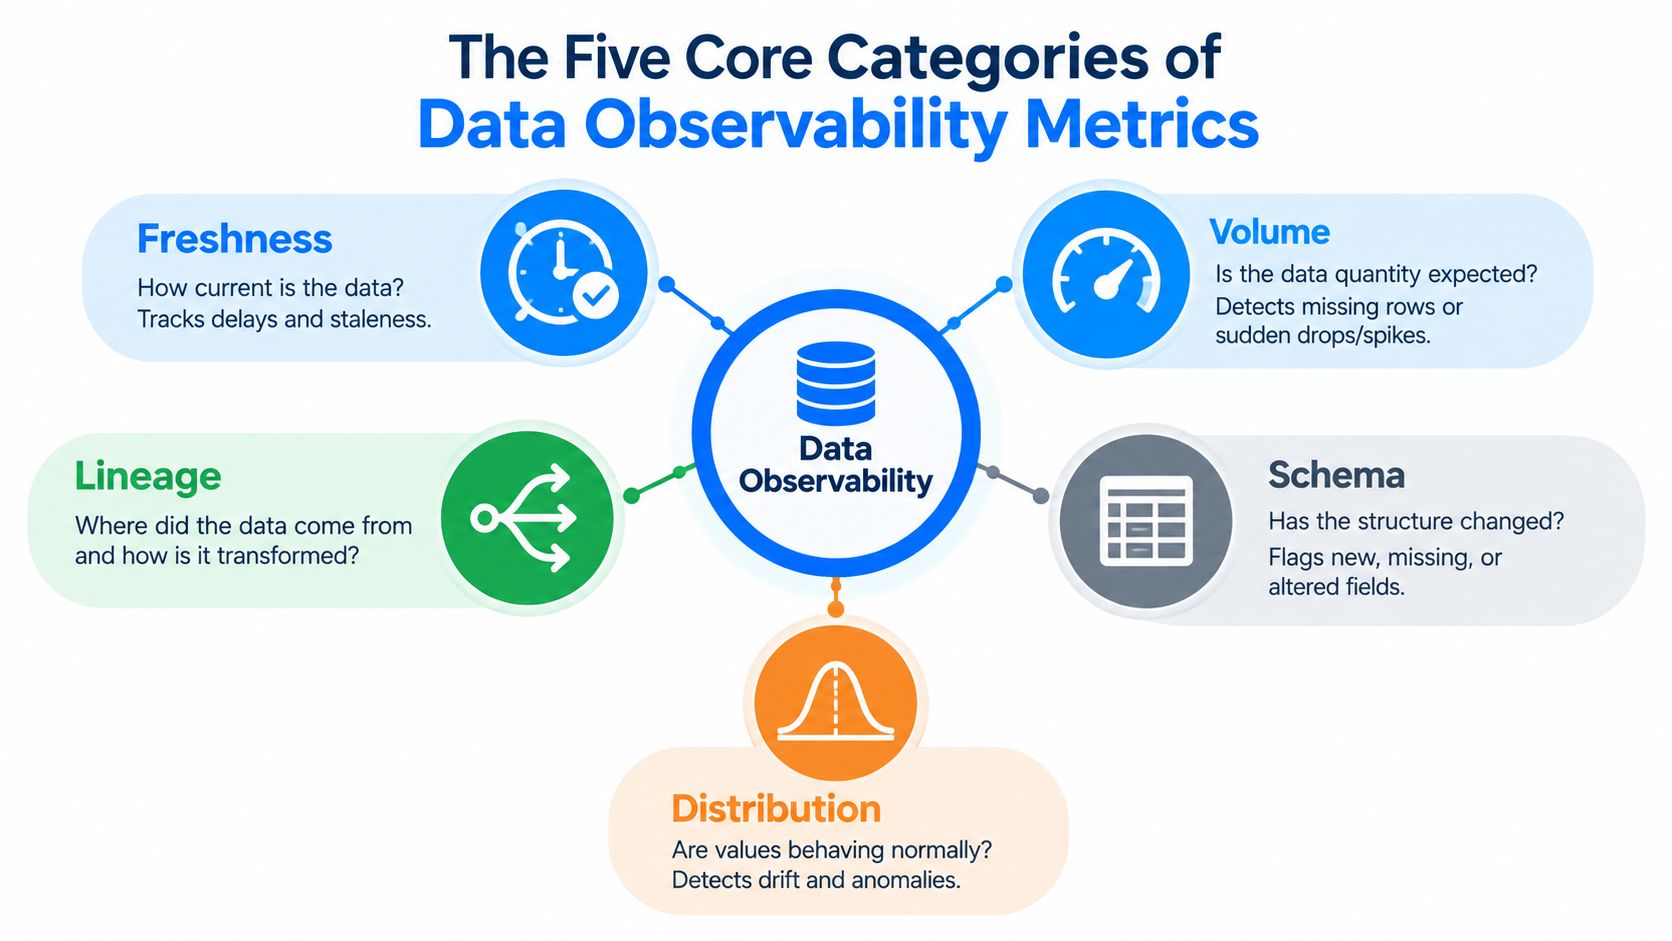
Fraîcheur, volume, schéma, distribution, lignage (lineage)
La fraîcheur permet de savoir si les données sont assez récentes pour l'usage métier prévu. Elle détecte les arrivées tardives de partitions et les tâches ELT bloquées, celles qui rendent un tableau de bord obsolète.
Le volume vérifie si la quantité d'enregistrements correspond globalement à ce qui était attendu. C'est la première ligne de défense contre les transferts vides, les chargements tronqués et les doublons lors de l'ingestion.
Le schéma surveille les changements structurels tels que les nouvelles colonnes, les champs manquants, les champs renommés et les changements de types. Il détecte les ruptures qui font que les modèles en aval commencent à renvoyer des valeurs NULL, même si la table continue de se charger.
La distribution examine le comportement des valeurs, et pas seulement les effectifs. Les variations des taux de valeurs nulles, de la cardinalité, des plages ou de la forme des données se manifestent souvent avant qu'un utilisateur métier ne remarque un résultat erroné.
Le lignage (lineage) cartographie les chemins de dépendance. Il vous indique quel tableau de bord, modèle ou table en aval dépend de l'actif qui a changé. C'est la catégorie qui évite qu'une seule source défaillante ne se transforme en une heure de recherche à l'aveugle.
L'avantage de regrouper ces mesures par catégorie est que chacune présente une signature de défaillance différente. Un travail en retard se traduit souvent d'abord par un problème de fraîcheur, puis de volume. Une migration d'API chez un fournisseur se manifeste souvent par une dérive de schéma combinée à des pics de valeurs nulles. Une panne de source peut se propager à travers le lignage et finir par apparaître comme une dérive de distribution en aval.
Utilisez la catégorie qui correspond au premier symptôme mesurable, puis confirmez les autres avant de lancer une escalade.
Métriques de fraîcheur et de Timeliness en détail
La fraîcheur est une question de retard, pas seulement de savoir si un traitement s'est exécuté. Un pipeline peut réussir tout en fournissant des données trop tard pour être utiles. Pour les événements produits, les flux de commandes et les tableaux de bord opérationnels, le retard lui-même constitue l'incident.
La méthode la plus rigoureuse pour exprimer la fraîcheur consiste à mesurer l'écart entre la disponibilité attendue et la disponibilité réelle. Cela vous donne une métrique que vous pouvez baser sur l'historique, associer à une alerte et transmettre au propriétaire du pipeline. digna's timeliness definition and monitoring notes s'adaptent parfaitement à ce cas d'usage si vous souhaitez un exemple de plateforme qui traite le calendrier de livraison comme un signal de premier plan.
Quatre métriques pour rendre la fraîcheur actionnable
max_event_lag_seconds est la mesure de retard la plus simple. Une formule pratique est now() - max(event_time), qui vous indique de combien de temps l'événement le plus récent est en retard par rapport au moment présent.
row_arrival_rate suit le débit au fil du temps, généralement exprimé en lignes ingérées par minute. Une baisse soudaine peut signifier que la source a cessé d'émettre, qu'un filtre est devenu trop restrictif ou que le traitement en amont est bloqué.
pipeline_completion_lag compare l'heure de fin planifiée avec l'heure de fin réelle. Cela permet de savoir quand le traitement se termine techniquement, mais seulement après que l'accord de niveau de service (SLA) a déjà été dépassé.
sla_breach_minutes mesure la durée pendant laquelle l'actif est resté au-delà de son budget de fraîcheur. C'est le chiffre qui transforme un retard technique en durée d'incident.
Métrique | Formule | Exemple | Avertissement | Alerte urgente |
|---|---|---|---|---|
max_event_lag_seconds |
| L'événement le plus récent est en retard sur l'heure actuelle | À 50 % du SLA | À 100 % du SLA |
row_arrival_rate |
| Le taux d'ingestion descend sous le rythme attendu | À 50 % du débit attendu | À 100 % du débit attendu |
pipeline_completion_lag |
| Le traitement se termine après la fermeture de la fenêtre | À 50 % du budget de fraîcheur | À 100 % du budget |
sla_breach_minutes | Temps écoulé au-delà du budget de fraîcheur | L'actif reste en retard au-delà de la fenêtre de SLA | À 50 % du retard autorisé | À 100 %, avec escalade à 200 % |
Définir la fenêtre par classe d'actifs
Utilisez des budgets de fraîcheur différents selon les produits de données. Les événements produits nécessitent généralement des fenêtres de l'ordre de la sous-minute. Les bases de données transactionnelles (marts) tolèrent souvent environ 5 minutes. Les agrégats nocturnes se situent généralement dans une fourchette de 15 à 60 minutes. Les extractions de Compliance peuvent être mesurées sur des fenêtres de 24 heures lorsque le processus métier le permet.
C'est pourquoi les limites globales sont une mauvaise pratique. Un seuil de fraîcheur unique ne peut pas convenir à la fois à un flux de clics à haute fréquence et à une table de règlement quotidienne sans générer de fausses alertes. Un système d'alerte à plusieurs niveaux est plus stable : avertissement à 50 pour cent du SLA, alerte urgente à 100 pour cent, et escalade à 200 pour cent si l'actif est toujours en retard.
Règle opérationnelle : inscrivez le SLA à côté du nom de la métrique. Si le budget de fraîcheur n'est pas explicite dans le runbook, l'alerte ne sera pas exploitable.
Scores d'anomalies et mesures de dérive (drift) ou de volatilité
Un ensemble de données défectueux n'est pas toujours en retard ou manquant. Parfois, les données arrivent à temps mais se comportent d'une manière totalement aberrante. C'est là que les scores d'anomalies et les mesures de dérive (drift) prouvent leur utilité, car ils traduisent l'impression que « quelque chose cloche » en un signal comparable avec l'historique.
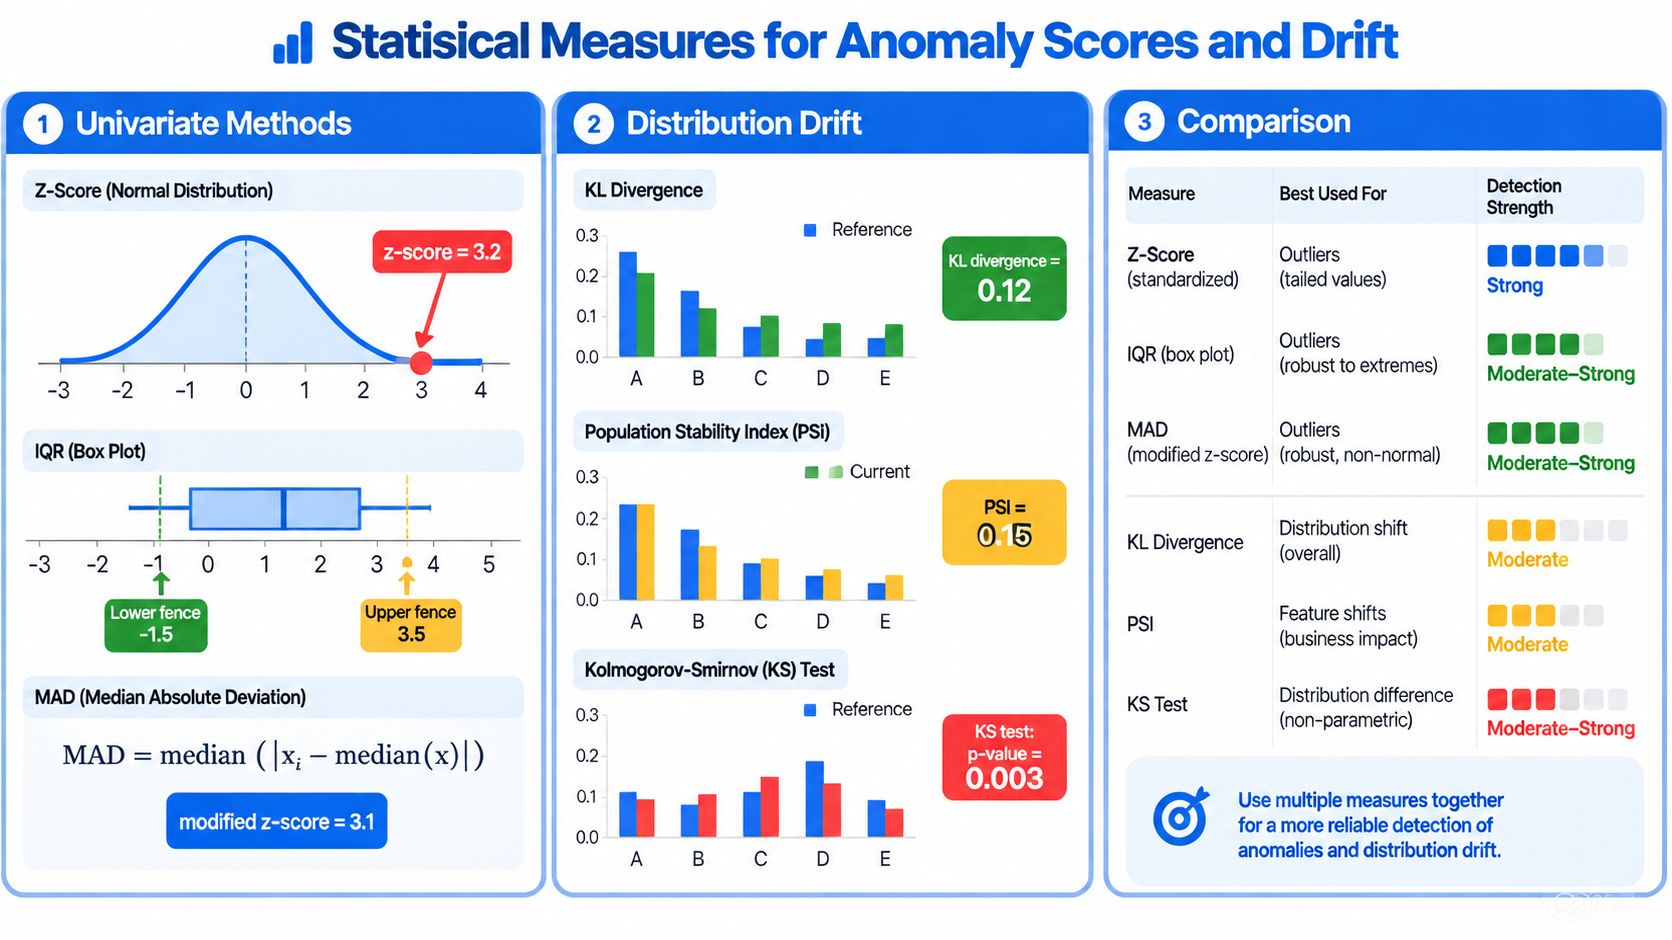
Trois façons de détecter un comportement inhabituel
Les méthodes univariées analysent une seule métrique à la fois. Un score z indique à combien d'écarts-types la valeur du jour se situe par rapport à la moyenne. Un score z modifié utilise la médiane et l'écart absolu médian (MAD), ce qui est utile lorsque les données contiennent des valeurs aberrantes. Les seuils basés sur l'écart interquartile (IQR) sont également simples, car ils signalent les valeurs situées au-delà de la dispersion centrale de la distribution.
Les méthodes basées sur la distribution comparent la forme d'un échantillon à un autre. La divergence de Kullback-Leibler (KL), l'indice de stabilité de population (PSI) et le test de Kolmogorov-Smirnov (KS) sont des choix courants pour savoir si l'histogramme d'une colonne a subi un glissement significatif.
Les références temporelles gèrent la saisonnalité. Une métrique quotidienne peut sembler alarmante si l'on compare le lundi matin au dimanche soir. Les références glissantes par jour de la semaine, par heure de la journée ou selon le calendrier d'activité sont donc généralement plus fiables qu'un seuil fixe unique.
Pour un exemple concret, prenons daily_active_users. Si vous calculez une moyenne et un écart-type mobiles sur 14 jours, le volume d'aujourd'hui peut être comparé à cette référence mobile. Une alerte simple peut se déclencher lorsque la valeur dépasse 3 sigma ou descend en dessous du 10e centile de référence. Cette configuration bilatérale est importante car les hausses comme les baisses soudaines peuvent invalider les hypothèses en aval.
La plus grande erreur ici est d'utiliser des seuils unilatéraux pour des données saisonnières. Un flux de trafic de vente au détail, un lot de règlements et un flux de connexion d'application B2B ne partagent pas le même profil. Une règle universelle unique a donc tendance à saturer les équipes d'alertes inutiles plutôt qu'à apporter de la clarté. Le coût d'un trop grand nombre de faux positifs est bien réel, car les équipes d'astreinte finissent par ignorer les alertes censées les protéger.
The data drift detection guidance est un complément utile pour voir comment la surveillance de la dérive (drift) se traduit dans des architectures de production. L'idée clé reste la même : mesurer l'écart par rapport à la bonne référence, et non par rapport à une idée abstraite de la normalité.
Comptage des modifications de schéma et signaux de dérive structurelle
La dérive de schéma devient gérable dès lors que l'on cesse de la traiter comme un vague problème de compatibilité pour commencer à la mesurer. Un champ renommé, un changement de type ou une colonne supprimée sont plus faciles à traiter lorsque l'alerte désigne l'événement structurel exact et cible le propriétaire avant le déploiement.
Quatre métriques pour rendre la structure visible
schema_change_count comptabilise les ajouts, suppressions et modifications de types par exécution de pipeline. Si une source commence à ajouter des colonnes chaque semaine, cette métrique mettra en évidence cette tendance bien avant que le modèle en aval ne se brise.
backward_incompatible_change_rate représente la proportion de modifications de schéma susceptibles de perturber les consommateurs existants. Elle vous indique si le changement s'effectue de manière sécurisée ou risquée.
drift_detection_latency_minutes mesure le temps écoulé entre un commit ou un Release en amont et l'alerte. Si vous ignorez le temps nécessaire pour détecter une dérive, vous ne savez pas vraiment à quel point vos consommateurs sont exposés.
orphaned_column_rate suit les champs qui ne sont plus lus par aucun modèle ou tableau de bord en aval. Ces colonnes sont souvent le signe de dépendances obsolètes, d'une logique oubliée ou d'un contrat de données qui n'est plus maintenu par personne.
Métrique de dérive (Drift) | Définition | Calcul | Exemple | Propriétaire |
|---|---|---|---|---|
schema_change_count | Nombre de modifications structurelles par exécution | Ajouts + suppressions + changements de types | Une colonne renommée apparaît dans le chargement | Ingénieur plateforme de données |
backward_incompatible_change_rate | Proportion de modifications incompatibles avec l'existant | Modifications incompatibles / modifications totales | Un changement de type tronque les valeurs en aval | Propriétaire du code |
drift_detection_latency_minutes | Temps écoulé entre le commit et l'alerte | Heure de l'alerte moins heure de la modification | Une migration n'est détectée qu'après la défaillance d'un tableau de bord | Propriétaire du pipeline |
orphaned_column_rate | Champs non utilisés par les consommateurs en aval | Colonnes non lues / colonnes totales | Un champ subsiste dans la table mais rien ne le lit | Ingénieur analytics |
Les références par table sont ici essentielles. Une table d'événements à forte activité ne doit pas être évaluée selon les mêmes critères qu'une table de référence à évolution lente, car l'une d'elles semblera toujours générer du bruit si vous leur imposez la même règle. Orientez les modifications incompatibles vers le propriétaire du code avant le déploiement, et non après la panne constatée sur le tableau de bord.
Les moniteurs de KPI d'entreprise comme couche de niveau décisionnel
Les métriques brutes d'observabilité vous indiquent ce qui a cassé. Les moniteurs de KPI d'entreprise expliquent à la direction ce que cela signifie. Cette couche se situe au-dessus de la fraîcheur, du volume, du schéma, de la distribution et du lignage (lineage), et elle associe ces signaux à des indicateurs concrets comme l'exactitude des revenus, les demandes de remboursement, l'attrition (churn) et la finalisation des commandes.

Construire le KPI à partir des actifs sous-jacents
Un moniteur de niveau décisionnel commence par un indicateur métier de confiance, puis remonte jusqu'aux actifs de données sous-jacents qui l'alimentent. Une fois les dépendances identifiées, vous pouvez associer des métriques d'observabilité à chaque actif afin que le KPI global hérite de ces signaux. Si les revenus d'achat fluctuent, vous ne vous contentez pas de regarder le graphique des ventes. Vous vérifiez simultanément la fraîcheur des événements de commande, les anomalies de volume sur les articles et la stabilité du schéma du catalogue produits.
C'est là toute la différence entre un tableau de bord d'apparat et un véritable outil de pilotage d'entreprise. Un graphique d'apparat peut rester au vert même si l'une des entrées est manquante ou mal formatée. Un moniteur de niveau décisionnel recherche la faille sous le KPI et oriente le problème vers l'équipe responsable du processus métier.
Un bon modèle de responsabilité est simple. Les équipes finance ou opérations doivent posséder la définition du KPI, l'équipe plateforme de données doit gérer les signaux d'observabilité bruts, et l'ingénierie analytics doit maintenir la carte des dépendances. Cela évite que l'alerte ne passe d'une équipe à l'autre alors que chacune ne maîtrise qu'une partie du problème.
digna est une plateforme qui associe la surveillance métier à la gestion de la Timeliness, à la détection d'anomalies, à la validation et au suivi de schéma au sein même de l'environnement du client. L'important n'est pas la marque, mais la méthodologie : le KPI ne devient exploitable que lorsque les signaux sous-jacents sont visibles et associés à un propriétaire clairement identifié.
Les moniteurs de KPI doivent être peu nombreux, car chacun d'eux doit être associé à une décision humaine.
Matrice de référence rapide pour le catalogue
Un catalogue de référence doit tenir sur un seul écran lorsqu'un utilisateur examine un ticket d'incident. L'objectif n'est pas d'afficher toutes les métriques possibles, mais d'aider un responsable à répondre rapidement à une question : sur quoi dois-je alerter pour cet actif ?
La matrice ci-dessous regroupe les catégories courantes dans une vue opérationnelle unique. Les seuils sont des points de départ, pas des vérités absolues, et doivent être ajustés pour chaque actif après avoir analysé le comportement réel.
Catégorie de métrique | Calcul principal | Seuil d'alerte recommandé | Propriétaire typique | Niveau de gravité |
|---|---|---|---|---|
Fraîcheur |
| Dépassement absolu du SLA en minutes | Ingénieur plateforme de données | Élevé |
Anomalie de volume | Moyenne et écart-type mobiles, ou score z | Déviation par rapport à la référence basée sur la distribution | Ingénieur analytics | Moyen à Élevé |
Nombre de changements de schéma | Nombre d'ajouts, suppressions, changements de types par run | Nombre absolu de changements incompatibles | Propriétaire du code | Élevé |
Dérive de distribution | PSI, test KS ou décalage d'histogramme | Variation relative par rapport à la distribution de référence | Responsable qualité des données | Moyen |
Rupture de lignage (lineage) | Dépendance manquante en amont ou en aval | Rupture absolue dans le graphique de dépendances | Ingénieur plateforme | Élevé |
Taux de valeurs nulles | Valeurs nulles divisées par le nombre total d'enregistrements | Augmentation relative par rapport à la référence | Ingénieur analytics | Moyen |
Unicité | Nombre de valeurs distinctes divisé par le nombre de lignes | Baisse absolue ou relative de l'unicité | Data steward | Moyen |
Moniteur de KPI métier | KPI dérivé de plusieurs signaux | Écart par rapport à la marge de tolérance de l'entreprise | Propriétaire métier | Critique |
Si vous souhaitez une table de plateforme qui reflète cette approche de catalogue, digna's metrics system table montre comment les familles de métriques peuvent être organisées pour un usage opérationnel. La meilleure matrice est celle que votre équipe peut maintenir en situation d'incident, pas celle qui contient le plus de lignes.
Références croisées entre les catégories de métriques
Un pipeline en retard commence souvent par un défaut de fraîcheur, puis se manifeste par une anomalie de volume car moins de lignes sont arrivées par rapport à la référence. Traitez ce doublon comme un chemin d'incident unique, et non comme deux alertes distinctes.

Fraîcheur-vers-volume, schéma-vers-distribution, lignage-vers-dérive
Une modification de schéma et un pic de valeurs nulles surviennent souvent ensemble après la migration d'une API de fournisseur. Une seule modification de structure peut entraîner à la fois un problème de champ manquant et un problème de profil de valeur. Une alerte de schéma doit donc être confrontée au moniteur de distribution avant de clôturer le ticket.
Les ruptures de lignage peuvent également déclencher des alertes de dérive en aval lorsqu'une source manquante affecte toutes les tables dépendantes. Les analyses de référence par actif permettent de garder des comparaisons fiables, car une table de règlement quotidienne et un flux d'événements à haute fréquence peuvent tous deux être sains tout en se comportant de façon très différente.
Configurez ces trois associations sous forme de vérifications complémentaires dans votre outil d'alerte, afin que le second signal soit interrogé automatiquement lorsque le premier se déclenche.
Choisir l'ensemble de métriques le plus restreint mais le plus pertinent
Un ensemble de métriques n'est utile que s'il permet d'orienter une décision. Si une alerte ne désigne pas un responsable ou une solution probable, elle devient un bruit parasite.
Commencez par un SLA de fraîcheur pour chaque niveau critique, un score d'anomalie sur les volumes liés aux revenus, des comptages de modifications de schéma sur les tables susceptibles de bloquer les consommateurs en aval, et un moniteur de KPI par processus métier majeur. Pour une plateforme de paiement, cet ensemble de départ pourrait consister en un SLA de fraîcheur sur la table des transactions, un score d'anomalie à 3 sigma sur le volume quotidien des règlements, un suivi des modifications de schéma sur la table des clients et un moniteur de KPI sur le taux de remboursement.
Sélectionnez les métriques en fonction des responsabilités, de l'historique des incidents et de la zone d'impact potentielle. Réévaluez cette liste chaque trimestre, car les actifs évoluent, les modes de défaillance changent et le catalogue doit s'adapter en conséquence.
Questions fréquentes
Que sont les métriques d'observabilité des données ?
Des mesures en série temporelle prises sur les actifs de données et les pipelines qui les déplacent. Un nom comme null_rate_email_hourly en dit bien plus à un analyste que check_7, car il porte déjà le sujet, la mesure et la cadence avant même d'ouvrir la définition.
En quoi diffèrent-elles des contrôles qualité ?
Un contrôle répond par oui ou non à un instant donné ; une métrique est suivie dans le temps, dotée d'une ligne de base et alertable. Le test utile est simple : si l'équipe ne l'exécute que lorsqu'elle soupçonne un problème, c'est un test, pas de l'observabilité.
Quelles sont les cinq catégories de métriques ?
Fraîcheur, volume, schéma, distribution et lineage. Chacune a sa signature de défaillance : la fraîcheur porte sur le retard et non sur le fait qu'un job ait tourné, le volume vérifie si le nombre d'enregistrements ressemble à l'attendu, et la distribution observe le comportement des valeurs plutôt que les comptages.
Pourquoi une équipe a-t-elle besoin d'un catalogue partagé ?
Pour arrêter la dérive des incidents. Quand un responsable data, un analyste et un ingénieur entendent la même chose par « données en retard », ils cessent de traduire et commencent à corriger. Si deux personnes peuvent débattre pour savoir si le sujet relève de la fraîcheur, du volume ou du schéma, le catalogue manque encore de précision.
Que doit documenter chaque entrée du catalogue ?
Trois choses : la définition en langage clair, la méthode de calcul sous-jacente et la posture d'alerte, c'est-à-dire si la métrique avertit, réveille quelqu'un ou alimente seulement l'analyse. C'est ce dernier champ qui empêche un catalogue de se transformer en bruit indifférencié.



