Classe de données : le guide pratique pour les équipes modernes
|
7
minute de lecture

Le conseil le plus répandu consiste à classifier les données une bonne fois pour toutes, à leur apposer des étiquettes comme public ou confidentiel, puis à considérer le problème de gouvernance comme réglé. Cette approche confond description et contrôle. Une étiquette qui ne modifie ni l'accès, ni la validation, ni la conservation, ni la surveillance, ni la réponse aux incidents relève de la documentation, pas de la gouvernance.
Un cadre de classe de données réellement utile doit décrire ce que contient un actif, comment il se comporte et ce que l'organisation doit faire lorsque son niveau de risque évolue. Cela implique de combiner le type analytique, la signification statistique, la représentation, le contexte métier et l'impact en matière de sécurité. Le travail difficile commence après la publication de la taxonomie, car les équipes doivent relier chaque classe à des contrôles qui fonctionnent réellement dans les bases de données, les pipelines, les entrepôts, les data lakes et les référentiels documentaires.
Table des matières
Le risque caché des étiquettes de données statiques
De nombreux programmes de classification échouent sans déclencher la moindre alarme : une équipe de gouvernance rédige une politique, les responsables étiquettent les jeux de données importants et les auditeurs reçoivent un export du catalogue, tandis que les droits d'accès restent inchangés. La surveillance continue de traiter toutes les tables de la même manière, et les équipes de réponse aux incidents ne disposent d'aucun signal fiable lorsqu'un jeu de données opérationnel ordinaire devient un actif à plus haut risque.
Des catégories comme public, interne, confidentiel et réglementé offrent toujours un vocabulaire commun utile. L'échec commence lorsque les équipes supposent que ce vocabulaire impose quoi que ce soit à lui seul. Une étiquette statique ne masque pas un champ, ne raccourcit pas une durée de conservation, n'augmente pas la fréquence de validation et ne fait pas remonter une alerte.
L'écart entre classification et application
Les chiffres révèlent un écart opérationnel mesurable. 55 % des organisations interrogées n'avaient pas mis en place de classification automatisée sur l'ensemble de leurs systèmes majeurs, et seulement 47 % disposaient d'une classification qui appliquait des contrôles en aval au lieu de se contenter d'apposer des étiquettes, selon le Kiteworks 2026 Data Security and Compliance Risk Report.
Ces chiffres distinguent deux résultats que les équipes confondent souvent. La précision de la classification consiste à savoir si la classe attribuée est correcte. L'efficacité de la classification consiste à savoir si cette classe modifie le comportement des systèmes qui stockent, traitent, surveillent et protègent les données.
Une équipe peut identifier à juste titre une table clients comme confidentielle tout en laissant un large accès aux analystes. Elle peut étiqueter un rapport réglementaire comme à haute intégrité, puis laisser un changement de schéma non revu modifier ses données d'entrée. Elle peut classer un pipeline comme à haute disponibilité tout en surveillant seulement si un traitement s'est terminé, et non si les données attendues sont arrivées à temps.
Règle pratique : traitez chaque classe comme le déclencheur d'une décision de contrôle. Si aucun contrôle ne change, interrogez-vous sur la valeur opérationnelle de la classe.
Pourquoi ajouter des catégories règle rarement le problème
Face à une application défaillante, les équipes ont souvent tendance à enrichir la taxonomie. Elles ajoutent des étiquettes pour les données personnelles, financières, critiques, restreintes, approuvées pour l'IA, archivées, ainsi que des exceptions locales. Le résultat paraît précis, mais les responsables et les outils font face à davantage d'ambiguïté sur l'étiquette qui prévaut et l'action qui en découle.
Un ensemble plus restreint de classes fiables, reliées à des actions explicites, fonctionne généralement mieux. Chaque classe doit répondre à des questions concrètes :
Qui peut accéder à l'actif ? Définissez la politique d'accès et les exceptions autorisées.
Que faut-il valider ? Précisez les contrôles au niveau des champs, des enregistrements, des rapprochements ou des règles métier.
En combien de temps les défaillances doivent-elles remonter ? Fixez la gravité des alertes et les délais de réponse attendus.
Comment les changements doivent-ils être tracés ? Conservez le lignage, les événements d'audit et les responsabilités.
Que se passe-t-il lorsque le contexte change ? Déclenchez une revue au lieu de laisser l'ancienne étiquette perdurer indéfiniment.
La classe de données prend toute sa valeur lorsqu'un processus automatisé peut détecter un décalage entre l'étiquette et le comportement actuel. Un changement de schéma, un profil de livraison inattendu, un nouvel usage en aval ou une signification métier modifiée peuvent nécessiter une reclassification.
Sans cette boucle de rétroaction, la taxonomie devient obsolète alors que les parties prenantes continuent de s'y fier. La gouvernance produit alors un catalogue qui décrit le risque d'hier, même si les droits d'accès, les pipelines et les usages métier ont évolué. La classification doit donc être reliée à la surveillance et à la réponse, faute de quoi ses étiquettes deviennent des passifs plutôt que des garde-fous.
Comprendre les trois dimensions des classes de données
Un système de classification fiable ne se résume pas à une échelle de sensibilité. Il doit évaluer conjointement la sensibilité, le format et le domaine, car chaque dimension modifie le sens des autres.
La sensibilité décrit les conséquences d'une compromission. Le format décrit la manière dont l'actif est représenté et ce qui peut être testé. Le domaine apporte le contexte métier, les responsabilités et les attentes réglementaires. La classe d'un jeu de données doit naître de leur interaction, et non d'une seule étiquette choisie isolément.
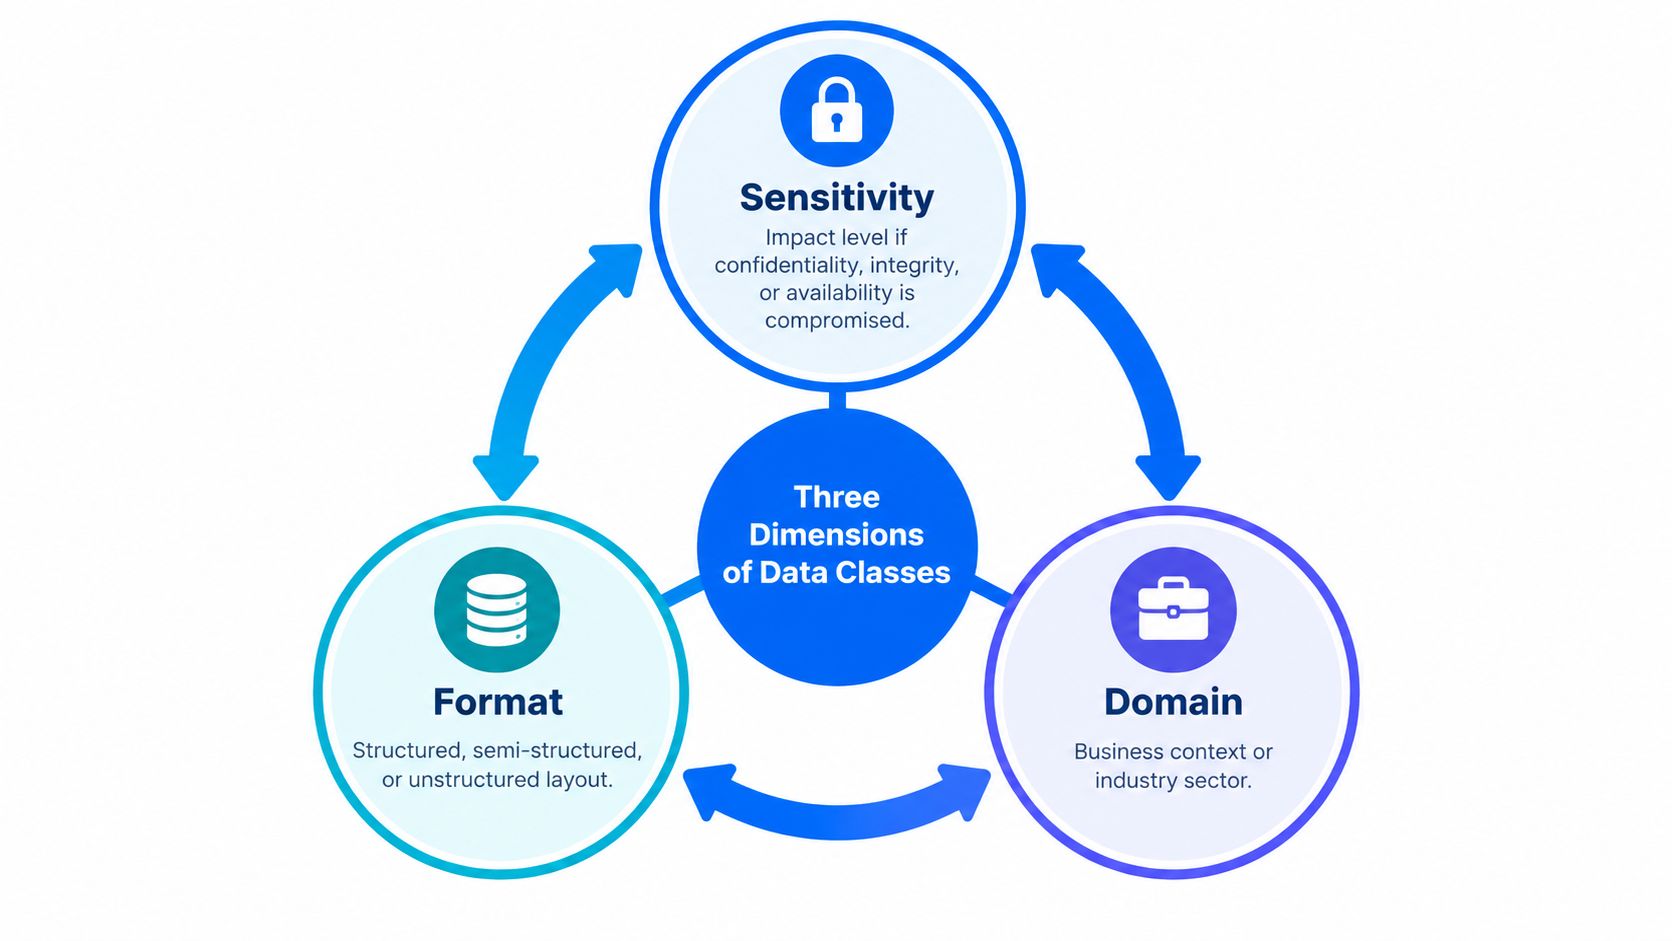
La sensibilité change la conséquence
La classification de sécurité évalue chaque type d'information séparément selon la confidentialité, l'intégrité et la disponibilité. Une classe peut être faible sur une dimension et élevée sur une autre. Un flux de KPI public peut ne contenir aucune information confidentielle, alors que des valeurs erronées pourraient orienter des décisions réglementaires ou opérationnelles : l'intégrité a alors une conséquence élevée.
Cette distinction évite une erreur fréquente, qui consiste à considérer « public » comme synonyme de « faible risque ». Des données publiques peuvent tout de même exiger une gestion des changements rigoureuse, des rapprochements, du lignage ou une surveillance de la fraîcheur. À l'inverse, des données privées n'ont pas forcément besoin de contrôles identiques sur toutes les dimensions.
Le format change le test
Une table relationnelle se prête à des contrôles sur les colonnes, les types de données, l'unicité, les relations et les règles au niveau de l'enregistrement. Un flux d'événements JSON demande une attention particulière aux chemins imbriqués, aux attributs facultatifs, aux variantes de contenu et aux erreurs d'analyse. Un référentiel documentaire peut nécessiter un suivi du statut d'extraction, des contrôles de métadonnées et la confirmation que les fichiers stockés restent exploitables.
La représentation détermine quelles défaillances sont visibles. Un test générique de valeurs manquantes peut réussir alors même qu'un attribut JSON imbriqué a disparu ou qu'un traitement d'ingestion de documents stocke des fichiers dont le contenu ne peut pas être extrait.
Le domaine change la décision
Un même champ peut exiger des contrôles différents selon le contexte. Un horodatage dans un processus de santé peut conditionner la ponctualité clinique. Le même type de champ dans un flux de reporting public peut servir les calendriers de publication et la redevabilité. Les équipes de la finance, des télécommunications, de la santé et du secteur public attachent chacune des conséquences différentes aux retards, aux modifications et aux enregistrements incomplets.
Un modèle pragmatique consigne donc le responsable métier de l'actif, son cas d'usage, sa criticité, son format et son impact CIA. Les équipes qui souhaitent approfondir la manière dont les dimensions de la qualité influencent ces décisions peuvent s'appuyer sur ce guide pour comprendre les dimensions de la qualité des données.
Le résultat est une classe qui indique aux ingénieurs non seulement ce que sont les données, mais aussi comment les surveiller.
Appliquer la triade CIA à la classification des données
Une classification orientée sécurité doit évaluer chaque type d'information séparément selon la confidentialité, l'intégrité et la disponibilité, en attribuant un niveau d'impact fondé sur le préjudice causé par la perte de chacun de ces objectifs. Ce principe est décrit dans les recommandations de classification des données d'entreprise de l'Organisation des États américains.
L'erreur pratique consiste à réduire les trois dimensions à un score de sensibilité unique. Un score unique masque la raison pour laquelle un jeu de données compte et complique le choix du bon contrôle. Le principe du niveau le plus élevé (high-watermark) répond à ce problème : la dimension CIA aux conséquences les plus lourdes détermine l'exigence de protection globale.
La confidentialité exige des contrôles d'exposition
Les données confidentielles causent un préjudice lorsque des personnes non autorisées peuvent les consulter, les copier ou les déduire. Les dossiers clients, les informations de santé, les données sur les collaborateurs et les éléments commercialement sensibles nécessitent des contrôles tels que l'accès restreint, le masquage, le chiffrement et la surveillance de l'exposition.
La classification doit identifier le type d'information et l'usage autorisé, pas seulement le nom de la table. Une table appelée customer_summary peut contenir des valeurs agrégées dans un environnement et des enregistrements directement identifiants dans un autre. Le contrôle doit suivre le contenu et le contexte réels.
L'intégrité exige des preuves d'exactitude
L'intégrité concerne les modifications non autorisées ou incorrectes. Les écritures financières, les chiffres réglementaires et les métriques qui orientent les décisions peuvent être publiquement visibles tout en exigeant une protection rigoureuse contre les modifications silencieuses.
Cela conduit à un ensemble de contrôles différent :
Validation des enregistrements : testez les valeurs au regard des règles métier et des relations autorisées.
Rapprochement : comparez des totaux liés ou les résultats entre source et destination.
Lignage : conservez le chemin qui mène des enregistrements sources aux métriques publiées.
Preuve d'altération : enregistrez les changements et rendez visibles les modifications inexpliquées.
Un flux de données public peut donc recevoir un impact élevé en intégrité tout en restant faible en confidentialité. La classe doit communiquer cette distinction aux data engineers et aux équipes de réponse aux incidents.
La disponibilité exige une visibilité sur la livraison
La disponibilité, c'est l'accès aux données au moment où les utilisateurs et les systèmes en ont besoin. Les jeux de données opérationnels, les flux et les dépendances de plateforme peuvent défaillir par retard de livraison, chargement manquant ou panne, même lorsque leur contenu reste exact et protégé.
La surveillance doit donc suivre la fraîcheur, la latence de livraison, les profils d'arrivée attendus et les chargements manquants. Une tâche de pipeline terminée ne prouve pas que des données exploitables sont arrivées. Le contrôle doit observer l'événement de données dont dépendent réellement les consommateurs en aval.
Une classe fondée sur la triade CIA doit se traduire directement en gravité des alertes, fréquence de validation, durée de conservation et objectifs de réponse aux incidents. Elle doit aussi rester révisable. Les usages métier changent, les dépendances s'étendent et les schémas évoluent. Une classification incapable d'absorber ces changements devient une hypothèse dépassée plutôt qu'un signal de sécurité fiable.
Structurer la classification selon le format des données
La première question structurelle n'est pas de savoir si un jeu de données est sensible. C'est de savoir comment les données sont représentées. Les actifs structurés, semi-structurés et non structurés présentent des modes de défaillance différents et exigent donc des contrôles d'observabilité différents. La Commission européenne considère la qualité, la structure, l'interopérabilité, l'authenticité et l'intégrité comme des conditions importantes pour tirer de la valeur des données, en particulier dans les contextes d'IA, comme le résume son document sur la gouvernance et les politiques des données.
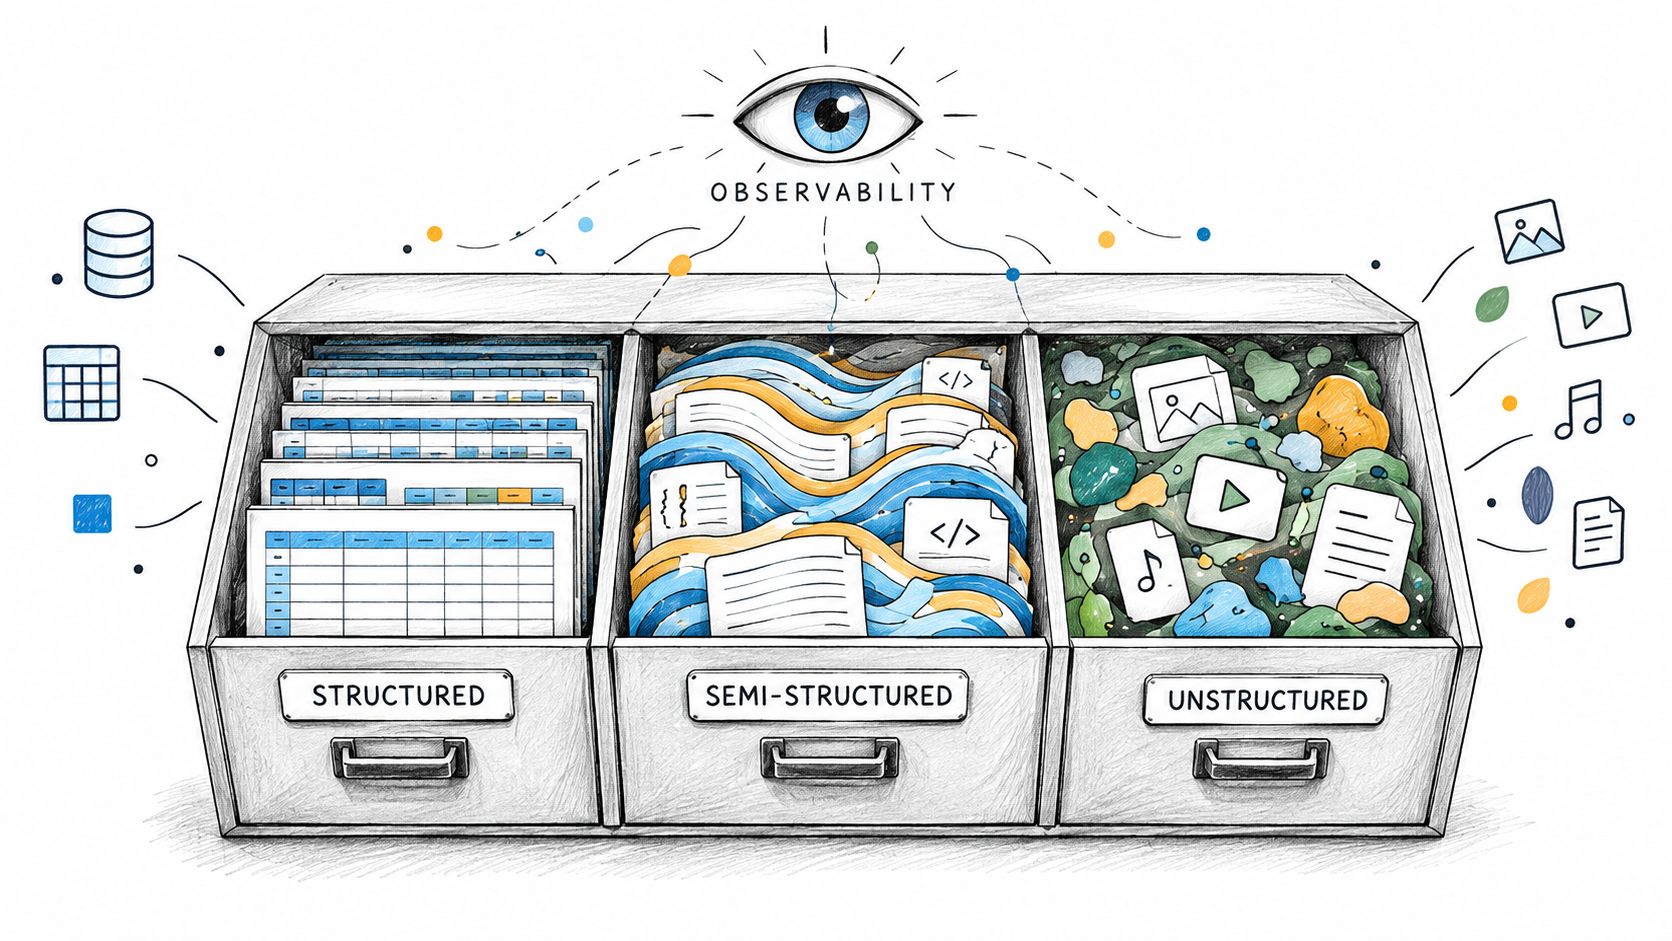
Actifs structurés
Les tables structurées suivent un modèle défini. Elles se prêtent donc à des contrôles ciblés :
Conformité au schéma : détectez les colonnes manquantes, ajoutées ou renommées.
Validation des types : vérifiez que les valeurs correspondent à l'attente analytique.
Unicité : repérez les clés en double ou les répétitions inattendues.
Intégrité référentielle : vérifiez les relations entre les tables.
Règles métier : testez les conditions au niveau de l'enregistrement et les combinaisons autorisées.
Le type de stockage ne se confond pas pour autant avec la signification analytique. Un champ numérique peut coder une catégorie, comme un code de statut, plutôt que représenter une quantité mesurable. Les données statistiques sont couramment réparties en classes catégorielles et quantitatives, et cette distinction détermine si les équipes doivent recourir aux comptages de fréquences et à la détection de valeurs inattendues, ou aux distributions, moyennes, percentiles, à la variance et à l'analyse des valeurs aberrantes. Le glossaire des termes statistiques de l'OCDE documente cette différence.
Contenus semi-structurés
Les événements JSON et contenus similaires peuvent avoir une forme reconnaissable sans schéma appliqué de manière cohérente. La surveillance doit examiner la présence des champs imbriqués, les variantes de structure, les erreurs d'analyse, les changements dans les tableaux et la dérive sémantique.
Un contrôle du taux de valeurs nulles peut manquer une défaillance où un producteur déplace une valeur vers un autre chemin ou en change le sens tout en laissant le champ renseigné. Les équipes qui travaillent avec un stockage en colonnes doivent aussi comprendre le format de fichier Parquet, notamment la manière dont sa structure influe sur la validation en aval et le suivi de schéma.
Documents et médias non structurés
Les documents, images et autres médias exigent un autre modèle de contrôle. Un téléversement de fichier réussi ne prouve pas que l'extraction a fonctionné, que les métadonnées sont complètes ou que les traitements en aval peuvent interpréter le contenu.
Suivez le statut d'ingestion, la complétude de l'extraction, la validité des métadonnées et les résultats du traitement du contenu. Classer l'actif comme non structuré doit sélectionner automatiquement ces contrôles, plutôt que d'appliquer des hypothèses relationnelles.
Les catalogues les plus efficaces consignent la représentation, la rigueur du schéma, le responsable, le comportement d'actualisation attendu et la criticité en aval. Le format n'est pas une note de bas de page descriptive. Il détermine quels signaux peuvent prouver que l'actif reste exploitable.
Relier la classification à des contrôles exécutables
Une fois les classes attribuées, la question est de savoir ce que chaque classe fait faire au système. Le tableau associe quatre classes courantes à un contrôle principal et aux preuves qui attestent que ce contrôle s'est déclenché.
Comparer les choix opérationnels
Classe de données | Contrôle principal | Métrique de surveillance |
|---|---|---|
Données clients confidentielles | Restriction d'accès, masquage et revue de l'exposition | Accès non autorisés, statut du masquage et exposition des champs sensibles |
Données financières à haute intégrité | Validation des enregistrements, rapprochement, lignage et preuve d'altération | Échecs de règles, écarts de rapprochement et changements structurels |
Données opérationnelles à haute disponibilité | Détection de fraîcheur, de livraison et de pannes | Heure d'arrivée, chargements manquants, latence et disponibilité |
Métriques publiques mais critiques pour les décisions | Gouvernance de la publication et validation de l'intégrité | Dérive des valeurs, rapprochement avec la source et changements inexpliqués |
Chaque ligne relie une étiquette à une réponse opérationnelle. Les responsables n'ont pas à interpréter le mot « critique » différemment d'un système à l'autre. Ils peuvent identifier le contrôle requis, attribuer la responsabilité et examiner les preuves produites lorsque ce contrôle réussit ou échoue.
Une classe n'a de valeur que si sa politique atteint les systèmes chargés de l'appliquer. Les métadonnées du catalogue peuvent devoir piloter les restrictions d'accès, le masquage, la conservation, la surveillance, l'acheminement des incidents ou la revue avant publication. Si ces destinations sont déconnectées, l'étiquette reste descriptive et peut créer une fausse assurance.
Cartographier les classes sur l'ensemble du patrimoine
Commencez par les actifs à fort impact plutôt que par tous les objets de l'organisation. Attribuez la classe multidimensionnelle, identifiez le responsable, définissez la destination du contrôle et vérifiez que la classification atteint chaque système concerné. Assurez-vous que chaque système enregistre une preuve, comme un résultat de validation, un événement d'accès, un résultat de rapprochement ou une alerte, lorsque le contrôle s'exécute.
Les recommandations sur les règles de validation des données et la qualité continue des données aident à traduire les classes en contrôles au niveau de l'enregistrement, en règles métier et en contrôles qualité récurrents. Le bon réflexe est de définir des contrôles qui correspondent au risque, et non d'attacher un score de qualité générique à chaque actif.
La responsabilité doit inclure la reclassification. Un jeu de données peut gagner un nouveau consommateur, changer de schéma, passer d'un domaine à un autre ou entrer dans un processus réglementé. Chacun de ces événements doit déclencher une revue de la classe et une mise à jour des politiques en aval.
Testez régulièrement toute la chaîne. Une classification qui met à jour un catalogue sans changer la surveillance, les accès ou le comportement des workflows n'est pas de la gouvernance. C'est une intention non vérifiée.
Intégrer l'observabilité à l'infrastructure
La classification devient applicable lorsque la surveillance s'exécute au plus près des données et peut agir à partir du même contexte que celui qui a défini la classe. Déplacer des enregistrements de production vers un service d'analyse externe peut créer une exposition inutile, compliquer les exigences de résidence et dissocier les décisions de gouvernance des preuves opérationnelles.
Une architecture intégrée maintient l'analyse au sein d'une infrastructure contrôlée par le client. C'est essentiel pour les organisations soumises à des exigences strictes de sécurité, de conformité ou de résidence, y compris les équipes qui opèrent on-premise ou dans un cloud privé.

Garder les contrôles au plus près de la source
L'exécution dans la base de données permet aux équipes de calculer des métriques et d'exécuter la validation sans extraire les données de production vers un environnement distinct hébergé par un éditeur. Elle facilite aussi le lien entre une classe et les signaux qui comptent :
Comportement du schéma : détectez les champs ajoutés, supprimés ou modifiés.
Comportement des enregistrements : appliquez des contrôles de règles métier à chaque enregistrement.
Ponctualité : repérez les retards, les chargements manquants et les profils d'arrivée inattendus.
Métriques métier : surveillez le comportement des indicateurs critiques.
Santé de la plateforme : observez la charge, la disponibilité et les changements opérationnels.
C'est le rôle architectural décrit pour la plateforme d'observabilité des données de digna, conçue pour fonctionner au sein de l'environnement propre de l'organisation. La documentation de digna décrit une plateforme de qualité et d'observabilité des données pilotée par l'IA, qui prend en charge le déploiement on-premise et en cloud privé, maintient la surveillance dans une infrastructure contrôlée par le client et réduit le besoin d'extraire les données de production vers un service externe.
S'appuyer sur le comportement appris là où les seuils deviennent fragiles
Les seuils manuels sont utiles pour les limites métier strictes, mais ils deviennent difficiles à maintenir lorsque chaque jeu de données présente une volatilité, une saisonnalité, un calendrier de livraison ou un comportement opérationnel différents. Une référence pilotée par l'IA peut apprendre le comportement normal de chaque jeu de données et repérer les changements inattendus, sans que les équipes aient à configurer un seuil pour chaque métrique.
L'analyse historique apporte le contexte manquant. Les ingénieurs peuvent examiner les tendances, la volatilité et les profils statistiques pour distinguer un écart ponctuel d'un problème en train de s'installer. Cette distinction améliore le tri des incidents et évite aux équipes de traiter chaque alerte comme une défaillance isolée.
Le choix de conception important n'est pas « IA contre règles ». Une gouvernance fiable utilise la validation déterministe pour les exigences explicites et la détection comportementale pour les schémas difficiles à coder manuellement. La classe détermine la combinaison adaptée, tandis que l'infrastructure détermine si les preuves restent sécurisées, disponibles à temps et exploitables.
Construire un cadre de classification opérationnel
Un cadre pragmatique commence par un inventaire délimité des actifs critiques. Sélectionnez les jeux de données qui alimentent le reporting important, les travaux réglementaires, les opérations clients, les processus cliniques, les services de télécommunications ou les décisions du secteur public. Ne commencez pas par vouloir classifier chaque fichier et chaque table avec la même précision.
Attribuez à chaque actif sélectionné une fiche multidimensionnelle :
Décrire la sensibilité : consignez séparément l'impact en confidentialité, en intégrité et en disponibilité.
Décrire le format : identifiez la représentation structurée, semi-structurée ou non structurée et le comportement de son schéma.
Décrire le domaine : renseignez le responsable métier, la finalité, le contexte réglementaire et les dépendances en aval.
Attribuer les contrôles : associez la classe aux exigences d'accès, de validation, de fraîcheur, de schéma, de conservation et de réponse.
Vérifier l'exécution : confirmez que les systèmes de surveillance et de politique ont appliqué les contrôles attendus.
Revoir les changements : réévaluez la classe lorsque le comportement, le schéma, le responsable ou l'usage métier change.
La fiche de classification doit être utile à la fois aux équipes de gouvernance et d'ingénierie. Un responsable sécurité doit connaître les conséquences d'une exposition. Un data engineer doit savoir quels tests doivent s'exécuter. Un intervenant en cas d'incident doit savoir à quelle vitesse le problème doit être escaladé et quelles preuves collecter.
Une classe n'est à jour que si ses contrôles correspondent toujours à la manière dont les données sont utilisées.
Ce modèle opérationnel éclaire aussi les décisions de souveraineté des données. Les équipes qui évaluent leurs exigences de résidence et de gouvernance trouveront peut-être utile de lire comment respecter les réglementations sur les données avec Stoa pour comprendre comment interagissent obligations légales, localisation de l'infrastructure et pratiques de traitement des données.
Confrontez la classification au comportement observé plutôt que de vous fier à une paperasse annuelle. Un jeu de données peut rester confidentiel tandis que ses exigences d'intégrité augmentent après qu'il est devenu une donnée d'entrée réglementaire. Une table structurée peut recevoir des contenus semi-structurés via un nouveau chemin d'ingestion. Un flux à faible disponibilité peut devenir critique sur le plan opérationnel dès qu'un processus métier commence à en dépendre.
Les recommandations de digna pour mettre en œuvre la gouvernance des données peuvent aider les équipes à relier responsabilités, contrôles qualité, surveillance et workflows de gouvernance. L'objectif n'est pas la taxonomie la plus vaste. C'est un ensemble de classes qui modifie de façon constante ce que les systèmes mesurent, protègent, conservent et font remonter.
digna aide les équipes à transformer une classe de données en contrôles exécutables grâce à la validation dans la base de données, au suivi de schéma, à la surveillance de la ponctualité, au suivi des métriques métier et à la détection d'anomalies par IA, dans des environnements en cloud privé ou on-premise. Rendez-vous sur digna pour découvrir comment votre équipe peut surveiller ses données critiques sans transférer les enregistrements de production vers un service externe.
La classification détermine aussi où les données peuvent être stockées et traitées. Notre guide sur les exigences de résidence des données explique comment les règles de localisation interagissent avec les classes que vous attribuez et les contrôles qu'elles déclenchent.
Questions fréquentes
Qu'est-ce qu'une classe de données ?
Une classe de données est la catégorie à laquelle appartient un actif en fonction de sa sensibilité, de son format et de son domaine métier. Une classe utile fait plus que décrire les données : elle détermine quels contrôles d'accès, de validation, de conservation et de surveillance s'appliquent. Une étiquette qui ne change rien en aval relève donc de la documentation, et non de la gouvernance.
Quelles sont les trois dimensions de la classification des données ?
La sensibilité, le format et le domaine. La sensibilité décrit les conséquences si les données sont compromises, le format décrit leur représentation et donc ce qui peut être testé, et le domaine apporte le contexte métier, les responsabilités et les attentes réglementaires. Évaluer les trois ensemble donne une classe plus fiable qu'une simple échelle de sensibilité.
Comment la triade CIA s'applique-t-elle à la classification des données ?
Chaque type d'information est évalué séparément en confidentialité, en intégrité et en disponibilité, selon le préjudice causé par la perte de chacune. Un flux de KPI public peut ne nécessiter aucun contrôle de confidentialité tout en exigeant de solides contrôles d'intégrité, car des valeurs erronées pourraient orienter des décisions réglementaires ou opérationnelles. Réduire les trois à un seul score masque cette nuance.
Pourquoi les programmes de classification des données échouent-ils ?
La plupart échouent en silence parce que les étiquettes ne modifient jamais les contrôles. Les responsables étiquettent les jeux de données et les auditeurs reçoivent un export du catalogue, mais les droits d'accès et la surveillance restent inchangés. Un rapport de 2026 cité dans l'article montre que seulement 47 % des organisations disposaient d'une classification qui appliquait des contrôles en aval, et ajouter des catégories ajoute généralement de l'ambiguïté au lieu de corriger l'application.
Comment surveiller différemment les données structurées et non structurées ?
Les tables structurées se prêtent aux contrôles de schéma, de type, d'unicité, d'intégrité référentielle et de règles métier. Le JSON semi-structuré nécessite une surveillance des chemins imbriqués, des variantes et des erreurs d'analyse, car les valeurs peuvent se déplacer sans devenir nulles. Les documents et médias non structurés exigent des contrôles d'ingestion, de complétude de l'extraction et de métadonnées, puisqu'un téléversement réussi ne prouve pas que le contenu est exploitable.


